《AI Agent 入门》学习笔记(精简重点版)
学习目标: 理解 AI Agent 的核心架构、运行机制、工程设计方法,以及如何从一个简单 Demo 构建可靠的 Agent 系统。
一、AI Agent 的核心概念
1. 什么是 AI Agent?
AI Agent(人工智能智能体)是一种能够理解目标、自主决策、调用工具,并根据环境反馈持续调整行动的智能系统。
与传统聊天机器人相比,其核心区别是:
- 传统 LLM: 用户提问 → 模型生成回答。
- AI Agent: 用户提出目标 → 模型规划 → 调用工具 → 观察结果 → 调整行动 → 完成任务。
2. 最重要的公式
Agent = LLM + 上下文 + 工具
| 组成 | 直观比喻 | 核心职责 |
|---|---|---|
| LLM | 大脑 | 决策与规划 |
| 上下文(Context) | 眼睛 | 观察与记忆 |
| 工具(Tools) | 手脚 | 感知与行动 |
Agent ↔ Environment(环境):Agent 与环境相互独立,通过观察和行动形成闭环。
重点理解: LLM 决定做什么,上下文决定能看到什么,工具决定能执行什么。环境是 Agent 的交互对象,不属于 Agent 内部。
二、Agent 的三大核心组件
1. 工具(Tools)
工具决定 Agent 能够执行哪些操作。
| 工具类型 | 作用 | 示例 |
|---|---|---|
| 感知工具 | 获取信息 | 搜索、数据库查询 |
| 执行工具 | 改变环境 | 代码执行、文件操作 |
| 协作工具 | 与其他 Agent 或人协作 | 子 Agent、人工确认 |
| 事件触发工具 | 被外部事件激活 | Webhook、定时任务 |
| 用户沟通工具 | 向用户传递信息 | 邮件、消息、语音 |
工具设计原则: 普通任务优先使用简单工具;复杂探索使用通用工具;支付、删除、部署等高风险操作使用权限受限的专用工具。
2. LLM(决策核心)
LLM 的职责是理解任务、制定计划、选择工具及参数、判断是否继续执行。
要区分两个概念:
- 模型负责决定如何调用工具。
- Harness 或 API 基础设施负责实际执行工具。
模型通过强化学习可以获得更强的工具调用决策能力,但工具的真实执行机制并不会因此进入模型参数。
3. 上下文(Context)
上下文包含五个部分:
| 组成 | 作用 |
|---|---|
| System Prompt | 身份、规则、权限 |
| Tool Definitions | 可用工具及参数 |
| User Messages | 用户需求与外部知识 |
| Assistant Messages | 历史回复、决策与调用 |
| Tool Results | 工具执行后的反馈 |
核心公式:
text
Context = Static Prefix + Trajectory- 静态前缀(Static Prefix): 系统提示词 + 工具定义。
- 动态轨迹(Trajectory): 用户消息 + 模型回复 + 工具结果。
重点: 给出了回答不代表完成了任务。缺少工具结果时,模型可能产生看似正确却没有事实依据的答案。
三、ReAct:Agent 的核心运行机制
ReAct = Reasoning + Acting,其本质是不断重复思考、行动和观察,直到完成任务。
text
用户提出任务
    ↓
Thought:思考(理解任务,决定下一步)
    ↓
Action:行动(选择并调用工具)
    ↓
Observation:观察(获取结果并更新轨迹)
    ↓
任务完成了吗?
    ├─ 否 → 返回 Thought,继续循环
    └─ 是 → 输出最终结果
最简伪代码
以下是说明机制的 Python 风格伪代码,并非可直接运行的 SDK 示例。
python
trajectory = [user_request]

while True:
    context = stable_prefix + trajectory

    decision = Model(context)
    trajectory.append(decision)

    if not decision.tool_calls:
        return decision.answer

    for call in decision.tool_calls:
        validated = Harness.validate(call)
        result = Environment.execute(validated)
        trajectory.append(result)
必须记住: 模型决策 → 框架校验 → 环境执行 → 结果回传 → 模型继续决策。
四、Harness 工程(本课重点)
Harness 是 Agent 内部、模型之外的运行与治理层,负责让模型可靠地执行任务。
Agent = Model + Harness
Harness 的五要素
| 要素 | 作用 |
|---|---|
| Context(上下文管理) | 组织任务、历史、知识和状态 |
| Tools(工具接口) | 提供清晰、可组合的观察与行动能力 |
| Constrain(约束) | 限制权限,阻止不允许的行动 |
| Verify(验证) | 检查工具调用及执行结果是否正确 |
| Correct(纠正) | 通过重试、回滚、熔断、人工接管恢复错误 |
关键区别:
- Context + Tools: 让 Agent 能做事。
- Constrain + Verify + Correct: 让 Agent 可靠地做事。
Harness 不包含环境自身的数据和状态。例如,沙箱的权限机制属于 Harness,沙箱内被操作的文件属于 Environment。
工程范式演进
| 阶段 | 核心关注点 |
|---|---|
| Prompt Engineering | 如何编写指令 |
| Context Engineering | 模型能看到什么 |
| Harness Engineering | 如何可靠运行 |
| Loop Engineering | 如何持续自主执行 |
| Graph Engineering | 如何组织多个循环与流程 |
这些阶段不是简单替代,而是逐步扩展工程范围。
五、Workflow 与自主 Agent
这是架构选型中需要重点区分的内容。
| 对比 | Workflow | 自主 Agent |
|---|---|---|
| 执行路径 | 预先定义 | 动态生成 |
| 决策主体 | 程序控制流程 | LLM 决定下一步 |
| 灵活性 | 相对较低 | 相对较高 |
| 控制性 | 路径容易约束 | 需要额外护栏 |
| 适用场景 | 固定业务流程 | 开放式复杂任务 |
选择原则:
- 单次 LLM 调用: 解决简单任务。
- Workflow: 解决固定、可拆解的多步骤任务。
- Autonomous Agent: 解决需要动态决策、探索和调整路径的任务。
实践中可以混合两种模式:确定性流程保证业务约束,自主 Agent 负责灵活处理不确定任务。
六、Agent 安全与护栏
课程将安全护栏分为三个层次:
| 层次 | 核心问题 | 防御措施 |
|---|---|---|
| 上下文层 | 模型能看到什么? | 提示注入检测、输入过滤 |
| 执行层 | 模型能做什么? | 工具权限、沙箱、人工审批 |
| 数据层 | 数据最终能如何改变? | 数据库权限、行级安全、约束 |
需要理解的三个重要结论:
- 单纯依赖 Prompt 不能保证安全。
- 高风险操作应在模型上下文之外进行独立验证。
- 安全评估既要检查危险请求是否被拦截,也要检查合法请求是否被误拒绝。
当 Agent 重复失败或需要执行付款、删除等高风险操作时,应触发人工干预。
七、必须掌握的五个设计模式
| 模式 | 核心思想 |
|---|---|
| 提议者---审核者(Proposer-Reviewer) | 生成与审核相互独立 |
| 渐进式披露(Progressive Disclosure) | 先提供目录,按需加载细节 |
| 只增不改(Append-only) | 追加状态,便于审计和回放 |
| 边界集 + 保留集(Boundary Set + Retention Set) | 同时测试预期变化与不应变化的部分 |
| 最小 diff + 可回滚 | 修改尽量小,可定位、可撤销 |
这五个模式贯穿知识更新、工具调用、Agent 评估和系统演进等多个环节。
一句话总结整门课
Agent 通过 LLM 决策、上下文感知和工具执行形成 ReAct 闭环,再利用 Harness 的约束、验证与纠正机制,将模型能力转化为可靠的任务执行能力。
实验 1-1 结果分析(2026-09-16 · doubao)
对应一次已通过验收的真实运行:
python run_experiment_1_1.py --provider doubao证据目录:
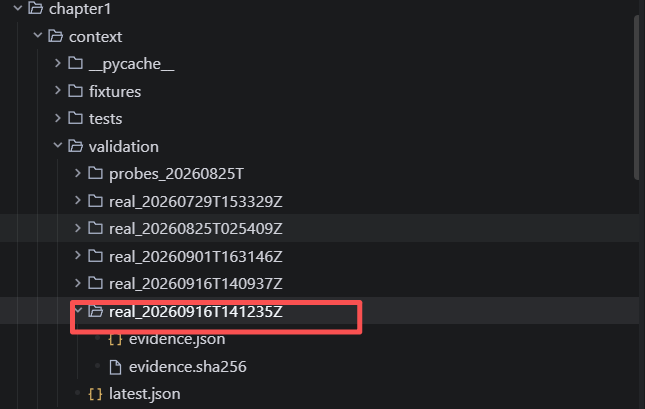
validation/real_20260916T141235Z/(已采纳,覆盖validation/latest.json)
1. 运行概览
| 项目 | 值 |
|---|---|
| 命令 | run_experiment_1_1.py --provider doubao --model deepseek-v4-flash --task guarded --hidden-result empty --modes full no_history no_reasoning no_tool_calls no_tool_results --max-iterations 5 |
| 运行时刻 | 2026-09-16 22:12--22:15(本地时间,UTC+8) |
| 提供商 | doubao(火山引擎方舟 Ark,北京区域) |
| 实际模型 | deepseek-v4-flash(因 .env 中 MODEL_NAME 覆盖了豆包默认模型) |
| 实际端点 | https://ark.cn-beijing.volces.com/api/coding/v3(编码计划端点,该端点恰好托管 deepseek-v4-flash,故请求成功) |
| 任务 | 季度营收换汇汇总(guarded 版本,含约束句「不要自行估计汇率,请使用工具观测」) |
| 标准答案 | 年度总计 9,602,895.73 USD;季度均值 2,400,723.93 USD |
| Token 用量 | prompt 20,311 / completion 10,508 / 总计 30,819(其中 reasoning 7,282) |
验收门全部通过:五组齐全 ✓ · 上下文契约 ✓ · 真实 API 证据(非 OpenRouter 兜底)✓ · 实验执行采纳 ✓
2. 结果总表
| 实验组 | outcome | 完成 | 数值正确 | 迭代 | 工具动作 | 重复调用 | 触顶 | 最终回答 |
|---|---|---|---|---|---|---|---|---|
| full | correct |
✓ | ✓ | 3 | 4 | 否 | 否 | 年度总计 9,602,895.73;季度均值 2,400,723.93 |
| no_history | no_terminal_response |
✗ | --- | 5(触顶) | 16 | 是 | 是 | (无) |
| no_reasoning | correct |
✓ | ✓ | 3 | 4 | 否 | 否 | 与 full 相同的两个数字 |
| no_tool_calls | no_unsupported_numbers |
✓ | ✗ | 1 | 0 | 否 | 否 | 明确拒绝:「没有换汇工具观测,无法给出数字」 |
| no_tool_results | no_terminal_response |
✗ | --- | 5(触顶) | 9 | 是 | 是 | (无) |
3. 各组轨迹详解
full(基线)--- 11.9 秒,教科书式执行
- 第 1 轮 :推理「Q1 已是 USD,需换 Q2/Q3/Q4」,并行 发起 3 次
convert_currency(210 万 EUR、180 万 GBP、3.8 亿 JPY → USD)。 - 第 2 轮 :拿到三个换汇结果(2,282,608.70 / 2,278,481.01 / 2,541,806.02),改用
code_interpreter精确求和与均值。 - 第 3 轮:给出终止回答,两个数字与标准答案完全一致。
要点:3 轮迭代、4 次工具动作、零重复------换汇和计算分工明确,这就是完整上下文的效率。
no_history(移除历史消息)--- 触顶失败
模型每轮都「失忆」,只看到系统提示词和任务,看不到自己刚做过什么。于是反复重新换汇:5 轮里发出 16 次工具动作 (full 组的 4 倍),且判定存在重复调用。到第 5 轮上限仍未收敛,没有给出任何回答。
要点 :历史上下文的作用不是「记得说过什么」,而是避免重复劳动。砍掉它,Agent 变成西西弗斯。
no_reasoning(剥离历史中的思考过程)--- 与基线无差异
同样 3 轮、4 次工具、答案正确。原因写在验收说明里:该组只是不把之前的 思考写回历史,模型每轮仍在重新推理;当每一步都由上一步的观测决定时,携带旧推理本来就没必要。
要点 :实测测不出退化 ------正文已不再宣称「去掉 reasoning 必然退化」。这是本次运行中唯一为 false 的正文行为断言(without_reasoning_degraded: false)。
no_tool_calls(移除工具定义)--- 有价值的拒绝
请求里没有 tools 参数,模型从构造上就不可能发出工具调用(这是验收说明标注的「构造性必然」)。真正可观察的是它转而做了什么:第 1 轮就声明「会话中没有换汇工具观测,无法给出数字」------没有编造汇率,没有假装计算。
要点 :本次 outcome 是 no_unsupported_numbers(未声称任何未被给予的数字),属于「诚实拒绝」。同一模型在 --task unguarded(去掉约束句)下可能改用记忆汇率拼出貌似完整的答案------那才是危险情况(README 实测出现过相差 0.16% 的自编汇率)。
no_tool_results(隐藏工具执行结果)--- 盲目执行的典型
工具消息按标准方式(--hidden-result empty)以空内容发出:消息还在,观测没了。模型陷入「发了调用却什么都没收到」的状态:5 轮发出 9 次工具动作 ,包括 README 描述的试探行为(用 1 EUR→USD、100 USD→EUR 这类测试值反推工具是否正常),始终没有收敛,触顶无答案。
要点 :没有反馈的 Agent 不是变慢,是变盲------而且它自己意识不到。
4. 正文行为断言核对
analysis.manuscript_behavior_claims(书中 §实验 1.1 的行为结论 vs 本次实测):
| 断言 | 实测 |
|---|---|
| full 基线正确 | ✓ true |
| 移除工具定义后无工具行动 | ✓ true |
| 移除工具结果后重复行动 | ✓ true |
| 移除历史后重复行动 | ✓ true |
| 移除推理后退化 | ✗ false(未复现) |
| 全部断言均被观察到 | false |
对「根本没到提供商」的组断言记
null而非true,防止失败请求白白满足否定式结论。
5. 结果语义速查
| outcome | 含义 |
|---|---|
correct |
有终止回答且数值符合评分标准 |
no_unsupported_numbers |
有终止回答,未声称任何未被给予的数字(含诚实拒绝) |
unsupported_numbers |
报出了任务与观测中都不存在的数字(最危险,本次五组均未出现) |
incorrect |
有观测依据但答案错误 |
no_terminal_response |
触顶或报错,没有终止回答 |
注意三层指标是独立的:completed(返回了终止回答)≠ task_success(数值正确)≠ 可依据性(数字来自观测而非记忆)。
6. 产物与复现
chapter1/context/validation/
├── latest.json                  # 本次运行已覆盖此文件(正式引用的证据)
└── real_20260916T141235Z/
    ├── evidence.json            # 完整轨迹:每轮无凭据请求/响应 + 分析(约 245 KB)
    └── evidence.sha256          # 证据完整性校验
复现命令:
powershell
cd chapter1\context
python run_experiment_1_1.py --provider doubao            # 全五组
python run_experiment_1_1.py --provider doubao --modes full no_tool_results   # 任选子集
实验结果图
实验 1-2 结果分析2026-09-16 · Kimi K3 联网搜索)
对应一次真实运行:
python main.py "比特币现价"(ReAct 循环完整走通)项目:
chapter1/web-search-agent/· 模型:kimi-k3· 后端:Moonshot 官方 API
1. 运行概览
| 项目 | 值 |
|---|---|
| 实际生效的问题 | 比特币现价 max -steps 3 --output result.json(见 §5 命令解析说明) |
| 提供商 | kimi(Moonshot,https://api.moonshot.cn/v1) |
| 模型 | kimi-k3(reasoning_effort=max 推理模型) |
| ReAct 上限 | 5 轮(默认值;--max-steps 3 未生效,见 §5) |
| 实际迭代 | 2 轮收敛 |
| 工具调用 | 1 次 $web_search(classes=finance) |
| 耗时 | 迭代 1 约 8.4s + 迭代 2 约 20s ≈ 29 秒 |
| 最终答案 | JSON 格式,BTC ≈ **75,891.12**(双源交叉区间 75,846--75,891) |
实验意义 :这是实验 1-2 的核心演示------模型即 Agent。没有本地编排框架,搜索工具是 Kimi 托管的原生能力,ReAct(想→做→看)循环由模型自己驱动。
2. ReAct 轨迹逐步解读
迭代 1:思考 → 搜索
- 💭 思考 :模型先解析了畸形的输入------识别出核心需求是「查比特币现价」,并把尾巴
max -steps 3 --output result.json正确判断为「用户粘贴的 CLI 命令」,决定主答现价、附带说明无法写本地文件但可给 JSON。这是意图理解能力的直接体现。 - 🔧 行动 :调用内置工具
web_search,参数{"query": "bitcoin price USD now live BTC current price", "classes": ["finance"]}------注意两点:- 问题用中文,搜索词自动译成了英文金融语料习惯的表达式;
classes: ["finance"]是模型主动选了垂直领域搜索通道,不是框架传的。
- 👀 观察 :返回
----MOONSHOT ENCRYPTED BEGIN----...的加密搜索结果块 。这是 Moonshot Formula API 的设计:搜索内容以密文形式下发,本地不可读也无需读 ,框架职责只是把这块密文原样拼回下一轮请求------解密发生在 Moonshot 服务端。
迭代 2:综合 → 终止
- 💭 思考 :模型已能看到解密后的内容,发现 CoinMarketCap(75,846.37)与 CoinGecko(75,891.12)报价不一致,主动决定:给区间而不是假装精确。信息已充足,不再继续搜索。
- ✅ 最终答案:自组织成合法 JSON------单价、近似值、双源区间、来源列表、波动提示一应俱全,且用中文写 note(跟随用户语言)。
循环为什么在第 2 轮停下?
第 1 轮观察已包含充分的价格数据 → 模型判定 信息充足? = 是 → 直接综合作答,只用了 1 次搜索。对照 README 的架构图:这是 ReAct 循环里「F →|是| I」这条边的真实发生。
3. 本次运行的三个亮点
- 畸形输入的鲁棒处理:CLI 参数被拼进问题后,模型没有报错或困惑,而是推理出「这是命令行参数,核心需求是查价」,并按暗示输出了 JSON------上下文理解挽救了一次错误调用。
- 交叉验证的诚实性 :面对两个来源的价差,答案是「区间 + 70 美分差异说明」而非随机挑一个------这正是书中强调的不编造精确性。
- 工具选择的自主性:英文查询式、finance 频道、一次搜完------全部是模型在思考块里自己决定的,本地代码只做转发。
4. 与实验 1-1 的对照(值得放进读书笔记)
| 实验 1-1(context) | 实验 1-2(web-search-agent) | |
|---|---|---|
| 工具形态 | 本地 Python 函数(换汇/计算器/代码执行) | 模型厂商托管的内置搜索 |
| 循环驱动 | 本地 harness 组装上下文、执行工具 | 模型原生驱动 ReAct,「模型即 Agent」 |
| 消融空间 | 五种上下文组件可拆 | 工具不可拆(OpenRouter 兜底下直接消失) |
| 观测返回 | 明文 JSON | 加密块(服务端解密,本地不读) |
1-1 教你理解 Agent 的骨骼,1-2 展示骨骼可以长在模型体内。
5. 命令解析问题(重要:本次的坑)
实际输入:
powershell
python main.py "比特币现价" -- max -steps 5 --output result.json 6. 复现与延伸
powershell
cd chapter1\web-search-agent

# 本次实验(联网,需 MOONSHOT_API_KEY)
python main.py "比特币现价" --max-steps 5--output result.json

# 零成本看 ReAct 形态(离线回放,不调 API)
python main.py --provider offline-demo

# 交互模式连续提问
python main.py
注意 :若观察到只有 {"search_result": {"search_id": "..."}} 而无内容块,是 Kimi 联网搜索服务维护中的信号(README §服务状态),与本地实现无关,稍后重试即可。本次日志中的完整加密块说明当时服务正常。
7. 产物
本次运行未产生本地文件(--output 未生效)。轨迹只在控制台实时打印;如需落盘,用上面修正后的命令重跑,result.json 会包含问题、完整 ReAct 轨迹与最终答案。
8. 补充轨迹:离线演示模式(2026-09-16 · 零成本)
命令:
python main.py --provider offline-demo· 不调用任何 API,回放内置示例轨迹
运行概览
| 项目 | 值 |
|---|---|
| 问题 | Moonshot AI 的 Context Caching 是什么技术? |
| 迭代 | 3 步(2 次搜索 + 1 次作答) |
| 成本 | 0 (无 API 调用,轨迹硬编码在 agent.py 的 run_offline_demo() 中) |
轨迹与教学点
| 步骤 | 内容 | 教学点 |
|---|---|---|
| 💭1 🔧1 | 判断需要先搜官方定义 → web_search("Moonshot AI Context Caching 是什么") |
先定义后细节的搜索规划 |
| 👀1 💭2 | 拿到定义后,评估「还缺适用场景」→ 决定再搜一次 | ReAct 的自评估:信息充足与否由模型判断,不是固定轮数 |
| 🔧2 👀2 | web_search("Context Caching 适用场景 计费") |
迭代搜索的价值------第二问的方向由第一问的结果决定 |
| ✅3 | 综合两次观测作答,并明确标注「本段来自离线示例轨迹,非真实搜索结果」 | 诚实标注信息来源(示范了答案应有的可依据性声明) |
两个值得注意的联系
- 多轮搜索的必要性:如果第 1 轮就把「定义 + 场景 + 计费」塞进一个 query,结果会又浅又散。演示轨迹展示的正是实验 1-2 要讲的「Agent 自主决定搜几次、搜什么」。
- 呼应实验 1-1:演示问题里的 Context Caching 正是 Kimi 提供商的降本特性(1-1 的 README 提到 Kimi「上下文缓存以优化成本」)。长系统提示 + 多轮工具调用正是缓存命中的典型场景------跑消融实验时重复发送的前缀就是靠它省钱的。
与真实运行的区别
离线模式的思考、行动、观察全部是预设文本,仅用于展示「想→做→看」的形态;真实运行的噪声(加密块、来源价差、模型自由措辞)在这里都看不到。学习顺序应是:先看离线版理解循环结构,再看 §2 的真实版理解实际行为。
实验 1-3 运行记录:东盟首都最近对(2026-09-16 · DashScope)
命令:
python main.py --backend dashscope --mode single --request "东盟 10 国首都之间最近的一对 哪两个?请搜索并用 Python 计算" --output result.json后端:阿里云百炼 DashScope Responses API · 模型:
qwen3.7-plus(托管web_search+code_interpreter)
1. 运行概览
| 项目 | 值 |
|---|---|
| 状态 | success: true,response completed(id resp_aea480f7...) |
| 模型 / 协议 | qwen3.7-plus,/responses 协议,stream: true,tool_choice: auto |
| 声明的工具 | [{"type": "web_search"}, {"type": "code_interpreter"}] |
| Token 用量 | 输入 26,136(其中缓存命中 10,880)/ 输出 2,671 / 总计 28,807 |
| 工具实际执行 | web_search × 2,code_interpreter × 1 (计费回执 x_details.plugins 记录) |
| 最终结论 | 吉隆坡 ↔ 新加坡,316.5 km |
2. 输出条目序列(result.json 的 output_items,共 9 项)
| # | 类型 | 内容 |
|---|---|---|
| 0 | reasoning |
思考:需要先查东盟 10 国首都列表 |
| 1 | web_search_call |
搜索①:东盟首都清单(来源如 scribd 的国家资料页等) |
| 2 | reasoning |
思考:还缺精确经纬度 |
| 3 | web_search_call |
搜索②:逐国坐标查询(来源如 geodatos.net、latitude.to 等坐标站) |
| 4 | reasoning |
思考:坐标齐全,该算距离了 |
| 5 | message |
过渡陈述:「现在我已收集到所有东盟 10 国首都的经纬度坐标...」 |
| 6 | code_interpreter_call |
托管执行① :Haversine 全配对计算,status: completed |
| 7 | reasoning |
思考:整理排名与解读 |
| 8 | message |
最终答案(含排名表、坐标来源表、地理解读) |
要点 :两次搜索的目标不同(先定性列表、后定量坐标),第二次搜索的方向由第一次结果决定------这是模型自主的 Deep Research 闭环,本地代码只负责发请求和收条目。
3. 托管代码执行回执(item6)
沙箱内实际运行的 Python(节选):
python
import math
from itertools import combinations

# ASEAN 10 capitals with coordinates (lat, lon)
capitals = {
    "Bandar Seri Begawan (Brunei)": (4.89035, 114.94006),
    "Phnom Penh (Cambodia)": (11.5564, 104.9282),
    ...
}
# → Haversine 枚举全部 45 对,输出最近的前 10 对执行输出(outputs: [{type: "logs", ...}]):「东盟 10 国首都间距离排名(最近的前 10 对)」,第 1 名吉隆坡---新加坡。
这正是验收强调的工具回执 :不是模型「说它用了 Python」,而是服务端返回了真实的 code_interpreter_call 条目(含 container id、代码、执行日志)。
4. 最终答案(控制台输出)
最近的前 10 对首都(Haversine 大圆距离):
| 排名 | 首都对 | 距离 |
|---|---|---|
| 1 | 吉隆坡 ↔ 新加坡 | 316.5 km |
| 2 | 万象 ↔ 河内 | 478.2 km |
| 3 | 万象 ↔ 曼谷 | 519.9 km |
| 4 | 金边 ↔ 曼谷 | 539.5 km |
| 5 | 万象 ↔ 内比都 | 708.9 km |
| 6 | 金边 ↔ 万象 | 755.4 km |
| 7 | 内比都 ↔ 曼谷 | 812.2 km |
| 8 | 雅加达 ↔ 新加坡 | 898.2 km |
| 9 | 曼谷 ↔ 河内 | 985.7 km |
| 10 | 金边 ↔ 吉隆坡 | 1001.6 km |
坐标来源表(10 国首都经纬度)与地理解读(中南半岛首都密集、岛国首都因海阻隔)见 result.json 最终 message。
与验收基准对照 :官方验收运行(2026-07-31)与本地独立参考值为 316.35 km,本次 316.5 km 属同一结论(差异来自坐标小数位与舍入),最近对判定完全一致。
5. result.json 结构速查
| 字段 | 含义 |
|---|---|
success / error |
本次调用是否成功 |
response |
最终回答全文 |
request |
实际发出的请求(model、instructions、tools、stream 等) |
raw_response |
提供商原始响应(含 id、usage、插件计费明细 x_details.plugins) |
output_items |
验收核心:带类型的输出条目序列(reasoning / web_search_call / code_interpreter_call / message) |
6. 备注
- 本次是
main.py --mode single的单场景体验 ,不是验收器(run_experiment_1_3.py)运行;未写验收证据目录,validation/latest.json未被改动。 - 缓存命中 10,880 token 说明百炼对重复前缀(系统提示词 + 工具定义)做了缓存计费------正是实验 1-2 离线演示里 Context Caching 机制的实际体现。
- 若要出正式验收记录,跑:
python run_experiment_1_3.py --backends dashscope --reasoning high(含东盟 + 比特币两场景与全部验收门)。
7. 控制台完整输出(原样记录)
text
(agentbook) D:\work\ai-agent-book-main\ai-agent-book-main\chapter1\search-codegen>python main.py --backend dashscope --mode single --request "东盟 10 国首都之间最近的一对  哪两个?请搜索并用 Python 计算" --output result.json

============================================================
📝 Response:
------------------------------------------------------------
现在我已收集到所有东盟 10 国首都的经纬度坐标,接下来用 Python 计算所有配对之间的距离。


## 东盟 10 国首都间最近的一对

### 📍 结论:**吉隆坡(马来西亚)** 与 **新加坡** 是距离最近的一对东盟首都,直线距离约 **316.5 公里**。

---

### 📊 最近的前 10 对首都(Haversine 大圆距离)

| 排名 | 首都对 | 距离 |
|:---:|:---|:---:|
| **1** | **🇲🇾 吉隆坡 ↔ 🇸🇬 新加坡** | **316.5 km** |
| 2 | 🇱🇦 万象 ↔ 🇻🇳 河内 | 478.2 km |
| 3 | 🇱🇦 万象 ↔ 🇹🇭 曼谷 | 519.9 km |
| 4 | 🇰🇭 金边 ↔ 🇹🇭 曼谷 | 539.5 km |
| 5 | 🇱🇦 万象 ↔ 🇲🇲 内比都 | 708.9 km |
| 6 | 🇰🇭 金边 ↔ 🇱🇦 万象 | 755.4 km |
| 7 | 🇲🇲 内比都 ↔ 🇹🇭 曼谷 | 812.2 km |
| 8 | 🇮🇩 雅加达 ↔ 🇸🇬 新加坡 | 898.2 km |
| 9 | 🇹🇭 曼谷 ↔ 🇻🇳 河内 | 985.7 km |
| 10 | 🇰🇭 金边 ↔ 🇲🇾 吉隆坡 | 1001.6 km |

---

### 🗺️ 使用的坐标数据来源

| 国家 | 首都 | 纬度 | 经度 |
|:---|:---|:---:|:---:|
| 🇧🇳 文莱 | 斯里巴加湾市 | 4.8904°N | 114.9401°E |
| 🇰🇭 柬埔寨 | 金边 | 11.5564°N | 104.9282°E |
| 🇮🇩 印尼 | 雅加达 | 6.2146°S | 106.8451°E |
| 🇱🇦 老挝 | 万象 | 17.9667°N | 102.6000°E |
| 🇲🇾 马来西亚 | 吉隆坡 | 3.1412°N | 101.6870°E |
| 🇲🇲 缅甸 | 内比都 | 19.7450°N | 96.1297°E |
| 🇵🇭 菲律宾 | 马尼拉 | 14.5958°N | 120.9772°E |
| 🇸🇬 新加坡 | 新加坡 | 1.2897°N | 103.8501°E |
| 🇹🇭 泰国 | 曼谷 | 13.7525°N | 100.4942°E |
| 🇻🇳 越南 | 河内 | 21.0285°N | 105.8048°E |

### 💡 解读

吉隆坡与新加坡同处马来半岛南端,地理上非常接近------现实中两地之间也有高速公路直通,车程约 4--5 小时。从排名可以看出,**中南半岛上的首都**(万象、曼谷、金边、河内、内比都)彼此 之间也相对较近,而岛国首都(雅加达、马尼拉、斯里巴加湾市)则因海洋阻隔,与其他首都的距离普遍较远。
------------------------------------------------------------
📊 Tokens - Input: 26136, Output: 2671, Reasoning: 778, Total: 28807
============================================================
💾 结果已保存到: result.json
8. 正式验收器运行记录(2026-09-16 22:15 前后 · 未通过)
命令:
python run_experiment_1_3.py --backends dashscope --reasoning high证据目录:
validation/runs/real_20260916T150905Z/· 全程静默约 6 分钟后一次性打印
控制台完整输出(原样记录)
text
(agentbook) D:\work\ai-agent-book-main\ai-agent-book-main\chapter1\search-codegen>python run_experiment_1_3.py --backends dashscope --reasoning high
{
  "policy": "multi-provider: acceptance is not gated on the official OpenAI account; any provider whose Responses API closes the hosted search + code-execution loop server-side is eligible",
  "eligible_acceptance_backends": [
    "openai",
    "dashscope"
  ],
  "eligible_backends_attempted": [
    "dashscope"
  ],
  "acceptance_backend": null,
  "per_backend": {
    "dashscope": {
      "started": true,
      "requested_model": "qwen3.7-plus",
      "asean_passed": false,
      "clarification_passed": true
    }
  },
  "openrouter_is_diagnostic_not_acceptance": false,
  "passed": false,
  "reference_docs": [
    "https://developers.openai.com/api/docs/guides/tools-web-search",
    "https://developers.openai.com/api/docs/guides/tools-code-interpreter",
    "https://help.aliyun.com/zh/model-studio/qwen-code-interpreter"
  ]
}
Evidence: validation\runs\real_20260916T150905Z\evidence.json
结果解读
| 项 | 值 | 说明 |
|---|---|---|
passed |
false | 总验收未通过,本次不会覆盖 validation/latest.json |
acceptance_backend |
null | 没有后端通过全部验收门,故无验收后端 |
asean_passed |
false | 东盟场景失败------原因是网络层超时,见下 |
clarification_passed |
true | 比特币场景的「先澄清后工具」顺序检查通过 |
东盟场景失败的确切原因 (evidence.json 中 runs[0].asean.error):
text
ConnectionError: HTTPSConnectionPool(host='dashscope.aliyuncs.com', port=443): Read timed out.即请求发往百炼后,在等待响应时读超时断开 ,连一条输出条目都没拿到(output_items: 0)------不是模型行为、工具回执或验收逻辑的问题,而是传输层波动。同一个端点在 §1-§7 的单场景运行中是成功的。
实验 1-4 工作流路线复跑记录(2026-09-16 · Kimi kimi-k3 + 通义万相 wan2.2-t2i-flash)
对应 README「三条路线的架构」中的工作流路线(workflow)。本次只跑通并复跑了这一条路线,
原生路线 A/B 未复跑,三路线对照结论仍以 README 记录的正式轮 20260821T040450Z 为准。
概述
- 目的 :用当前可用的两把 key(
KIMI_API_KEY+DASHSCOPE_API_KEY国内站)单独跑通
工作流路线:节点 1 提示词改写(kimi-k3)→ 节点 2 文生图(wan2.2-t2i-flash)。 - 结果 :正式复跑 run_id=
20260916T150506Z,5 句需求 5/5 全部成功。 - 为此做的代码改动 :配置校验从「无论跑哪条路线都要求 4 个 key 全部非空」改为
按路线最小化校验 (详见下文),否则缺GEMINI_API_KEY/OPENAI_API_KEY时连
--route workflow都无法启动。
代码与配置改动(本次为跑通所做的修改)
config.py:新增ROUTE_ENV映射(workflow→KIMI+DASHSCOPE,native→GEMINI,
native_gptimage→OPENAI);validate(routes)改为只校验所选路线需要的密钥。
不传routes时仍校验全部 4 个,required_env()未变,离线测试兼容。main.py:启动前把--route解析出的路线列表传给Config.validate(routes)。.env:DASHSCOPE_BASE_URL=https://dashscope.aliyuncs.com/api/v1
(国内站)。默认值是国际站dashscope-intl.aliyuncs.com,与本次国内站 key 不匹配。
模型与端点实录(本次)
- 改写节点 :Moonshot
kimi-k3(OpenAI 兼容接口,api.moonshot.cn/v1)。
不传temperature(该模型只允许默认值 1,显式传其他值被 400 拒绝,见 README 失败记录)。
本轮实测改写耗时约 10--60 s/次,usage 中可见reasoning_tokens(思考型输出)与
cached_tokens(命中 Context Cache)。 - 生图节点 :DashScope 国内站
wan2.2-t2i-flash,异步任务接口,三步:- 提交:
POST /services/aigc/text2image/image-synthesis(headerX-DashScope-Async: enable); - 轮询:
GET /tasks/{task_id}(每 5 s,实测单张约 10--30 s 完成); - 下载:
results[0].url。
- 提交:
- 与 20260821 正式轮的差异 :国际站 → 国内站端点(模型同名,端点不同)。
服务端二次扩写行为一致:轮询响应的results[0].actual_prompt仍会返回扩写后的提示词。
失败记录(过程留证,均保留)
- run_id=
20260916T145953Z(失败) :5 次运行全部在万相任务提交时
HTTP 401 InvalidApiKey------改写节点均成功,失败原因是代码默认国际站端点 + 国内站 key。
manifest 留证在validation/real_20260916T145953Z/;此轮无图片产物(改写留证只在
成功运行时落盘)。修复:.env启用国内站DASHSCOPE_BASE_URL。 - 一次空日志退出码 1 :在
.env编辑保存过程中启动进程,读到瞬时空值导致校验失败
退出(exit 1),无产物,配置稳定后直接重跑解决。教训:启动前确保.env已保存完整。
正式复跑结果(run_id=20260916T150506Z)
5 句需求 × 工作流路线,5/5 成功:
| 类别 | 需求 ID | 成图 |
|---|---|---|
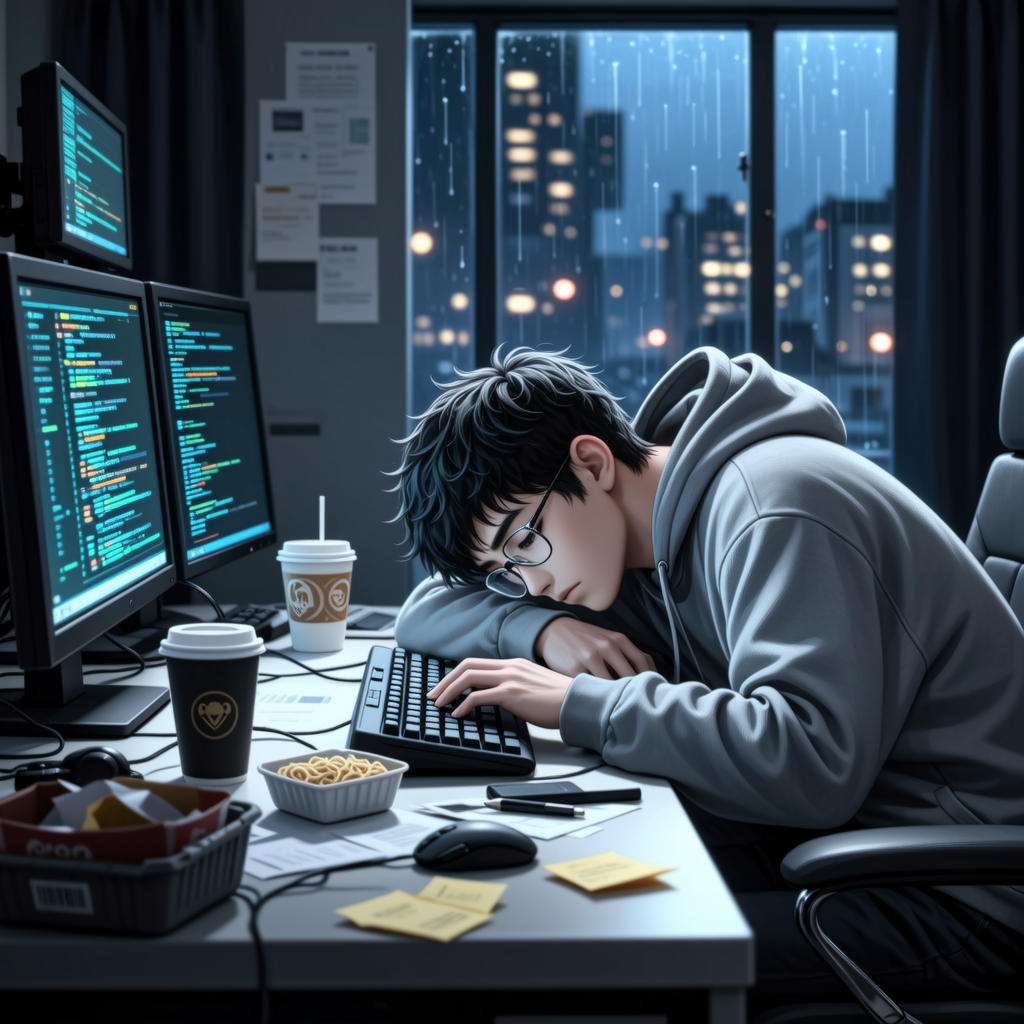
| 具体 | programmer-overtime |
outputs/20260916T150506Z/images/programmer-overtime_workflow.png |
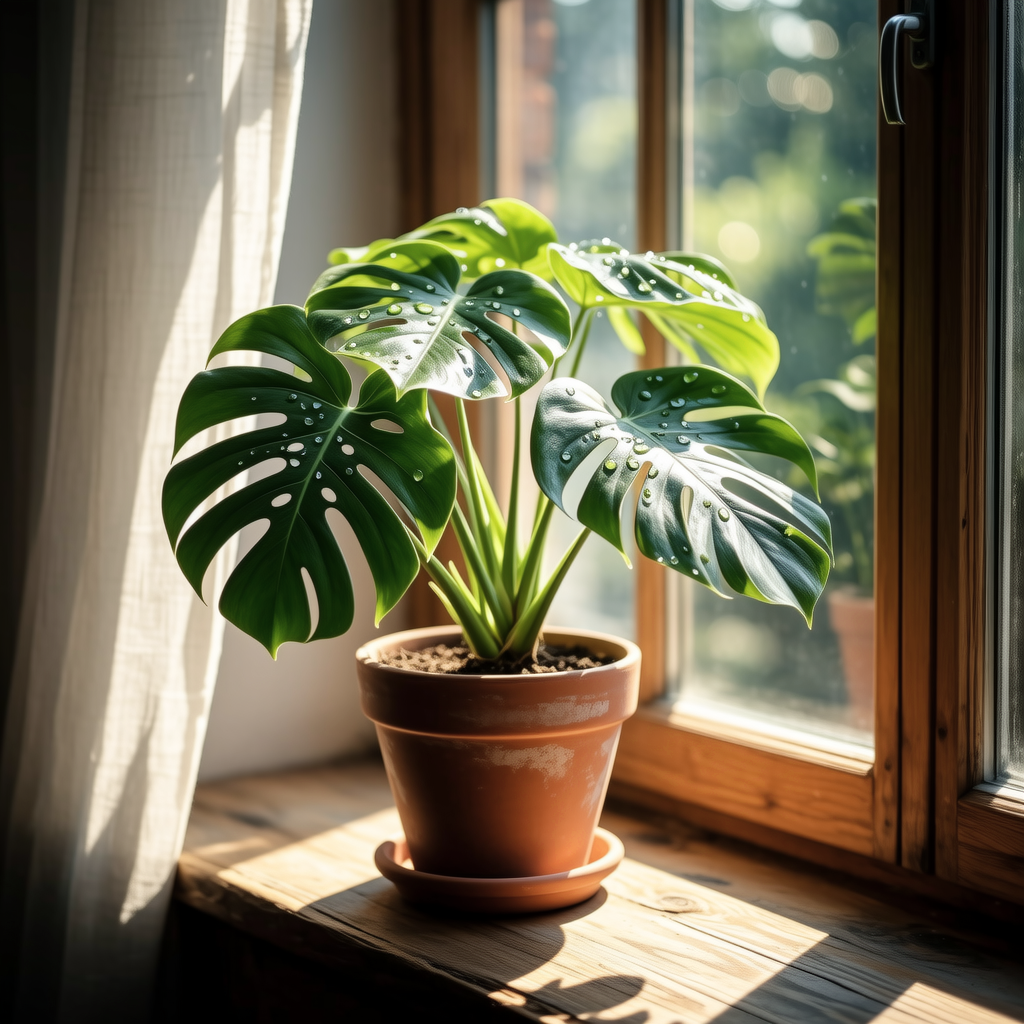
| 具体 | windowsill-plant |
outputs/20260916T150506Z/images/windowsill-plant_workflow.png |
| 具体 | headphone-poster |
outputs/20260916T150506Z/images/headphone-poster_workflow.png |
| 宽泛 | agi-programmer |
outputs/20260916T150506Z/images/agi-programmer_workflow.png |
| 宽泛 | future-city-morning |
outputs/20260916T150506Z/images/future-city-morning_workflow.png |
- manifest:
validation/real_20260916T150506Z/evidence.json
(sha256:7292a2b6e5b839f33d77a89e34790a433c69de68cc594810c9c8fdfeaca9111c),
validation/latest.json已同步更新为本次 manifest。
每次调用的留证(outputs/20260916T150506Z/calls/)
文件命名 {需求ID}_workflow_{节点}_{call_id}.json:
*_rewrite_*.json(1 条/需求):完整 system prompt、原始需求、raw_output
(含prompt/negative_prompt/style_notes)、response_id、usage、耗时。*_image_generate_*.json(3 条/需求):- submit:请求参数(prompt / negative_prompt / size)、
task_id; - poll:
task_status、usage、task_metrics(提交/调度/结束时间)、actual_prompt
(万相服务端对 prompt 的二次扩写,留证重点); - download:响应字节数。
- submit:请求参数(prompt / negative_prompt / size)、
改写行为实例(programmer-overtime)
kimi-k3 把「帮我画一个周末加班的程序员,风格丧一点」改写为(节选):
- prompt:
... weary young male programmer, messy hair, dark circles under eyes, ... empty dark office at night, weekend overtime, ... rain-streaked window, ... cold blue-grey tones, gloomy melancholic atmosphere, dead-inside expression ... - negative_prompt:
... smiling, happy expression, crowded office, daylight ... - style_notes 原文:把「周末加班」具象化为空无一人的深夜办公室、代码屏幕冷光、咖啡杯
泡面外卖盒等细节;用冷蓝灰色调、雨窗、城市光斑和生无可恋的表情落实「丧」的气质,
并在负面词中排除笑容、明快色彩和白天,避免画面变阳光。
与 20260821 轮的观察一致:改写做了翻译 (中文→英文 tag)、具象化 (丧→冷蓝光/
雨窗/死鱼眼式细节)、风格决策(负面词排除 bright cheerful colors / smiling 来保情绪)。
海报用例复现了「文案丢失」(headphone-poster)
本轮 kimi-k3 的 negative_prompt 同样包含 text, logo,style_notes 明言
「经典模型无法稳定生成中文文字,海报文案建议后期排版添加」------与 README 正式轮结论
吻合:适配层围绕旧模型短板的合理取舍,代价是原始需求里「主打这句文案」在改写环节
就被丢弃,成图中不会有文字。
复现命令
bash
cd chapter1/image-gen-workflow
pip install -r requirements.txt

python main.py --route workflow              # 全部 5 句需求,仅工作流路线
python main.py --requirement agi-programmer  # 只跑单句(可叠加 --route)
python -m pytest # 离线测试(不发真实请求)所需环境变量(工作流路线仅前两个):KIMI_API_KEY、DASHSCOPE_API_KEY(国内站 key,
配合 DASHSCOPE_BASE_URL=https://dashscope.aliyuncs.com/api/v1)。
生成图片如下所示: