note
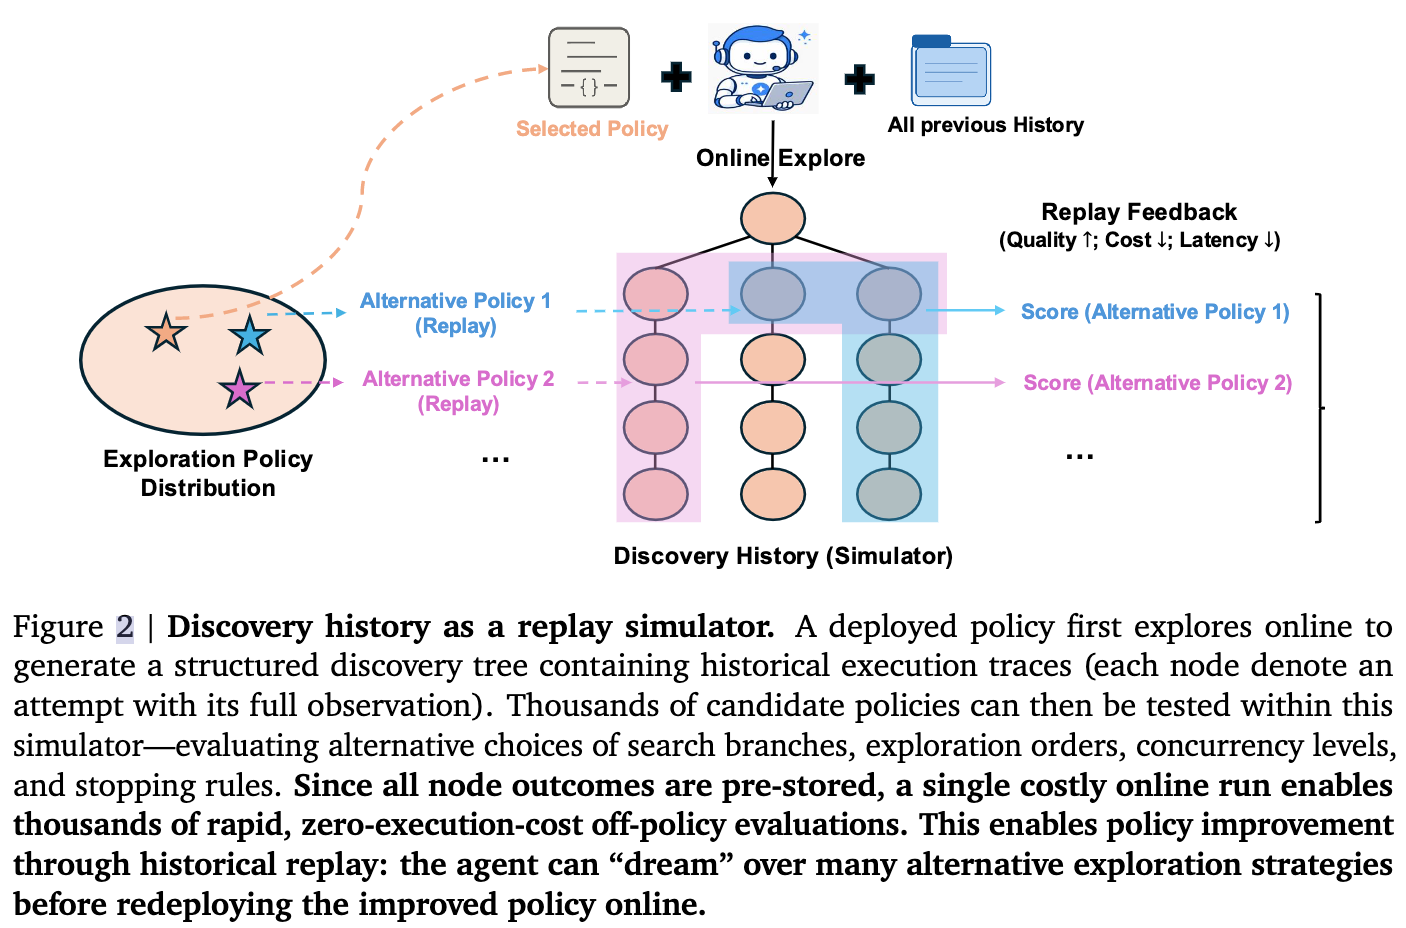
- 真实环境先探索出很多历史轨迹/分支 → 用这些历史树做低成本 replay → 比较"不同搜索策略"怎么走更有效 → 更新上层探索 policy → 再回到真实环境探索
文章目录
- note
- [一、Dream-RSI: Recursive Self-Improvement through Evolving Worlds](#一、Dream-RSI: Recursive Self-Improvement through Evolving Worlds)
- Reference
一、Dream-RSI: Recursive Self-Improvement through Evolving Worlds
Dream-RSI: Recursive Self-Improvement through Evolving Worlds
链接:https://arxiv.org/abs/2609.14858
项目:https://github.com/zhengkid/Dream-RSI
Motivation: 传统递归自我改进(RSI)中,固定探索策略难以随着搜索空间扩大持续适应;而在线优化探索策略,又需要让每个候选策略执行昂贵的长程探索,反馈延迟高、成本大,限制策略迭代效率。
解决方法: 不修改底层 Coding Agent 权重,而是优化上层的 exploration policy / orchestration strategy。核心是把历史真实探索形成的 discovery tree 直接作为 replay simulator,在已探索过的搜索空间内低成本回放、评估和改进候选探索策略;再将更优策略部署回真实环境继续探索,并用新产生的 discovery tree 扩充 simulator pool,形成递归自改进闭环。
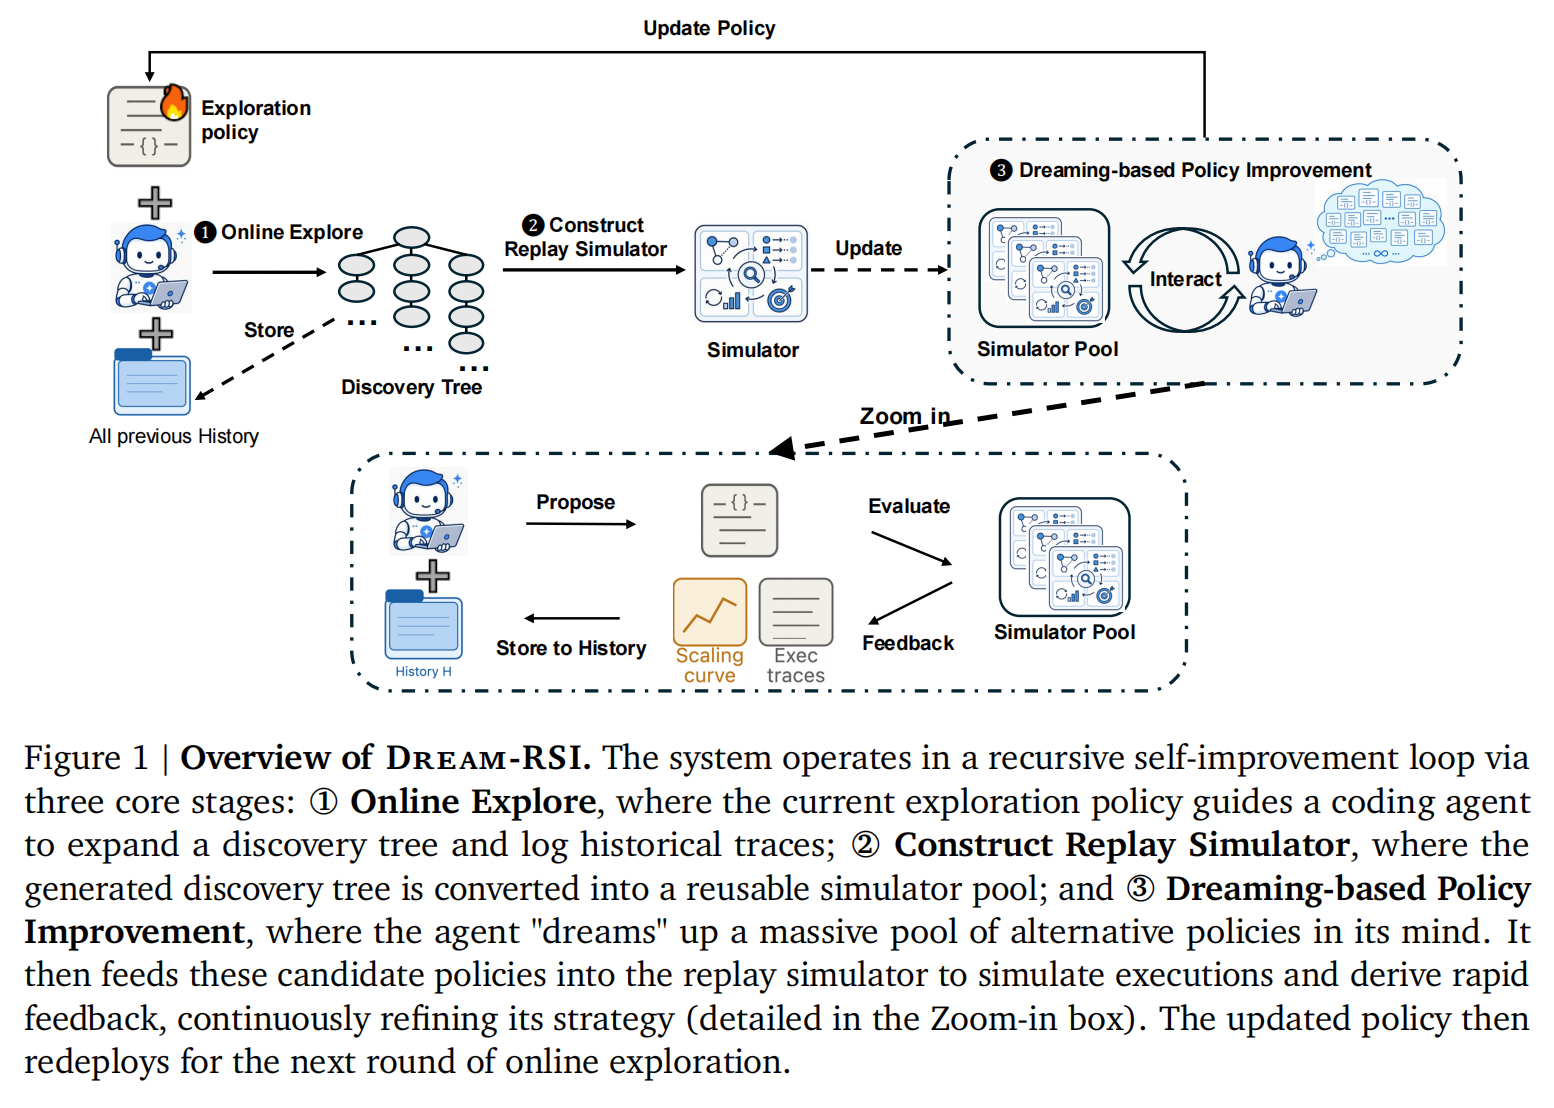
核心动作:
1)当前探索策略驱动 Agent 在真实环境中搜索,并记录完整 discovery tree;
2)在历史 discovery tree 上进行 "dreaming / replay",离线评估多个候选探索策略;
3)选择更优策略重新上线,用新的真实探索结果继续扩充 replay simulator,循环迭代。
结果: 在算法工程、数学优化和 GPU Kernel 工程任务上验证,整体在保持或提升 discovery quality 的同时显著降低探索成本;其中部分任务可大幅减少 discovery-agent calls / generations