一个二维码背后的系统设计:批次生成、绑定、扫码与数据统计怎么做?
在日常生活中,二维码无处不在------从商品溯源、活动签到到信息展示,它们像一个个数字入口,连接着线下场景与线上数据。但当业务规模扩大,一个简单的"生成-打印-扫描"流程,很快会演变为一个需要精细设计的系统。如何实现高效的批次生成?如何确保二维码与业务实体的可靠绑定?如何处理扫码请求并保证实时性?又如何从海量扫码数据中提取有价值的统计信息?
本文将深入探讨一个完整二维码系统的核心设计,涵盖从生成到数据分析的全流程。我们将引用行业标准、开源项目文档和分布式系统设计原则,为您提供一套经过验证的解决方案。
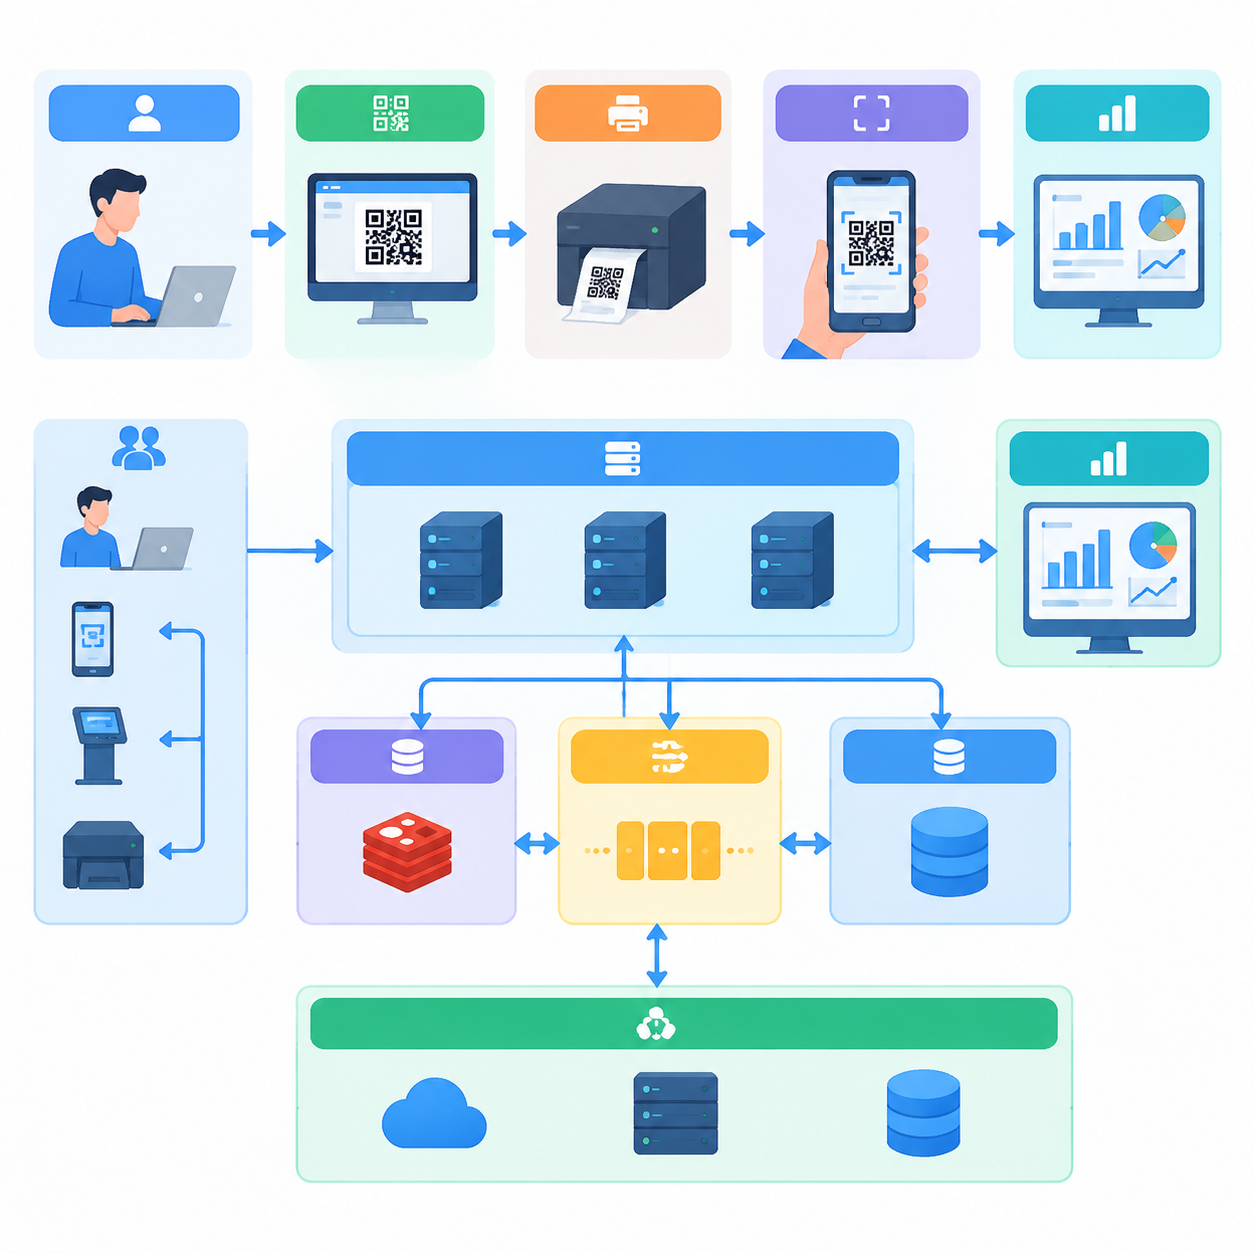
一、二维码批次生成设计
当需要为数万甚至数十万件商品或物料生成二维码时,单个生成的方式效率低下且难以管理。批次生成 是解决这一问题的关键。二维码技术遵循国际标准 ISO/IEC 180041,该标准定义了二维码的符号规范、数据编码和错误纠正机制,是所有生成库的实现基础。
1.1 生成策略
批次生成不是简单地在一个循环中调用生成函数。一个健壮的系统需要考虑:
- 内容编码策略:二维码可以编码URL、文本、结构化数据(如JSON)或仅包含一个唯一ID(推荐)。后者将信息存储在后端数据库中,二维码本身轻量,便于更新和管理。根据ISO/IEC 18004,二维码支持多种数据模式(数字、字母数字、字节/二进制、汉字),选择最优模式可以显著提高编码效率1。
- 格式与纠错级别:根据使用场景(如是否需要在破损情况下扫描)选择二维码版本和纠错级别(L、M、Q、H)。通常,M或Q级别提供了较好的平衡。纠错级别决定了二维码在部分遮挡或损坏时仍可被读取的能力,这是工业应用场景的关键考量1。
- 命名与编码规范 :为每个批次制定清晰的命名规则,如
批次ID-产品代码-序号,便于追溯和管理。 - 编码容量选择:二维码的最大数据容量取决于版本(1-40)和纠错级别。对于仅包含唯一ID的场景,使用低版本(如Version 1-5)即可,可减少扫描延迟。例如,Version 1(21x21模块)在纠错级别M下可容纳20个字节,足以存储一个唯一ID1。
1.2 技术实现
通常使用成熟的开源库(如ZXing、ZBar)或云服务API来生成二维码图片。
- 异步批量生成:对于大量生成,应采用异步任务队列(如使用Redis Queue、Celery)将生成任务解耦,避免阻塞主线程,并支持进度监控和失败重试。Celery是一个强大的分布式任务队列,支持多种消息代理,常用于异步任务处理2。
- 输出与存储 :生成的二维码图片可以:
- 打包下载:将整个批次的二维码图片打包成ZIP文件供用户下载。
- 持久化存储:上传至对象存储(如AWS S3、阿里云OSS),并在数据库中记录每个二维码的唯一ID、图片URL及元数据。对象存储提供了高可用、高扩展性的存储解决方案3。
- 生成优化 :
- 并行处理 :使用多线程/多进程并行生成,显著提升大批量生成速度。Python的
concurrent.futures模块或Java的ExecutorService可以方便地实现并行处理。 - 缓存模板:对于相同格式的二维码,可复用生成模板,减少重复计算。
- 压缩存储:使用WebP等现代格式存储二维码图片,在保证可扫描性的同时减少存储空间。WebP格式由Google开发,通常比PNG小26%,且支持透明度4。
- 并行处理 :使用多线程/多进程并行生成,显著提升大批量生成速度。Python的
1.3 数据模型设计
需要一个数据库表来管理批次和二维码元数据:
sql
CREATE TABLE batch (
    id BIGINT PRIMARY KEY,
    name VARCHAR(100),
    status VARCHAR(20), -- e.g., 'PENDING', 'PROCESSING', 'COMPLETED'
    created_at TIMESTAMP,
    total_count INT,
    description TEXT
);

CREATE TABLE qrcode (
    id BIGINT PRIMARY KEY,
    batch_id BIGINT REFERENCES batch(id),
    unique_code VARCHAR(64) UNIQUE, -- 二维码编码的核心ID
    payload TEXT, -- 编码的原始内容或URL
    image_url VARCHAR(512),
    entity_id VARCHAR(128), -- 绑定的业务实体ID(如商品ID)
    created_at TIMESTAMP,
    scanned_count INT DEFAULT 0
);扩展字段建议:
expires_at:二维码有效期max_scan_count:最大扫描次数限制qr_version:二维码版本号error_correction_level:纠错级别status:二维码状态(ACTIVE, DISABLED, EXPIRED)
数据库设计应遵循规范化原则,以减少数据冗余并提高一致性5。对于高并发读写场景,可以考虑读写分离和分库分表策略。
1.4 生成接口示例(Python)
python
import qrcode
from PIL import Image
import hashlib
import uuid
import asyncio
import aiohttp
from io import BytesIO

class QRCodeGenerator:
    def __init__(self, base_url: str):
        self.base_url = base_url

    def generate_unique_code(self, batch_id: int, index: int) -> str:
        """生成唯一二维码编码"""
        raw = f"{batch_id}-{index}-{uuid.uuid4().hex[:8]}"
        return hashlib.sha256(raw.encode()).hexdigest()[:16].upper()

    async def generate_single(self, unique_code: str) -> bytes:
        """异步生成单个二维码"""
        url = f"{self.base_url}/qr/{unique_code}"

        qr = qrcode.QRCode(
            version=1,
            error_correction=qrcode.constants.ERROR_CORRECT_M,
            box_size=10,
            border=4,
        )
        qr.add_data(url)
        qr.make(fit=True)

        img = qr.make_image(fill_color="black", back_color="white")

        # 转换为字节
        buffer = BytesIO()
        img.save(buffer, format="PNG")
        return buffer.getvalue()

    async def generate_batch(self, batch_id: int, count: int, concurrency: int = 10):
        """批量生成二维码"""
        semaphore = asyncio.Semaphore(concurrency)

        async def generate_with_semaphore(index):
            async with semaphore:
                unique_code = self.generate_unique_code(batch_id, index)
                image_data = await self.generate_single(unique_code)
                return unique_code, image_data

        # 并发生成
        tasks = [generate_with_semaphore(i) for i in range(count)]
        results = await asyncio.gather(*tasks)

return results上述代码使用了Python的qrcode库6,该库是生成二维码的流行开源工具,遵循ISO/IEC 18004标准。
二、二维码绑定机制
"绑定"是指将二维码与特定的业务实体(如一件商品、一个设备、一个展位)建立关联的过程。这是二维码从"图片"变为"业务入口"的关键一步。
2.1 绑定方式
- 静态绑定:在二维码生成时就确定了其指向的实体ID(如商品SN码)。适用于一对一且不变的场景。
- 动态绑定 :二维码生成时只包含唯一ID,绑定关系在后端数据库中动态建立或修改。这种方式更灵活,支持"先扫码,后绑定"或"一码多用"等场景。推荐采用动态绑定,因为它提供了更大的灵活性和可维护性7。
- 批量绑定:支持通过Excel导入或API批量绑定多个二维码与实体的关系,提高运营效率。
2.2 绑定流程
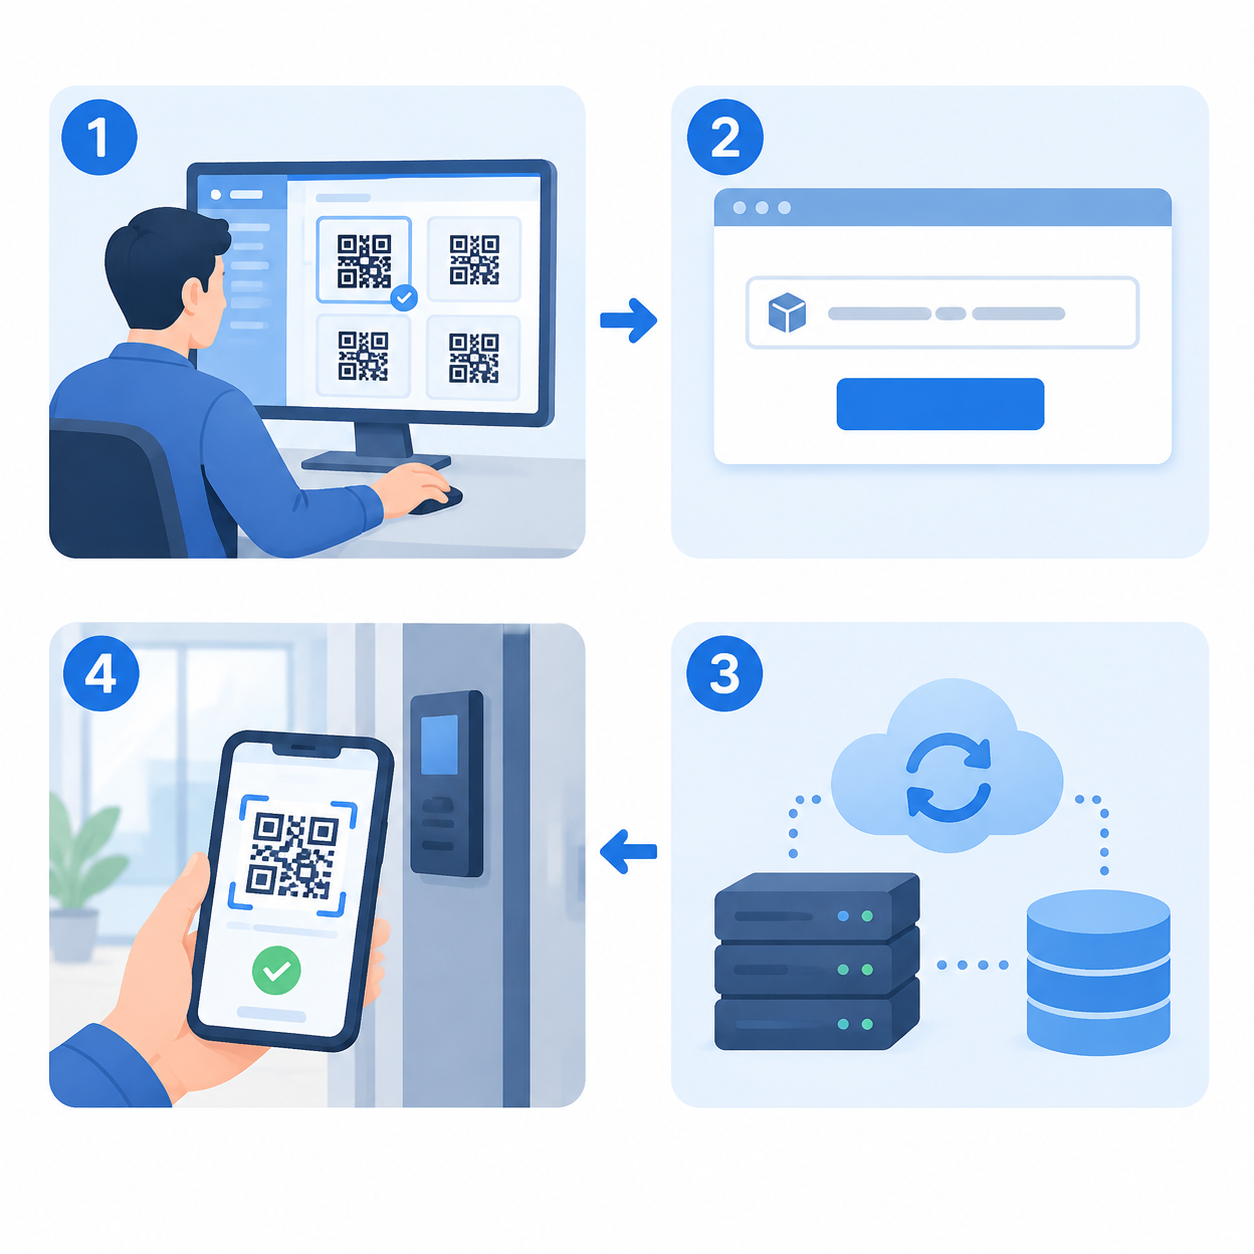
典型的绑定流程(以商品为例):
- 管理员通过后台系统,选择一个批次的二维码。
- 输入要绑定的商品ID(或通过其他方式关联)。
- 系统在后台更新
qrcode表,设置对应的entity_id。 - 此后,任何人扫描该二维码,系统即可根据
unique_code找到对应的entity_id,并展示商品详情。
2.3 绑定关系存储设计
绑定关系可能需要额外信息,建议使用独立的关系表:
sql
CREATE TABLE qr_entity_binding (
    id BIGINT PRIMARY KEY,
    qr_id BIGINT REFERENCES qrcode(id),
    entity_type VARCHAR(50), -- 'product', 'device', 'booth', etc.
    entity_id VARCHAR(128),
    bound_at TIMESTAMP,
    bound_by VARCHAR(100), -- 操作人
    metadata JSON, -- 附加信息
    UNIQUE (qr_id, entity_type) -- 一个二维码只能绑定一种类型的实体
);使用JSON字段存储元数据是现代数据库的常见做法,它提供了灵活性,同时避免了过多的列5。
2.4 扫码解耦设计
扫描请求不应直接跳转到最终业务页面。一个推荐的设计是:
用户扫码 -> 访问统一入口URL -> 后端根据URL中的唯一ID查询绑定关系 -> 根据业务规则跳转至详情页或执行操作
这个过程允许在跳转前进行权限验证、记录扫码日志、实现AB测试等。这种模式类似于Web应用中的**控制器(Controller)**层,负责协调业务逻辑7。
示例跳转逻辑:
python
@app.get('/qr/{unique_code}')
async def handle_qr_scan(unique_code: str, request: Request):
    # 1. 查询缓存
    qr_info = await redis.get(f"qr:{unique_code}")
    if not qr_info:
        # 2. 查询数据库
        qr_info = await db.get_qrcode_by_unique_code(unique_code)
        if not qr_info:
            return RedirectResponse(url="/404")
        # 3. 写入缓存
        await redis.setex(f"qr:{unique_code}", 3600, qr_info)

    # 4. 记录扫码日志(异步)
    await record_scan_log.delay(unique_code, request.client.host, request.headers.get('User-Agent'))

    # 5. 检查绑定关系
    entity = await get_bound_entity(qr_info['id'])
    if not entity:
        return RedirectResponse(url="/qr/unbound")

    # 6. 根据业务类型跳转
    if entity['type'] == 'product':
        return RedirectResponse(url=f"/products/{entity['id']}")
    elif entity['type'] == 'event':
        return RedirectResponse(url=f"/events/{entity['id']}")
    else:
return RedirectResponse(url=f"/entities/{entity['id']}")此代码示例展示了缓存(Redis)和异步任务(Celery)的集成,这是高并发系统设计的常见模式28。
三、扫码处理与业务逻辑
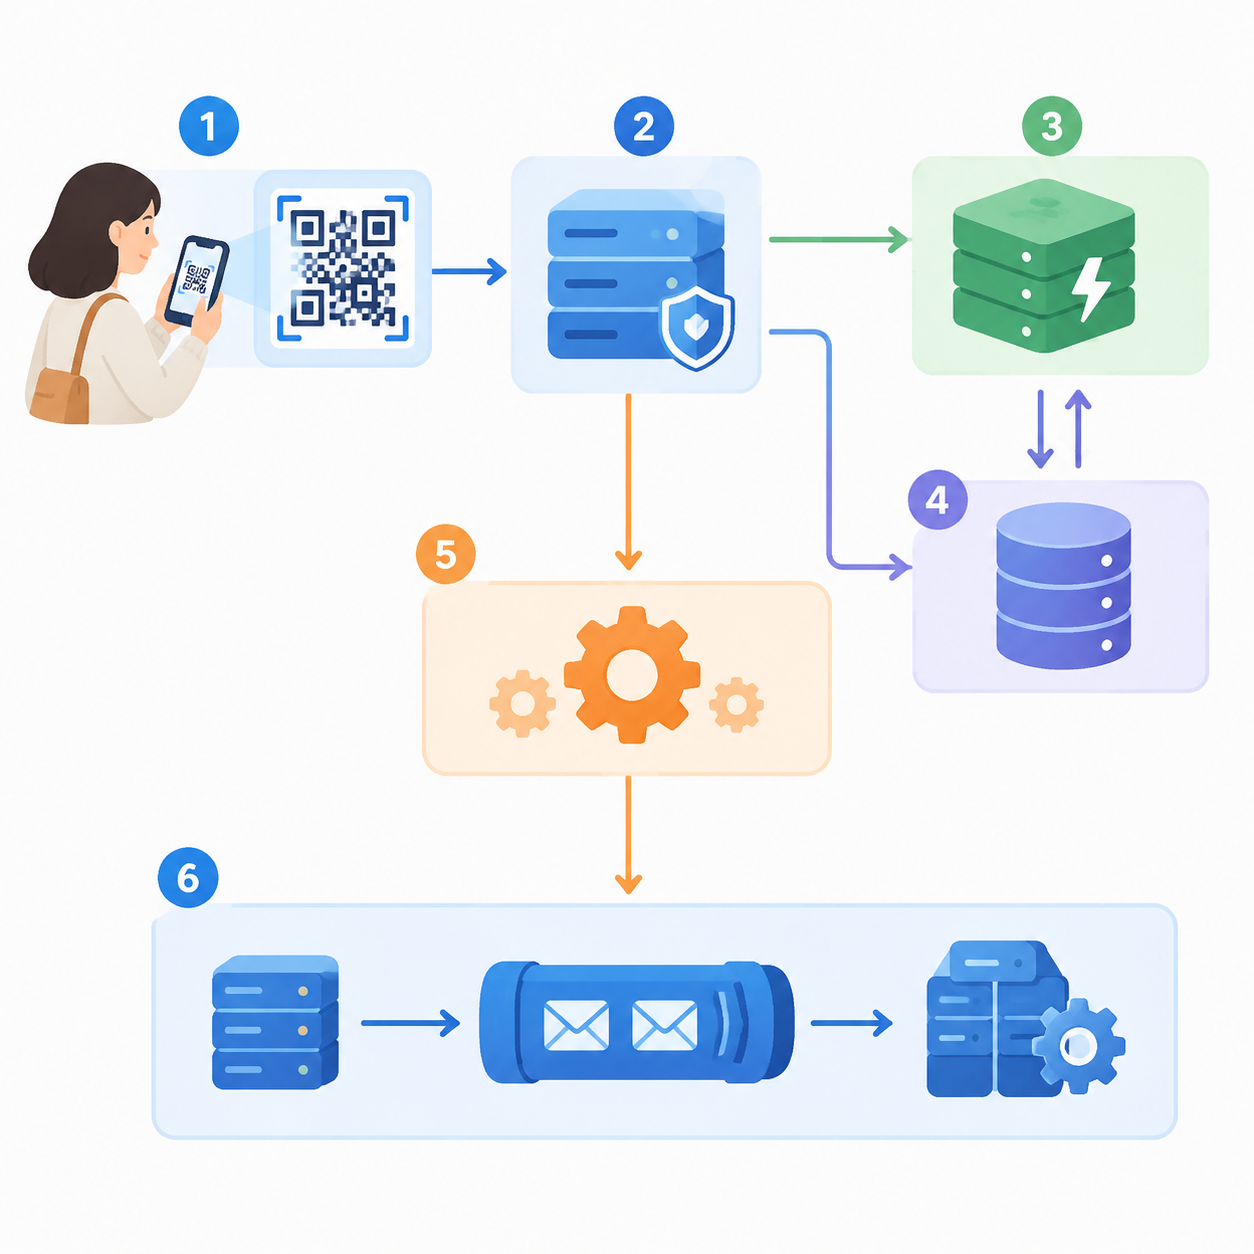
扫码是数据流的起点。一个高并发、可靠的扫码处理服务是系统的核心。根据《设计数据密集型应用》9,处理高并发读取请求的关键在于无状态设计、缓存和异步处理。
3.1 架构设计
- 统一网关入口:所有扫码请求首先到达一个轻量级的网关或API服务。网关可以处理路由、限流、认证等横切关注点9。
- 短链服务 :二维码可以编码一个短链(如
https://s.example.com/abc123),短链服务负责将短链解析为真实业务URL。这解耦了二维码内容和后端路由。短链服务本身也是一个高并发系统,通常使用布隆过滤器或缓存来快速判断短码是否存在9。 - 异步处理:扫码后的核心动作(如统计计数、更新状态、发送通知)应通过消息队列异步处理,保证响应速度。消息队列如Apache Kafka或RabbitMQ可以提供高吞吐量和持久化10。
3.2 核心流程与容错
- 请求解析 :从URL中提取唯一标识符(
unique_code)。 - 缓存查询:首先查询缓存(如Redis)中该二维码的绑定信息和状态,提高响应速度。Redis是一个高性能的键值存储,常用于缓存、会话管理等场景8。
- 数据库查询:缓存未命中时,查询数据库。
- 业务处理 :
- 信息展示:返回绑定的商品或活动详情页面。
- 签到/核销:在后台标记该二维码对应实体的状态。
- 防重复机制:对于签到等场景,需要在同一事务中检查并更新状态,防止同一二维码被重复使用。这需要数据库事务或分布式锁来保证原子性9。
- 记录日志:将扫码事件(时间、地点、设备信息等)异步写入日志系统。
3.3 高并发优化策略
- 缓存策略 :
- 本地缓存:使用Caffeine等本地缓存库,减少网络往返。Caffeine是Java的高性能缓存库,提供近乎最优的命中率11。
- 分布式缓存:使用Redis集群,支持水平扩展。
- 缓存预热:在系统启动或二维码批量生成后,主动将热点数据加载到缓存。
- 限流与降级 :
- 令牌桶算法:控制请求速率,防止突发流量冲击。这是一种常见的限流算法9。
- 降级策略:当服务不可用时,返回静态页面或缓存数据。
- 异步化处理 :
- 非核心逻辑异步:日志记录、统计更新、通知发送等非实时关键逻辑通过消息队列异步处理。
- 最终一致性:通过消息队列保证数据最终一致性,提高系统吞吐量9。
3.4 安全考虑
- 有效期控制:可以为二维码设置有效期,过期后不可用。
- 访问控制:某些二维码可能需要验证用户身份或权限才能查看内容。
- 防爬与限流:对扫码接口进行限流,防止恶意请求。
- IP黑名单:对频繁异常请求的IP进行封禁。
- 地理位置验证:某些场景下可结合GPS定位,防止远程恶意扫码。
3.5 扫码处理代码示例
python
import redis
from fastapi import FastAPI, Request
from fastapi.responses import RedirectResponse
import asyncio
from datetime import datetime
import json

app = FastAPI()
redis_client = redis.Redis(host='localhost', port=6379, db=0)

class QRCodeService:
    def __init__(self):
        self.cache_ttl = 3600  # 缓存1小时

    async def get_qr_info(self, unique_code: str) -> dict:
        """获取二维码信息(带缓存)"""
        cache_key = f"qr:{unique_code}"

        # 尝试从缓存获取
        cached = await redis_client.get(cache_key)
        if cached:
            return json.loads(cached)

        # 查询数据库
        qr_info = await self._query_database(unique_code)
        if qr_info:
            # 写入缓存
            await redis_client.setex(
                cache_key,
                self.cache_ttl,
                json.dumps(qr_info)
            )

        return qr_info

    async def _query_database(self, unique_code: str) -> dict:
        """查询数据库"""
        # 实际实现中这里会执行SQL查询
        # 示例返回
        return {
            'id': 1,
            'unique_code': unique_code,
            'entity_id': 'product_123',
            'entity_type': 'product',
            'is_active': True,
            'expires_at': '2024-12-31 23:59:59'
        }

qr_service = QRCodeService()

@app.get('/qr/{unique_code}')
async def handle_qr_scan(unique_code: str, request: Request):
    try:
        # 获取二维码信息
        qr_info = await qr_service.get_qr_info(unique_code)

        if not qr_info:
            return RedirectResponse(url="/404")

        # 检查是否激活
        if not qr_info.get('is_active', False):
            return RedirectResponse(url="/qr/disabled")

        # 检查有效期
        if qr_info.get('expires_at'):
            if datetime.now() > datetime.strptime(qr_info['expires_at'], '%Y-%m-%d %H:%M:%S'):
                return RedirectResponse(url="/qr/expired")

        # 记录扫码日志(异步)
        asyncio.create_task(
            record_scan_log(
                unique_code=unique_code,
                ip=request.client.host,
                user_agent=request.headers.get('User-Agent'),
                timestamp=datetime.now().isoformat()
            )
        )

        # 根据业务类型跳转
        entity_type = qr_info.get('entity_type')
        entity_id = qr_info.get('entity_id')

        if entity_type == 'product':
            return RedirectResponse(url=f"/products/{entity_id}")
        elif entity_type == 'event':
            return RedirectResponse(url=f"/events/{entity_id}")
        elif entity_type == 'user':
            return RedirectResponse(url=f"/users/{entity_id}")
        else:
            return RedirectResponse(url=f"/entities/{entity_type}/{entity_id}")

    except Exception as e:
        # 记录错误日志
        await record_error_log(unique_code, str(e))
        return RedirectResponse(url="/error")

async def record_scan_log(unique_code: str, ip: str, user_agent: str, timestamp: str):
    """记录扫码日志(异步)"""
    log_data = {
        'unique_code': unique_code,
        'ip': ip,
        'user_agent': user_agent,
        'timestamp': timestamp
    }
    # 实际实现中会写入数据库或消息队列
print(f"Scan log: {log_data}")此示例使用了FastAPI12,一个现代、高性能的Python Web框架,特别适合构建API服务。
四、数据统计与分析
二维码系统最终的价值体现在数据上。清晰的统计维度能帮助业务决策。数据统计与分析通常遵循数据仓库的分层架构,如经典的数据分层模型(ODS、DWD、DWS、ADS)13。
4.1 关键统计指标
- 基础数据 :
- 扫码总次数、总人数(UV)。
- 按时间(日/周/月)、地理位置、设备类型、渠道(哪个批次的二维码)的分布。
- 业务数据 :
- 核销率:已绑定实体中,被成功扫描或使用的比例。
- 转化漏斗:从扫码到完成最终操作(如下单、注册)的转化率。
- 热力图:基于地理位置数据,生成扫码热力图,了解线下流量分布。
- 性能指标 :
- 平均响应时间
- 扫码成功率
- 缓存命中率
- 并发处理能力
4.2 数据收集与存储
- 实时流处理:使用流处理平台(如Apache Flink, Spark Streaming)实时处理扫码事件流,计算实时指标(如当前小时扫码量)。Apache Flink是领先的流处理框架,提供事件时间处理和精确一次语义14。
- 离线数仓:将原始扫码日志(时间戳、二维码ID、地理位置、设备等)定期同步到数据仓库(如Hive, ClickHouse),用于复杂的离线分析和报表生成。ClickHouse是一个用于联机分析(OLAP)的列式数据库管理系统,以其极高的查询性能著称15。
- 数据分层设计 :
- ODS层:原始扫码日志
- DWD层:清洗后的明细数据
- DWS层:汇总统计数据
- ADS层:应用层数据,供报表使用
4.3 统计系统架构
sql
-- 统计表设计示例
CREATE TABLE scan_statistics_daily (
    id BIGINT PRIMARY KEY,
    stat_date DATE,
    batch_id BIGINT,
    entity_type VARCHAR(50),
    entity_id VARCHAR(128),
    total_scans INT DEFAULT 0,
    unique_users INT DEFAULT 0,
    avg_response_time_ms FLOAT,
    success_rate FLOAT,
    created_at TIMESTAMP,
    UNIQUE (stat_date, batch_id, entity_type, entity_id)
);

CREATE TABLE scan_details (
    id BIGINT PRIMARY KEY,
    scan_id VARCHAR(64) UNIQUE,
    unique_code VARCHAR(64),
    batch_id BIGINT,
    entity_id VARCHAR(128),
    scan_time TIMESTAMP,
    ip_address VARCHAR(45),
    user_agent TEXT,
    latitude DECIMAL(10, 8),
    longitude DECIMAL(11, 8),
    response_time_ms INT,
    is_success BOOLEAN,
    device_type VARCHAR(50),
    os_type VARCHAR(50),
    browser_type VARCHAR(50)
);索引设计对于查询性能至关重要,通常对经常作为查询条件的列(如scan_time、batch_id)建立索引5。
4.4 可视化与报表
为业务人员提供直观的Dashboard,展示:
- 各批次二维码的扫码趋势图。
- 不同地区或渠道的效果对比。
- 单个实体(如某个商品)的扫码历史时间线。
- 关键业务指标(如核销率)的预警。
可视化工具如Apache Superset16或Grafana17可以快速构建交互式仪表盘。

4.5 实时统计代码示例
python
from datetime import datetime, timedelta
import asyncio
from collections import defaultdict

class RealTimeStatistics:
    def __init__(self):
        self.scan_counts = defaultdict(int)  # 按批次统计
        self.hourly_counts = defaultdict(int)  # 按小时统计
        self.geo_data = []  # 地理位置数据
        self.last_cleanup = datetime.now()

    async def record_scan(self, unique_code: str, batch_id: int,
                         latitude: float = None, longitude: float = None):
        """记录扫码事件"""
        # 增加计数
        self.scan_counts[batch_id] += 1

        # 按小时统计
        current_hour = datetime.now().strftime('%Y-%m-%d %H:00:00')
        self.hourly_counts[current_hour] += 1

        # 记录地理位置
        if latitude and longitude:
            self.geo_data.append({
                'latitude': latitude,
                'longitude': longitude,
                'timestamp': datetime.now().isoformat(),
                'batch_id': batch_id
            })

        # 定期清理过期数据
        if datetime.now() - self.last_cleanup > timedelta(hours=1):
            await self.cleanup_old_data()

    async def cleanup_old_data(self):
        """清理过期数据"""
        cutoff_time = datetime.now() - timedelta(days=30)
        self.geo_data = [
            item for item in self.geo_data
            if datetime.fromisoformat(item['timestamp']) > cutoff_time
        ]
        self.last_cleanup = datetime.now()

    def get_batch_statistics(self, batch_id: int) -> dict:
        """获取批次统计"""
        return {
            'batch_id': batch_id,
            'total_scans': self.scan_counts.get(batch_id, 0),
            'hourly_trend': self.get_hourly_trend(batch_id),
            'geo_distribution': self.get_geo_distribution(batch_id)
        }

    def get_hourly_trend(self, batch_id: int) -> list:
        """获取小时趋势"""
        # 实际实现中需要关联批次ID
        trend = []
        for hour, count in sorted(self.hourly_counts.items()):
            trend.append({'hour': hour, 'count': count})
        return trend[-24:]  # 返回最近24小时

# 使用示例
statistics = RealTimeStatistics()

async def main():
    # 模拟扫码事件
    await statistics.record_scan('abc123', 1, 39.9042, 116.4074)
    await statistics.record_scan('def456', 1, 31.2304, 121.4737)

    # 获取统计
    stats = statistics.get_batch_statistics(1)
print(f"批次1统计: {stats}")在实际生产环境中,实时统计通常由流处理引擎(如Flink)或时间序列数据库(如InfluxDB)来处理,以保证性能和可扩展性14。
五、系统扩展性与最佳实践
- 微服务化:将生成、绑定、扫码、统计拆分为独立的服务,便于独立开发、部署和扩展。微服务架构是现代云原生应用的主流架构模式9。
- 幂等性设计:所有接口,尤其是绑定和状态修改接口,都应设计为幂等的,防止网络重试导致数据错误。这是分布式系统设计的基本原则之一9。
- 监控与告警:为关键路径(如扫码响应时间、队列积压、错误率)设置监控和告警,确保系统稳定性。Prometheus和Grafana是开源监控和可视化方案的黄金组合18。
- 灰度发布:在新功能(如新的扫码跳转逻辑)上线时,支持按批次或二维码ID进行灰度发布。这是降低发布风险的有效手段。
5.1 技术选型建议
| 组件 | 推荐技术 | 备选方案 |
|---|---|---|
| 二维码生成 | ZXing (Java), qrcode (Python) | ZBar, 云服务API |
| 任务队列 | Celery + Redis, RabbitMQ | Apache Kafka, Amazon SQS |
| 缓存 | Redis Cluster | Memcached, Hazelcast |
| 数据库 | PostgreSQL, MySQL | ClickHouse (分析), MongoDB (日志) |
| 消息队列 | Apache Kafka, RabbitMQ | Amazon SNS/SQS, Apache Pulsar |
| 流处理 | Apache Flink | Spark Streaming, Kafka Streams |
| 对象存储 | AWS S3, 阿里云OSS | MinIO, 腾讯云COS |
| 监控 | Prometheus + Grafana | Datadog, New Relic |
5.2 性能优化清单
- 数据库优化 :
- 为常用查询字段建立索引
- 使用读写分离
- 考虑分库分表(当数据量超过千万级)
- 缓存策略 :
- 实现多级缓存(本地缓存 + 分布式缓存)
- 设置合理的缓存过期时间
- 实现缓存预热和降级机制
- 异步处理 :
- 将非关键路径操作异步化
- 使用消息队列解耦服务
- 实现最终一致性
- 代码优化 :
- 避免循环中的数据库查询
- 使用批量操作减少网络往返
- 实现连接池管理
5.3 监控指标
- 业务指标 :
- 扫码成功率
- 平均响应时间
- 并发用户数
- 地理分布热力图
- 技术指标 :
- 服务器CPU/内存使用率
- 数据库连接数
- 缓存命中率
- 消息队列积压情况
- 告警阈值 :
- 扫码成功率 < 99%
- 平均响应时间 > 500ms
- 服务器CPU使用率 > 80%
- 消息队列积压 > 1000条
总结
一个看似简单的二维码,背后可能连接着一个完整的、分布式的系统。从高效的批次生成 ,到灵活的动态绑定 ,再到高并发的扫码处理 与深入的数据统计,每一步都需要精心的设计。
通过采用异步处理、缓存、队列和微服务架构,我们可以构建出一个健壮、可扩展的二维码管理平台。关键成功因素包括:
- 合理的架构设计:确保系统可扩展、可维护
- 高效的生成策略:支持大批量二维码的快速生成
- 灵活的绑定机制:适应不同业务场景的需求
- 可靠的扫码处理:保证高并发下的系统稳定性
- 全面的数据统计:提供有价值的业务洞察
记住,技术选型要根据实际业务规模和团队能力来决定。从小规模开始,随着业务增长逐步演进架构,是务实且有效的策略。真正释放二维码作为连接物理世界与数字世界桥梁的潜力。
参考文献
1 ISO/IEC 18004:2015. Information technology --- Automatic identification and data capture techniques --- QR Code bar code symbology specification. International Organization for Standardization. https://www.iso.org/standard/62021.html
2 Celery. Distributed Task Queue. https://docs.celeryq.dev/
3 Amazon S3. Object Storage Built to Retrieve Any Amount of Data from Anywhere. https://aws.amazon.com/s3/
4 Google Developers. WebP Compression. https://developers.google.com/speed/webp
5 Silberschatz, A., Korth, H. F., & Sudarshan, S. (2019). Database System Concepts (7th ed.). McGraw-Hill Education.
6 QRCode. Python Library to generate QR Codes. https://pypi.org/project/qrcode/
7 Martin, R. C. (2017). Clean Architecture: A Craftsman's Guide to Software Structure and Design. Prentice Hall.
8 Redis. The Real-time Data Platform. https://redis.io/documentation/
9 Kleppmann, M. (2017). Designing Data-Intensive Applications: The Big Ideas Behind Reliable, Scalable, and Maintainable Systems. O'Reilly Media.
10 Apache Kafka. A Distributed Streaming Platform. https://kafka.apache.org/documentation/
11 Caffeine. A high performance caching library for the JVM. https://github.com/ben-manes/caffeine
12 FastAPI. Modern, fast, web framework for building APIs with Python 3.7+ based on standard Python type hints. https://fastapi.tiangolo.com/
13 Kimball, R., & Ross, M. (2013). The Data Warehouse Toolkit: The Definitive Guide to Dimensional Modeling (3rd ed.). Wiley.
14 Apache Flink. Stateful Computations over Data Streams. https://flink.apache.org/
15 ClickHouse. Open Source DBMS for OLAP. https://clickhouse.com/
16 Apache Superset. Data Exploration and Visualization Platform. https://superset.apache.org/
17 Grafana. The open observability platform. https://grafana.com/
18 Prometheus. From metrics to insight. https://prometheus.io/