我们是怎么让 AI 找到那个 Bug 的?
上一篇结尾留了一句话:给系统补上调用链检索能力之后,原本要搜 2-4 小时的路径,AI 用几分钟就定位到了。
今天把这个"补上"拆开讲。
它不是一个 Prompt,也不是一段咒语。
要让 AI 真正完成一次故障排查,我们最后补上的,其实是四种能力:
看得见代码、拿得到现场、找得到经验、验证得了结论。
对应的,就是四套基础设施:
代码图谱、运行时通道、经验知识库、验证闭环。
每一套都不性感。
但缺任何一套,AI 都可能停在"给你一个看起来很合理的答案"这里。
而我们真正想要的,是让它能够继续往下走,直到:
从一个模糊症状,走到一个可以被验证的根因。
⸻
先回忆一下那个 Bug 的困境
OAuth2 登录失败,返回一个空的 HTTP 错误。AI 说"去 SSO 认证链路查 validate 方法",方向完全正确。
但工程师面对的是:大量微服务,散在多个代码仓,海量源文件。搜错误码,搜到的全是 REST 侧的正确处理,越搜越远;搜 HTTP 状态码,全是无关噪音。
核心困难不是"不知道往哪查",而是从方向到 文件:行号 之间的距离太远了。
这个距离,就是我们要帮 AI 补上的。
⸻
第一条路:代码图谱------让 AI 沿着调用链走,而不是全局搜
一个大型微服务系统,你不可能把所有源码塞进上下文。塞不进去,AI 就只能靠通用知识猜。
我们做的第一件事是给代码建索引------不是全文索引,是符号级的调用关系图谱。
用 AST 解析把 21 个仓库里的类、方法、字段全部抽出来,同时识别跨服务调用注解,把微服务之间的 HTTP 调用关系也建进图里。然后封装成工具,AI 可以按需调用:给一个类名,返回它在哪个文件第几行;给一个方法,沿着调用关系向上或向下展开,包括跨服务的链路。
回到 OAuth2 那个 Bug。AI 拿到这些工具后,做的事情是:
搜索 "OAuth2" → 找到 Token 端点 Controller
向下追踪 → handleRequest → 调用 validate
向上追踪 → 找到 UserAuthenticator
几步跳转,定位到 validate 方法里一个典型的 catch 块:
java
} catch (final Exception e) {
    throw new GenericAuthException("Authentication failed", e);
}
所有认证失败------密码错误、账号锁定、账号失效------在这里被统一包装成一个通用异常,业务错误码全部丢失。
但 AI 没有停在这里。它顺着图谱继续走,发现同一个系统里 REST 侧已经有一套完整的异常处理结构------HTTP 状态码 + 错误码 + 错误信息,规规矩矩。而 OAuth 端点压根没接入这套机制。
这个发现之所以重要,是因为它不仅定位了 Bug,还同时给出了修复方向:不需要从零设计,接入已有机制就行。
grep 给不了这个信息。grep 能告诉你某个字符串出现在哪里,但它不知道两段代码之间的调用关系,更不知道"这个系统里已经存在一个正确的实现"。
调用关系图谱让 AI 从"全局搜关键词"变成"沿着调用链精确跳转"。 这是从方向到行号之间最短的路。
⸻
第二条路:运行时通道------让环境事实能送到 AI 面前
代码图谱解决了"代码里写了什么"的问题。但 Bug 往往不只是代码问题------它还跟环境有关。
Pod 是不是在 Running?配置在多节点之间是不是一致?日志里的异常栈长什么样?这些运行时事实,原本只有进客户隔离网络才能看到。
而 AI 不能进客户网络。这是安全红线,不可谈判。
我们的做法是把工作流切成三层,让 AI 和数据在物理上分离:
第一层:AI 在本地,根据症状生成一个诊断脚本
          ↓  脚本送到客户环境
第二层:脚本在客户机器上执行,收集证据
          ↓  报告带回本地
第三层:AI 在本地,解析报告,给出判定
这里有一个关键的设计决策,也是我觉得做 Agent 最容易踩的坑:
很多人做 Agent 的第一反应是------给它一个 Shell,让它自己执行命令。
我们反过来。AI 不能自己写命令,它只能从一个预置的只读命令模板库里选取------目前 110+ 条,每条都经过安全审计,标注了风险等级;AI 的工作是根据症状选对组合,而不是自由发挥。
这不是普通的 Tool Calling,而是把 Agent 的自由度限制在一个预先验证过的动作空间里。
在分诊和分析环节,AI 可以充分推理、做判断。但在取证环节------涉及客户生产环境的那一步------它的每一个动作都是受限的、可审计的、确定性的。
创造性留给两端,确定性守住中间。这是整套设计里最重要的取舍。
脚本输出同时生成人读的文本和机读的结构化数据。第三层 AI 拿到的不是一堆原始日志,而是每项检查的名称、状态和判定理由。
当受控远程通道可用时,这个过程可以进一步自动化------AI 通过预审计的执行工具上传脚本、取回报告,中间不需要人工搬运。所有远程操作同样走白名单,只读命令直接执行,任何写操作必须经人确认,完整审计日志落盘。通道不可用时,系统完全退化成手动模式------人把脚本拷进去、执行完、把结果粘贴回来,一样能跑。
客户环境零依赖------不需要装 AI、不需要装任何额外工具,只执行我们送进去的只读脚本。这是方案能在大量隔离环境里推开的前提。
⸻
第三条路:经验知识库------让同一个问题不再排查第二次
前两条路解决了单次排查的效率。但有一个问题它们解决不了:
同一个故障模式,在不同客户那里被独立排查了一遍又一遍------每次都从零推理,因为上一次的经验只在某个工程师的脑子里。
解决方案听起来很朴素:把经验结构化,让 AI 在分诊阶段就能检索到。
我们从历史工单里提炼出 46 个故障模式,按"是否要改代码"分成两层------现场能闭环的归一类,必须转研发的归另一类。每个模式配上匹配规则和确认步骤。
分类不是为了整齐,是为了在分诊阶段就决定这单该谁接。回顾未闭环工单的归因数据,我们发现不少故障其实属于配置、环境或容量类问题,现场就能闭环,根本不需要研发改代码------但之前经常被误转到研发。这是效率损耗的一个重要来源。
在此之上,我们维护了一个"已知问题库"------经过验证的闭环方案,连修复步骤都写好了。同样的问题第二次出现时,AI 直接命中已知条目,输出已验证的方案,不用再推理,不用再排查。
经验沉淀不是让 AI 去"学习",而是把人的经验翻译成 AI 可消费的结构化数据,我们后来发现,故障知识库真正有价值的地方,不是让 AI "知道更多",而是让它在面对一个症状时,少走几条错误的路。
⸻
第四条路:验证闭环------找到根因之后,怎么证明它真的对
前三条路解决了"让 AI 拿得到证据"。但拿到证据不等于诊断正确。
AI 有一个很危险的特点:即使证据不足,它也能给你一个听起来非常完整的解释。它可以用合理的逻辑串起一段分析,读起来天衣无缝,但根因可能完全错了。
所以我们设计了一个分层验证体系,强度逐级递增:
必须过的关:Bug 复现 + 回归测试。
修复前是红的,修复后是绿的------没有红变绿的证据,不算修复。同时,改过的每个点,它的调用者的原有行为不能变------不是"我觉得不会影响",是实际跑过测试。
这两层是硬门槛,过不了就不能说"修好了"。
能做的尽量做:环境对照。
如果能连到测试环境,AI 会通过浏览器自动化工具登录系统、按照复现步骤操作、截图。修复后再走一遍,断言反转------原来验证"症状存在",现在验证"症状消失"。修复前后的截图并排归档,任何人都能复核。连不上环境时,跳过这层,不阻断流程。
修复完成后:知识回流。
验证通过后,修复记录沉淀到一个独立的修复历史库------症状关键词、根因类型、涉及的代码位置、修复模式。它和代码图谱是两个东西:图谱记录代码结构,修复历史记录"这段代码出过什么问题、怎么修好的"。下次遇到相似症状,AI 在定位阶段就能检索到这条记录,第三条路的知识库也因此持续生长。
这就形成了一个闭环:诊断产生证据 → 证据驱动修复 → 修复产生验证 → 验证沉淀为知识 → 知识加速下一次诊断。
验证体系不是质量流程的附属品,它是整套系统能自我进化的前提。
⸻
四条路拼在一起
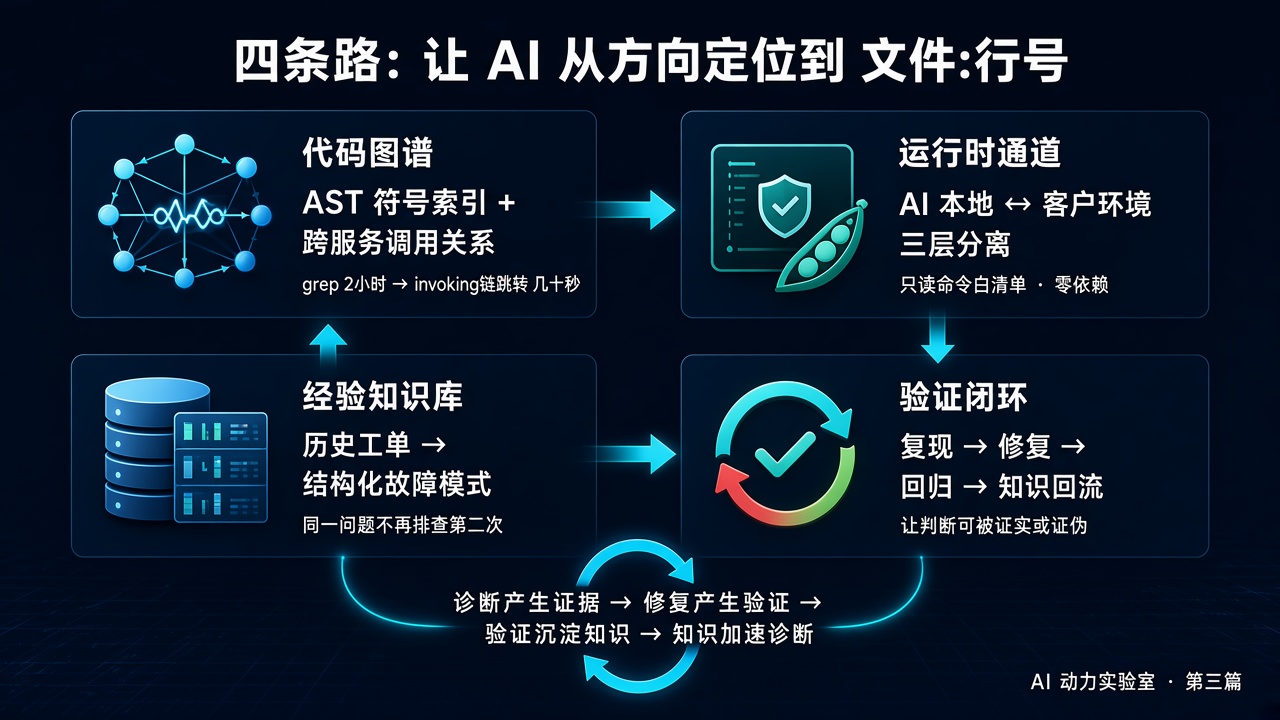
回到最开始的问题:我们到底"补上"了什么?
| 路 | 解决什么 | 没有它会怎样 |
|---|---|---|
| 代码图谱 | AI 看不见跨服务调用关系 | 全局 grep,搜很久 |
| 运行时通道 | AI 拿不到环境事实 | 只能凭症状猜,无法确认 |
| 经验知识库 | 同一个问题每次从零推理 | 同一模式反复排查 |
| 验证闭环 | AI 的分析无法被证实或证伪 | 越猜越自信,一次误判摧毁信任 |
四条路不是并列摆设,而是一条可以持续推进的排查链路:
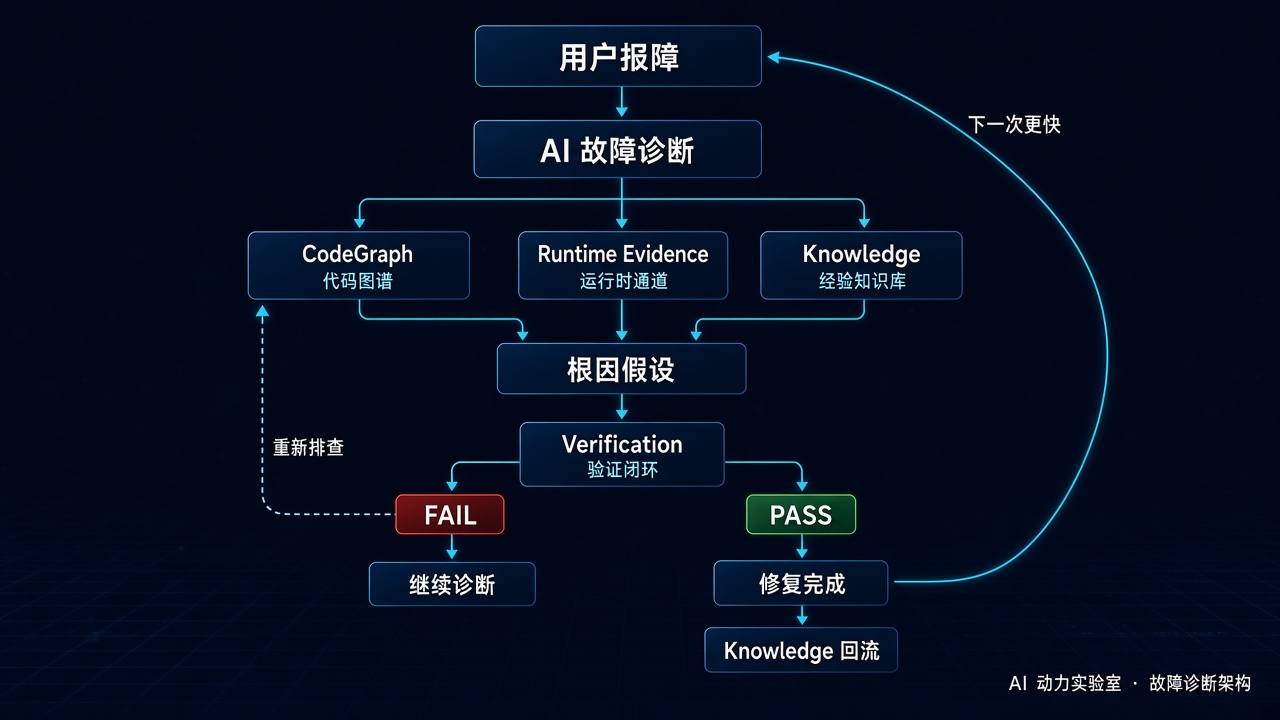
这四条路的共同点:它们都不改变模型本身,只改变模型能看到什么、能做什么、以及怎么被验证。
模型还是那个模型。从"给个方向,人搜 2-4 小时"变成"几分钟定位到文件行号",中间差的不是更好的 Prompt,是这四条基础设施。
几个数字可以概括这套投入:21 个仓库 建图谱,110+ 条 审计过的诊断命令,46 个 故障模式------排查时间从 2-4 小时 压到几分钟。
⸻
一个可能更重要的观察
整套系统做下来,最让我意外的不是提效倍数,而是一个定性的变化:
AI 的角色从"高级搜索引擎"变成了"可以独立推进排查的执行体"。
以前,工程师问 AI 一个问题,AI 回答一个方向,然后工程师自己去做所有的事情。
现在,AI 沿着调用链定位代码、生成诊断脚本、解析执行结果、给出判定、验证修复、回流知识。人做的事情变成了:确认关键假设、批准敏感操作、在验证环里做最终判断。
这不是"AI 更聪明了",而是系统被改造成了 AI 可以持续推进的形态。
这也是我在第一篇里说的那个观点的具体展开:
AI 不是不会做,而是系统有没有给它足够的证据、工具、边界和验证机制,让它能够持续把事情做完。
⸻
尾声
有人可能会问:这套东西的建设成本高不高?
说实话,不低。代码图谱要做 AST 解析和跨服务关系识别,故障模式要从历史工单里逐个提炼,诊断命令要逐条审计安全性,验证流程要反复踩坑打磨。
但换一个角度看:这些东西建一次,用在每一次后续的排查里。而"每次从零推理"的成本,是在每一个工单上反复支付的。
前者是一次性投入,后者是持续税。
下一篇,我想换个视角,聊聊 AI Coding Agent 在 0→1 建设新系统时到底能做到什么程度------不是"辅助写代码"的程度,而是"十几万行代码没有一行是人写的"的程度。它的前提是什么,边界在哪里,我们踩了哪些坑。
⸻
最后说个事
这篇文章讲的是四条路的 What 和 Why。
但真正做起来,最费时间的往往是 How:
CodeGraph 的 AST 解析器到底怎么设计?
跨服务调用关系怎么建立?
110+ 条诊断命令怎么做安全边界?
46 个故障模式怎么从历史工单里提炼出来?
AI 不按流程走的时候怎么办?
验证环为什么会失效?
这些东西很难在一篇文章里全部展开。
所以我会把更原始的工程过程放进知识星球:
不是只记录最后的答案,也记录答案是怎么被做出来的。
包括踩坑、方案权衡、被推翻的设计、工具链实现,以及我每天看到的一手 AI 工程实践。
如果你正在做 AI Agent、Coding Agent、AI Native 研发效能,或者正在尝试把 AI 真正接进企业研发流程,可以来这里一起研究。
AI 动力实验室