Spring Insight 里如何把 Span 收成一条链路
作者:苏渡苇
项目地址 :github.com/iweidujiang...(感谢 Star !)
一次下单接口,在链路追踪只占列表一行?
上一篇把拓扑讲完了:图上的箭头来自 remoteService,按 服务对 归边。
链路页要回答的是另一件事------一次请求从头到尾经过了哪些调用。
如果把内存里的 Span 直接摊成表格,同一条 Trace 会占很多行,入口、总耗时、成没成功都看不清。
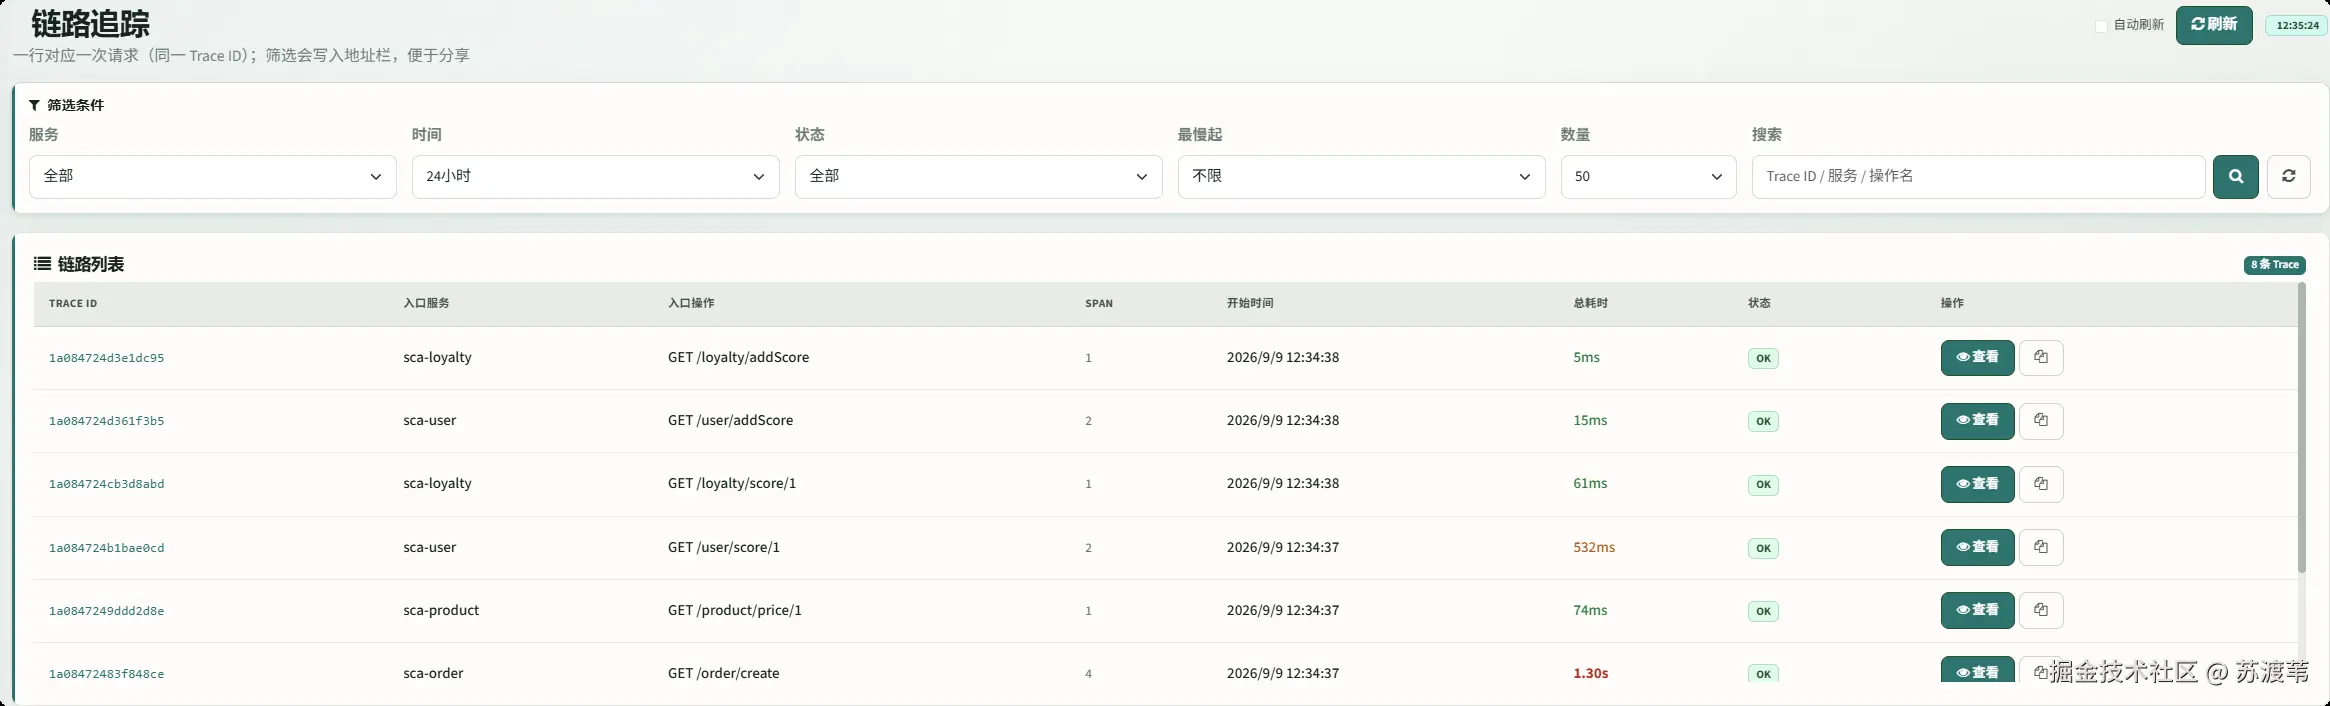
控制台现在的做法是:同一 traceId 收成一行摘要,点进去才展开那些 Span。
这篇要讲的就是这行摘要:根服务、入口操作、总耗时、是否有错误,是怎么从扁平记录里抠出来的。
列表要的是摘要,不是把 Span 全铺出来
一次跨服务调用会留下多条 Span:Gateway 进站、Gateway 出站、order 进站、order 调 user、order 调 product......它们共享同一个 traceId,parentSpanId 把树串起来。
列表如果按 Span 展示,刷新一次能刷出几十上百行,其中很多是同一次下单。打开页面的人想找的通常是:刚才那次请求慢不慢、有没有 ERROR、入口是哪个服务。
所以列表接口返回的不是 Span 数组,而是 Trace 摘要:
| 字段 | 含义 |
|---|---|
traceId |
这一次请求的 ID |
serviceName |
根 Span 所在服务,当作入口 |
operationName |
根 Span 的操作名 |
startTime |
这棵树里最早的开始时间 |
durationMs |
最晚结束减去最早开始,整段墙钟时间 |
spanCount / serviceCount |
这条 Trace 里有多少条 Span、经过几个服务 |
hasError |
其中任意一条失败,整行就算 ERROR |
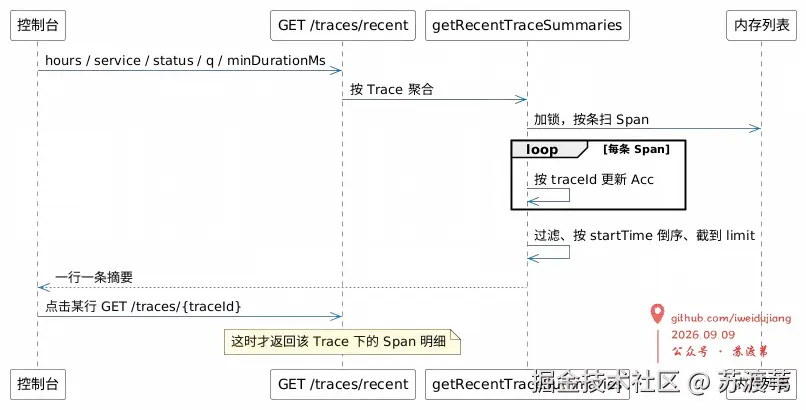
聚合代码在此:
TraceSpanPersistenceService.getRecentTraceSummaries查询接口:
GET /api/v1/ui/traces/recent
进站 SERVER、JDBC 只要挂了同一个 traceId,都会进 spanCount,并不要求带 remoteService。拓扑那张图会丢掉没有远端名的记录,列表这边不会。
用 record 把同一条 Trace 累在一起
扫描仍在那把锁里做,按 traceId 放进 LinkedHashMap,每条 Trace 一个累加器:
java
record Acc(
        String traceId,
        long minStart,
        long maxEnd,
        int spanCount,
        boolean hasError,
        String rootService,
        String rootOperation,
        LinkedHashSet<String> services
) {}
record是 Java 16 正式引入的一种紧凑型类声明 ,专为纯数据载体设计,可参考我之前的这篇介绍:record + sealed class = Java 的"类型乐高"!
这里用它,是因为 Acc 只扛一组数字和字符串,不需要再手写 getter、equals、hashCode。取字段写成 acc.traceId()、acc.minStart(),不像普通 JavaBean 那样 getXxx()。Insight 要求 JDK 21,这类写法可以直接用。
碰到一条 Span,先用时间窗口切掉过旧的,再更新这几个量:
minStart/maxEnd:整段链路的起止,缺endTime时用startTime + durationMs顶上spanCount:条数加一services:出现过的serviceName去重hasError:任意一条statusCode为 ERROR,或success == false,整行打上错误- 根节点:
parentSpanId为空的那条,记下它的服务名和操作名,当作入口
java
boolean root = s.getParentSpanId() == null || s.getParentSpanId().isBlank();总耗时不是把每条 Span 的 durationMs 加起来------子调用是嵌套、并行都有,加总会虚高。这里用 maxEnd - minStart,表示这次请求从最早埋点到最晚结束跨了多久。
扫完之后再过滤、排序:按 startTime 倒序,截到 limit。根服务如果始终没找到(整棵树都带了 parent),就退回这条 Trace 里出现过的第一个服务名,避免列表上入口是空白。
筛选项对着接口参数来
接口参数和页面上的筛选项是对齐的:
text
GET /api/v1/ui/traces/recent
    ?hours=24
    &limit=100
    &service=sca-order
    &status=error
    &q=create
    &minDurationMs=500
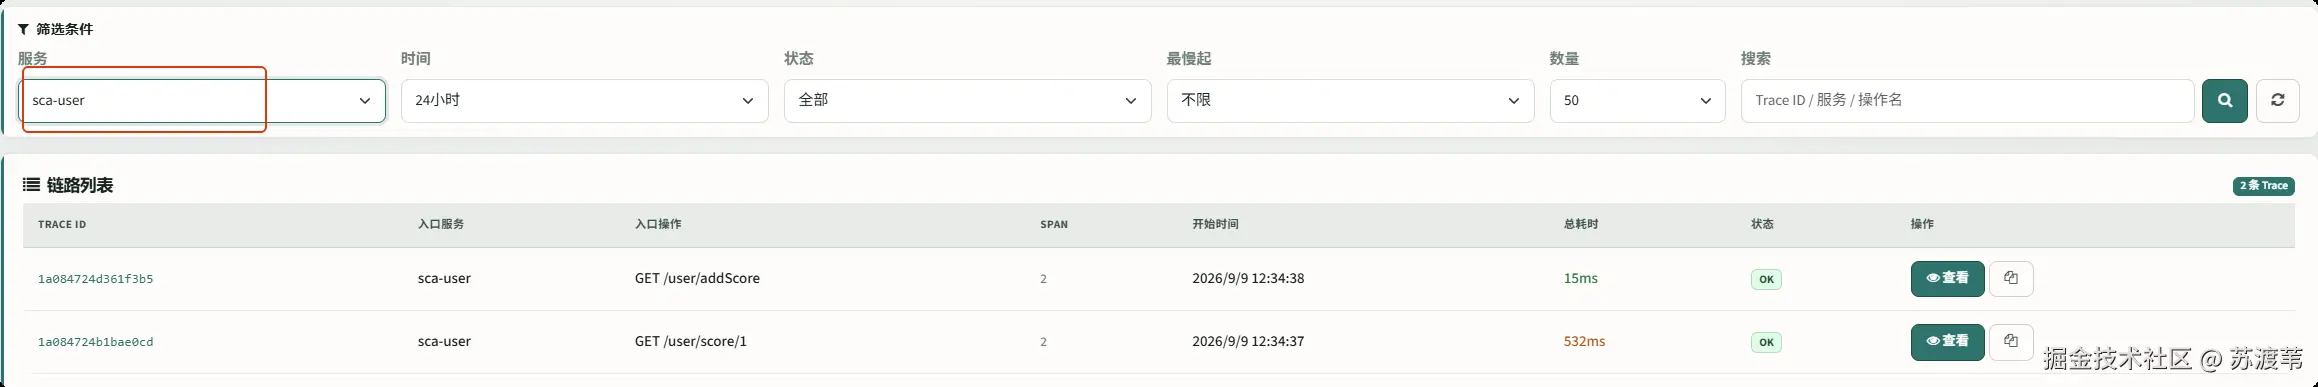
service 看的是这条 Trace 有没有经过 该服务,不是只匹配入口。
order 调了 user,按 sca-user 筛,这次下单仍会留下。status=error|ok 看的是整行的 hasError。
关键字会拿 Trace ID、入口操作、入口服务、以及路过的服务名做忽略大小写包含。
minDurationMs 用的是上面算出来的墙钟耗时,仪表盘跳慢请求也走这个参数。
这些条件都在内存里聚完后过滤,没有单独的索引。前端把当前筛选写进地址栏,复制 URL 能打开同一组条件;点某一行再请求 GET /api/v1/ui/traces/{traceId},那才是这条 Trace 下的 Span 明细,瀑布图怎么画放在下一篇。
收成一行之后,还要看清哪一段慢
链路列表把同一 traceId 收成一行:入口来自没有父节点的根 Span,总耗时是整段墙钟,任意一条失败整行就是 ERROR。接口是 GET /api/v1/ui/traces/recent,筛选在聚完之后做。
看列表时有两处容易对不上预期。总耗时不是子 Span 耗时之和,并行调用加起来会比墙钟更夸张;按服务筛选是 经过该服务,不是只显示以它为入口的请求。根找不到时会拿出现过的第一个服务名顶上,跨进程如果 parent 没带上,入口可能不准。
点进某一行之后,还要把这些 Span 按开始时间和父子关系排成瀑布,才能看出哪一段把时间吃掉了。
下集预告:详情页的时间线怎么把扁平 Span 画成调用树,深度、偏移和条宽分别从哪几个字段来。
最后:欢迎围观 Spring Insight
如果你对轻量监测、Spring Boot Starter、链路埋点感兴趣,欢迎看看这个还在打磨的小项目:
🔗 GitHub :github.com/iweidujiang...
当前形态很朴素:业务服务加 spring-insight-agent-starter,旁边单独跑 insight-server 看拓扑和链路。能力有限,代码也还糙,适合当练手和对照。
你的 Star 是对我最大的鼓励。