面向开发者解析风控规则引擎选型误区:对比Drools等传统方案,说明JVS-Rules三层轻量化设计如何以决策编排、规则表达、函数计算覆盖真实业务闭环,降低治理成本与运维负担。
问题起点:你的风控逻辑真需要Java级编码吗?
很多团队一提规则引擎,就默认要支持任意Java逻辑------但真实高频场景(如贷前准入、营销券发放、分段计息)本质是多源变量(征信分、负债率、地域政策、活动有效期)的组合判断与轻量加工,而非复杂状态机或模型集成。
金融类系统的核心诉求不是'能写多少代码',而是:
- 规则执行路径可解释、可追溯;
- 变更不影响核心系统稳定性;
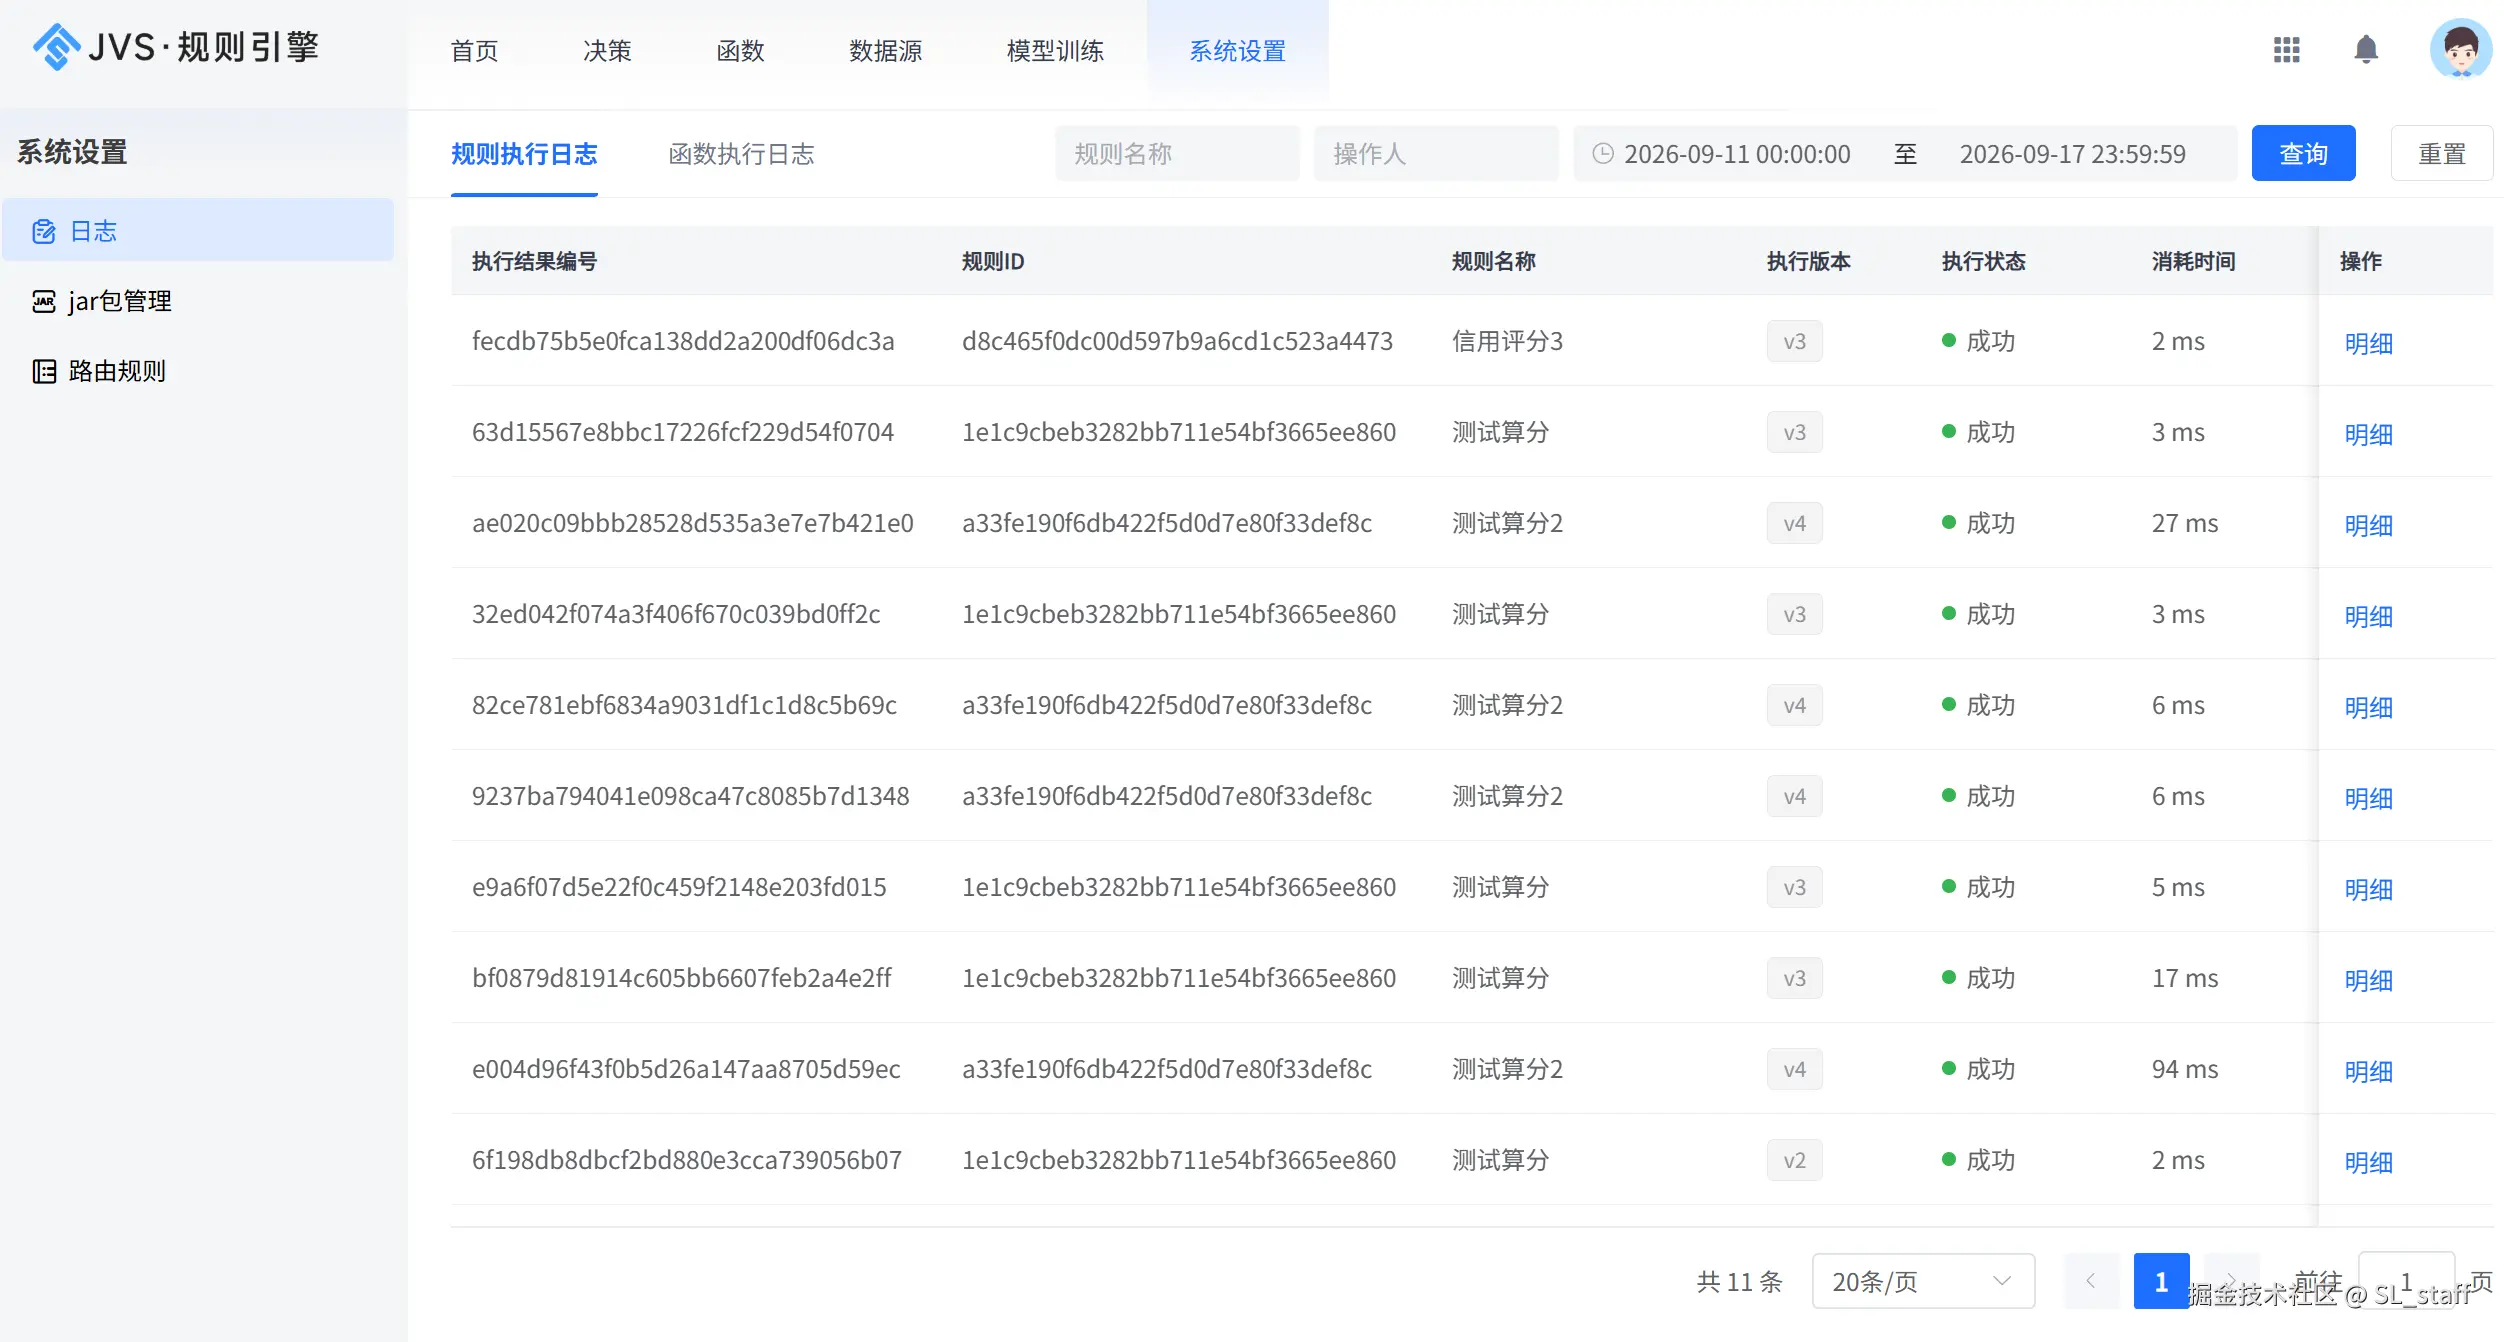
- 审计时能输出'命中哪条规则、依据哪些字段、触发何种分支'的完整链路。
当规则散落在if-else里、依赖发版上线、业务人员无法自主配置时,技术自由度反而成了合规与迭代的瓶颈。
JVS-Rules的三层设计:聚焦开发者真正要解决的问题
它不堆砌'支持Groovy/Java/Python'这类参数,而是围绕风控工程师日常工作流构建产品化能力:
-
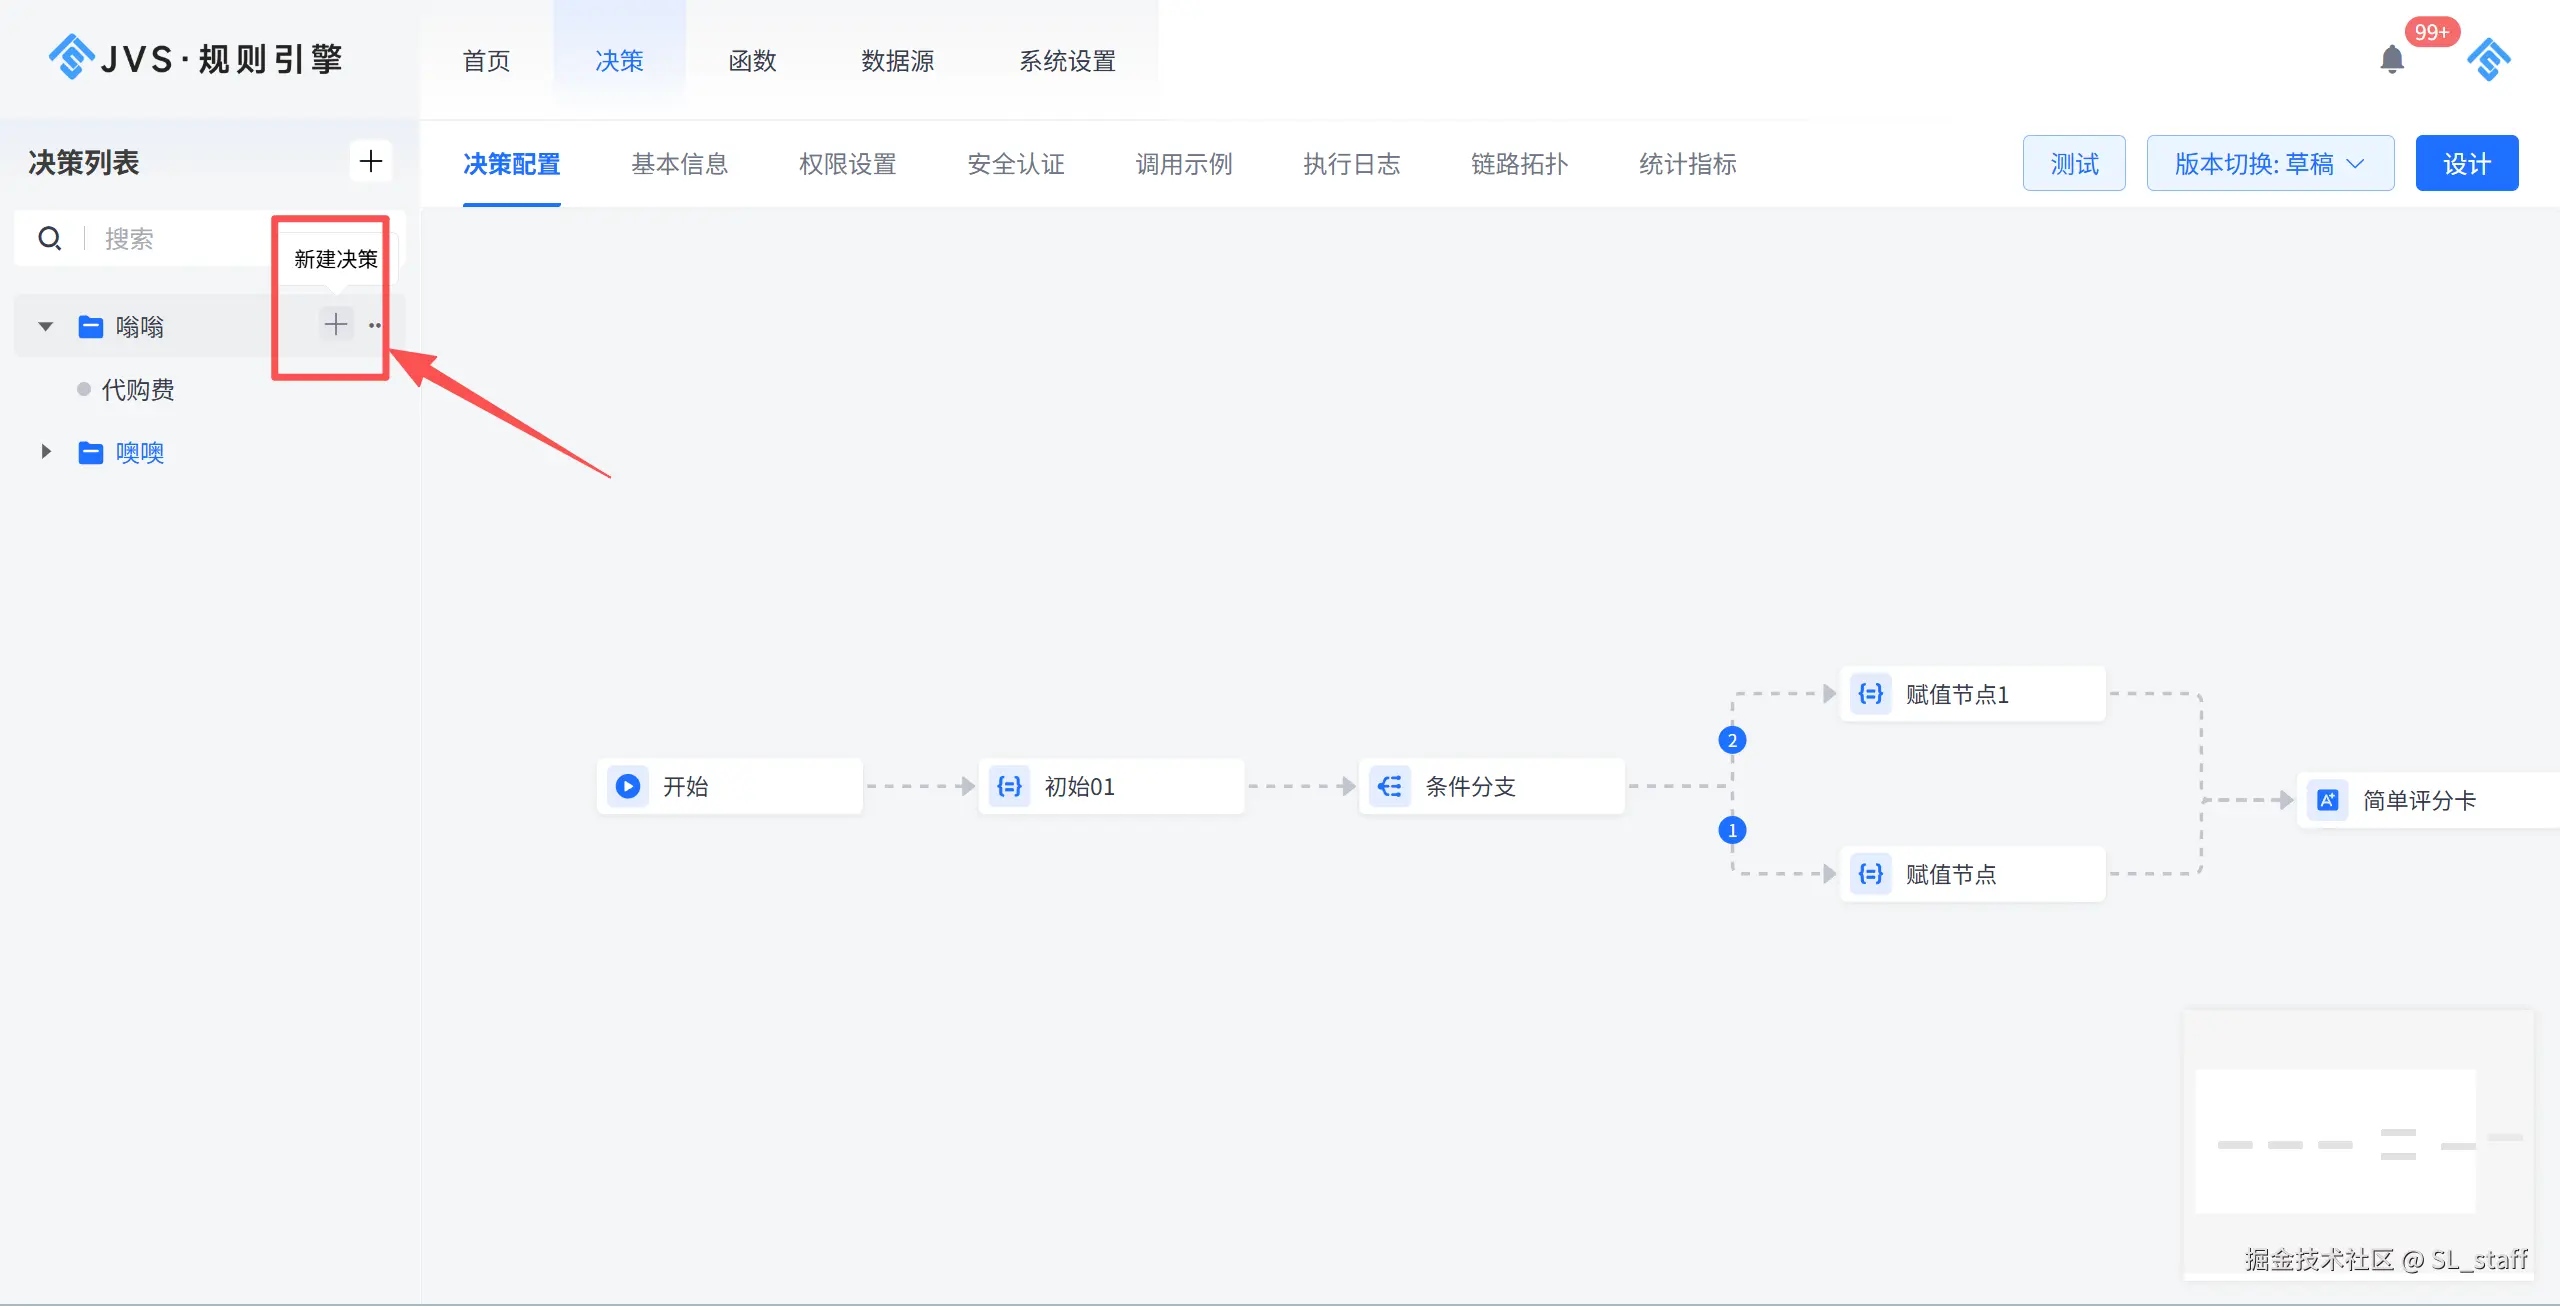
决策编排层:可视化拖拽构建决策流(如'准入→评分→额度→复核'),支持调试、分支跳转与跨场景复用;
-
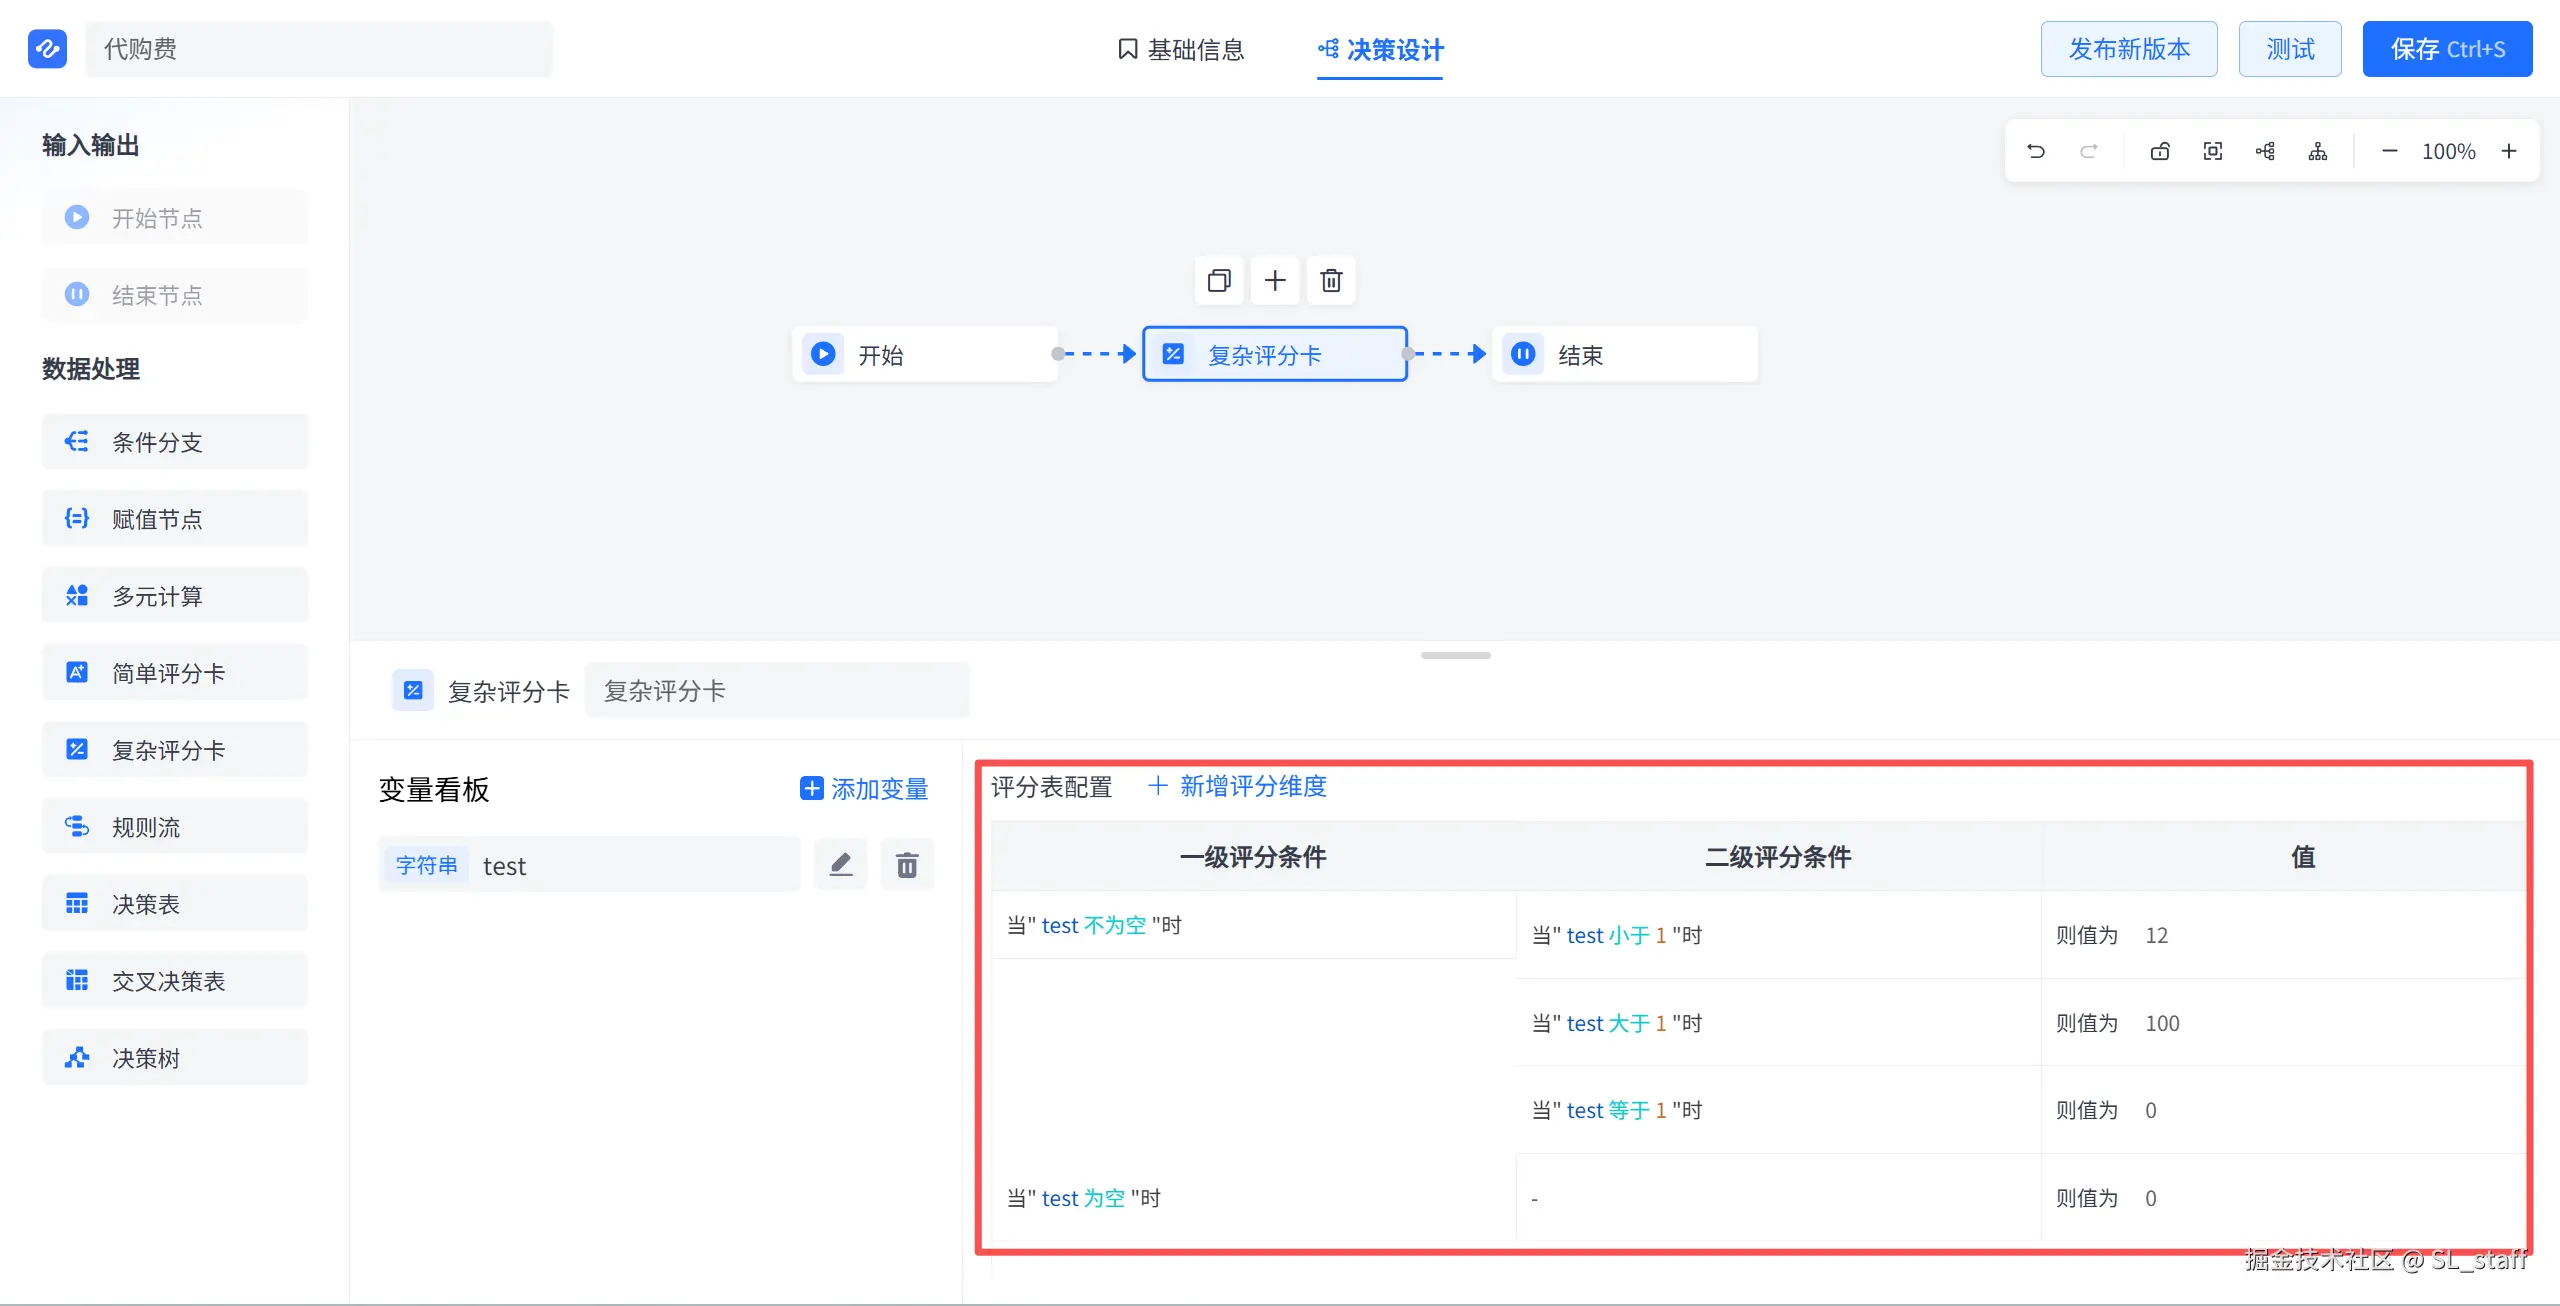
规则表达层:提供决策表、评分卡、决策树等形态,直接将'收入≥5万且征信分>650则自动授信'映射为可执行逻辑;
-
函数计算层:封装常用数据加工能力,包括:
- API调用(查第三方征信);
- SQL聚合(计算近6个月负债比);
- Groovy脚本(实现分段计息逻辑)。
所有能力均服务于一条完整链路:数据接入 → 加工 → 判断 → 服务化暴露 → 执行日志归档 → 审计回溯。
例如:
- 零售信贷负责人可一键发布'准入+评分+额度'三合一规则包;
- 风控经理在评分卡界面调整阈值,无需发版即可生效;
- 数据团队通过前置函数统一校验口径,避免各系统自行实现导致结果偏差。
对比传统方案:为什么'能编码'不等于'该编码'?
| 方案类型 | 典型代表 | 开发者实际投入点 |
|---|---|---|
| 开源BRMS | Drools | 自研配置台、权限体系、执行日志、API网关、监控告警 ------ 这些隐性成本常超商业许可费 |
| 国际BRMS | IBM ODM | 长周期部署、强定制依赖、难以适配国内月度级政策变更节奏 |
更关键的是治理代价:
- 编码主导模式使规则深陷Java方法中,审计时无法定位'为何拒贷';
- 多环境迁移靠人工导出/导入代码片段;
- 异常排查需翻日志+查Git+连调试器------这正是'异常总靠人救火'和'上线后不敢动规则'的根源。
三步自检:你的场景是否适合轻量化规则中枢?
第一步:看判断复杂度
- 若核心逻辑可用条件分支、决策表或评分卡清晰表达(如'客户等级A且订单金额>5万则发放满减券'),无需编码扩展。
第二步:看数据准备方式
- 若主要依赖标准函数即可完成加工(API查征信、DB查历史逾期、SQL算资产负债率),已覆盖90%场景需求。
第三步:看治理诉求
- 若需统一全系统审批口径、跨ERP/CRM/OA调用同一规则、执行日志可供审计复盘、规则包支持测试/生产一键迁移,则轻量化、产品化中枢更具工程优势。
特别提示:仅当存在大量自研模型集成、复杂状态机编排或非标协议解析等极少数场景时,才需审慎评估编码扩展必要性。
写给开发者的结语
选型不是比谁支持更多语法,而是看谁把'规则可维护、可审计、可协同'这件事真正做进了产品内核。少写一行Java,可能就少一个线上故障点;少一次发版,就多一次策略快速响应的机会。