一、引言
元数据可以简单理解为"描述数据的数据",在企业数据平台中,一张表不只是一个存储对象,它有字段、分区、格式、存储路径、生命周期,也有业务含义、负责人、所属主题域、访问热度、任务状态、质量结果和下游消费方,把这些信息拆开看,就形成了技术元数据、业务元数据和操作元数据三类视角。
| 类型 | 关注问题 | 典型字段 | 主要来源 | 治理价值 |
|---|---|---|---|---|
| 技术元数据 | 数据是什么结构,在哪里,如何被系统识别 | 库名、表名、字段、类型、分区、存储位置、格式、创建时间 | Hive Metastore、湖仓目录、数据库系统、消息系统、BI 平台 | 支撑资产发现、目录检索、Schema 变更感知 |
| 业务元数据 | 数据代表什么,谁负责,适用于什么业务场景 | 中文名、业务口径、指标定义、主题域、标签、数据 owner、敏感等级 | 数据标准平台、指标平台、人工维护、审批流程 | 支撑数据理解、责任归属、口径统一 |
| 操作元数据 | 数据如何被生产、使用和运行 | 任务运行状态、访问日志、查询频次、血缘事件、质量检测结果、最近更新时间 | 调度系统、查询引擎、日志系统、质量平台、权限系统 | 支撑可信度判断、冷热分层、影响分析 |
一个常见误区是把元数据平台做成"技术表目录"。这种平台可以查到表名和字段,但业务用户仍然不知道表是否能用、字段含义是什么、数据是否过期、出问题该找谁。真正有价值的元数据治理,必须把技术结构、业务语义和运行事实连起来。
lua
                 +----------------+
                 |   业务元数据    |
                 |  含义/口径/Owner |
                 +--------+-------+
                          |
                          v
+----------------+   +----+-----+   +----------------+
|   技术元数据    |-->| 数据资产 |<--|   操作元数据    |
| 结构/位置/Schema|   |  目录项  |   | 运行/访问/质量  |
+----------------+   +----+-----+   +----------------+
                          |
                          v
                 +----------------+
                 | 数据目录/数据地图 |
                 +----------------+
二、数据目录
数据目录不是简单的"表列表",而是企业数据资产的索引层、语义层和协作层。数据目录的职责不是复制数据,也不是替代数仓或湖仓,而是让用户通过元数据找到可信资产。目录中每个数据资产至少应包含以下信息:
| 目录维度 | 最低可用内容 | 进阶内容 |
|---|---|---|
| 身份标识 | 平台、库、表、字段、唯一 ID | 全局 URN、跨系统映射 ID |
| 技术结构 | 字段、类型、分区、存储位置 | Schema 版本、变更历史、采集时间 |
| 业务语义 | 中文名、描述、主题域 | 指标口径、业务术语、适用场景 |
| 责任归属 | owner、维护团队 | steward、审批人、值班群 |
| 使用情况 | 最近访问时间、查询次数 | 活跃用户、下游报表、消费系统 |
| 可信信号 | 更新时间、质量状态 | SLA、质量分、认证标识 |
| 治理标签 | 敏感等级、生命周期 | 合规分类、共享范围、脱敏策略 |
DataHub 的模型中,Dataset、Chart、Dashboard、Data Job、Data Flow 都是核心实体,且这些实体可以挂载 owner、tag、glossary term、description 等上下文信息;这说明企业目录不应只覆盖表,还应覆盖报表、任务、数据流、指标、模型等更完整的数据资产。
三、资产盘点
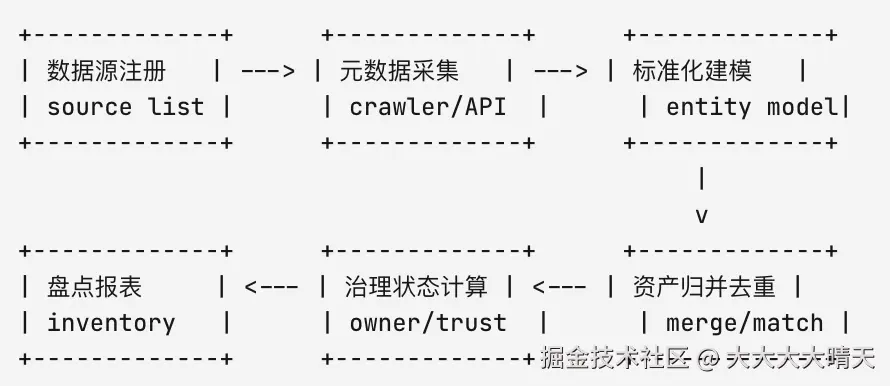
资产盘点要回答"企业到底有多少数据"。这个问题看似简单,实际上容易陷入三个陷阱:不同平台重复统计,临时表和正式表混在一起,技术对象数量和业务资产数量混为一谈。
建议把资产盘点拆成四层口径:
| 盘点层级 | 统计对象 | 典型问题 | 输出结果 |
|---|---|---|---|
| 平台层 | Hive、Iceberg、Kafka、MySQL、S3、BI、调度系统 | 数据分布在哪些系统 | 数据源清单 |
| 技术对象层 | 库、表、字段、Topic、文件集、任务、报表 | 有多少技术对象 | 技术资产台账 |
| 业务资产层 | 主题域、数据产品、指标、宽表、标签、人群包 | 哪些对象真正服务业务 | 业务资产目录 |
| 治理状态层 | 有 owner、无 owner、已认证、待下线、高风险 | 哪些资产可治理 | 治理驾驶舱 |
资产盘点的关键不是一次性扫出"表数量",而是建立持续更新机制。
四、数据地图
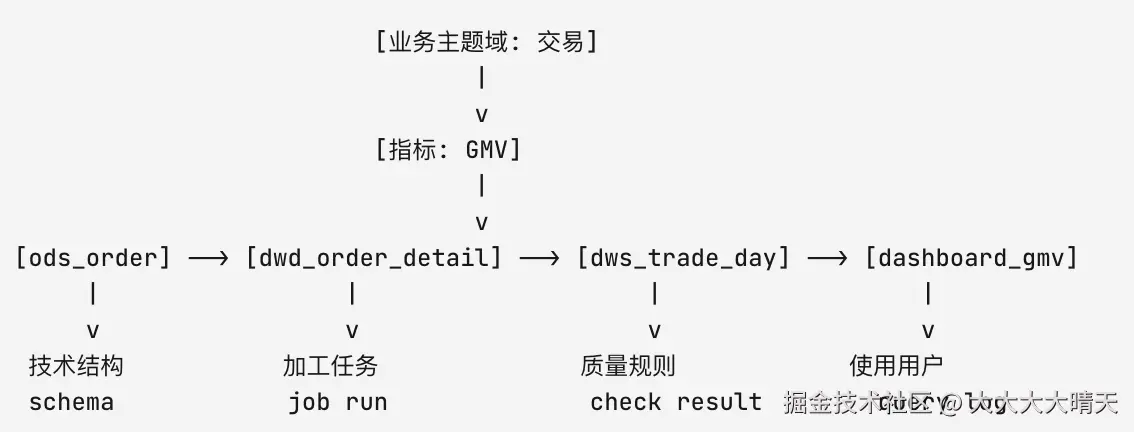
数据地图解决的是"数据之间是什么关系,数据如何被使用"。如果数据目录像图书馆目录,数据地图更像城市交通图:它不仅告诉你站点在哪里,还告诉你线路如何连接、哪里是枢纽、哪里会受影响。
一个完整的数据地图至少包含三类关系:
| 关系类型 | 示例 | 用途 |
|---|---|---|
| 结构关系 | 平台 -> 库 -> 表 -> 字段 | 帮助用户按层级浏览资产 |
| 业务关系 | 主题域 -> 业务过程 -> 指标 -> 数据集 | 帮助用户按业务语义理解资产 |
| 流动关系 | 源表 -> 任务 -> 明细表 -> 汇总表 -> 报表 | 支撑血缘、影响分析、故障定位 |
OpenMetadata 的血缘规范中,血缘表示实体之间的数据流和依赖关系,用于展示数据如何从源头经过转换流向目标,并支持影响分析、根因分析、合规追踪和数据溯源。
五、元数据采集
元数据采集要遵循一个原则:能自动采集的不要人工填,必须人工判断的要有审核和变更记录。技术元数据和操作元数据适合自动采集,业务元数据适合"自动推荐 + 人工确认"。
1.采集对象
| 来源系统 | 采集内容 | 采集方式 | 频率建议 |
|---|---|---|---|
| Hive Metastore / Iceberg Catalog | 库、表、字段、分区、位置、格式 | API、JDBC、Catalog SDK | 每日全量 + 小时级增量 |
| MySQL / PostgreSQL / Oracle | Schema、表、字段、索引、注释 | JDBC、information_schema | 每日 |
| Kafka / Pulsar | Topic、Schema、消费组 | API、Schema Registry | 小时级 |
| Airflow / DolphinScheduler / Azkaban | DAG、任务、依赖、运行状态 | API、数据库、事件日志 | 分钟级或任务完成触发 |
| Spark / Flink | 作业、输入输出、执行 SQL、运行指标 | Listener、日志、OpenLineage | 运行时事件 |
| BI 平台 | 报表、数据集、图表、访问用户 | API、审计日志 | 每日 |
| 查询引擎 | SQL、访问用户、访问时间、扫描量 | 审计日志、query history | 准实时或每日 |
DataHub 把元数据抽象为实体、方面、关系和 URN,其中 aspect 是某个实体的一组属性,也是最小写入单元;这种设计适合把 schema、owner、tag、glossary、profile、status 等不同变化频率的信息拆开更新。
2.采集链路
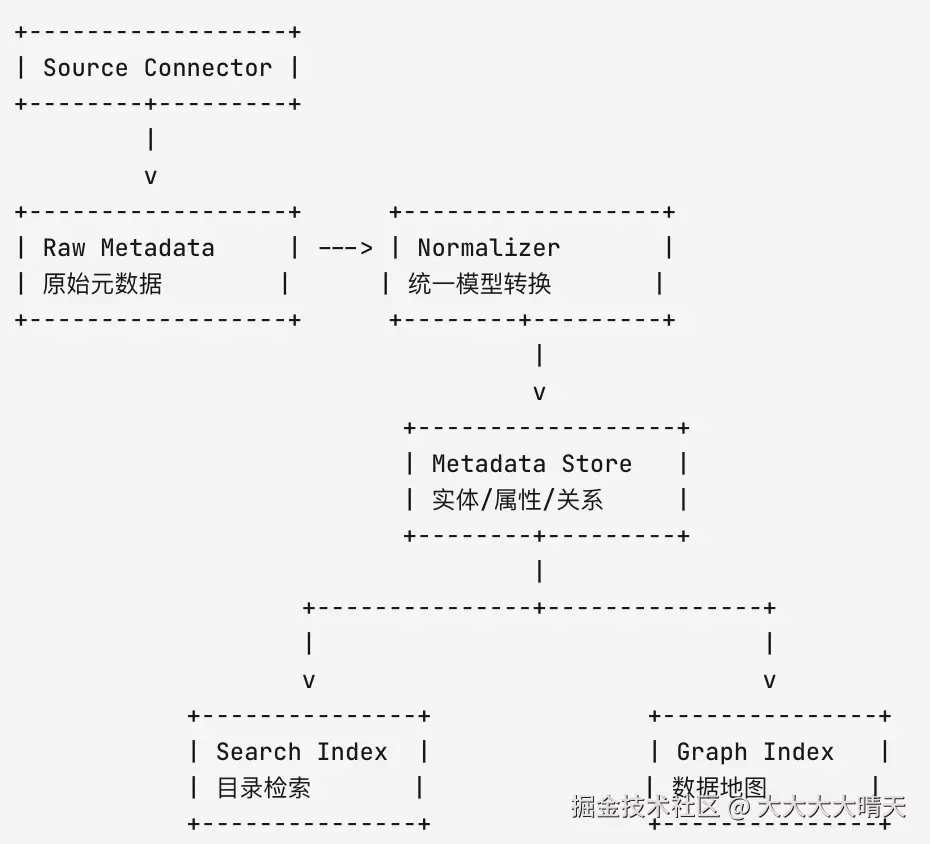
一个工程化的元数据采集链路通常由六部分组成:
| 模块 | 作用 | 设计要点 |
|---|---|---|
| Source Connector | 连接各类源系统 | 支持鉴权、限流、失败重试 |
| Extractor | 抽取原始元数据 | 保留源系统原始字段,便于追溯 |
| Normalizer | 转换为统一模型 | 建立统一资产类型、字段命名和 ID 规则 |
| Matcher | 资产归并与去重 | 处理同一资产在多个系统中的不同名称 |
| Metadata Store | 存储元数据图 | 支持实体、属性、关系、版本 |
| Search Index | 支撑目录检索 | 支持关键词、标签、owner、主题域、热度排序 |
六、统一元模型设计
元数据平台的底层最好采用"实体 + 属性 + 关系"的模型,而不是只设计几张宽表。原因很简单:企业数据资产类型会不断增加,从表、字段、任务、报表,到指标、特征、模型、数据产品,如果模型过早绑定到"表中心",后续扩展会很痛苦。
可以设计如下核心实体:
| 实体 | 含义 | 示例 |
|---|---|---|
| DataPlatform | 数据平台或系统 | Hive、Kafka、MySQL、Tableau |
| Dataset | 数据集 | 表、视图、Topic、文件集 |
| SchemaField | 字段 | order_id、user_id、amount |
| DataJob | 数据处理任务 | Spark 任务、Airflow Task |
| DataFlow | 任务流或 DAG | 每日交易汇总 DAG |
| Dashboard | 报表或看板 | GMV 经营看板 |
| Metric | 指标 | GMV、支付订单数 |
| GlossaryTerm | 业务术语 | 用户、订单、支付成功 |
| Owner | 责任人或团队 | 数据开发组、风控数据团队 |
关系可以这样设计:
| 关系 | 含义 |
|---|---|
| contains | 平台包含库,表包含字段 |
| owns | 人或团队负责资产 |
| belongs_to_domain | 资产属于某个主题域 |
| has_term | 资产关联业务术语 |
| upstream_of | 上游资产流向下游资产 |
| generated_by | 数据集由任务生成 |
| consumed_by | 资产被报表、任务或用户消费 |
| certified_as | 资产被认证为可信数据 |
Relationship 是两个实体之间的命名边,并且可以双向遍历;这类图模型很适合表达 owner、包含关系、上下游依赖和报表消费链路。
ini
(Entity) Dataset: dwd_order_detail
   |
   +--[contains]------> Field: order_id
   +--[contains]------> Field: pay_amount
   +--[owned_by]------> CorpGroup: trade_data_team
   +--[has_term]------> GlossaryTerm: 订单
   +--[generated_by]--> DataJob: spark_dwd_order_daily
   +--[upstream_of]---> Dataset: dws_trade_day
   +--[consumed_by]---> Dashboard: gmv_dashboard
七、目录和盘点指标
数据目录建成之后,平台需要一组指标来衡量治理效果。否则目录很容易变成"大家都知道有,但没人维护"的页面。
| 指标 | 计算口径 | 反映问题 |
|---|---|---|
| 资产总数 | 按平台、类型、主题域统计资产数量 | 企业到底有多少数据 |
| owner 覆盖率 | 有明确 owner 的资产数 / 总资产数 | 责任是否清晰 |
| 描述覆盖率 | 有有效描述的资产数 / 总资产数 | 用户是否能理解 |
| 术语绑定率 | 绑定业务术语的资产数 / 总资产数 | 技术资产是否有业务语义 |
| 活跃资产占比 | 近 N 天被访问或被任务依赖的资产数 / 总资产数 | 哪些数据真正被用 |
| 僵尸资产占比 | 长期无访问、无下游、无 owner 的资产数 / 总资产数 | 哪些数据应归档或下线 |
| 可信资产占比 | 通过认证或质量门禁的资产数 / 总资产数 | 哪些数据可放心使用 |
| 敏感资产识别率 | 已完成敏感分类的资产数 / 应识别资产数 | 安全治理覆盖是否充分 |
这里要注意,"可信"不能只靠人工打标。较合理的做法是组合多个信号:是否有 owner、是否有业务描述、是否有质量规则、最近一次质量结果是否通过、数据是否按 SLA 更新、是否被认证为官方口径。
matlab
可信度评分示例:

owner 覆盖       20%
业务描述         15%
术语绑定         15%
质量规则         20%
SLA 更新         15%
使用活跃         10%
安全分类          5%
--------------------
总分            100%
八、建设落地路径
企业建设元数据治理平台时,不建议一开始就追求大而全。更稳妥的路径是先把"能发现、能检索、能归属"做好,再逐步增强血缘、质量、安全和自动化能力。
第一阶段聚焦技术元数据采集。目标是接入核心数仓、湖仓、数据库、BI 和调度系统,形成统一资产台账。这个阶段的关键验收标准不是界面多好看,而是资产是否采全、唯一 ID 是否稳定、增量更新是否可靠。
第二阶段补充业务元数据。目标是建立主题域、业务术语、指标口径和 owner 机制。业务元数据不能完全依赖平台团队填写,应该把维护责任交还给数据 owner 和数据 steward,平台提供模板、审批和变更记录。
第三阶段接入操作元数据。目标是引入访问日志、任务运行、质量结果、下游消费、最近更新时间等信号,让目录从"可查"变成"可判断"。用户看到一张表时,应能判断它是否活跃、是否按时更新、是否有人负责、是否通过质量校验。
第四阶段建设数据地图。目标是把平台、表、字段、任务、报表、指标和用户连接成图,支撑影响分析、故障定位和安全传播。Atlas 支持分类与血缘结合,并可让分类沿血缘传播,这对敏感数据从源头到下游的识别有现实意义。
rust
阶段 1:资产可见
数据源接入 -> 技术元数据 -> 资产台账

阶段 2:语义可懂
主题域 -> 术语 -> 指标 -> owner

阶段 3:状态可信
任务运行 -> 使用日志 -> 质量结果 -> 可信评分

阶段 4:关系可追
表血缘 -> 字段血缘 -> 报表消费 -> 影响分析
九、与质量、血缘、安全的关系
元数据治理不是数据治理的全部,但它是质量、血缘、安全治理的基础。
质量治理需要知道规则挂在哪个资产、字段含义是什么、owner 是谁、失败后通知谁。血缘治理需要知道资产之间的上下游关系、转换逻辑、任务运行情况和消费端。安全治理需要知道哪些字段敏感、敏感标签如何传播、哪些用户访问过、权限策略如何关联资产。
lua
                 +----------------+
                 |   元数据治理    |
                 +--------+-------+
                          |
        +-----------------+-----------------+
        |                 |                 |
        v                 v                 v
+---------------+ +---------------+ +---------------+
|   质量治理     | |   血缘治理     | |   安全治理     |
| 规则/结果/Owner| | 依赖/影响/溯源 | | 分类/权限/审计 |
+---------------+ +---------------+ +---------------+
因此,企业做治理平台时,不应把元数据模块当作附属功能。目录里没有 owner,质量告警就没人处理;字段没有业务含义,质量规则就难以解释;敏感标签没有血缘传播,安全治理就只能停留在源表层面。
十、统一数据目录建设示例:
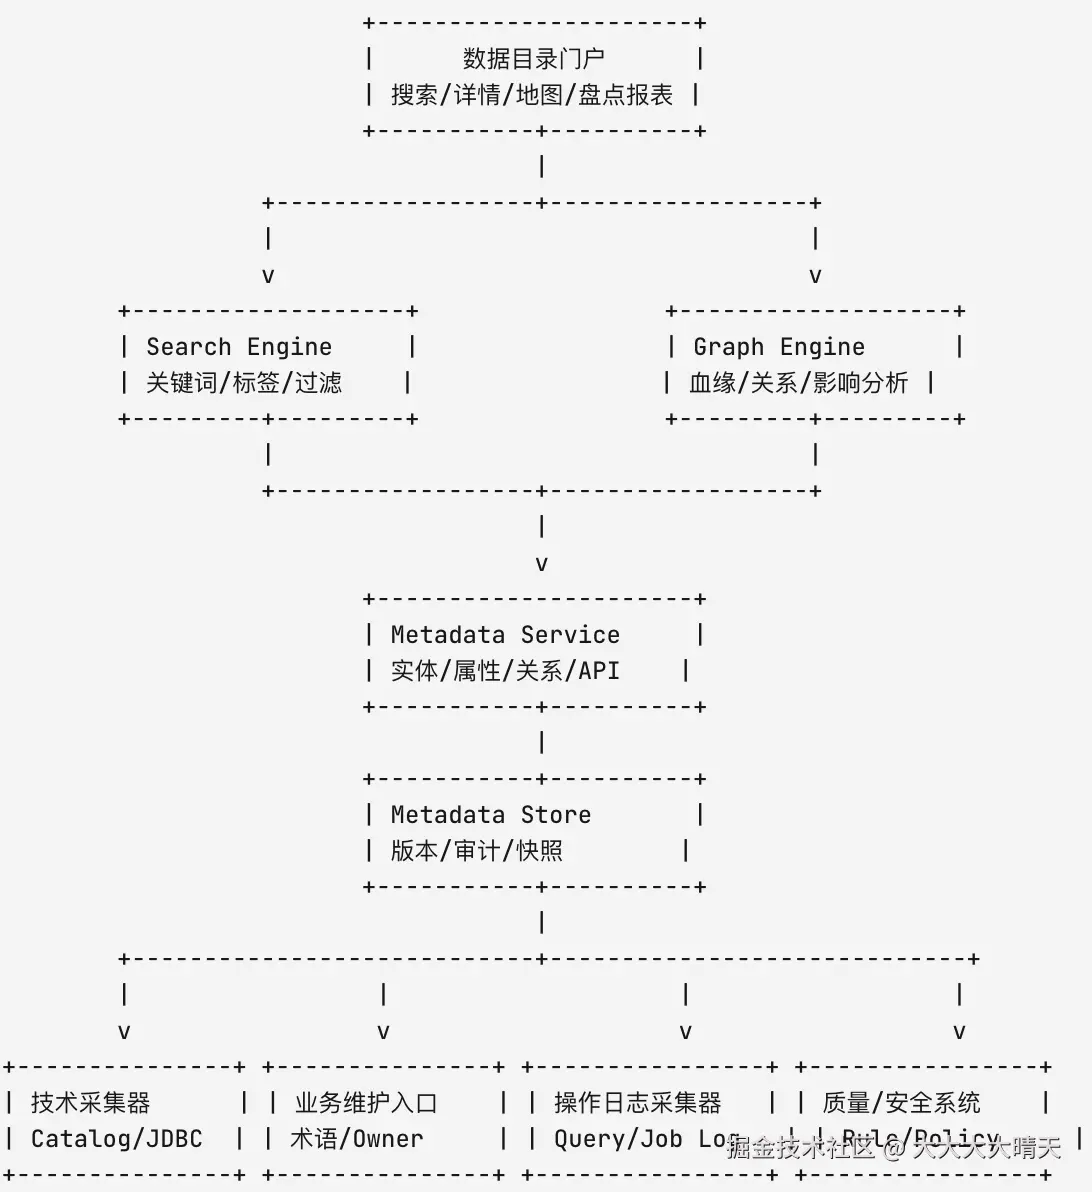
资产详情页字段:
| 区域 | 字段 |
|---|---|
| 基本信息 | 资产名称、类型、平台、环境、库表名、创建时间、更新时间 |
| 结构信息 | 字段列表、类型、注释、分区、Schema 版本 |
| 业务信息 | 中文名、描述、主题域、业务术语、指标口径 |
| 责任信息 | owner、steward、维护团队、告警群 |
| 使用信息 | 查询次数、访问用户、下游报表、最近访问时间 |
| 可信信息 | SLA、质量规则、最近质量结果、认证状态 |
| 安全信息 | 敏感等级、权限策略、脱敏方式、访问审计 |
| 关系信息 | 上游、下游、生成任务、消费任务、关联报表 |