小肥柴的Hadoop之旅 快速实验篇(B16)用户级预测可行性审计(否定性意见)
1. 引言
B15 把协同过滤放到推荐系统任务上,得到的是负结果:在 100 用户 × 20 品类、训练集完全密集、测试集接近全满的数据上,CF 不优于随机,这件事说明推荐系统在这份数据上没有施展空间。
顺着这条线往下想,自然会冒出下一个问题:推荐不行,那用户级预测行不行?
用户级预测有两个经典任务:流失预测 和价值预测。前者判断用户会不会走,后者判断用户会贡献多少。它们在工业界是标配,几乎每本数据挖掘教材都会讲,每个数据平台都会搭。
B16 就是把这个常见问题拿到同一份数据上,看看它能不能成立。试探的结果比 B15 更直接:**流失标签根本不可定义,价值目标有方差但不可预测。**这份底稿记录完整的审计过程。
2. 5 分钟速读
数据底座:100 用户,10 天行为,166770 行。
流失审计:
- 100 用户最后行为日期全部是
2019-07-26 - 100 用户在 10 天窗口内全部每天活跃
- 流失正样本 = 0
价值审计:
- 时间切分:前 7 天历史,后 3 天预测
- 未来 3 天支付次数:均值 22.59,标准差 7.28,范围 8--41
- 6 个历史特征与未来支付的最大 Pearson 相关 = 0.208
- 最大单变量 AUC = 0.584
- 历史支付次数与未来支付次数的相关性 = 0.057
回归基线(MAE 越低越好):
| 模型 | MAE | RMSE |
|---|---|---|
| 全局均值 | 5.97 | 7.24 |
| 历史支付次数(3/7 缩放) | 7.03 | 8.58 |
| 线性回归 5 折 CV | 6.15 | 7.45 |
全局均值最优,任何模型都打不过它。
结论:用户级预测在这份数据上不可行,不是模型不够复杂,而是任务不成立。
3. 实验定位
3.1 名称
B16 用户级预测可行性审计:流失标签审计 + 价值目标审计
3.2 来源
原计划里,B16 是用户流失预测,B17 是用户价值预测。两者都是用户级预测,都在同一份数据上,都要回答"能不能预测"这个问题。合并成一个实验,做一次审计,比拆两个实验更省事,也更清楚。
B18--B20 取消,B17 改为 B 组实验总结。
3.3 目标
B16 不是要建一个能上线的流失模型或价值模型。它要回答三个更前置的问题:
- 流失标签能不能定义?
- 价值目标有没有可预测的方差?
- 如果前两条都成立,简单模型能不能超过基线?
如果前两条不成立,第三条不必做。
4. 数据底座
4.1 主表结构
主表 dwd_user_behavior,字段 31 个,分区字段 dt。关键字段:
| 字段 | 类型 | 说明 |
|---|---|---|
| user_id | bigint | 用户 ID |
| session_id | string | 会话 ID |
| behavior_type | string | 行为类型 |
| action_time | string | 行为时间 |
| ts | timestamp | 时间戳 |
| click_category_id | bigint | 点击品类 |
| order_category_ids | array<string> | 下单品类 |
| pay_category_ids | array<string> | 支付品类 |
行为类型有四种:
| 行为 | 行数 |
|---|---|
| click | 111310 |
| search | 37115 |
| order | 10887 |
| pay | 7458 |
4.2 时间范围与用户规模
口径 dt < '2019-07-27':
- 最小日期:2019-07-17
- 最大日期:2019-07-26
- 天数:10
- 用户数:100
- 总行数:166770
10 天窗口,100 用户。这是 B16 的全部样本。
4.3 用户活跃天数分布
sql
SELECT active_days, COUNT(*) AS user_cnt
FROM (
  SELECT user_id, COUNT(DISTINCT dt) AS active_days
  FROM dwd_user_behavior
  WHERE dt < '2019-07-27'
  GROUP BY user_id
) t
GROUP BY active_days
ORDER BY active_days;
结果:
active_days  user_cnt
10           100
100 个用户,10 天全部活跃。 没有一个用户在某天缺席。
这一条直接决定了流失标签的下场。
5. 审计设计:为什么先审计再建模
常见做法是拿到数据直接上模型:切分、训练、验证、调参。B12--B15 的经验反复提醒同一件事:这份数据的结构问题发生在建模之前。
用户全部活跃,说明流失标签可能不存在。
用户全部活跃,也可能意味着用户之间差异极小,价值目标难以区分。
审计的意义在于:先确认任务能不能定义、目标有没有信号,再决定是否建模。 这一步如果跳过,模型跑出来会很难解释------AUC 接近 0.5 是数据问题还是模型问题,说不清。
审计流程分四步:
- 流失标签审计:标签能不能构造。
- 价值目标审计:目标有没有方差。
- 相关性审计:历史特征能不能预测未来目标。
- 条件建模:前三条都通过才跑模型,否则只跑基线。
6. 流失标签审计
6.1 什么是流失
定义:流失是用户在某个时间点之后不再活跃。
类比:像常客突然不再光顾一家店,从某天起再也没出现。
本项目用途:判断用户是否流失,是流失预测的第一步。没有明确的流失定义,就没有可训练的分类任务。
6.2 审计查询
流失定义的关键是"最后行为日期"。如果所有用户的最后行为日期都落在数据截止日,说明没有用户流失。
sql
SELECT last_dt, COUNT(*) AS user_cnt
FROM (
  SELECT user_id, MAX(dt) AS last_dt
  FROM dwd_user_behavior
  WHERE dt < '2019-07-27'
  GROUP BY user_id
) t
GROUP BY last_dt
ORDER BY last_dt;
6.3 结果
last_dt     user_cnt
2019-07-26  100
100 个用户的最后行为日期全部是 2019-07-26。
6.4 解读
三个事实同时发挥作用:
- 用户活跃天数全部 = 10
- 用户最后行为日期全部 = 2019-07-26
- 数据截止日前一天(07-26)仍有 100 人活跃
流失标签的候选定义是"未来 N 天无行为"。而在这份数据上,未来 N 天(不论 N 取多少)都有行为,正样本 = 0。
**流失分类任务不可定义,分类审计终止。**这一步不需要跑逻辑回归,不需要算 AUC。任务是空的,模型无从谈起。
7. 价值目标审计
7.1 什么是价值目标
定义:价值目标是用户在预测窗口内贡献的行为量,比如未来 N 天的支付次数。
类比:预测一家店未来一周的营业额。
本项目用途:价值预测的目标变量,通常用未来支付次数、金额、订单数来度量。
7.2 时间切分
价值目标必须按时间切分,否则历史特征会包含未来信息,造成时间泄漏。
时间泄漏的定义:训练特征中混入了预测时点之后才有的数据,模型看起来很强,实际不能用。
类比:用考试成绩预测考试分数,当然准,但没意义。
本项目用途:切出历史窗口和未来窗口,历史窗口特征预测未来窗口目标。
切分方案:
- 历史窗口:
dt <= '2019-07-23',07-17 至 07-23,共 7 天 - 未来窗口:
dt > '2019-07-23',07-24 至 07-26,共 3 天
7 天历史,3 天未来,窗口比例 7:3。10 天总窗口下,这是唯一合理切分。
7.3 未来支付次数分布
sql
SELECT future_pay_cnt, COUNT(*) AS user_cnt
FROM (
  SELECT u.user_id, COUNT(p.user_id) AS future_pay_cnt
  FROM (SELECT DISTINCT user_id FROM dwd_user_behavior WHERE dt < '2019-07-27') u
  LEFT JOIN dwd_user_behavior p
    ON u.user_id = p.user_id
   AND p.dt > '2019-07-23'
   AND p.behavior_type = 'pay'
  GROUP BY u.user_id
) t
GROUP BY future_pay_cnt
ORDER BY future_pay_cnt;
结果:
| 指标 | 值 |
|---|---|
| 均值 | 22.59 |
| 标准差 | 7.28 |
| 最小值 | 8 |
| 最大值 | 41 |
| 零值比例 | 0 |
未来支付次数分布覆盖 8 到 41,均值 22.59,标准差 7.28,没有零值用户。
从纯统计角度看,目标有方差,看起来可以回归。
7.4 分布图解读
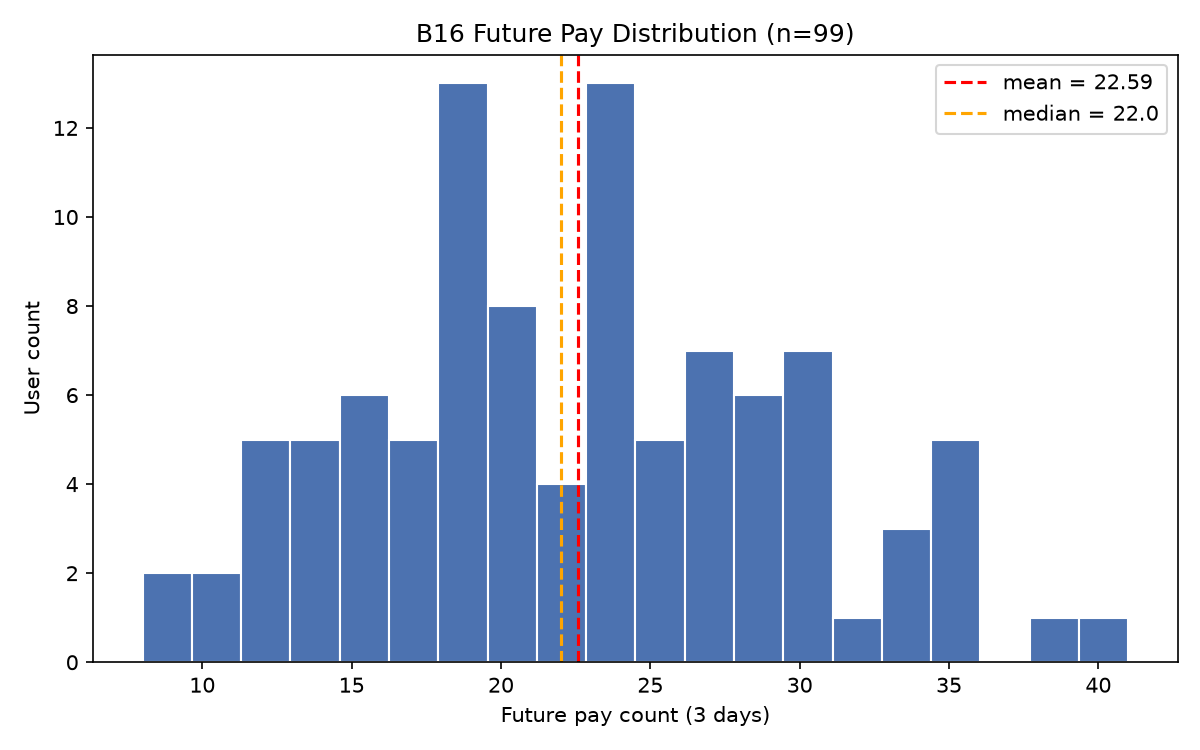
均值 22.59,中位数 22.0,两者几乎重合;分布大致对称,集中在 18--30 区间;没有明显长尾,也没有极值。这张图给出的信息是:
- 目标有方差,回归任务形式上可行。
- 方差范围适中,不是接近常量的退化数据。
- 分布的形状接近正态,无异常结构。
到这一步,价值目标的审计结论是"看起来能做",但"看起来能做"和"实际能做"是两件事;要判断目标能不能被预测,必须看它和历史特征有没有关系。
8. 历史特征与未来目标的相关性
8.1 什么是相关性
定义:相关性衡量两个变量同时变化的程度,取值 -1, 1,0 表示无关。
类比:身高和体重同向变化,相关系数为正;鞋码和 IQ 无关,相关系数接近 0。
本项目用途:如果历史行为与未来支付有相关性,说明历史特征有预测价值;如果相关性接近 0,说明历史信息不能帮助预测。
8.2 特征构造
从 dwd_user_behavior 历史窗口(dt <= '2019-07-23')构造 6 个用户级特征:
| 特征 | 含义 |
|---|---|
| hist_click | 历史点击次数 |
| hist_search | 历史搜索次数 |
| hist_order | 历史下单次数 |
| hist_pay | 历史支付次数 |
| hist_active_days | 历史活跃天数 |
| hist_session | 历史会话数 |
历史窗口内出现过的用户共 99 个。用户 20 在历史窗口内没有任何行为记录,被 GROUP BY 过滤掉。
8.3 三组相关性指标
-
Pearson 相关系数:衡量线性相关,对极端值敏感。
-
Spearman 相关系数:衡量单调相关,对极端值不敏感。
-
AUC:单变量区分度,把未来支付次数按中位数二值化后,看特征能不能区分正负样本。
三组指标结合,能避免单一指标误判。
8.4 结果
| 特征 | Pearson | p | Spearman | p | AUC |
|---|---|---|---|---|---|
| hist_click | 0.170 | 0.093 | 0.209 | 0.038 | 0.577 |
| hist_search | 0.166 | 0.100 | 0.223 | 0.027 | 0.584 |
| hist_order | 0.208 | 0.039 | 0.208 | 0.039 | 0.573 |
| hist_pay | 0.057 | 0.577 | 0.074 | 0.465 | 0.510 |
| hist_active_days | 常量 7 | --- | --- | --- | --- |
| hist_session | 0.136 | 0.179 | 0.168 | 0.097 | 0.550 |
8.5 逐项解读
-
hist_click,Pearson 0.170。点击次数与未来支付弱相关。100 样本下 Pearson 的标准误约 0.1,0.170 落在 1.7 倍标准误,属于不显著。
-
hist_search,Pearson 0.166。与点击类似。Spearman 0.223 略高,但同样不构成强信号。
-
hist_order,Pearson 0.208。这是六个特征里相关性最高的。p = 0.039,勉强过 0.05。但 6 个特征同时比较时,Bonferroni 校正后阈值是 0.0083,0.039 不通过。100 样本下的 0.208 属于噪声范围内的偶然。
-
hist_pay,Pearson 0.057。历史支付次数与未来支付次数几乎无关。这一条对价值预测最致命------如果连"用户之前付过钱"都不能预测"用户之后会付钱",价值回归没有立足点。
-
hist_active_days 是常量 7。所有 99 个用户在历史窗口全部 7 天活跃。常量列无法计算相关性,也无法提供区分信息。
-
hist_session,Pearson 0.136。会话数与未来支付弱相关,不显著。
8.6 AUC 补充解读
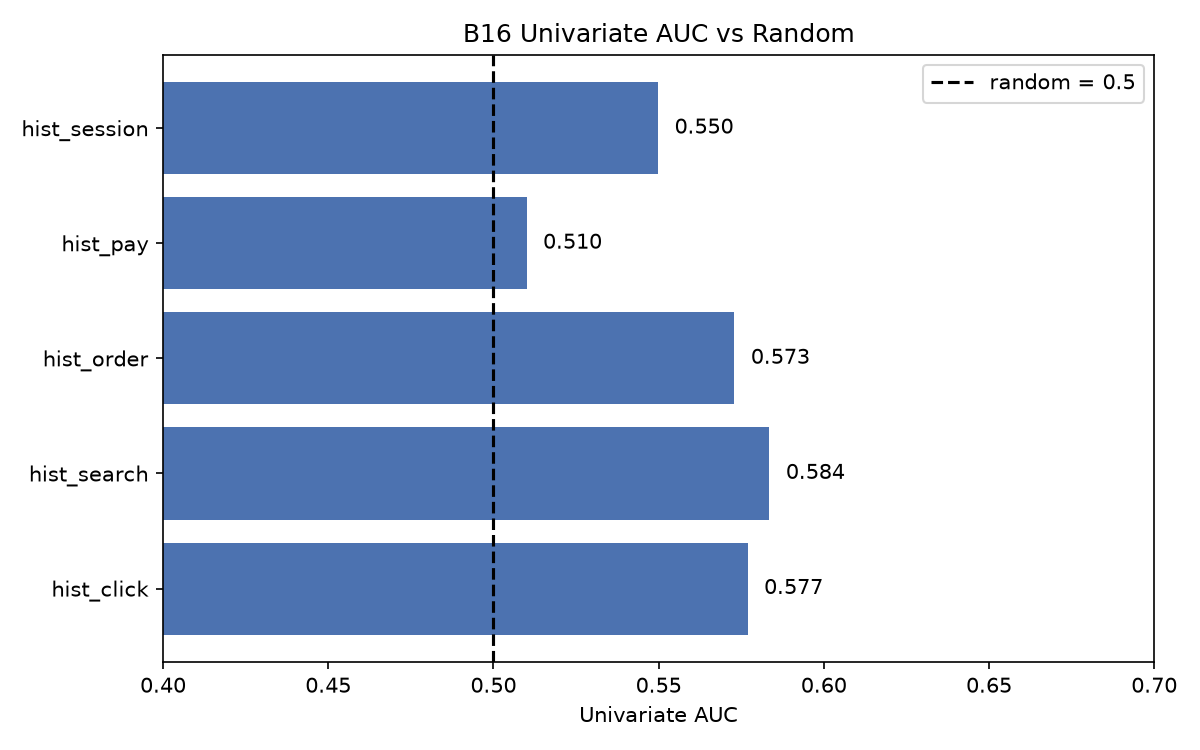
AUC 值从 0.510 到 0.584,全部落在 0.5--0.6 区间。100 样本下 AUC 的标准误约 0.058,95% 置信区间约 0.47, 0.69,全部包含 0.5。没有单变量显著优于随机。
8.7 相关性审计结论
六条结论:
- 历史特征与未来支付的相关性全部很弱,最大 Pearson 0.208,最大 AUC 0.584。
- 相关性最强的是
hist_order,但在多重比较下不成立。 hist_pay与未来支付几乎无关(r=0.057,AUC=0.510),价值回归没有信号源。hist_active_days是常量,无区分力。- 6 个特征同时比较,Bonferroni 校正后没有一个显著。
- 从散点图看,所有特征与未来支付都是一团云,没有斜率。
价值目标有方差,但方差与历史特征无关。价值回归不具备可预测性。
9. 回归基线与模型对照
9.1 为什么还要跑回归
相关性审计已经说明特征无预测力。再跑一次回归,不是为了推翻这个结论,而是为了把"不可预测"的量级定下来。
三个模型:
- 全局均值基线:预测值恒为未来支付次数的全局均值。
- 历史支付次数(3/7 缩放):用历史 7 天支付次数乘 3/7,当作未来 3 天的预测。
- 线性回归 5 折 CV:用 5 个历史特征做线性回归,5 折交叉验证。
全局均值基线是最低要求。任何模型如果打不过它,就没有实用价值。
9.2 结果
| 模型 | MAE | RMSE | 相对全局均值 |
|---|---|---|---|
| 全局均值 | 5.97 | 7.24 | 基线 |
| 历史支付次数(3/7 缩放) | 7.03 | 8.58 | 差 17.9% |
| 线性回归 5 折 CV | 6.15 | 7.45 | 差 3.0% |
9.3 图解读
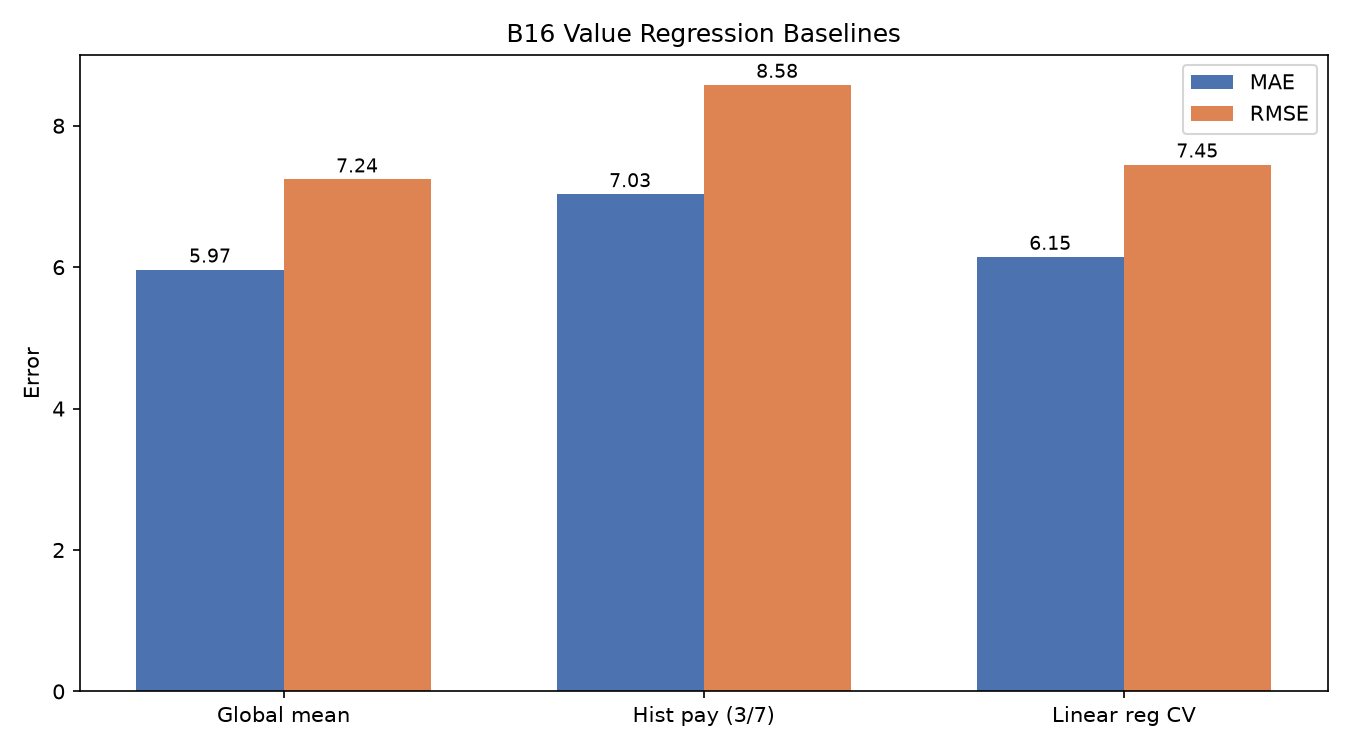
三组对比:
- 全局均值 MAE 5.97,是所有模型里最低的。
- 历史支付次数按 3/7 缩放后 MAE 7.03,比全局均值差 17.9%。
- 线性回归 MAE 6.15,比全局均值差 3.0%。
RMSE 的排序一致:全局均值 7.24 最低,线性回归 7.45,缩放版 8.58。
9.4 解读
模型加特征加复杂度,误差反而变大。
线性回归在 5 个特征上学到的系数,本质是拟合噪声。100 样本 5 个特征,模型自由度相对样本量偏高。交叉验证把过拟合暴露出来:训练时看着好,验证时不如均值。
历史支付次数按时间缩放后仍不优于均值,说明即使做了量纲对齐,历史信息也不能帮助预测未来。这一条排除了"基线不公平"的质疑。
全局均值最优,意味着用户之间没有可利用的系统差异。 一个统一的中心值就能达到最优预测。
9.5 与相关性审计的呼应
相关性审计给出"历史特征与未来支付无关",回归基线给出"任何模型都不如均值"。两个结论一致,互相印证。
价值回归不可行。
10. 产出表
B16 产出两张 ADS 表。
10.1 ads_prediction_feasibility
预测可行性审计表,两行:一行流失,一行价值。
| 字段 | churn 行 | value 行 |
|---|---|---|
| task | churn | value |
| target_def | 未来N天无行为 | 未来3天支付次数 |
| time_split | 不适用 | 前7天历史 / 后3天预测 |
| data_window | 2019-07-17 至 2019-07-26 | 2019-07-17 至 2019-07-26 |
| n_users | 100 | 99 |
| target_mean | NULL | 22.59 |
| target_std | NULL | 7.28 |
| target_min | NULL | 8 |
| target_max | NULL | 41 |
| zero_rate | NULL | 0.0 |
| positive_rate | 0.0 | NULL |
| max_feature_corr | NULL | 0.2076 |
| max_feature_name | NULL | hist_order |
| max_auc | NULL | 0.5835 |
| max_auc_name | NULL | hist_search |
| baseline_metric | NULL | 均值基线 |
| conclusion | 分类任务不可定义 | 价值回归不可行 |
| reason | 100用户最后行为日期全部为2019-07-26,流失正样本为0 | 历史特征与未来支付最大相关性0.208,最大AUC 0.584,均不显著;历史支付次数与未来支付次数几乎无关(r=0.057) |
10.2 ads_user_value_baseline
价值回归基线表,四行。
| model_name | method | mae | rmse | vs_baseline | note |
|---|---|---|---|---|---|
| global_mean | 全局均值基线 | 5.9655 | 7.2405 | 基线 | 预测值恒为22.59,最优基线 |
| user_hist_pay | 用户历史支付次数 | 29.5657 | 32.2827 | 差396% | 7天量纲硬套3天目标,不公平基线 |
| user_hist_pay_scaled | 用户历史支付次数(3/7缩放) | 7.0317 | 8.5785 | 差17.9% | 同尺度下仍不优于全局均值 |
| linear_reg | 线性回归5折CV | 6.1457 | 7.4515 | 差3.0% | 5特征100样本,学噪声,不优于均值 |
10.3 不产出 ads_user_churn_score
流失标签不可定义,因此不产出用户流失分数表。如果强行产出,只能标注"无业务意义",反而误导下游。
这也是 B16 的一个设计选择:不可行的任务不产出可消费的资产。
11. 可视化
B16 共 4 张图。
| 图 | 文件 | 内容 |
|---|---|---|
| 未来支付分布 | b16_future_pay_dist.png | 未来 3 天支付次数直方图 |
| 六宫格散点 | b16_feature_scatter.png | 6 个特征 vs 未来支付 |
| 单变量 AUC | b16_univariate_auc.png | 特征区分度条形图 |
| 回归基线 | b16_value_baseline.png | MAE / RMSE 三模型对比 |
11.1 六宫格散点
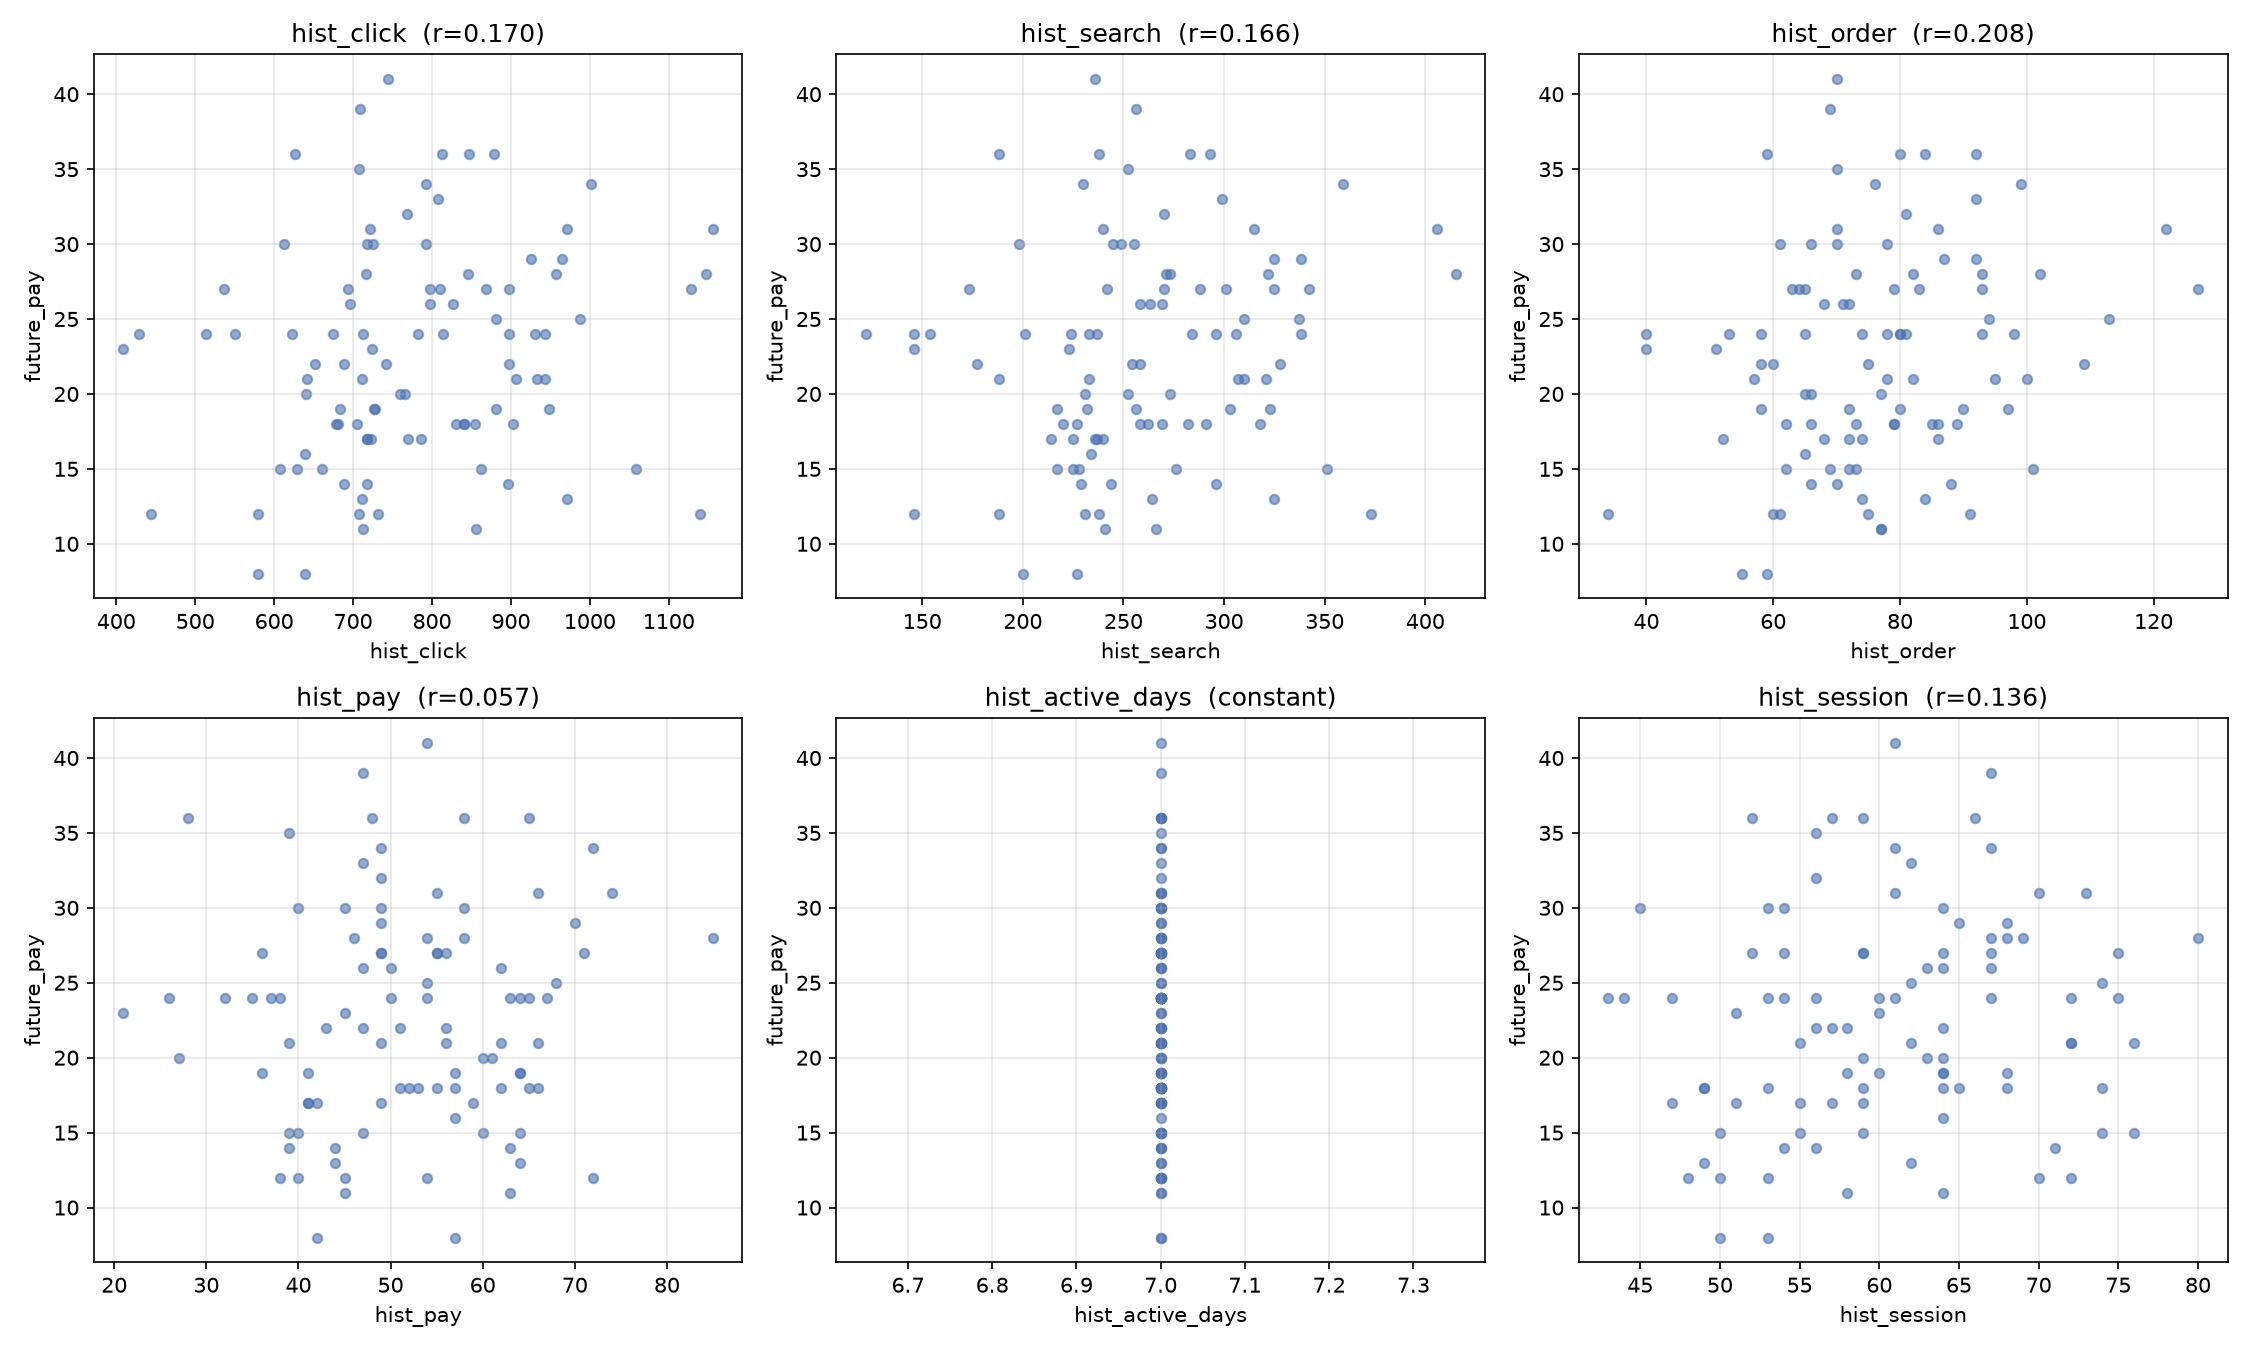
六张散点图,五张是一团云,一张是竖线。
五张散点图的共性:横轴是历史特征,纵轴是未来支付次数,所有点随机散落,没有斜率。相关系数分别标注在标题里,从 0.057 到 0.208。
第六张是常量 :hist_active_days 恒为 7,所有点落在一条竖线上。
这张图是 B16 最直观的视觉证据。任何人看到这六张图,都能得出"历史特征不预测未来目标"的结论。
11.2 单变量 AUC 条形图
五根条形,最短的是 hist_pay(0.510),最长的是 hist_search(0.584)。虚线标注随机基线 0.5,所有条形都在虚线右边一点,但都接近虚线。
视觉结论:区分度接近随机。
12. 与 B15 的呼应
B15 的结论是"协同过滤不优于随机"。B16 的结论是"用户级预测不可行"。
两份实验看起来任务不同,其实在回答同一个问题:
这份数据能支撑什么级别的建模?
| 维度 | B15 | B16 |
|---|---|---|
| 任务 | 品类推荐 | 用户级预测 |
| 数据前提 | 偏好差异 / 物品区分度 / 未观测项 | 标签可定义 / 目标有方差 / 特征有信号 |
| 前提是否成立 | 全部不成立 | 全部不成立 |
| 结论 | CF 不优于随机 | 模型不优于均值 |
两条线索合起来:
这份数据不支持协同过滤,也不支持用户级预测。 它是一份结构性均匀的合成数据,用户之间没有真实差异,行为序列没有可学习的信号。
13. B 组方法论主线
截至 B16,B 组主线是:
| 实验 | 对照 | 结论 |
|---|---|---|
| B11 | 规则分层 vs K-means | 规则胜 |
| B12 | Z-score / 卡方 vs iForest | 简单不输 |
| B13 | 规则分组 vs K-means | 规则胜 |
| B14 | PCA / LDA / t-SNE / DBSCAN | 高级制造假结构 |
| B15 | CF vs 随机 / 热门 / 规则 | CF 不优于随机 |
| B16 | 均值基线 vs 用户历史 / 线性回归 | 均值基线最优 |
主线:简单方法 ≥ 高级方法,在合成数据、小样本、无外部标签的条件下反复成立。
合成数据铁证:B12 三条 + B13 三条 + B14 一条 + B15 一条 + B16 一条,共 9 条。
B16 的贡献是把这个主线从"推荐"扩展到"预测"。结论一致:数据的信息量决定模型的上限,模型复杂度无法突破数据本身的结构。
14. 结论
14.1 核心结论
- 流失标签不可定义。100 用户最后行为日期全部为 2019-07-26,正样本 = 0。
- 价值目标有方差但不可预测。未来 3 天支付次数均值 22.59,标准差 7.28,但与 6 个历史特征的最大相关性 0.208,最大 AUC 0.584。
- 历史支付次数与未来支付次数几乎无关(r=0.057)。价值预测缺少最基本的信号。
- 任何模型都不优于全局均值。线性回归 MAE 6.15,历史支付次数缩放版 7.03,全局均值 5.97。
- 用户级预测在这份数据上不可行,不是模型问题,而是任务不成立。
14.2 负结果的正面意义
负结果不是空跑。B16 给出三件东西:
- 一份明确的审计流程:先检查标签可定义性,再检查目标方差,再检查特征相关性,最后才条件建模。
- 一套可复用的审计表结构:
ads_prediction_feasibility记录任务是否成立,ads_user_value_baseline记录基线对比。 - 一条方法论证据:简单基线在小样本、弱信号条件下仍然是最优解。
14.3 什么时候需要更高复杂度
用户级预测在 B16 上失败,不代表它在所有数据上都失败。需要满足至少一条:
- 用户之间存在真实差异,比如活跃度、消费能力、偏好。
- 目标有可解释的方差来源,比如季节性、促销、生命周期。
- 历史行为与未来目标有明确因果链。
三条都不满足时,任何模型都只是拟合噪声。
15. 局限与边界
-
样本量
- 100 用户,10 天。样本量小,统计效力低。相关性审计里的 p 值在不显著边缘反复徘徊,一部分原因是样本不够。
- 这不改变 B16 的结论,因为"信号不存在"和"样本太小测不出信号"在工程上导向同样的处理方式,不值得投入更复杂的模型。
-
合成数据
- 这份数据是合成的,用户行为高度均匀。真实电商数据中,用户差异通常远大于这里。
- B16 的结论应限定在这份数据的范围内,不推广到所有用户级预测任务。
-
时间窗口
- 10 天总窗口下,切分为 7 天历史、3 天未来。更长的历史窗口可能带来更多特征,但也可能继续是均匀行为。B16 没有测试更多切分方案。
-
用户 20
- 用户 20 在历史窗口(07-17 至 07-23)无行为,全窗口有行为。它被
GROUP BY过滤,价值审计样本为 99。这一条要在记录里注明,但不足以改变结论。
- 用户 20 在历史窗口(07-17 至 07-23)无行为,全窗口有行为。它被
16. 坑点速查
| 坑 | 表现 | 解法 |
|---|---|---|
| Hive 保留字 | AS rows 报 ParseException |
换别名 row_cnt |
hive -f 找不到表 |
Table not found |
HQL 首行加 USE b_group; |
INSERT ... VALUES 多行类型不匹配 |
Argument type mismatch | 改 UNION ALL + 显式 CAST(NULL AS 类型) |
| HDFS 安全模式 | SafeModeException |
hdfs dfsadmin -safemode get,必要时 leave |
| Python 输出目录不存在 | Cannot save file into a non-existent directory |
os.makedirs(OUT, exist_ok=True) |
| 常量列相关性 | ConstantInputWarning |
显式识别常量列,跳过并记录 |
comm 排序不一致 |
input is not in sorted order |
两边都用默认字典序 sort,不要用 sort -n |
17. 关键数字速查
数据底座
用户数                 100
天数                   10(2019-07-17 至 2019-07-26)
总行数                 166770
行为分布:
  click                111310
  search               37115
  order                10887
  pay                  7458
用户活跃天数           全部 = 10
用户最后行为日期       全部 = 2019-07-26
流失审计
流失正样本             0
分类任务              不可定义
价值审计
切分                   前 7 天历史 / 后 3 天预测
历史窗口覆盖用户       99 / 100(缺用户 20)
未来支付次数:
  均值                 22.59
  标准差               7.28
  最小值               8
  最大值               41
  零值比例             0
相关性
hist_click             r=0.170  p=0.093  AUC=0.577
hist_search            r=0.166  p=0.100  AUC=0.584
hist_order             r=0.208  p=0.039  AUC=0.573
hist_pay               r=0.057  p=0.577  AUC=0.510
hist_active_days       常量 7
hist_session           r=0.136  p=0.179  AUC=0.550
回归基线
全局均值               MAE=5.97  RMSE=7.24
历史支付次数缩放       MAE=7.03  RMSE=8.58
线性回归 5 折 CV       MAE=6.15  RMSE=7.45
ADS 表
ads_prediction_feasibility  2 行
ads_user_value_baseline     4 行
18. 附录:文件清单
HQL 脚本 (/home/hadoop/b16/sql/)
- b16_step0_target_audit.hql
- b16_step0_corr_audit.hql
- b16_step4_build_feasibility.hql
- b16_step4_build_value_baseline.hql
Python 脚本 (D:\py_code\douban\src\)
- b16_step0_corr_audit.py
- b16_step4_value_baseline.py
- b16_step4_value_baseline_b.py
- b16_step5_visualize.py
输出文件 (D:\py_code\douban\src\b16_output\)
- b16_step0_corr_audit.tsv
- b16_step0_corr_result.tsv
- b16_step0_auc_result.tsv
- b16_step4_value_baseline.tsv
- b16_future_pay_dist.png
- b16_feature_scatter.png
- b16_univariate_auc.png
- b16_value_baseline.png
Linux 导出 (/home/hadoop/b16/export/)
- b16_step0_corr_audit.tsv
HDFS
- /b_group/ads/ads_prediction_feasibility/
- /b_group/ads/ads_user_value_baseline/
日志 (/home/hadoop/b16/logs/)
- step0_show_tables_*.log
- step0_desc_dwd_behavior_*.log
- step0_desc_ods_action_*.log
- step0_desc_b14_wide_*.log
- step0_time_range_*.log
- step0_active_days_*.log
- step0_behavior_type_*.log
- step0_target_audit_*.log
- step0_b14_wide_scope_*.log
- step0_corr_audit_*.log
- step0_user20_check_*.log
- step4_build_feasibility_*.log
- step4_build_value_baseline_*.log