你要本地部署字节跳动的 Protenix 跑蛋白-核酸-配体-抗体结构预测,官方 README 信息分散。这篇以官方 README + docs/ + inference_demo.sh + finetune_demo.sh + Dockerfile + CHANGELOG 为唯一信源,在 Ubuntu 22.04 / Python 3.11 端到端转写命令:原理、特点、零基础教程、模型权重速查与踩坑速查。你照官方原文命令一步步跑通推理与微调,权重选择直接查第六节速查表。
实测环境:Ubuntu 22.04 / Python 3.11.16 / 12GB GPU / driver 580 / CUDA 12.4(命令基于官方文档转写,2026-09-12 已在本机端到端跑通推理并回填实测数据,见 §5.0 / §5.0.1) 项目地址:GitHub - bytedance/Protenix: Toward High-Accuracy Open-Source Biomolecular Structure Prediction. · GitHub
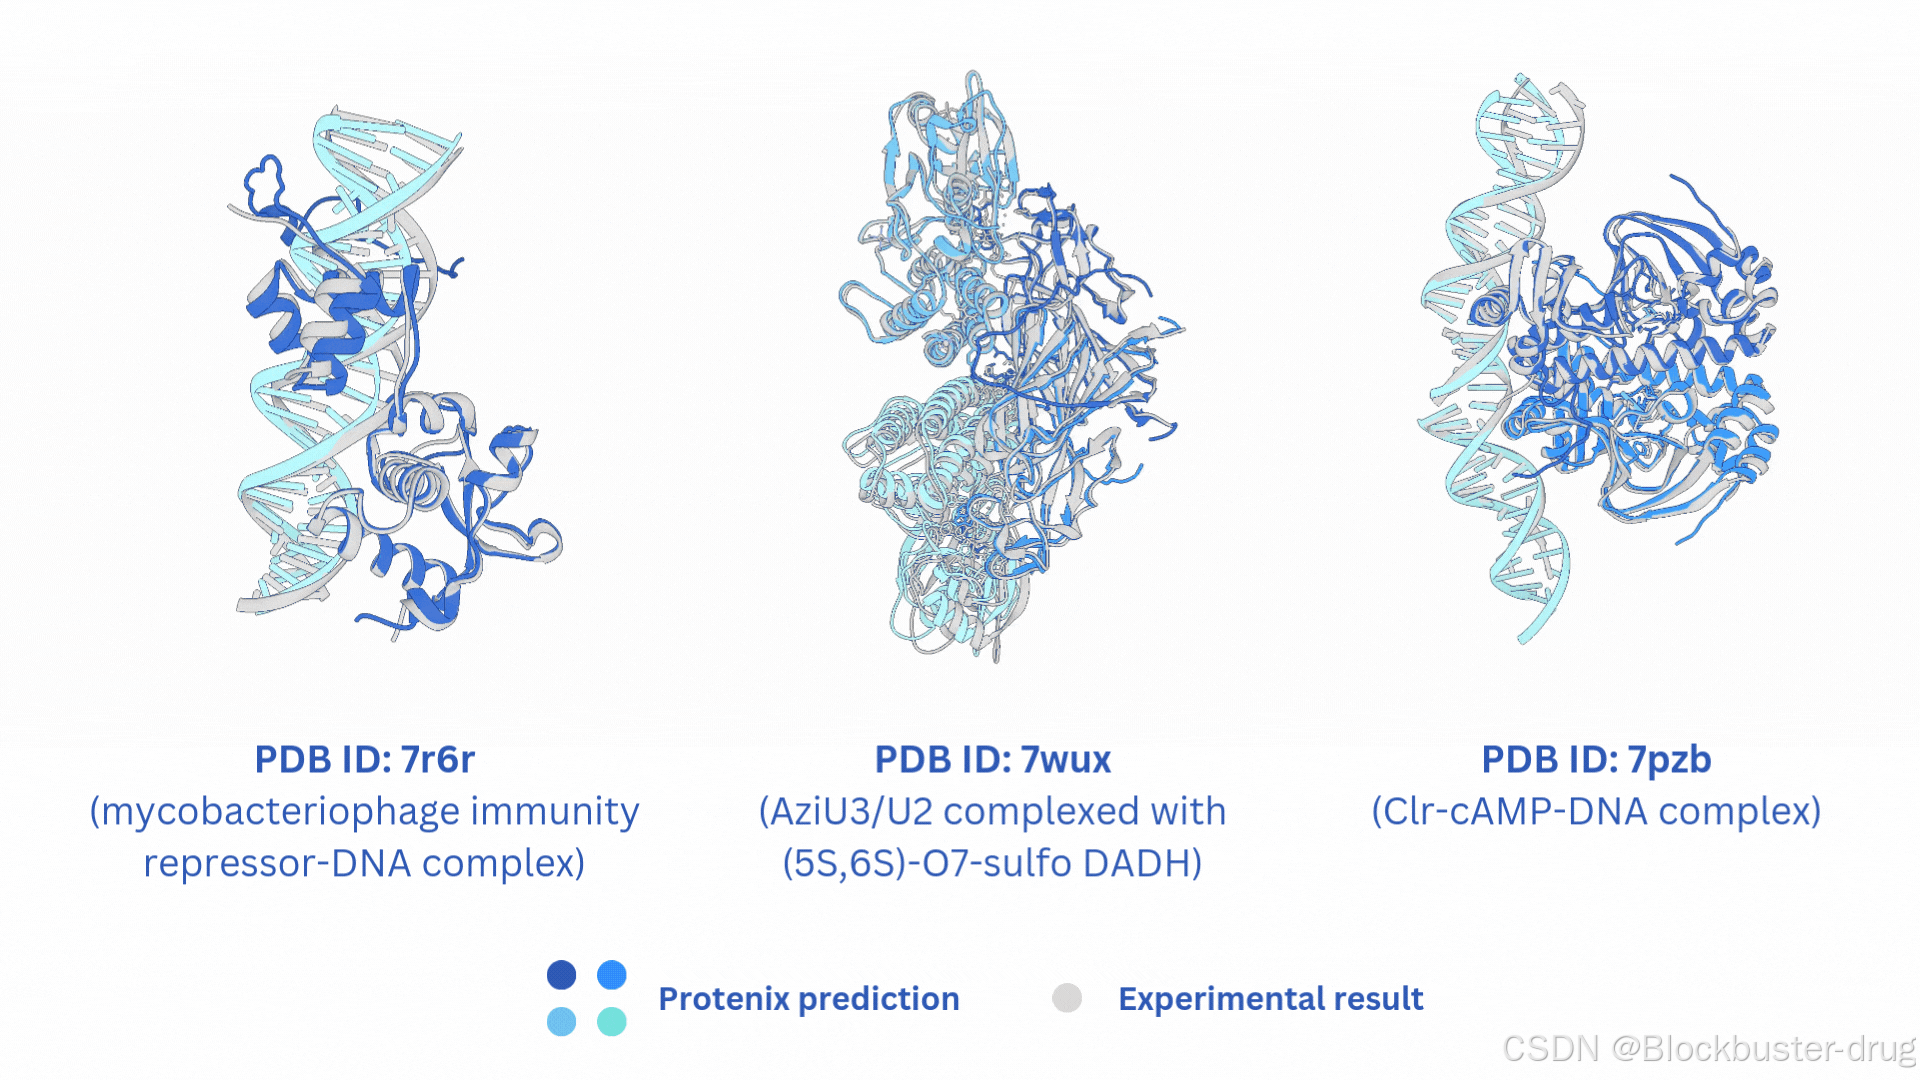
一、原理
Protenix 是什么:一个能预测"蛋白质 + DNA + RNA + 小分子配体 + 金属离子 + 抗体-抗原"在三维空间里怎么排布的开源 AI 模型,由字节跳动 ByteDance AML AI4Science 团队 2024-11-08 开源,Apache-2.0,2026-07 时 1977 stars、293 forks、102 open issues。
怎么做到的 :是 AlphaFold 3 的完整复现并向上扩展,沿用 AF3 的"Pairformer + Diffusion"双阶段架构------先在潜空间把蛋白-核酸-配体-离子的成对关系(pair representation)算清楚,再用一个 diffusion model 从一团随机噪声里一步步"画"出三维坐标。论文里直接挂了三篇 bioRxiv:2025.01 AF3 复现、2026.02 Protenix-v1、2026.04 Protenix-v2。
核心四点:
- 模型推理(reasoning):Pairformer 跑 10 轮(N_cycle=10)做 pairwise reasoning,把残基-残基、残基-配体、配体-配体的关系编码到 pair representation。
- 扩散生成(diffusion):从噪声出发,迭代 N_step=200 步逐步去噪,输出三维坐标(mmCIF 格式)。
- 可信度头(confidence head):配套预测 pLDDT、pTM、ipTM、PAE、chain_pair_plddt 等十几种置信度指标。
- 训练自由引导(TFG, Training-Free Guidance) :v1.0.0+ 引入
--use_tfg_guidance参数,在推理阶段引入梯度引导,不需要重新训练就能提精度。
输入是一段 JSON(蛋白/核酸序列、配体 CCD 或 SMILES、离子、可选 MSA/Template 路径),输出是 CIF 结构 + 置信度 JSON。本地需要 NVIDIA GPU(推荐 ≥24 GB 显存,训练用 A100 80GB / H20 / H100);CPU 路径官方未提供,仅 GPU 推理。
二、特点(跟现有方案比有什么不一样)
| 维度 | Protenix | AlphaFold 3 | Chai-1 / Boltz-1 / Boltz-2 |
|---|---|---|---|
| 开源 | ✅ 代码 + 权重双开源(Apache-2.0) | ❌ 闭源 | ✅ 开源 |
| 训练数据 cutoff 与权重规模与 AF3 一致 | ✅ protenix_base_default_v1.0.0 368M 参数,cutoff 2021-09-30,与 AF3 同尺度 |
--- | --- |
| Antibody-Antigen 精度(DockQ>0.23) | Protenix-v2 比 v1 绝对提升 9-13 pp,5 seeds 已超过 v1 跑 1000 seeds | 闭源无公开数据 | --- |
| 训练数据 pipeline 全部开源 | ✅ 包括 MSA 生成、Template 搜索、RNA MSA、训练数据预处理 | ❌ | 部分开源 |
| 支持输入类型 | 蛋白 / DNA / RNA / 小分子(CCD+SMILES+SDF)/ 离子 / 抗体-抗原 / 约束(contact + pocket) | 蛋白 / DNA / RNA / 小分子 / 离子 | 类似 |
| 微调(finetune) | ✅ 官方提供 finetune_demo.sh,支持按 PDB ID 子集微调 |
❌ | 部分 |
| 配套工具生态 | ✅ PXDesign(设计)、PXMeter(评测)、Protenix-Dock(经典打分对接)、Protenix Server(Web) | AlphaFold Server | BoltzGen |
最值得关注的五点:
-
首个"严格对标 AF3 规模 + cutoff"的真正开源模型 :
protenix_base_default_v1.0.0368M 参数、训练数据 cutoff 2021-09-30(与 AF3 同一截止日期),可作为 AF3 的可复现、可微调替代。 -
抗体-抗原复合物开源 SOTA:Protenix-v2 在 DockQ>0.23 阈值上比 v1 提升 9-13 pp,且 5 seeds 采样已超过 v1 跑 1000 seeds------采样效率显著优于 v1。
-
训练 pipeline 全栈开源:MSA 搜索、Template 搜索(HMMER)、RNA MSA(nhmmer)、训练数据预处理(mmCIF bioassembly)脚本全部 release,可以独立训练或继续预训练。
-
多个尺寸模型覆盖全场景 :
base(368M,最准)→mini(134M,轻量)→tiny(109M,超轻量);另有 ESM 单序列模式(不依赖 MSA)和 constraint 模式(支持 pocket/contact 软约束)。 -
配套生态完善:PXDesign 做 binder 设计(实验成功率 20-73%,比 AlphaProteo、RFdiffusion 高 2-6 倍)、PXMeter 做评测(手动清洗过的基准数据集)、Protenix-Dock 做经典打分对接。
三、手把手教程
3.1 在动手之前,先确认你能满足这些条件
| 条件 | 怎么检查 | 不满足怎么办 |
|---|---|---|
| Linux 系统(Ubuntu 20.04+ 推荐 22.04) | uname -a |
Windows 走 WSL2 或 Docker |
| Python 3.11 或更高 | python3 --version |
Docker 镜像自带 3.11 |
| NVIDIA GPU(推理 ≥16GB,训练 ≥40GB 建议 80GB) | nvidia-smi |
仅 GPU 推理,无 CPU 路径 |
| ≥10 GB 磁盘(仅推理) | df -h ~ |
训练全量数据要 ≥1.5 TB |
| CUDA 12.6 + Driver ≥535 | nvcc --version |
装 NVIDIA 驱动 + CUDA Toolkit 12.6 |
能访问 protenix.tos-cn-beijing.volces.com 或 huggingface.co/bytedance |
curl -I https://protenix.tos-cn-beijing.volces.com |
走 huggingface 镜像(见 3.6) |
外部工具(可选,按需装) :kalign、hmmer(含 nhmmer、hmmsearch、hmmbuild、hmmalign)、mmseqs2(ColabFold MSA 路径需要) |
which kalign hmmsearch nhmmer mmseqs |
apt-get install -y kalign hmmer |
⚠️ 最重要的两条 :Linux + NVIDIA GPU + CUDA 12.6。Protenix 不像 OpenDDE 那样有 CPU 兜底路径,没 GPU 直接走 Docker 镜像。
3.2 安装 Python 包(按顺序做,别跳步)
第 0 步:建 conda 环境(必做,别用系统 Python)
Ubuntu 22.04 自带 Python 3.10,不满足 3.1 节的 ≥3.11 要求。直接系统 pip 会把包装到 3.10 上------能装,但不符合官方要求,后面 torch/cuequivariance 出问题极难排查。实测路径:
# 没 conda 的先装 Miniconda(官方脚本一行)
# wget https://mirrors.tuna.tsinghua.edu.cn/anaconda/miniconda/Miniconda3-latest-Linux-x86_64.sh && bash Miniconda3-latest-Linux-x86_64.sh
conda create -n protenix python=3.11 -y
conda activate protenix
python --version     # 确认输出 3.11.x 再往下走
第 1 步:装 Protenix(三选一)
# 方式 A(推荐):PyPI 稳定版
pip install --upgrade protenix --index-url https://pypi.org/simple
网络慢/断线时换阿里镜像(实测 2026-09 同步到最新版,快 20 倍):
pip install --upgrade protenix --index-url https://mirrors.aliyun.com/pypi/simple/
⚠️ 大包警告:torch(821MB) + nvidia-cublas(393MB) 是依赖大头。pip 反复断线时,先单独装大件再装本体:
pip install torch==2.7.1 triton==3.3.1   # 先大件(版本必须精确,见 §5.0)
pip install protenix                      # 后本体
# 方式 B:GitHub 最新版
pip install git+https://github.com/bytedance/Protenix.git
方式 C:源码装(开发者)
git clone https://github.com/bytedance/Protenix.git
cd Protenix && pip install -e .
第 2 步:装外部依赖 kalign + hmmer(按你的权限二选一)
# 路 A:有 sudo ------ 官方 apt 路线
sudo apt-get update && sudo apt-get install -y kalign hmmer
路 B:没 sudo(服务器/公司机常见)------ bioconda 免 root 替代,实测可用
conda install -n protenix -c bioconda -c conda-forge hmmer -y
kalign 同理:conda install -n protenix -c bioconda -c conda-forge kalign -y
装完 which hmmsearch nhmmer 能找到即可
Docker 镜像(ai4s-share-public-cn-beijing.cr.volces.com/release/protenix:1.0.0.4)已预装这些工具 + CUTLASS v3.5.1 + PyTorch 2.7.1-cu12.6.3 + py3.11,可直接用。
第 3 步:验证安装(首次会编译内核,别慌)
protenix --help⚠️ 首次运行预期行为 :第一次执行会触发 JIT 编译
fast_layer_norm_cuda_v2(ninja 输出一堆nvcc/c++编译行,约 30 秒),这是正常的一次性 编译,第二次起秒进。只要最后出现Usage: protenix [OPTIONS] COMMAND [ARGS]...就是装好了。如果卡在编译报错,九成是 triton 版本不对(必须 3.3.1,见 §5.0 坑 3)。
3.3 验证安装
已并入 3.2 第 3 步(含首次 JIT 编译的预期行为说明)。
protenix --help预期输出(关键子命令):
usage: protenix [-h] {pred,tojson,json,msa,mt,prep,inputprep} ...| 子命令 | 别名 | 干啥 |
|---|---|---|
pred |
predict |
模型推理(CIF + 置信度 JSON) |
tojson / json |
--- | PDB/CIF 转 Protenix 兼容的输入 JSON |
msa |
--- | 只做蛋白 MSA 搜索 |
msatemplate |
mt |
蛋白 MSA + Template 搜索 |
inputprep |
prep |
蛋白 MSA + Template + RNA MSA 三件套 |
3.4 下载模型权重
Protenix 提供 9 套预训练模型,按需下载。字节跳动把权重放在火山引擎 TOS(国内可达),也同步到 HuggingFace(境外可达)。
主下载源(火山引擎 TOS,国内服务器优先):
export PROTENIX_ROOT_DIR=/home/你的用户名/app/Protenix/data
mkdir -p $PROTENIX_ROOT_DIR/checkpoint
推荐:Protenix-v1 base(368M,AF3 同尺度,2021-09-30 cutoff)
wget -P $PROTENIX_ROOT_DIR/checkpoint/

https://protenix.tos-cn-beijing.volces.com/checkpoint/protenix_base_default_v1.0.0.pt
HuggingFace 备用源(境外服务器或 TOS 不通时):
| 模型 | HuggingFace 路径 |
|---|---|
protenix_base_default_v1.0.0 |
https://huggingface.co/bytedance/Protenix-base-v1.0.0 |
protenix-v2 |
https://huggingface.co/bytedance/Protenix-v2 |
| 其他 mini/tiny/constraint | 搜 bytedance 组织下的 Protenix-* 仓库 |
下载完核对大小(base v1.0.0 约 1.4 GB):
ls -lh $PROTENIX_ROOT_DIR/checkpoint/
# protenix_base_default_v1.0.0.pt  ~1.4G
⚠️ 不要用
curl -C -续传权重 。TOS 对续传支持有问题,中断后再下会得到损坏文件(PytorchStreamReader failed reading)。建议用wget或aria2c -x 4,下完用md5sum校验。
PROTENIX_ROOT_DIR 目录约定:
$PROTENIX_ROOT_DIR/
├── checkpoint/      # 模型权重 .pt 文件
├── common/          # CCD、release date 缓存等(推理用不到,训练才需要)
├── mmcif/           # 训练用,mmCIF 原始数据
├── mmcif_bioassembly/  # 训练用,预处理的 wwPDB
├── mmcif_msa_template/ # 训练用,MSA + Template 缓存
├── search_database/    # 训练用,PDB seqres / NT-RNA / Rfam / RNAcentral
└── rna_msa/            # 训练用,RNA MSA
仅推理只需要 checkpoint/;其他目录训练 / 微调才需要。
3.5 准备输入文件:手写一个最小 JSON
Protenix 的 JSON 格式与 AlphaFold Server 高度相似,但有 5 处增强(不限配体类型、可指定 SMILES 或结构文件、可指定共价键、多 CCD 配体当单一 entity、glycan 通过多配体表达)。
最小可工作例子 tiny.json(预测 8 残基小肽 ACDEFGHIK):
[
  {
    "name": "tiny",
    "sequences": [
      {
        "proteinChain": {
          "sequence": "ACDEFGHIK",
          "count": 1
        }
      }
    ]
  }
]
保存:
mkdir -p /tmp/protenix-test
cat > /tmp/protenix-test/tiny.json << 'JSONEOF'
[
  {
    "name": "tiny",
    "sequences": [
      {
        "proteinChain": {
          "sequence": "ACDEFGHIK",
          "count": 1
        }
      }
    ]
  }
]
JSONEOF
JSON 字段速查:
| 字段 | 含义 | 必填 |
|---|---|---|
name |
任务名(输出目录名) | ✅ |
sequences |
entity 列表 | ✅ |
proteinChain.sequence |
蛋白序列(20 字母 + X) | 至少一种 entity |
proteinChain.count |
重复几条 | 可选,默认 1 |
proteinChain.modifications |
PTM 修饰(CCD 码) | 可选 |
proteinChain.pairedMsaPath |
已配对的 MSA .a3m 绝对路径 |
可选 |
proteinChain.unpairedMsaPath |
未配对的 MSA .a3m 绝对路径 |
可选 |
proteinChain.templatesPath |
模板 .a3m 或 .hhr 路径 |
可选 |
dnaSequence / rnaSequence |
单链核酸序列(A/T/G/C/N 或 A/U/G/C/N) | --- |
ligand.ligand |
小分子:CCD_XXX 或 SMILES 或 FILE_path/to.sdf |
--- |
ion.ion |
金属离子(不带 CCD_ 前缀,如 "MG"、"NA") |
--- |
covalent_bonds |
跨 entity 共价键(entity 编号从 1 开始) | 可选 |
constraint.contact |
软接触约束(残基-残基 / 原子-原子距离) | 可选,需 base_constraint 模型 |
constraint.pocket |
口袋约束(binder chain + 接触残基) | 可选,需 base_constraint 模型 |
完整字段表见 docs/infer_json_format.md(397 行,5 种 entity + 共价键 + 约束 + 输出格式)。
3.6 第一次推理:跑起来
方式 1:CLI(推荐新手)
# 设环境
export PROTENIX_ROOT_DIR=/home/你的用户名/app/Protenix/data
跑推理(base v1.0.0,不开 MSA/Template/RNA MSA,先把流程跑通)
protenix pred

-i /tmp/protenix-test/tiny.json

-o /tmp/protenix-test/out

-n protenix_base_default_v1.0.0

--use_default_params true
--use_default_params true 是 Protenix 的"懒人开关"------自动套用每个模型的最佳参数(base 用 N_cycle=10、N_step=200;mini/tiny 用 N_cycle=4、N_step=5)。
方式 2:Python 脚本(更细粒度控制)
export PYTHONPATH="${PYTHONPATH}:$(pwd)"
python3 runner/inference.py

--model_name protenix_base_default_v1.0.0

--seeds 101

--dump_dir /tmp/protenix-test/out

--input_json_path /tmp/protenix-test/tiny.json

--model.N_cycle 10

--sample_diffusion.N_sample 5

--sample_diffusion.N_step 200

--triangle_attention cuequivariance

--triangle_multiplicative cuequivariance
关键参数速查
| 参数 | 含义 | 推荐值 |
|---|---|---|
-i / --input |
输入 JSON 路径或目录 | 必填 |
-o / --out_dir |
输出目录 | 必填 |
-s / --seeds |
随机种子,逗号分隔(如 101,102) |
101 |
-n / --model_name |
模型名 | protenix_base_default_v1.0.0 |
--use_default_params |
自动套用模型默认 cycle/step | true |
--use_msa |
用蛋白 MSA(默认 true) |
关掉可加速但掉精度 |
--use_template |
用模板(v1.0.0+ 支持) | true(前提:JSON 里有 templatesPath) |
--use_rna_msa |
用 RNA MSA(v1.0.0+ 支持) | true(前提:JSON 里有 unpairedMsaPath) |
--use_tfg_guidance |
Training-Free Guidance 引导 | true(精度↑,速度↓) |
--dtype |
bf16(默认,GPU 必用)或 fp32 |
bf16 |
--triatt_kernel |
三角注意力内核:triattention / cuequivariance / deepspeed / torch |
GPU:cuequivariance |
--trimul_kernel |
三角乘法内核:cuequivariance / torch |
GPU:cuequivariance |
--enable_cache / --enable_fusion |
共享变量缓存 + 内核融合(v0.7.0+) | true(GPU 推荐) |
-c / --cycle |
Pairformer 轮数 | base:10,mini/tiny:4 |
-p / --step |
Diffusion 步数 | base:200,mini/tiny:5 |
-e / --sample |
每 seed 候选数 | 真实研究 5-25 |
跑 TFG(Training-Free Guidance,v1.0.0+)
python3 runner/inference.py \
  --model_name protenix_base_default_v1.0.0 \
  --seeds 101 \
  --dump_dir /tmp/protenix-test/out_tfg \
  --input_json_path /tmp/protenix-test/tiny.json \
  --model.N_cycle 10 \
  --sample_diffusion.N_sample 1 \
  --sample_diffusion.N_step 200 \
  --sample_diffusion.guidance.enable true
3.7 看输出结果
输出落在 <out_dir>/<name>/<seed>/:
ls /tmp/protenix-test/out/tiny/101/
# tiny_101_sample_0.cif                          # 结构文件
# tiny_101_sample_1.cif                          # 多 sample 时会有 N 个
# tiny_101_summary_confidence_sample_0.json      # 置信度
# tiny_101_summary_confidence_sample_1.json
置信度 JSON(官方 README 示例):
{
    "plddt": 92.65,
    "gpde": 0.49,
    "ptm": 0.85,
    "iptm": 0.0,
    "chain_ptm": [0.85],
    "chain_pair_iptm": [[0.0]],
    "chain_iptm": [0.0],
    "chain_pair_iptm_global": [[0.0]],
    "chain_plddt": [92.65],
    "chain_pair_plddt": [[92.65]],
    "has_clash": false,
    "disorder": 0.0,
    "ranking_score": 0.85,
    "num_recycles": 10
}
📌 2026-09-12 本机实测对照 (同 tiny.json,protenix 2.0.0 + base v1.0.0):plddt 83.5 、ptm 0.17、has_clash false、num_recycles 10、5 个 sample 全出、单 seed 耗时 10.9 s(RTX 3060 12GB,GPU 峰值 ~3.6 GB)。9 残基小肽无稳定折叠,plddt/ptm 偏低是正常现象(短肽本身无序),结构合理性看 CIF 与 has_clash。另注意 2.0.0 的 chain_plddt 数值格式变为 0-1 小数(如 0.835),详见 §5.0.1。
关键指标含义:
| 指标 | 含义 | 怎么算"好" |
|---|---|---|
plddt (0-100) |
每原子置信度 | > 90 极高 / 70-90 可用 / < 50 别信 |
ptm (0-1) |
整体 TM-score | 越接近 1 越好 |
iptm (0-1) |
界面 TM-score(多链复合物才看) | > 0.7 界面可信 |
chain_plddt |
每条链的 pLDDT | --- |
chain_pair_plddt / chain_pair_iptm |
链-链对的可信度矩阵 | 用于筛选界面 |
has_clash |
是否原子重叠 | false 好 |
disorder (0-1) |
预测的无序区域比例 | 高 = 这段可能无序 |
ranking_score |
综合排序分(多候选时挑最高分) | --- |
num_recycles |
Pairformer 实际跑了几轮 | 反映推理深度 |
⚠️ 输出 JSON 比 OpenDDE 多很多字段 ------Protenix 在 v1.0.0+ 引入了 chain 级 / chain-pair 级全套指标,方便做复合物筛选。完整字段定义见
docs/infer_json_format.md的 "Format of the model output" 章节。
3.8 把所有命令串起来(复制即用版)
# === 一键脚本(Ubuntu 22.04 + CUDA 12.6 + 普通用户账号)===
1. 装依赖
sudo apt-get update && sudo apt-get install -y kalign hmmer
2. 装 Protenix
pip install --upgrade protenix --index-url https://pypi.org/simple
3. 验证
protenix --help
4. 下权重
export PROTENIX_ROOT_DIR=~/app/Protenix/data
mkdir -p $PROTENIX_ROOT_DIR/checkpoint
wget -P $PROTENIX_ROOT_DIR/checkpoint/

https://protenix.tos-cn-beijing.volces.com/checkpoint/protenix_base_default_v1.0.0.pt
5. 写输入 JSON
mkdir -p ~/protenix-test
cat > ~/protenix-test/tiny.json << 'JSONEOF'
[
{"name": "tiny",
"sequences": [{"proteinChain": {"sequence": "ACDEFGHIK", "count": 1}}]}
]
JSONEOF
6. 跑推理(不开 MSA/Template,最快验证流程)
protenix pred

-i ~/protenix-test/tiny.json

-o ~/protenix-test/out

-n protenix_base_default_v1.0.0

--use_default_params true
7. 看结果
cat ~/protenix-test/out/tiny/101/tiny_101_summary_confidence_sample_0.json
3.9 从 PDB 直接转 JSON
如果你有现成的 PDB / mmCIF 文件,用 protenix json 自动转成 Protenix 输入:
protenix json --input examples/7pzb.pdb --out_dir ./output --altloc first
进阶:指定 biological assembly
wget -P ./examples/ https://files.rcsb.org/download/7pzb.cif
protenix json --input ./examples/7pzb.cif --out_dir ./output --altloc first
进阶:保留不连续 polymer-polymer 键(如环肽)
protenix json --input examples/2lwu.cif --out_dir ./output

--altloc first --include_discont_poly_poly_bonds
3.10 自动搜索 MSA / Template(精度最大化路径)
Protenix 把 MSA + Template + RNA MSA 搜索封装成三个子命令。精度敏感的场景一定要做这一步:
# 三件套:蛋白 MSA + Template + RNA MSA(最完整)
protenix prep --input ~/protenix-test/tiny.json --out_dir ./output
只做蛋白 MSA + Template(不要 RNA MSA)
protenix mt --input ~/protenix-test/tiny.json --out_dir ./output
只做蛋白 MSA(支持 FASTA 或 JSON 输入)
protenix msa --input ~/prot.fasta --out_dir ./output --msa_server_mode protenix跑完后,prep / mt / msa 会把搜索到的 MSA / Template 路径写回 JSON ,再喂给 protenix pred:
protenix pred \
  -i ./output/tiny_with_msa.json \
  -o ./output \
  -n protenix_base_default_v1.0.0 \
  --use_default_params true
💡
prep和mt可能会自动下载搜索数据库(PDB seqres、Rfam、RNAcentral、NT-RNA)到PROTENIX_ROOT_DIR/search_database/。数据库几个 G,需要时间。
四、上手后想进阶?这些是常见下一步
1. 用 Docker 跑(推荐训练 / 多用户环境):
# 拉镜像
docker pull ai4s-share-public-cn-beijing.cr.volces.com/release/protenix:1.0.0.4
跑容器(GPU + 共享内存)
docker run --gpus all -it

-v "$(pwd)":/app

-v /dev/shm:/dev/shm

ai4s-share-public-cn-beijing.cr.volces.com/release/protenix:1.0.0.4

/bin/bash
容器内:装 + 验证
cd /app && pip install -e .
protenix --help
镜像已预装 PyTorch 2.7.1 + CUDA 12.6.3 + Python 3.11 + HMMER + Kalign + CUTLASS v3.5.1,唯一没装的是 Protenix 本体 ,所以要在容器里 pip install -e .。
2. 用 ColabFold 本地 MSA 替代官方 MSA pipeline(无服务器环境友好):
# 装 ColabFold + 编译 MMseqs2
pip install colabfold[alphafold]
ColabFold 的 MSA 不带物种信息,Protenix 提供了后处理脚本加伪 taxonomy ID
python3 scripts/colabfold_msa.py examples/dimer.fasta <path/to/colabfold_db>

dimer_colabfold_msa --db1 uniref30_2103_db --db3 colabfold_envdb_202108_db

--mmseqs_path <path/to/mmseqs>
详见 docs/colabfold_compatible_msa.md。
3. 用更强的 Protenix-v2(抗体-抗原更强,配体更合理):
# v2 checkpoint 单独下载(约 1.7 GB,比 v1 大)
wget -P $PROTENIX_ROOT_DIR/checkpoint/ \
  https://protenix.tos-cn-beijing.volces.com/checkpoint/protenix-v2.pt
跑 v2
protenix pred

-i input.json -o ./out_v2

-n protenix-v2

--use_template true

--use_default_params true
v2 比 v1 的关键差异:c_z=256(representation 维度更高)、464M 参数(v1 是 368M)、抗体-抗原 DockQ>0.23 提升 9-13 pp。
4. 用 mini / tiny 模型做高通量筛选:
# Mini(134M,比 base 快约 5-10 倍)
protenix pred -i input.json -o ./out_mini \
  -n protenix_mini_default_v0.5.0 --use_default_params true
Tiny(109M,最快)
protenix pred -i input.json -o ./out_tiny

-n protenix_tiny_default_v0.5.0 --use_default_params true
Mini/Tiny 的代价:N_cycle 从 10 降到 4,N_step 从 200 降到 5。适合先做一轮粗筛,再用 base 精排。
5. 用 ESM 单序列模型(无 MSA 也能用):
# 走 ESM2-3B embedding,不需要 MSA
protenix pred -i input.json -o ./out_esm \
  -n protenix_mini_esm_v0.5.0 --use_default_params true
适合:找不到同源序列的孤儿蛋白、设计全新序列、或者想完全离线不联网跑。
6. 用 constraint 模型加口袋 / 接触先验:
{
  "name": "binder_design",
  "sequences": [
    {"proteinChain": {"sequence": "...", "count": 1}},
    {"proteinChain": {"sequence": "...", "count": 1}}
  ],
  "constraint": {
    "pocket": {
      "binder_chain": {"entity": 2, "copy": 1},
      "contact_residues": [
        {"entity": 1, "copy": 1, "position": 126},
        {"entity": 1, "copy": 1, "position": 168}
      ],
      "max_distance": 6.0
    }
  }
}

protenix pred -i binder.json -o ./out_constraint \
  -n protenix_base_constraint_v0.5.0 --use_default_params true
注意要换专门支持 constraint 的模型(base_constraint_v0.5.0)。
7. 微调(finetune)自己的数据集:
# 编辑 finetune_subset.txt,每行一个 PDB ID(用 prepared 训练数据里的)
cat finetune_subset.txt
# 6hvq
# 5mqc
# 5zin
跑 finetune(脚本已设好 PYTHONPATH 和 base 配置)
bash finetune_demo.sh
finetune_demo.sh 关键参数:
| 参数 | 含义 |
|---|---|
model_name |
起点的预训练 checkpoint(推荐 protenix_base_default_v1.0.0) |
load_checkpoint_path / load_ema_checkpoint_path |
预训练权重路径 |
data.<dataset>.base_info.pdb_list |
子集 PDB ID 文件路径 |
train_crop_size |
训练时随机裁剪的 token 数 |
diffusion_batch_size |
Diffusion 批大小 |
ema_decay |
EMA 衰减率(默认 0.999) |
dtype |
bf16(推荐)或 fp32 |
triangle_attention / triangle_multiplicative |
内核选择 |
use_wandb |
是否记录到 W&B |
8. 多卡分布式训练:
torchrun --nproc_per_node=8 runner/train.py \
  --model_name "protenix_base_default_v1.0.0" [OTHER_ARGS]
9. 跑 PXMeter 基准(评估你自己的模型或别的模型):
git clone https://github.com/bytedance/PXMeter.git
# 详见 PXMeter 仓库 README
五、踩坑速查(碰到问题先翻这里)
5.0 软件包版本搭配实测(2026-09-12 本机端到端验证,RTX 3060 12GB + Ubuntu 22.04 + CUDA 12.4 driver 580)
验证可用的完整版本组合 (pip list 实测,端到端推理跑通):
| 包 | 版本 | 说明 |
|---|---|---|
| protenix | 2.0.0 | 当前 PyPI 最新;文档以 v1.x 命令为准但 2.0.0 CLI 兼容 |
| torch | 2.7.1 | protenix 2.0.0 的精确 pin(torch==2.7.1),不能装 2.8+ |
| triton | 3.3.1 | torch 2.7.1 配套 pin,必须 3.3.1,不能 3.4+ |
| nvidia-cublas-cu12 | 12.6.4.1 | torch 2.7.1 精确 pin;装 12.9.x 会报 incompatible 警告但能跑------建议严格用 12.6.4.1 |
| cuequivariance | 0.11.1 | 三角注意力 GPU 内核 |
| cuequivariance-ops/ops-torch/torch | 0.8.0 | 三件套必须同版本 0.8.0 |
| deepspeed | 0.17.5 | 变更记录明确修了 Pydantic <2.x 冲突(issue #182) |
| pydantic | 2.13.5 | 配 deepspeed 0.17.5 无冲突 |
| numpy | 2.4.1 | 2.x 可用(无需降到 1.26) |
| rdkit | 2025.9.3 | CCD/SMILES 配体解析 |
| ml_collections | 1.1.0 | 配置系统 |
| fair-esm | 2.0.0 | ESM 模式(mini_esm)用 |
| Python | 3.11.16 | conda env;README 要求 ≥3.11 |
版本坑 4 条(实测踩过):
- torch pin 死 2.7.1 :protenix 2.0.0 的 setup 依赖写死
torch==2.7.1(不是>=)。手动装了 torch 2.14/cu130 的 env 会冲突。凡从别的 env 复制思路的,先pip list | grep torch确认。 - nvidia-cublas 版本不匹配只警告不报错 :装 12.9.2.10 时 pip 报 "torch 2.7.1 requires nvidia-cublas-cu12==12.6.4.1... which is incompatible" 但
Successfully installed,推理也能跑。但别赌------CUDA 运行时库版本错位是隐性炸弹,换卡/换驱动时会炸。老老实实 12.6.4.1(torch 的精确 pin 与 driver 580 + CUDA 12.4 完全兼容)。 - triton 必须 3.3.1 :torch 2.7.1 的硬依赖 pin。装 3.4+ 会让
fast_layer_norm_cuda_v2JIT 编译失败(首次protenix --help就会触发编译,报错立现)。 - cuequivariance 三件套版本错位 = 三角注意力静默回退 :
cuequivariance(元包)0.11.1 +cuequivariance-ops-cu12/cuequivariance-ops-torch-cu12/cuequivariance-torch全部 0.8.0。错位安装不报错但--triatt_kernel cuequivariance路径可能失效。这套是 pip 自动解出来的,别手动单独 upgrade 其中一个。
安装顺序坑:依赖里 torch(821MB)+nvidia-cublas(393MB) 是超大包。若网络慢到 pip 反复断线,先单独装大包再装 protenix:
pip install torch==2.7.1 triton==3.3.1        # 先大件
pip install protenix                           # 后本体(其余依赖小)
5.0.1 protenix 2.0.0 相对文档(v1.x 时代)的实测差异
| 项 | 文档(v1.x) | 实测 2.0.0 |
|---|---|---|
| 输出目录结构 | out/<name>/<seed>/ |
out/<name>/seed_101/predictions/ |
| 置信度字段 | pldddt/ptm/iptm/chain_* | 新增 gpde/chain_gpde/chain_pair_gpde 组 |
| chain_plddt | 数值 ×100(如 92.65) | 0-1 小数(如 0.8347),plddt 字段仍是 0-100 |
| 首次运行 | 直接出结果 | 先 JIT 编译 fast_layer_norm_cuda_v2(ninja,~30s,一次性) |
| 配体任务 | 本地 CCD 解析 | 蛋白链自动触发远程 MSA 队列 (colab_request_utils,PENDING 排队)------离线/内网环境会卡住,需提前跑 protenix msa 或用本地 MSA 路径 |
| 现象 | 原因 | 解决 |
|---|---|---|
command not found: protenix |
没装上或 PATH 没生效 | pip install protenix;重启 shell |
python3: command not found |
系统没 Python | sudo apt install python3.11 |
OSError: [Errno 101] Network is unreachable 下权重 |
TOS 不通 | 切 HuggingFace 镜像 |
PytorchStreamReader failed reading file data/XXX: invalid header |
权重损坏(curl 续传导致) | 删掉重下,用 wget 或 aria2c |
FileNotFoundError: hmmsearch/nhmmer/kalign |
外部工具没装 | apt-get install -y kalign hmmer |
CUDA out of memory |
显存不够 | mini/tiny 模型;或开 --enable_cache true + --enable_fusion true;或 N_sample 调小 |
Triangle kernel error: triattention compile failed |
Triton 不支持当前 GPU | 切 --triatt_kernel torch 或 --triatt_kernel cuequivariance |
RuntimeError: DeepSpeed requires Pydantic <2.x |
Pydantic 版本冲突 | 升 DeepSpeed 到 0.17.5(CHANGELOG 已修,issue #182) |
JSON 报错 Expecting property name enclosed in double quotes |
heredoc 里的引号被 shell 吃了 | 用 << 'JSONEOF'(带引号)或文件编辑器 |
| 输出目录里没文件 | 推理提前报错退出了 | 看完整日志找 ERROR 行;用 tee 把输出保存到日志再排查 |
has_clash: true |
模型预测有原子重叠 | 加大 --step 到 200,开 --use_template true,或换 --use_tfg_guidance true |
iptm 很低但 plddt 高 |
链-链界面没对 | 加 MSA / Template 重新跑;或换 Protenix-v2(抗体-抗原更强) |
Docker 容器内 nvidia-smi 找不到 GPU |
没装 NVIDIA Container Toolkit | 按 官方指南 装 |
--use_template true 但 JSON 里没 templatesPath |
不报错但不起作用 | 先跑 protenix mt -i input.json -o out 自动生成模板路径并写回 JSON |
| 训练时 OOM | batch size 太大 | 调小 diffusion_batch_size;或用 bf16;或减小 model.pairformer.nblocks |
MSA header format error |
MSA header 不符合 UniRef/UniProt 正则 | 见 docs/msa_template_pipeline.md 的 MSA Header Format 要求 |
covalent_bonds 字段被忽略 |
用了旧版字段名(left_entity 等) |
改用新版 entity1 / entity2 等(v2 format) |
constraint 不生效 |
模型不是 base_constraint_v0.5.0 | 换专门支持约束的模型 |
--use_tfg_guidance true 后显存爆 |
TFG 显存占用高 | 减小 --sample_diffusion.N_sample 或关 TFG |
protenix prep 下载搜索数据库超时 |
网络问题 | 手动下 PDB seqres、Rfam、RNAcentral、NT-RNA 放到 $PROTENIX_ROOT_DIR/search_database/ |
六、模型与权重速查
| 模型名 | 参数 | MSA | Template | RNA MSA | Constraint | ESM | 训练数据 cutoff | 发布日期 | 用途 |
|---|---|---|---|---|---|---|---|---|---|
protenix-v2 |
464M | ✅ | ✅ | ✅ | ❌ | ❌ | 2021-09-30 | 2026-04-08 | 抗体-抗原、配体最强 |
protenix_base_default_v1.0.0 |
368M | ✅ | ✅ | ✅ | ❌ | ❌ | 2021-09-30 | 2026-02-05 | 推荐默认,与 AF3 同尺度 |
protenix_base_20250630_v1.0.0 |
368M | ✅ | ✅ | ✅ | ❌ | ❌ | 2025-06-30 | 2026-02-05 | 实际应用场景,数据更新 |
protenix_base_default_v0.5.0 |
368M | ✅ | ❌ | ❌ | ❌ | ❌ | 2021-09-30 | 2025-05-30 | 旧版,向后兼容 |
protenix_base_constraint_v0.5.0 |
368M | ✅ | ❌ | ❌ | ✅ | ❌ | 2021-09-30 | 2025 | pocket / contact 软约束 |
protenix_mini_esm_v0.5.0 |
135M | ❌ | ❌ | ❌ | ❌ | ✅ | 2021-09-30 | 2025 | ESM 单序列模式,无 MSA |
protenix_mini_ism_v0.5.0 |
135M | ❌ | ❌ | ❌ | ❌ | ✅(ISM) | 2021-09-30 | 2025 | ISM 单序列模式 |
protenix_mini_default_v0.5.0 |
134M | ✅ | ❌ | ❌ | ❌ | ❌ | 2021-09-30 | 2025 | 轻量级筛选 |
protenix_tiny_default_v0.5.0 |
109M | ✅ | ❌ | ❌ | ❌ | ❌ | 2021-09-30 | 2025 | 超轻量级筛选 |
base 默认参数 :N_cycle=10、N_step=200。 mini/tiny 默认参数:N_cycle=4、N_step=5。
关键字
Protenix 本地部署 结构预测 字节 官方文档 推理demo 微调 权重速查 实测 踩坑
性能参考(官方 benchmark)
推理显存 / 延迟
N_token |
N_atom |
Peak Memory (GB) | Latency (s) |
|---|---|---|---|
| 500 | 5,000 | 6.1 | 17 |
| 1,000 | 10,000 | 18.2 | 59 |
| 2,000 | 20,000 | 66.6 | 226 |
| 3,000 | 30,000 | 60.8 | 935 |
| 4,000 | 40,000 | 78.1 | 1,424 |
⚠️ 上表是
protenix_base_default_v1.0.0+ 默认配置(bf16 混合精度 + SampleDiffusion 和 ConfidenceHead 自动 FP32)。N_token>3840 时update_inference_configs()会自动启用 SampleDiffusion AMP 节省显存。
训练显存 / 吞吐(A100-80G)
| 训练阶段 | train_crop_size | diffusion_batch_size | s/step | Peak GPU (GB) |
|---|---|---|---|---|
| Initial | 384 | 48 | ~12 | ~34 |
| Fine-tune Stage 1 | 640 | 32 | ~30 | ~35 |
| Fine-tune Stage 2 | 768 | 32 | ~44 | ~48 |
| Fine-tune Stage 3 | 768 | 32 | ~13 | ~24 |
完整 4 阶段 loss 权重表见 docs/training_inference_instructions.md 第 240-254 行。
抗体-抗原精度(DockQ>0.23)
| 模型 | 5 seeds | 1000 seeds |
|---|---|---|
| Protenix-v1 | 基准 | 基准 |
| Protenix-v2 | 高于 v1 跑 1000 seeds | --- |
Protenix-v2 比 v1 绝对提升 9-13 pp(三个集合平均)。
参考资料
官方仓库与文档
- 项目仓库:GitHub - bytedance/Protenix: Toward High-Accuracy Open-Source Biomolecular Structure Prediction. · GitHub
- 完整 README:https://raw.githubusercontent.com/bytedance/Protenix/main/README.md
- 训练 & 推理指南:Protenix/docs/training_inference_instructions.md at main · bytedance/Protenix · GitHub
- 输入 JSON 格式:Protenix/docs/infer_json_format.md at main · bytedance/Protenix · GitHub
- 支持的模型:Protenix/docs/supported_models.md at main · bytedance/Protenix · GitHub
- Kernel 配置:Protenix/docs/kernels.md at main · bytedance/Protenix · GitHub
- Docker 安装:
Protenix/docs/docker_installation.md at main · bytedance/Protenix · GitHub
- MSA / Template 流程:Protenix/docs/msa_template_pipeline.md at main · bytedance/Protenix · GitHub
- ColabFold 兼容 MSA:Protenix/docs/colabfold_compatible_msa.md at main · bytedance/Protenix · GitHub
- v1.0.0 基准:Protenix/docs/model_1.0.0_benchmark.md at main · bytedance/Protenix · GitHub
- v0.5.0 基准:Protenix/docs/model_0.5.0_benchmark.md at main · bytedance/Protenix · GitHub
- 训练数据准备:Protenix/docs/prepare_training_data.md at main · bytedance/Protenix · GitHub
技术报告(PDF)
- Protenix 原始复现(2024-12):
docs/Protenix_Technical_Report_2024.pdf(3.4 MB) - Protenix-v1(2026-02-05):
docs/PTX_V1_Technical_Report_202602042356.pdf(1.1 MB) - Protenix-v2(2026-04-10):
docs/PX2.pdf(7.8 MB)
论文(bioRxiv)
- Protenix 原始复现:https://www.biorxiv.org/content/early/2025/01/11/2025.01.08.631967
- Protenix-v1:https://www.biorxiv.org/content/early/2026/02/22/2026.02.05.703733.1
- Protenix-v2:https://www.biorxiv.org/content/early/2026/04/11/2026.04.10.717613
- Protenix-Mini:2507.11839 Protenix-Mini: Efficient Structure Predictor via Compact Architecture, Few-Step Diffusion and Switchable pLM
模型权重下载
- 火山引擎 TOS:
https://protenix.tos-cn-beijing.volces.com/checkpoint/<model_name>.pt - HuggingFace:
https://huggingface.co/bytedance/Protenix-*
Docker 镜像
docker pull ai4s-share-public-cn-beijing.cr.volces.com/release/protenix:1.0.0.4Web 服务
- Protenix Server:https://protenix-server.com
配套生态
- PXDesign(binder 设计):PXDesign --- De Novo Design of Protein Binders
- PXMeter(评测):GitHub - bytedance/PXMeter: Structural Quality Assessment for Biomolecular Structure Prediction Models · GitHub
- Protenix-Dock(经典对接):GitHub - bytedance/Protenix-Dock: An accurate and trainable end-to-end protein-ligand docking framework · GitHub
- Protenix-Mini 论文:2507.11839 Protenix-Mini: Efficient Structure Predictor via Compact Architecture, Few-Step Diffusion and Switchable pLM
衍生项目
- BoltzGen(基于 Protenix 的 binder 设计):GitHub - HannesStark/boltzgen: BoltzGen: Toward Universal Binder Design · GitHub
- boltzgen_mcp(BoltzGen MCP 服务):GitHub - MacromNex/boltzgen_mcp: BoltzGen MCP server for protein binder design · GitHub
- boltz_mcp(Boltz-2 MCP 服务):GitHub - MacromNex/boltz_mcp: Boltz2 MCP server for protein structure and affinity prediction · GitHub
- Boltz-2 笔记本:GitHub - AtharvaTilewale/boltz2-notebook: Boltz2 Notebook -- A streamlined Colab-based pipeline for protein structure prediction and binding affinity analysis using the Boltz2 deep learning model. · GitHub
社区
- Twitter/X:https://x.com/ai4s_protenix
- Slack:https://join.slack.com/t/protenixworkspace/shared_invite/zt-3drypwagk-zRnDF2VtOQhpWJqMrIveMw
- 微信群:WeChat group for Chinese users · Issue #52 · bytedance/Protenix · GitHub
- 邮箱:anewbt_mind@bytedance.com
我的专栏链接
| 蛋白 / 多肽 | 分子模拟 / 动力学 | 分子对接 / CADD / 工具 | agent / 核酸 / 药物 |
|---|---|---|---|
| 开源蛋白结构推理 | 分子模拟基础 | UCSF DOCK系列 | agent智能体系列 |
| 开源蛋白生成实践 | 分子动力学模拟-Amber | rDock系列教程 | 化学大模型介绍 |
| 蛋白设计原理案例 | 分子动力学模拟-Gromacs | LeDock系列教程 | 我胡师兄说药 |
| 多肽设计模型实践 | 开源結合自由能计算 | CADD中的机器学习模型 | siRNA药物设计模型 |
| 开源多肽性质预测 | 高效计算基本配置 | 小分子药物设计案例 | ASO药物设计模型 |
| 多肽设计原理案例 | 靶向DNA/RNA药物设计 | 开源小分子生成和设计实践 | 开源药代动力学软件教程 |