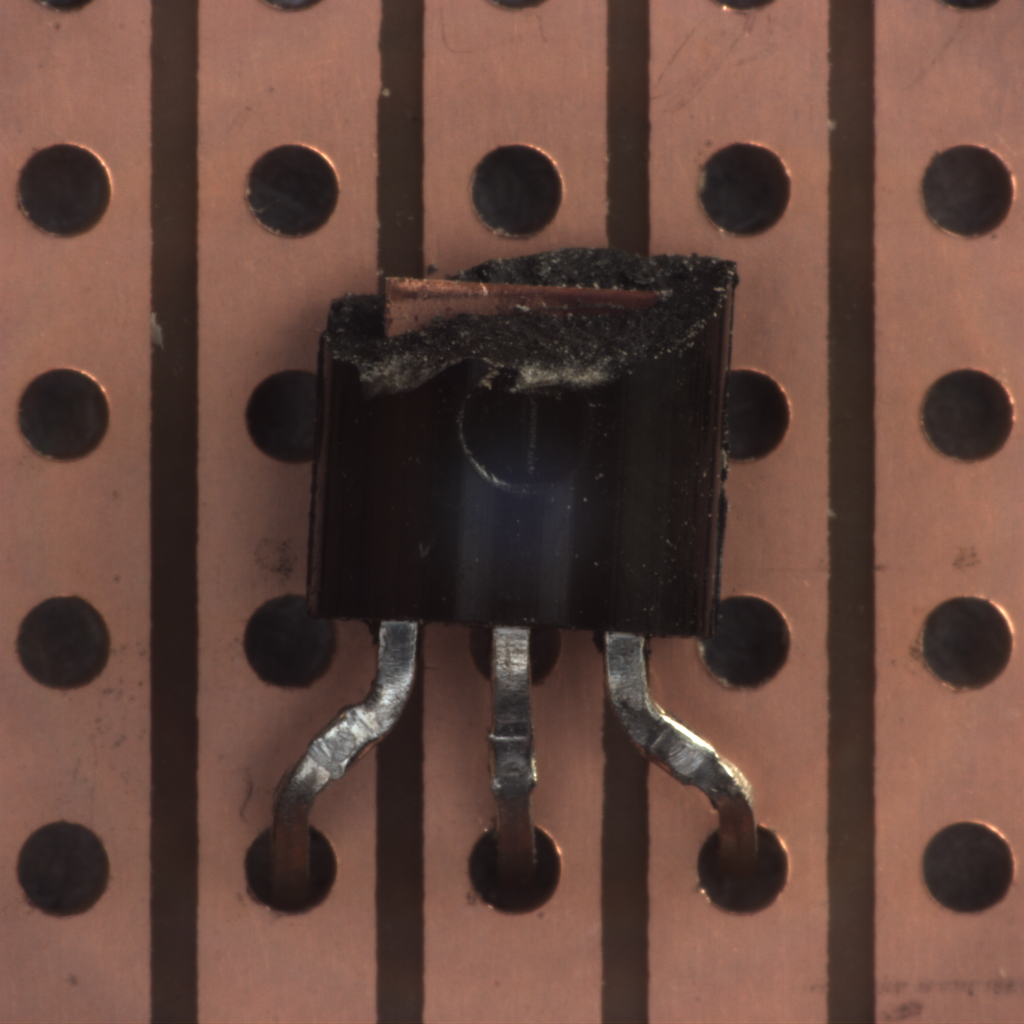
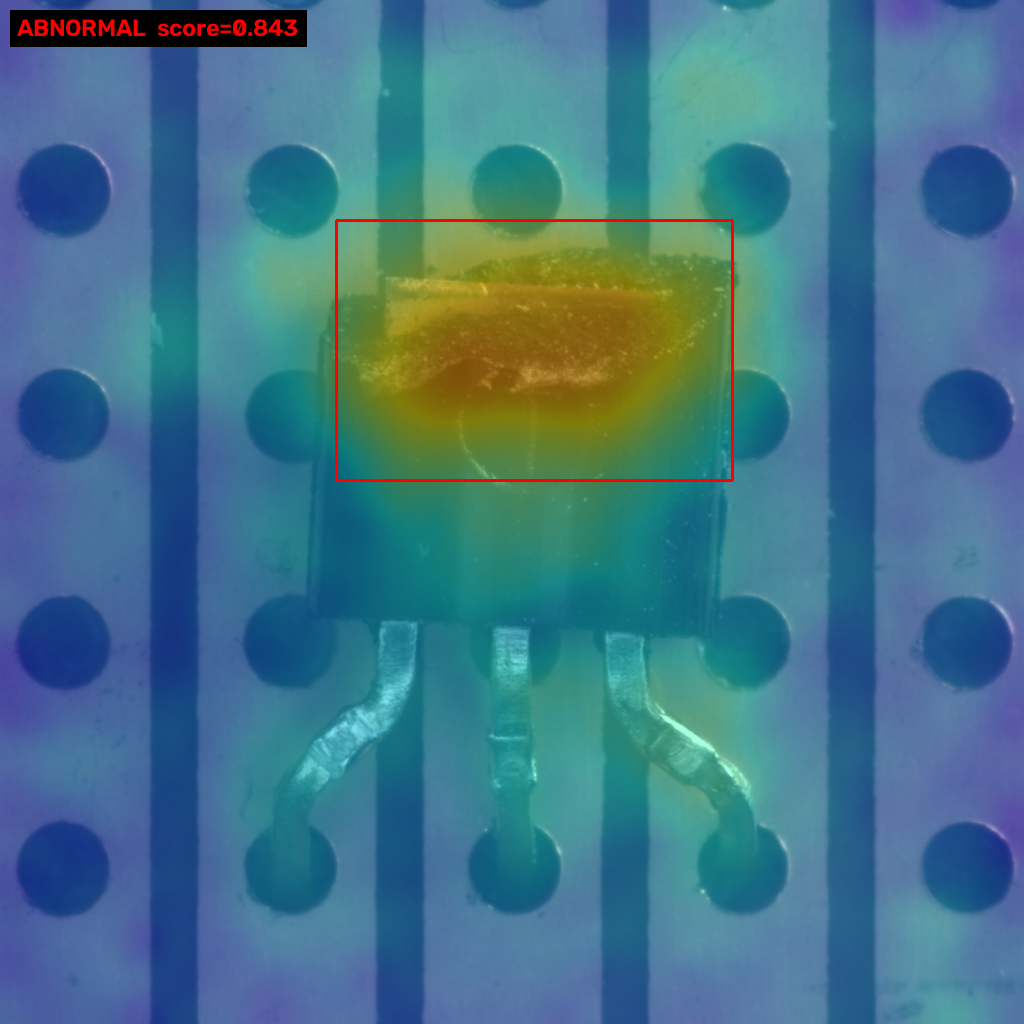
摘要:PatchCore(CVPR2021)是工业界落地非常广的一类异常检测算法,只需要正常样本,不需要缺陷图片参与训练,适合零件缺陷等样本稀缺、缺陷形态不可预知的场景。本文结合 Anomalib,讲解算法原理、环境搭建、数据集规范、完整训练代码、常见报错、模型输出物以及 Triton 部署注意事项。
一、背景介绍
在传统深度学习检测任务中,不管 YOLO、Faster‑RCNN 都需要大量标注缺陷样本。但真实工业场景往往面临痛点:
- 缺陷样本极少,收集困难;
- 缺陷形态五花八门,无法提前收集全部缺陷;
- 很多场景只有大量正常合格图片。
一类(One‑Class)异常检测应运而生:模型只学习 "正常长什么样",凡是和正常不一样的区域,判定为异常。
PatchCore 全称《Towards Total Recall in Industrial Anomaly Detection》,2021CVPR 论文,目前工业落地主流方案。
- ✅训练只需要正常图片,不需要任何缺陷标签;
- ✅输出:整张图异常分数 + 像素级异常热力图,可以定位缺陷位置;
- ✅骨干网络权重全程冻结,不反向传播更新,训练只是遍历一遍正常图片提取特征;
- ✅MVTec 数据集上可以取得很高 AUROC 指标,适合零部件、轨道、隧道视频帧等场景。
核心思想:不去学异常,把所有正常局部 Patch 特征存入内存库 MemoryBank;推理时,测试图片 patch 特征和内存库做 K‑NN 最近邻搜索,距离越大代表越异常。
二、PatchCore 算法原理
整体分为**训练阶段(构建内存库)与推理阶段(异常打分定位)**两大模块。
2.1 训练阶段(没有梯度更新!)
- 骨干网络冻结 :默认
wide_resnet50_2,加载 ImageNet 预训练权重,全程不做反向传播,权重不更新,只做前向特征提取。 - 多层特征提取 :取网络中间层
layer2、layer3特征图。浅层保留空间细节,深层保留语义信息;将多层特征 resize 对齐、融合,输出每个位置的 Patch 局部特征向量。 - 构建 Memory Bank 内存库:遍历全部训练集正常图片,把所有 patch 特征存入内存库。此时特征数量巨大,占用内存高。
- Coreset Greedy 核心集采样压缩 :使用贪心核心集采样,按
coreset_sampling_ratio保留代表性特征,大幅度减少特征数量,降低内存占用、加速后续 KNN 检索,精度损失很小。 - 构建 FAISS 索引,为后续推理快速最近邻检索做准备。
⚠️重点误区:
max_epochs=1!PatchCore 不是迭代训练,只是遍历一遍数据集提取特征;设置大于 1 不会提升效果,只会重复执行提取,浪费时间。
2.2 推理阶段
- 测试图片输入冻结骨干网络,提取同样的多层 Patch 特征;
- FAISS 做 K‑NN 最近邻检索:每个 patch 特征在 MemoryBank 找距离最近的若干个正常特征;
- 计算距离:距离越大代表该 patch 和正常样本差异越大,越可能是异常;
- 输出两个结果:
- 图像级异常分数 image_score:0‑1,判断整张图片是否存在异常;
- 像素级异常热力图 anomaly_map:和原图同尺寸,每个像素代表异常程度,可以可视化缺陷位置。
三、环境准备
测试环境:Windows11 / Python3.10 /anomalib>=1.0,注意 anomalib1.x 与 0.x 版本 API 改动很大,网上很多旧博客是 0.x 版本,参数会报错。
bash
# 创建虚拟环境
conda create -n py310 python=3.10
conda activate py310

# 安装依赖
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu121
pip install anomalib faiss‑cpu numpy<2.0
Windows 优先faiss‑cpu;GPU 版本 faiss‑gpu 建议 Linux 环境使用。
numpy 版本必须小于 2.0,高版本 numpy 会报 np.float_废弃错误。
自用版本 anomalib==2.6.0
四、数据集目录规范(Anomalib1.x Folder 数据集)
anomalib1.x 中 Folder 类已经移除
test_normal_dir、test_abnormal_dir参数,很多旧博客代码直接复制会报unexpected keyword argument类型错误。
✅正确目录结构
dataset_my/
├─ train/
│   └─ good/         #【训练集,全部正常图片,不要放缺陷】
│       ├─ 001.jpg
│       └─ 002.jpg
├─ test/
│   ├─ good/         #测试集正常样本
│ └─ bad/ #测试集缺陷样本train/good:只能放正常图片,训练不会读取 test 文件夹;- test 目录用来做评估,计算 AUROC 指标;
- 图片格式支持 jpg/png;子目录不要带空格、中文
五、完整训练代码
python
from pathlib import Path

from anomalib.data import Folder
from anomalib.engine import Engine
from anomalib.models import Patchcore

import win_compat  # noqa: F401  # Windows 下修复 anomalib 创建 latest 目录时崩溃(必须在 import anomalib 之后)

if __name__ == "__main__":
    # 1. 数据集加载
    # 注意:anomalib 2.x 的 Folder 参数名与旧版本不同:
    #   - 训练集正常图 -> normal_dir
    #   - 测试集正常图 -> normal_test_dir
    #   - 测试集异常图 -> abnormal_dir
    # 且必须提供 name 参数;Folder 本身没有 image_size 参数(图像尺寸在模型侧配置)。
    datamodule = Folder(
        name="bridge",                  # 数据集名称,用于日志/结果目录命名
        root=Path("./dataset"),
        normal_dir="good",              # 训练只用正常样本: dataset/good
        normal_test_dir="test/good",    # 测试集正常样本: dataset/test/good
        abnormal_dir="test/bad",        # 测试集异常样本: dataset/test/bad
        train_batch_size=4,
        eval_batch_size=4,
        num_workers=0,                  # windows 必须设置 0;linux 可以 4
        # 默认 val_split_mode="from_test" 会把测试集对半切开(一半当验证集),
        # 这里设为 same_as_test,保证 test/good + test/bad 全部参与评估。
        val_split_mode="same_as_test",
    )
    datamodule.setup()

    # 2. 模型初始化 PatchCore 核心参数
    # 输入尺寸通过 pre_processor 配置(默认就是 256x256 + ImageNet 归一化,
    # 这里显式写出,便于后续调整)。
    model = Patchcore(
        backbone="wide_resnet50_2",     # 论文默认骨干网络
        layers=("layer2", "layer3"),    # 提取哪几层特征
        pre_trained=True,               # 必须 True,加载 imagenet 预训练权重
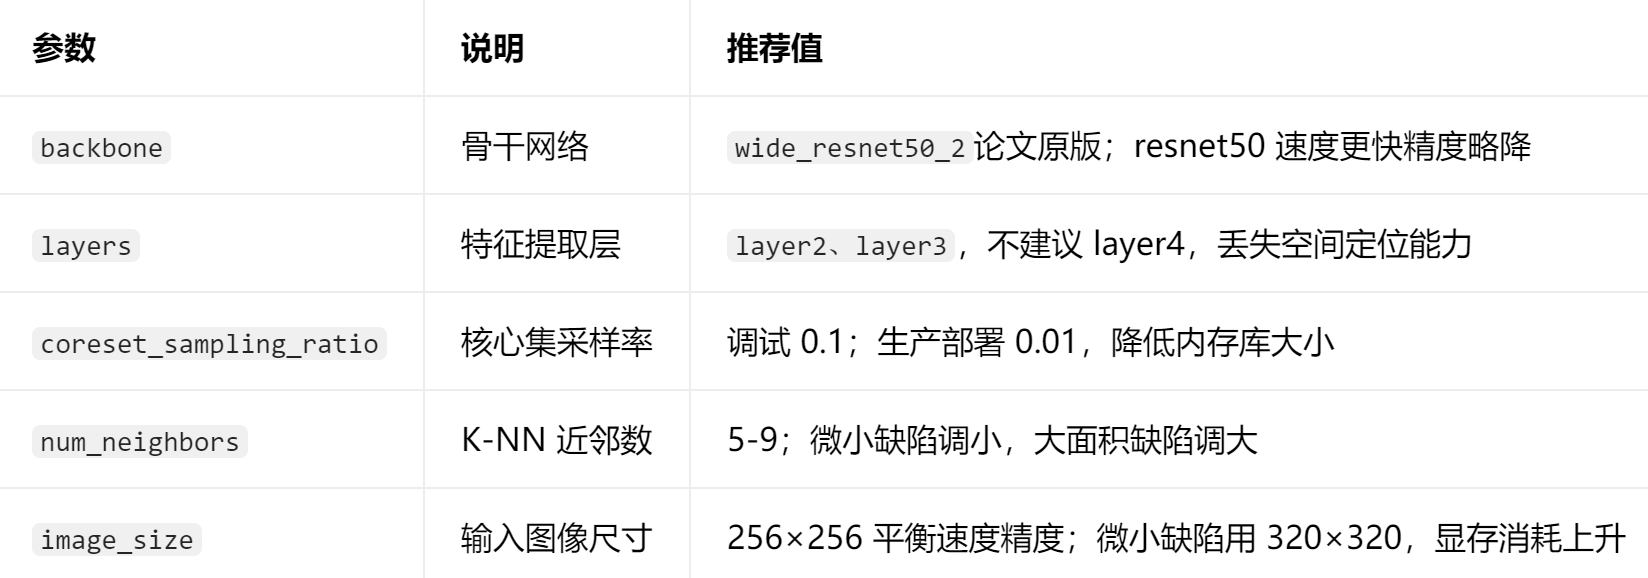
        coreset_sampling_ratio=0.1,     # 核心集采样比例;生产建议 0.01~0.1,越小内存越小
        num_neighbors=9,                # K 近邻,用来计算异常得分,默认 9
        pre_processor=Patchcore.configure_pre_processor(image_size=(256, 256)),
    )

    # 3. 训练引擎:max_epochs=1,只遍历一遍正常图片构建 memory bank,不是迭代训练
    engine = Engine(
        max_epochs=1,
        devices=1,
        default_root_dir="./patchcore_result",
    )

    # --------训练(构建特征内存库,无反向传播)---------
    engine.fit(model=model, datamodule=datamodule)

    # 在测试集评估,输出 AUROC 等指标
    engine.test(model=model, datamodule=datamodule)

    # 导出 ONNX,方便 C++ 部署(比如 OpenCV / TensorRT)
    # anomalib 2.x 中导出目录参数名为 export_root(不是 output_dir)
    engine.export(
        model=model,
        export_type="onnx",
        export_root=Path("./patchcore_result/onnx"),
    )
六、训练完成输出产物说明
执行完engine.fit(),输出目录./patchcore_result/weights/。
- model.ckpt【最重要】
- 保存内容:骨干网络权重 + 压缩后的 MemoryBank 特征库 + FAISS 索引 + 全部超参;
- 文件体积很大主要是内存库特征,不是网络权重;
coreset_sampling_ratio越小 ckpt 体积越小; - 推理加载:
model = Patchcore.load_from_checkpoint("xxx/model.ckpt")。
❗重要踩坑:导出的 ONNX 文件只包含骨干网络前向特征提取逻辑,不包含 MemoryBank、KNN 检索 。
部署到 Triton 推理服务器的时候,onnx 只负责图像→特征图;KNN 距离计算、异常打分逻辑,需要写在 Triton Python Backend 里面,不能只靠 onnx 独立完成完整 PatchCore 推理。
七、推理加载 ckpt 简单示例
python
from anomalib.models import Patchcore
from PIL import Image
import torch

# 加载训练完成带MemoryBank的ckpt
model = Patchcore.load_from_checkpoint("./patchcore_result/weights/model.ckpt")
model.eval()

img = Image.open("test_bad.jpg").convert("RGB")
# 输入预处理按照训练配置,输出异常得分与热力图
with torch.no_grad():
    pred = model.predict(img)

image_score = pred.pred_score.item()   #整张图片异常分数
anomaly_map = pred.anomaly_map.numpy() #像素级异常热力图
print(f"图像异常得分:{image_score:.4f}")- 导出 ONNX 模型仅做特征提取;
- MemoryBank 特征库、FAISS 索引保存在 ckpt 中;部署时需要把特征库加载到 Triton Python Backend;
- Triton 请求链路:图片输入 → onnx 提取特征 → Python backend 加载内存库做 K‑NN 距离计算 → 返回异常分数 + 热力图;
- 不可以直接把完整 PatchCore 全部交给 ONNX/TensorRT,K‑NN 检索逻辑不在网络计算图内。
加载导出的 PatchCore ONNX 模型做异常检测推理并可视化
python
from __future__ import annotations

import argparse
import csv
from dataclasses import dataclass
from pathlib import Path

import cv2
import numpy as np
import onnxruntime as ort

IMG_EXTS = {".png", ".jpg", ".jpeg", ".bmp", ".tif", ".tiff", ".webp"}


@dataclass
class InferResult:
    image_path: str
    score: float
    label: int
    verdict: str
    max_pixel: float


def _build_session(model_path: Path) -> ort.InferenceSession:
    providers = []
    if "CUDAExecutionProvider" in ort.get_available_providers():
        providers.append(("CUDAExecutionProvider", {"device_id": 0}))
    providers.append("CPUExecutionProvider")
    sess = ort.InferenceSession(str(model_path), providers=providers)
    in_meta = sess.get_inputs()[0]
    print(f"[model] {model_path}")
    print(f"  provider     : {sess.get_providers()}")
    print(f"  input  name  : {in_meta.name}, shape={in_meta.shape}, dtype={in_meta.type}")
    for o in sess.get_outputs():
        print(f"  output name  : {o.name}, shape={o.shape}, dtype={o.type}")
    return sess


def _preprocess(image_bgr: np.ndarray, image_size: int) -> np.ndarray:
    """BGR uint8 -> NCHW float32 in [0, 1]。

    注意:anomalib 导出的 ONNX 模型的 ``pre_processor/export_transform`` 已将
    Resize 烘进图里,模型 backbone 内部再做 ImageNet 归一化。所以这里**不要再手动
    ImageNet 归一化**(否则会被双重归一化,全部图片都会判为异常)。只需要:
        BGR -> RGB -> Resize -> /255 -> NCHW float32。
    image_size 控制送进 ONNX 之前的尺寸(默认 256),与训练 pre_processor 一致。
    """
    rgb = cv2.cvtColor(image_bgr, cv2.COLOR_BGR2RGB)
    rgb = cv2.resize(rgb, (image_size, image_size), interpolation=cv2.INTER_AREA)
    x = rgb.astype(np.float32) / 255.0
    x = np.transpose(x, (2, 0, 1))[None]
    return np.ascontiguousarray(x, dtype=np.float32)


def _postprocess(outs: dict, custom_threshold):
    score = float(np.asarray(outs["pred_score"]).reshape(-1)[0])
    label = int(np.asarray(outs["pred_label"]).reshape(-1)[0])
    amap = np.asarray(outs["anomaly_map"])
    if amap.ndim == 4:
        amap = amap[0, 0]
    elif amap.ndim == 3:
        amap = amap[0]
    amap = amap.astype(np.float32)
    if custom_threshold is not None:
        label = int(score > custom_threshold)
    return score, label, amap


def _colorize_heatmap(amap: np.ndarray) -> np.ndarray:
    norm = np.clip(amap, 0.0, 1.0)
    u8 = (norm * 255).astype(np.uint8)
    return cv2.applyColorMap(u8, cv2.COLORMAP_JET)


def _overlay(original_bgr, amap, score, label, alpha=0.45):
    """原图 + 热图叠加 + 文本标签 + 最大异常区域的 bbox。"""
    h, w = original_bgr.shape[:2]
    heat = _colorize_heatmap(amap)
    heat = cv2.resize(heat, (w, h), interpolation=cv2.INTER_LINEAR)
    binary = (amap > max(0.5, amap.max() * 0.6)).astype(np.uint8)
    binary = cv2.resize(binary, (w, h), interpolation=cv2.INTER_NEAREST)
    x, y, bw, bh = 0, 0, 0, 0
    contours, _ = cv2.findContours(binary, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    if contours:
        cnt = max(contours, key=cv2.contourArea)
        x, y, bw, bh = cv2.boundingRect(cnt)
    overlay = original_bgr.copy()
    mask = heat.sum(axis=2) > 0
    overlay[mask] = cv2.addWeighted(original_bgr, 1 - alpha, heat, alpha, 0)[mask]
    if bw > 0 and bh > 0:
        color = (0, 0, 255) if label == 1 else (0, 255, 0)
        cv2.rectangle(overlay, (x, y), (x + bw, y + bh), color, 2)
    text = f"{'ABNORMAL' if label == 1 else 'NORMAL'}  score={score:.3f}"
    color = (0, 0, 255) if label == 1 else (0, 180, 0)
    (tw, th), _ = cv2.getTextSize(text, cv2.FONT_HERSHEY_SIMPLEX, 0.8, 2)
    cv2.rectangle(overlay, (10, 10), (10 + tw + 14, 10 + th + 14), (0, 0, 0), -1)
    cv2.putText(overlay, text, (17, 10 + th + 4), cv2.FONT_HERSHEY_SIMPLEX, 0.8, color, 2, cv2.LINE_AA)
    return overlay


def _gather_images(input_path: Path):
    if input_path.is_file():
        return [input_path]
    if input_path.is_dir():
        return sorted(p for p in input_path.rglob("*") if p.suffix.lower() in IMG_EXTS)
    raise FileNotFoundError(input_path)


def _save_visual(result, bgr, amap, output_dir, save_overlay, save_heatmap):
    stem = Path(result.image_path).stem
    if save_overlay:
        cv2.imwrite(str(output_dir / f"{stem}_overlay.png"), _overlay(bgr, amap, result.score, result.label))
    if save_heatmap:
        cv2.imwrite(str(output_dir / f"{stem}_heatmap.png"), _colorize_heatmap(amap))


def main():
    parser = argparse.ArgumentParser(description="PatchCore ONNX anomaly detection inference")
    parser.add_argument("-m", "--model", default="patchcore_result/onnx/weights/onnx/model.onnx")
    parser.add_argument("-i", "--input", required=True, help="single image or directory")
    parser.add_argument("-o", "--output_dir", default="runs/infer")
    parser.add_argument("-t", "--threshold", type=float, default=None,
                        help="custom image-level threshold; default uses ONNX built-in pred_label")
    parser.add_argument("--image_size", type=int, default=256)
    parser.add_argument("--no_overlay", action="store_true")
    parser.add_argument("--no_heatmap", action="store_true")
    parser.add_argument("--score_csv", default=None,
                        help="results CSV path (default <output_dir>/results.csv)")
    args = parser.parse_args()

    model_path = Path(args.model).resolve()
    if not model_path.exists():
        raise SystemExit(f"ONNX model not found: {model_path}")
    input_path = Path(args.input).resolve()
    output_dir = Path(args.output_dir).resolve()
    output_dir.mkdir(parents=True, exist_ok=True)
    csv_path = Path(args.score_csv).resolve() if args.score_csv else output_dir / "results.csv"

    images = _gather_images(input_path)
    if not images:
        raise SystemExit(f"no images found under {input_path}")

    sess = _build_session(model_path)
    results = []
    print(f"\n[infer] {len(images)} images -> {output_dir}\n")
    for img_path in images:
        try:
            bgr = cv2.imread(str(img_path), cv2.IMREAD_COLOR)
            if bgr is None:
                print(f"  [skip] cannot read: {img_path}")
                continue
            x = _preprocess(bgr, args.image_size)
            outs = sess.run(None, {sess.get_inputs()[0].name: x})
            out_dict = dict(zip([o.name for o in sess.get_outputs()], outs))
            score, label, amap = _postprocess(out_dict, args.threshold)
            r = InferResult(
                image_path=str(img_path),
                score=score,
                label=label,
                verdict="abnormal" if label == 1 else "normal",
                max_pixel=float(amap.max()),
            )
            _save_visual(r, bgr, amap, output_dir,
                         save_overlay=not args.no_overlay,
                         save_heatmap=not args.no_heatmap)
            results.append(r)
            print(f"  {img_path.name:40s}  score={score:7.3f}  label={label}  [{r.verdict}]")
        except Exception as e:
            print(f"  [fail] {img_path}: {e}")

    n = len(results)
    n_abn = sum(1 for r in results if r.label == 1)
    print(f"\n[summary] total={n}  abnormal={n_abn}  normal={n - n_abn}")

    with open(csv_path, "w", encoding="utf-8-sig", newline="") as f:
        w = csv.writer(f)
        w.writerow(["image_path", "score", "label", "verdict", "max_pixel"])
        for r in results:
            w.writerow([r.image_path, f"{r.score:.4f}", r.label, r.verdict, f"{r.max_pixel:.4f}"])
    print(f"[csv]  {csv_path}")


if __name__ == "__main__":
    main()
九 效果展示