产业AI落地技术解析:边缘部署、工业视觉检测与多传感器融合预警的工程实践
引言
AI大模型的热潮中,一个被忽视的事实是:真正决定人工智能成败的不是模型参数规模,而是它能否在矿山、港口、工厂等实体经济场景中稳定运行。这些场景的共同特征是------环境恶劣、边缘算力受限、容错率极低、数据闭环要求高。
本文从技术架构视角,拆解中国产业智能化落地中的核心技术挑战与工程方案,覆盖边缘AI部署、工业视觉检测、港口自动化调度、矿山安全监控等典型场景。
一、产业AI vs 互联网AI:完全不同的技术约束
互联网AI(推荐系统、搜索引擎、内容生成)运行在云端数据中心,算力充足、网络稳定、延迟容忍度高。而产业AI面临的技术约束截然不同:
| 维度 | 互联网AI | 产业AI |
|---|---|---|
| 部署位置 | 云端集群 | 边缘设备/现场服务器 |
| 网络条件 | 稳定宽带 | 矿山/海上可能无网络 |
| 延迟要求 | 秒级可接受 | 毫秒级(安全控制回路) |
| 环境条件 | 恒温机房 | 粉尘、震动、高温、潮湿 |
| 容错率 | 推荐不准无大碍 | 误检可能造成安全事故 |
| 数据特点 | 用户行为日志 | 传感器流数据、工业图像 |
| 模型更新 | 在线学习/天级 | 离线更新/月级,需停机验证 |
这些约束决定了产业AI不能简单照搬互联网AI的技术栈,需要一套独立的工程体系。
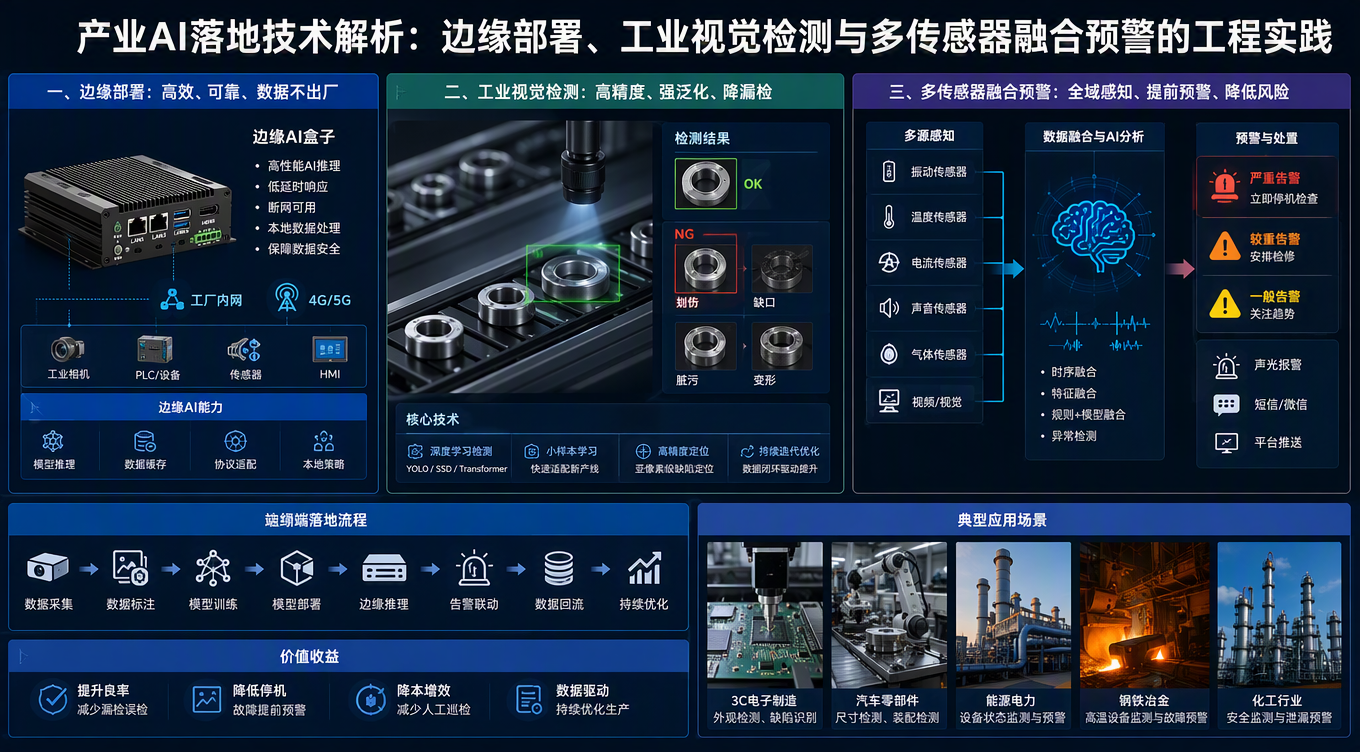
二、边缘AI部署:让模型在恶劣环境中跑起来
2.1 模型轻量化技术栈
矿山、工厂等场景的边缘设备算力有限(通常为ARM嵌入式芯片或低功耗NPU),需要将大模型压缩到可部署规模。
技术路径:
原始模型 (浮点FP32)
    │
    ├── 量化 (Quantization)
    │   ├── PTQ: 训练后量化 (INT8/INT4)
    │   └── QAT: 量化感知训练
    │
    ├── 剪枝 (Pruning)
    │   ├── 结构化剪枝: 移除整个通道/层
    │   └── 非结构化剪枝: 稀疏化权重矩阵
    │
    ├── 知识蒸馏 (Knowledge Distillation)
    │   └── Teacher模型 → Student模型
    │
    └── 算子优化
        ├── TensorRT / OpenVINO 编译优化
        └── NPU专用算子重写
量化部署示例(基于ONNX Runtime + INT8):
python
import onnx
from onnxruntime.quantization import quantize_dynamic, QuantType

# 模型量化:FP32 → INT8
quantize_dynamic(
    model_input="model_fp32.onnx",
    model_output="model_int8.onnx",
    weight_type=QuantType.QUInt8,  # 无符号INT8适合ReLU后权重
    op_types_to_quantize=['MatMul', 'Gemm', 'Conv'],  # 量化计算密集算子
)

# 量化前后对比
import onnxruntime as ort
import numpy as np
import time

def benchmark(model_path, input_data, runs=100):
    sess = ort.InferenceSession(model_path)
    input_name = sess.get_inputs()[0].name

    # 预热
    for _ in range(10):
        sess.run(None, {input_name: input_data})

    # 计时
    start = time.perf_counter()
    for _ in range(runs):
        sess.run(None, {input_name: input_data})
    elapsed = time.perf_counter() - start

    return elapsed / runs * 1000  # ms per inference

# 典型结果:INT8模型推理速度提升2-4x,模型体积缩小约4x
2.2 边缘推理框架选型
| 框架 | 适用硬件 | 优势 | 局限 |
|---|---|---|---|
| TensorRT | NVIDIA Jetson | 极致GPU优化 | 仅限NVIDIA |
| OpenVINO | Intel CPU/VPU | CPU推理优化强 | Intel生态绑定 |
| NCNN | ARM CPU | 移动端首选,无依赖 | 功能相对基础 |
| MNN (阿里) | ARM/CPU/GPU | 跨平台,动态图支持 | 社区较小 |
| MindSpore Lite (华为) | 昇腾NPU | 端云协同,国产化 | 昇腾硬件依赖 |
| Paddle Lite (百度) | 多种NPU | 国产芯片支持广 | 生态碎片化 |
选型决策因素:
硬件平台?
├── NVIDIA Jetson → TensorRT
├── Intel CPU/边缘服务器 → OpenVINO
├── ARM嵌入式 → NCNN / MNN
├── 华为昇腾 → MindSpore Lite
└── 国产NPU集群 (瑞芯微/地平线/寒武纪) → Paddle Lite
2.3 离线推理与模型热更新
矿山井下、海上平台等场景网络不可靠,模型更新不能依赖云端在线下发。典型方案:
python
import hashlib
import os
import shutil

class EdgeModelManager:
    """边缘模型离线更新管理器"""

    def __init__(self, model_dir="/edge/models", active_version=None):
        self.model_dir = model_dir
        self.active_version = active_version or self._read_active_version()

    def verify_and_install(self, model_package_path, expected_sha256):
        """验证模型包完整性并安装"""
        # 1. 校验SHA256,防止传输损坏
        actual_hash = self._compute_sha256(model_package_path)
        if actual_hash != expected_sha256:
            raise ValueError(f"Hash mismatch: expected {expected_sha256}, got {actual_hash}")

        # 2. 解压到临时目录
        temp_dir = os.path.join(self.model_dir, "tmp_update")
        shutil.unpack_archive(model_package_path, temp_dir)

        # 3. 灰度验证:在影子模式下运行新模型,对比输出
        #    不影响线上推理,仅记录差异
        validation_result = self._shadow_validate(temp_dir)
        if not validation_result['passed']:
            shutil.rmtree(temp_dir)
            raise RuntimeError(f"Shadow validation failed: {validation_result['reason']}")

        # 4. 原子切换:符号链接指向新版本,失败可秒级回滚
        new_version = validation_result['version']
        symlink_path = os.path.join(self.model_dir, "active")
        temp_link = os.path.join(self.model_dir, "active.tmp")

        if os.path.exists(temp_link):
            os.remove(temp_link)
        os.symlink(os.path.join(self.model_dir, new_version), temp_link)
        os.rename(temp_link, symlink_path)  # 原子操作

        self.active_version = new_version
        self._write_active_version(new_version)
        return new_version

    def rollback(self):
        """回滚到上一版本"""
        versions = sorted(os.listdir(self.model_dir))
        versions = [v for v in versions if v.startswith('v')]
        if len(versions) < 2:
            raise RuntimeError("No previous version to rollback")
        prev_version = versions[-2]
        # 更新符号链接...
        return prev_version
燎原:我看见的智能中国
京东:https://item.jd.com/14727957.html?
卖点
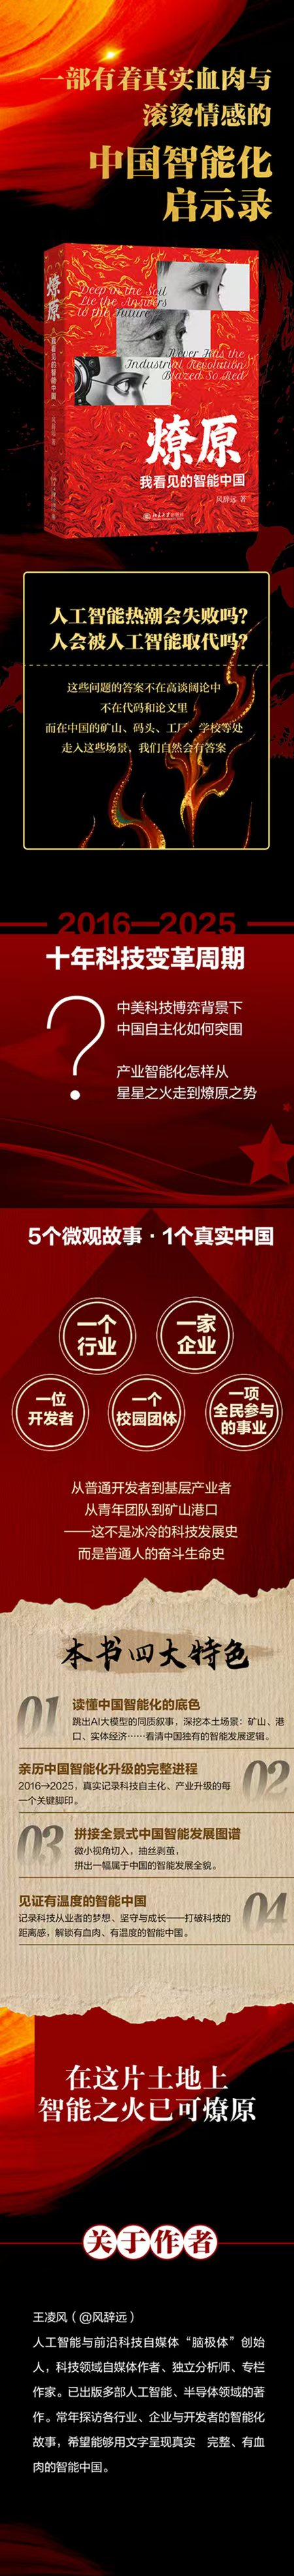
1.读懂中国智能化的底色。AI大模型的同质化叙事,聚焦矿山、港口、实体经济等本土场景,深挖中国产业智能化的独有路径与发展特色,读懂区别于世界的中国智能发展逻辑。
2.亲历中国智能化升级的完整进程。2016---2025十年科技变革周期,真实记录中美科技博弈背景下,中国科技自主化突围、产业智能化升级的完整进程,还原硬核科技崛起的真实底色。
- 拼接全景式中国智能发展图谱。以五个核心微观案例切入,从普通开发者、基层产业、青年团队等微小视角,抽丝剥茧梳理行业变革,拼接出全景式中国智能发展图谱。
4.见证有温度的智能中国。不止是冰冷的科技发展史,更是普通人的奋斗生命史。记录科技从业者的梦想、坚守与成长,打破科技的距离感,解锁有血肉、有温度的智能中国。
内容简介
如今,人工智能已经成为街知巷闻的话题,然而,面对智能时代,很多人内心深处有疑问:历史上的几次人工智能热潮均以失败告终,这次会例外吗?人会被人工智能取代吗?我们应该如何应对内心的焦虑与恐慌?这些问题的答案不在高谈阔论中,不在代码和论文里,而在中国的矿山、码头、工厂、学校等处。走入这些场景,我们自然会有答案。
本书选取了5个故事,分别围绕一个行业、一家企业、一位开发者、一个校园团体,以及一项凝聚了中国社会广泛参与的事业展开。希望他们的真实经历,能初步描绘智能中国蓝图,为我们解答有关智能化未来的疑问。
在这片土地上,智能之火已可燎原。
作者简介
王凌风(@风辞远),人工智能与前沿科技自媒体"脑极体"创始人,科技领域自媒体作者、独立分析师、专栏作家。已出版多部人工智能、半导体领域的著作。常年探访各行业、企业与开发者的智能化故事,希望能够用文字呈现真实 完整、有血肉的智能中国。
三、工业视觉检测:从"人眼质检"到"AI质检"
3.1 技术架构
工厂产线上的视觉质检是产业AI最成熟的应用之一。典型架构:
┌──────────────────────────────────────────────────────────┐
│                    工业视觉质检系统                         │
├──────────┬──────────┬──────────┬──────────────────────────┤
│  图像采集 │  预处理   │  AI推理   │       决策与执行          │
│          │          │          │                          │
│ 工业相机  │ 去噪/校正 │ 缺陷检测  │ 合格→放行                │
│ 线阵/面阵 │ ROI裁剪   │ 分类定位  │ 不合格→剔除+报警         │
│ 光源控制  │ 图像增强  │ 分割     │ 存疑→人工复检            │
└──────────┴──────────┴──────────┴──────────────────────────┘
      ↓                                ↑
┌──────────────────────────────────────────────────────────┐
│              数据闭环与模型迭代                             │
│  人工复检结果 → 标注入库 → 增量训练 → 模型更新 → 边缘部署   │
└──────────────────────────────────────────────────────────┘
3.2 缺陷检测模型选型
工业缺陷检测的难点在于:缺陷样本少(正负样本极度不平衡)、缺陷形态多样、精度要求高(漏检率 < 0.1%)。
方案对比:
| 方案 | 技术路线 | 适用场景 | 优缺点 |
|---|---|---|---|
| 分类模型 | ResNet/EfficientNet | 合格/不合格二分类 | 简单但无法定位缺陷 |
| 目标检测 | YOLOv8/DETR | 缺陷定位+分类 | 平衡速度与精度 |
| 语义分割 | U-Net/Mask2Former | 像素级缺陷分割 | 精度最高但计算量大 |
| 异常检测 | PatchCore/PaDiM | 无缺陷样本训练 | 解决样本不足问题 |
| 少样本学习 | Siamese/Prototypical | 缺陷类型多变 | 灵活但泛化待验证 |
异常检测方案(无缺陷样本场景):
python
import torch
import torch.nn.functional as F
from torchvision import models

class PatchCore:
    """
    PatchCore: 基于特征记忆库的异常检测
    核心思想:用正常样本构建特征记忆库,测试时计算与记忆库最近邻距离
    优势:仅需正常样本训练,适合缺陷样本极少的工业场景
    """
    def __init__(self, backbone='wide_resnet50', coreset_ratio=0.1):
        # 使用预训练骨干网络提取中间层特征
        self.feature_extractor = self._build_extractor(backbone)
        self.memory_bank = None  # 正常样本特征记忆库
        self.coreset_ratio = coreset_ratio  # 核心集采样比例

    def _build_extractor(self, backbone):
        """提取Layer2和Layer3的特征图,捕获不同尺度信息"""
        model = models.wide_resnet50_2(pretrained=True)
        layers = [model.layer2, model.layer3]
        return torch.nn.Sequential(*layers[:2]).eval()

    def build_memory_bank(self, normal_dataloader):
        """用正常样本构建特征记忆库"""
        features = []
        with torch.no_grad():
            for images in normal_dataloader:
                feat = self.feature_extractor(images)
                # 将特征图reshape为patch特征向量
                b, c, h, w = feat.shape
                feat = feat.permute(0, 2, 3, 1).reshape(-1, c)
                features.append(feat)

        self.memory_bank = torch.cat(features, dim=0)

        # 核心集采样:用贪心算法选择代表性子集,降低推理时计算量
        self.memory_bank = self._coreset_sampling(self.memory_bank)

    def _coreset_sampling(self, features):
        """贪心核心集选择:迭代选取距离已选样本最远的点"""
        n = features.shape[0]
        k = int(n * self.coreset_ratio)
        selected = [torch.randint(0, n, (1,)).item()]

        for _ in range(k - 1):
            # 计算每个点到已选点集的最小距离
            min_distances = torch.full((n,), float('inf'))
            for idx in selected:
                dists = torch.norm(features - features[idx], dim=1)
                min_distances = torch.minimum(min_distances, dists)
            # 选择最小距离最大的点
            selected.append(torch.argmax(min_distances).item())

        return features[selected]

    def predict(self, image):
        """推理:计算图像patch特征与记忆库的最近邻距离"""
        with torch.no_grad():
            feat = self.feature_extractor(image.unsqueeze(0))
            b, c, h, w = feat.shape
            feat = feat.permute(0, 2, 3, 1).reshape(-1, c)

            # 计算每个patch到记忆库的最近邻距离
            dist_matrix = torch.cdist(feat, self.memory_bank)
            min_distances, _ = dist_matrix.min(dim=1)

            # 重塑为热力图,定位异常区域
            anomaly_map = min_distances.reshape(h, w)
            anomaly_score = min_distances.max().item()  # 全局异常分数

        return anomaly_score, anomaly_map
3.3 数据闭环工程
工业AI的核心竞争力不在模型,而在数据闭环:
产线运行 → 模型推理 → 存疑样本自动收集 → 人工标注
    ↑                                              ↓
    └──── 模型增量训练 ←── 数据清洗 ←── 质检入库 ←──┘
python
class DataLoopPipeline:
    """数据闭环流水线"""

    def __init__(self, confidence_threshold=0.85):
        self.confidence_threshold = confidence_threshold
        self.uncertain_samples = []  # 低置信度样本队列
        self.labeled_buffer = []     # 已标注样本缓冲

    def on_inference_result(self, image, prediction, confidence):
        """推理回调:自动收集低置信度样本"""
        if confidence < self.confidence_threshold:
            # 存疑样本进入人工复检队列
            self.uncertain_samples.append({
                'image': image,
                'prediction': prediction,
                'confidence': confidence,
                'timestamp': time.time()
            })

    def ingest_labels(self, labeled_samples):
        """接收人工标注结果,进入训练缓冲"""
        for sample in labeled_samples:
            self.labeled_buffer.append(sample)

        # 缓冲区达到阈值触发增量训练
        if len(self.labeled_buffer) >= 500:
            self._trigger_incremental_training()

    def _trigger_incremental_training(self):
        """触发增量训练任务"""
        # 1. 数据增强与平衡
        # 2. 基于上一版模型做微调(避免灾难性遗忘)
        # 3. 在验证集上评估,达标后进入灰度部署
        pass
四、港口自动化:多模态感知与调度系统
4.1 自动化码头技术架构
全自动化集装箱码头是产业AI的复杂场景,涉及多系统协同:
┌─────────────────────────────────────────────────┐
│              港口调度大脑 (TOS)                    │
│   船舶计划 → 泊位分配 → 作业序列优化 → 资源调度     │
└──────────────────┬──────────────────────────────┘
                   │ 任务下发
    ┌──────────────┼──────────────┐
    ↓              ↓              ↓
┌────────┐  ┌──────────┐  ┌───────────┐
│ 岸桥   │  │  AGV/IGV  │  │  场桥     │
│ (STS)  │  │  自动导引车│  │  (ASC)    │
│        │  │           │  │           │
│ 视觉   │  │ 路径规划   │  │ 箱位识别  │
│ 锁定   │  │ 避障      │  │ 堆叠控制  │
│ 抓取   │  │ 车队协同   │  │ 翻箱优化  │
└────────┘  └──────────┘  └───────────┘
4.2 集箱号识别:OCR在工业场景的挑战
集装箱号识别看似简单,实际面临多重挑战:光照变化大(昼夜/天气)、箱号锈蚀/污损、字体不统一、拍摄角度多变。
技术方案:检测+识别两阶段
python
import cv2
import numpy as np

class ContainerCodeRecognizer:
    """集装箱号识别:YOLO检测 + CRNN识别"""

    def __init__(self, det_model, ocr_model):
        self.det_model = det_model  # YOLOv8检测模型
        self.ocr_model = ocr_model  # CRNN序列识别模型

    def recognize(self, image):
        # 1. 图像预处理:适应不同光照
        image = self._adaptive_preprocess(image)

        # 2. 检测箱号区域
        detections = self.det_model.predict(image)
        # detections: [(x1,y1,x2,y2, conf), ...]

        results = []
        for x1, y1, x2, y2, conf in detections:
            if conf < 0.5:
                continue
            # 3. 裁剪ROI
            roi = image[int(y1):int(y2), int(x1):int(x2)]

            # 4. 校验码验证(ISO 6346标准)
            code = self.ocr_model.predict(roi)
            if self._validate_check_digit(code):
                results.append({'code': code, 'confidence': conf})
            else:
                # 校验失败,可能OCR错误,尝试二次识别
                code = self._retry_recognition(roi)
                results.append({'code': code, 'confidence': conf * 0.8})

        return results

    def _adaptive_preprocess(self, image):
        """自适应预处理:CLAHE增强对比度"""
        gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
        clahe = cv2.createCLAHE(clipLimit=2.0, tileGridSize=(8, 8))
        enhanced = clahe.apply(gray)
        return cv2.cvtColor(enhanced, cv2.COLOR_GRAY2BGR)

    def _validate_check_digit(self, code):
        """ISO 6346校验码验证"""
        if len(code) != 11:
            return False
        # 前4位字母 + 6位数字 + 1位校验码
        letter_values = {chr(i): 10 + idx for idx, i in
                         enumerate(range(ord('A'), ord('Z')+1)) if chr(i) != 'E' and chr(i) != 'I' and chr(i) != 'O'}
        # ... 计算校验码并比对第11位
        return True  # 简化
4.3 AGV路径规划与避障
自动导引车(AGV)在港口大规模编队运行,路径规划需要兼顾全局效率和局部安全。
分层规划架构:
python
class AGVPathPlanner:
    """
    分层路径规划:
    - 全局层:A*算法在港口拓扑图上规划最优路径
    - 局部层:DWA(动态窗口法)实时避障
    """

    def __init__(self, port_map):
        self.global_map = port_map  # 港口栅格地图
        self.agv_positions = {}     # 所有AGV实时位置

    def global_plan(self, start, goal):
        """全局路径规划:改进A*,考虑其他AGV占用"""
        open_set = [(0, start)]
        came_from = {}
        g_score = {start: 0}
        f_score = {start: self._heuristic(start, goal)}

        while open_set:
            _, current = heapq.heappop(open_set)

            if current == goal:
                return self._reconstruct_path(came_from, current)

            for neighbor in self._get_neighbors(current):
                # 动态代价:其他AGV预定路径上的节点增加通行代价
                dynamic_cost = self._get_dynamic_cost(neighbor)
                tentative_g = g_score[current] + dynamic_cost

                if neighbor not in g_score or tentative_g < g_score[neighbor]:
                    came_from[neighbor] = current
                    g_score[neighbor] = tentative_g
                    f_score[neighbor] = tentative_g + self._heuristic(neighbor, goal)
                    heapq.heappush(open_set, (f_score[neighbor], neighbor))

        return None  # 无可行路径

    def local_plan(self, current_pos, current_vel, global_path, obstacles):
        """局部避障:动态窗口法"""
        # 1. 计算动态窗口(考虑加速度限制)
        dw = self._compute_dynamic_window(current_vel)

        # 2. 采样速度空间
        best_traj = None
        best_score = -float('inf')

        for v in np.arange(dw['v_min'], dw['v_max'], 0.1):
            for w in np.arange(dw['w_min'], dw['w_max'], 0.1):
                traj = self._simulate_trajectory(current_pos, current_vel, v, w)

                # 评分:目标导向 + 障碍物距离 + 速度
                score = (self._goal_score(traj, global_path) * 0.5 +
                         self._obstacle_score(traj, obstacles) * 0.3 +
                         self._velocity_score(v) * 0.2)

                if score > best_score:
                    best_score = score
                    best_traj = (v, w)

        return best_traj
五、矿山安全监控:时序异常检测与预警
5.1 技术挑战
矿山安全监控的核心需求是对瓦斯浓度、微震、应力等时序数据进行实时异常检测,在事故发生前预警。
技术难点:
- 多源异构传感器数据融合(瓦斯、温度、应力、微震、视频)
- 误报率要求极低(频繁误报会导致"狼来了"效应,工人忽视警报)
- 井下环境导致传感器漂移,需要持续校准
5.2 多传感器融合预警架构
python
import torch
import torch.nn as nn

class MultiSensorFusionModel(nn.Module):
    """
    多传感器时序融合模型:
    - 各传感器独立LSTM编码
    - Cross-Attention跨模态融合
    - 风险等级分类 + 异常时间预测
    """

    def __init__(self, sensor_configs, hidden_dim=128, num_heads=4):
        super().__init__()
        self.sensor_encoders = nn.ModuleDict()

        for name, config in sensor_configs.items():
            self.sensor_encoders[name] = nn.LSTM(
                input_size=config['input_dim'],
                hidden_size=hidden_dim,
                num_layers=2,
                batch_first=True,
                bidirectional=True
            )

        # 跨模态注意力融合
        self.cross_attention = nn.MultiheadAttention(
            embed_dim=hidden_dim * 2,
            num_heads=num_heads,
            batch_first=True
        )

        # 风险等级分类头
        self.risk_head = nn.Sequential(
            nn.Linear(hidden_dim * 2, 64),
            nn.ReLU(),
            nn.Linear(64, 4)  # 4级风险:正常/关注/预警/危险
        )

        # 异常时间预测头(回归:预计多少分钟后可能发生异常)
        self.time_head = nn.Sequential(
            nn.Linear(hidden_dim * 2, 64),
            nn.ReLU(),
            nn.Linear(64, 1)
        )

    def forward(self, sensor_inputs):
        """
        sensor_inputs: dict of {sensor_name: tensor[B, T, D]}
        """
        encoded = []
        for name, data in sensor_inputs.items():
            out, _ = self.sensor_encoders[name](data)
            encoded.append(out)  # [B, T, hidden*2]

        # 堆叠为多模态序列 [B, num_sensors, T, hidden*2]
        stacked = torch.stack(encoded, dim=1)
        B, S, T, D = stacked.shape

        # 每个时间步做跨传感器注意力
        fused_outputs = []
        for t in range(T):
            timestep_features = stacked[:, :, t, :]  # [B, S, D]
            fused, _ = self.cross_attention(
                timestep_features, timestep_features, timestep_features
            )
            fused_outputs.append(fused.mean(dim=1))  # [B, D]

        fused_seq = torch.stack(fused_outputs, dim=1)  # [B, T, D]
        last_hidden = fused_seq[:, -1, :]  # 取最后时间步

        risk_logits = self.risk_head(last_hidden)
        time_pred = self.time_head(last_hidden)

        return risk_logits, time_pred
5.3 传感器漂移补偿
井下传感器长期运行后会出现漂移,直接导致模型输入分布偏移(OOD问题):
python
class SensorDriftCompensator:
    """传感器漂移在线补偿"""

    def __init__(self, window_size=1000, drift_threshold=0.05):
        self.window_size = window_size
        self.drift_threshold = drift_threshold
        self.baseline_stats = None  # 出厂校准基线
        self.recent_buffer = []     # 近期数据滑动窗口

    def update_and_compensate(self, reading):
        """在线补偿:滑动窗口统计 + 基线偏移校正"""
        self.recent_buffer.append(reading)
        if len(self.recent_buffer) > self.window_size:
            self.recent_buffer.pop(0)

        if len(self.recent_buffer) < self.window_size:
            return reading  # 数据不足,不补偿

        # 计算近期统计量
        recent_mean = np.mean(self.recent_buffer)
        recent_std = np.std(self.recent_buffer)

        # 计算漂移量
        drift = recent_mean - self.baseline_stats['mean']

        if abs(drift) > self.drift_threshold:
            # 线性补偿
            compensated = reading - drift
            # 记录漂移事件,触发维护工单
            self._log_drift_event(drift, recent_mean, recent_std)
            return compensated

        return reading
六、产业AI的工程化挑战
6.1 模型可解释性
产业场景中,AI决策必须可解释------工厂安全主管需要知道"为什么模型判定这个零件不合格",矿山调度员需要知道"为什么系统发出瓦斯预警"。
技术方案:
python
import cv2
import numpy as np

def grad_cam_heatmap(model, image, target_layer, target_class):
    """
    Grad-CAM: 生成类激活热力图,解释模型关注区域
    适用于工业视觉检测:展示模型判定缺陷时关注的图像区域
    """
    # 注册前向和反向钩子
    activations = []
    gradients = []

    def forward_hook(module, input, output):
        activations.append(output)

    def backward_hook(module, grad_input, grad_output):
        gradients.append(grad_output[0])

    handle_fwd = target_layer.register_forward_hook(forward_hook)
    handle_bwd = target_layer.register_backward_hook(backward_hook)

    # 前向传播
    output = model(image)
    model.zero_grad()

    # 反向传播目标类
    output[0][target_class].backward()

    # 计算权重和热力图
    weights = gradients[0].mean(dim=(2, 3), keepdim=True)  # 全局平均池化
    cam = (weights * activations[0]).sum(dim=1, keepdim=True)
    cam = torch.relu(cam)  # 只保留正向贡献
    cam = cam.squeeze().cpu().numpy()

    # 归一化并叠加到原图
    cam = (cam - cam.min()) / (cam.max() - cam.min() + 1e-8)
    cam = cv2.resize(cam, (image.shape[3], image.shape[2]))
    heatmap = cv2.applyColorMap(np.uint8(cam * 255), cv2.COLORMAP_JET)

    handle_fwd.remove()
    handle_bwd.remove()

    return heatmap
6.2 系统可靠性设计
产业AI系统的可靠性要求远高于互联网应用,需要考虑:
可靠性设计清单:
├── 模型层
│   ├── 推理超时熔断(单次推理 > 100ms 自动降级)
│   ├── 置信度阈值过滤(低置信度转人工)
│   └── 模型版本回滚机制
├── 数据层
│   ├── 传感器数据校验(范围检查/异常值剔除)
│   ├── 数据缓冲与断点续传
│   └── 数据血缘追踪
├── 系统层
│   ├── 双机热备(主备切换 < 1s)
│   ├── 看门狗进程监控
│   └── 灰度发布与AB测试
└── 运维层
    ├── 模型性能监控(准确率/延迟漂移检测)
    ├── 数据分布监控(OOD检测告警)
    └── 故障自愈脚本
七、技术趋势与展望
7.1 端侧大模型
大模型正在从云端向边缘迁移。通过量化(INT4)、蒸馏、推测解码(Speculative Decoding)等技术,7B参数模型已可在Jetson Orin等边缘设备上运行:
云端大模型 (70B+) → 蒸馏 → 边缘小模型 (1-7B) → 量化 → INT4部署7.2 具身智能
矿山、港口场景的终极形态是具身智能------AI不仅有"大脑"(感知+决策),还有"身体"(机械臂/AGV/机器人),形成感知-决策-执行的闭环。
7.3 数字孪生
将物理工厂/港口/矿山映射为数字模型,AI在数字空间中做仿真推演和策略优化,再下发到物理世界执行:
物理世界 ←→ 数字孪生空间
  执行          仿真优化
  反馈          策略生成
总结
中国产业智能化的技术路径与硅谷"大模型至上"的叙事不同,它更关注:
- 边缘部署能力:模型必须在恶劣环境、有限算力下稳定运行
- 数据闭环工程:持续的数据采集-标注-训练-部署循环是核心竞争力
- 多模态融合:工业场景需要融合视觉、时序、传感器等多源数据
- 可靠性保障:产业场景容错率极低,系统设计必须以安全为第一优先级
- 可解释性:AI决策必须能向一线工人和管理者解释清楚
这些技术挑战的答案确实不在论文里,而在矿山井下、港口码头、工厂产线的工程实践中。理解这些场景的技术约束和解决方案,才能真正读懂中国产业智能化的底层逻辑。