3D Gaussian Splatting 项目详解
仓库:
graphdeco-inria/gaussian-splatting(Inria GRAPHDECO 官方实现)论文:3D Gaussian Splatting for Real-Time Radiance Field Rendering (SIGGRAPH 2023, ACM TOG)
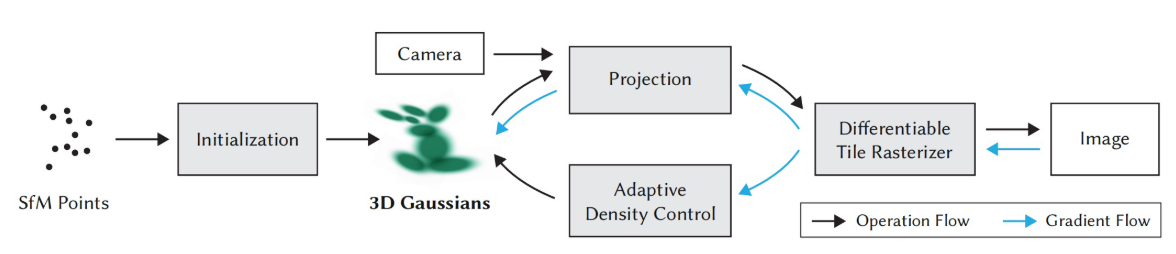
目录
- 项目介绍
- 它解决了什么问题
- [NeRF 是怎么做的](#NeRF 是怎么做的)
- 输入:从多视角照片到相机与点云
- [COLMAP / SfM 是什么](#COLMAP / SfM 是什么)
- [模型表示:3D 高斯是什么](#模型表示:3D 高斯是什么)
- [训练过程:渲染 → 比对 → 反传](#训练过程:渲染 → 比对 → 反传)
- 密度控制:哪里放高斯,哪里不放
- [渲染核心:splat / tile / 排序 / alpha 混合 / 可微光栅化](#渲染核心:splat / tile / 排序 / alpha 混合 / 可微光栅化)
- 为什么方向相反还能重建
- 为什么又快又好
- 输出与推理
- 代码地图与关键参数
- 学习路径
- [NeRF 与 3DGS 的技术栈对比](#NeRF 与 3DGS 的技术栈对比)
1. 项目介绍
这是论文 3D Gaussian Splatting(3DGS) 的官方实现。
一句话:输入一批从不同角度拍摄的照片,重建出一个可以实时渲染任意新视角的三维场景。
它的效果直观理解是:训练完成后,你可以像玩 3D 游戏一样,在场景里自由移动视角,实时看到画面。
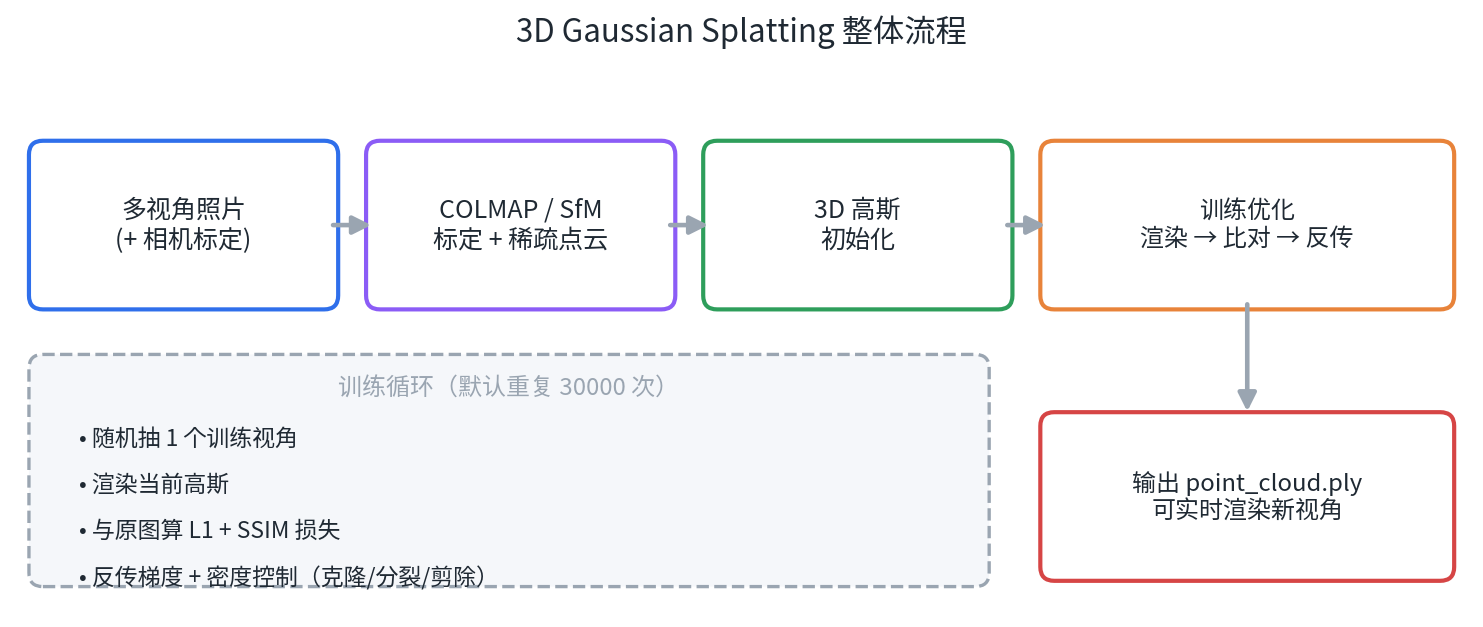
整个流程只有四步:
- 拍照片(多视角照片)
- 用 COLMAP / SfM 做相机标定,得到相机参数和稀疏点云
- 用这些点云初始化一堆 3D 高斯
- 训练优化这些高斯,最后输出一个
.ply模型文件
2. 它解决了什么问题
在 3DGS 出现之前,主流是新视角合成(Novel View Synthesis):
- NeRF / Mip-NeRF360 :画质高,但极慢(1080p 通常不到 1 fps,训练要几十小时)
- Plenoxels / InstantNGP :更快,但画质有损失,且在无界大场景 + 1080p下仍做不到实时
核心矛盾:「快」和「好」长期不可兼得。
论文原话:对于无界完整场景(而不是孤立物体)的 1080p 渲染,之前没有任何方法能实时。
3DGS 的目标就是同时拿到高画质 + 实时渲染 + 较短训练时间。
而它达成的关键,是三个设计(后面各节逐一展开):
- 用 3D 高斯做显式场景表示(而不是神经网络)
- 交错的优化 / 密度控制(自适应增删高斯)
- 可见性感知的快速可微光栅化(替代逐光线体渲染积分)
3. NeRF 是怎么做的
要理解 3DGS 的取舍,必须先把 NeRF 讲透。这一节从头讲一遍 NeRF 的完整原理。
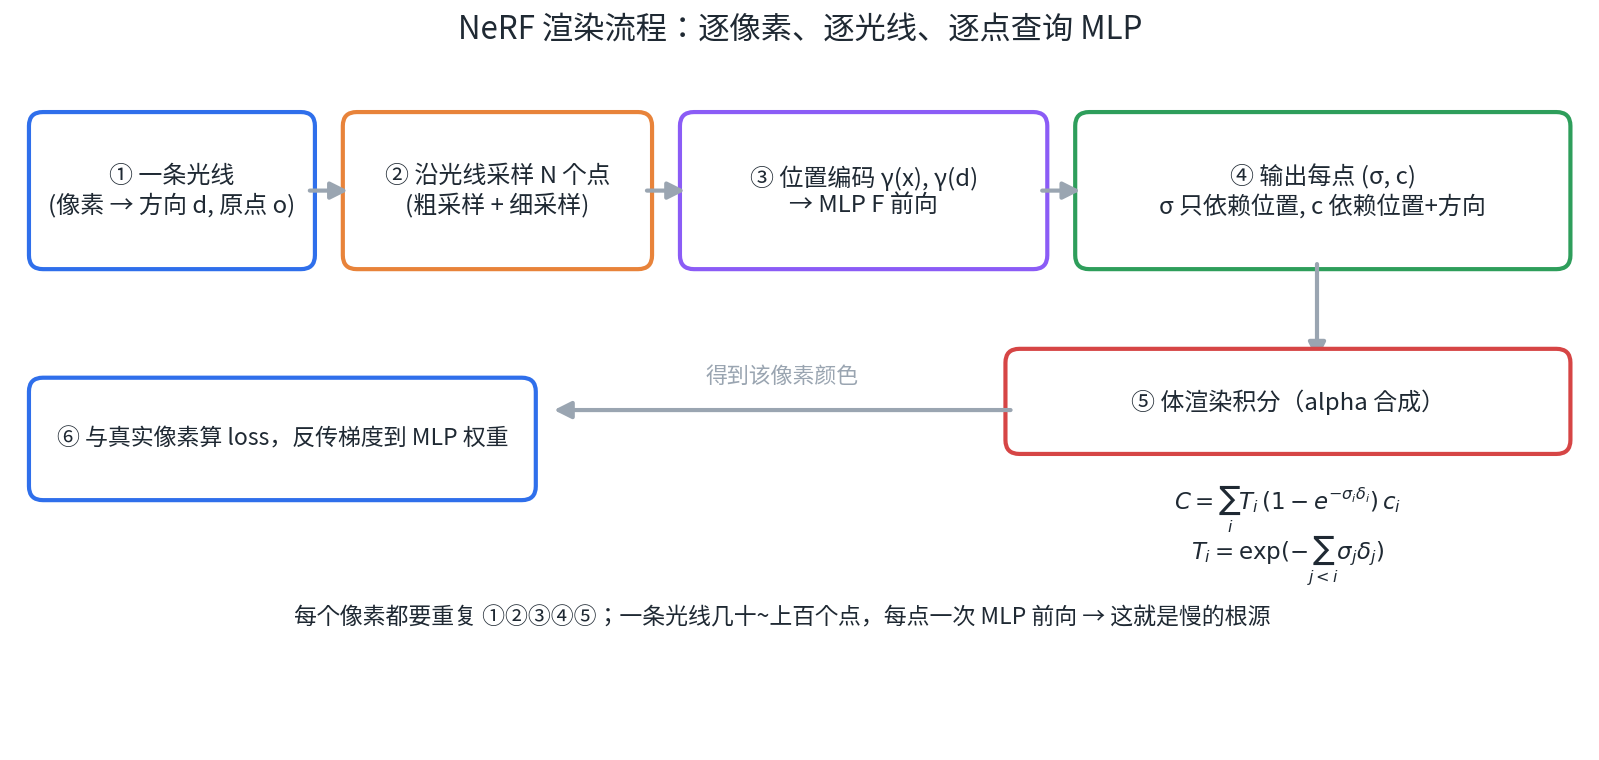
3.1 核心思想:用一个函数表示整个场景
NeRF(Neural Radiance Field,神经辐射场)的核心假设是:
整个三维场景,可以用一个连续的数学函数来描述。
这个函数是:
F(x, y, z, θ, φ) → (σ, r, g, b)- 输入 :空间中一个 3D 点的坐标
(x, y, z),加上一个观察方向(θ, φ)(单位方向向量d) - 输出 :
σ:该点的体积密度(有多不透光)(r, g, b):该点朝这个方向看过去的颜色
NeRF 用一个 MLP(多层感知机) 来拟合这个函数。训练完成后,网络权重里就「装下了」整个场景。
关键点 :这是一个隐式表示------场景没有显式的几何形状,你无法直接从网络里拿出来一个「物体」,只能通过查询函数得到某个位置的信息。
3.2 渲染:从像素发射光线
渲染一张图时,NeRF 对每个像素做下面这套流程:
① 生成光线
用相机内外参,从像素 (u, v) 和相机光心 o 出发,确定一条光线:
r(t) = o + t · d其中 d 是归一化的射线方向,t 是沿光线的距离参数(近端 t_near 到远端 t_far)。
② 沿光线采样
在 [t_near, t_far] 之间取 N 个采样点 t₁, t₂, ..., t_N。
- 原始 NeRF 用 粗网络 + 细网络 两级采样:先均匀粗采样,再根据粗网络的密度分布在「可能有物体」的地方细采样(重要性采样)
- InstantNGP 等后续工作改用哈希网格加速查询,但思路一样:还是要沿光线取很多点
③ 位置编码(Positional Encoding)
直接把 (x, y, z) 喂给 MLP 会导致网络偏向学习低频(模糊)结果。所以 NeRF 先把坐标映射到高维:
γ(p) = (sin(2⁰πp), cos(2⁰πp), sin(2¹πp), cos(2¹πp), ..., sin(2^{L-1}πp), cos(2^{L-1}πp))这一招让 MLP 能表达高频细节(纹理、边缘)。位置用 L=10,方向用 L=4。
④ MLP 前向
F_Θ( γ(x), γ(d) ) → (σ, c)- 网络通常是 8 层全连接 + ReLU,宽度 256
σ只依赖位置 (γ(x)),因为密度是几何属性,与观察方向无关c依赖位置 + 方向(把方向拼接到中间层特征上),这样能表达镜面反射等视角相关效果
⑤ 体渲染积分
得到沿光线的 N 个 (σᵢ, cᵢ) 后,用经典的体渲染公式合成像素颜色:
C = Σᵢ Tᵢ · (1 - exp(-σᵢ δᵢ)) · cᵢ
Tᵢ = exp( - Σ_{j<i} σⱼ δⱼ )
其中 δᵢ 是相邻采样点的间距。
直觉解读:
αᵢ = 1 - exp(-σᵢ δᵢ)是第i个点的不透明度(密度越高、间距越大越不透明)Tᵢ是透光率 :光从相机走到第i个点,还没被前面挡掉的比例- 所以
C就是「每个点贡献自己的颜色 × 自己的不透明度 × 前面剩下的透光率」的加权和
这和 3DGS 的 alpha 混合公式本质完全一样,只是 NeRF 的点是沿光线采样出来的,3DGS 的点是空间中的高斯。
⑥ 计算损失并反传
L = Σ_pixels ‖ C_render - C_gt ‖²梯度反传回 MLP 权重,更新网络。因为整套流程可微,所以能端到端训练。
3.3 为什么 NeRF 慢
把上面的流程算一下成本:
- 一张 1080p 图像 ≈ 200 万像素
- 每个像素一条光线
- 每条光线采
N个点(原始 NeRF 是 64 粗 + 128 细 = 192 个点) - 每个点都要跑一次完整的 MLP 前向(8 层 × 256 维)
结果:渲染一张图需要约 4 亿次网络前向的量级。这就是它慢的根本原因------不是实现不好,而是「逐像素 × 逐光线 × 逐点查网络」这个结构本身的计算量太大。
而且还有个浪费:光线穿过空白区域(天空、空气)时,照样要采样、照样要查网络,但这些点对最终颜色几乎没有贡献。
4. 3d高斯泼溅
输入:从多视角照片到相机与点云
训练需要三类输入,它们分别负责不同的事情:
| 数据 | 回答的问题 | 在 3DGS 中的作用 |
|---|---|---|
| 外参 (R, T) | 相机在哪、朝哪 | 决定「从哪个视角渲染」 |
| 内参 (fx, fy, W, H) | 如何投影成像 | 决定「3D 点落到哪个像素」 |
| 稀疏点云 | 场景大概长什么样 | 决定「高斯从哪里开始、初始多大」 |
为什么会需要这三样?
因为 3DGS 的训练本质是一个循环:
用相机参数把 3D 高斯投影成 2D 图像 → 和真实照片比对 → 反传修正高斯
- 没有外参 → 不知道该渲染哪个视角,损失无从计算
- 没有内参 → 不知道 3D 点该落在哪个像素,渲染尺寸对不上
- 没有点云 → 只能随机初始化,优化更难收敛
4.1 内参与外参
用针孔相机模型来理解:
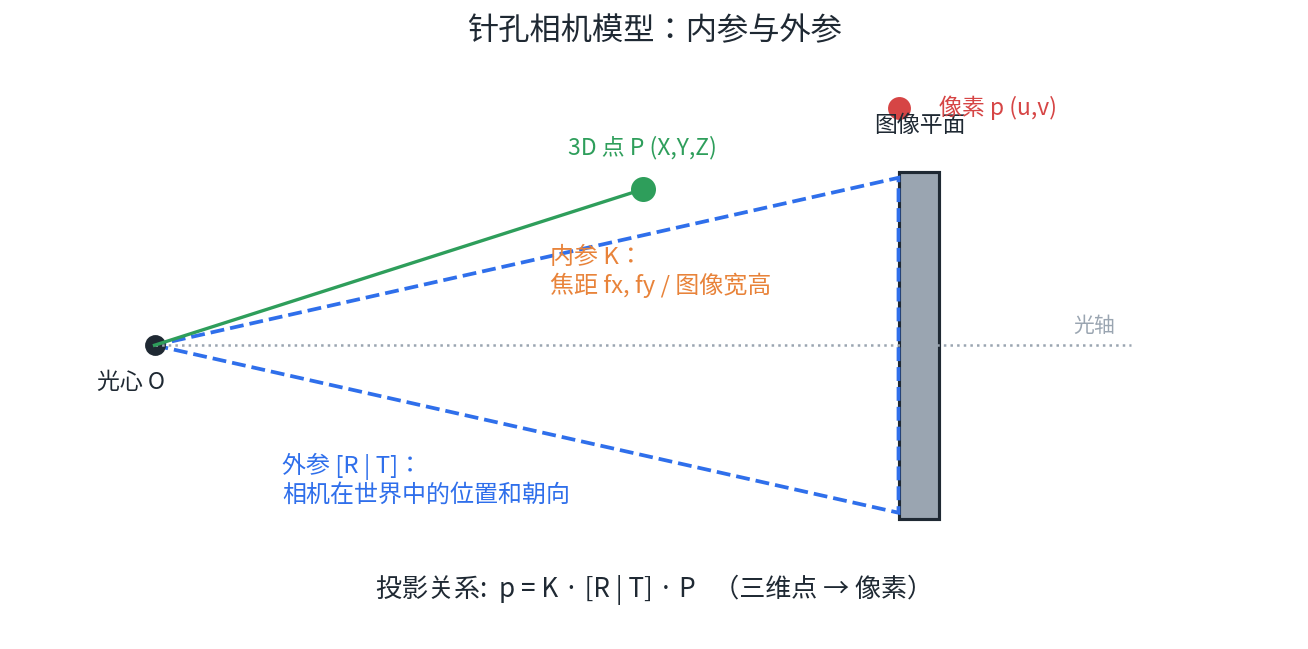
投影公式:
像素坐标 p = K · [R | T] · 世界点 P- 外参
[R | T]:R旋转 +T平移,描述相机在世界坐标系中的位姿。代码里getWorld2View2(utils/graphics_utils.py:38)把世界坐标转到相机坐标。 - 内参
K:焦距fx, fy和图像宽高W, H。代码把它们换算成视场角(utils/graphics_utils.py:73):focal2fov(focal, pixels) = 2 · atan(pixels / (2 · focal))- 焦距越大 → 视场越窄 → 物体投影越大
注意 :3DGS 只支持 PINHOLE / SIMPLE_PINHOLE 这两种无畸变 的相机模型(scene/dataset_readers.py:88-97)。带畸变的模型(RADIAL、OPENCV 等)会直接报错,必须先让 COLMAP 去畸变。
4.2 稀疏点云
COLMAP 输出的 points3D 每个点只有 XYZ 坐标 + RGB 颜色 ,它不是高斯的全部参数。
剩下这些参数是 3DGS 初始化时构造出来的(scene/gaussian_model.py:119 create_from_pcd):
| 高斯参数 | 初值来源 |
|---|---|
位置 _xyz |
直接用点的 XYZ |
| 颜色 | 点 RGB 转成球谐的 DC 项(RGB2SH) |
尺度 _scaling |
到最近邻点的距离(distCUDA2),点密则小、点疏则大 |
旋转 _rotation |
单位四元数(无旋转) |
不透明度 _opacity |
固定初值 0.1 |
| 协方差 Σ | 由尺度和旋转算出,不是直接给的 |
所以准确说法是:COLMAP 点云提供高斯的「出生位置和基础颜色」,其余参数是构造出来的,再靠训练优化。
5. COLMAP / SfM 是什么
COLMAP 是一个开源的摄影测量 / Structure-from-Motion(SfM)工具。给它一堆从不同角度拍同一场景的照片,它反推出:
- 每张照片拍摄时相机在哪、朝哪(外参)
- 相机的焦距 / 成像特性(内参)
- 场景中一批稀疏的三维点(点云)
这正是 3DGS 需要的全部输入。
5.1 名字的含义
- Structure(结构):场景的三维结构
- Motion(运动):拍摄时相机的运动轨迹
- from Motion:从相机运动中恢复出三维结构
5.2 四个步骤
- 特征提取:在每张照片里找出特征点(角点、纹理丰富的区域)。纯色墙、天空提不出特征,这也解释了为什么这些地方后来没有高斯。
- 特征匹配:找出「照片 A 的哪个点和照片 B 的哪个点是同一个三维点」。
- 稀疏重建:用三角测量算出三维点坐标,用光束法平差(Bundle Adjustment)联合优化相机位姿和三维点。
- 稠密重建(MVS) :可选,3DGS 不需要这一步,它只用稀疏点云。
5.3 输出目录结构
<scene>/
  images/                    # 去畸变后的照片
  sparse/0/
    cameras.bin   -> 内参(焦距、分辨率、相机模型)
    images.bin    -> 外参(每个相机的 R 旋转、T 平移)
points3D.bin -> 稀疏三维点(XYZ + RGB),高斯的初始位置对应代码:scene/dataset_readers.py:144 读取。
5.4 验收标准
判断 COLMAP 跑得好不好:
- 注册的相机数量:是否几乎覆盖所有照片
- 重投影误差:一般应 < 1 像素
- 点云密度和分布:是否覆盖场景主要结构
6. 模型表示:3D 高斯是什么
6.1 先理解 NeRF 在做什么
NeRF 的网络输入是空间中任意一个 3D 点的坐标 + 一个观察方向:
F(x, y, z, θ, φ) → (密度 σ, 颜色 c)也就是:给它空间中任意一点,它告诉你「这里有多不透光、朝某方向看是什么颜色」。
注意两个常见误解:
- ❌ NeRF 的输入不是「带位置的图片」,也不是 2D 像素
- ❌ NeRF 的输出不是直接的 2D 像素颜色
渲染时是从像素发射一条光线,在光线上采样很多 3D 点,逐点查网络,再积分算出像素颜色。
慢的根本原因:每个像素 → 发一条光线 → 沿光线采样几十上百个点 → 每个点跑一次 MLP 前向 → 再做体渲染积分。1080p 有 200 万像素,量级巨大。
可以用一个类比:想象空间里弥漫着一层半透明的彩色雾,每个位置的浓淡(σ)和颜色(c)由网络定义。NeRF 学的是这层「雾」的函数。
6.2 3D 高斯是什么
3DGS 不再用「连续函数 + 逐点采样」,而是直接在空间里放很多个半透明的椭球 (高斯球)。可以想成空气中悬浮的、可长可扁、可调朝向的彩色糖豆。
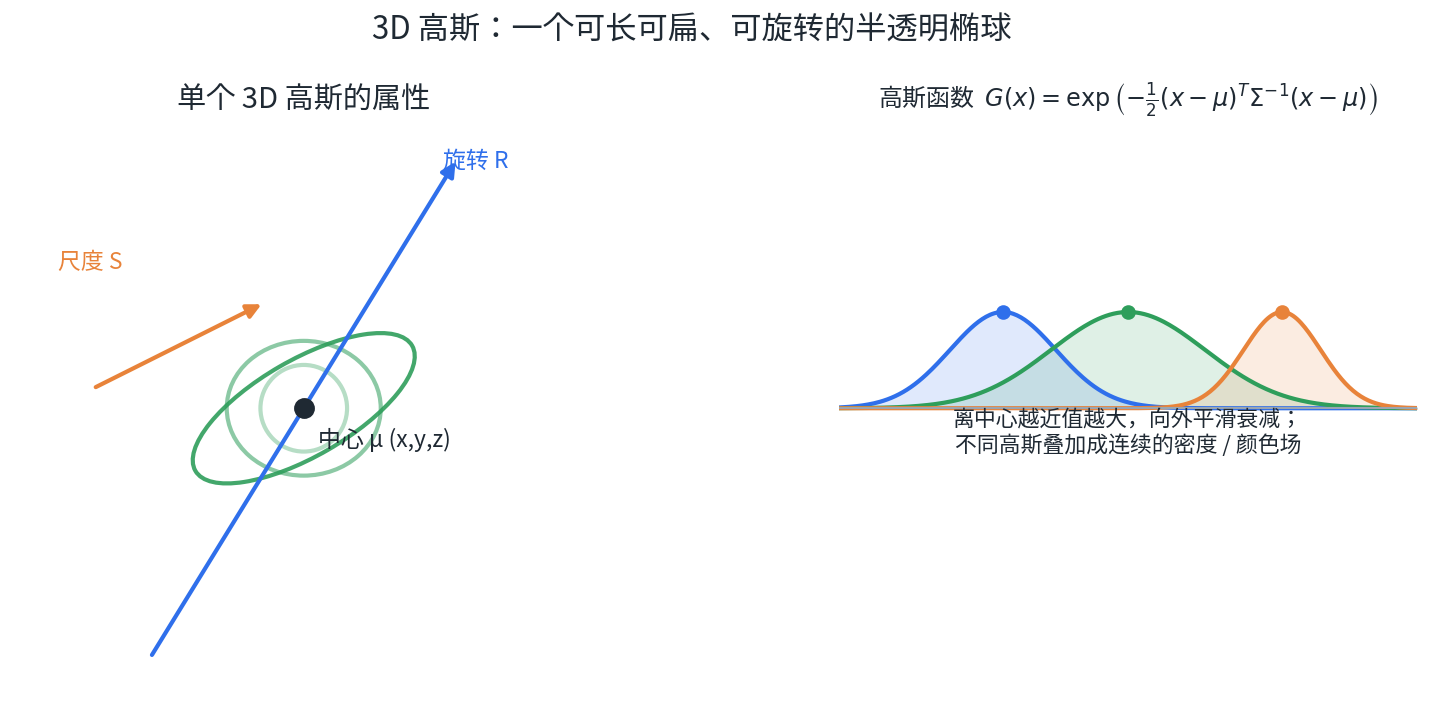
每个高斯的属性(scene/gaussian_model.py):
-
位置 μ:中心在哪 (x, y, z)
-
协方差 Σ:形状。由缩放 S 和旋转 R 决定:
Σ = R S Sᵀ Rᵀ
-
缩放让它能变椭球、能各向异性拉长
-
旋转让椭球朝向任意方向------这是它能贴合薄面、细结构的关键
-
不透明度 α:这颗糖豆有多「实」,介于 0~1
-
颜色:用球谐系数(SH)表示,能随视角变化出不同颜色(镜面反光等)
6.3 高斯为什么是「连续」的
单个 3D 高斯本身就是一个连续函数:
G(x) = exp( -½ (x - μ)ᵀ Σ⁻¹ (x - μ) )离中心越近值越大,向外平滑衰减。
关键点 :所以 3DGS 依然是连续的、可微的表示,不是离散体素------这正是它能保留 NeRF 那种「可微体渲染、能优化」优点的原因。
区别只在计算方式:
- NeRF 沿光线密集采样、逐点查网络
- 3DGS 把每个高斯直接投影到屏幕变成 2D 椭圆,只对覆盖到的像素加权混合
6.4 3D 高斯与 NeRF 的关系
两者描述的是同一件事------空间的密度和颜色场------只是形式不同:
| NeRF | 3DGS | |
|---|---|---|
| 形式 | 隐式:存在网络权重里 | 显式:一颗颗高斯叠加 |
| 查询 | 必须过一遍 MLP | 直接读参数 |
| 元素操作 | 无法直接查看/编辑 | 可逐个增删、移动 |
某个位置的「密度」≈ 该点落进各个高斯内部的概率之和;某方向的「颜色」≈ 各高斯加权平均。
7. 训练过程:渲染 → 比对 → 反传
主循环在 train.py:80,每次迭代:
-
随机抽一张训练相机 (
train.py:96) -
渲染 :用
render()把当前高斯投到该视角,得到渲染图、可见性掩码、2D 半径、深度 -
算损失 (
train.py:122):L = (1 - λ) · L1 + λ · (1 - SSIM)
默认 λ = 0.2。直觉:L1 保证像素级准确,SSIM 保证结构相似。
如果启用深度正则化,再加一项逆深度 L1。
- 反传 :
loss.backward(),用 Adam 更新所有高斯参数 - 密度控制:增删高斯(见下一节)
- 位置的学习率按指数调度逐步衰减(
get_expon_lr_func)
另外,球谐阶数每 1000 步升一级(gaussian_model.py:113 oneupSHdegree),逐步提升对视角相关外观的表达能力。
8. 密度控制:哪里放高斯,哪里不放
短答:不是所有区域都铺高斯。
高斯只出现在有内容的地方,靠训练中动态增删实现。
8.1 初始化已经在筛了
create_from_pcd 只在 COLMAP 的稀疏点上创建高斯,而这些点本身只存在于有纹理、可匹配的地方。天空、纯色墙、玻璃这类无特征区域,COLMAP 根本不出点,初始就没有高斯。
(如果是 Blender/NeRF 合成数据没有点云,程序会随机撒 10 万个点,dataset_readers.py:296------这是被迫「全区域铺」,效果通常更差。)
8.2 训练中的增删规则
核心是 densify_and_prune(gaussian_model.py:392),在 densify_from_iter(默认 500 步)到 densify_until_iter(默认 15000 步)之间,每 100 步执行一次。
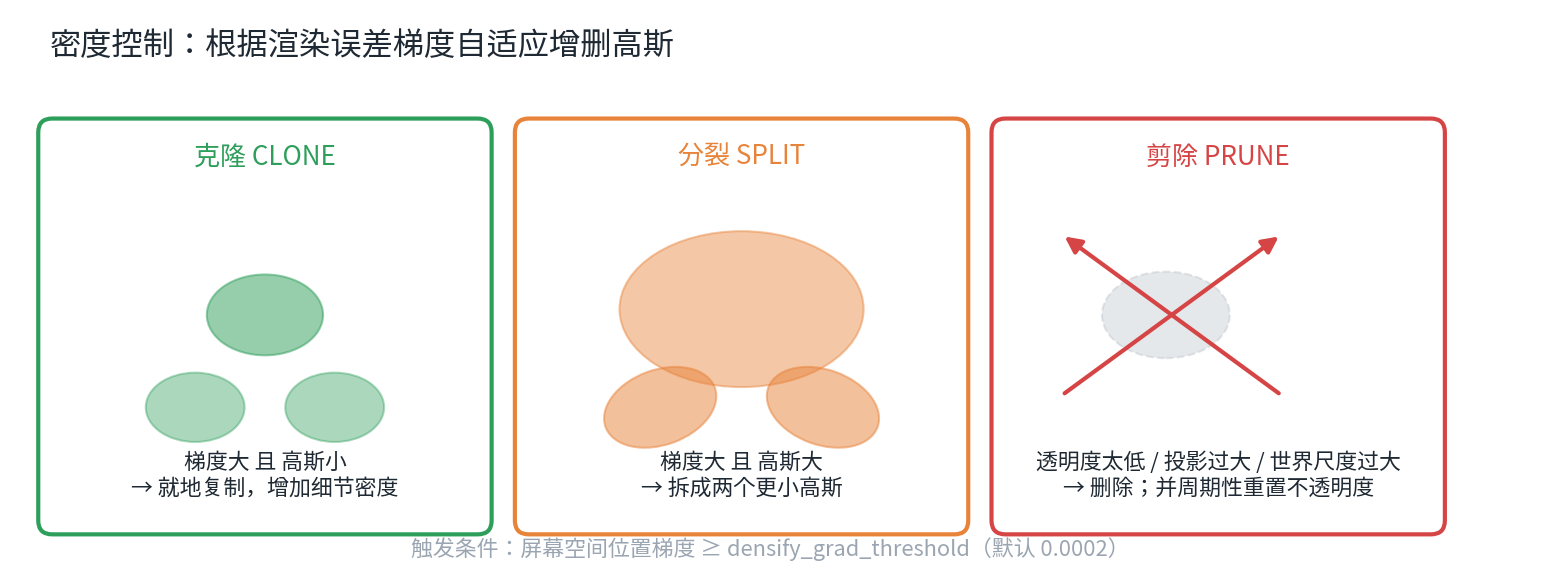
加(克隆 / 分裂) ------判据是屏幕空间位置梯度,梯度大说明「这里没拟合好」:
- 梯度 ≥
densify_grad_threshold(默认 0.0002)→ 候选 - 候选里,高斯小 → 克隆(就地复制一份),增加局部密度
- 候选里,高斯大 → 分裂 (拆成 2 个更小的),提高分辨率
- 「大/小」的界:
max(scaling) > percent_dense · scene_extent(默认percent_dense = 0.01)
- 「大/小」的界:
减(剪除)------三种都没用了就删:
- 不透明度太低(
< 0.005):几乎透明的废高斯 - 屏幕投影过大(
> 20像素):横跨半张图,通常是错误的背景解 - 世界尺度过大(
> 0.1 · scene_extent):占满场景的超大高斯
不透明度重置 :每 opacity_reset_interval(默认 3000 步)把所有高斯不透明度压到 ≤0.01,让「滥竽充数」的高斯在下一轮被剪掉,同时给新位置腾出生长空间。这是防止高斯只增不减的关键机制。
8.3 结果
高斯数量从初始几千个 SfM 点,逐步长到几百万个,全部集中在有纹理、有细节、重建误差大的地方(树叶、栏杆、细纹理),而平坦区域、空旷区域高斯很稀疏甚至没有。
这就是它比 NeRF 均匀采样更高效的原因------自适应地匹配场景的复杂度分布。
9. 渲染核心:splat / tile / 排序 / alpha 混合 / 可微光栅化
这是整个方案最核心、也最「工程」的部分(submodules/diff-gaussian-rasterization)。用「往屏幕上撒彩色糖豆」的直觉来理解。
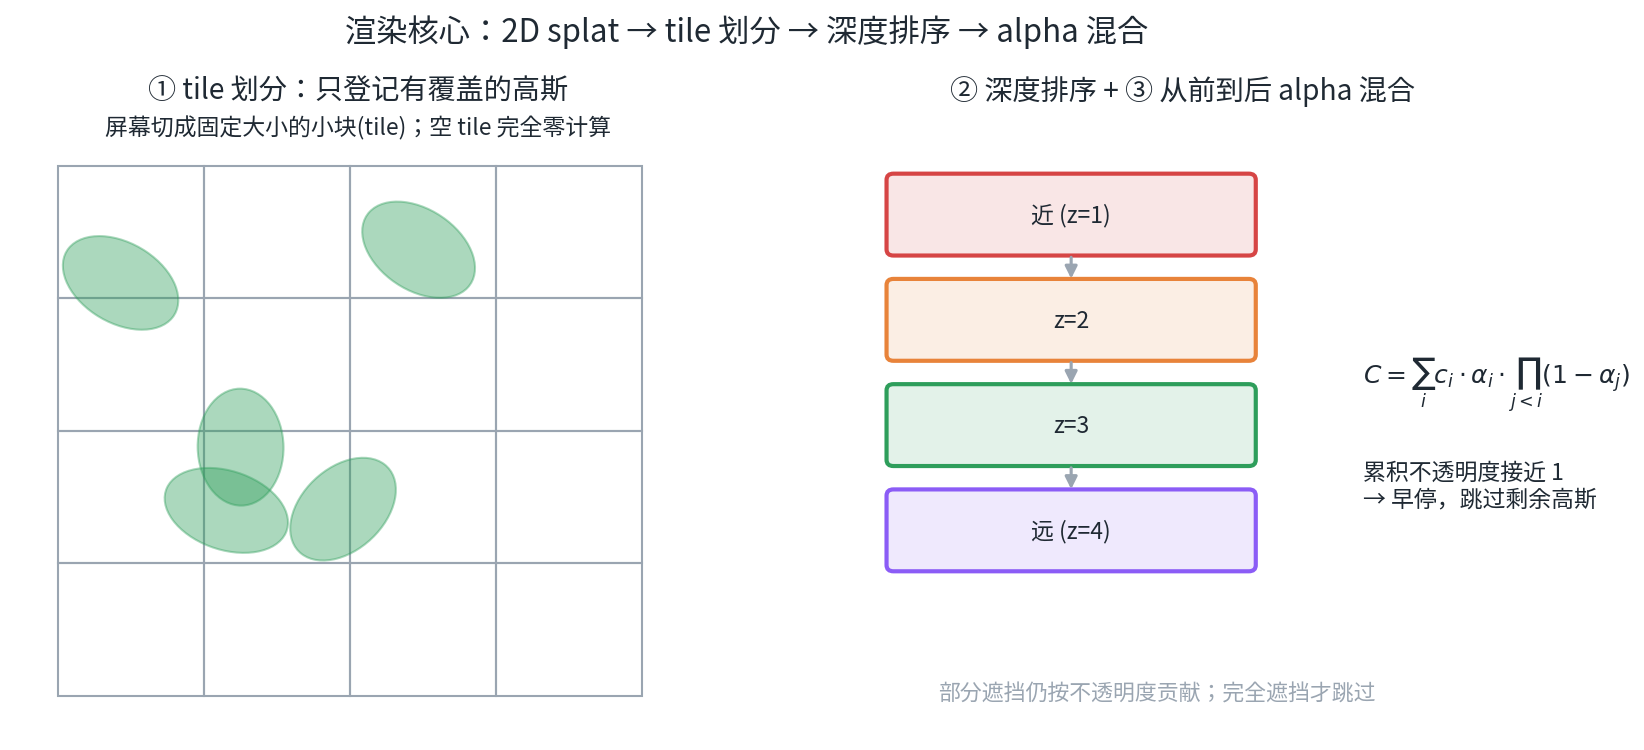
① 2D splat(把 3D 高斯投到屏幕)
- 每个 3D 高斯是空间中的椭球,
splat就是把它投影到屏幕------3D 椭球投下来还是 2D 椭圆。 - 投影用相机的内外参:外参决定从哪看,内参决定投到屏幕哪里、多大。
- 投影后得到:屏幕上的中心位置、2D 椭圆形状、深度、颜色、不透明度。
- 和 NeRF 最大的区别:NeRF 是「从像素射光线出去找点」,3DGS 是「从点投到像素上来」。方向反了,这是快的第一层原因。
② tile 划分(把屏幕切成小块)
- 屏幕被切成很多个固定大小的正方形 tile(如 16×16 像素)。
- 每个 splat 只登记到它覆盖的 tile 上。
- 空区域没有任何高斯覆盖,对应 tile 完全零计算。
- 同时一个 tile 内像素可并行处理,内存访问局部化。
③ 深度排序(保证前后遮挡关系对)
- 同一个 tile 上会有很多 splat 重叠,必须按深度从近到远排序再混合。
- 为什么必须排序 :alpha 混合不可交换 。顺序错了,近的物体就不能正确遮住远的,颜色会算错。
- 例:近的红色不透明 1.0,远的蓝色不透明 1.0。正确顺序(近→远)结果 = 红色;顺序反了会得到错误结果。
- 排序本身是为了正确性,不是可选项。
④ alpha 混合(怎么合成一个像素颜色)
从前到后依次混合,公式和体渲染一致:
C = Σᵢ cᵢ · αᵢ · Π_{j<i}(1 - αⱼ)直觉:每个高斯贡献自己的颜色 c,权重 = 自己的不透明度 α ×「被前面所有高斯挡住后还剩多少透光」。
早停(early termination) :当累积不透明度 Σα 接近 1(后面彻底看不见了),剩下的高斯直接跳过。
注意纠正一个常见误解:
- ❌ 不是「先做前面的,后面的就不做了」
- ✅ 是「按顺序累积,完全不透明后才停」
- 部分遮挡的高斯仍会按不透明度贡献颜色,只是贡献很小
⑤ 可微光栅化(为什么能训练)
- 普通图形学光栅化只求「画得快」,不可导,不能训练。
- 这里每一步(投影、混合公式)都写成对高斯参数可微 的形式。渲染图和真实照片算损失后,梯度能反传回每一个高斯的位置、协方差、不透明度、球谐颜色。
- 细节:为了让反向传播高效,作者把梯度计算放在 CUDA kernel 里手写实现,而不是靠 PyTorch 自动搭图。这既是它快、也是它能训练的原因。
全流程串联
3D 高斯集合
   │  ① 用相机内外参投影(splat)
   ▼
屏幕上的 2D 椭圆
   │  ② 登记到它覆盖的 tile
   ▼
每个 tile 一份高斯列表
   │  ③ 按深度排序
   ▼
有序列表
   │  ④ 从前到后 alpha 混合(可早停)
   ▼
渲染图像
   │  ⑤ 和原图比 loss,梯度反传回高斯参数
   ▼
更新位置/协方差/不透明度/颜色 → 下一轮
10. 为什么方向相反还能重建
这是一个很本质的问题。
物理上只有一个方向:光从场景到相机。
场景中的点 → 发出/反射光 → 沿直线传播 → 穿过小孔 → 打在传感器某个像素上像素是「果」,场景点是「因」。
- 光栅化(3DGS)顺着物理方向走:拿着场景点,正向投影,算出它落在哪个像素。
- 光线追踪 / NeRF 逆着物理方向走:从像素反向发射光线,回溯它「当初是从场景哪个点来的」。
所以「方向相反」不是两件不同的事,而是同一条直线,从两端各看一眼。
数学上是一对手性相反的变换:
- 正向(3DGS):世界点 → 像素。确定性投影。
- 反向(NeRF):像素 → 射线。深度未知,所以才要沿光线采样很多点,靠体渲染积分「猜」深度。
重建能成立的核心:多视角约束 + 可微优化。
- 同一个真实 3D 点,在多个视角的投影必须一致。
- 3DGS 直接假设 场景由一堆高斯构成,投到某视角和照片比对,哪里不对就调整高斯。
- 训练时随机换不同视角,每个视角都是对「同一批高斯」的一个约束。几十上百个视角一起约束,高斯就被逐步逼到正确解。
就像从不同角度给一个物体拍照,虽然每张都是 2D,但把多张放一起,形状就被「夹」出来了。
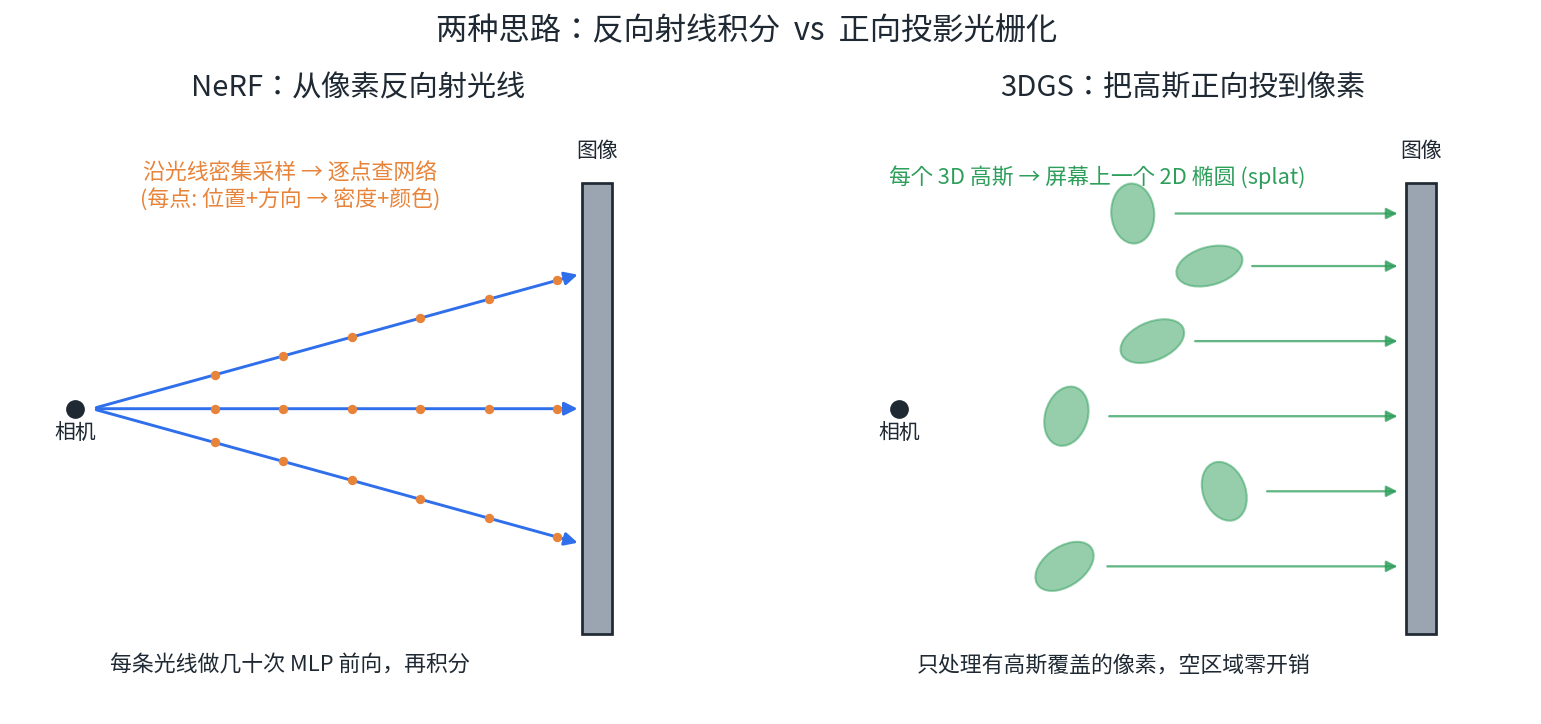
一句话:方向只决定计算路径,不决定能否重建;重建依据的是「多视角一致性 + 可微优化」。
11. 为什么又快又好
快的原因
- 表示显式:没有网络前向,直接读高斯参数
- 只算有内容的地方:空区域没有高斯,零开销(NeRF 在空空间照样采样)
- 光栅化 + tile 并行:GPU 天然适合,比串行逐光线高效
- 早停:完全遮挡后跳过剩余高斯
- CUDA 手写 kernel:前向反向都高度优化
好的原因
- 避免空区域伪影:只在高斯存在处渲染,边界更锐利
- 能表达高频细节:自适应增密 + 各向异性拉长,细结构表达力强
- 保留体渲染优点:alpha 混合等价于体渲染离散化,可微、可优化
- 无界完整场景:第一次在 1080p 无界场景下做到画质领先且实时
权衡(诚实说明)
- 显存占用大:几百万个高斯,训练需 24GB 级别显存
- 显式表示:文件体积比 NeRF 的 checkpoint 大,但换来可直接光栅化、易编辑(剪裁、变形、组合)
- 依赖初始点云质量:SfM 失败的区域难以补全(无纹理区域容易空洞或模糊)
12. 输出与推理
训练完成后,最重要的产物:
output/<id>/point_cloud/iteration_XXX/point_cloud.ply:3D 高斯模型。PLY 里每个点存位置、SH 颜色系数、不透明度、缩放、旋转(gaussian_model.py:232)cameras.json:相机参数记录input.ply:原始稀疏点云副本exposure.json:每张图的曝光参数(若启用)chkpntXXX.pth:训练检查点,可续训- TensorBoard 日志(loss、PSNR 等)
推理 / 渲染:
render.py加载训练好的point_cloud.ply,对任意新视角实时渲染metrics.py计算 PSNR / SSIM / LPIPSSIBR_viewers/提供 OpenGL 实时交互查看器
标准命令
shell
# 训练
python train.py -s <path to COLMAP dataset>

# 训练(带评测划分)
python train.py -s <path> --eval

# 渲染
python render.py -m <path to trained model>

# 计算指标
python metrics.py -m <path to trained model>
13. 代码地图与关键参数
代码地图
| 文件 / 目录 | 作用 |
|---|---|
train.py |
训练主循环 |
render.py |
训练后渲染 |
metrics.py / full_eval.py |
评测指标 |
convert.py |
把自定义图片转成 COLMAP 数据集 |
scene/gaussian_model.py |
高斯模型定义、优化、密度控制、存取 |
scene/dataset_readers.py |
数据集读取(COLMAP / Blender) |
scene/__init__.py |
场景组装(相机 + 点云 + 高斯) |
gaussian_renderer/ |
渲染封装(调用 CUDA 光栅化器) |
submodules/diff-gaussian-rasterization |
可微光栅化 CUDA 核心 |
submodules/simple-knn |
最近邻距离(初始化尺度用) |
SIBR_viewers/ |
OpenGL 实时查看器 |
arguments/ |
命令行参数定义 |
关键参数(默认值)
| 参数 | 默认 | 含义 |
|---|---|---|
--iterations |
30000 | 总训练步数 |
--sh_degree |
3 | 球谐阶数(≤3) |
--lambda_dssim |
0.2 | loss 中 SSIM 的权重 |
--densify_from_iter |
500 | 开始增密 |
--densify_until_iter |
15000 | 停止增密 |
--densify_grad_threshold |
0.0002 | 增密梯度阈值 |
--densification_interval |
100 | 增密间隔 |
--opacity_reset_interval |
3000 | 不透明度重置间隔 |
--percent_dense |
0.01 | 「大高斯」判定比例 |
--position_lr_init |
0.00016 | 位置初始学习率 |
--position_lr_final |
0.0000016 | 位置最终学习率 |
14. NeRF 与 3DGS 的技术栈对比
这一节把两者的每一层技术选型摊开来对比,你能清楚看到 3DGS 是「在哪一层做了什么替换」才换来快和好。
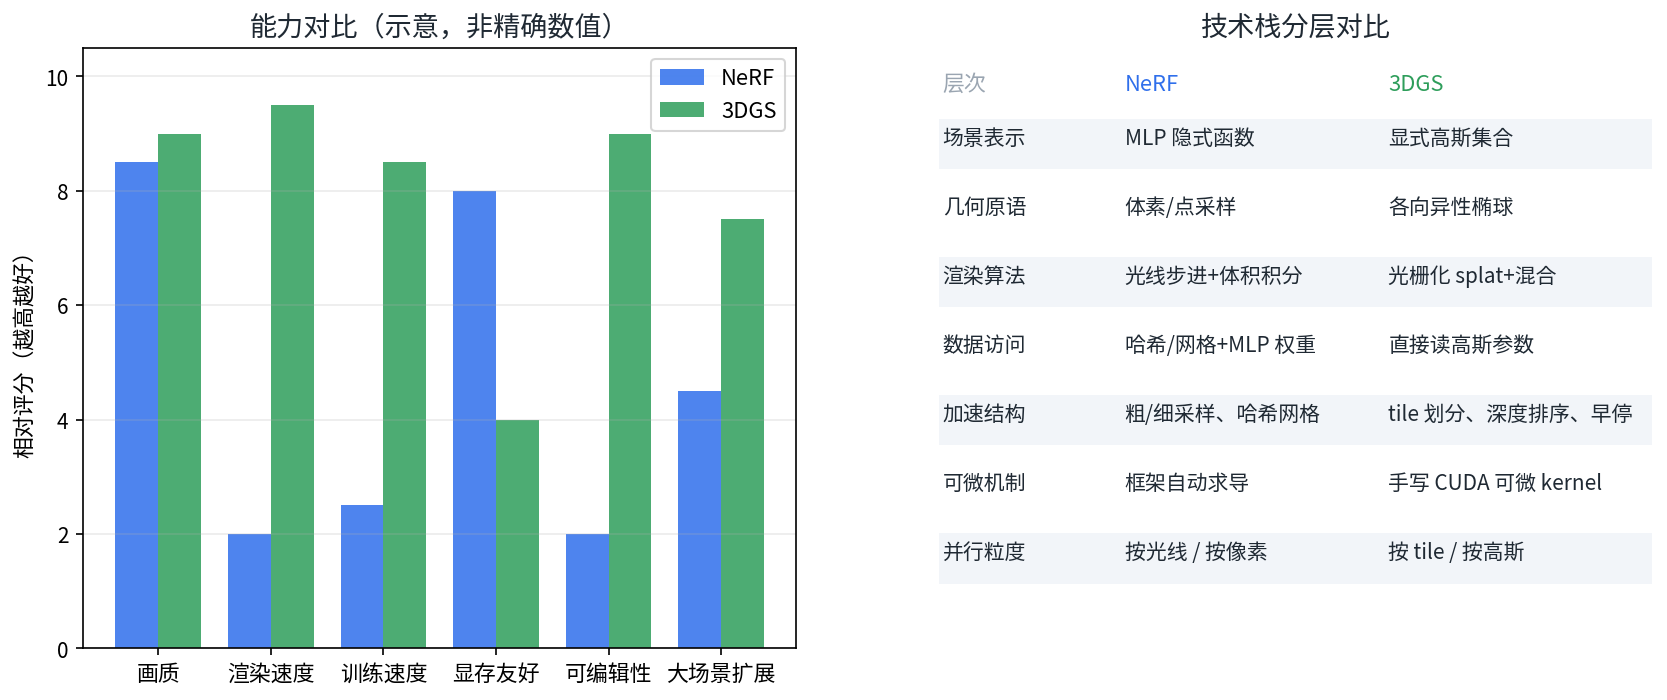
15.1 分层对比表
| 层次 | NeRF | 3D Gaussian Splatting |
|---|---|---|
| 场景表示 | MLP 隐式函数 | 显式高斯集合 |
| 几何原语 | 无(靠密度场隐式表达) | 各向异性椭球 |
| 外观表示 | MLP 输出颜色 | 球谐系数(SH) |
| 初始状态 | 随机初始化网络权重 | SfM 稀疏点云 |
| 渲染原语 | 光线(ray) | 高斯(splat) |
| 采样方式 | 沿光线密集采样 | 不需要采样(直接在点上算) |
| 渲染算法 | 光线步进 + 体积积分 | 光栅化 + alpha 混合 |
| 计算方向 | 像素 → 场景(反向) | 场景 → 像素(正向) |
| 加速结构 | 粗/细采样、哈希网格 | tile 划分、深度排序、早停 |
| 可微机制 | 框架自动求导 | 手写 CUDA 可微 kernel |
| 并行粒度 | 按光线 / 按像素 | 按 tile / 按高斯 |
| 几何更新 | 权重隐式变化 | 显式克隆/分裂/剪除 |
| 参数量级 | 网络权重(约 MB) | 几百万高斯(约百 MB ~ GB) |
15.2 逐层解读
① 表示层:隐式 vs 显式
- NeRF 把场景编码进 MLP 权重。优点是紧凑、连续、参数少;缺点是每次查询都要算一遍网络,且无法直接操作几何。
- 3DGS 把场景摊开成一堆高斯。优点是查询是 O(1) 的常数操作(直接读参数),且几何可直接增删编辑;缺点是存储大、需要显存。
② 几何层:连续密度场 vs 各向异性几何原语
- NeRF 没有「几何」这个概念,几何是从密度场里「浮现」出来的。高密度区域就是物体,但边界模糊,且表面靠等值面提取。
- 3DGS 每个高斯自带各向异性协方差 (
RSSᵀRᵀ),可以拉成任意朝向的椭球,因此能精确贴合薄平面、细杆这类结构。
③ 采样层:密集采样 vs 无需采样(这是快的关键差异)
- NeRF:一条光线必须采几十~上百个点,每个点都是一次网络前向。
- 3DGS:高斯本身就是「点」,投影后直接混合,没有采样这一步。
- 这是两者计算量差距最大的地方。NeRF 的成本是
像素 × 采样点数 × 网络深度;3DGS 的成本是高斯数 × 覆盖像素数(且有空区域剪枝和早停)。
④ 渲染层:光线步进积分 vs 光栅化混合
- 两者的数学本质一样 (都是 alpha 合成),差别在计算组织方式 :
- NeRF 沿光线串行累积(虽然能按光线并行)
- 3DGS 把高斯投影到屏幕,切成 tile,按 tile 并行、按深度排序混合
- 后者更贴合 GPU 的并行架构,且天然支持早停。
⑤ 加速层
- NeRF 系:InstantNGP 用哈希网格 + 多分辨率特征缓存,Mip-NeRF 360 用提议网络(proposal network)做重要性采样,都是为了减少无效采样。
- 3DGS:tile 划分减少无效高斯处理,深度排序保证正确性的同时允许早停,空区域天然零成本。
⑥ 可微机制层(容易被忽略但很关键)
- NeRF:整个前向是「光线采样 → 逐点 MLP → 积分」,用 PyTorch 自动求导就能反传,实现相对简单,但显存开销大、速度受限。
- 3DGS:光栅化的前向和反向都在 CUDA kernel 里手写 (
diff-gaussian-rasterization),包括对协方差、球谐的梯度。这让它既快又省显存,但实现复杂度高得多。
⑦ 几何自适应层
- NeRF:网络容量固定。想让细节更好,只能加大网络或提高采样密度,无法「局部加密」。
- 3DGS:训练中按梯度自适应地克隆/分裂/剪除,计算力自动集中到需要的区域,这是它画质能超过 NeRF 的重要原因之一。
总结
3D Gaussian Splatting 并不是对 NeRF 的简单「加速版」,而是一次表示层、渲染层与优化层的整体重构。
它把 NeRF 中「隐式网络 + 逐光线密集采样 + 体渲染积分」这条计算昂贵的路径,替换成了「显式高斯集合 + 正向光栅化 + 可微 alpha 混合」的高效路径。数学本质仍是体渲染,但工程组织方式彻底改变,从而第一次在无界完整场景、1080p 分辨率下同时做到了高画质、实时渲染与可接受的训练时间。
回过头看,3DGS 的成功可以归结为三个关键选择:
- 表示显式化:用几百万个各向异性 3D 高斯代替 MLP,让查询从「跑一次网络」变成「直接读参数」;
- 优化自适应:通过克隆、分裂、剪除与不透明度重置,让计算力自动集中到有纹理、有细节、重建误差大的区域;
- 渲染可微化:把光栅化的前向与反向都写进 CUDA kernel,既保证速度,又让梯度能反传回每一个高斯的位置、形状、不透明度与颜色。
当然,它也有代价:显存占用大、模型文件体积大、依赖 SfM 初始点云质量,无纹理区域仍容易出现空洞或模糊。但这些问题恰恰构成了后续研究的方向------压缩、稀疏化、鲁棒初始化、动态场景扩展、与网格/神经场的混合表示等。
如果说 NeRF 教会了我们「用一个函数描述整个场景」,那么 3DGS 则证明了:当表示足够显式、渲染足够贴合硬件、优化足够自适应时,实时高保真三维重建可以从理想走进现实。