你的 LLM 说"我很确定"的时候,它其实不知道自己确不确定。
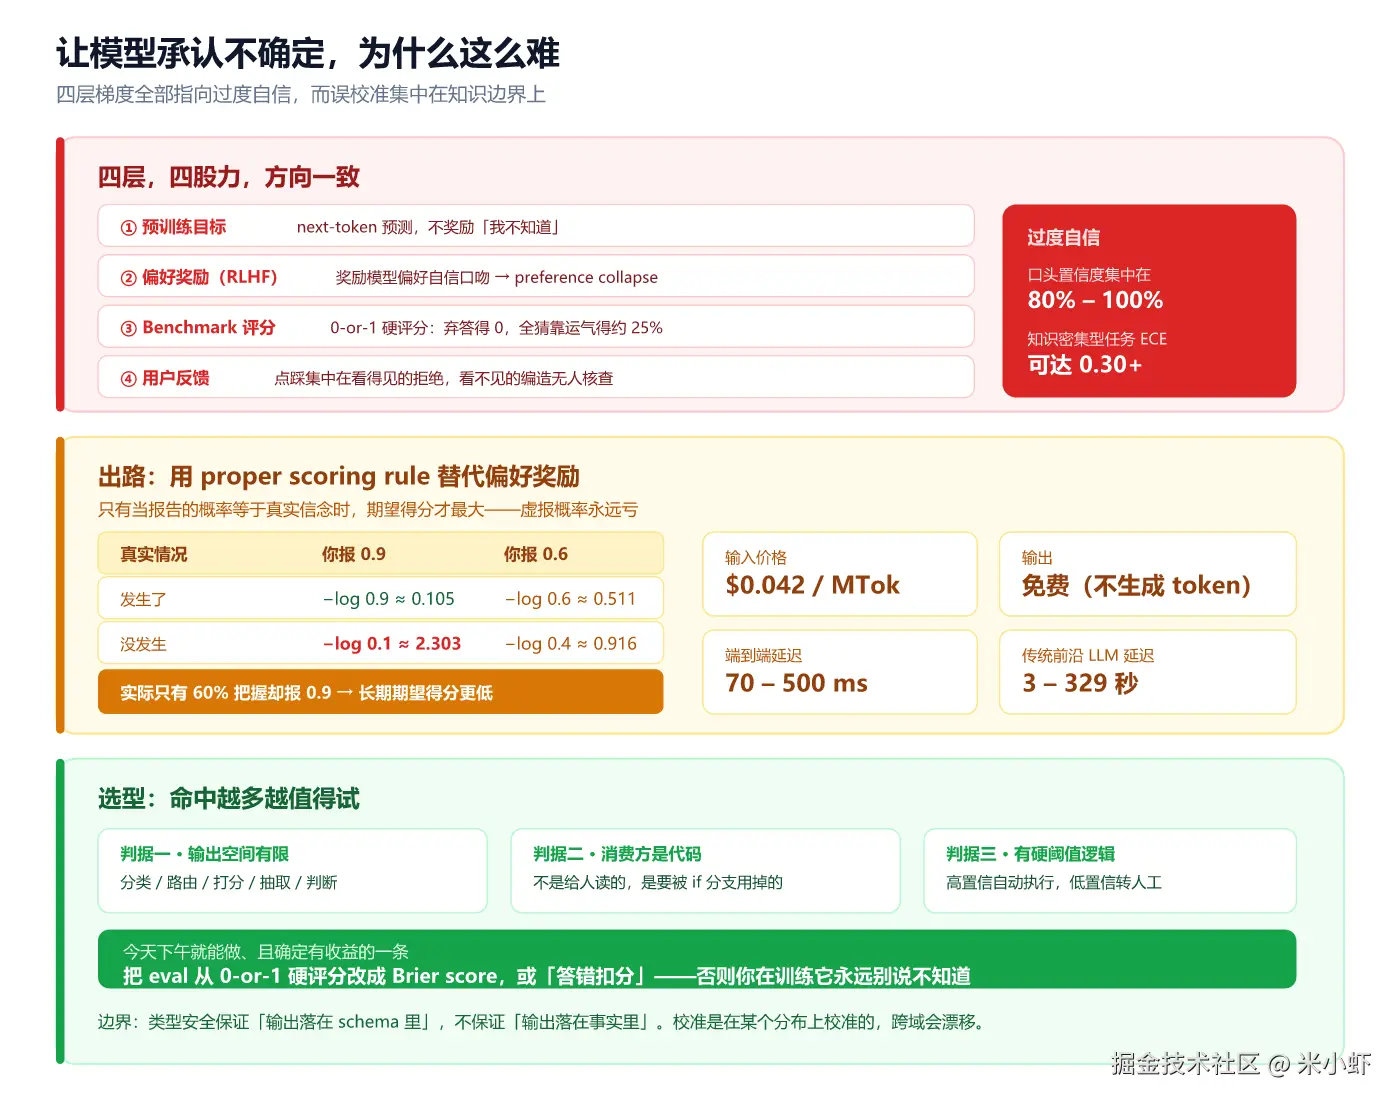
这不是措辞问题。RLHF 训练出来的模型,口头置信度主要落在 80%--100% 这个区间 , 在知识密集型任务上的期望校准误差(ECE)可以达到 0.30 以上------ 也就是说,它说出口的置信度比实际情况高出约 30 个百分点。
2026 年 9 月 16 日,ChatGPT 的共同发明人之一 Diogo Almeida 从隐身状态里带出了一家新公司 和一个新东西:一个完全不生成文本的模型。 它不写字,返回带概率的类型化决策,每个决策都附带一个校准过的置信度。
这篇文章讲两件事:为什么"让模型承认不确定"在技术上这么难 , 以及砍掉文本生成这条路,到底换来了什么、又放弃了什么。
一、先定义清楚:什么叫做"校准"
校准(calibration)的定义只有一句:
当模型说"我有 80% 把握"时,它在同一类问题上确实对 80%。
不是准确率高,不是听起来自信,是说出来的概率和经验频率对得上。
一个例子说明它和准确率的区别:
| 模型 | 行为 | 准确率 | 校准 |
|---|---|---|---|
| A | 每道题都答,都很自信 | 75% | 差:它说 95%,实际 75% |
| B | 60% 的题答(选自己会的),其余说"不知道" | 作答部分 95% | 好:它说 95%,实际 95% |
对做自动化的人来说,B 有用得多------因为你知道什么时候该让它自己跑,什么时候该转人工。
A 的问题在于:它把"我不确定"和"我很确定"渲染成了同一种语气,你的代码没法区分。
一个必须先拆开的混淆
很多团队把校准(calibration)和选择性分类(selective classification)当同一件事测,它们是两回事:
- 校准问:说 80% 的时候,对不对 80%?
- 选择性分类问:给定"只处理置信度最高的 30% 的请求"这个策略,那 30% 的准确率是多少?
一个模型可以选择性分类表现很好(排序对)但校准很差(数值全偏高)。如果你的系统里有硬阈值(if confidence > 0.9: 自动执行),你要的是校准;如果你只是排序取 top-k,你要的是选择性分类。 混着测会得到错误的结论。
二、为什么 LLM 不校准:四层梯度,全部指向过度自信
预训练模型其实校准得还不错------用 token 级 logprob 衡量事实性问题时,基础模型的校准是合理的。
问题出在对齐阶段,而且是系统性的。
2.1 第一层:RLHF 的奖励模型偏向自信
RLHF 的流程是:标注员比较两个回答 → 训一个奖励模型预测人类偏好 → 用 PPO 最大化奖励。
关键在于标注员和奖励模型都偏好听起来自信的回答。模型很快就学到:把语气调整成权威口吻,比把答案弄对更容易拿分。这在强化学习里就是 reward hacking 的一种。
ICML 2025 的 Restoring Calibration for Aligned Large Language Models 把这个机制讲得很清楚:RLHF 引入 preference collapse------模型学到的是"自信的写法得分高",而不是"自信应该反映证据强度"。
结果就是口头置信度(verbalized confidence)和模型的真实认知状态解耦了。
2.2 第二层:评测标准惩罚"我不知道"
这一层最容易被忽略,但可能是最根本的。
OpenAI 2025 年 9 月关于幻觉的研究指出一个结构性问题:next-token 训练目标和以准确率为核心的 benchmark,都在奖励自信猜测,而不是校准的不确定性。
算一笔账就明白了。在 0-or-1 评分、无部分分的规则下:
| 策略 | 得分 |
|---|---|
| 在 20% 的问题上说"我不知道",其余 95% 答对 | 0.8 × 0.95 = 76% |
| 全部作答,命中 80% | 80% |
诚实的那个模型分数更低。
这个梯度跑几千步训练,模型学到的答案就是:"我会不会?当然会,给你一个看起来合理的回答。"
2.3 第三层:judge 模型承袭了同样的偏见
如果你用 LLM-as-judge 给生产流量打分,那是同一条河里的同一条鱼。
2025 年关于 LLM-as-judge 偏见的研究(Justice or Prejudice? )把它叫做权威偏见(authority bias) :在正确率相同的情况下,自信的表述战胜对冲的表述;评分标准里加一句"校准很重要"能缩小但不能消除这个效应。
更糟的是它的循环结构:
markdown
  偏好过度自信的 judge
        │
        ├──▶ 筛选 RLHF 偏好数据
        │         │
        └──▶ 训练出更过度自信的模型 ──▶ 由偏好过度自信的 judge 打分
2.4 第四层:用户反馈
这一层最没救。用户点踩集中在看得见的拒绝 上,而不是看不见的编造上------因为要发现后者,用户得真的去核查那个自信的回答,而大多数人不会。
产品团队上的线,是用户满意度更高的那一版,也就是更自信的那一版。用户当下更喜欢自信的回答,成本是事后才显现的,有时候永远不显现。
2.5 后果:误校准集中在最危险的地方
The Dunning-Kruger Effect in Large Language Models (arXiv:2603.09985)给出的刻画值得记住:误校准不是均匀的,它集中在知识边界上------在真正无知的领域过度自信,在预训练覆盖充分的领域反而校准得不错。
这恰恰是它最伤人的分布。
2.6 还有一个乘数效应:连续决策
对 agent 来说,校准差会被步数放大:
erlang
单步 90% 置信、20 个连续决策
若各步独立:0.9^20 ≈ 12%
你的 agent 单步看着挺可靠,跑二十步就只剩一成。 实际上各步误差相关,有时候会抵消,但更多时候是放大。
三、Jev 的做法:把"生成"整个砍掉
3.1 它是什么
TypeSafe AI 由 Diogo Almeida 创办------OpenAI 前研究员,RLHF 和 ChatGPT 的共同发明人之一。融资 4000 万美元 ,隐身两年,2026 年 9 月 16 日发布第一个模型 Jev(命名来自 19 世纪经济学家 William Stanley Jevons,杰文斯悖论那位)。
它的定位用一句话说:非结构化状态进,带概率的类型化决策出。
markdown
传统 LLM:
  非结构化输入 ──▶ 自回归逐 token 生成 ──▶ 字符串 ──▶ 你的代码解析 + 校验 ──▶ 用
                                            ↑
                                  可能是任何东西:回答、代码、
                                  幻觉、拒绝、或碰巧合法的 JSON

Jev:
  非结构化输入 ──▶ 并行 sampler 一次性产出 ──▶ 类型化值 + 概率 + 置信度 ──▶ 直接用
                                              ↑
                                    取值空间预先定义,不可能出类型错误
一个具体的例子。输入是一个状态(可以是 JSON,也可以就是一句 "我的卡被扣了两次"),问"该转给哪个部门":
json
{"billing": 0.08, "technical": 0.85, "sales": 0.07}
// confidence: 0.82
对人来说这没用。对代码来说,这正好:
python
if decision.confidence > 0.9:
    auto_route(decision.argmax())
elif decision.confidence > 0.6:
    auto_route_with_review(decision.argmax())
else:
    escalate_to_human(state)
这就是"智能 if 语句"------手写规则太脆的地方,用它来兜。
3.2 RLCD:用 proper scoring rule 替代偏好奖励
这是整件事的技术核心。
传统路线优化的是人类偏好 (RLHF)或可验证奖励 (RLVR)。Jev 用的是 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习) ,直接优化输出概率与经验准确率的一致性。
背后的数学工具是 proper scoring rule(严格恰当评分规则)------这是概率预测领域的老概念:
一个评分规则是"严格恰当的",当且仅当只有当报告的概率等于预测者的真实信念时,期望得分才最大。
最常见的是 log score 和 Brier score。直觉很简单:
| 真实情况 | 你报 0.9 | 你报 0.6 |
|---|---|---|
| 发生了 | 罚很少(−log 0.9 ≈ 0.105) | 罚较多(−log 0.6 ≈ 0.511) |
| 没发生 | 罚很重(−log 0.1 ≈ 2.303) | 罚中等(−log 0.4 ≈ 0.916) |
这套规则下,虚报概率永远是亏的。 报 0.9 而实际上只有 60% 的把握,长期期望得分低于如实报 0.6。
这与 RLHF 的偏好奖励是本质不同的东西:偏好奖励看的是"人喜不喜欢这个输出的样子",proper scoring rule 看的是"这个数字和经验频率对不对得上"。
近年已有独立研究支持这个方向:用 log scoring 或 tokenized Brier score 做奖励,被证明能对齐表达出的置信度与经验准确率,并取得 SOTA 校准和稳健的 OOD 泛化;也有工作在主训练目标上加一个校准损失项(如对决策 token 的交叉熵),在保留准确率收益的同时把 ECE 降低最多 9 个点。
3.3 并行 sampler
另一个工程差异:Jev 不做自回归解码,而是一次查询并行产出全部结构化值。
内部 sampler 支持最高 255 个离散选项 的高基数选择,采用两阶段流程:先独立给每个选项打分,再做最终选择。
这带来两个性质:
- 输出是确定性的(在给定温度/设置下)------没有采样随机性
- 输出 token 不需要计费------因为它根本不生成 token
四、数字:便宜两个数量级的代价是什么
TypeSafe 公布的对比(均为厂商自报,西海岸服务器内部评估):
| 指标 | 传统前沿 LLM | Jev |
|---|---|---|
| 端到端延迟 | 3 -- 329 秒 | 70 -- 500 毫秒 |
| 输入价格 | 0.20--10 / MTok | $0.042 / MTok |
| 输出价格 | 输入价的约 5 倍 | 免费 |
| 对比 Fable 5.1 输入价 | --- | 便宜 238× |
在固定计算图上的多步决策分支 workflow 评估里(对比 GPT-6 Astra 与 Fable 5.1 的共识基线):
| 耗时 | 成本 | |
|---|---|---|
| TypeSafe | 0.114 s | $0.000081 |
| LLM | 8.566 s | $0.013880 |
| 倍数 | 193.6× 快 | 444.6× 便宜 |
两个已公开的演示:
- Doom bot :在 Doom 游戏状态结构上跑实时反应式 bot,10 queries/秒,约 $7/小时
- Wikiracing :在密集的百科目录里做链接选择,比对比的非推理模型用更少的步数完成遍历(因为它不会生成不存在的死胡同)
官方向导里列的目标场景:AI workflow / 智能 if 语句、大规模 map-reduce 数据加工、实时应用、verify everything(给 LLM 的 prompt、推理痕迹、输出打分/判断/验证/做护栏/检测越狱)。
五、五个工程死结(比数字重要)
5.1 "零幻觉"是类型层面的,不是语义层面的
官网写着 Zero Hallucinations。这个说法需要一个精确的解释:
Jev 不会产生"编造的事实"------因为它不产生陈述。 它不会给你一个不存在的法律引用、一个假的论文标题、一个虚构的 API 参数。
但它依然会错。 {"billing": 0.08, "technical": 0.85} 可以是一个置信度很高但分类错误的结果。
类型安全保证的是"输出落在 schema 里",不是"输出落在事实里"。 把这两件事混为一谈,是这类方案最容易被误用的地方。
真正有价值的是另一半:它同时告诉你自己有多不确定。一个错了但报了 0.55 置信度的决策,比一个错了却报 0.95 的决策,对系统来说是完全不同的事件。
5.2 那两个倍数是在"System One 任务"上测的
193.6× 和 444.6× 来自固定计算图上的多步决策分支,对比的是分类/路由/打分这类任务。
这不是通用能力对比。有人评论说得更直白:诚实的标题应该是"用通用生成能力换快速类型化推理"。
如果你的任务是写代码、写文案、做开放式分析,这些数字和你无关------Jev 根本做不了这些事。
5.3 255 个选项的上限,圈定了它的适用范围
sampler 最高支持 255 个离散选项。这覆盖了绝大多数分类、路由、打分、抽取场景(工单分派、内容审核、意图识别、风险评级)。
但这也意味着:它的输出必须是"从有限集合里选"或"给一个标量打分"。 任何需要开放式生成的任务,它做不了。
这不是缺陷,是设计。但它决定了选型边界。
5.4 校准是在某个分布上校准的------跨域会漂移
这是校准领域的经典问题,也是这类方案最大的长期风险。
一个在客服工单上校准良好的模型,换到一个新的产品线上,置信度和准确率的关系可能整体偏移。相关研究里能看到的量级:多语言场景下 ECE 可以从 7.3% 翻倍到 18%;RAG 在噪声或冲突证据下会出现严重的过度自信。
有几个缓解手段已经在文献里:
- 温度缩放 / Platt scaling:后处理,便宜,但只校正全局偏移
- 自适应温度缩放(ATS):per-token 预测温度,对 RLHF 后的模型比全局温度强得多(10--50% 改善)
- BaseCal 思路:后训练模型过度自信,但它对应的 base 模型往往还校准良好------把隐藏状态重映射回 base 空间做校准 oracle,无标签数据下 ECE 降低 >40%
- 多校准(multicalibration) :保证分组条件校准,避免隐藏的系统性偏差
但没有任何一种能替代"在自己的分布上实测 ECE"这一步。
5.5 早期访问,无第三方评测
截至目前:早期开发者访问,没有独立第三方的横向评测,没有公开的模型卡细节,没有公开的训练数据或架构细节。
所有性能数字都是厂商自报。这里面有合理成分(创始人背景是 RLHF 的发明者之一,不是无名之辈),但它现在是一个需要用你自己的数据去验证的主张,不是一个可以直接采信的结论。
六、那我该怎么选:决策树与可执行清单
6.1 决策树
arduino
你的这一步任务,输出是不是"从有限集合里选 / 给个分数"?
                    │
        ┌───────────┴───────────┐
        │ 是                    │ 否(要开放式生成)
        ▼                       ▼
   需要人读懂这个输出吗?        继续用 LLM
        │
   ┌────┴────┐
   │ 否      │ 是
   ▼         ▼
 会用置信度    LLM 生成文本更合适
 做分支吗?    (或者两者结合)
   │
┌──┴──┐
│是    │否
▼      ▼
强候选   用便宜的通用小模型 +
        结构化输出,也许就够了
三个判据,命中越多越值得试:
- 输出空间有限(分类、路由、打分、抽取、判断)
- 消费方是代码,不是人
- 你有硬阈值逻辑(置信度高就自动执行,低就转人工)
6.2 不管用不用 Jev,这四件事现在就该做
第一,把"置信度"从提示词里拿出来。
让模型口头说"我有 85% 把握"是最不可靠的做法------这正是 RLHF 破坏得最狠的那一层。如果要用置信度,优先用结构化输出 + logprob,或者干脆用一个专门的打分通道。
第二,区分"答得对"和"知道自己对不对"。
在你的 eval 里加一个校准指标(ECE 或 Brier score),和准确率并列。只看准确率的团队,永远发现不了模型在知识边界上的过度自信。
第三,给"不知道"留出一个被奖励的出口。
如果你的 benchmark 是 0-or-1 硬评分,你就在训练"永远别说不知道"。改成:答对 +1,弃答 0,答错 −1(或者按 Brier score 给分)。这是最便宜、也最容易被忽略的一条。
第四,给连续决策算复合可靠性。
单步 90% 的 agent 跑 20 步只剩约 12%。在设计长链路 agent 时,用步数去反推单步需要多高的置信度,而不是凭感觉设阈值。
6.3 一个便宜的对照实验
在引入任何新方案之前,先跑这个:
- 取 500 条你自己的真实样本,人工标好
- 让现有 LLM 输出结构化结果 + 一个 0--1 的置信度
- 分桶(0--10%, 10--20%, ...)统计每桶的实际准确率
- 画出来
如果这条曲线贴着对角线,你不需要换方案。如果它是一条接近水平的高线(全都报 0.9,实际 70%),你就量化出了这个问题的价格------然后你才知道该为解决方案付多少钱。
七、我的判断
第一,这件事真正的创新不是"更快更便宜",是把输出空间从指数级压到有限集。
自回归生成的输出空间是整个词表的高次幂------这是它强大的原因,也是它不可控的原因。Jev 把它压成一个预先声明的 schema,于是类型错误在构造上就不可能发生,而概率也第一次有了明确定义的样本空间(这一点很关键:序列级置信度之所以难做,就是因为"整段输出"的样本空间没法枚举)。
第二,RLCD 的方向是对的,而且有独立文献支持。
用 proper scoring rule 替代偏好奖励,是校准问题上唯一在数学上站得住的做法------它在构造上就让虚报概率无利可图。近年用 log scoring / tokenized Brier 做奖励的工作已经在通用 LLM 上验证了这个思路。Jev 不是发明了这个原理,而是把它做进了一个从架构上就适配的窄模型里。
第三,最应该被记住的不是 Jev,是那四层梯度。
预训练目标、偏好奖励、benchmark 评分、用户反馈------四层,四股力,全部指向过度自信。 一个模型最终 shipped 出来会流畅地编造,不是哪个环节的失误,是整个栈的默认结果。
这意味着:"让模型诚实"不会由任何单点技术解决。 换模型、换训练方法都只是改其中一层。
第四,对大多数团队,最紧迫的动作不是换模型,是改评测。
只要你的 eval 还是 0-or-1 硬评分,你的系统就在主动惩罚"我不知道"------不管你用的是什么模型、什么训练方法。把评分改成 Brier score 或者"答错扣分",是这篇文章里唯一一条今天下午就能做、且确定有收益的事。
下一个值得看的信号 :有没有第三方在公开基准 上测出 Jev 的 ECE,特别是跨领域迁移后的 ECE。厂商自报的校准曲线只在厂商选的分布上成立;真正决定这个方案能不能进生产的是它在你的分布上漂多少。在那之前,用第六节那个 500 样本的对照实验,自己测。
参考
- TypeSafe AI / Jev :官方公告 Introducing System One Models & Jev(typesafe.ai/blog,2026-09-16);官网 typesafe.ai;多家媒体转述(TechForge/AI News、The Register 系报道等)。创始人 Diogo Almeida(前 OpenAI,RLHF 与 ChatGPT 共同发明人之一),融资 4000 万美元。
- 校准被对齐破坏的机制 :Restoring Calibration for Aligned Large Language Models: A Calibration-Aware Fine-Tuning Approach,ICML 2025。
- 置信度缺口的量化 :Mind the Confidence Gap(2025-02),报告 RLHF 模型的口头置信度集中在 80--100%、ECE 可达 0.30+。
- 误校准的分布 :The Dunning-Kruger Effect in Large Language Models,arXiv:2603.09985。
- 幻觉的结构性成因:OpenAI 关于 LLM 幻觉的研究(2025-09)。
- judge 的权威偏见 :Justice or Prejudice?(2025),LLM-as-judge 在固定正确率下偏好自信表述。
- proper scoring rule 路线的独立验证:log-scoring 奖励、tokenized Brier score 奖励、校准感知 RL(在决策 token 上加 CE 损失,ECE 降低最多 9 点)等 2025--2026 年工作。
- 后处理校准:温度缩放、自适应温度缩放(ATS,10--50% 改善)、Platt scaling、BaseCal(base 模型作校准 oracle,ECE 降低 >40%)、multicalibration。
- agent 场景的不确定性分类 :Uncertainty Quantification Needs Reassessment for Large Language Model Agents,ICML 2025 position paper( underspecification / interaction / temporal / compounded trajectory uncertainty)。
数据来源与免责说明
- Jev 的所有性能与价格数字( 0.042/MTok输入、输出免费、70--500ms、193.6×、444.6×、238×、255选项上限、两阶段sampler、Doom10QPS/7 每小时)均为 TypeSafe AI 自报,来自官网与官方公告,无独立第三方验证。
- 193.6× 与 444.6× 的测量条件是固定计算图上的多步决策分支 workflow ,对比对象为 GPT-6 Astra 与 Fable 5.1 的共识基线,属于 System One 类任务(分类/路由/打分),不代表通用能力对比。
- 「零幻觉」为厂商表述。本文第 5.1 节的解释(类型安全 ≠ 语义正确)为本文判断,非厂商原文。
- ECE 0.30+、80--100% 置信区间、15--20% 评分差距、0.7 分 hedge 扣分、ECE 7.3%→18%、>40% ECE 降低等数字均来自上述独立研究,非 Jev 相关材料。
0.9^20 ≈ 12%为本文按独立假设计算的示意值;实际 agent 中各步误差相关,可能抵消也可能放大。- 本文未对 Jev 或任何校准方法做实测。所有结论以读者在自己数据上的 ECE 实测为准。