之所以要单独写一篇c++11,是因为c++11是在c++98之后做出的一次重大改变完善,引入了非常多的东西。因为C++98之后C++委员会想要做出一次重大改变直接来一波大的,所有后面一直没有更新,但是11年承受不住压力只好放出来,期间的8年时间是迄今为止时间最长的版本间隔,后面一直延用3年一改。
1.列表初始化
在c++98的时候{ }初始化只能给数组和结构体使用,但是等到了c++11,列表初始化已经可以给所有类型对象使用,包括了自定义结构,因为自定义结构最终的成员还是会落实到内置类型对象上,自定义类型的本质就是类型转换。并且使用初始化列表初始化的时候可以省略掉" = "。
cpp
#include <list>
using namespace std;

struct MyDate
{
    int _year;
    int _month;
    int _day;
    MyDate(int a, int b, int c)
        :_year(a)
        ,_month(b)
        ,_day(c)
    {}
};

int main()
{
    int a[] = { 1,2,3,4 };        //c++98
    int a1[]{ 1,2,3,4,5 };        //c++11
    list<int> b{ 3,2,1,5,6 };     //c++11
    MyDate c{ 2026,9,15 };
    return 0;
}
如上图所示案例
2.std:initializer_list
initializer_list可以说是实现初始化列表的一种重要手段,我们需要首先了解,像上面例子里的最后一个实际上是通过传的参数创建了一个临时对象,然后拷贝构造这个临时对象,只不过有的编译器会进行优化,把这个过程缩减成直接创建一个对应变量的过程。但是列表初始化像第三个list的例子里,list本身并没有构造函数支持传任意个数的参数来初始化变量的构造函数来,或者说不会傻傻的写一堆构造函数,里面是传一个参数,两个参数,三个参数这样的。实际中会用下面这种:

initializer_list会把所有传递的参数都放在一个数组里面,然后再一个个把数组里的东西插入到新创建出来的变量里,最后得到一个包含了多个数据的变量。
3.右值引用和移动语义
我们在写代码的时候经常会遇到常量表达式和临时变量,还有存储于寄存器中的变量,这些就是右值。左值则是一个表示数据的表达式,一般是有持久状态,存储在内存中。左值和右值有根本上的区别在于,左值能够取地址,右值则不能,右值只提供数据值,但是不可以寻址。我们经常写的引用&也被称为左值引用,因为一般都是引用对象的。同理,右值也存在右值引用,语法上来看左值引用和右值引用都是取别名。常见的右值例子如下:
cpp
10;           //右值
int x=1,y=2;  //x,y是左值
x+y;          //这里是两者的和,并且没有赋值给其他变量,属于右值
string("111");//字符串常量,右值
左值引用和右值引用的目的都是在于减少拷贝,提高效率。左值引用可以修改参数和返回值,便于使用,但是左值引用在面对部分函数返回值为临时变量的时候无法引用,因为返回的临时变量用一个变量接受实际上是拷贝过去的,示例如下:
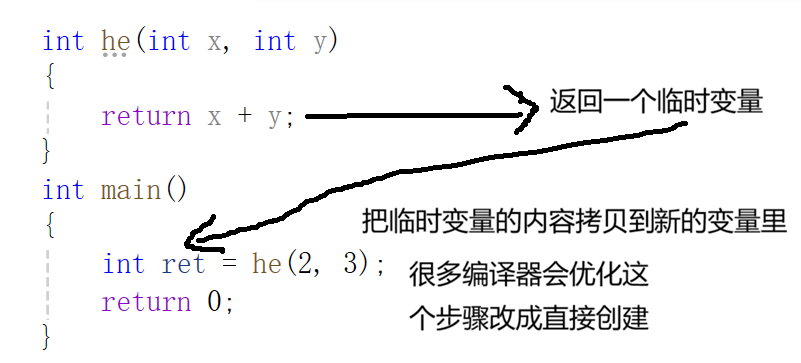
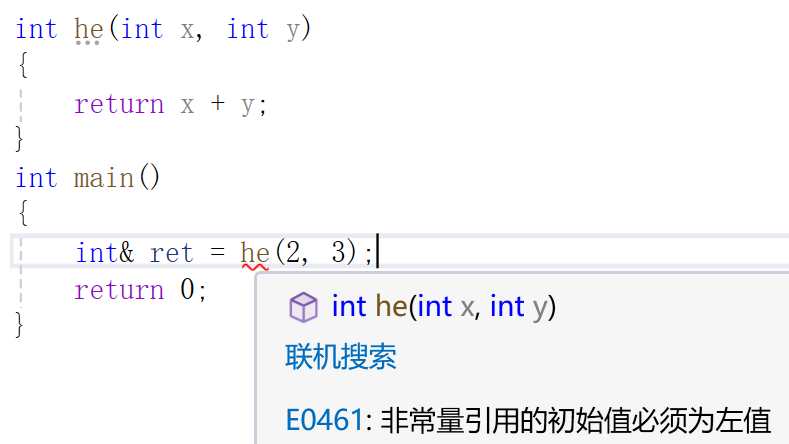
这个时候我们就可以使用右值引用来引用这个临时变量:
cpp
int he(int x, int y)
{
    return x + y;
}
int main()
{
    int&& ret = he(2, 3);
    return 0;
}
右值引用的书写就是在原本一个&的基础上再加一个&,也就是&&。
左值引用不能直接引用右值,同理,右值引用不能直接引用左值,但是也存在特殊情况。const修饰的左值引用可以引用右值,右值引用可以引用move()后的左值。一开始的右值像临时变量是具有常性不可以被修改的,但是const修饰完成左值引用变量之后也具有常性,因此可以引用。而move()则是库里的一个函数模板,具体的并不介绍,只需要了解用于右值引用左值的情况即可。示例如下:
cpp
#include <string>
#include <utility>

using namespace std;

int he(int x, int y)
{
    return x + y;
}
int main()
{
    const int& ret = he(2, 3);
    const string& a = "aaaaa";
    int x = 10086;
    int&& b = move(x);
    return 0;
}
右值引用和const修饰的左值引用都可以用于延迟生命周期,但是这些都无法被修改。并且在c++11之后,函数形参是左值引用,const左值引用和右值引用,在传参时会分别匹配左值,const左值,右值。函数传参用引用则是用于直接改变传递的参数和减少临时变量拷贝。左值引用已经减少了大部分的拷贝效率问题,但是还有一部分并不能很好的改变,比如当函数返回值是一个右值,这个时候用右值引用可以减少拷贝问题。但不管是左值引用还是右值引用,两者在函数返回值上的应用都必须注意的一点是不能返回局部变量的数据,否则会使得引用悬空(在函数调用完成的那一刻局部变量就已经被销毁)。
需要注意的是,右值引用变量本身是属于左值的范畴,他也是一个"变量",有着具体的地址范围。
4.移动构造和移动赋值
移动构造函数是一种构造函数,类似拷贝构造函数,移动构造函数要求第一个参数是该类类型的引用,但是不同的是要求这个参数是右值引用,如果还有其他参数,额外的参数必须有缺省值。
移动赋值是一个赋值运算符的重载,他跟拷贝赋值构成函数重载,类似拷贝赋值函数,移动赋值函数要求第一个参数是该类类型的引用,但是不同的是要求这个参数是右值引用。
对于像string/vector这样的深拷贝的类或者包含深拷贝的成员变量的类,移动构造和移动赋值才有意义,因为移动构造和移动赋值的第一个参数都是右值引用的类型,他的本质是要"掠夺"引用的右值对象的资源,原来右值的数据变成空,而不是像拷贝构造和拷贝赋值那样去拷贝资源,因为原来右值是找不到地址的,本来就是"一次性"的,所以把数据全部"抢过来"也不会造成什么影响。从而提高效率。下面是代码例子:
cpp
#include <iostream>
#include <utility>
using namespace std;

class car
{
private:
    int _id;
    int _kg;
    int _space;
public:
    car(car&& x)        //移动构造
    {
        cout << "使用了移动构造" << endl;
        swap(this->_id, x._id);     //直接掠夺
        swap(this->_kg, x._kg);
        swap(this->_space, x._space);
    }

    car(car& x)         //拷贝构造
        :_id(x._id)
        , _kg(x._kg)
        , _space(x._space)
    {
        cout << "使用了car&拷贝构造" << endl;
    }

    car(int a, int b, int c)
        :_id(a)
        , _kg(b)
        , _space(c)
    {}

    car& operator=(const car& x)
    {
        cout << "使用了const car&拷贝赋值" << endl;
        this->_id = x._id;
        this->_kg = x._kg;
        this->_space = x._space;
        return *this;
    }

    car& operator=(car&& x)
    {
        cout << "使用了car&& x移动赋值" << endl;
        swap(this->_id, x._id);     //直接掠夺
        swap(this->_kg, x._kg);
        swap(this->_space, x._space);
        return *this;
    }
};

int main()
{
    car a(move(car{11, 22, 33}));    //move之后是右值,移动构造
    car b = a;                       //拷贝构造
    car c{22,33,44};
    b = c;                           //拷贝赋值
    b = move(car{11, 22, 33 });      //移动赋值
    return 0;
}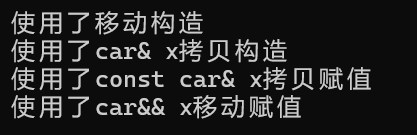
这里作者只是用move去强制生成的右值,可能便利程度不是太浅显易懂,注意string a(string("xxx")),这种就是移动构造,并且是直接掠夺"xxx"里的数据,这种这个时候并不是拷贝构造,拷贝构造是已经存在的同类型的变量,不是上面的那种临时变量,两者需要区分。
右值引用的便利在前面说到过了,是对于资源的直接掠夺。并且在3.右值引用和移动语义的第一张图片里面也有传值返回的一个过程,先拷贝构造一个临时对象,然后再拷贝构造临时对象的数据去接收变量里面,部分编译器优化到直接用return的变量直接拷贝构造到接收变量里,这样只用完成一次的资源复制,而移动构造会让这个过程流程不变,只是从拷贝构造变成移动构造,资源复制变成资源掠夺。之前也提到过,资源复制可以理解为创建一个空的对象,把被复制对象的数据一个一个插入到新对象里,但是资源掠夺是直接"抢",根本不用慢慢转移,可能稍微几次并没有太明显的改善,但是在大量的使用时会有明显的效率提升。
5.类型分类与万能引用
c++11之后对类型有了更加细致的划分。右值被划分为纯右值和将亡值。纯右值是指那些字⾯值常量或求值结果相当于字面值或是一个不具名的临时对象。如: 42、 true、nullptr 或者类似 str.substr(1, 2)、str1 + str2 传值返回函数调用,或者整形 a、b,a++,a+b 等。纯右值和将亡值C++11中提出的,C++11中的纯右值概念划分等价于 C++98中的右值。将亡值是指返回右值引用的函数的调用表达式和转换为右值引用的转换函数的调用表达,如 move(x)、static_cast(x)。泛左值包含将亡值和左值。
在函数传参的过程中,右值传参和左值传参是两个不同的概念,我们想要一个函数同时实现既可以传右值又可以传左值,就需要用到万能引用,如下所示:
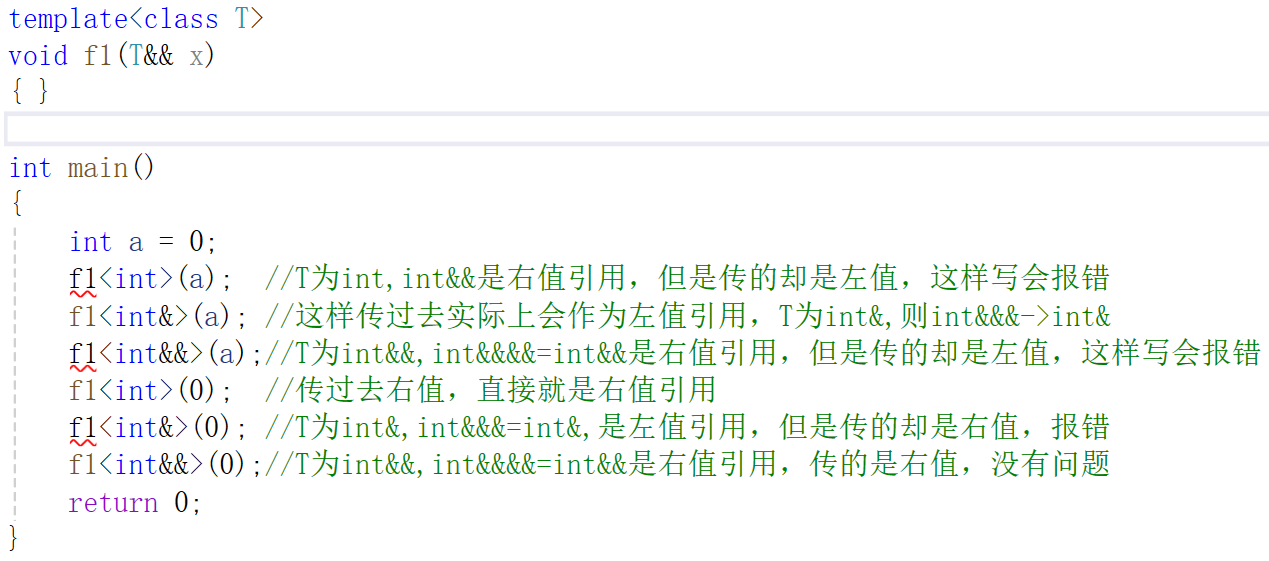
这里的万能应用可以让我们自主选择传递的是左值还是右值,只需要根据自己的需求改变传递的模板参数即可。
6.类功能的改进
6.1默认成员函数改变
在原来C++类中,有6个默认成员函数:构造函数,析构函数,拷贝构造函数,拷贝赋值重载,取地址重载,const 取地址重载。最后重要的是前4个,后两个用处不大。默认成员函数就是我们不写编译器会生成一个默认的。
C++11 新增了两个:移动构造函数和移动赋值运算符重载。
针对移动构造函数和移动赋值运算符重载有一些需要注意的点如下:
如果你没有自己实现移动构造函数,且没有实现析构函数 、拷贝构造、拷贝赋值重载中的任意一个。那么编译器会自动生成一个默认移动构造。默认生成的移动构造函数,对于内置类型成员会执行逐成员按字节拷贝,自定义类型成员,则需要看这个成员是否实现移动构造,如果实现了就调用移动构造,没有实现就调用拷贝构造。
如果你没有自己实现移动赋值重载函数,且没有实现析构函数 、拷贝构造、拷贝赋值重载中的任意一个,那么编译器会自动生成一个默认移动赋值。默认生成的移动构造函数,对于内置类型成员会执行逐成员按字节拷贝,自定义类型成员,则需要看这个成员是否实现移动赋值,如果实现了就调用移动赋值,没有实现就调用拷贝赋值。(默认移动赋值跟上面移动构造完全类似)
最后,如果你提供了移动构造或者移动赋值,编译器不会自动提供拷贝构造和拷贝赋值。
6.2defult与delete
C++11可以让你更好的控制要使用的默认函数,强制生成默认函数的关键字default。假设你要使用某个默认的函数,但是因为一些原因这个函数没有默认生成。比如:我们提供了拷贝构造,就不会生成移动构造了,那么我们可以使用default关键字显示指定移动构造生成。
cpp
class Person
{
public:
	Person(const char* name = "", int age = 0)
		:_name(name)
		, _age(age)
	{}
	Person(const Person& p)
		:_name(p._name)
		, _age(p._age)
	{}
	Person(Person&& p) = default;    //强制生成移动构造
private:
	string _name;
	int _age;
};
int main()
{
	Person s1;
	Person s2 = s1;
	Person s3 = move(s1);
	return 0;
}
如果想要限制某些默认函数的生成,在C++98中,把该函数设置成private,并且只声明不定义,这样只要其他人想要调用就会报错。在C++11中增加了禁止生成默认函数的关键字delete,只需在该函数声明加上=delete即可,该语法指示编译器不生成对应函数的默认版本,称=delete修饰的函数为删除函数。
6.3final与override
我们在写虚函数的时候仅仅是边缘有的时候即使我们写错了编译器也不会检查出来,只有在运行的时候才会爆出来。c++提供了关键字override帮助我们检查是否写错,如果出错会在编译期间就爆出来。而final前面有提到可以使基类不会被继承,而final还有一种用法是放在基类成员函数()的后面,这会使得这个成员函数不能被重写。这些在前面继承和多态部分讲过。
7.STL的改变
STL的改变主要是增加了新的容器和方法,容器包括unordered_map与unordered_set,在前面也已经说过。新的接口像移动构造和移动赋值与initializer_list构造也都提到了。
8. lambda
8.1 lambda
lambda底层是仿函数,本质则是匿名函数对象,只不过还可以定义在函数内部。由于当我们定义自定义类型的比较的时候,都需要写一个类来规定比较的方法(仿函数),使用起来非常不方便,所以就弄出来lambda表达式。
lambda 表达式语法使用层而言没有具体类型,所以我们一般是用auto(auto也是c++11新增的关键字,自动推导数据类型)或者模板参数定义的对象去接收lambda 对象。 lambda表达式的格式:
capture-list (parameters)-> return type { function boby }
capture-list :捕捉列表,该列表总是出现在 lambda 函数的开始位置,编译器根据 来判断接下来的代码是否为 lambda 函数,捕捉列表能够捕捉上下文中的变量供 lambda 函数使用,捕捉列表可以传值和传引用捕捉。捕捉列表为空也不能省略。
(parameters) :参数列表,与普通函数的参数列表功能类似,如果不需要参数传递,则可以连同()⼀起省略。
->return type :返回值类型,用追踪返回类型形式声明函数的返回值类型,没有返回值时此部分可省略。⼀般返回值类型明确情况下,也可省略,由编译器对返回类型进行推导。
{function boby} :函数体,函数体内的实现跟普通函数完全类似,在该函数体内,除了可以使用其参数外,还可以使用所有捕获到的变量,函数体为空也不能省略。,下面是一个lambda的例子:
cpp
int main()
{
	auto add = [](int a, int b)->int {return a + b; };
	int x = add(1, 2);
	//1、捕捉为空也不能省略
	//2、参数为空可以省略
	//3、返回值可以省略,可以通过返回对象⾃动推导
	//4、函数题不能省略
	auto hello = []() {cout << "hello" << endl;};  //省略了返回值,参数为空可以省略,可以不省略
	auto hello2 = []{cout << "hello" << endl;};
	hello();
	hello2();
	return 0;
}
8.2捕捉列表说明
我们再写lambda时默认只可以用()传递过去的参数,但是lambda也可以突破出自身作用域,捕获使用外层作用域的变量。描述了上下文中那些数据可以被lambda使用,以及使用的方式传值还是传引用。
x:表示值传递方式捕捉变量x
=:表示隐式值捕捉。值传递方式捕获所有父作用域中的变量(包括this)
\&:表示隐式引用捕捉,引用传递捕捉所有父作用域中的变量(包括this)
\&x:表示引用传递捕捉变量x
this:表示值传递方式捕捉当前的this指针
一般捕捉有三种方式,一种是显式的针对性的值或者引用捕捉x,y,\&a,表示对x,y值捕捉,对a引用捕捉。一种是隐式捕捉,包括 = 和 \& ,只要函数体用了就会自动捕捉。最后一种是混合使用显式和隐式的捕捉,比如=,\&x表示其他的隐式捕捉,x引用捕捉。\&,x,y表示xy值捕捉,其他隐式捕捉。
使用时需要注意:
父作用域指包含lambda函数的语句块
语法上捕捉列表可由多个捕捉项组成,并以逗号分割。比如:=, \&a, \&b:以引用传递的方式捕捉变量a和b,值传递方式捕捉其他所有变量,\&,a, this:值传递方式捕捉变量a和this,引用方式捕捉其他变量
捕捉列表不允许变量重复传递,否则就会导致编译错误。比如:=, a:=已经以值传递方式捕捉了所有变量,捕捉a重复。
在块作用域以外的lambda函数捕捉列表必须为空。
在块作用域中的lambda函数仅能捕捉父作用域中局部变量,捕捉任何非此作用域或者非局部变量都会导致编译报错。
lambda表达式之间不能相互赋值,即使看起来类型相同。
混合捕捉使用时第一个元素必须是=或者&,并且如果第一个是&,那么后面必须是值捕捉,同理前面是=,后面必须是引用捕捉。
8.3lambda的原理
lambda 的原理和范围for很像,编译后从汇编指令层的角度看,压根就没有 lambda 和范围for 这样的东西。范围for底层是迭代器,而lambda底层是仿函数对象,也就说我们写了⼀个 lambda 以后,编译器会生成一个对应的仿函数的类。
仿函数的类名是编译按一定规则生成的,保证不同的 lambda 生成的类名不同,lambda参数/返回类型/函数体就是仿函数operator()的参数/返回类型/函数体, lambda 的捕捉列表本质是生成 的仿函数类的成员变量,也就是说捕捉列表的变量都是 lambda 类构造函数的实参,当然隐式捕 捉,编译器要看使用哪些就传那些对象。
9.包装器
9.1.std::function(函数包装器)
头文件:#include<fuctional>
官方文件:function
std::function是一个可调用对象的容器,可以包装:普通函数、函数指针、lambda 表达式、成员函数、仿函数。 统一不同类型可调用对象的类型签名,把它们当成同一个类型来保存、传递、回调。
语法:std::function<返回值类型(参数列表)> 变量名;
cpp
#include <iostream>
#include <functional>
using namespace std;

// 普通函数
int add(int a, int b)
{
    return a + b;
}

int main()
{
    // 包装普通函数
    function<int(int, int)> f1 = add;
    cout << f1(1,2) << endl;

    // 包装lambda
    function<int(int, int)> f2 = [](int x, int y){return x-y;};
    cout << f2(10,3) << endl;

    return 0;
}
9.2bind
bind的头文件和function一样,bind是用来调整参数个数和参数顺序的,一般形式为:
auto newCallable = bind(callable,arg_list);
newCallable是一个可调用对象,arg_liat是一个逗号分隔的参数列表,对应给定的callable的参数,调用newCallable时,newCallable调用callable,并传给arg_list中的参数。
arg_list中的参数可能包含形如_n的名字,其中n是一个整数,这些参数是占位符,表示 newCallable的参数,它们占据了传递给newCallable的参数的位置。数值n表示生成的可调用对象 中参数的位置:_1为newCallable的第一个参数,_2为第二个参数,以此类推。_1/_2/_3....这些占 位符放到placeholders的⼀个命名空间中。这里作者并不过多介绍了,感兴趣的可以自行了解
10.补充
c++11补充的知识是非常多的,这里只是简要说明了其中的几个,并不是全部内容,另外,智能指针也是c++11所新增的,但是智能指针作者会在后面再写一篇文章进行说明。