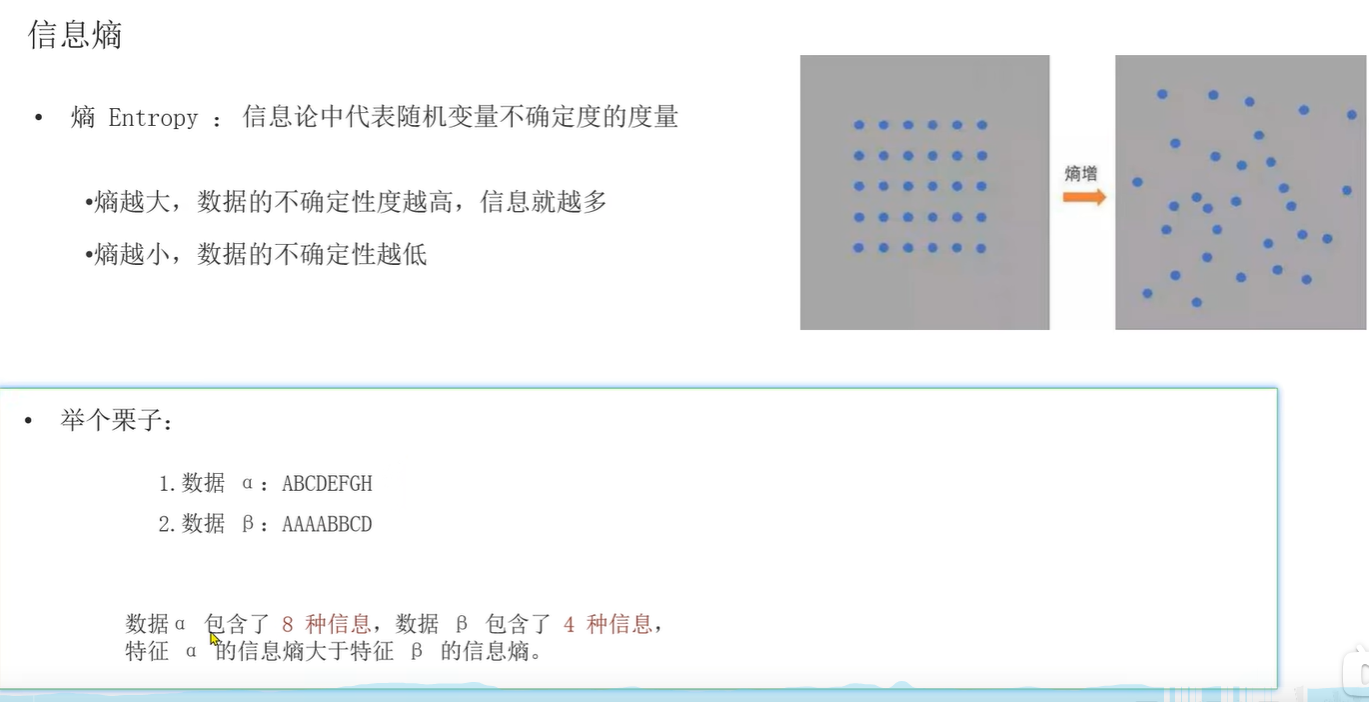
公式
(信息)熵 = ∑ -分类占比 * log 2(分类占比)
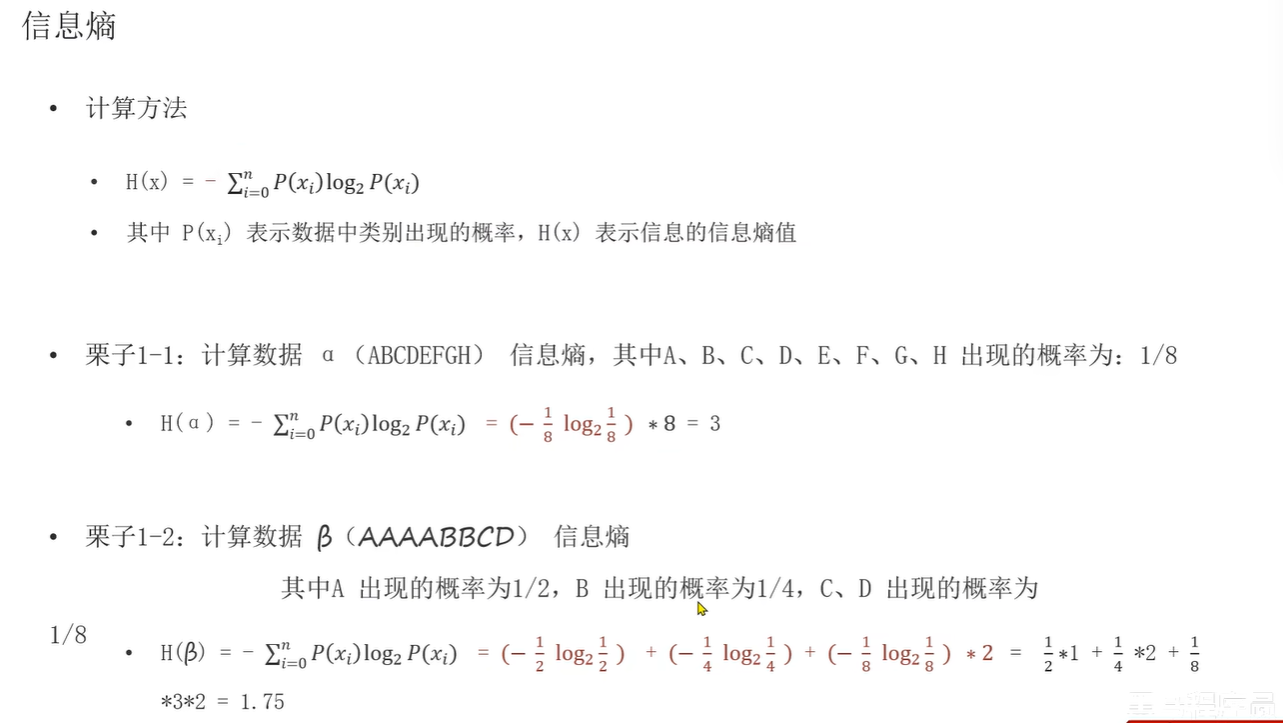
信息增益
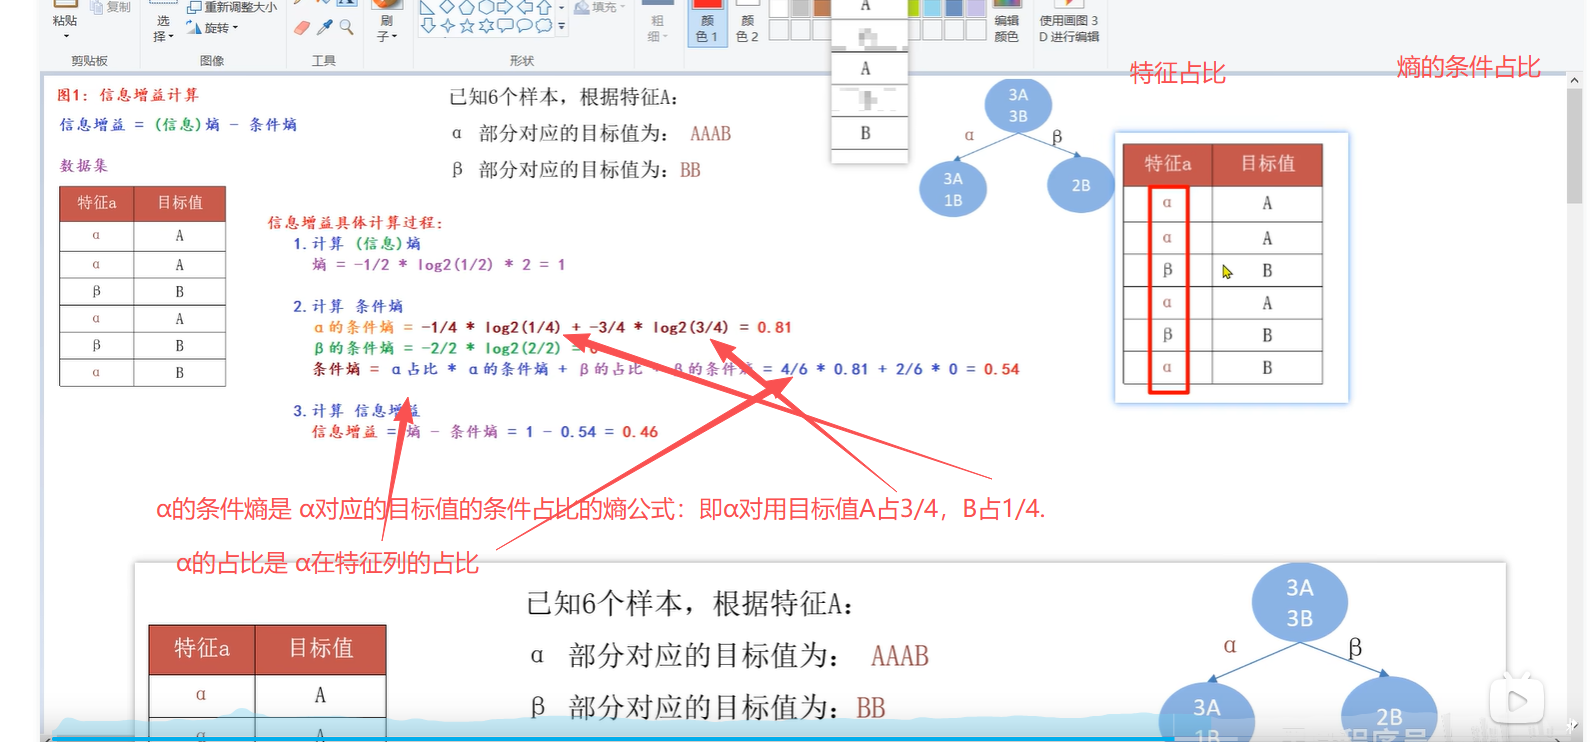
实际案例:信息增益
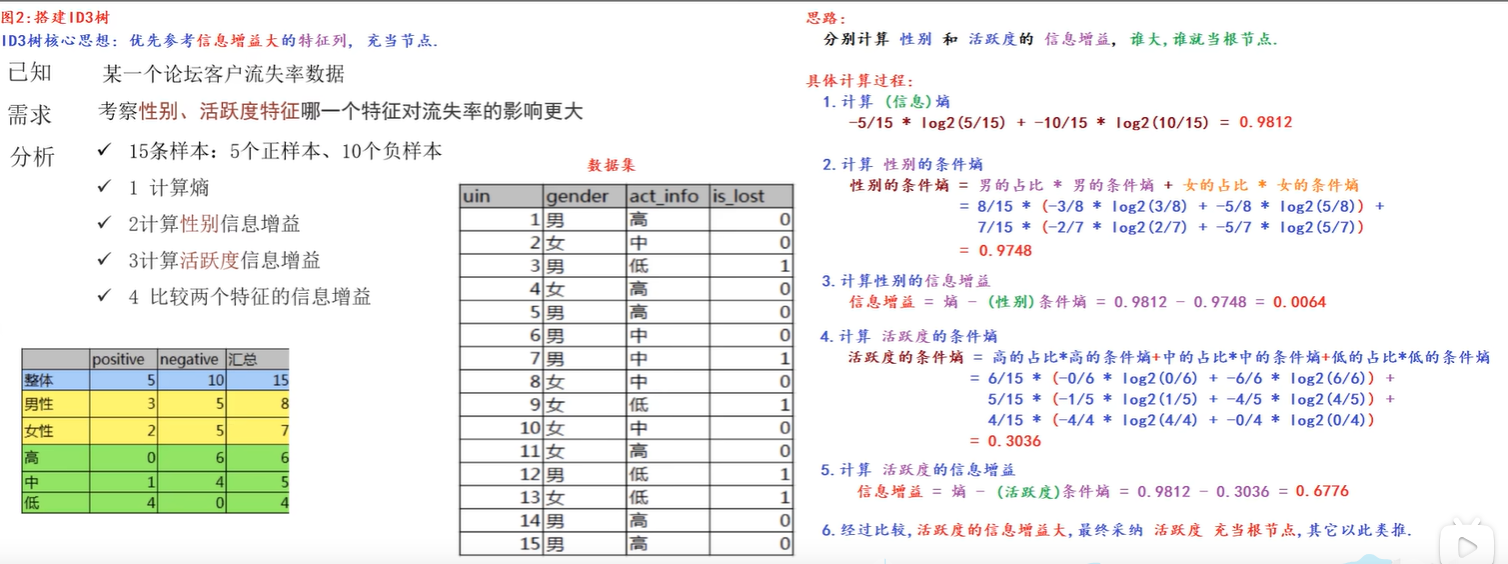
实际案例:信息增益率
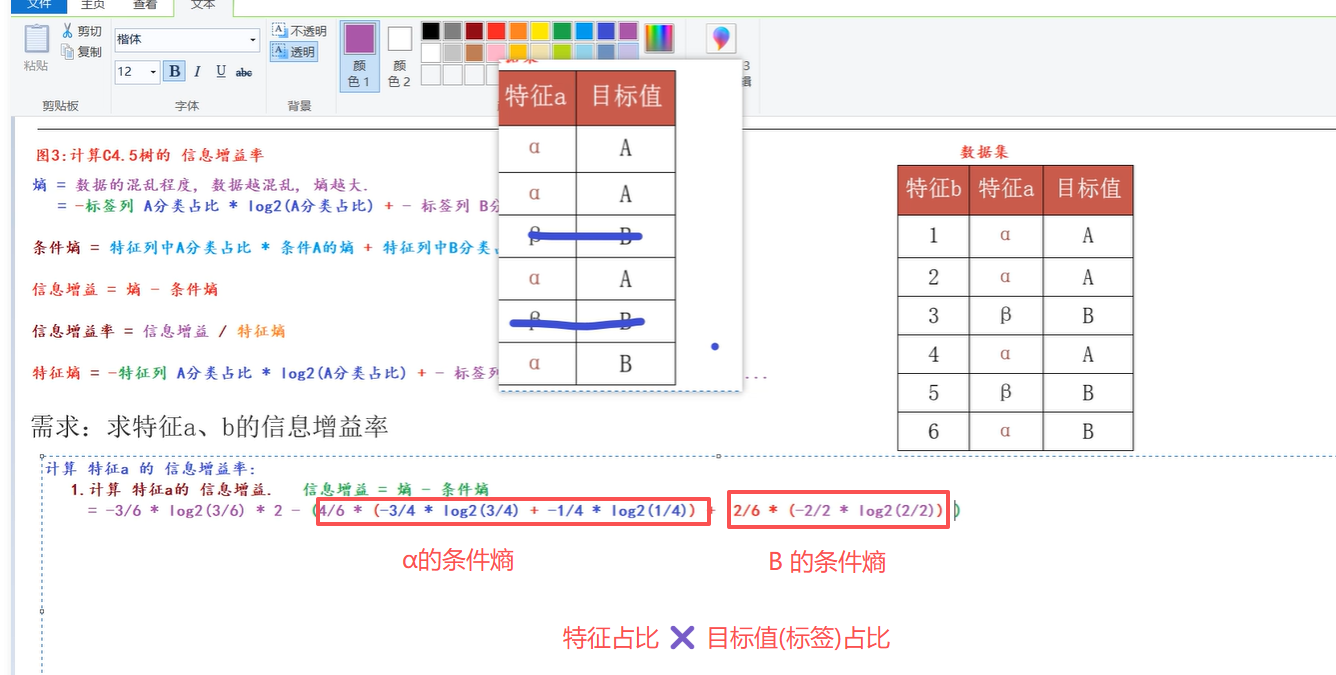
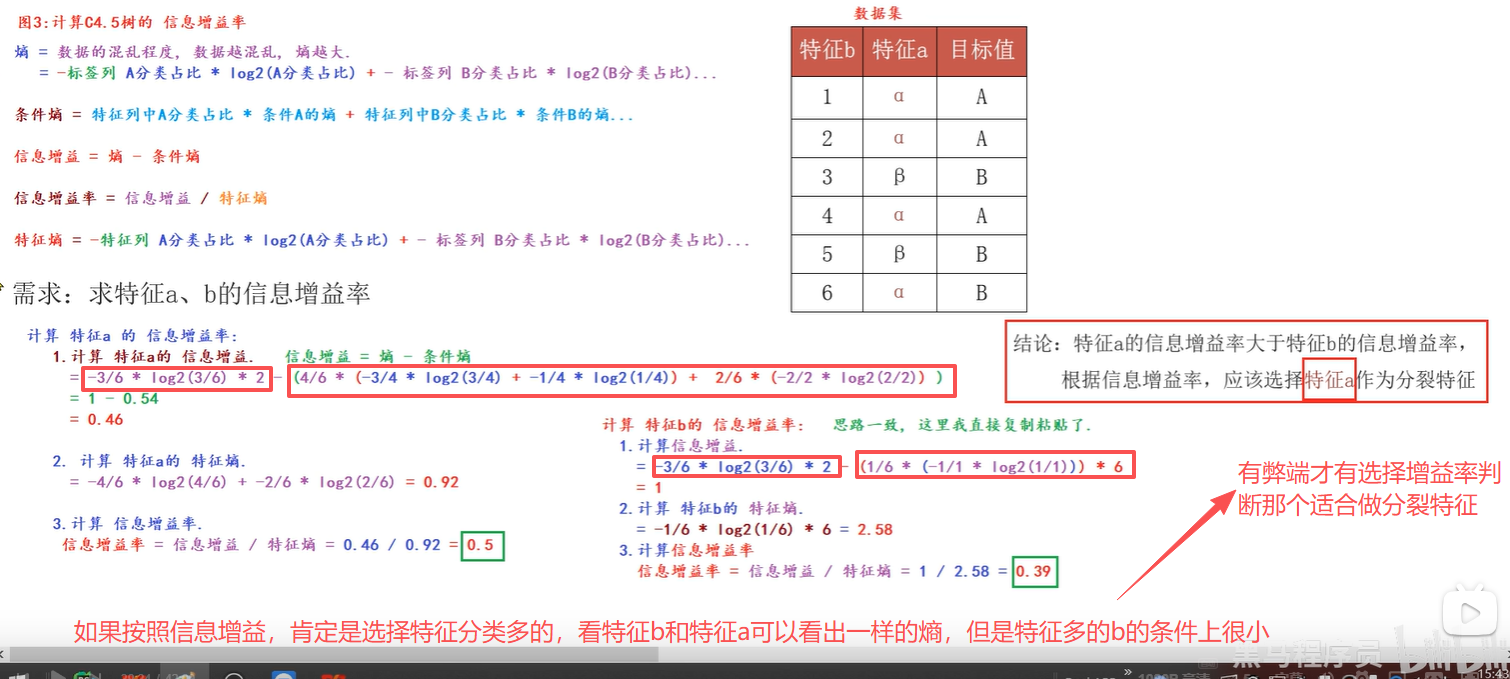
为啥选择信息增益率,不用信息增益?信息增益弊端是啥
因为信息增益等于 熵 - 条件熵
在 实际案例:信息增益率 中可以看出来,一个特征如果分类多(特征b),他的条件熵很小,一个特征如果分类少(特征a),他的条件熵很大。 但是无论特征多,还是特征少,他们的熵是一致的。
所以 信息增益等于熵 - 条件熵 的情况,会一直选择 特征分类多的。
特征分类越多,模型越容易在训练集上表现完美,但在测试集上表现很差。信息增益的弊端就是它无法区分"真正有用的分类"和"仅仅是把数据切碎的无效分类"。
举个例子:我们在做一个"是否购买电脑"的预测,数据里有 10 个人,其中 5 个买、5 个不买(熵 = 1)
现在有两个特征:
- 特征 A(年龄):分为"青年、中年、老年" 3 类。
- 特征 B(身份证号):分为 10 类,因为每个人身份证号都不同。
如果用信息增益来选特征,会发生什么?
看特征 B(身份证号) :它把 10 个人分成了 10 个小组,每组只有 1 个人。对于每个小组,要么是"买",要么是"不买",纯度 100%。所以它的条件熵 = 0。那么它的信息增益 = 1 - 0 = 1(最大值)。
看特征 A(年龄):虽然把人群分成了 3 组,但每组里可能还是有买有没买的,纯度没那么高。假设它的条件熵 = 0.8。那么它的信息增益 = 1 - 0.8 = 0.2。
结论 :信息增益会毫不犹豫地选择"身份证号"这个特征。
但"身份证号"这个特征对于预测"是否买电脑"毫无意义,它只是把数据切碎了,产生了过拟合,不能泛化到新数据。