决策树
优点:易解读,无需对数据标准化,天然支持多分类和非线性
缺陷:易过拟合,可能不够准确(通过随机森林改善),对数据变化敏感
-
核心概念:
- 基本思想 :模拟人类决策的自然过程(一系列"是/否"问题) ,解决分类 和回归问题。
- 核心组成 :
- 根节点(Root Node):决策树的起点,包含所有数据样本,第一个决策点。
- 内部节点(Internal/Decision Node):每个节点对应一个数据特征,算法会在此处进行测试,并根据结果将数据分到不同分支。
- 分支(Branch):连接节点之间的路径,代表特征测试的不同结果。
- 叶子节点(Leaf Node):决策终点,包含最终的预测结果或分类标签。
- 生活举例:医生看病(发烧吗?-> 咳嗽吗?-> 流鼻涕吗?-> 诊断:感冒)
-
核心算法逻辑:信息增益(典型)
-
作用:决策树用于选择最佳分裂特征的核心指标(减少不确定性的度量)。
-
原理 :特征的
信息增益越大,区分不同类别样本的能力越强,越优先作为分裂节点。 -
计算逻辑(三步走):
- 计算原始熵(shāng) :测量分裂前 数据集的混乱程度(越混乱,熵越大)。
- 计算条件熵 :使用某特征分割后 ,各子集加权平均熵。
- 计算信息增益 = 原始熵 - 条件熵。
【实战提示 】:在实际应用中(如sklearn),算法会自动计算并选择最佳分裂,无需手动计算复杂公式;分类默认 用基尼系数 ,当设置
criterion='entropy'时使用信息增益。
-
-
决策树内部构建过程:
决策树构建本质是贪心算法 ,每次选当前最优分裂。通常采用
DecisionTreeClassifier(决策树分类器)或DecisionTreeRegressor(决策树回归器)来实现决策树的构建。理论步骤 核心动作 对应代码 / 参数 1. 选择最佳特征 计算信息增益/基尼系数,找最好的特征 criterion='gini'(基尼系数)或'entropy'(信息增益)2. 分割数据集 根据特征取值切分数据 内部自动完成 3. 递归构建子树 在子集上重复 1 和 2 内部自动完成 4. 达到停止条件 停止生长,生成叶子节点 max_depth(最大深度)、min_samples_split(分裂最小样本数) 、min_samples_leaf(叶子最小样本数)关键参数:
max_depth(最大深度):控制树复杂度,典型值 3-10。防止模型过于复杂。min_samples_split(分裂最小样本数) :默认2,增大可减少过拟合,典型值 2-20。min_samples_leaf(叶节点最小样本数) :保证叶节点可靠性,提高泛化能力,典型值 1-10。
-
案例 :波士顿地区的房屋中位数价格(房价)------
DecisionTreeRegressor(决策树回归器)第一步:网格搜索 + 交叉验证(确定参数)
pythonfrom sklearn.metrics import r2_score from sklearn.model_selection import GridSearchCV from sklearn.tree import DecisionTreeRegressor from sklearn.model_selection import train_test_split import pandas as pd # 准备数据 df = pd.read_csv("boston_housing_data.csv") x = df.drop('MEDV', axis=1) y = df['MEDV'] # 房价 # 1. 定义您想尝试的参数组合 param_grid = { 'max_depth': [3, 5, 7, 10], # 尝试不同深度 'min_samples_split': [2, 5, 10, 20], # 尝试不同分裂要求 'min_samples_leaf': [1, 2, 4, 8] # 尝试不同叶节点大小 } x_train,x_test,y_train,y_test = train_test_split( x,y,test_size=0.2,random_state=42 ) # 2. 初始化模型 base_model = DecisionTreeRegressor(random_state=42) # 3. 设置网格搜索(cv=5 表示5折交叉验证,scoring='r2' 表示用 R² 评估) grid_search = GridSearchCV(estimator=base_model, param_grid=param_grid, cv=5, scoring='r2', n_jobs=-1) # n_jobs=-1 表示用所有CPU核心加速 # 4. 在训练集上执行搜索 grid_search.fit(x_train, y_train) # 5. 查看最佳参数组合和最佳得分 print(f"最佳参数组合: {grid_search.best_params_}") print(f"最佳交叉验证 R²: {grid_search.best_score_:.2f}") # 6. 用最佳参数的模型去预测测试集 best_model = grid_search.best_estimator_ y_pred = best_model.predict(x_test) print(f"最终测试集 R²: {r2_score(y_test, y_pred):.2f}") ------------------------------------------------------------------------------- 最佳参数组合: {'max_depth': 10, 'min_samples_leaf': 8, 'min_samples_split': 20} 最佳交叉验证 R²: 0.74 最终测试集 R²: 0.78 -------------------------------------------------------------------------------第二步:模型构建与应用
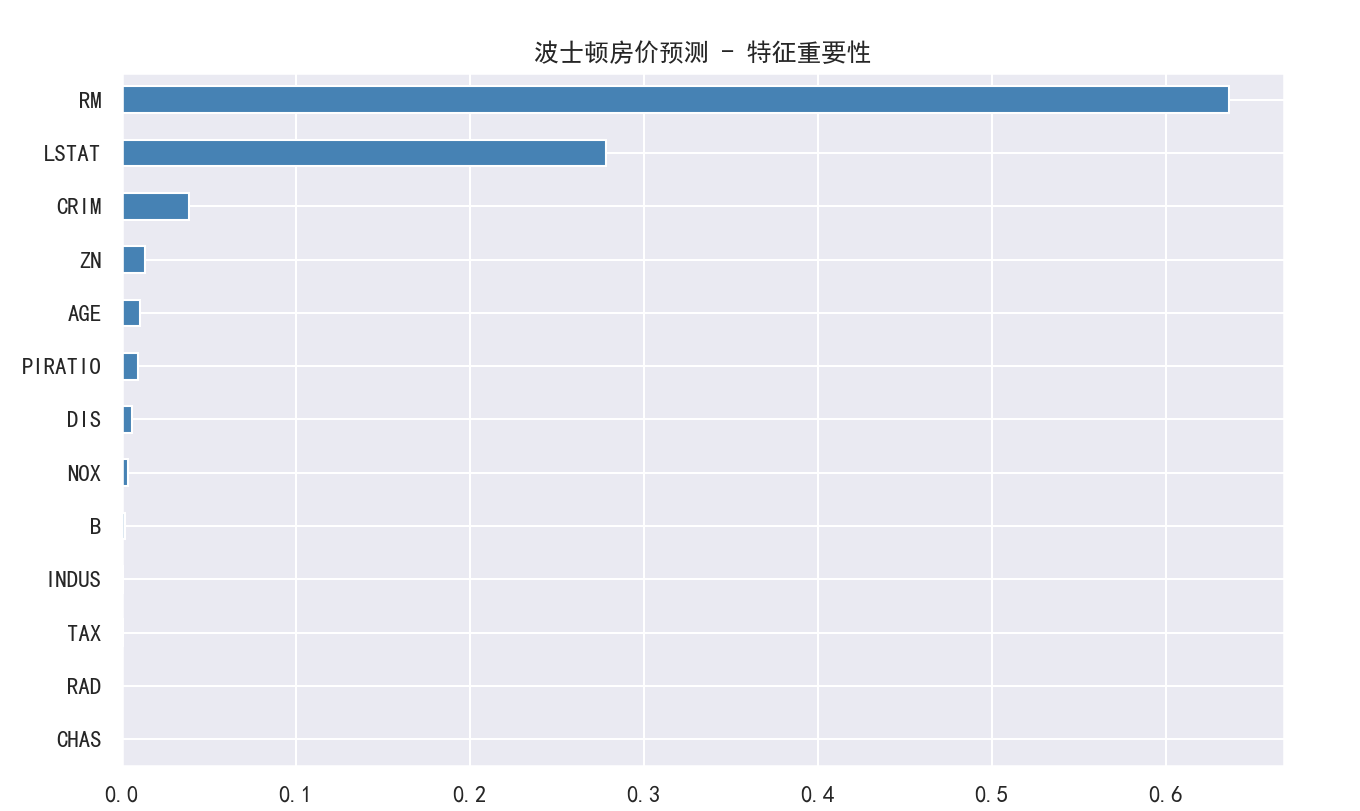
pythonfrom sklearn.tree import DecisionTreeRegressor,plot_tree from sklearn.model_selection import train_test_split import pandas as pd import matplotlib.pyplot as plt from sklearn.metrics import mean_squared_error,r2_score import seaborn as sns # 准备数据 df = pd.read_csv("boston_housing_data.csv") x = df.drop('MEDV', axis=1) y = df['MEDV'] # 房价 # 划分数据集和测试集 x_train,x_test,y_train,y_test = train_test_split( x,y,test_size=0.2,random_state=42 ) # 模型 model = DecisionTreeRegressor(max_depth=10,min_samples_split=20,min_samples_leaf=8) # 模型训练 model.fit(x_train,y_train) # 模型评估 (回归模型常用指标) y_pred = model.predict(x_test) mse = mean_squared_error(y_test, y_pred) r2 = r2_score(y_test, y_pred) print(f"均方误差 (MSE): {mse:.2f}") print(f"决定系数 (R²): {r2:.2f} (越接近1越好)") # 可视化决策树 plt.figure(figsize=(16, 8)) plot_tree(model, filled=True, feature_names=x.columns, rounded=True) plt.show() # 特征重要性分析 plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei'] # 黑体优先,备选微软雅黑 plt.rcParams['axes.unicode_minus'] = False # 解决负号变成方框 sns.set(font="SimHei") # seaborn热力图也要指定字体 feature_importances = pd.Series(model.feature_importances_, index=x.columns) feature_importances.sort_values(ascending=True).plot(kind='barh', figsize=(10, 6), color='steelblue') plt.title('波士顿房价预测 - 特征重要性') plt.show() ---------------------------------------------------------- 均方误差 (MSE): 16.16 决定系数 (R²): 0.78 (越接近1越好) ----------------------------------------------------------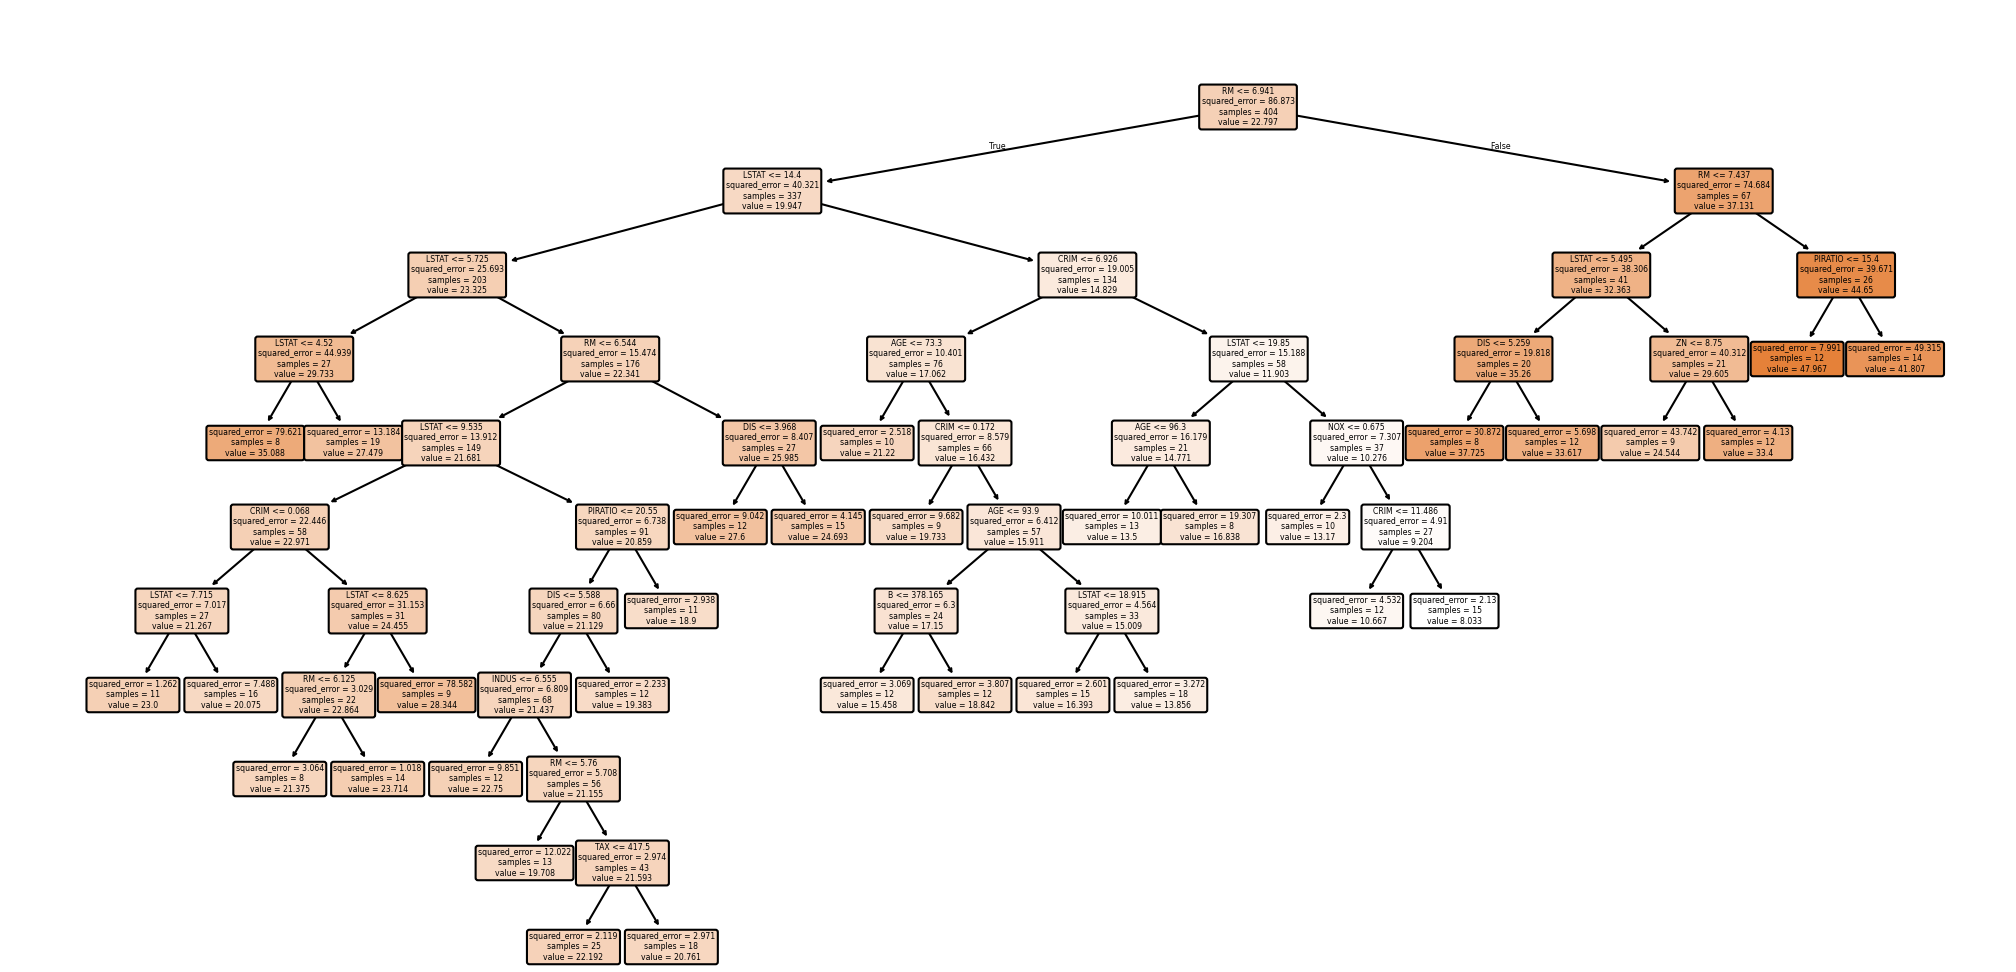
-
案例:鸢尾花数据集 (Iris)
第一步:网格搜索 + 交叉验证(确定参数)
pythonfrom sklearn.datasets import load_iris from sklearn.metrics import accuracy_score from sklearn.model_selection import GridSearchCV from sklearn.model_selection import train_test_split from sklearn.tree import DecisionTreeClassifier # 1. 加载内置数据 iris = load_iris() x = iris.data # 特征:花萼长度、花萼宽度、花瓣长度、花瓣宽度 (150行, 4列) y = iris.target # 目标:3种鸢尾花类别 (0, 1, 2) # 1. 定义您想尝试的参数组合 param_grid = { 'max_depth': [3, 5, 7, 10], # 尝试不同深度 'min_samples_split': [2, 5, 10, 20], # 尝试不同分裂要求 'min_samples_leaf': [1, 2, 4, 8] # 尝试不同叶节点大小 } x_train,x_test,y_train,y_test = train_test_split( x,y,test_size=0.2,random_state=42 ) # 2. 初始化模型 base_model = DecisionTreeClassifier(random_state=42) # 3. 设置网格搜索(cv=5 表示5折交叉验证,scoring='accuracy' 表示用准确率评估) grid_search = GridSearchCV(estimator=base_model, param_grid=param_grid, cv=5, scoring='accuracy', n_jobs=-1) # n_jobs=-1 表示用所有CPU核心加速 # 4. 在训练集上执行搜索 grid_search.fit(x_train, y_train) # 5. 查看最佳参数组合和最佳得分 print(f"最佳参数组合: {grid_search.best_params_}") print(f"最佳交叉验证准确率: {grid_search.best_score_:.2f}") # 6. 用最佳参数的模型去预测测试集 best_model = grid_search.best_estimator_ y_pred = best_model.predict(x_test) print(f"最终测试集准确率: {accuracy_score(y_test, y_pred):.2f}") ------------------------------------------------------------------------------ 最佳参数组合: {'max_depth': 3, 'min_samples_leaf': 4, 'min_samples_split': 2} 最佳交叉验证 R²: 0.95 最终测试集准确率: 1.00 ------------------------------------------------------------------------------第二步:模型构建与应用
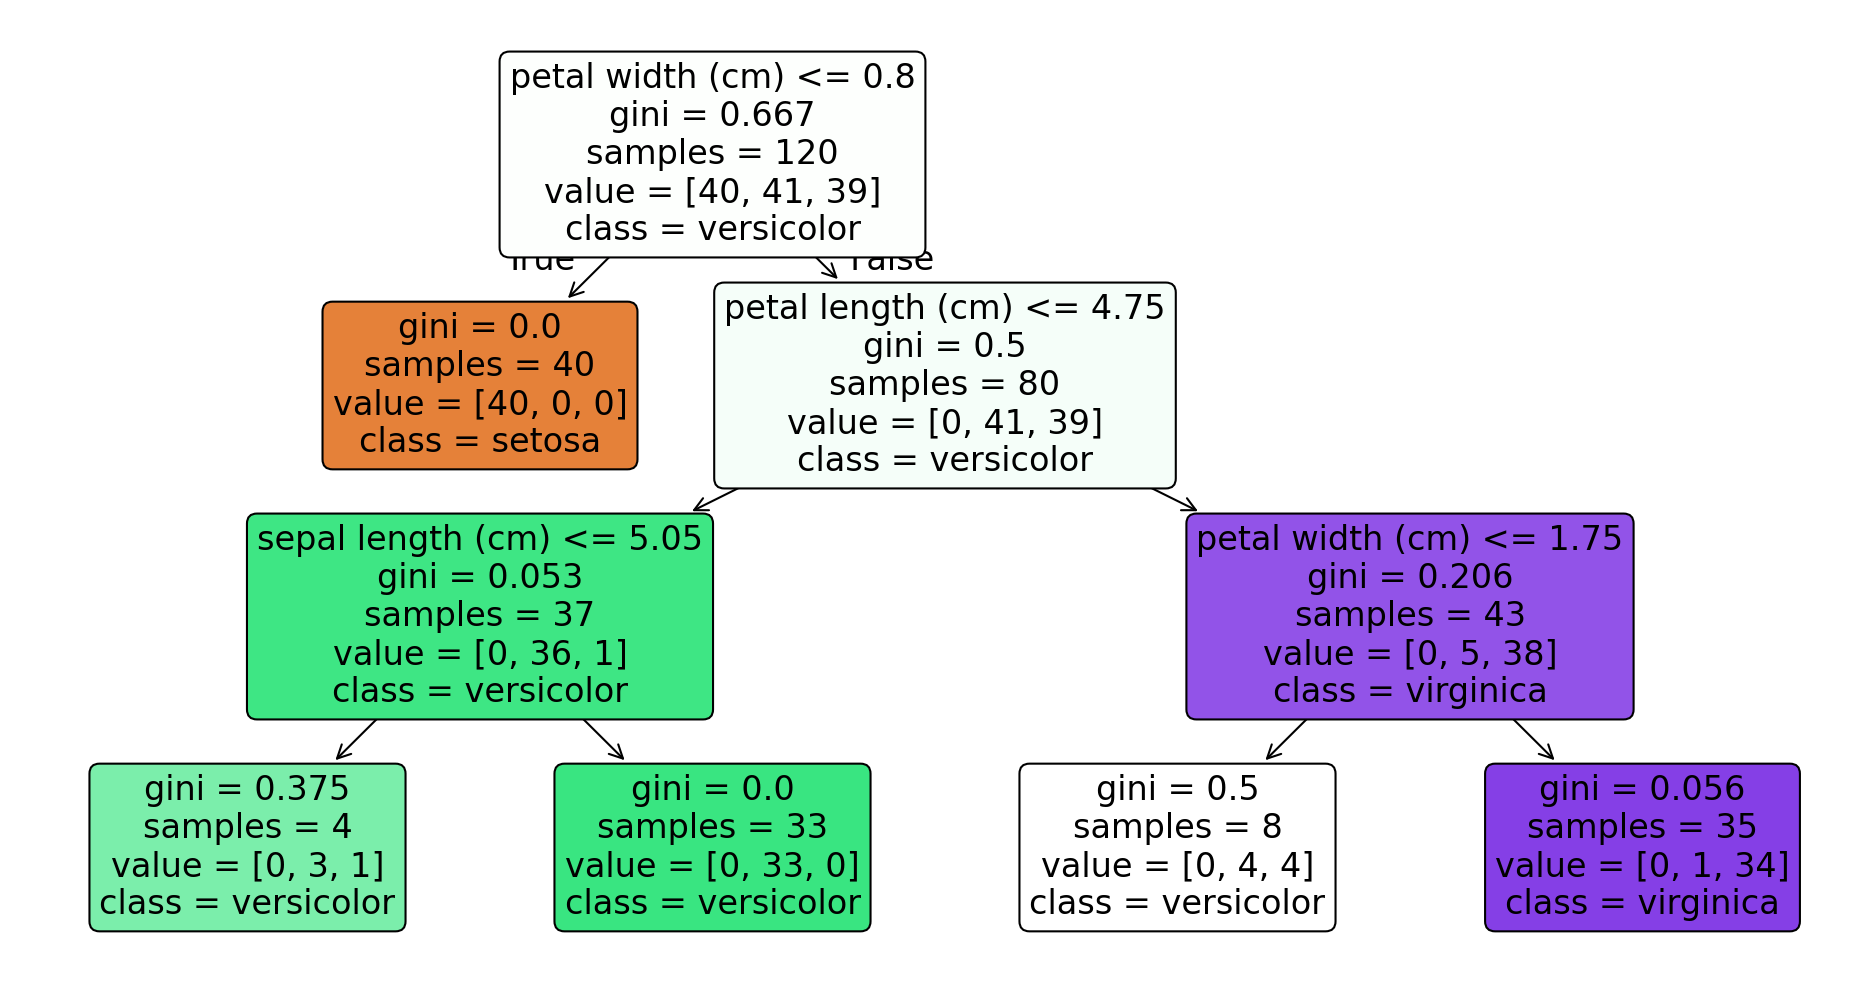
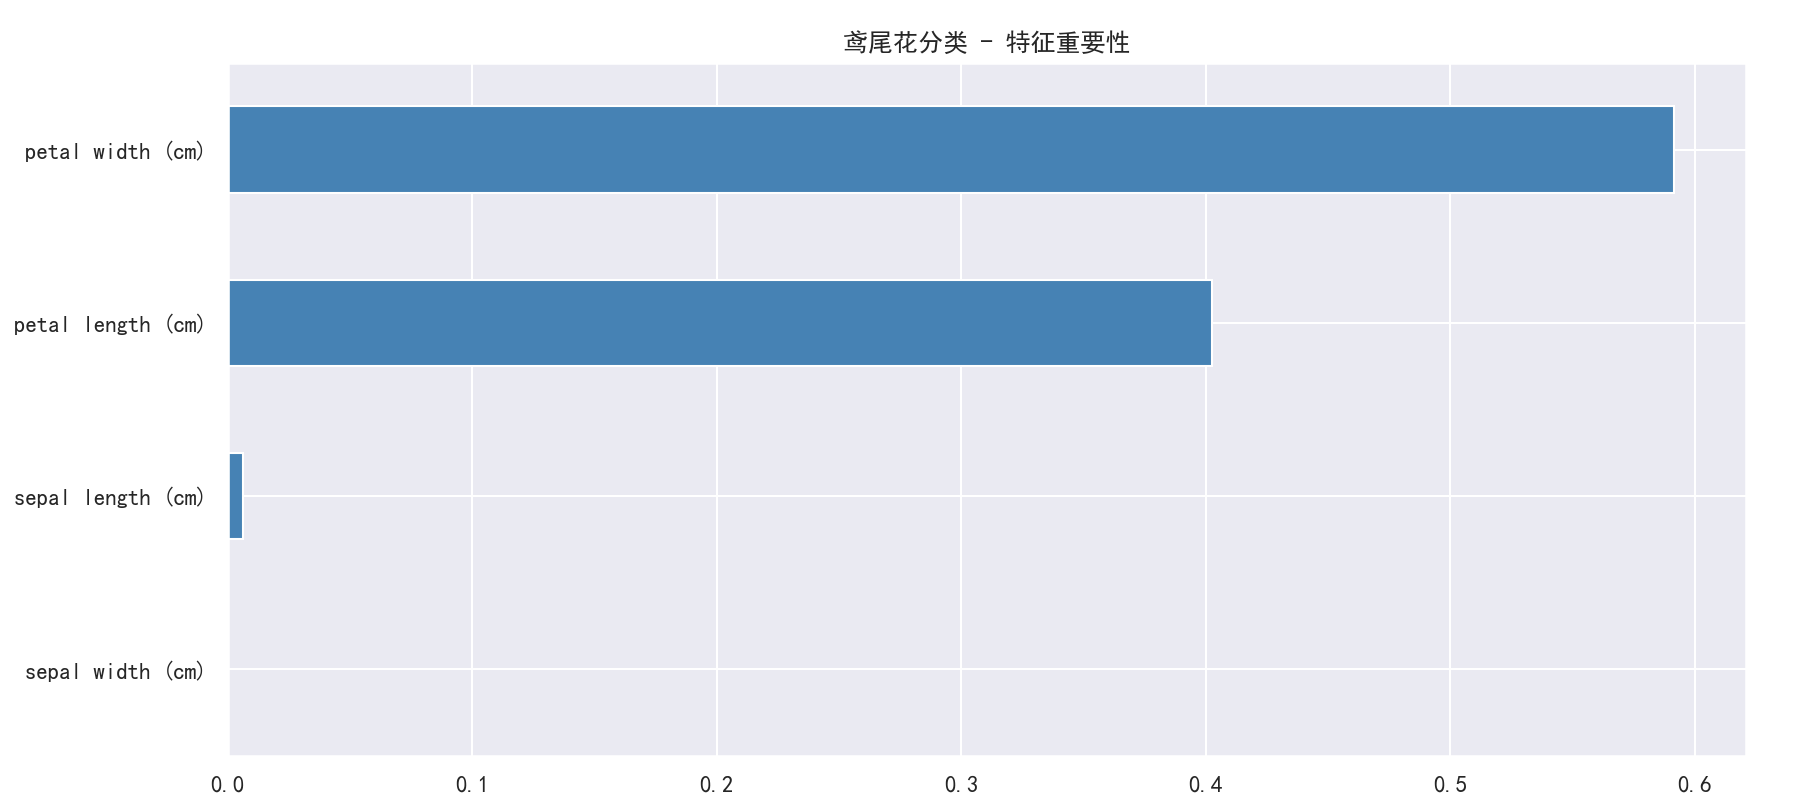
pythonimport pandas as pd import matplotlib.pyplot as plt from sklearn.datasets import load_iris from sklearn.model_selection import train_test_split from sklearn.tree import DecisionTreeClassifier, plot_tree from sklearn.metrics import accuracy_score, classification_report import seaborn as sns # 1. 加载内置数据 iris = load_iris() X = iris.data # 特征:花萼长度、花萼宽度、花瓣长度、花瓣宽度 (150行, 4列) y = iris.target # 目标:3种鸢尾花类别 (0, 1, 2) # 2. 划分训练集和测试集 (80% 训练,20% 测试) X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42) # 3. 创建决策树分类模型并训练 # max_depth=3 是经典参数,防止过拟合,同时便于可视化 clf = DecisionTreeClassifier(max_depth=3, min_samples_split=2, min_samples_leaf=4) clf.fit(X_train, y_train) # 4. 模型预测 y_pred = clf.predict(X_test) # 5. 模型评估 (分类模型常用指标) # 准确率 (Accuracy) acc = accuracy_score(y_test, y_pred) print(f"模型准确率 (Accuracy): {acc:.2f}") # 打印分类报告(包含精确率 Precision、召回率 Recall、F1值) print("\n分类报告:") print(classification_report(y_test, y_pred, target_names=iris.target_names)) # 6. 可视化决策树 plt.figure(figsize=(16, 8)) plot_tree(clf, filled=True, feature_names=iris.feature_names, class_names=iris.target_names, rounded=True) plt.show() # 7. 特征重要性分析 plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei'] # 黑体优先,备选微软雅黑 plt.rcParams['axes.unicode_minus'] = False # 解决负号变成方框 sns.set(font="SimHei") # seaborn热力图也要指定字体 feature_importances = pd.Series(clf.feature_importances_, index=iris.feature_names) feature_importances.sort_values(ascending=True).plot(kind='barh', figsize=(10, 6), color='steelblue') plt.title('鸢尾花分类 - 特征重要性') plt.show() ------------------------------------------------------------------------------ 模型准确率 (Accuracy): 1.00 分类报告: precision recall f1-score support setosa 1.00 1.00 1.00 10 versicolor 1.00 1.00 1.00 9 virginica 1.00 1.00 1.00 11 accuracy 1.00 30 macro avg 1.00 1.00 1.00 30 weighted avg 1.00 1.00 1.00 30 ------------------------------------------------------------------------------