导语:视觉语言模型能识别物体、理解指令,却不一定能把末端执行器准确地移动到正确位置。这个"看懂但手伸不对"的问题,是具身智能从感知走向执行的核心瓶颈。Show-Harness的思路不是让模型一次性预测整条轨迹,而是让它在一个紧凑的语义动作空间中逐步决策,再由具体机器人的动作解释器完成物理执行。在Franka、AgileX双臂、仿真到现实和多组受控实验中,这套分工把VLM的世界知识更稳定地带进了机器人操作------跨任务平均成功率89%,跨环境100%,仿真到现实13/20。
一、问题:VLM为什么"看懂"却"手伸不对"?
如果把每一个视觉观察直接映射成某一台机器人的关节角或连续末端轨迹,模型需要同时记住物体语义、空间关系、控制器特性和工作空间边界。换一台机器人、换一组摄像头,甚至只改变目标物体的摆放位置,原来的映射就可能失效。
另一种方式是把VLM放在更高层,让它生成程序、调用控制函数或给出粗粒度子任务。这样可以保留语言推理能力,却容易出现一个问题:模型只负责"说要做什么",真正的接近、对齐、抓取和纠错都由另一个策略完成,模型的视觉判断没有持续进入执行环。
Show-Harness选择了一个中间位置。模型每次只输出一个语义动作单元,例如向前移动一小步、绕某个轴旋转、抓取或释放;机器人如何把这个单元变成位姿变化,则由自己的执行器处理。动作完成后,新的图像和状态再次返回模型,形成可观察、可修正的闭环。
二、方法总览:从感知到执行的五步闭环
Show-Harness的核心是一个感知---推理---动作---执行---反馈的闭环。模型不是只在任务开始时规划一次,而是在每个交互步都重新读取当前证据。
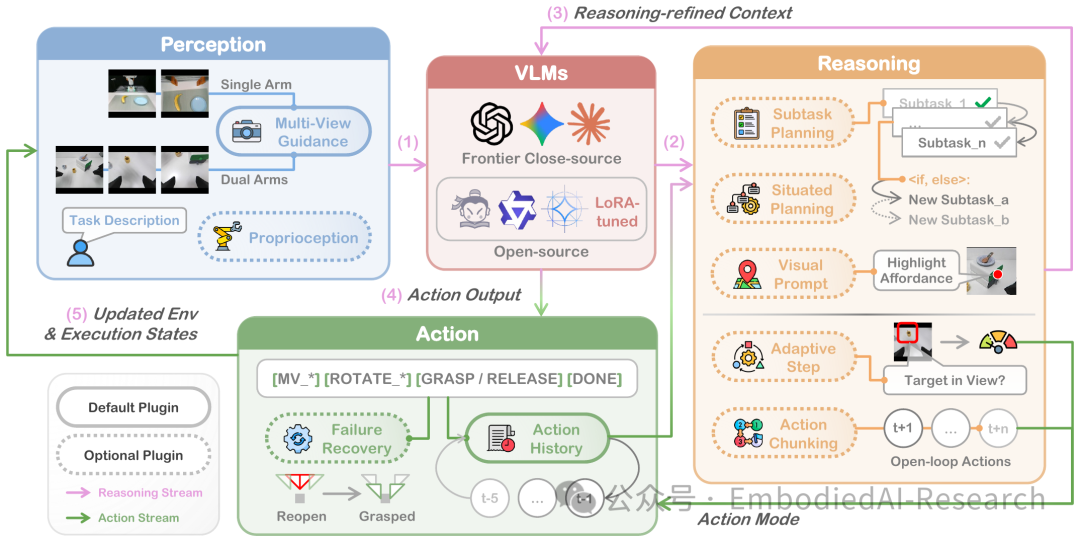
图 1:Show-Harness 的原始方法总览图。感知阶段整理多视角与本体状态,VLM 结合推理插件作出动作判断,动作单元经过形态相关的执行解释后作用于机器人,更新后的环境和执行状态再回到下一轮。
推理阶段可以先把语言任务拆成一串带有完成条件的子任务,也可以把暂时无法判断的分支留到相关物体出现时再决定。视觉提示负责把含糊的语言目标落到具体可交互位置,自适应步长和动作分块则在远距离移动与近距离对齐之间调整反馈密度。
这套组织方式带来的直接变化是:规划、局部动作和执行反馈处在同一个循环里。它仍然依赖VLM的视觉判断,但不要求VLM一次性承担运动学求解和安全约束。
三、关键设计:把大动作拆成可观察的小动作
3.1 语义动作集合
动作集合主要包含三类:
平移类:MV_FWD、MV_BACK、MV_LEFT、MV_RIGHT、MV_UP、MV_DOWN------相对于当前参考视角移动末端执行器。
旋转类:ROTATE_CW、ROTATE_CCW------围绕指定的x、y或z轴逐步调整姿态。
夹爪类:GRASP、RELEASE、DONE------控制夹爪开合并声明任务结束。
它们看起来比连续位姿简单,但关键是每个动作都足够小。模型移动一次后马上看到新的目标相对位置,可以继续修正,而不是等一条长轨迹执行完才发现方向偏了。对VLM来说,MV_RIGHT这样的符号也比一串难以解释的浮点数更接近它本来擅长的语义推理。
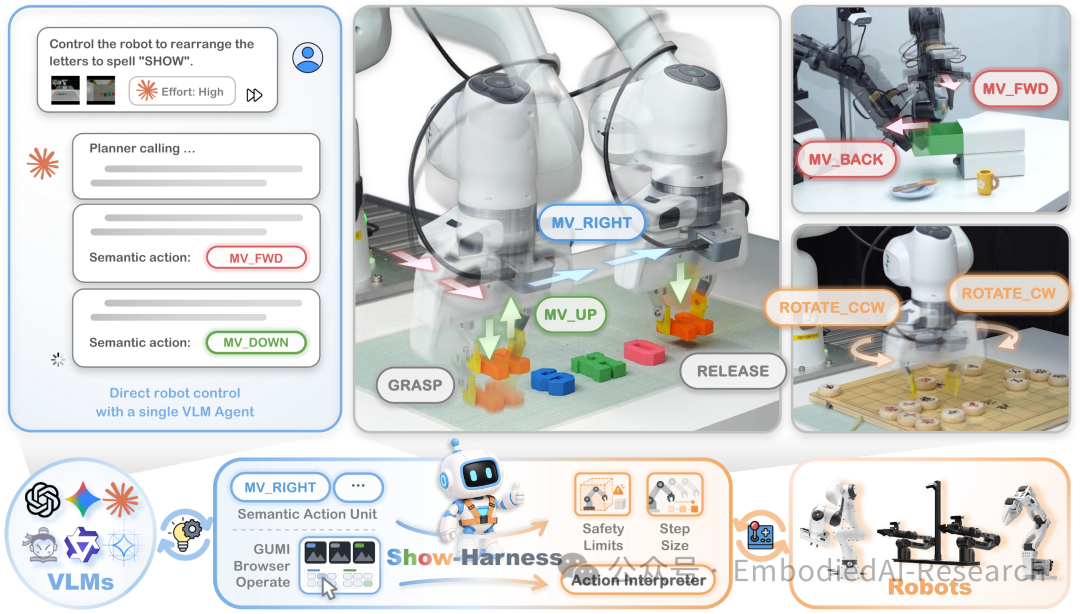
图 2:论文原始动作语义示意。视觉语言模型输出 MV_FWD、MV_BACK、MV_RIGHT、MV_UP、ROTATE_CW、GRASP 等可读单元,再由同一动作层驱动不同机器人完成局部移动、旋转和夹爪操作。
3.2 动作如何落到不同机器人
动作单元并不直接决定某个机器人的关节角。解释器会根据当前形态的坐标系、校准步长、工作空间边界和桌面高度,把平移或旋转转换为该机器人能执行的局部位姿变化;超出边界的动作会在执行前被拦截,抓取和释放则直接对应夹爪开合。
论文以两种底层控制方式为例:Franka跟踪笛卡尔设定点并使用阻抗控制,AgileX通过逆运动学和关节目标流执行,仿真器则使用相应的操作空间控制。它们的控制器不同,但模型看到的动作单元保持一致。
这是一种朴素但有效的分工:VLM负责根据当前视觉和语言判断"下一小步是什么",机器人侧负责把这一步安全地执行出来。对于新形态,工程重点转移到坐标变换、逆运动学、标定与边界设置,而不是重新发明一套模型输出语言。
3.3 两种使用方式
零样本模式:使用Gemini-3.1 Pro等前沿VLM,依靠多视角观察、任务指令和推理插件直接选择动作。
微调模式:使用Qwen3.5-2B等小型VLM,以语义动作单元作为训练目标,在冻结视觉编码器和多模态投影器的情况下,对语言模型的线性层加入rank-64 LoRA,更新参数约占模型的3%。
两种模式共享动作层,因此实验可以更清楚地比较"更强的基础模型"和"更轻量的专用模型"在相同执行表达下的差异。
四、GUMI:把示范采集变成可重复的图形化操作
GUMI是Show-Harness在数据采集层面的延伸。人类可以用键盘逐步控制机器人,计算机使用代理也可以操作同一组按钮,系统同步保存执行前观察、语义动作、低层命令和轨迹。
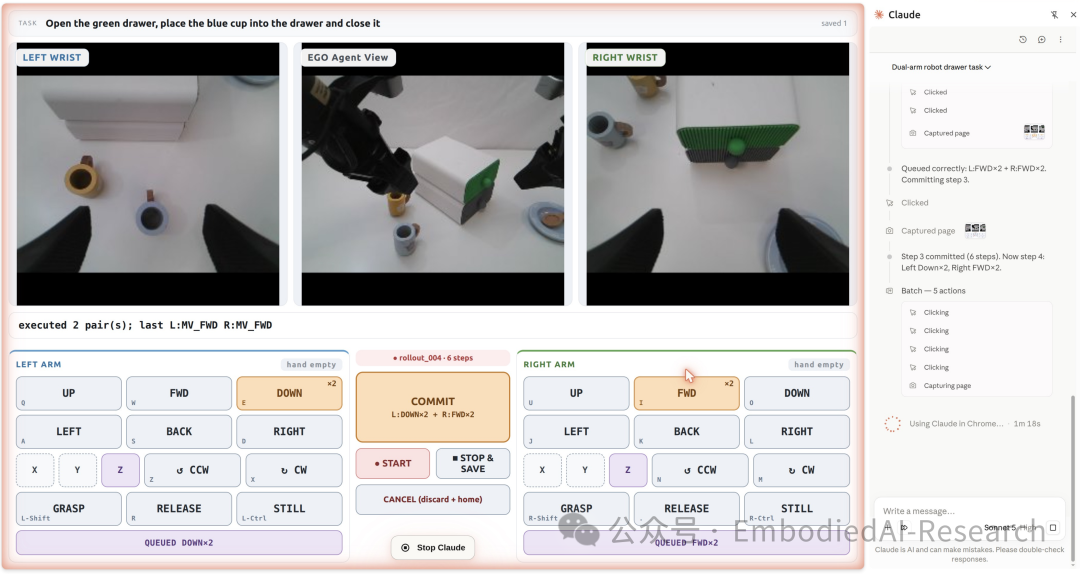
图 3:GUMI 的原始图形界面。上方显示多视角观察和代理记录,下方提供左右手臂的移动、旋转、抓取、释放、动作片段和提交控制,人类与代理可以使用同一套按钮完成示范。
它的实际意义不是把遥操作简单搬到浏览器,而是让示范和模型输出使用同一种动作语言。这样,一条示范既可以形成观察---动作对,也能保留对应的连续轨迹;人类还可以在代理抓取不稳时介入修正。
论文共收集164条真实机器人回合、7774个决策步,以及230条仿真回合、13523个决策步。真实数据来自Franka和单臂AgileX,仿真数据覆盖ManiSkill与RoboLab,并用于后面的仿真到现实实验。
五、实验设置
真实实验使用7自由度Franka Research 3和双臂AgileX。任务由五种物体与两个目标容器组合而成:刚性方块、不规则香蕉、会滚动的网球、可变形的泰迪熊,以及需要精细抓取的棋子;目标容器是盘子或碗。
微调示范只覆盖方块、香蕉和网球,泰迪熊与棋子被留作未见物体检验。
对比方法包括直接预测连续动作的π0.5、GR00T,加入规划层的H-VLA、G-VLA,以及把高层推理转换为程序或控制调用的CaP-X、RATS。
六、主结果:跨任务、跨环境与跨机器人形态
跨任务平均成功率:Show-Harness零样本模式89%,微调模式86%,最高对照RATS为57%。
未见物体:泰迪熊与棋子任务上,零样本模式在盘子目标上分别完成10/10和10/10,微调模式完成8/10和9/10。
跨环境平均值:100%和88%。
仿真到现实:微调模式只用仿真示范,迁移到真实Franka后完成13/20;π0.5和GR00T都是0/20。这支持了语义动作对仿真到现实迁移的帮助。
跨形态:Franka上48/50与45/50,AgileX上45/50与42/50。两种机器人使用不同的底层控制器,模型却无需改变动作表达。
七、物理适应:步长、方向与工作空间
细粒度控制:解释器平移步长从2cm改成1cm,模型和训练数据不变。零样本成功率从60%提升到约80%,微调从40%提升到65%。这说明新的精度需求可以先由执行层吸收,而不是马上重新训练模型。
旋转外推:在0°、45°和训练未出现的90°方向抓取胡萝卜,每次旋转单元只改变15°。带旋转动作时,零样本在未见90°条件下仍达到100%。增量旋转把较大的姿态变化拆成重复的小动作,给模型留下了逐步纠错的空间。
动作组合:两个正交平移合成为一次对角位移,零样本成功率从94%变为92%,平均步数减少约26%。
双臂任务:整理桌面任务中,独立单臂控制成功率为80%和70%,联合控制达到90%且没有碰撞;传递香蕉任务中,独立控制为30%并出现3次碰撞,联合控制提升到70%且无碰撞。
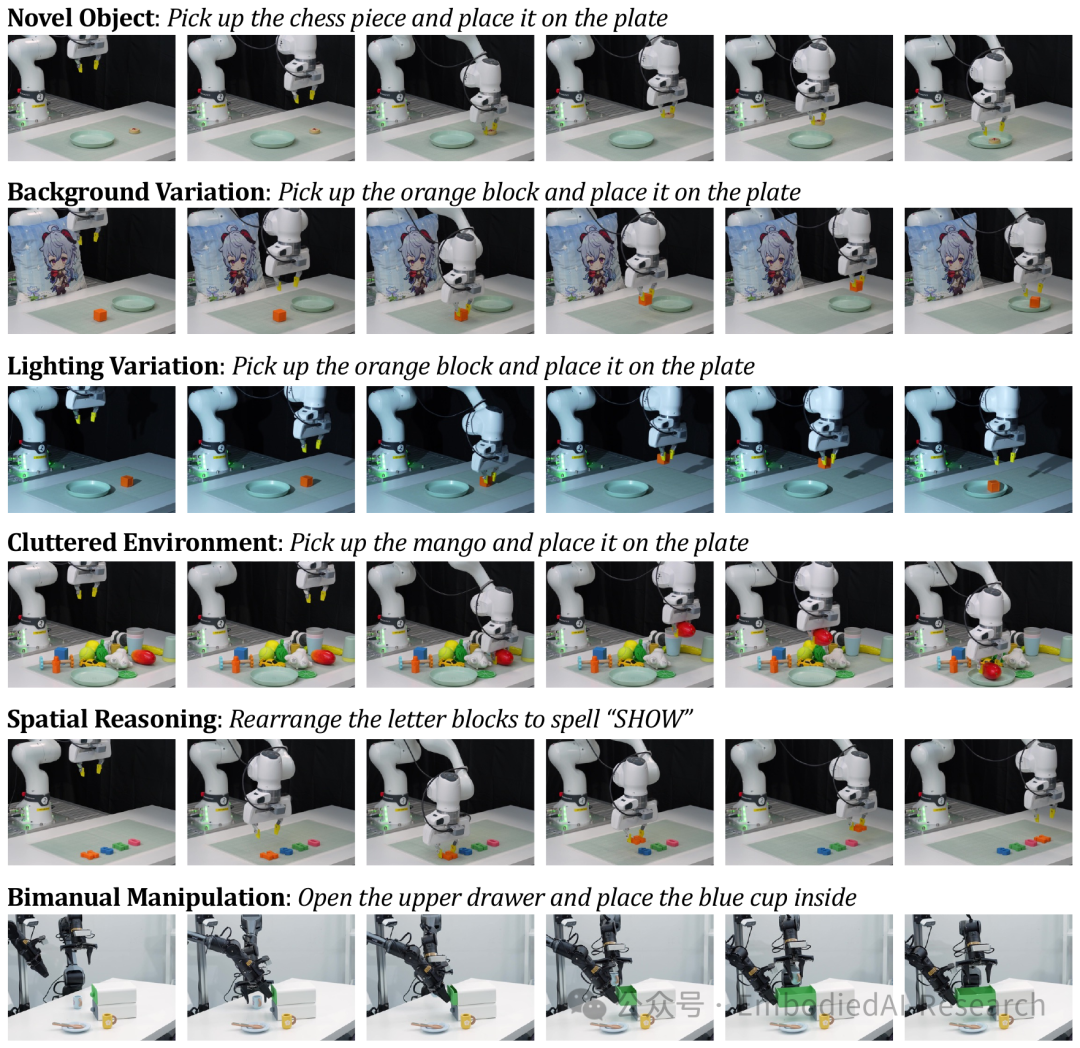
图4:论文原始定性示范图。完整图体覆盖新物体、背景变化、光照变化、杂乱场景、空间推理和双臂操作等真实机器人任务。
八、插件消融:闭环里哪些信息最有用?
多视角引导:从只使用全局视角的58%提升到96%。
本体状态:从68%提升到96%。
子任务计划:从60%提升到96%。
视觉提示:普通盘子任务中影响有限,但在需要抓取杯把手的场景中把成功率从约40%提升到85%。
情境规划:普通任务中变化不大,却把隐藏物体搜索从35%提升到85%。
动作历史:从76%提升到96%。
失败恢复:从72%提升到96%。
这些结果说明:插件的作用不是普遍加分,而是针对视角不足、目标指代不清、来回振荡和空抓等失败模式提供补充信息。
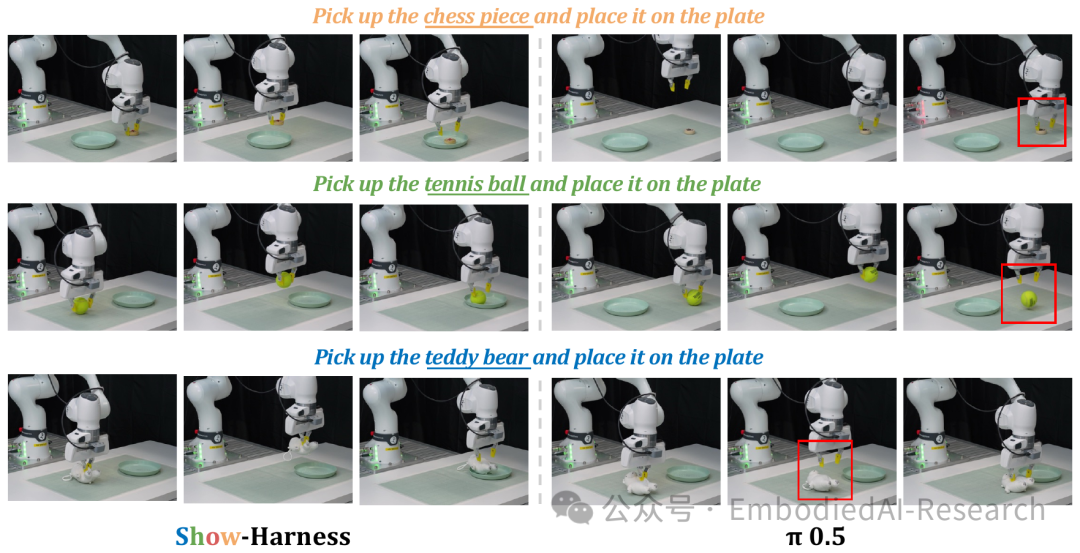
图5:论文原始受控定性对照。Show-Harness 与 π0.5 使用同一批示范,分别完成棋子、网球和泰迪熊放置任务;红框标出对照策略中的抓取或物体交互失败。
九、一个关键发现:动作名称重要,但物理约定更重要
这组消融实验是整篇论文最值得关注的部分。
语义名称+明确约定:100%成功率。
语义名称+无约定:90%。
任意符号+保留约定:95%。
任意符号+无约定:仅5%。
让模型从前后图像变化中自行猜测未知符号,20次试验只成功1次。
结论:动作名称提供有用先验,但明确说明动作会造成什么物理变化更关键。具身控制不能只依靠语言模型的常识,还需要稳定且可验证的动作约定。
十、模型规模与推理开销
不同前沿模型的成功率总体随基础能力上升,但增加思考强度更多表现为减少冗余步骤,并不稳定地提高任务成功率。
能力分解显示:计划正确率普遍高于精细抓取和放置,真正的瓶颈集中在物理对齐,而不是模型是否理解任务目标。
微调骨干规模消融表明:2B模型在精度与响应速度之间取得较好平衡;9B模型在方块堆叠和插入任务上更强,但延迟也更高;较小模型在网球任务上反而可能因为反应更快而有优势。对于真实机器人,模型规模必须与闭环频率、动作步长和目标运动速度一起评估。
十一、边界与思考
Show-Harness的贡献集中在VLM与机器人执行之间的动作表达和闭环组织,不是新的视觉编码器,也不是覆盖所有机器人形态的通用控制器。
论文目前主要在单臂、双臂和并联夹爪上验证;人形机器人、灵巧手、触觉和力反馈尚未进入实验。对于强接触、柔性物体和长时程任务,少量平移、旋转、抓取、释放单元可能不足以表达全部动作细节。
动作解释器也把大量系统工程集中到了机器人侧。每种新形态都需要独立的坐标变换、逆运动学或阻抗控制、工作空间边界和安全标定。
从研究路线看,后续最值得关注的是三件事:其一,把触觉、力和接触事件纳入闭环,让动作单元不仅描述空间移动,也表达当前接触状态。其二,研究从少量手工动作单元到可学习动作词汇的过渡。其三,把动作层与世界模型、长时程记忆和不确定性估计结合。
总结
Show-Harness试图回答一个具体而关键的问题:视觉语言模型已经具备的语义能力,能否在不重新训练成某一台机器人的连续控制器的情况下,直接参与真实机器人动作?
论文给出的路径是:紧凑的语义动作单元、面向形态的执行解释器,以及感知---推理---动作---反馈闭环。
Franka与AgileX实验中的跨任务、跨环境、跨形态结果,加上仿真到现实和多组插件消融,共同说明动作表达方式会显著影响VLM的具身能力。GUMI则把这种表达延伸到示范采集,让人类、代理和策略学习共享同一套动作语言。
但论文的边界同样清晰:任务仍以并联夹爪的桌面操作为主,解释器仍需要形态相关工程,复杂接触、触觉反馈、长时程记忆和更大规模的真实部署还没有充分验证。
它的价值不在于宣称"一个VLM已经会控制所有机器人",而在于把语义推理与机器人执行之间的分工做得更清楚,为后续跨形态、低成本和可复用的具身系统提供了一条可检验的路线。