一、索引的本质与作用
1.1 什么是索引
索引是一种以空间换时间的数据结构,用于加速数据的查找。它的本质和现实生活中"书的目录"完全一样:想找某一章的内容,先翻目录定位页码,再直接翻到对应页面,而不是从第一页逐页翻到目标页。
在数据库中,没有索引时查找数据只能全表扫描(逐行遍历);有了索引后,可以通过索引结构快速定位到目标数据所在的位置,将查找复杂度从 O(n) 降到 O(log n)。
1.2 哪些约束会自动创建索引
在约束篇我们学过主键和唯一键,这两个约束在创建时会自动创建对应的索引:
| 约束 | 自动创建的索引类型 | 说明 |
|---|---|---|
| PRIMARY KEY(主键) | 主键索引(聚簇索引) | 一张表只能有一个,叶子节点存完整行数据 |
| UNIQUE(唯一键) | 唯一索引(二级索引/非聚簇索引) | 一张表可以有多个,叶子节点存主键值,需回表 |
注意:普通索引需要手动创建,不会自动生成。
二、为什么需要索引:从磁盘 IO 说起
2.1 磁盘 IO 的代价
外存(硬盘)是硬件设备,读写数据时需要移动磁头到目标磁道、等待目标扇区旋转到磁头下,这个机械运动的时间开销远大于内存访问。一次随机磁盘 IO 通常需要毫秒级,而内存访问是纳秒级,差距可达百万倍。
因此,减少磁盘 IO 次数是数据库性能优化的核心目标之一。索引的意义就在于:通过 B+ 树结构,用很少的几次 IO 就能定位到目标数据,避免全表扫描带来的大量随机 IO。
2.2 InnoDB 的页(Page)与操作系统块
- 操作系统块(block) :操作系统与磁盘交互的最小单位,通常为 4KB。
- InnoDB 页(Page) :InnoDB 存储引擎与磁盘交互的最小 IO 单位,默认大小为 16KB。
所以:1 个 InnoDB 页 = 4 个操作系统块(4 × 4KB = 16KB)。
为什么 InnoDB 一次读 16KB 而不是只读需要的那几字节?因为磁盘 IO 最耗时的是磁头寻道和旋转延迟,而不是数据传输本身。既然已经花了寻道时间,把附近的数据一起读进内存(局部性原理),很可能下次查询就能直接命中内存,避免再次 IO。这就是"预读"思想。
2.3 Buffer Pool:服务端的内存缓冲
MySQL 服务端(mysqld)会向操作系统申请一块较大的内存区域,称为 Buffer Pool(缓冲池),用于缓存从磁盘加载的数据页和索引页。
- 查询数据时,先在 Buffer Pool 中找,命中则直接返回(内存访问,极快);
- 未命中则从磁盘读取对应页,加载到 Buffer Pool 后再返回;
- 修改数据时,先修改 Buffer Pool 中的页(脏页),再由后台线程异步刷回磁盘。
Buffer Pool 是 MySQL 服务端(mysqld) 的内存,不是客户端的。undo log 也存储在服务端。
2.4 无索引查询的性能测试
创建一张无索引的测试表,插入 800 万行数据:
CREATE TABLE `test_no_index` (
  `id` int NOT NULL COMMENT '用户ID',
  `name` varchar(50) NOT NULL COMMENT '用户名',
  `email` varchar(100) NOT NULL COMMENT '邮箱',
  `age` tinyint unsigned NOT NULL COMMENT '年龄',
  `status` tinyint unsigned NOT NULL DEFAULT '0' COMMENT '状态',
  `create_time` datetime NOT NULL COMMENT '创建时间',
  `remark` varchar(200) DEFAULT NULL COMMENT '备注'
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='无索引性能测试表';
通过存储过程批量插入 800 万行数据后,执行无索引查询:
SELECT * FROM test_no_index WHERE id = 593728;多次测试平均耗时约 6.96 秒。因为没有索引,MySQL 只能从第一行开始逐行扫描,直到找到 id=593728 的那一行------800 万行数据需要扫描大量数据页,产生大量磁盘 IO。
2.5 添加索引后的性能对比
ALTER TABLE test_no_index ADD INDEX idx_id (id);执行这条语句时会"卡住"几秒------这是因为 MySQL 正在扫描全表 800 万行数据,按 id 排序,构建一棵 B+ 树索引。表越大,建索引越慢。
索引建好后再次查询:
SELECT * FROM test_no_index WHERE id = 593728;耗时从 6.96 秒降到毫秒级,性能提升了上千倍。这就是索引的威力。
三、InnoDB 数据页的内部结构
3.1 页的整体结构
一个 16KB 的 InnoDB 数据页,内部结构如下:
| 区域 | 大小 | 作用 |
|---|---|---|
| File Header(文件头) | 38 字节 | 页的通用信息:页号、上一页/下一页指针、页类型等 |
| Page Header(页头) | 56 字节 | 数据页专属信息:记录数、页目录槽数、第一个记录偏移等 |
| Infimum + Supremum | 26 字节 | 虚拟记录:Infimum 是页内最小记录,Supremum 是页内最大记录,用于链表边界 |
| User Records(用户记录) | 动态 | 实际存储的行数据 |
| Free Space(空闲空间) | 动态 | 页内未使用的空间,用于插入新记录 |
| Page Directory(页目录) | 动态 | 槽(slot)数组,用于加速页内查找 |
| File Trailer(文件尾) | 8 字节 | 校验页的完整性,检测磁盘损坏 |
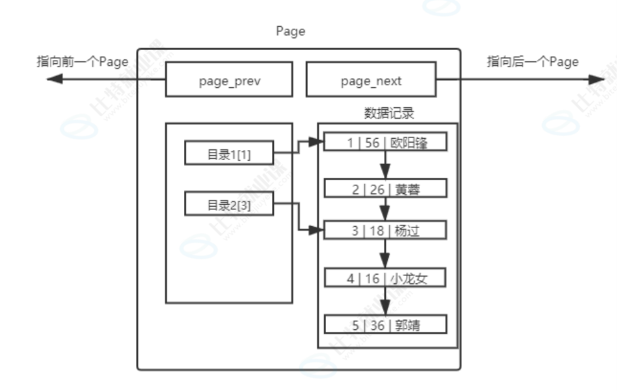 3.2 页与页之间:双向链表
File Header 中有两个关键字段:
FIL_PAGE_PREV:上一页的页号FIL_PAGE_NEXT:下一页的页号
通过这两个指针,所有数据页形成一个双向链表。
3.3 页内记录:单向链表 + 页目录
页内的每一行记录,在记录头中有一个 next_record 指针,指向下一条记录的位置,所有记录形成一个单向链表,按主键从小到大排序。
但如果只靠链表遍历,页内查找还是 O(n)。因此 InnoDB 还有 Page Directory(页目录):
- 页目录由多个**槽(slot)**组成,每个槽记录一条记录的偏移量;
- 每个槽对应 4~8 条记录;
- 查找时,先对页目录进行二分查找,定位到目标记录所在的槽,再在槽内沿链表遍历少量记录即可找到目标。
这样页内查找也达到了 O(log n) 的效率。
3.4 无索引时的插入与查找
- 插入:新记录直接追加到页的 User Records 区域尾部(或 Free Space 中),不需要排序,页满了就分配新页继续尾插。
- 查找:只能从链表头部开始逐行遍历,直到找到目标------全表扫描。
3.5 有索引时的插入与查找
以 id 建立主键索引为例:
- 插入 :新记录必须按 id 大小有序插入 到链表的正确位置。比如已有 id=1,2,3,4,5,插入 id=0 时,需要在 id=1 前面插入这条记录,而不是尾插。如果页内空间不足,还会触发页分裂------将当前页的一半记录分到新页中,保持 B+ 树平衡。
- 查找:通过 B+ 树多级页目录快速定位到目标页,再在页内通过页目录二分查找定位到槽,最后少量遍历找到记录------全程 O(log n)。
四、B+ 树索引结构
4.1 为什么不用其他数据结构
| 数据结构 | 查找效率 | 问题 |
|---|---|---|
| 链表 | O(n) | 线性遍历,数据量大时极慢 |
| 二叉搜索树 | O(log n) 平均,O(n) 最坏 | 可能退化成链表(比如按顺序插入 1,2,3,4,5) |
| AVL 树 / 红黑树 | O(log n) | 虽然是平衡树,但毕竟是二叉结构,每个节点最多 2 个子节点,数据量大时树很高,意味着需要多次磁盘 IO |
| Hash 表 | O(1) 平均 | 不支持范围查询(>、<、BETWEEN、ORDER BY),存在哈希冲突 |
结论:需要一种多阶、平衡、支持范围查询的树结构------这就是 B+ 树。
4.2 B 树 vs B+ 树
B 树和 B+ 树都是多阶平衡树,但 B+ 树做了关键优化:
| 对比项 | B 树 | B+ 树 |
|---|---|---|
| 非叶子节点是否存数据 | ✅ 存(索引键 + 数据) | ❌ 只存索引键和指针,不存数据 |
| 叶子节点是否存所有数据 | 部分数据在非叶子节点 | ✅ 所有数据都在叶子节点 |
| 叶子节点是否链表连接 | ❌ 否 | ✅ 双向链表连接 |
| 单节点能存的指针数 | 较少(因为要存数据) | 较多(只存键和指针,空间利用率高) |
| 树高 | 较高 | 更矮 → IO 次数更少 |
| 范围查询 | 需要中序遍历,多次 IO | 叶子节点链表直接顺序扫描,效率高 |
B+ 树的两大核心优势:
- 非叶子节点不存数据,同样 16KB 的页能存更多索引键和指针,树更矮,查找时 IO 次数更少;
- 叶子节点双向链表 ,范围查询(如
WHERE id BETWEEN 100 AND 200)只需找到起点,沿链表顺序扫描即可,效率极高。
4.3 B+ 树的多级页目录
B+ 树本质上是一个多级页目录结构:
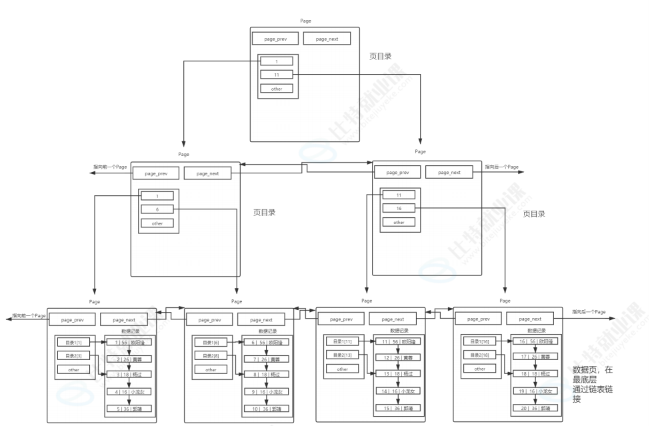
- 根节点:最顶层的页,存储索引键和指向子页的指针;
- 内部节点:中间层的页,同样存储索引键和指针;
- 叶子节点:最底层的页,存储完整数据(聚簇索引)或主键值(二级索引),叶子节点之间通过双向链表连接。
以 16KB 页、索引键+指针约 12 字节估算,一个非叶子页大约能存 1000+ 个指针。一棵 3 层的 B+ 树就能管理约 1000 × 1000 × 100 = 1亿 行数据------也就是说,查找任意一行数据最多只需要 3 次磁盘 IO。
4.4 B+ 树的查找过程
以查找 id = 593728 为例:
- 从根页开始,比较 id 与根页中的索引键,确定目标在哪个子页;
- 加载对应的内部节点页,继续比较,确定下一层子页;
- 加载叶子节点页,在页内通过页目录二分查找 + 链表遍历找到目标记录;
- 整个过程通常只需 2~3 次磁盘 IO。
五、聚簇索引与非聚簇索引
5.1 聚簇索引(主键索引)
聚簇索引 :索引的叶子节点直接存储完整的行数据。数据和索引"聚"在一起,找到索引就找到了数据。
- InnoDB 中,主键索引就是聚簇索引;
- 一张表有且只有一个聚簇索引;
- 如果表没有定义主键,InnoDB 会选择第一个唯一非空索引作为聚簇索引;
- 如果两者都没有,InnoDB 会自动生成一个隐藏的 6 字节
DB_ROW_ID作为聚簇索引。
5.2 非聚簇索引(二级索引)
非聚簇索引 (也叫二级索引、辅助索引):索引的叶子节点存储的是主键值,而不是完整行数据。
- 普通索引、唯一索引都属于非聚簇索引;
- 一张表可以有多个非聚簇索引;
- 叶子节点存主键值,需要通过主键值再回到聚簇索引中查找完整数据------这个过程叫回表。
5.3 回表查询
以 name 字段建立普通索引为例,查询 SELECT * FROM user WHERE name = '张三':
第一步:在 name 的二级索引 B+ 树中查找 '张三'
        → 找到叶子节点,得到对应的主键 id = 100

第二步:用 id = 100 回到主键聚簇索引的 B+ 树中查找
→ 找到叶子节点,得到完整行数据这个"先查二级索引得到主键,再查主键索引得到数据"的过程,就是回表。回表需要多走一棵 B+ 树,多几次 IO。
5.4 覆盖索引
如果查询的所有字段都包含在二级索引中,就不需要回表了,直接从二级索引返回数据------这叫覆盖索引。
-- name 有索引,查询只需要 name 字段,不需要回表
SELECT name FROM user WHERE name = '张三';

-- 如果查询需要 email,而 email 不在 name 索引中,就需要回表
SELECT name, email FROM user WHERE name = '张三';覆盖索引是重要的性能优化手段------EXPLAIN 结果中 Extra 列显示 Using index 就表示使用了覆盖索引。
5.5 InnoDB vs MyISAM
| 对比项 | InnoDB | MyISAM |
|---|---|---|
| 主键索引 | 聚簇索引(叶子存完整数据) | 非聚簇索引(叶子存数据的物理地址) |
| 二级索引 | 非聚簇索引(叶子存主键值,需回表) | 非聚簇索引(叶子存数据物理地址) |
| 事务 | ✅ 支持 | ❌ 不支持 |
| 行锁 | ✅ 支持 | ❌ 仅表锁 |
关于效率的重要认知:
对于InnoDB:
不管聚簇还是非聚簇,查找一条记录时,都是从根到叶子加载 2~3 个页。每个页都是 16KB,占用的 Buffer Pool 空间一样。
实际上:
- 聚簇索引 查找完整数据时,找到索引就找到了数据,不需要回表,一次 IO 链路就能拿到完整行;
- 非聚簇索引 查找完整数据时,必须先查二级索引得到主键,再回表查聚簇索引,多走一棵 B+ 树,多几次 IO;
- 非聚簇索引的优势在于索引体积小(只存主键值),但查询完整数据的效率不如聚簇索引。
当然,如果查询字段刚好被二级索引覆盖(覆盖索引),不需要回表,那非聚簇索引也很快。
造成效率的点在于回表
对于MYISAM:
因为索引都是非聚簇索引,所以不存在回表的问题,但是查找到对应的地址后,需要额外的一次IO
六、索引的分类
6.1 主键索引
- 建表时通过
PRIMARY KEY定义; - 自动创建,一张表只能有一个;
- InnoDB 中是聚簇索引,叶子存完整数据;
- 非空且唯一。
6.2 唯一索引
- 建表时通过
UNIQUE定义,或后续添加; - 自动创建,一张表可以有多个;
- 属于非聚簇索引(二级索引),叶子存主键值;
- 值唯一,但允许为 NULL(可多个 NULL)。
6.3 普通索引
- 最基本的索引类型,没有唯一性限制;
- 属于非聚簇索引;
- 用于加速普通字段的查询。
6.4 复合索引(联合索引)
复合索引 是基于多个字段建立的索引,如 INDEX idx_name_age (name, age)。
最左前缀原则(核心考点)
复合索引按字段顺序从左到右排序。查询时,必须从最左列开始匹配,才能利用索引;遇到范围查询后,后面的列无法继续使用索引。
以复合索引 (a, b, c) 为例:
| 查询条件 | 是否使用索引 | 使用了哪些列 |
|---|---|---|
WHERE a = 1 |
✅ | a |
WHERE a = 1 AND b = 2 |
✅ | a, b |
WHERE a = 1 AND b = 2 AND c = 3 |
✅ | a, b, c |
WHERE b = 2 |
❌ | 无(跳过了最左列 a) |
WHERE b = 2 AND c = 3 |
❌ | 无(跳过了最左列 a) |
WHERE a = 1 AND c = 3 |
⚠️ 部分 | 只用了 a,c 无法用索引(跳过了 b) |
WHERE a = 1 AND b > 2 AND c = 3 |
⚠️ 部分 | 用了 a, b,c 无法用(b 是范围查询,后面的列失效) |
WHERE a LIKE '张%' AND b = 2 |
⚠️ 部分 | 用了 a(前缀匹配),b 可用 |
WHERE a LIKE '%张' AND b = 2 |
❌ | 无(a 以 % 开头,索引失效) |
记忆口诀:最左前缀不能丢,中间不能断,范围之后全失效。
6.5 前缀索引
对于字符串类型的字段,如果字段值较长,可以只对字段的前 N 个字符建立索引,减少索引体积:
-- 对 email 的前 20 个字符建立索引
CREATE INDEX idx_email ON user (email(20));- 优点:索引体积小,查询快;
- 缺点:无法用于覆盖索引,无法用于 ORDER BY 和 GROUP BY;
- 适用场景:字段值前几个字符区分度就很高的场景。
6.6 全文索引
全文索引(FULLTEXT)用于全文检索,支持自然语言搜索和布尔搜索,适用于文章内容、商品描述等大文本字段的关键词搜索:
CREATE FULLTEXT INDEX idx_content ON article (content);

-- 全文检索
SELECT * FROM article WHERE MATCH(content) AGAINST('MySQL 索引');
七、索引的创建与管理
7.1 创建索引
方式一:建表时创建
CREATE TABLE user (
    id INT PRIMARY KEY,              -- 主键索引
    name VARCHAR(50) NOT NULL,
    email VARCHAR(100),
    age INT,
    UNIQUE KEY uk_email (email),     -- 唯一索引
    INDEX idx_name (name),           -- 普通索引
    INDEX idx_name_age (name, age)   -- 复合索引
) ENGINE=InnoDB;
方式二:建表后添加
-- 普通索引
ALTER TABLE table_name ADD INDEX index_name (column, ...);
-- 或
CREATE INDEX index_name ON table_name (column, ...);

-- 唯一索引
ALTER TABLE table_name ADD UNIQUE INDEX index_name (column);
-- 或
CREATE UNIQUE INDEX index_name ON table_name (column);

-- 复合索引
ALTER TABLE table_name ADD INDEX idx_name_age (name, age);
索引命名规则:如果不指定索引名,普通索引默认和字段同名;复合索引默认取第一个字段的名字。建议显式指定有意义的索引名,便于管理。
7.2 查看索引
SHOW INDEX FROM table_name;输出关键字段说明:
| 字段 | 含义 |
|---|---|
| Table | 表名 |
| Key_name | 索引名 |
| Seq_in_index | 字段在索引中的序号(从1开始) |
| Column_name | 字段名 |
| Non_unique | 是否非唯一(0=唯一,1=非唯一) |
| Index_type | 索引类型(BTREE / FULLTEXT / HASH) |
| Cardinality | 基数(索引中不同值的数量估算,越大选择性越好) |
7.3 删除索引
ALTER TABLE table_name DROP INDEX index_name;
-- 或
DROP INDEX index_name ON table_name;
⚠️ 注意:删除索引时用的是索引名(index_name),不是字段名!复合索引必须用索引名删除。
7.4 重命名索引
ALTER TABLE table_name RENAME INDEX old_index_name TO new_index_name;八、索引的优缺点与使用原则
8.1 索引的优点
- 加速查询:将全表扫描 O(n) 降为 B+ 树查找 O(log n);
- 加速排序和分组:如果 ORDER BY / GROUP BY 的字段有索引,可以利用索引的有序性,避免额外排序;
- 保证唯一性:唯一索引保证字段值不重复;
- 加速表连接:连接字段有索引时,多表连接效率大幅提升。
8.2 索引的缺点
- 占用存储空间:每个索引都是一棵 B+ 树,需要额外的磁盘空间;
- 降低写性能:INSERT/UPDATE/DELETE 时,除了修改数据,还要维护所有相关索引的 B+ 树结构,可能触发页分裂;
- 索引过多时优化器选择困难:可能选错索引,反而降低查询效率。
innodb:聚簇索引先当于直接对数据库进行修改;非聚簇索引相当于在数据库文件内部增加了一个B+Tree
InnoDB 在文件内部用段(segment)→ 区(extent)→ 页(page) 的层级来管理空间:
- 聚簇索引有自己的段(存放数据页)
- 每个非聚簇索引各有自己的段(存放索引页)
- 所有段都在同一个
.ibd文件内,通过段号区分
myisam:
MySQL8.0之后只有两个文件:一个 .MYD(数据库文件),一个.MYI(索引)
因此每创建一个索引,就会索引文件中增加一棵树
8.3 索引失效的常见场景
以下情况会导致索引失效,退化为全表扫描:
| 场景 | 示例 | 原因 |
|---|---|---|
| 对索引列使用函数/表达式 | WHERE YEAR(create_time) = 2024 |
函数运算后索引值不连续,无法用 B+ 树查找 |
| 隐式类型转换 | WHERE varchar_col = 123(字符串列和数字比较) |
MySQL 会对列做隐式转换,相当于函数运算 |
| LIKE 以 % 开头 | WHERE name LIKE '%张' |
前缀不确定,无法利用索引的有序性 |
| OR 连接非索引列 | WHERE name = '张三' OR age = 20(age 无索引) |
为了找到 age 匹配的行,必须全表扫描 |
| 不符合最左前缀 | 复合索引 (a,b),查询 WHERE b = 2 |
跳过了最左列 a |
| 使用 != / <> / NOT IN | WHERE status != 0 |
不一定失效,取决于数据分布和优化器选择,但范围大时优化器可能选择全表扫描 |
| 索引列参与算术运算 | WHERE id + 1 = 100 |
相当于对列做了函数运算 |
8.4 索引设计原则
- 出现在 WHERE、JOIN、ORDER BY、GROUP BY 中的字段优先建索引;
- 区分度(基数)高的字段适合建索引:比如手机号、邮箱,而性别(只有男/女)区分度太低,建索引效果差;
- 字符串字段优先考虑前缀索引,减少索引体积;
- 复合索引遵循最左前缀原则,把最常用作查询条件的字段放最左边;
- 控制索引数量:一张表建议不超过 5~6 个索引,避免写性能下降;
- 避免在频繁更新的列上建过多索引,更新时维护索引开销大;
- 用 EXPLAIN 分析执行计划,确认索引是否被正确使用。