一、问题现象
线上有一个数据处理服务,运行一段时间后会突然卡死。
表现很诡异:
- 进程还活着,没有崩溃,没有 coredump
- CPU 占用率很高,但就是不处理数据
- 上游数据持续发过来,但下游再也收不到处理结果
- 重启服务后恢复正常,但运行几小时后又会卡死,反复出现
一开始怀疑是网络问题、上游发送异常、下游消费阻塞,排查了一圈都不对。服务本身也没有报错日志,就像陷入了某种"活锁"状态------CPU 在转,但什么有用的事都没干。
二、排查过程
2.1 gdb attach 看线程
既然进程还活着,直接用 gdb attach 上去看线程堆栈:
bash
    gdb -p <pid>
    (gdb) thread apply all bt
输出结果很有规律:
text
    Thread 25 (LWP 2514677):
    #0  0x00007f62e2f057c5 in pthread_mutex_lock () from /lib64/libpthread.so.0
    #1  0x0000000000479a4b in IceUtil::Mutex::lock() const ()
    #2  ...(业务代码,等待锁)

    Thread 26 (LWP 2514678):
    #0  0x00007f62e2f057c5 in pthread_mutex_lock () from /lib64/libpthread.so.0
    #1  0x0000000000479a4b in IceUtil::Mutex::lock() const ()
    #2  ...(业务代码,等待锁)

    ...(N 个线程都在等同一把锁)
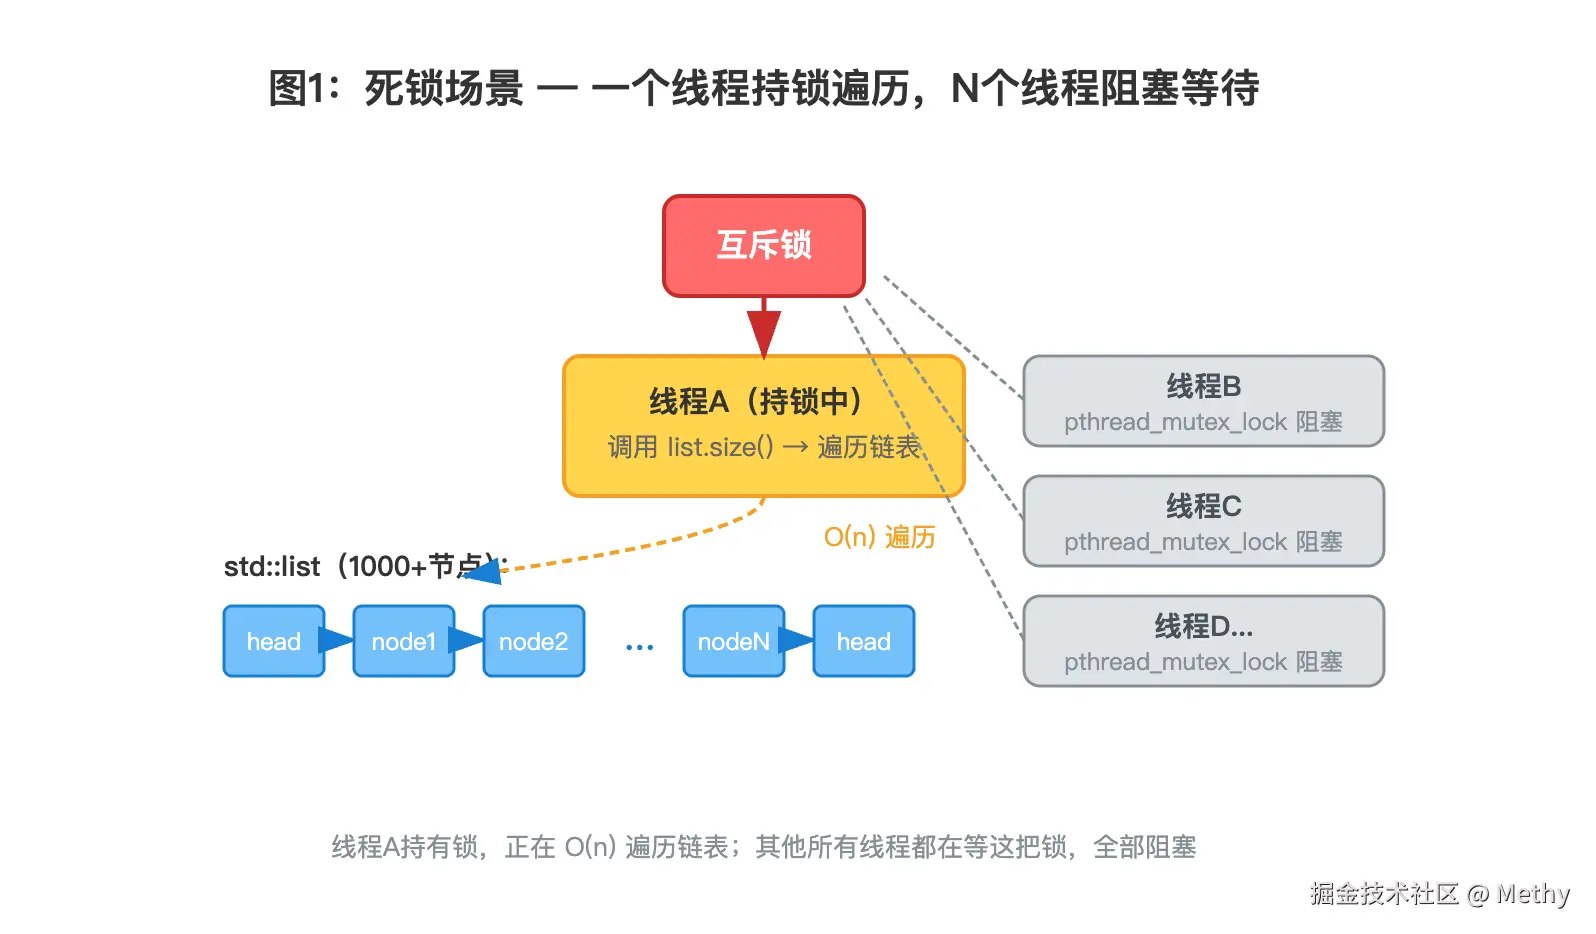
大部分线程都卡在 pthread_mutex_lock,等待同一把互斥锁。只有一个线程在"干活",看看它在干嘛:
text
    Thread 12 (LWP 2514664):
    #0  0x00000000004a1813 in std::__detail::_List_node_base::_M_hook()
    #1  0x00000000004a2xxx in std::list<...>::size() const
    #2  0x00000000004bxxxx in CDataManager::addTask()
    #3  ...
这个线程持有着锁,正在调用 std::list::size()。
等等,size() 不应该是 O(1) 的吗?怎么会在里面调 _M_hook 这种链表操作?
2.2 看代码定位
找到业务代码中调用 size() 的地方:
cpp
    void CDataManager::addTask(const Task& task) {
        IceUtil::Mutex::Lock lock(m_mutex);  // 加锁

        // 判断队列长度,超过阈值打日志
        if (m_taskList.size() > 100) {  // ← 这里调用了 size()
            LOG_WARN("queue high, size=%d", m_taskList.size());  // ← 又调了一次
        }

        m_taskList.push_back(task);

        // 其他地方还有两次 size() 调用...
    }
这个 m_taskList 是一个 std::list<Task>,存的是待处理的数据任务。高峰期队列里能攒几百上千条数据。
每次有新数据进来,都会在锁内调用 size() 判断队列长度。而且代码里同一把锁内调用了 4 次 size() 。
如果 size() 是 O(1),那没问题。但如果是 O(n),在锁内遍历上千个节点,其他线程就全部阻塞了。
2.3 汇编实锤
光看堆栈还不够,直接 disassemble 看 size() 的汇编实现:
asm
    (gdb) disassemble std::list<Task>::size
    Dump of assembler code for function std::list<Task>::size():
       0x00000000004a2xxx <+0>:     push   %rbp
       0x00000000004a2xxx <+1>:     mov    %rsp,%rbp
       0x00000000004a2xxx <+8>:     mov    %rdi,-0x8(%rbp)
       0x00000000004a2xxx <+12>:    mov    -0x8(%rbp),%rax
       0x00000000004a2xxx <+19>:    mov    0x10(%rax),%rax      # 取链表头节点
       0x00000000004a2xxx <+23>:    mov    $0x0,%ecx             # 计数器清零
       0x00000000004a2xxx <+28>:    jmp    0x4a2xxx <size()+40>  # 跳到循环判断
       0x00000000004a2xxx <+30>:    add    $0x1,%rcx             # 计数器+1
       0x00000000004a2xxx <+34>:    mov    0x8(%rax),%rax        # 指向下一个节点
       0x00000000004a2xxx <+40>:    lea    0x10(%rdi),%rdx       # 头节点地址
       0x00000000004a2xxx <+47>:    cmp    %rdx,%rax             # 判断是否回到头节点
       0x00000000004a2xxx <+50>:    jne    0x4a2xxx <size()+30>  # 没到就继续循环
       0x00000000004a2xxx <+52>:    mov    %rcx,%rax             # 返回计数器
       0x00000000004a2xxx <+55>:    pop    %rbp
0x00000000004a2xxx <+56>: retq实锤了!这是一个遍历链表的循环,从 head 节点开始,一个一个 next 走,直到回到 head,统计节点数。
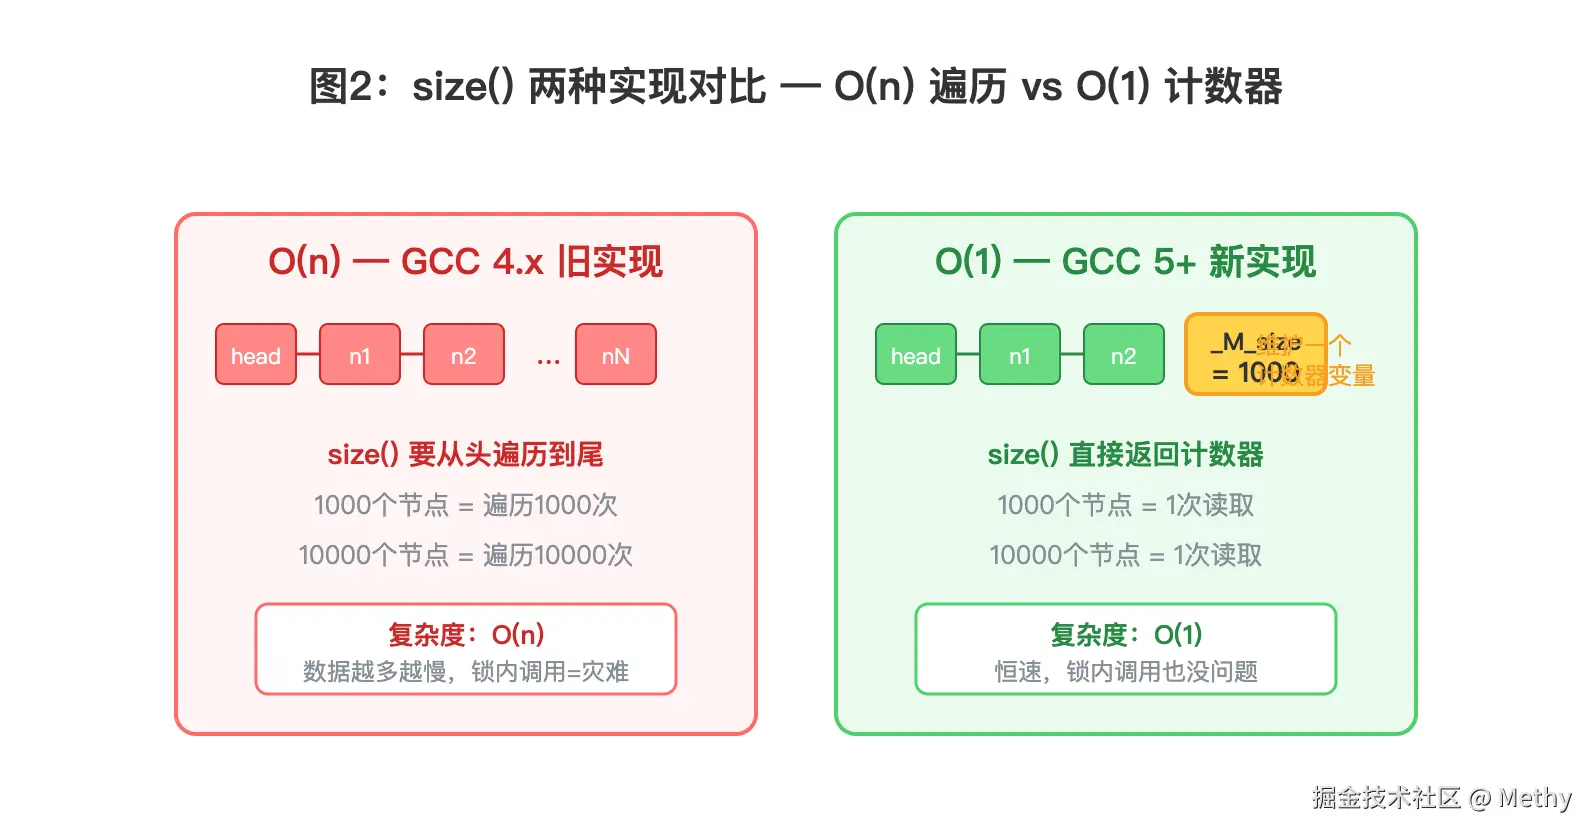
这就是 O(n) 的实现,不是 O(1)。
三、根因分析
3.1 C++ 标准的变化
为什么 size() 会是 O(n)?这就要说到 C++ 标准的变化了:
- C++03 及之前 :标准只规定了
size()的语义,没有规定复杂度。大多数实现选择 O(n),因为维护一个计数器会增加splice()等操作的复杂度 - C++11 标准 :明确要求所有标准库容器的
size()都是 O(1) 复杂度
那为什么线上服务的 size() 还是 O(n)?因为编译器版本太老了。
3.2 GCC 版本的锅
线上服务器用的是 GCC 4.8.5 (2014 年发布),对应的 libstdc++ 中,std::list::size() 仍然是 O(n) 的遍历实现。
GCC 是从 GCC 5 开始才把 std::list::size() 改成 O(1) 的(用一个成员变量 _M_size 维护链表长度)。
也就是说:
- GCC 4.x:
std::list::size()= O(n),遍历整个链表 - GCC 5+:
std::list::size()= O(1),直接返回计数器
C++11 标准说要 O(1),但老版本的 GCC 没遵守,或者说还没来得及改。
3.3 为什么会卡死
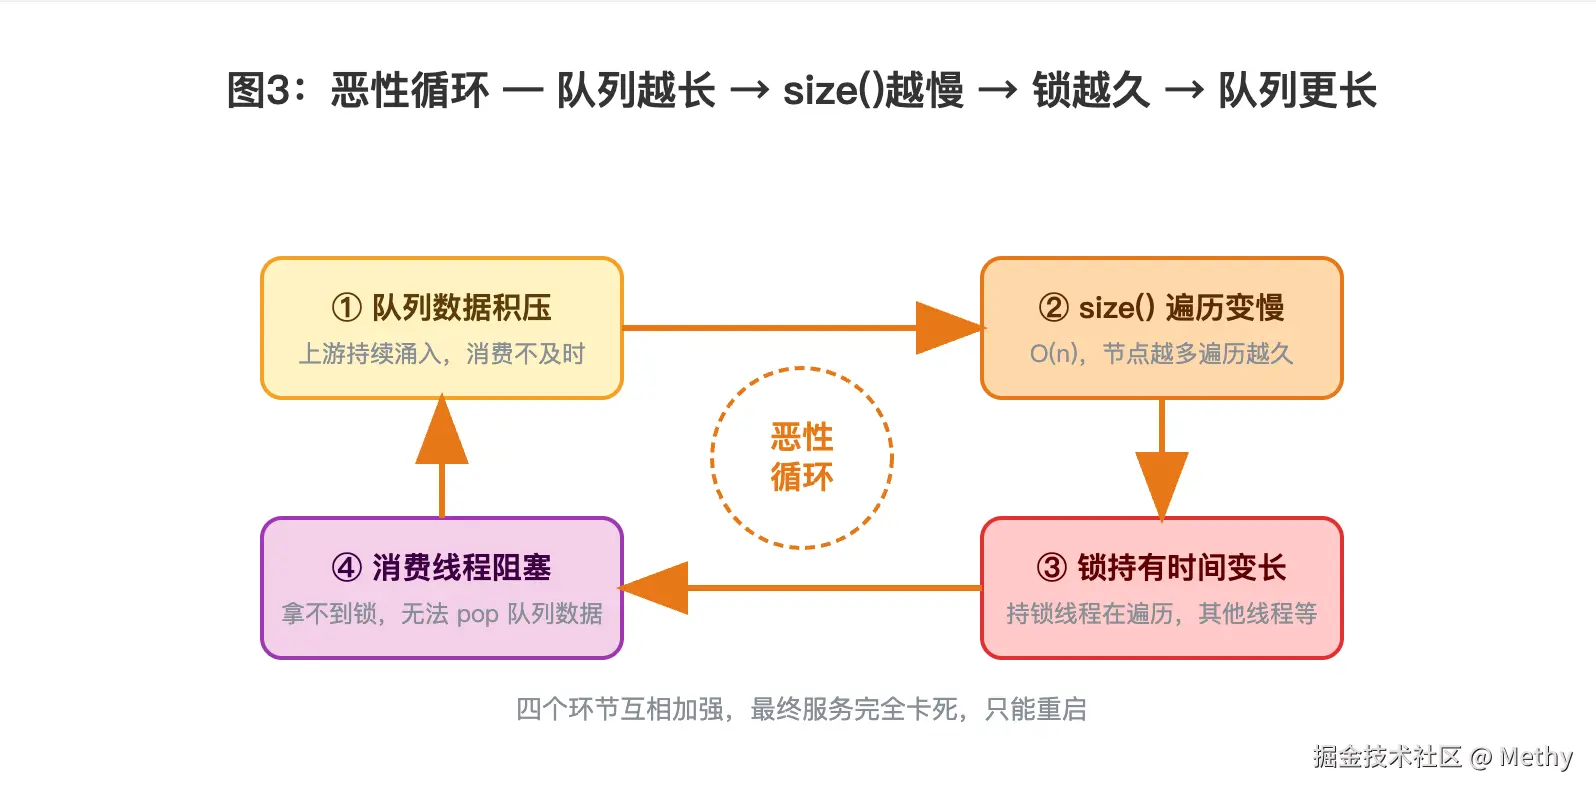
现在整个逻辑就通了:
text
    时间线:
    1. 上游数据持续涌入,addTask() 被高频调用
    2. addTask() 内部加锁,调用 size() 判断队列长度
    3. size() 是 O(n),队列里有 1000 条数据就要遍历 1000 个节点
    4. 遍历期间持有锁,其他调用 addTask() 的线程全部阻塞
    5. 数据处理线程也拿不到锁,无法消费队列
    6. 队列越攒越多 → size() 遍历更慢 → 锁持有时间更长 → 更多线程阻塞
    7. 恶性循环,最终整个服务卡死
而且代码里同一把锁内调用了 4 次 size(),相当于把 O(n) 的开销放大了 4 倍。
四、解决方案
4.1 立即修复:用计数器替代 size()
最直接的修复方式:自己维护一个计数器,不要调用 size()。
cpp
    class CDataManager {
    private:
        std::list<Task> m_taskList;
        std::atomic<int> m_taskCount{0};  // 新增:原子计数器
        IceUtil::Mutex m_mutex;

    public:
        void addTask(const Task& task) {
            IceUtil::Mutex::Lock lock(m_mutex);

            // 用计数器判断,O(1)
            if (m_taskCount.load() > 100) {
                LOG_WARN("queue high, size=%d", m_taskCount.load());
            }

            m_taskList.push_back(task);
            m_taskCount.fetch_add(1);  // push 后计数器+1
        }

        Task popTask() {
            IceUtil::Mutex::Lock lock(m_mutex);
            if (m_taskList.empty()) return Task();
            Task t = m_taskList.front();
            m_taskList.pop_front();
            m_taskCount.fetch_sub(1);  // pop 后计数器-1
            return t;
        }
    };
同时,把锁内不必要的 size() 调用全部去掉,能移到锁外的移到锁外。
4.2 长期方案:升级 GCC 版本
根本解决方案是升级编译器。GCC 4.8.5 太老了,不仅 size() 是 O(n),很多 C++11 特性的实现也不完整,还有一些已知的 bug。
但升级编译器不是小事:
- 需要重新编译所有第三方依赖(Ice、ActiveMQ 等)
- 需要完整的回归测试
- 线上环境可能有其他依赖绑定了老版本 GCC
所以先用计数器方案止血,升级 GCC 作为长期规划。
五、经验教训
- 不要假设标准库的复杂度 ------C++11 说
size()是 O(1),但老版本编译器不一定遵守。用之前最好确认一下,或者直接看汇编。 - 锁内不要做复杂操作------尤其是可能遍历容器的操作。锁内代码越短越好,能移到锁外的移到锁外。
- 判断队列长度用计数器,别用
size()------尤其是高频调用的场景。std::atomic<int>又快又安全。 - 线上编译器版本要关注------GCC 4.8.5 是 2014 年的产品,到现在已经 10 多年了。很多你以为"理所当然"的特性,在老版本上可能根本不是那样。
- 排查死锁要看"谁持有锁" ------大部分线程在等锁不奇怪,奇怪的是持有锁的那个线程在干嘛。找到它,你就找到根因了。
后续可以补充的内容
- gdb 线程堆栈的真实截图
- size() 汇编代码的真实截图
- 修复前后的 CPU/响应时间对比图
- 具体的业务场景描述(脱敏后)
- 其他踩坑细节