要在一套系统里加审批流,第一个绕不过去的问题是:要动多少数据库?
答案决定了这件事的难度。如果每个引擎都要你先建二十张表、跑三个迁移脚本、再请一位懂它内部编码的人来解释每张表在干什么,那这件事在评审会上就永远过不了。我们把这套引擎用八种语言各写了一遍,表结构反而是一个可以当面数清楚的东西:
- 建表 SQL 一共 128 行 ,8 张表 、81 列;
- 其中真正参与流程裁决的是 5 张 (54 列),另外 3 张(27 列)是设计稿台账和委托窗口这类管理能力;
- 表单表 0 张。你的表单数据不建新表,它进的是实例和任务上那一列 JSON。
这一篇把这份账摊开给你:逐列讲清存什么,逐行动讲清谁在什么时候把它写进去,最后给你三条能直接用在评审会上的判断。
一、先把账给了:5 张裁决表、3 张管理表
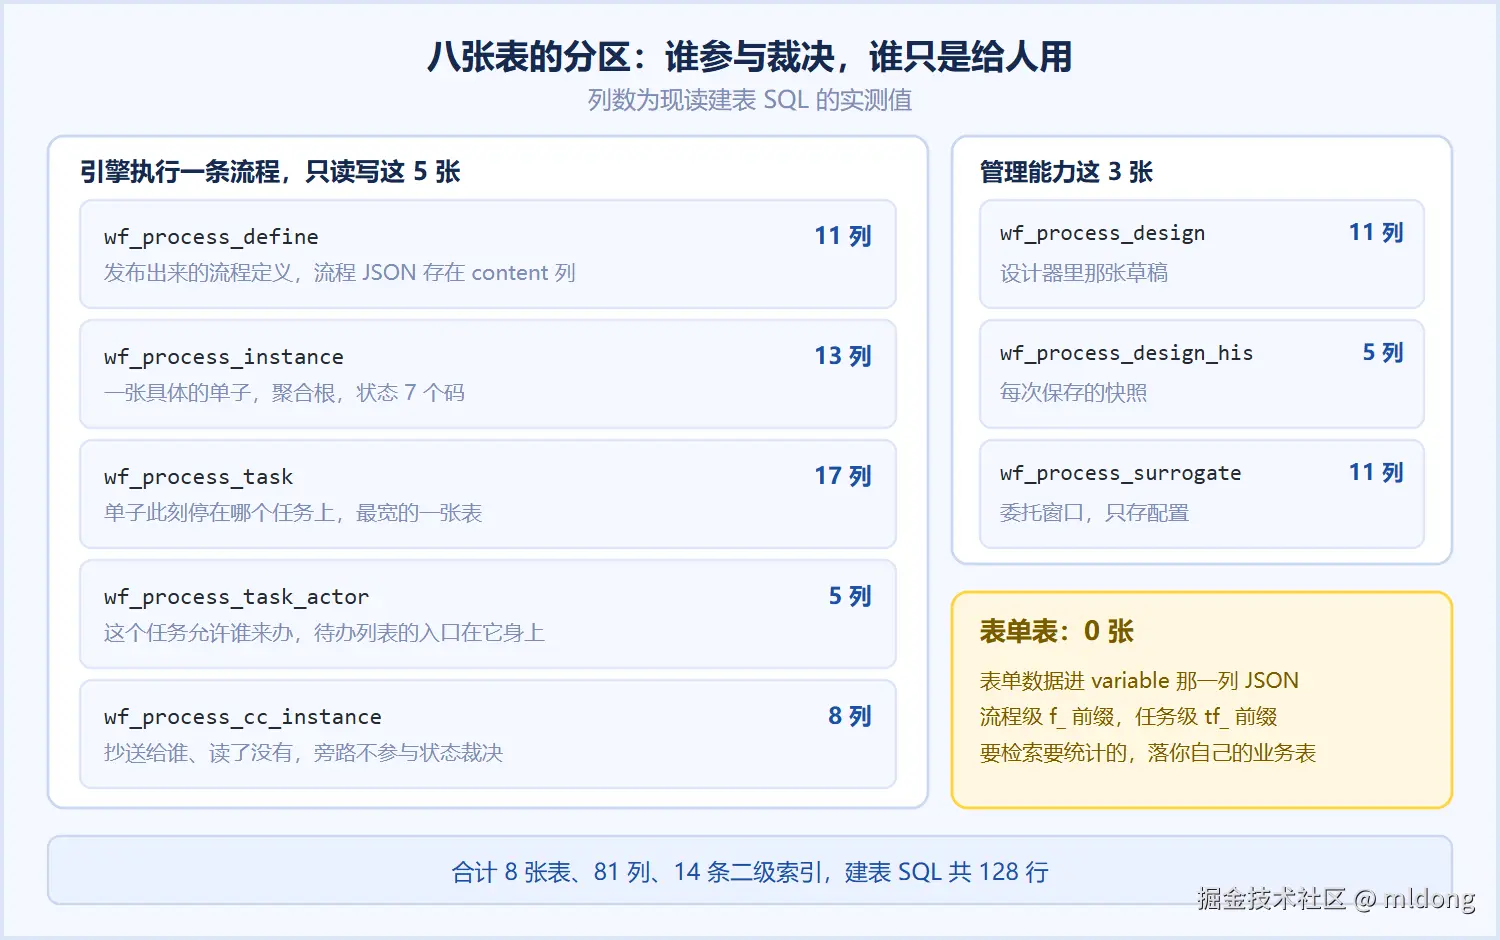
引擎执行一条流程,只在下面这 5 张表上读写:
| 表 | 列数 | 存什么 | 参与状态裁决吗 |
|---|---|---|---|
wf_process_define |
11 | 发布出来的流程定义,含流程 JSON 与版本号 | 只读 |
wf_process_instance |
13 | 一张具体的单子:谁发起的、走哪版定义、什么状态 | 聚合根 |
wf_process_task |
17 | 单子当前停在谁手上的哪一个任务 | 子实体 |
wf_process_task_actor |
5 | 这个任务允许谁来办 | 参与者快照行 |
wf_process_cc_instance |
8 | 抄送给谁、读了没有 | 旁路,不参与裁决 |
另外 3 张是管理能力,引擎核心不依赖它们:
| 表 | 列数 | 存什么 |
|---|---|---|
wf_process_design |
11 | 设计器里那张草稿,以及它发布过没有 |
wf_process_design_his |
5 | 每次保存的草稿快照,供设计器回看历史版本 |
wf_process_surrogate |
11 | 委托窗口:谁在什么时间段把哪类单子交给谁 |
这张分区表就是本篇的第一条判断依据:"要不要建表"和"这张表参与不参与裁决"是两个问题。前 5 张的每一列都要被状态机读到;后 3 张只是给人用的台账,删了不影响在跑的单子。
二、五张核心表逐列过
wf_process_define(11 列):发布产物,不是设计稿
| 列 | 类型 | 干什么 |
|---|---|---|
id |
BIGINT | 主键,应用层生成 |
name |
VARCHAR(64) | 流程编码,唯一,程序按它找流程 |
display_name |
VARCHAR(100) | 给人看的名字 |
type |
VARCHAR(32) | 流程分类,用于列表分组 |
state |
INT | 流程是否可用(1 可用 / 0 不可用) |
content |
BLOB | 流程模型定义本体(设计器画出来的那份 JSON) |
version |
INT | 版本号 |
create_time / create_user / update_time / update_user |
--- | 审计四列 |
索引一条:name。
这里有两个落地时最容易问的点。第一,流程 JSON 直接存在这张表的 content 列里 ,不是文件、不是对象存储,所以备份库就备份了流程定义。第二,version 在这张表上,而实例只记 process_define_id------同一份定义重复发布是原地更新还是新增一行,决定了在跑的单子跟着变还是走旧版,这是接引擎时必须自己拍板的一件事,我们的做法在《改了工作流引擎的流程定义,在跑的审批单有的跟着变、有的不变》里写过,此处不重复。
wf_process_instance(13 列):一张具体的单子
| 列 | 类型 | 干什么 |
|---|---|---|
id |
BIGINT | 主键 |
parent_id |
BIGINT | 父流程实例 ID,只有子流程实例才有值 |
process_define_id |
BIGINT | 走哪一条流程定义 |
state |
INT | 实例状态 |
parent_node_name |
VARCHAR(100) | 挂在父流程的哪个节点上 |
business_no |
VARCHAR(64) | 业务单号,你的报销单号写在这里 |
operator |
VARCHAR(64) | 发起人 |
expire_time |
DATETIME(3) | 期望完成时间,按定义里配的到期表达式算出来写入 |
variable |
TEXT | 流程变量,JSON 字符串 |
| 审计四列 | --- | 同上 |
索引两条:process_define_id、operator。
实例状态全集是 7 个码:10 进行中、20 已完成、30 已撤回(发起人撤回)、40 强行终止(管理员终止)、45 已拒绝、50 挂起、99 已废弃。这 7 个码是契约的一部分,八种语言实现取值一致,别在自己的项目里再造一套------再造一套的代价是所有现成的前端页面、统计口径、报表都要跟着改。
business_no 这一列值得单独说:它是引擎和你的业务之间唯一的挂接位。引擎不知道报销单是多少钱,它只知道自己这张实例挂着哪个业务号。
wf_process_task(17 列):单子此刻停在谁手上
| 列 | 类型 | 干什么 |
|---|---|---|
id |
BIGINT | 主键 |
process_instance_id |
BIGINT | 属于哪张单子 |
task_name |
VARCHAR(100) | 任务节点编码,对应流程图上的节点 id |
display_name |
VARCHAR(100) | 节点显示名 |
task_type |
INT | 0 主办任务 / 1 协办任务 |
perform_type |
INT | 0 普通参与 / 1 会签参与 |
task_state |
INT | 任务状态 |
operator |
VARCHAR(64) | 实际办理人(办完才写) |
finish_time |
DATETIME(3) | 完成时间 |
expire_time |
DATETIME(3) | 任务期望完成时间 |
form_key |
VARCHAR(100) | 这个任务用哪张表单------只是标识,不存数据 |
task_parent_id |
BIGINT | 上一步任务 ID,"退回上一步"按它回 |
variable |
TEXT | 任务变量,JSON 字符串(会签计数在这里) |
| 审计四列 | --- | 同上 |
索引三条:process_instance_id、task_name、operator。
任务状态全集 6 个码:10 进行中、20 已完成、30 已撤回(随实例撤回)、40 强行终止(随实例终止)、50 挂起(随实例挂起)、99 已废弃。最后这个码解释了一件事:驳回或者跳转之后,那些"本来还要办但不用再办"的兄弟任务不是被删掉的,是标成 99 留在表里的------所以你查得到"当时有三个人要会签,两个人没办就被废了"。
task_type 和 perform_type 是两列独立开关:前者管这个人在流程里算主办还是协办,后者管这个任务是单人办还是会签。组合出来的四种形状都成立,别把它们当一列用。
task_parent_id 说明一件反直觉的事:"上一步"不是流程图上的前驱节点,而是这张单子里实际走过的上一条任务行。所以退回落点由数据决定,画了回环的流程也能退回对的地方。
wf_process_task_actor(5 列):最小的表,撑住待办列表
sql
CREATE TABLE IF NOT EXISTS wf_process_task_actor (
  id              BIGINT      NOT NULL COMMENT '主键',
  process_task_id BIGINT      NOT NULL COMMENT '流程任务ID',
  actor_id        VARCHAR(64) NOT NULL COMMENT '参与者ID',
  create_time     DATETIME(3) NULL COMMENT '创建时间',
  create_user     VARCHAR(64) NULL COMMENT '创建用户',
  PRIMARY KEY (id),
  KEY idx_process_task_actor_ptid (process_task_id),
  KEY idx_process_task_actor_aid (actor_id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='流程任务和参与人关系';
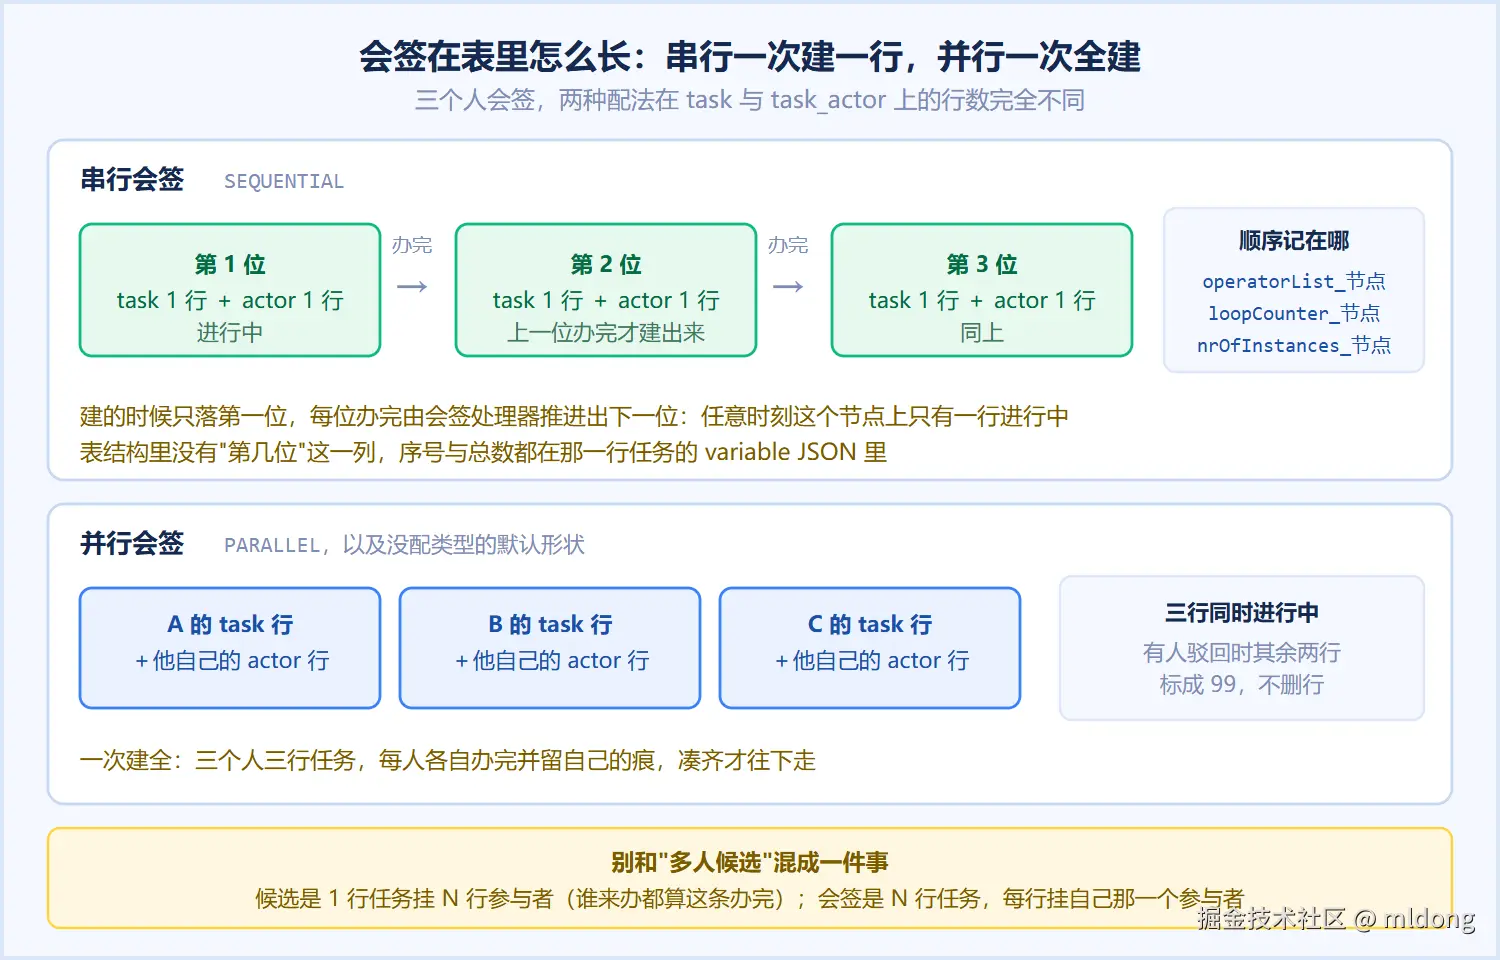
五个列、没有 update 两列,因为它是一行写完就不改的关系行。一个允许的办理人一行:一个节点给三个人候选、谁来办都行时,一条任务对应三行参与者。
这里有个容易混的点值得说清:"多人候选"和"会签"在表里不是一种形状。候选是 1 行任务挂 N 行参与者(谁先办都算这一条任务办完);会签是 N 行任务,每行任务挂自己那一个参与者(三个人就是三行任务加三行参与者),因为每个人都要各自办完并留自己的痕。
这张表解释了为什么 actor_id 是 VARCHAR(64) 而不是 BIGINT:参与者的身份由宿主系统给,可能是用户 ID,也可能是用户名或者工号,引擎不参与这个决定,只按字符串存并按字符串查。
wf_process_cc_instance(8 列):抄送是旁路
| 列 | 类型 | 干什么 |
|---|---|---|
id |
BIGINT | 主键 |
process_instance_id |
BIGINT | 抄送的是哪张单子 |
actor_id |
VARCHAR(64) | 被抄送人 |
state |
INT | 0 未读 / 1 已读,默认 0 |
| 审计四列 | --- | 同上 |
索引两条:process_instance_id、actor_id。
抄送行独立写入,不参与任何状态判断------它不影响流程走不走得下去,只影响红点。把它和参与者混在一张表里是很多实现的第一坑:抄送人一多,"我的待办"就长出根本不需要办的单子。
三、四条通用约定,决定了这张表能不能跨库跨语言用
主键不自增。 八张表的 id 全是 BIGINT NOT NULL,没有 AUTO_INCREMENT------主键由应用层的 ID 生成器给(雪花或等价方案)。这么做的收益很实在:一条流程实例先在 A 库建、再迁到 B 库,ID 不变;分库分表时不用处理自增段冲突;批量导入历史单据时不会出现"同一条单子两个库两个号"。代价是导入外部数据要自己带 ID。
出口一律字符串化。 雪花 ID 是 19 位数字,超过 JavaScript 的 2^53 安全整数上限,浏览器里 JSON 解析一次就把尾数舍了。引擎门面把实例 ID、任务 ID 出口统一转成字符串,前端拿到的就是完整的那一串。这一条不是可选的,任何把 ID 当数字返回的实现都会在某个浏览器上出事。
时间是 DATETIME(3)。 存 UTC 还是存本地时区,八种语言实现按规范归到一个口径(以宿主时钟为准),毫秒精度留给"两个人同一秒内点了同意"这种纠纷------没有毫秒,审批留痕的先后顺序就说不清。
不用逻辑删除。 设计相关表的删除就是物理删除,没有 is_deleted 列。留痕不靠软删标记,靠实例和任务的状态:30 已撤回、40 强行终止、99 已废弃,单子永远在,只是不再往下走。
四、表单数据为什么不建表:扩展位只有那一列 JSON
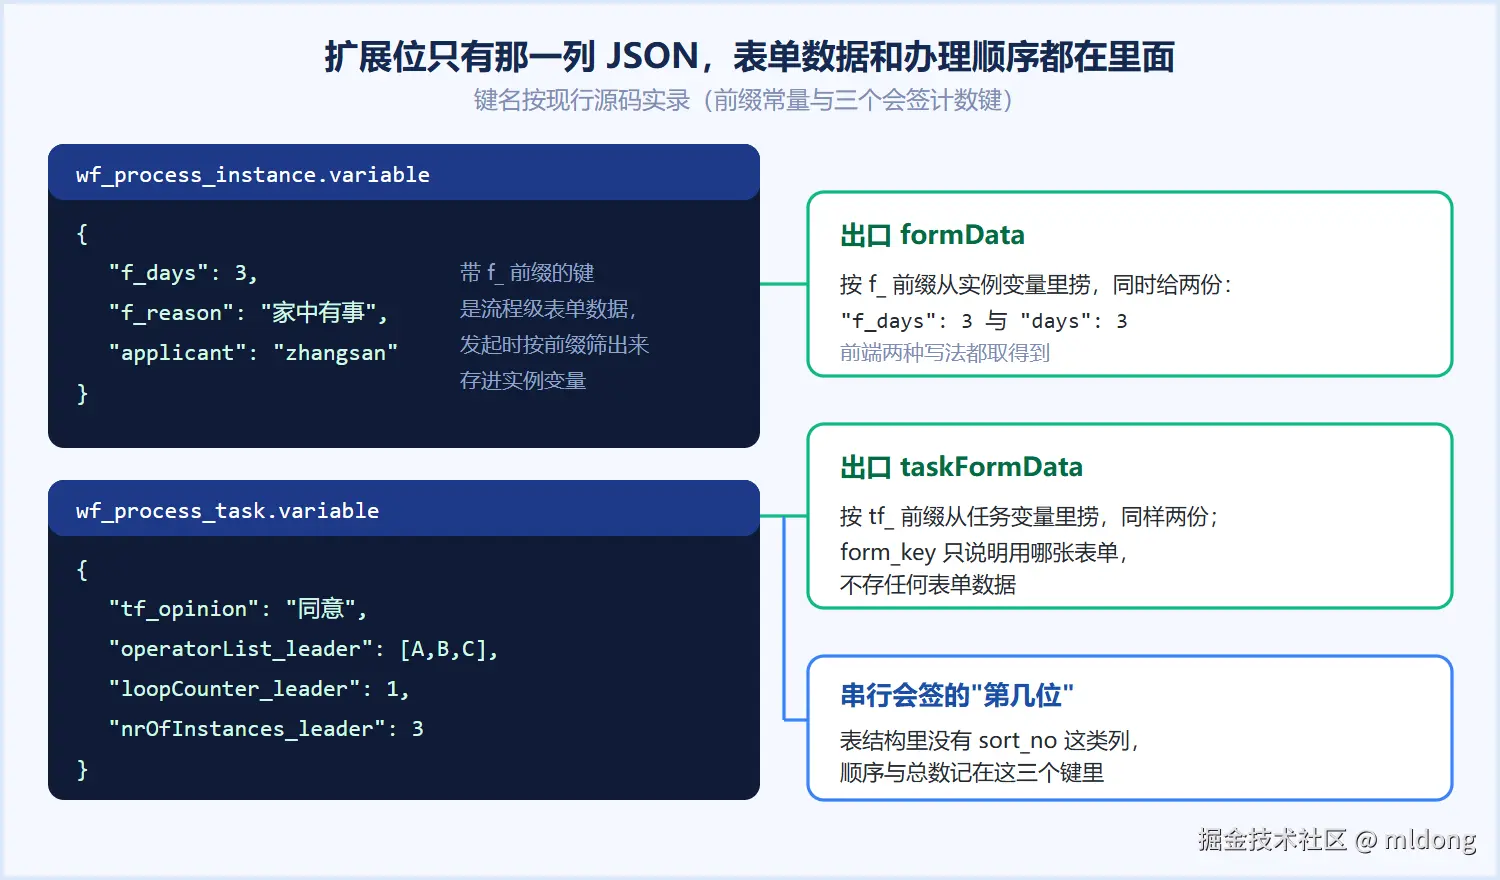
这是本篇标题里那个 0 的来处。审批流系统里"表单"是需求量最大的部分,但它和流程裁决是两件事:引擎要知道的是这一步该谁批、批完往哪走,金额是多少、附件传了没有,引擎不需要按列去查。
我们的做法是把表单数据放进那两列 JSON:
- 实例的
variable里,带f_前缀的键是流程级表单数据; - 任务的
variable里,带tf_前缀的键是任务级表单数据; - 门面出口时按前缀捞出来,派生成
formData和taskFormData两个字段,同时给"带前缀"和"去掉前缀"两份,前端两种写法都能取到。
顺序也存在 JSON 里。以串行会签为例:任务行的 variable 里放 operatorList_{节点}(全量办理人)、loopCounter_{节点}(当前序号)、nrOfInstances_{节点}(总数)三个键,表结构里根本没有"第几位"这一列。串行会签只创建第一位成员的任务行,每位成员办完才推进出下一位,所以任意时刻这个节点上只有一个进行中的会签任务;并行会签才是全员预建。
委托也一样:wf_process_surrogate 存的是配置,生效结果是参与者行 。某个窗口生效时,代理人被并进那个任务的参与者集合,也就是往 wf_process_task_actor 里加一行。所以"我的待办"这个查询不需要 UNION 一张委托表,也不需要 JOIN 窗口时间去判断------判断在任务创建那一刻就做完了。配置表和结果表分清,查询面就干净。
那么表单数据到底该怎么放?给你三条判断:
- 字段要参与流程走向判断 (金额决定走不走总监)------放进
variable,用f_前缀,表达式取的就是它。 - 这张表单就是业务主体 (报销单本身,要能单独查、单独改、单独出报表)------建你自己的业务表,把实例 ID 或
business_no挂在你的表上。别把报销明细塞进 JSON 列,那是拿 JSON 列当明细表用。 - 需要按字段检索或做统计------落业务表并建索引。JSON 列检索要整列解析,数据一多这条路就废了。
第 2 条是大多数团队该选的那条:引擎给的是 8 张表,你给自己的业务加几张表由你的业务决定,这笔账两边不要混。
五、每一行是什么时候被写进去的
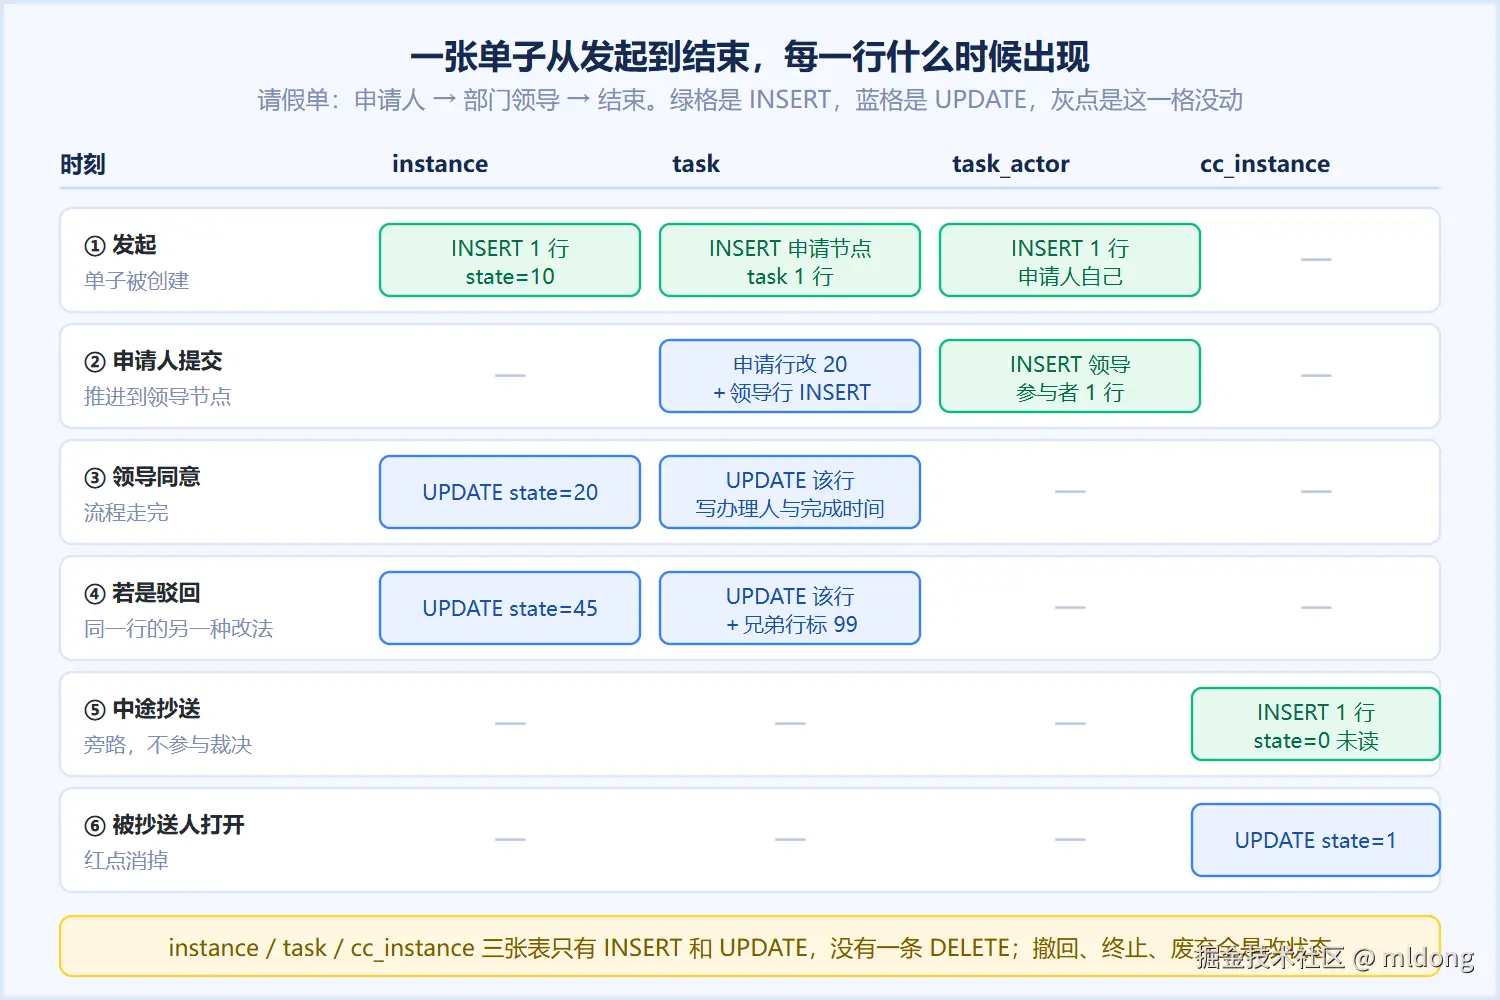
拿最普通的形状走一遍:请假单,申请人 → 部门领导 → 结束。
| 时刻 | 写了哪些行 | 动词 |
|---|---|---|
| 发起 | instance 1 行(state=10)+ 申请节点的 task 1 行 + task_actor 1 行(申请人自己) |
INSERT |
| 申请人提交 | 申请节点 task 行更新为已完成;领导节点 task 新插 1 行 + 参与者 1 行 | UPDATE + INSERT |
| 领导同意 | 领导 task 行更新(写 operator、finish_time、state=20);实例 state 改 20 |
UPDATE |
| 领导驳回 | 领导 task 行更新;实例 state 改 45 | UPDATE |
| 中途抄送 | cc_instance 新插 1 行,state=0 |
INSERT |
| 被抄送人打开 | cc_instance 那行 state 改 1 |
UPDATE |
这里有一条能替你避开一堆问题的性质:流程走完,单子不会被删,行只会变状态 。我们数过仓储层的 SQL 清单:wf_process_instance、wf_process_task、wf_process_cc_instance 三张表只有 INSERT 和 UPDATE,一条 DELETE 都没有。撤回、终止、废弃全是改状态。
而所有"新任务出现"的路径------发起、办理推进、串行会签的每一步、跳转、回退到首节点------收在同一个建任务入口上,仓储层对应的 INSERT 也只有一条。这个"唯一收口"是引擎侧的纪律:八条路径共用一条写语句,跨语言的表行为才不会各写各的。
参与者集合是会变的:换人、加签、移除参与者都会动它,所以 task_actor 上有两处 DELETE,分工不同------一处按任务号清掉这个任务的全部参与者行(整个集合重建时用),一处按 actor_id IN (...) 只删指定那几个人(移除个别参与者时用)。这是三张执行表里唯一允许删的:它删的是"此刻谁该办",不是"发生过什么"。
六、14 条索引就是你的查询面
8 张表一共 14 条二级索引,它们把"这个系统能高效回答哪些问题"划定了:
| 你要查的 | 走哪条索引 | 形状 |
|---|---|---|
| 我的待办 | idx_process_task_actor_aid |
任务表 JOIN 参与者表,条件 task_state = 10 AND actor_id = ? |
| 我办过的 | idx_process_task_operator |
按 operator 查任务,task_state <> 10 |
| 这单走到哪了 | idx_process_task_piid |
按 process_instance_id 取全部任务行 |
| 我发起的单子 | idx_process_instance_operator |
按 operator 查实例 |
| 某定义的所有实例 | idx_process_instance_pfid |
按 process_define_id 查实例 |
| 谁的待办最多(统计) | idx_process_task_actor_aid |
参与者表 JOIN 任务表,按 actor_id 分组计数 |
| 委托是否生效 | idx_process_surrogate_op / _sur |
按授权人或代理人取窗口 |
注意第一行:待办的入口在参与者表,不在任务表 。这就是为什么一张只有 5 列的 task_actor 不能省------待办列表要的是"允许我来办",而不是"我办的",后者是 task.operator,那是已办列表的口径。这两个查询混用是待办列表出现幽灵单子的常见原因。
也请注意另一件事:这份 DDL 里没有 (actor_id, task_state) 这样的复合索引,因为引擎不知道你的数据量。待办表过千万时按你自己的查询补索引,这份 SQL 是起点不是终点。
七、八份一模一样的建表 SQL
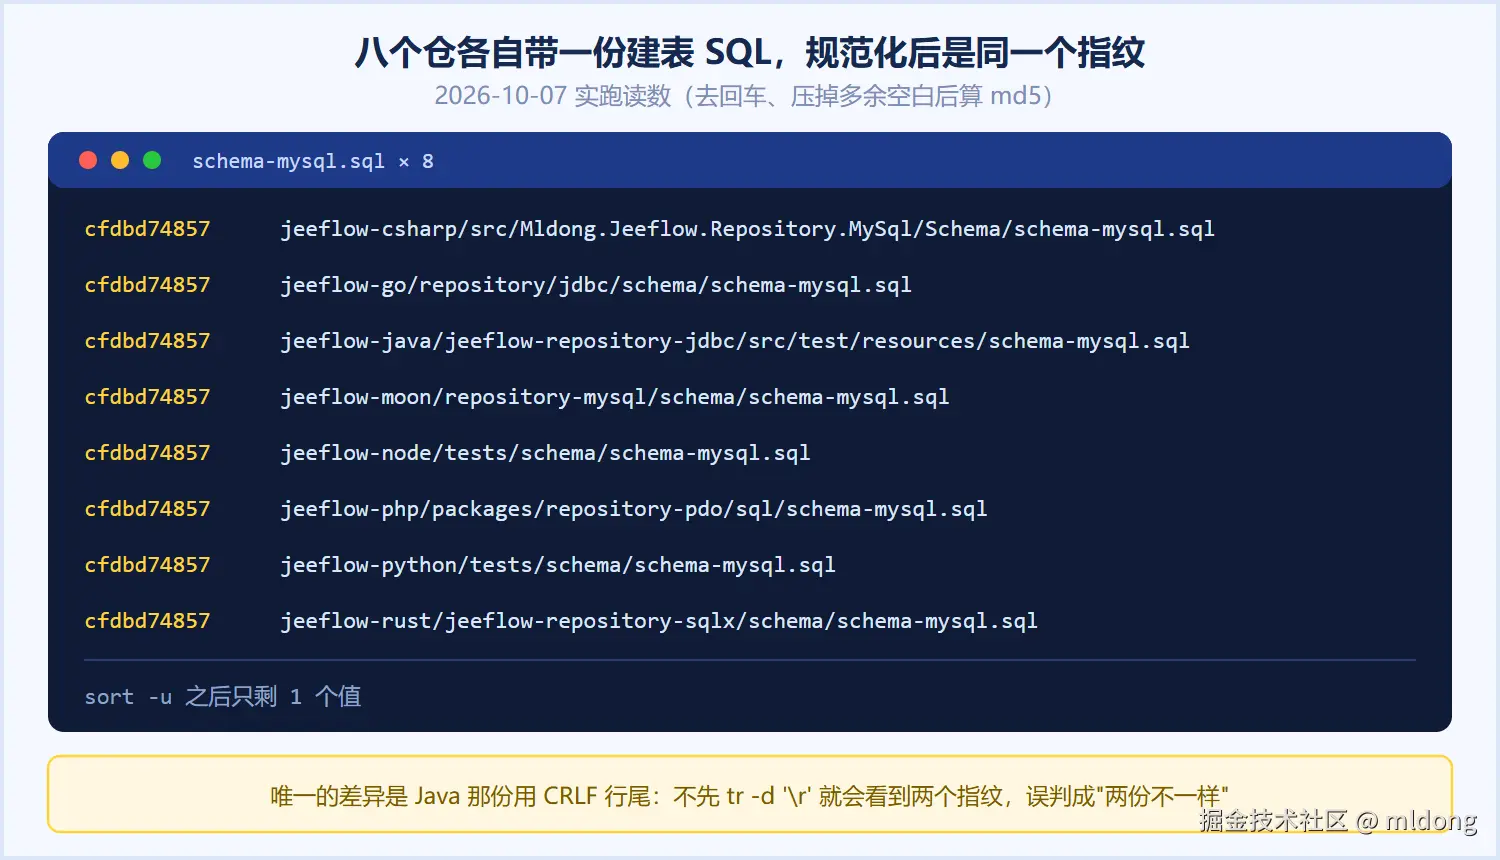
最后说一件很笨但很有用的事。
这套引擎有 Java、Go、Python、Node、PHP、Rust、MoonBit、C# 八个实现,每个仓里都带一份自己的 schema-mysql.sql------放在各自仓的 schema 或测试目录里,单语言用户下载就能建表,不需要先去别处找 DDL。
八份是逐字相同的。核一次很简单,在放着这几个仓的目录里跑:
bash
find . -name schema-mysql.sql -not -path '*/target/*' | sort |
while read -r f; do
  h=$(tr -d '\r' < "$f" | sed 's/[[:space:]]\{2,\}/ /g' \
      | md5sum | cut -c1-10)
  printf '%s  %s\n' "$h" "$f"
done
八行输出、指纹只有一个值,就说明内容一致。我们 2026-10-07 这一轮跑出来是八个 cfdbd74857。唯一要记得的是先去回车再压空白:Java 那份的行尾是 CRLF,不除回车你会看到两个指纹,然后怀疑人生。
编辑只改一个源,然后分发到各仓,表结构就零自由度。这是跨语言对齐里最便宜的一块:行为要读代码才能对齐,而表结构只需要一条复制命令。把没有争议的东西固定下来,把精力留给有争议的,这份账在引擎移植里省下的时间比看上去多。
收个尾
- 接审批流先数表。 5 张参与裁决、3 张管设计和委托、0 张表单表。多出来的每一张都要问一句:谁读它。
- 想清楚表单数据放哪儿。 参与流程判断的进 JSON 列,业务主体建自己的表挂
business_no,要检索要统计的落业务表建索引。这三句选错一句,后面全是补丁。 - 状态码不要自己造。 实例 7 个、任务 6 个是契约,八种语言实现取值一致;索引按你的量补,状态码别动。
参考资料
- mldong 官网(框架 / 在线演示):www.mldong.com/
- jeeflow 文档站(规范 01 数据模型、规范 03 状态机、规范 06 门面):jeeflow-doc.mldong.com/
- jeeflow 演示站(八语言后端,可在线跑一条真流程):jeeflow-demo.mldong.com/