大家好,我是吾鳴。专注于分享提升工作与生活效率的工具,持续关注 AI 的前沿动向。
在开始做AI电商短视频前,第一步并不是立马去写提示词,而是先开始找素材、找对标视频,然后再判断让AI去生成什么样的视频。
网上能够找到很多有价值的图片和视频,也经常能看到某条视频的动作很自然,某张模特图的穿搭和适合你的产品,某张产品图片将包装拍摄得很好等。
但是网上找到的这些素材可以作为创作的参考,但是却不能直接去搬运发布,不然轻则被投诉限流封号,重则要吃官司。
所以,我们需要将素材进行二次创作,并不是直接复制原片,而是借助它的镜头、动作、人物状态和商品呈现的方式,重新去生成一条新的原创视频。
要做到通过素材去制作原创视频,那么就需要通过AI去低成本的去创作视频。
说到AI制作视频,就不得不说首尾帧、参考图、参考视频这几项关键技术,如何有效地应用去控制AI视频的效果。
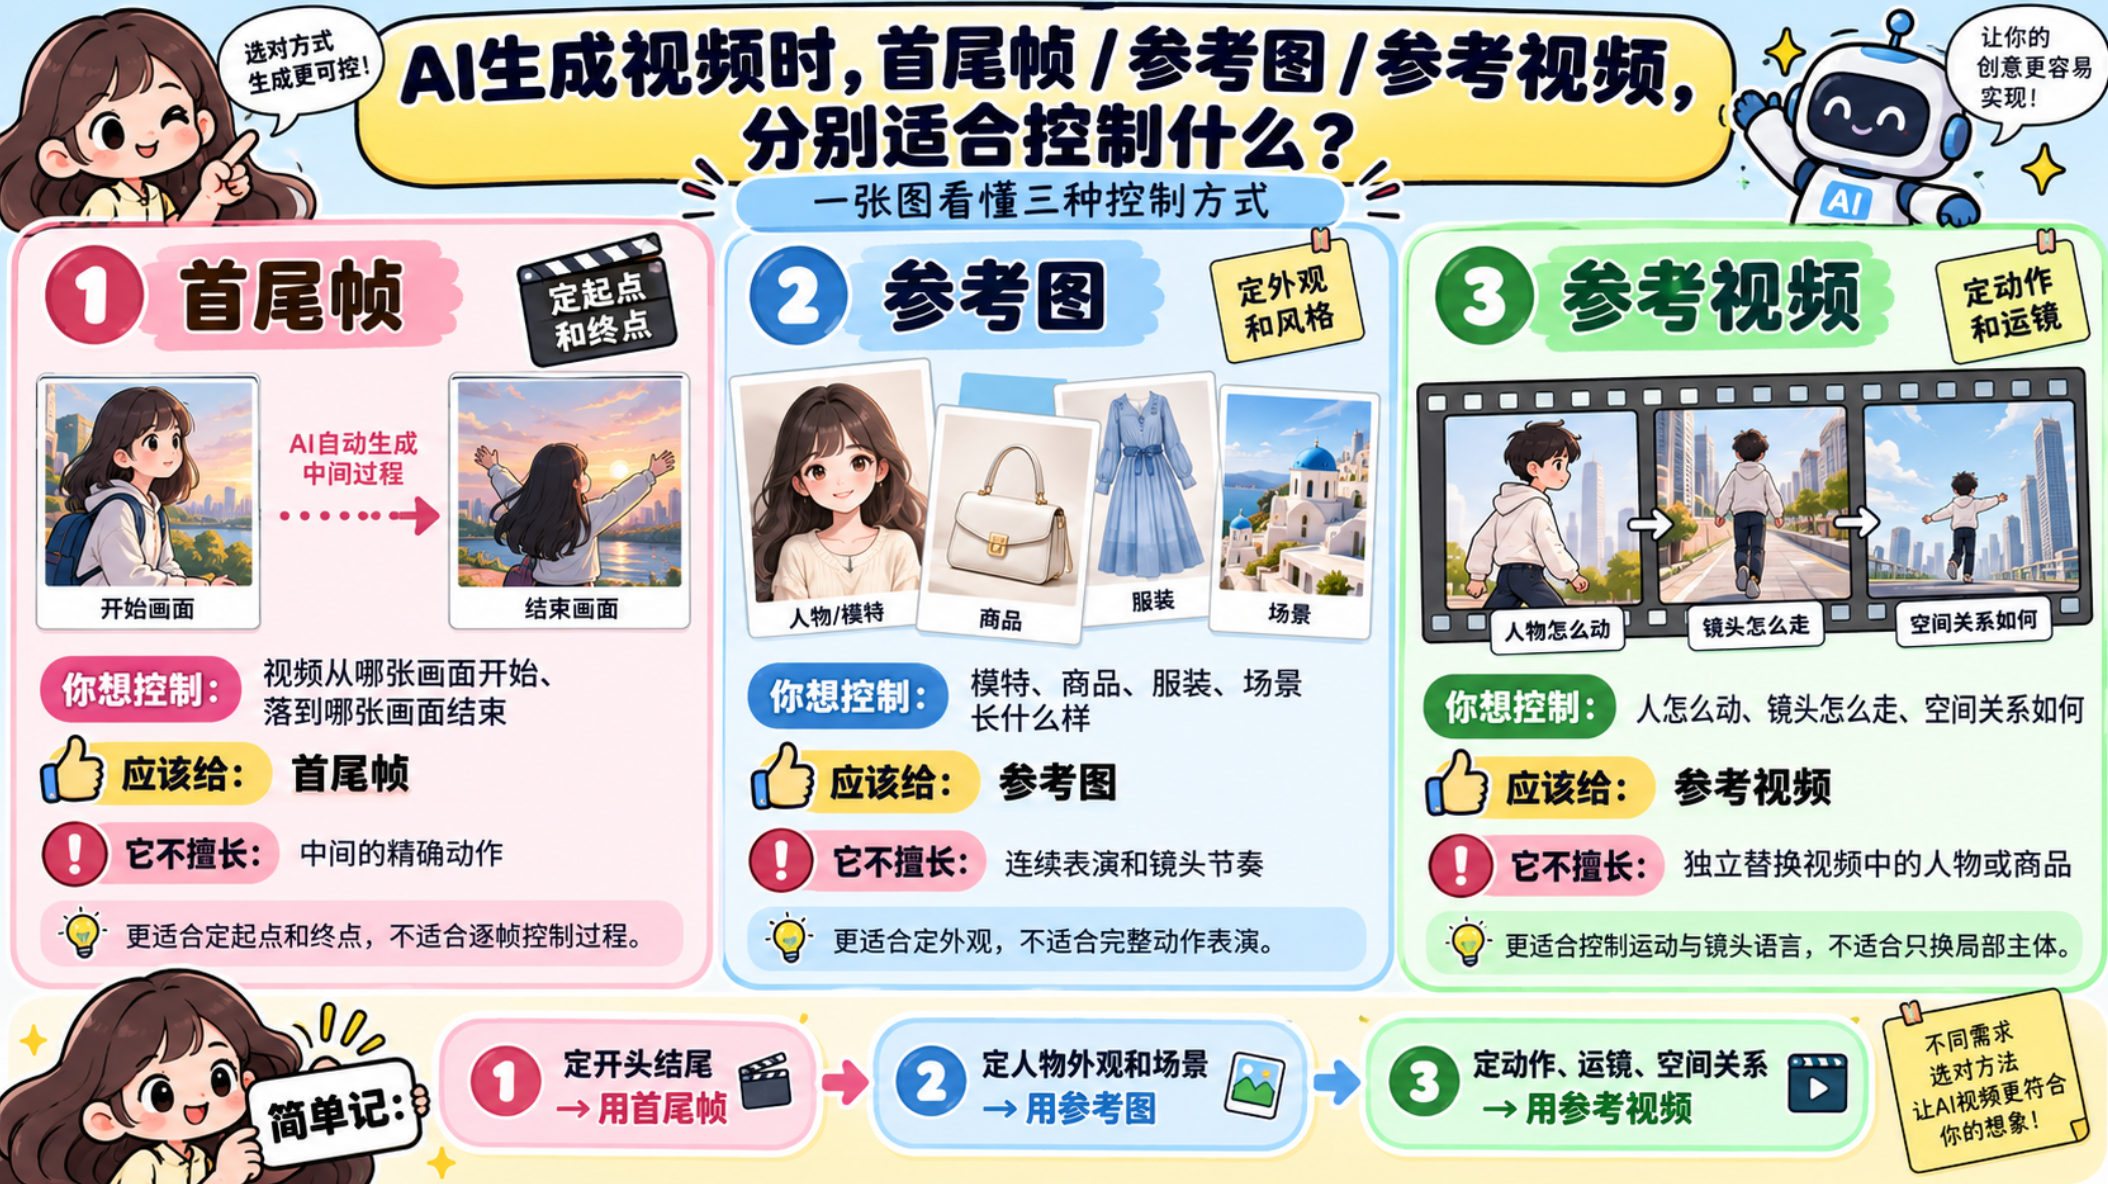
这不是功能介绍,而是素材分工,一份素材只负责一件事情,才能让AI没有那么多的干扰,生成了不该生成的内容。
下面我将以一条"车内涂口红"的视频生成案例,把首尾帧、参考图、参考视频这三种控制素材的方式给讲清楚,本次测试都是使用WorkBuddy桌面版、Wan3.0视频模型、5秒时长、16:9横屏。
需要固定结果画面时,给首尾帧
首尾帧适合处理视频从画面A到画面B的变化,例如我们常见的一些视频的例子:
- 视频开始的时候,人物望向窗外,结尾的时候,人物看向镜头
- 开头的是环境,结尾是适合拍摄商品的近景
- 开始是还没有使用商品的画面,结尾是使用商品后的效果
它的核心的思想,并不是随便给模型截取两张好看的图片,而是为了告诉模型,视频需要发生什么变化。
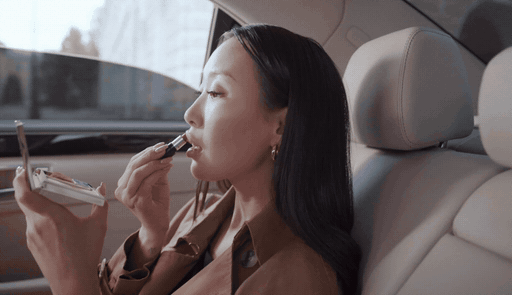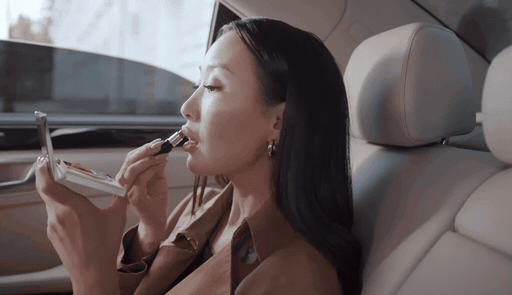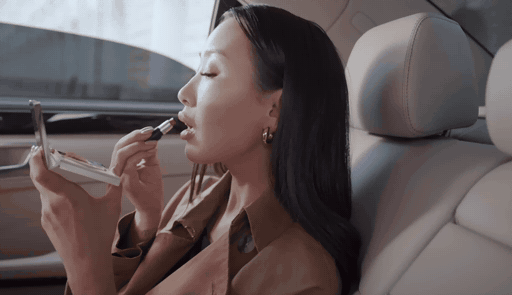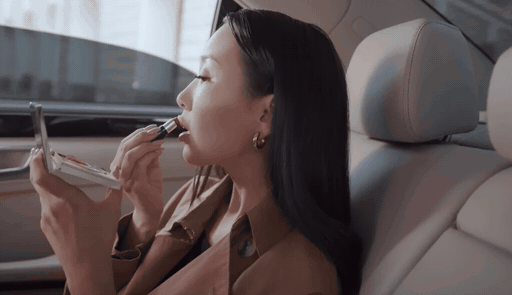
在这次案例的测试中,我给的首尾帧是长下面这样的:
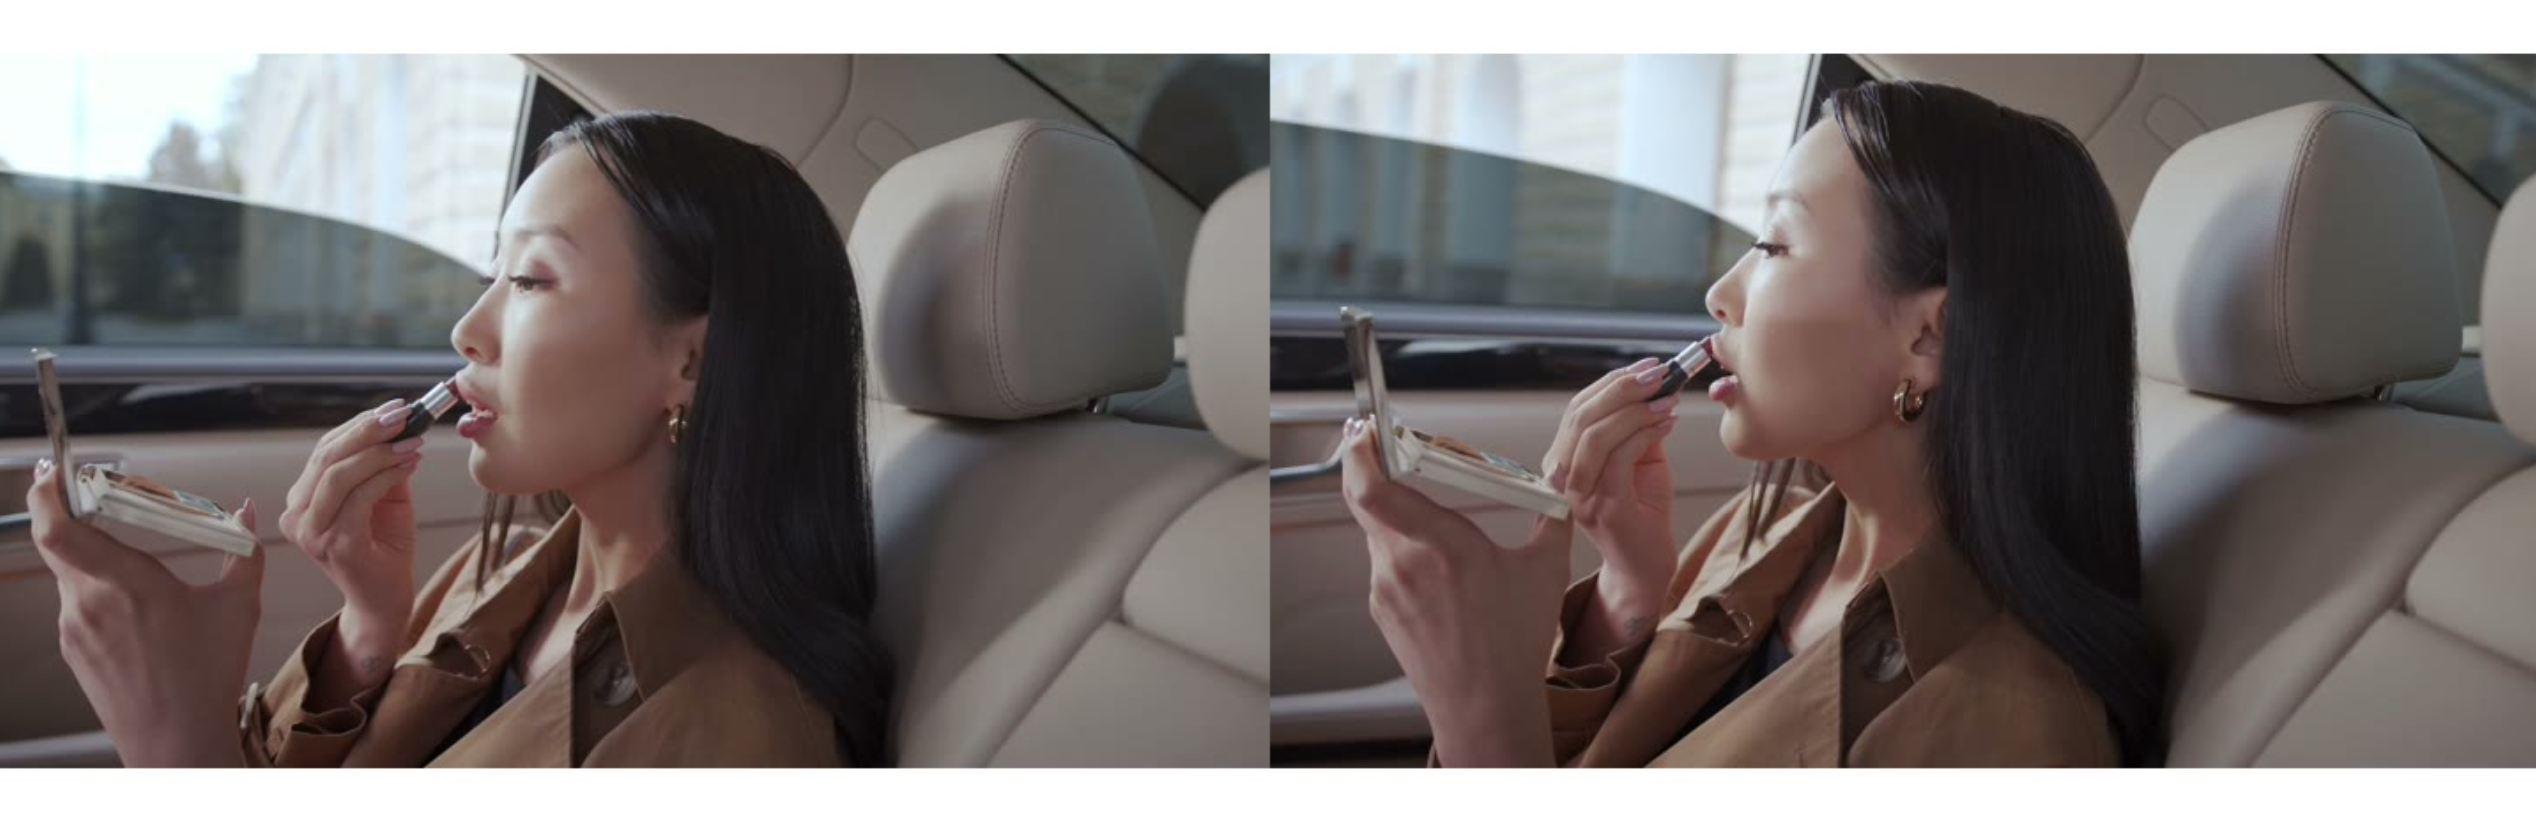
这组首尾帧参考图片中,人物姿势、背景和场景都非常的相似。
所以模型并没有做成过多的变化,这是在原首尾帧微弱的差异中,补充了一小段连续性的动作。
因此,这里有一个可以直接得出来的操作结论,那就是:
首尾帧的画面差异越明确,那么AI生成的视频的叙事方向也就会越明确。
如果你提供的首尾帧是两张几乎一模一样的画面,那么就不要奢望模型会帮你脑补非常完美的剧情,哪怕你的提示词写得再溜,也摆脱不了首尾帧的束缚。
需要锁定人物或者商品时,给参考图
参考图它解决的是视频画面里面应该出现什么, 比如:
- 哪一位模特出境
- 口红是什么包装的,什么颜色
- 化妆盒是什么形状的
- 人物的妆容、发型、服饰各是什么样的状态
- 场景是什么场景,车内、直播间还是在专柜
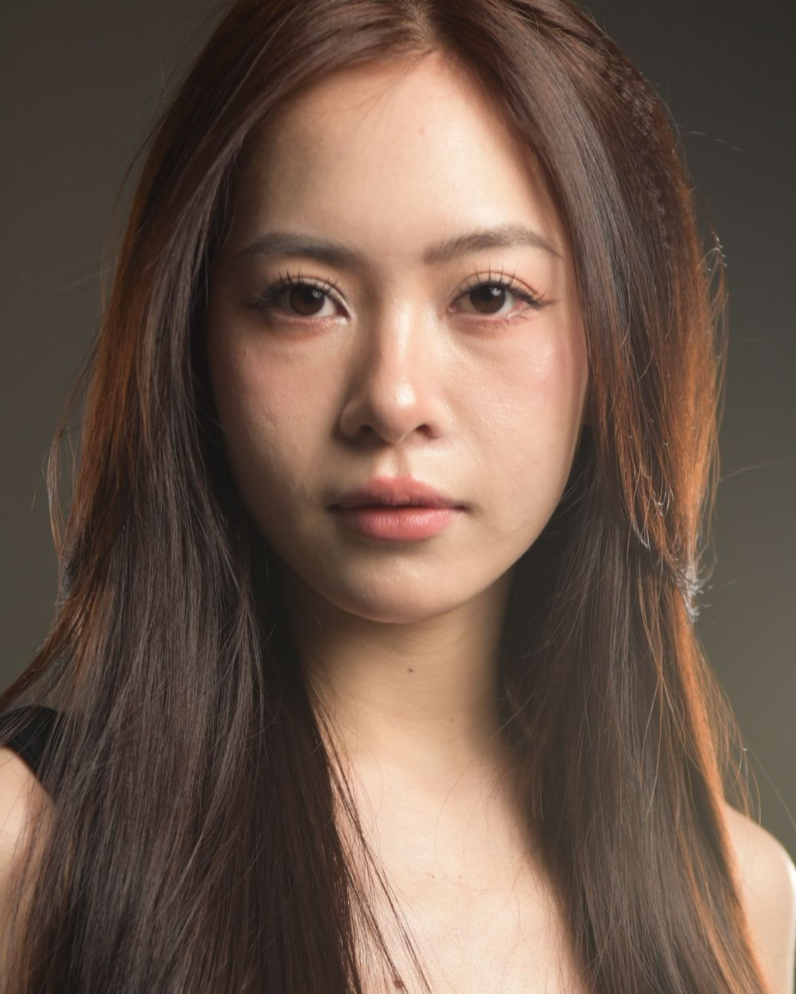
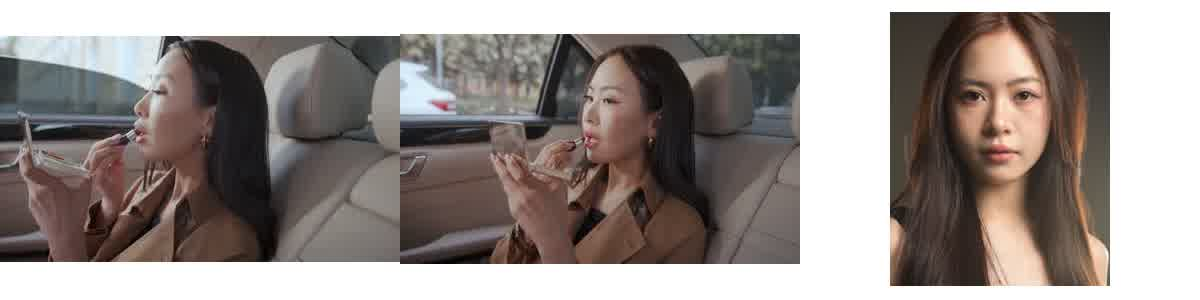
这次的测试中,我为了能够替换掉视频中的模特,我使用了一张新模型特的脸部近景照片。
为了锁定口红和化妆盒,我又去补充了一张商品的参考图。
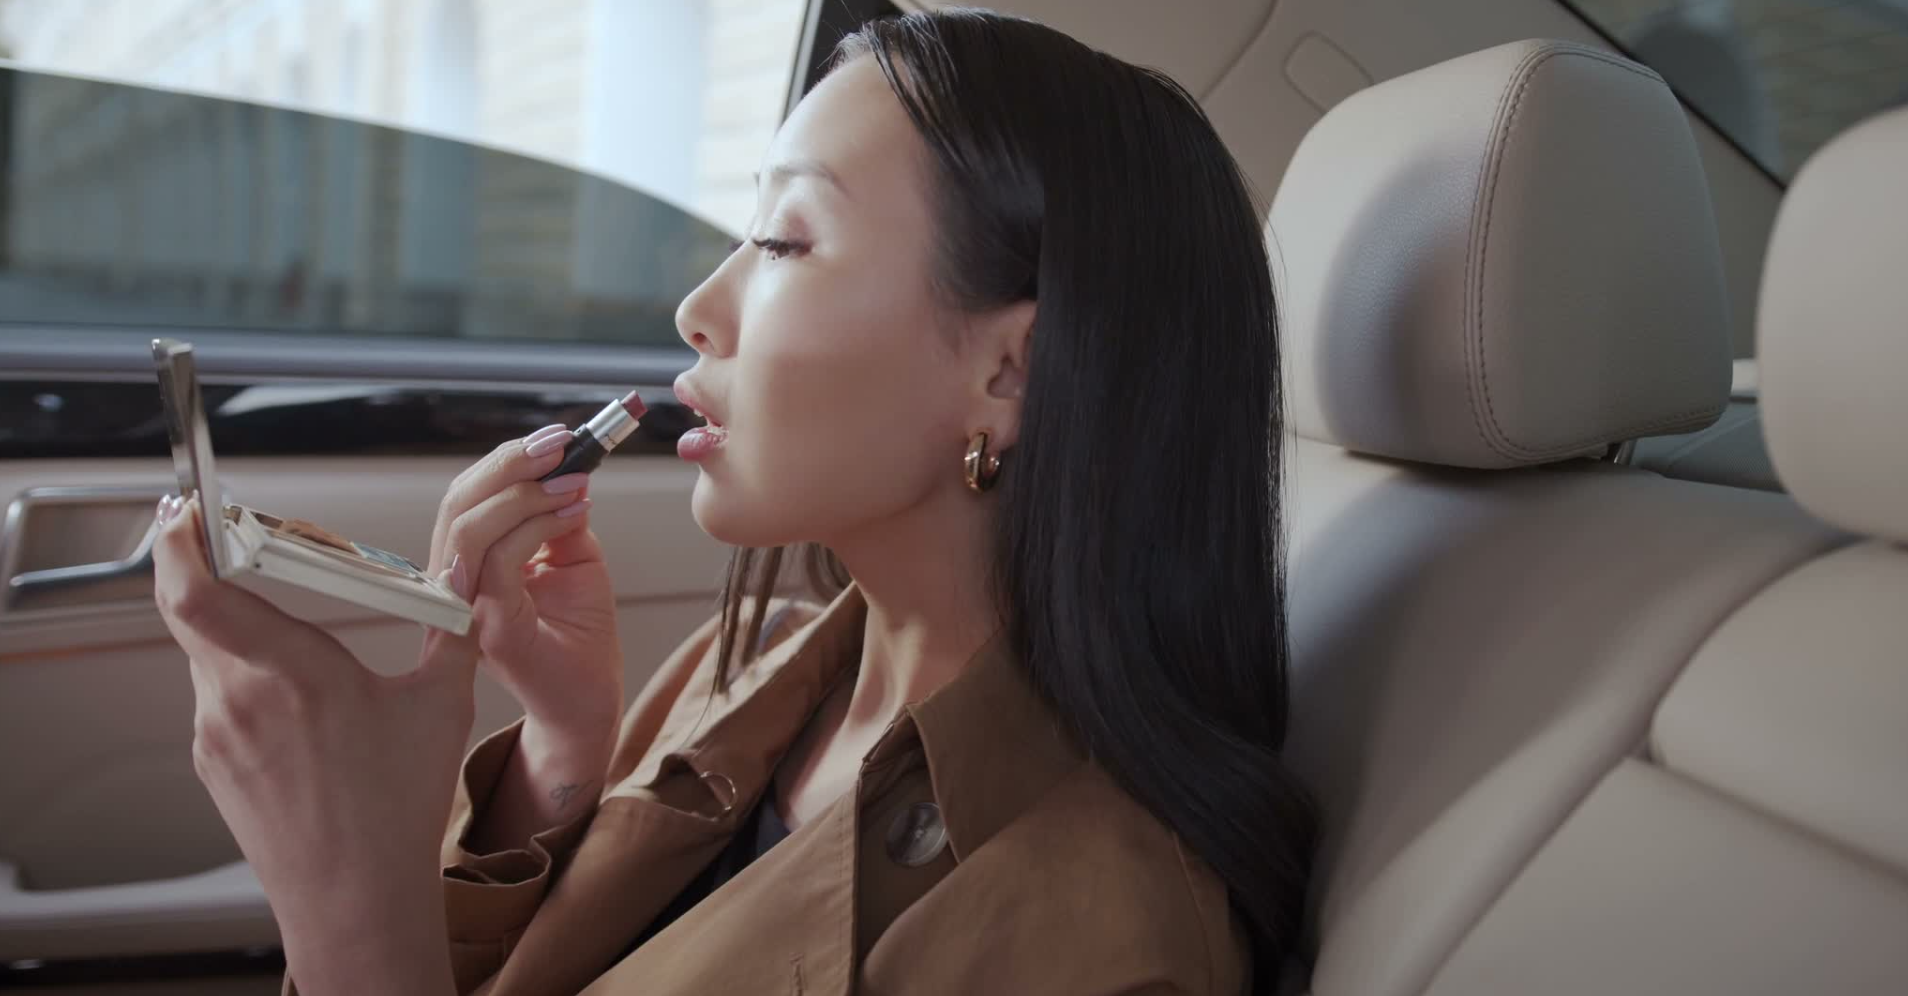
这个组合看起来非常的合理,看着没有什么毛病,但是它有一个电商素材里面非常常见的坑,商品参考图里不只是包含商品。
如果在商品图中依旧出现模特的脸、手、服装或者场景,那么它就不再这是一张纯商品图,对于模型来说,它还同时在提供着以下的参考:
- 商品要长成这样
- 人物也可以长成这样
- 场景也可以是这样的
所以,我同时上传"原始参考视频 + 新模特图 + 商品图"后,得到了下面的结果。
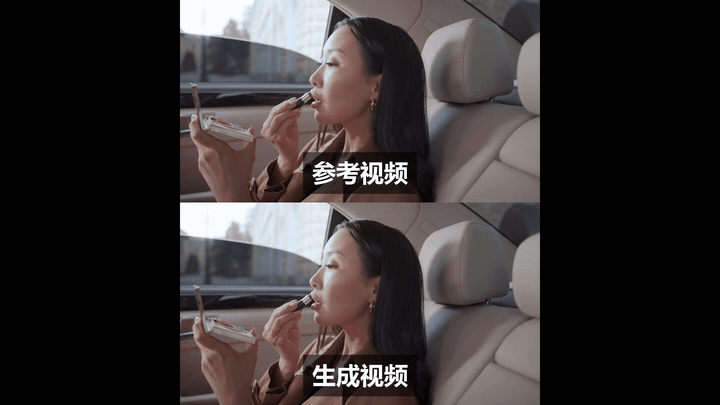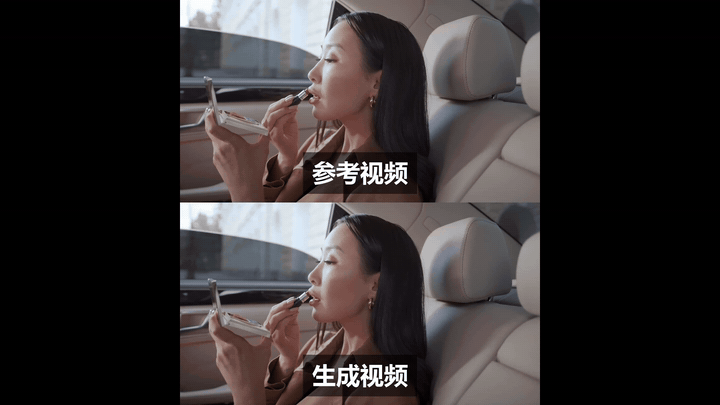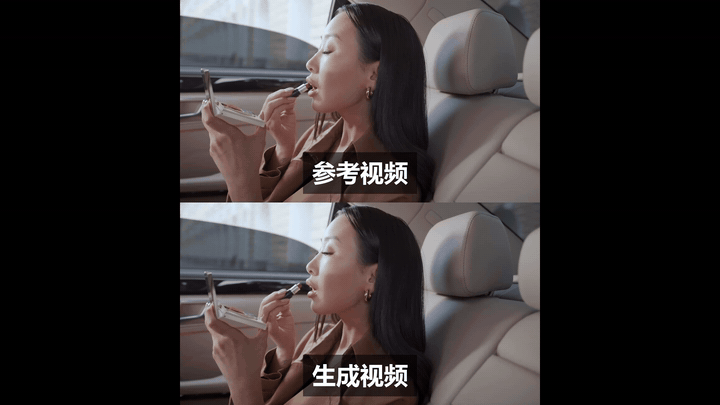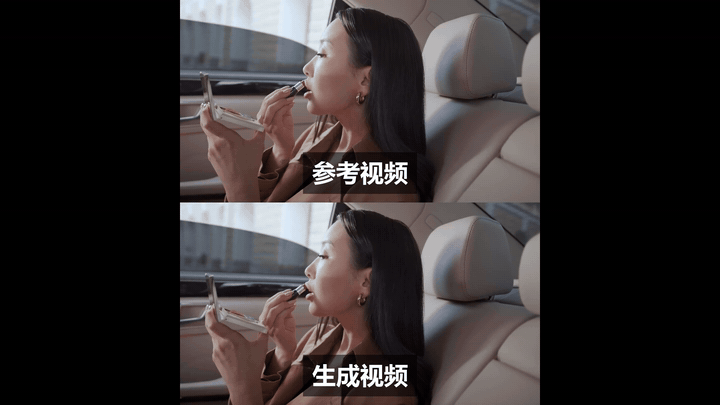
模特涂口红的动作、车内的景别这些虽然都保住了,但是新模特的却没有被替换进去。
这里的原因理解起来其实也不复杂,旧模特在参考视频、商品参考图中都有出现,而新模特只有一张参考图,所以其实模型收到的图片信息是冲突的。
所以,在给商品准备参考图时,我建议尽量按照下面的这个标准来:
- 商品尽量完整
- 包装、结构、材质、和结构要清楚
- 背景要尽量的简单
- 不要出现多余的人物、物品
- 尽量不要出现旧模特的脸、手、身体
处理好参考图的素材,比多写几句提示词要更管用。
需要复刻动作和镜头时,给参考视频
参考视频最容易让模型了解视频是怎么动的。
下面的这条参考视频,我真正想要让模型参考的是:
- 模特坐在车后排上补口红的动作
- 手拿化妆镜和口红的关系
- 镜头拍摄到的中近景
- 车窗、座椅和人物之间的空间关系
- 整条视频的视频节奏
参考视频的控制力非常强,但是它也有一个不好地方,那就是它会把原视频中的人物、发型、环境、服装等元素非常习惯性的带入到新视频中。
所以,要想通过参考视频换人的时候,不要只是简单的一句"换成另一个模特"。
更加有效的做法是:
- 给一张清晰的新模特的特写图
- 明确的指定"人物身份以参考图为准"
- 明确的指定"参考视频只参考动作、镜头以及空间关系"
- 删除其他素材中会强化旧人物的信息
这一次测试,我只保留了新模特和参考图视频,使用了如下的提示词:
一位长黑发的年轻亚洲女性坐在行驶中的汽车后座上,自然地补涂口红。
她的脸型、五官比例、眼睛、鼻子、嘴唇、肤色与整体气质严格与参考图中的女性一致,
全程人物身份稳定,不得变成其他人的脸。

参考视频仅提供涂口红的动作节奏、手部运动轨迹、车内后座空间关系、景别、构图与镜头运动,
不继承参考视频中人物的脸、发型、肤色、妆容或服装。

单镜头连续运镜,表情自然,手部与口红接触合理,画面真实有质感。
不要字幕、文字或水印。
这次替换视频中的模特终于有效果了。
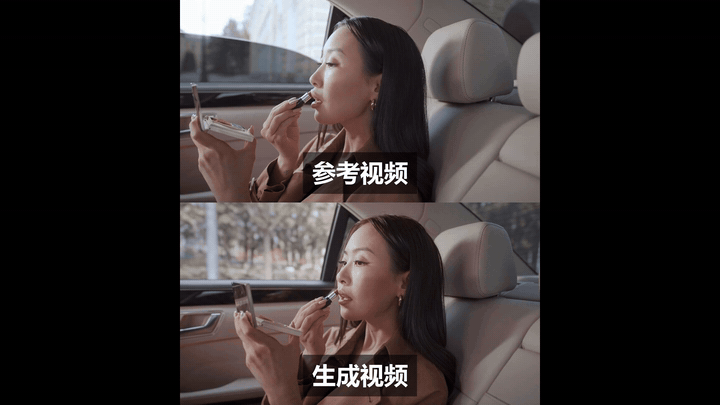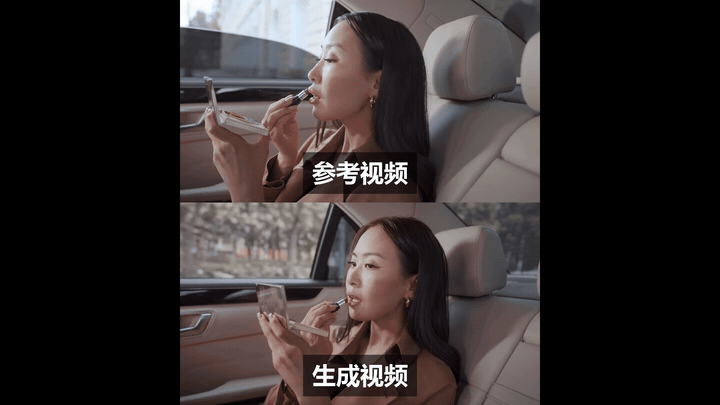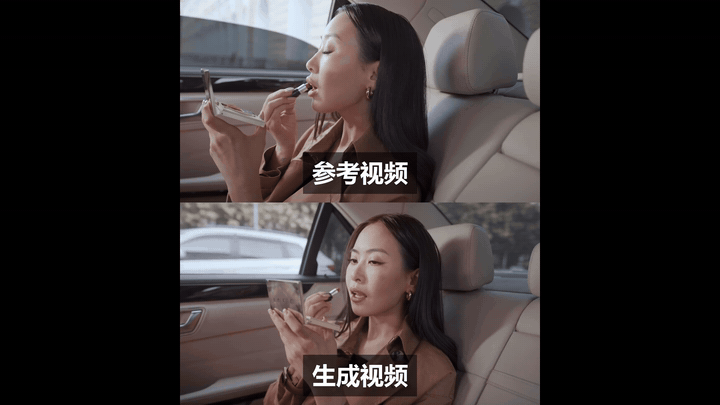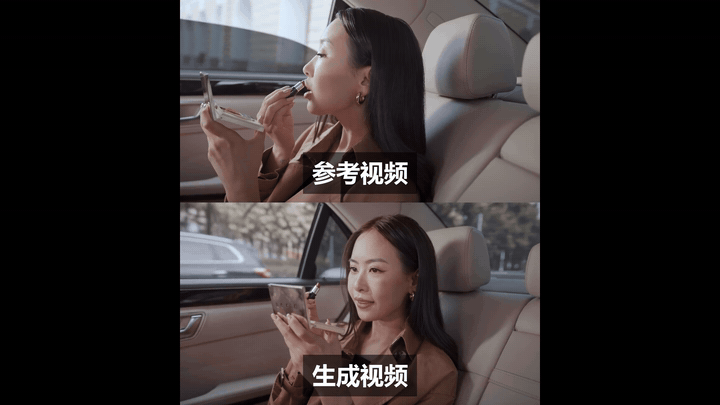
从5秒的关键帧看,新人物基本稳定,并没有跳回到旧视频中的模特。
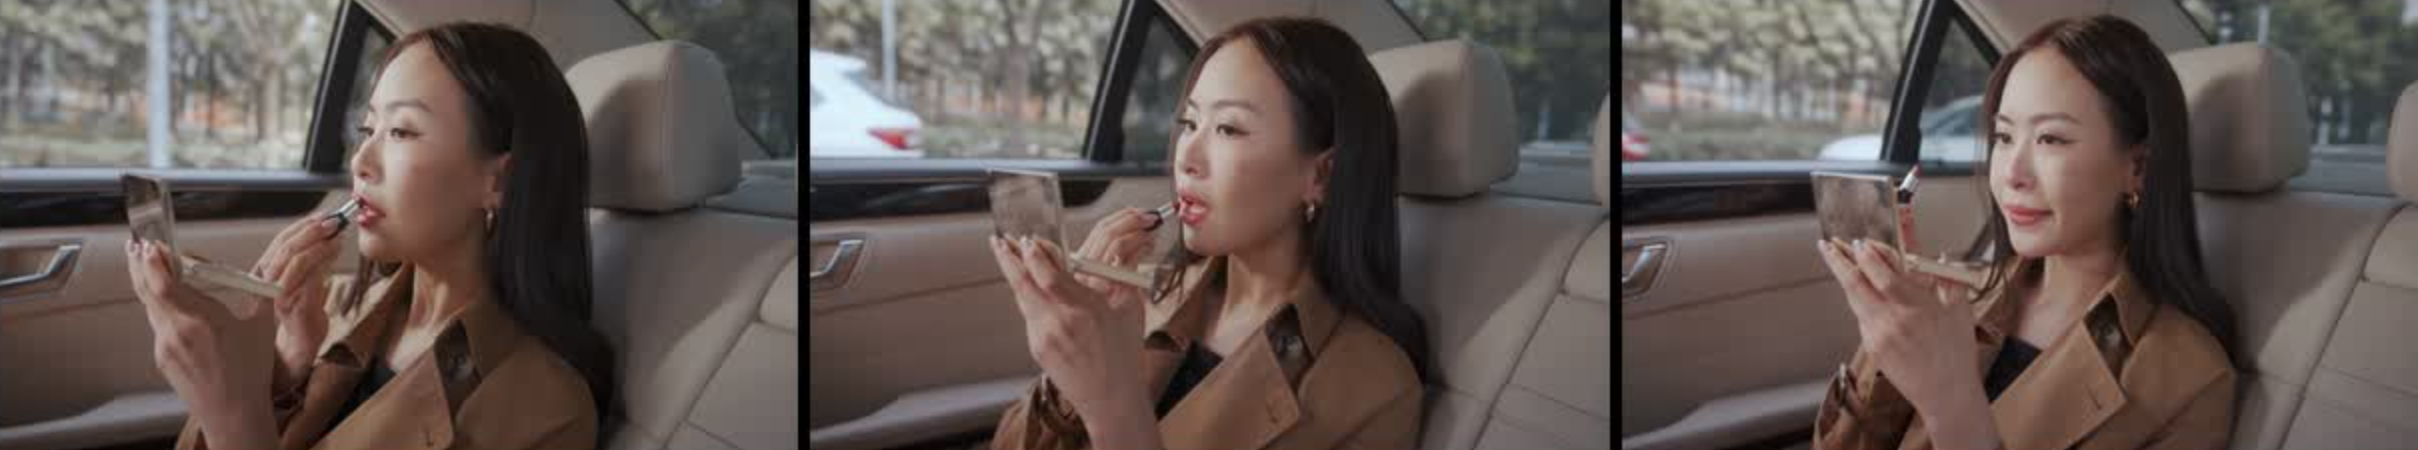
当然,这条结果也是有边界的,人物控制变强了,但是因为去掉了之前的口红的参考图,口红和化妆盒就不是严格的锁定状态了,这不是失败,而是素材控制的优先级问题。
同时要换人、锁商品、保动作,素材该怎么准备?
这是电商场景最常见、也最容易翻车的组合。
我会按照一下的方式进行准备。
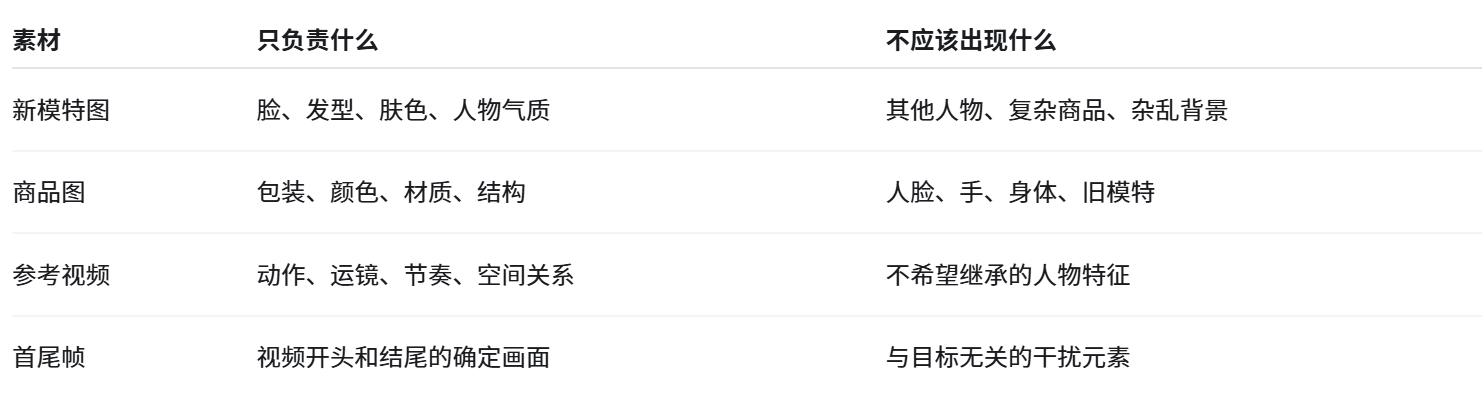
先把素材都给拆解干净后,在上传,不要去期待模型会自动的去理解"这张图只看口红,别看画面中的其他元素",它并不会按照你心理想的那样去工作,它反而回去理解整张图里的视觉信息。
最后给一个选素材口诀
想要依据起点和终点生成视频,给首尾帧;
想要锁住人物和商品,给干净的参考图;
想要借动作和镜头的话,给参考视频。
如果是三样都需要控制,那么就要划分清楚素材功能。
AI生视频真正不好控制的地方,不是找不到素材,而是素材里面的视觉元素太过于杂乱,无法给视频模型正确的参考。
好了,本文的分享就到这里,如果您觉得有收获的话,可以给个一键三连,您的鼓励是吾鳴持续输出的最大动力。