调模型的时候,我们都希望它按固定格式把结果给你。
可模型默认吐出来的,是一段自然语言。
你要的是几个字段,它给你的往往是一整段话,中间还夹着解释。
要让它按你给的格式返回,这件事有个名字,叫结构化输出。
它说的是:
模型返回的数据是可解析的,格式是固定的。
比如你要一份联系人信息,它给你的就是姓名、电话这两个字段。
程序拿到这两个字段,直接就能用。
这件事在 LangChain 里,可以按三个阶段来理解,每个阶段解决的问题不一样。
把这条线捋清楚,才能把这件事说明白。
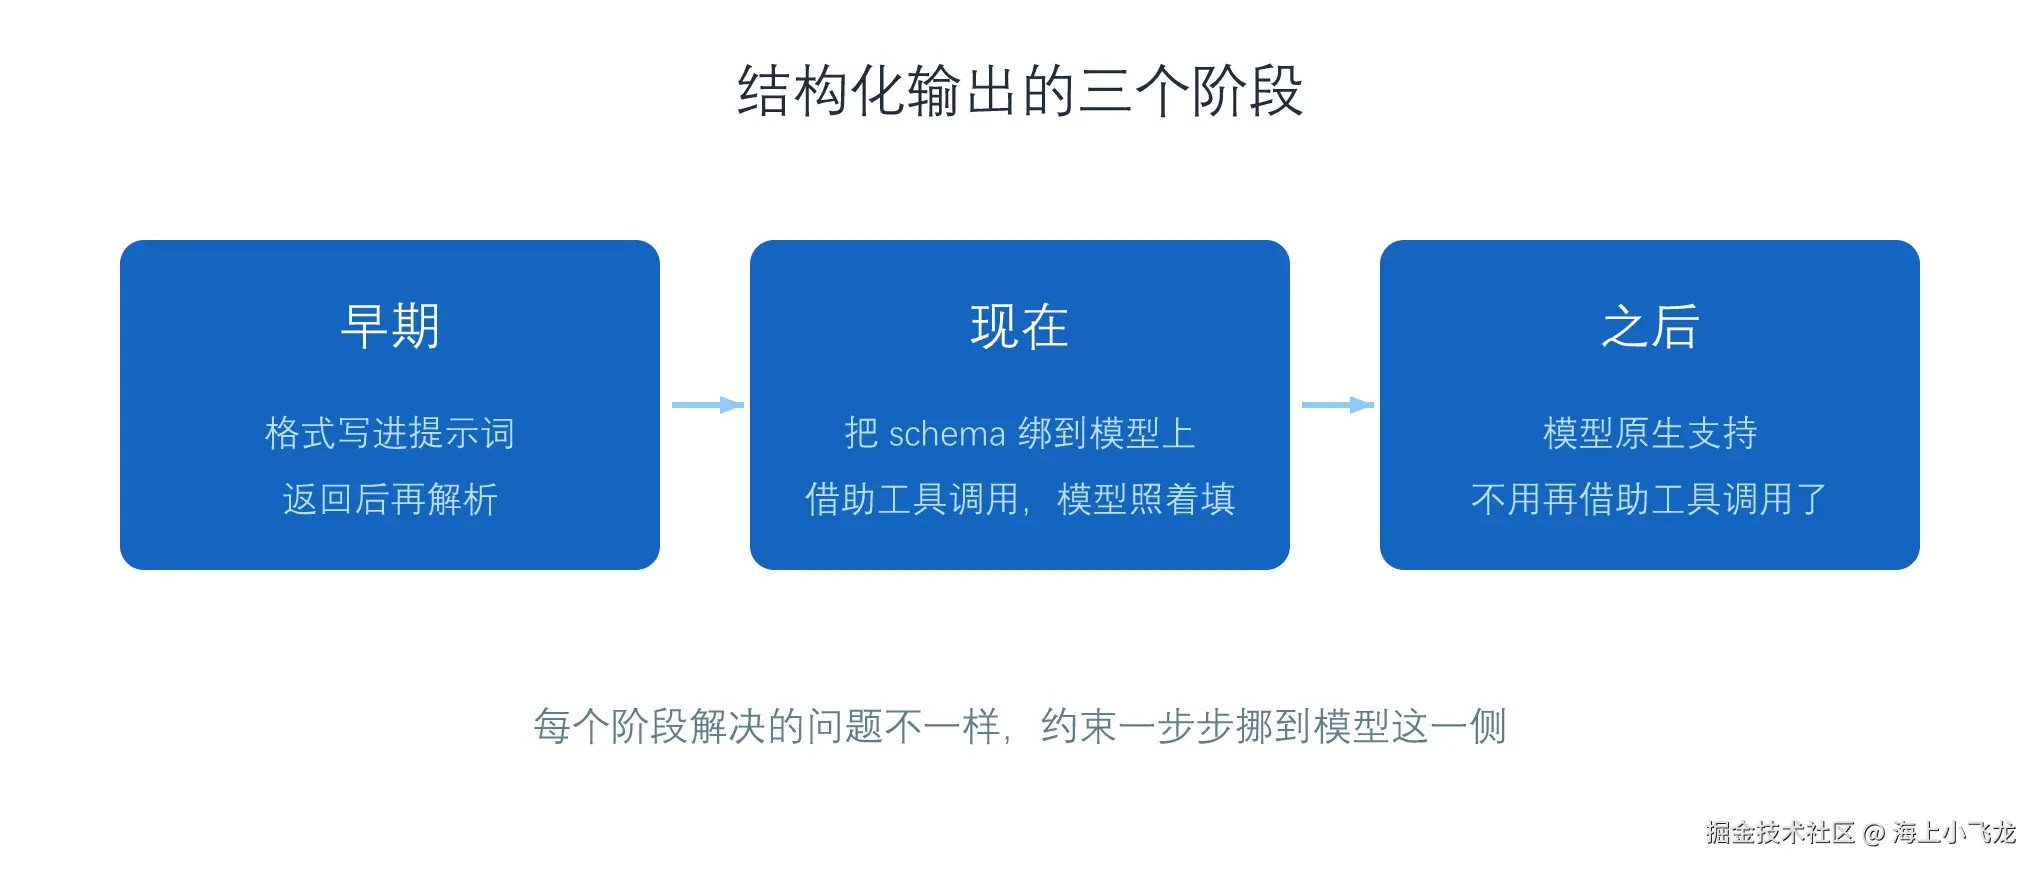
早期靠提示词,返回后再解析
早期的常见做法,是把格式要求写进提示词,让模型按这个格式把结果吐出来。
模型返回一段符合格式的文本,你在外面再把它解析成结构化数据,交给下一步。
打个比方,就像口头交代格式:
说清楚要哪几项,等它写完了,再一项一项核对。
环节多,容易出错的地方也多。
python
import json

prompt = """
从下面这句话里抽出联系人信息,用 JSON 返回,只要 name 和 phone 两个字段,不要输出解释。
张三的电话是 12300001111,他说下周一再联系。
"""
text = model.invoke(prompt).content  # 模型返回的是一段文本,后面还得自己解析一遍
contact = json.loads(text)
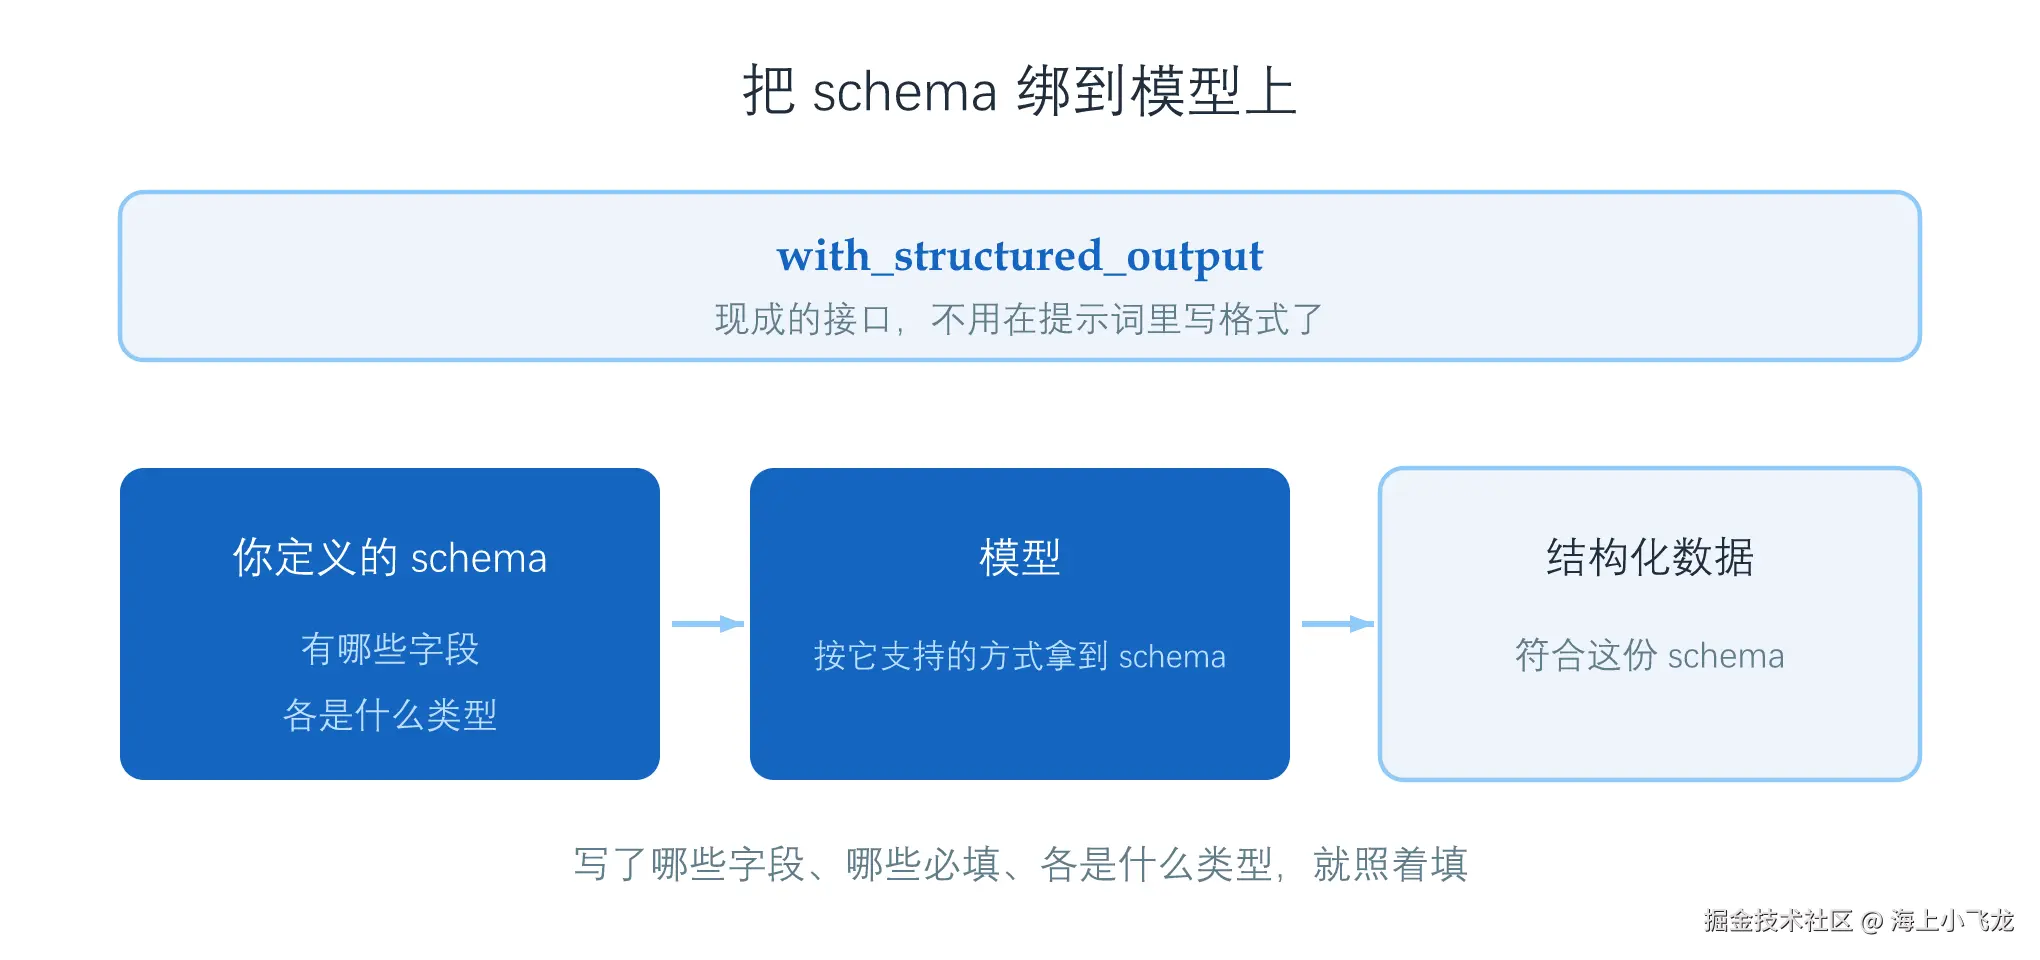
把 schema 绑到模型上
schema 就是你要的字段结构:
有哪些字段、各是什么类型、分别代表什么。
现在的版本里,这件事有现成的接口,叫 with_structured_output。
常见的一种做法,是借助模型支持的能力来约束结果,比如 function call(函数调用)或者 tool call(工具调用)。
具体走哪一种,要看这个模型支持什么。
你把定义好的 schema 传进去,它会把这个 schema 绑到模型上。
对模型来说,这份 schema 就是它必须满足的约束。
就像递过去一张写满字段的单子:
每一栏该填什么,都写得清清楚楚。
哪些必须填,哪些可以不填,也提前规定好了。
schema 里写了哪些字段、哪些必填、各是什么类型,模型就照着这些往下填。
跟纯靠提示词那套比,约束从提示词里挪到了模型这一侧。
模型返回之后,LangChain 会把它转成你定义的结构。
python
from pydantic import BaseModel, Field

class Contact(BaseModel):
    name: str = Field(description="姓名")
    phone: str = Field(description="电话号码,只留数字")

model_with_schema = model.with_structured_output(Contact)  # 把 schema 绑到模型上
contact = model_with_schema.invoke("张三的电话是 12300001111,他说下周一再联系")
四种常用的 schema
LangChain 里常见的 schema 有四种。
| schema 类型 | 怎么给 | 拿到什么 |
|---|---|---|
| Pydantic 模型 | 定义一个继承 BaseModel 的类 |
校验过的实例 |
TypedDict |
定义一个类型化的字典类 | 字典 |
| dataclass | 直接用 Python 的数据类 | 字典 |
| JSON Schema | 自己写一个 schema 字典 | 字典 |
这四种里,dataclass 主要用在 create_agent 的结构化输出(下一节就讲它)。
with_structured_output 这边,支持的是 Pydantic、TypedDict 和 JSON Schema。
第一种,也就是 Pydantic 模型,通常是最省事的选择。
定义一个 BaseModel 的子类,每个字段用 Field 配上描述就行。
字段定义、字段描述、校验规则都写在一处。
描述写得越具体,越有利于模型正确填充字段。
Pydantic 拿到的,是校验过的实例,字段对不上会直接报错,不会把不对的数据悄悄交给后面的程序。
在结构化输出的常见用法下,TypedDict、dataclass 和 JSON Schema 最终拿到的都是字典。
TypedDict 更偏向类型提示,不做运行时校验。
类型对不上它不拦,不对的数据会一路流到后面。
dataclass 是 Python 标准库里的数据类,手上已经有一份的话,拿来就能用。
JSON Schema 是自己写 schema 字典,想控制得细一点就走这条。
具体支持哪些类型、返回什么形式,不同版本、不同模型可能不一样。
create_agent 里的结构化输出
还有一种做法,是让模型直接把结构化结果给出来,不用再借助工具调用。
现在不少模型供应商在 API 这一层就直接支持结构化输出。
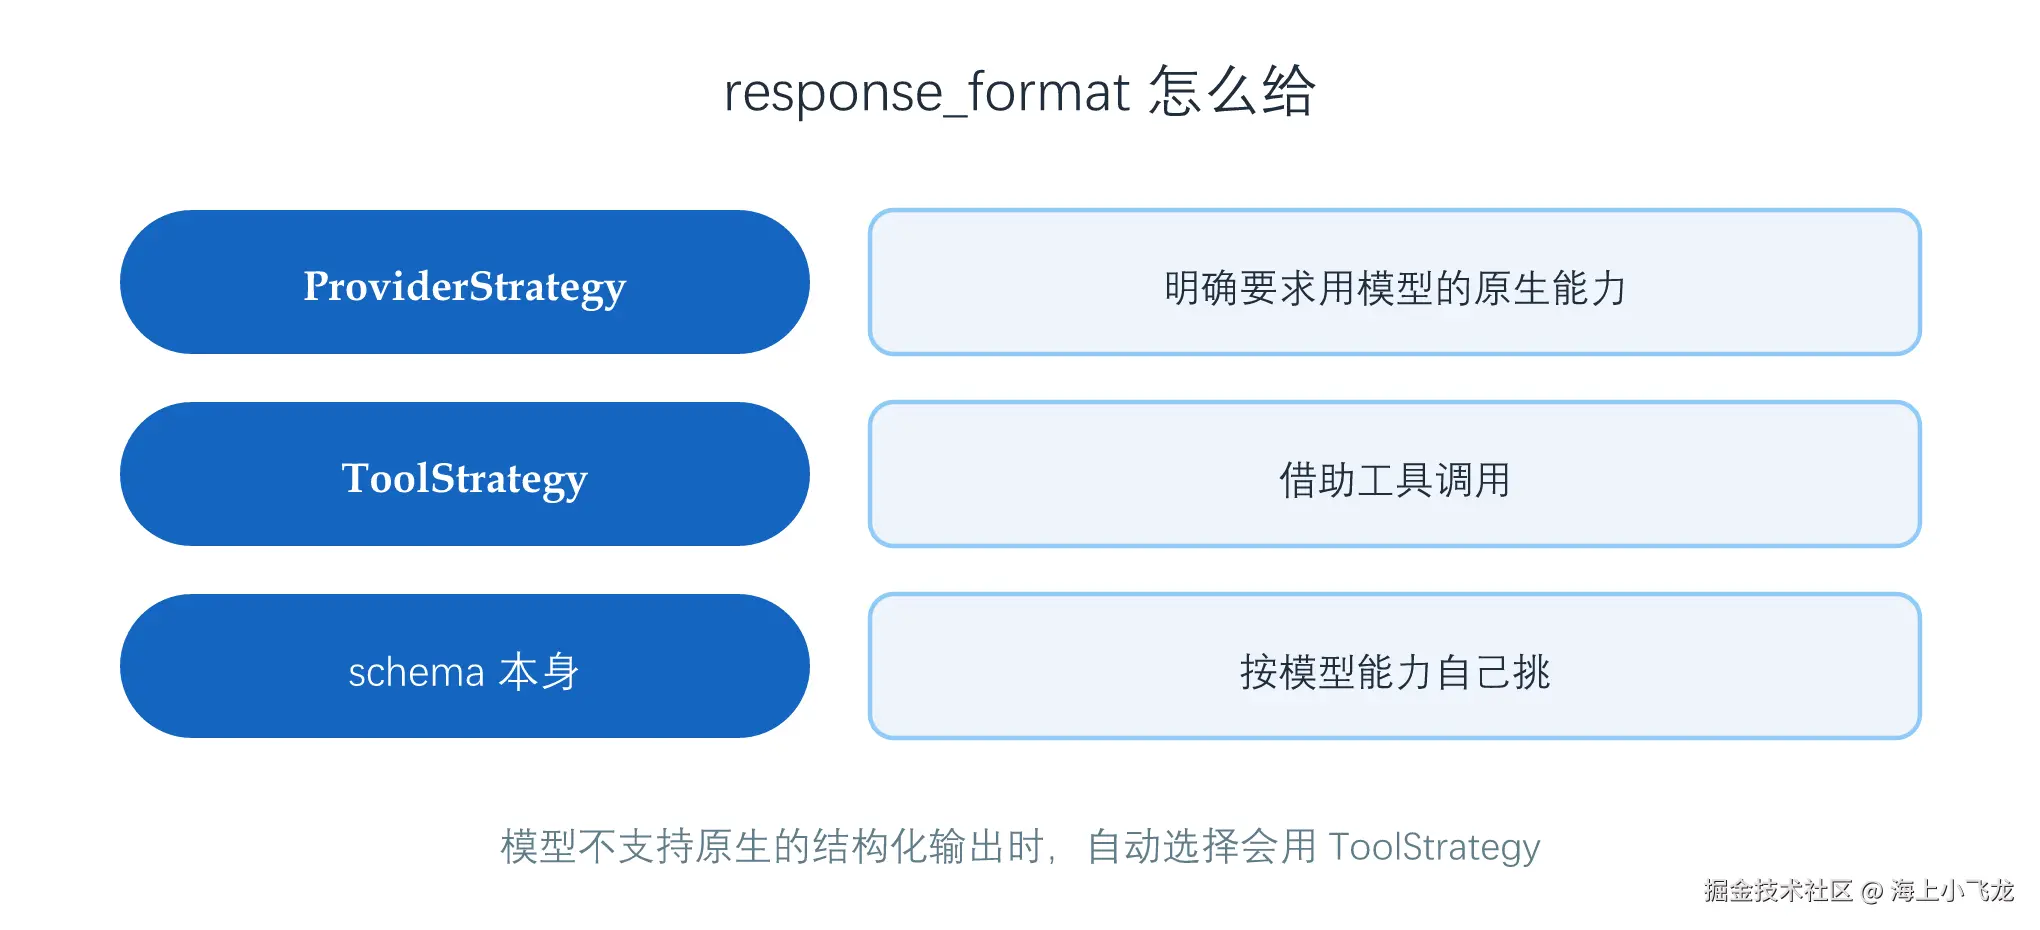
create_agent 是 LangChain 里搭 Agent 的入口,结构化输出由 response_format 这个参数控制。
这个参数怎么给,有三种选择:
- 给
ProviderStrategy,明确要求用模型的原生能力 - 给
ToolStrategy,借助工具调用 - 给 schema 本身,让
create_agent按模型能力自己挑(JSON Schema 字典要显式包一层策略,且要带 title 和 description)
如果模型不支持原生的结构化输出,自动选择时会用 ToolStrategy。
python
from langchain.agents import create_agent
from langchain.agents.structured_output import ProviderStrategy

agent = create_agent(
    model=model,
    tools=[],
    response_format=ProviderStrategy(Contact),  # 明确走模型的原生能力
)
用哪一种,主要看这个模型有没有原生的结构化输出能力,也看你需不需要明确指定。
- 确定这个模型有原生结构化输出能力,就直接指定
ProviderStrategy - 不太确定这个模型有没有,就把 schema 交给 create_agent,让它根据模型能力自动选择