第七章:多 Agent 系统与协作
7.1 多 Agent 系统概述:为什么需要多个 Agent
在单 Agent 架构中,一个 LLM 实例承担全部职责:理解意图、检索信息、推理决策、生成内容、执行工具调用。简单任务够用,但任务复杂度上来后,几个结构性瓶颈就暴露了。
首先是上下文窗口竞争。单 Agent 要在有限窗口里同时维护任务描述、历史对话、工具调用结果、中间推理过程。任务链路一长,中间状态占满窗口,关键信息被挤出,模型开始"遗忘"或注意力分散。即便用 128K 甚至 200K 的大窗口模型,信息密度下降带来的性能衰减依然明显。
其次是角色混淆。一个 Agent 同时当研究员、代码编写者和审查者,行为策略会相互干扰。生成代码时要倾向创造性输出,审查代码时要倾向批判性思考------两种倾向在同一个模型实例里很难有效切换,往往是"自己写的代码自己审不出问题"。
最后是工具调用爆炸。单 Agent 处理复杂任务要挂载大量工具:搜索引擎、代码解释器、数据库查询、文件操作、API 调用......工具一多,选择准确率就下降。研究表明,可用工具超过 20 个时,工具选择准确率下降 15% 以上。
多 Agent 系统把复杂任务拆成多个子任务,每个子任务交给专门的 Agent 处理。每个 Agent 有独立的上下文窗口、专属工具集和明确的角色定义,彼此通过结构化协议协作。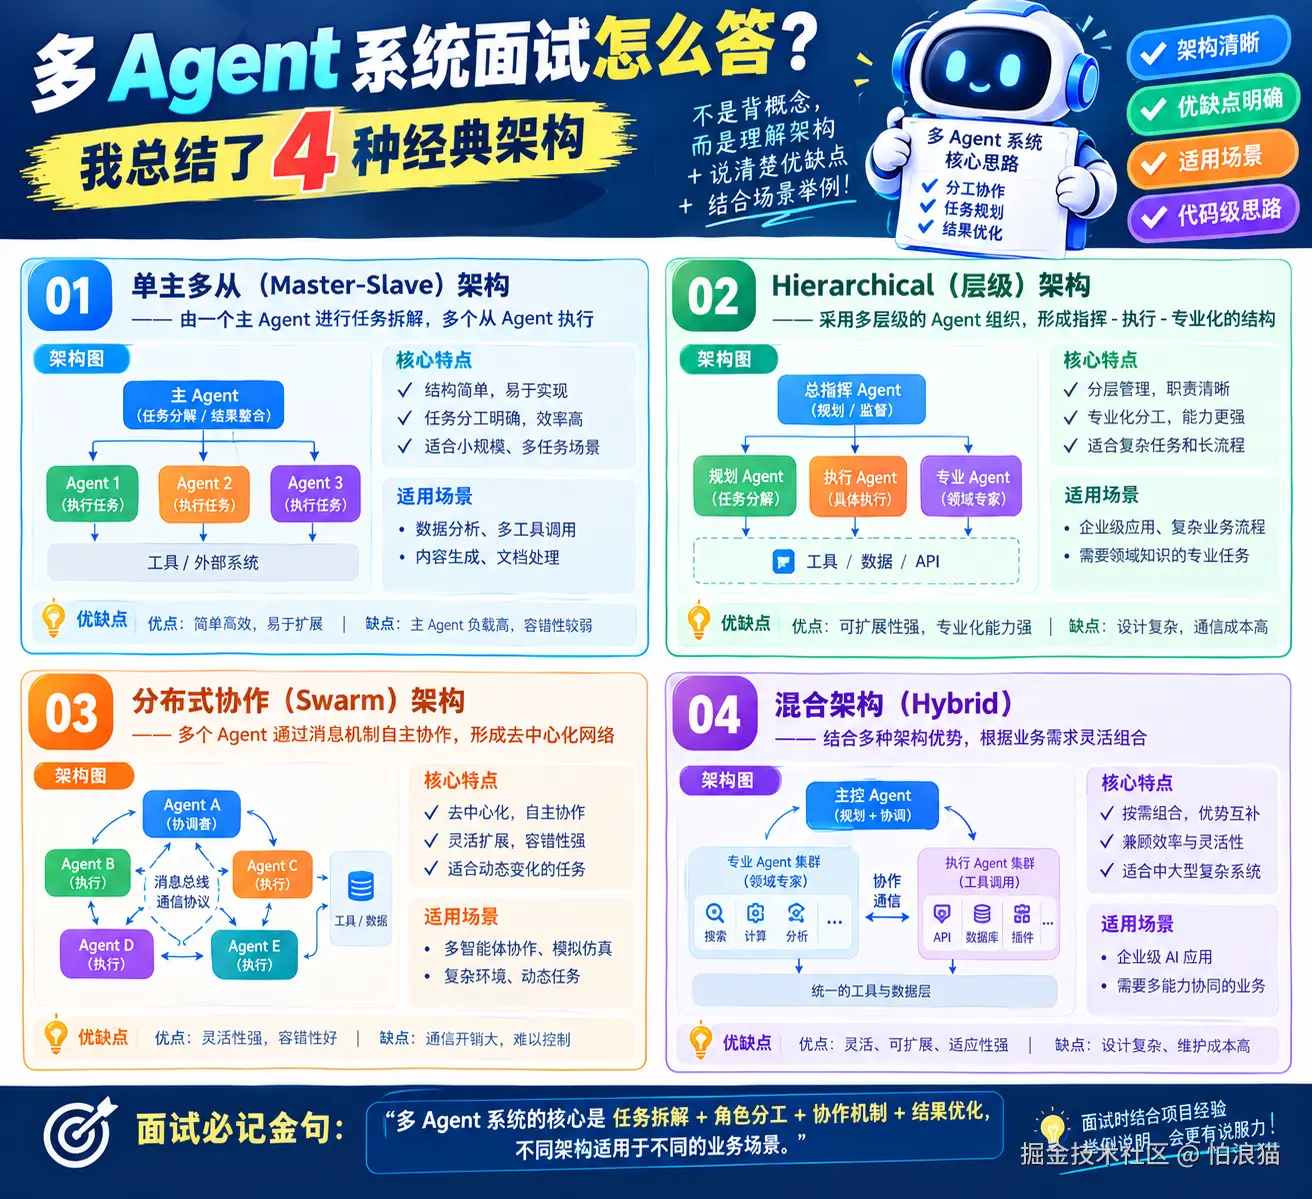
以下是单 Agent 与多 Agent 系统的关键对比:
| 维度 | 单 Agent | 多 Agent 系统 |
|---|---|---|
| 上下文管理 | 所有信息共享一个窗口,容易溢出 | 每个 Agent 独立窗口,隔离性好 |
| 角色定义 | 角色混淆,策略冲突 | 角色明确,各司其职 |
| 工具管理 | 工具集中挂载,选择困难 | 工具按角色分配,精准调用 |
| 错误恢复 | 错误传播影响全局 | 错误可被其他 Agent 纠正 |
| 并行能力 | 串行执行,速度受限 | 可并行执行独立子任务 |
| 系统复杂度 | 架构简单,开发成本低 | 通信开销大,调试难度高 |
| 成本 | 单次调用成本低 | 总 Token 消耗高,成本上升 |
但多 Agent 不是银弹。它带来了通信开销、状态同步一致性、调试复杂度、以及更高的 Token 消耗。工程实践中,要在任务复杂度和系统复杂度之间找平衡。
一个实用判断标准:当任务满足以下任一条件时,考虑多 Agent 架构------
- 任务可以被自然地分解为 3 个以上独立子任务
- 不同子任务需要不同的系统提示词和工具集
- 任务流程中存在明确的"审查-修改"循环
- 需要多个专业领域的知识进行交叉验证
- 子任务之间存在可并行执行的依赖关系
学术界和工业界的实践中,多 Agent 系统已广泛应用于软件开发(MetaGPT 模拟开发团队)、科学研究(多 Agent 协作撰写综述论文)、金融分析(多视角投资决策)等领域,证明了其在复杂任务中的有效性。
7.2 协作模式:层级式、流水线式、并行式与辩论式
多 Agent 系统的协作模式决定了 Agent 之间的交互拓扑。不同模式适用不同任务类型,选对协作模式是系统设计的关键决策。
层级式协作(Hierarchical)
层级式协作采用树状结构,顶层 Agent 负责任务分解和调度,底层 Agent 负责具体执行------类似企业的管理层级:CEO 把战略目标拆成部门目标,部门经理再拆成具体任务,基层员工执行。
bash
          [Orchestrator Agent]
           /        |        \
    [Agent A]   [Agent B]   [Agent C]
     /    \       |          |
  [A1]  [A2]   [B1]        [C1]
层级式的优势是控制流清晰,顶层 Agent 可以全局视角调度任务。劣势是顶层容易成为瓶颈,底层 Agent 之间缺乏直接沟通,信息传递有损耗。
典型应用场景:项目管理类任务,如"开发一个 Web 应用",顶层 Agent 分解为前端开发、后端开发、测试等子任务,各子任务再进一步分解。
流水线式协作(Pipeline)
流水线式协作采用线性链式结构,每个 Agent 处理特定阶段,把输出传给下游------类似工厂流水线,原料经过一道道工序产出成品。
bash
[Research Agent] --> [Drafting Agent] --> [Review Agent] --> [Publish Agent]流水线式的优势是流程明确,每个 Agent 只管输入输出格式,职责边界清晰。劣势是整体延迟等于各阶段延迟之和,任何一个环节出错就阻塞整条流水线。
典型应用场景:内容生产流水线,如"研究主题 -> 撰写初稿 -> 审校修改 -> 发布"。每一步由专门 Agent 处理,上游产出作为下游输入。
并行式协作(Parallel)
并行式协作让多个 Agent 同时处理同一任务的不同方面,最后汇总------类似专家组各自独立研究同一问题的不同维度,再汇总报告。
bash
                 --> [Financial Analyst Agent] --
[Task Dispatcher] --> [Tech Analyst Agent]      --> [Aggregator Agent]
                 --> [Market Analyst Agent]     --
并行式的优势是执行效率高,多个 Agent 同时工作大幅缩短总时间。劣势是结果汇总可能冲突(不同 Agent 给出矛盾结论),需要额外的冲突解决机制。
典型应用场景:多维度分析任务,如投资决策时同时从财务、技术、市场三个维度分析一家公司。
辩论式协作(Debate)
辩论式协作中,多个 Agent 针对同一问题提出不同观点,通过多轮辩论达成共识或呈现多元视角------类似学术辩论赛,正方反方各自论证,评委综合评判。
bash
[Question] --> [Agent A: Pro]  <---> [Agent B: Con]
                      |                |
                      v                v
              [Round 1: Arguments]
                      |
              [Round 2: Rebuttals]
                      |
              [Round 3: Synthesis]
                      |
              [Judge Agent: Final Decision]
辩论式的优势是能充分探索问题的多个面相,减少单一视角偏见,提升决策质量。劣势是 Token 消耗大(多轮对话),且辩论可能陷入僵局无法收敛。
典型应用场景:高风险决策任务,如"是否应该投资某项目"、"某方案的安全风险评估"。
协作模式对比
| 模式 | 拓扑结构 | 通信开销 | 并行度 | 适用场景 | 主要风险 |
|---|---|---|---|---|---|
| 层级式 | 树状 | 中 | 低 | 复杂任务分解 | 顶层瓶颈 |
| 流水线式 | 链式 | 低 | 无 | 流程化生产 | 级联阻塞 |
| 并行式 | 星状 | 中 | 高 | 多维分析 | 结果冲突 |
| 辩论式 | 网状 | 高 | 无 | 高风险决策 | 不收敛 |
这些模式并非互斥。一个复杂的多 Agent 系统可能在不同层级采用不同模式:外层用层级式分解任务,子任务内部用流水线式执行,关键决策点用辩论式做多视角验证。
7.3 Agent 通信协议与信息交换机制
多 Agent 系统的核心挑战之一是 Agent 之间的通信。通信协议定义了 Agent 怎么交换信息、怎么寻址、怎么确保消息被正确理解,直接决定系统的协作效率和可靠性。
通信模式分类
在多 Agent 系统中,通信模式可以分为两大类:直接通信和间接通信。
直接通信是 Agent 之间显式发送和接收消息,发送方明确知道接收方身份,通过点对点或广播传递------类似人类对话,你明确知道在和谁说话。
间接通信是 Agent 通过共享环境(黑板模型、共享内存、消息队列)交换信息,不直接寻址对方,而是写入共享空间,其他 Agent 自行读取------类似论坛发帖,你不知道谁会看,但感兴趣的人会来读。
以下是两种通信模式的对比:
| 维度 | 直接通信 | 间接通信 |
|---|---|---|
| 寻址方式 | 显式指定接收方 | 通过共享空间 |
| 耦合度 | 高耦合 | 低耦合 |
| 可扩展性 | 差(连接数 O(n^2)) | 好(线性扩展) |
| 消息可靠性 | 高(有确认机制) | 低(无确认) |
| 典型实现 | RPC、消息队列 | 黑板模型、Pub/Sub |
消息格式设计
在 LLM-based 的多 Agent 系统中,消息通常采用结构化格式。以下是一个典型的 Agent 间消息格式:
python
from pydantic import BaseModel
from typing import Optional

class AgentMessage(BaseModel):
    sender: str                    # 发送方 Agent ID
    receiver: str                  # 接收方 Agent ID, "broadcast" 表示广播
    msg_type: str                  # 消息类型: request/response/notify
    content: str                   # 消息正文
    task_id: str                   # 关联的任务 ID
    reply_to: Optional[str] = None # 回复的消息 ID
    metadata: dict = {}            # 附加元数据
    timestamp: str = ""            # 时间戳
消息类型设计是关键。常见类型包括:
- request:请求其他 Agent 执行某项操作
- response:对请求的回复
- notify:通知事件发生,不期待回复
- delegate:将任务委托给其他 Agent
- escalate:向上层 Agent 报告问题或请求决策
通信协议实例:FIPA ACL 参考
在传统多 Agent 研究中,FIPA (Foundation for Intelligent Physical Agents) 定义了一套标准 Agent 通信语言(ACL)。LLM-based Agent 系统很少直接用 FIPA ACL,但它的设计理念值得借鉴。
FIPA ACL 定义了多种通信行为(communicative act),每种有明确语义:
| 行为类型 | 语义 | 在 LLM Agent 中的对应 |
|---|---|---|
| inform | 告知对方某事实 | Agent 返回执行结果 |
| request | 请求对方执行动作 | 委派任务给其他 Agent |
| query | 询问信息 | 检索请求 |
| propose | 提出方案 | 辩论中提出论点 |
| accept/reject | 接受/拒绝提议 | 审查通过/驳回 |
实现层面的通信机制
工程实现中,Agent 间通信通常走以下几种机制:
函数调用模式:最简单的方式,Agent 之间直接函数调用传数据。适用于单进程内多 Agent 系统,如 AutoGen 的 GroupChat。
消息队列模式:通过消息中间件(Redis、RabbitMQ)传递消息。适用于分布式部署,支持异步通信和解耦。
共享状态模式:所有 Agent 读写同一个共享状态对象(黑板模型)。适用于需要全局状态一致性的场景。
python
# 基于共享黑板模型的通信示例
class Blackboard:
    def __init__(self):
        self._data = {}
        self._subscribers = {}

    def write(self, key: str, value: str, writer: str):
        self._data[key] = {"value": value, "writer": writer}
        # 通知订阅了该 key 的 Agent
        for agent in self._subscribers.get(key, []):
            agent.notify(key, value)

    def read(self, key: str) -> str | None:
        entry = self._data.get(key)
        return entry["value"] if entry else None

    def subscribe(self, key: str, agent):
        self._subscribers.setdefault(key, []).append(agent)
通信中的语义理解挑战
与传统的分布式系统不同,LLM Agent 之间的通信面临独特的语义理解挑战。传统系统消息格式严格定义,解析是确定性的;但 LLM Agent 的消息内容是自然语言,存在歧义和误解的可能。
比如 Agent A 发送"请分析这个数据集的趋势",Agent B 可能理解为时间序列分析,也可能理解为统计描述。语义歧义需要通过以下方式缓解:
- 在系统提示词中明确定义每个 Agent 的输入输出格式
- 使用结构化消息(JSON)而非纯自然语言
- 引入确认机制:接收方复述理解,发送方确认
- 建立领域词汇表,减少歧义
7.4 信息一致性与状态同步
多 Agent 系统中,每个 Agent 各自维护独立的上下文和状态。协作时如何保证信息一致性是个核心问题------类似分布式系统的数据一致性,但叠加了自然语言的不确定性。
一致性问题的来源
信息不一致主要来自几个方面:
异步执行导致的信息滞后:并行式协作中,Agent A 和 Agent B 同时开始工作。Agent A 在 t=1 更新了某个共享数据,但 Agent B 在 t=2 读到的还是旧数据。时间差导致的状态不一致在分布式系统中普遍存在。
理解偏差导致的信息失真:Agent A 发了一段自然语言描述的结果,Agent B 理解时可能产生偏差。比如 Agent A 说"测试通过了",Agent B 可能理解为"所有测试都通过了",但 Agent A 其实只是指"当前测试用例通过了"。
推理路径不同导致的结论分歧:面对相同信息,不同角色设定的 Agent 可能得出不同结论。安全审查 Agent 认为某代码存在风险,功能审查 Agent 认为该代码功能正确。分歧不一定是错误,但需要被识别和处理。
状态同步策略
针对不同类型的一致性问题,可以采用不同的同步策略:
强一致性同步:所有 Agent 在关键决策点必须读取最新共享状态,通过锁机制或版本控制确保一致性。适用于关键决策场景,但降低并行度。
python
class StateManager:
    def __init__(self):
        self._state = {}
        self._version = 0
        self._lock = threading.Lock()

    def update(self, key, value, agent_id):
        with self._lock:
            self._state[key] = {
                "value": value,
                "version": self._version + 1,
                "updated_by": agent_id
            }
            self._version += 1

    def read(self, key, min_version=None):
        with self._lock:
            entry = self._state.get(key)
            if not entry:
                return None
            if min_version and entry["version"] < min_version:
                return None  # 版本过旧,拒绝读取
return entry最终一致性同步:允许 Agent 短时间内使用过时信息,通过定期同步最终达到一致。适用于非关键路径,性能更好。
事件溯源模式:不存当前状态,只存所有状态变更事件。Agent 通过重放事件重建状态。天然支持审计和回溯,适合需要调试的多 Agent 系统。
冲突检测与解决
当多个 Agent 对同一问题给出不同结论时,系统需要冲突检测和解决机制:
投票机制:多个 Agent 投票,少数服从多数。适用于客观事实类问题,如代码是否通过编译。
优先级机制:为不同 Agent 设定优先级,冲突时采用高优先级 Agent 的结论。适用于有明确专业层级差异的场景,如安全问题的最终决定权归安全专家 Agent。
升级机制:Agent 间无法解决冲突时,把问题升级到上层 Agent 或人类决策者。适用于高风险决策。
辩论机制:冲突双方各自阐述理由,由第三方 Agent 裁决。适用于需要深度分析的问题,对应 7.7 节的 Agent Debate。
上下文管理的工程实践
工程实践中,一个有效的做法是维护一个"会话状态对象"(Session State Object),所有 Agent 共享只读视图,只有特定的协调 Agent 有写权限。
python
class SessionState:
    """多 Agent 共享的会话状态"""
    def __init__(self, task_id: str):
        self.task_id = task_id
        self.facts: dict = {}        # 已确认的事实
        self.artifacts: dict = {}    # 产出物(代码、文档等)
        self.open_questions: list = []  # 待解决的问题
        self.decisions: list = []    # 已做的决策

    def add_fact(self, key, value, source_agent):
        self.facts[key] = {
            "value": value,
            "source": source_agent,
            "confirmed": False
        }

    def confirm_fact(self, key, confirming_agent):
        if key in self.facts:
            self.facts[key]["confirmed"] = True
            self.facts[key]["confirmed_by"] = confirming_agent

    def get_snapshot(self) -> dict:
        """返回只读快照给各 Agent"""
        return {
            "facts": dict(self.facts),
            "artifacts": dict(self.artifacts),
            "open_questions": list(self.open_questions),
            "decisions": list(self.decisions)
        }
该设计保证了状态一致性和可追溯性:每个事实有来源标记,每个决策有记录,便于事后审计和调试。
7.5 主流框架对比:AutoGen、CrewAI、LangGraph
当前多 Agent 领域有三个主流框架,各自代表不同的设计哲学。理解它们的差异对选型和面试都很重要。
AutoGen
AutoGen 是微软研究院开发的多 Agent 对话框架,核心理念:通过 Agent 之间的对话来完成任务。最经典的模式是 GroupChat------多个 Agent 在一个群聊中交互,由管理 Agent 控制发言顺序。
AutoGen 的设计特点是"对话优先"。Agent 之间所有交互都是自然语言对话,框架管理对话历史和发言轮转。这让它非常适合需要大量自然语言交流的任务,如头脑风暴、方案讨论。
python
import autogen

# 创建 Agent
researcher = autogen.AssistantAgent(
    name="Researcher",
    system_prompt="你是一位研究员,负责收集和分析信息。",
    llm_config={"model": "gpt-4"}
)

coder = autogen.AssistantAgent(
    name="Coder",
    system_prompt="你是一位程序员,负责编写代码。",
    llm_config={"model": "gpt-4"}
)

user_proxy = autogen.UserProxyAgent(
    name="User",
    human_input_mode="NEVER",
    max_consecutive_auto_reply=5
)

# 创建 GroupChat
groupchat = autogen.GroupChat(
    agents=[user_proxy, researcher, coder],
    messages=[],
    max_round=10
)

manager = autogen.GroupChatManager(groupchat=groupchat)
user_proxy.initiate_chat(manager, message="研究并实现一个快速排序算法")
CrewAI
CrewAI 是以"角色扮演"为核心的多 Agent 框架。设计理念:每个 Agent 扮演明确角色,拥有特定目标、背景和工具集。CrewAI 强调"crew"(团队)概念,通过任务(Task)和流程(Process)组织协作。
CrewAI 的特点是"角色驱动"。每个 Agent 的行为主要由角色定义决定,而非对话历史,行为更加可预测,适合流程化任务。
python
from crewai import Agent, Task, Crew, Process

researcher = Agent(
    role='市场研究员',
    goal='收集目标市场的关键数据',
    backstory='你是一位资深市场分析师,擅长数据收集和分析。',
    verbose=True
)

writer = Agent(
    role='内容撰写人',
    goal='基于研究结果撰写报告',
    backstory='你是一位专业技术作家,擅长将复杂数据转化为易读报告。',
    verbose=True
)

research_task = Task(
    description='分析 2024 年 AI Agent 市场规模和趋势',
    agent=researcher,
    expected_output='一份包含数据和分析的市场研究报告'
)

write_task = Task(
    description='基于研究报告撰写一份面向投资者的摘要',
    agent=writer,
    expected_output='一份 500 字的投资摘要'
)

crew = Crew(
    agents=[researcher, writer],
    tasks=[research_task, write_task],
    process=Process.sequential
)

result = crew.kickoff()
LangGraph
LangGraph 是 LangChain 团队推出的基于图结构的多 Agent 编排框架,核心理念:将 Agent 协作建模为状态图(State Graph),节点是 Agent 或处理函数,边是状态转移逻辑。
LangGraph 的特点是"图驱动"。它不预设特定协作模式,而是通过图的拓扑结构定义任意复杂的协作流程。灵活性最高,学习成本也最高。
python
from langgraph.graph import StateGraph, END
from typing import TypedDict, Annotated
import operator

class AgentState(TypedDict):
    messages: Annotated[list, operator.add]
    next_agent: str

def research_node(state: AgentState):
    # 研究Agent的处理逻辑
    return {"messages": [{"role": "assistant", "content": "研究完成"}]}

def review_node(state: AgentState):
    # 审查Agent的处理逻辑
    return {"messages": [{"role": "assistant", "content": "审查通过"}]}

def router(state: AgentState) -> str:
    last_msg = state["messages"][-1]["content"]
    if "需要修改" in last_msg:
        return "research"
    return "end"

# 构建状态图
workflow = StateGraph(AgentState)
workflow.add_node("research", research_node)
workflow.add_node("review", review_node)

workflow.set_entry_point("research")
workflow.add_conditional_edges("review", router, {
    "research": "research",
    "end": END
})
workflow.add_edge("research", "review")

app = workflow.compile()
result = app.invoke({"messages": [{"role": "user", "content": "开始任务"}]})
框架详细对比
| 维度 | AutoGen | CrewAI | LangGraph |
|---|---|---|---|
| 开发者 | 微软研究院 | CrewAI Inc. | LangChain |
| 核心理念 | 对话驱动 | 角色驱动 | 图结构驱动 |
| 协作模式 | 主要是群聊对话 | 顺序/层级流程 | 任意自定义图 |
| 状态管理 | 对话历史 | 任务状态 | 显式状态图 |
| 灵活性 | 中等 | 较低 | 最高 |
| 学习成本 | 中等 | 最低 | 最高 |
| 人类介入 | 内置支持 | 有限 | 完全可控 |
| 流程控制 | GroupChat Manager | Process 参数 | 条件边+循环 |
| 适用场景 | 开放式讨论 | 流程化任务 | 复杂工作流 |
| 工具集成 | 自动工具调用 | 自定义工具 | LangChain 生态 |
| 持久化 | 对话保存 | 有限 | 检查点机制 |
| 分布式 | 支持 | 不支持 | 支持 |
选型建议
选型时考虑任务特性和团队能力:
如果任务需要开放式讨论和灵活的 Agent 交互,对话过程可能产生不可预测的分支,AutoGen 的 GroupChat 最合适。比如头脑风暴、方案评审等探索性任务。
如果任务有明确流程定义,每步有清晰的输入输出,角色分工明确,CrewAI 的角色驱动模式最简洁高效。比如内容生产流水线、标准化报告生成。
如果任务流程复杂,包含条件分支、循环、并行执行、人在回路等多种控制流,且需要精确控制状态转移,LangGraph 提供了最强大的表达能力。比如复杂的 RAG (Retrieval-Augmented Generation, 检索增强生成) 工作流、多阶段审批流程。
实际项目中也可以混合使用。比如用 LangGraph 构建整体工作流框架,在特定节点用 AutoGen 的 GroupChat 做开放式讨论。
7.6 角色定义与任务分配策略
多 Agent 系统的设计核心之一是角色定义。角色定义决定 Agent 的行为边界、专业领域和交互方式。一个好的角色定义应该包含以下要素:
角色定义的要素
身份描述:Agent 是谁,具备什么专业背景,直接影响 LLM 的生成倾向。"你是一位有 10 年经验的网络安全工程师"比"你是安全 Agent"更能引导出专业分析。
职责边界:Agent 负责什么,不负责什么。明确边界避免角色重叠和职责真空。比如"你只负责代码安全审查,不负责功能正确性检查"。
行为规范:Agent 应该如何执行任务,包括输出格式、思考方式、与他人的交互规则。比如"你的输出必须包含风险等级(高/中/低)和具体建议"。
工具集:Agent 可以使用哪些工具,应该与角色职责匹配,避免过度授权。审查 Agent 不该有代码修改权限,只能提出建议。
以下是一个完整的角色定义示例:
python
# 角色定义模板
SECURITY_AUDITOR_PROMPT = """
## 身份
你是一位具有 15 年经验的网络安全审计工程师,精通 OWASP Top 10
漏洞分析和安全编码规范。

## 职责
- 审查代码中的安全漏洞(SQL注入、XSS、CSRF等)
- 评估安全风险等级(高/中/低)
- 提供修复建议和改进方案

## 限制
- 不负责功能正确性验证(由功能测试Agent负责)
- 不直接修改代码(只提出建议)
- 对于不确定的安全问题,标注"需进一步验证"

## 输出格式
{
    "risk_level": "高/中/低",
    "vulnerability_type": "漏洞类型",
    "description": "漏洞描述",
    "location": "代码位置",
    "fix_suggestion": "修复建议"
}
"""
任务分配策略
任务分配是多 Agent 系统的调度核心。好的分配策略应该考虑:
能力匹配:把任务分给具备相应能力的 Agent,系统要维护 Agent 能力描述表。
负载均衡:避免某些 Agent 过载而其他空闲。有多个同类 Agent 时,按负载分配。
依赖顺序:尊重任务间的依赖关系。任务 B 依赖任务 A 的输出,就必须等 A 完成后再分配 B。
优先级:高优先级任务应优先分配和执行。
以下是一个基于能力的任务分配器示例:
python
class TaskAllocator:
    def __init__(self):
        self.agents = {}  # agent_id -> capability list
        self.agent_load = {}  # agent_id -> current task count

    def register_agent(self, agent_id, capabilities):
        self.agents[agent_id] = capabilities
        self.agent_load[agent_id] = 0

    def allocate(self, task):
        """根据任务需求分配最合适的Agent"""
        required_caps = task.get("required_capabilities", [])
        candidates = []

        for agent_id, caps in self.agents.items():
            # 检查能力匹配
            if all(cap in caps for cap in required_caps):
                candidates.append((agent_id, self.agent_load[agent_id]))

        if not candidates:
            return None  # 无可用Agent

        # 选择负载最低的候选Agent
        candidates.sort(key=lambda x: x[1])
        chosen = candidates[0][0]
        self.agent_load[chosen] += 1
        return chosen

    def release(self, agent_id):
        """任务完成后释放Agent负载"""
        self.agent_load[agent_id] = max(0, self.agent_load[agent_id] - 1)
角色设计的常见陷阱
角色定义过于宽泛:"你是一个有用的助手"几乎没有角色约束。LLM 没有明确角色定位时,行为趋于平庸和泛化。
角色之间存在大面积重叠:两个 Agent 职责高度重叠会导致冗余工作和潜在冲突。"代码审查 Agent"和"质量检查 Agent"如果没有清晰边界,可能对同一段代码给出重复或矛盾的意见。
角色定义忽略约束:只定义了 Agent 应该做什么,没定义不应该做什么。缺少约束的 Agent 可能过度发挥,越界操作。
忽视角色间的权力关系:在层级式等协作模式中,Agent 之间存在上下级关系。角色定义中如果不体现权力关系,Agent 可能不服从调度或越权决策。
动态角色分配
在更高级的多 Agent 系统中,角色不是预先固定的,而是根据任务动态分配。Orchestrator Agent 根据任务需求从角色池中选择合适的角色组合,动态实例化 Agent。
动态分配的优势是灵活:同一套系统可以处理不同类型任务,每次只激活需要的角色。劣势是不可预测:难以预先知道哪些 Agent 会被激活,增加调试难度。
7.7 Agent Debate:多视角碰撞提升决策质量
Agent Debate 是多 Agent 系统中一种特殊的协作模式,让多个 Agent 从不同视角对同一问题辩论,以提升决策质量。受到人类社会中"对抗性审议"(Adversarial Deliberation)的启发:通过正反双方的激烈辩论,揭示问题各个面相,避免单一视角盲点。
Agent Debate 的理论基础
Agent Debate 的理论基础可以追溯到几个研究领域:
德尔菲法(Delphi Method):结构化的专家咨询方法,通过多轮匿名问卷调查收集专家意见,每轮结束后反馈汇总结果,专家据此调整观点。Agent Debate 借鉴了多轮迭代和反馈调整的理念。
红蓝对抗(Red Teaming / Blue Teaming):来自网络安全领域,红队攻击、蓝队防守,通过对抗性测试发现薄弱环节。Agent Debate 把对抗性思维推广到一般决策场景。
批判性思维理论:有效决策不仅需要支持论据,还需要考虑反对论据。单一 Agent 容易出现"确认偏误"(Confirmation Bias),倾向于寻找支持自己观点的证据。多个不同立场的 Agent 可以相互制衡。
Agent Debate 的流程设计
一个典型的 Agent Debate 流程包含以下阶段:
bash
[输入: 待决策问题]
        |
        v
[阶段1: 立场生成] -- 多个Agent分别给出初始立场和论据
        |
        v
[阶段2: 论辩交锋] -- 各Agent看到其他Agent的论据后进行反驳
        |          (可多轮, 通常2-3轮)
        v
[阶段3: 立场调整] -- Agent根据辩论内容调整自己的立场
        |
        v
[阶段4: 共识综合] -- Judge Agent综合所有论据, 给出最终决策
        |
        v
[输出: 决策结果 + 理由 + 风险提示]
每个阶段的设计要点如下:
立场生成阶段:各 Agent 独立分析问题,不知道其他 Agent 的观点,确保初始立场独立性,避免"锚定效应"(Anchoring Bias)。
论辩交锋阶段:各 Agent 看到其他 Agent 的论据后提出反驳。关键要求 Agent 不仅反驳对方,还要回应对方对自己的反驳。"交叉质询"机制能深入挖掘问题。
立场调整阶段:允许 Agent 根据辩论内容调整立场。设计良好的 Debate 系统应该鼓励 Agent 在遇到有力论据时改变观点,而不是固执己见。
共识综合阶段:由中立的 Judge Agent 综合所有论据,做出最终决策,可以采用投票、加权评分或综合分析等方式。
代码实现示例
以下是一个简化的 Agent Debate 实现:
python
import json

class DebateAgent:
    def __init__(self, name, stance, llm_client):
        self.name = name
        self.stance = stance  # "pro" or "con"
        self.llm = llm_client
        self.arguments = []

    def generate_argument(self, question, context=""):
        prompt = f"""
        问题: {question}
        你的立场: {"支持" if self.stance == "pro" else "反对"}
        已有论据: {context}

        请给出你的论据(不超过200字), 包含:
        1. 核心观点
        2. 支撑理由
        3. 对对方论据的反驳(如有)
        """
        response = self.llm.complete(prompt)
        self.arguments.append(response)
        return response

class JudgeAgent:
    def __init__(self, llm_client):
        self.llm = llm_client

    def decide(self, question, all_arguments):
        prompt = f"""
        问题: {question}
        正反方论据记录:
        {json.dumps(all_arguments, ensure_ascii=False, indent=2)}

        请作为中立裁判:
        1. 总结双方核心论据
        2. 评估各方论据的说服力(1-10分)
        3. 给出最终决策和理由
        4. 标注残余风险
        """
        return self.llm.complete(prompt)

def run_debate(question, pro_agent, con_agent, judge, rounds=3):
    transcript = {"question": question, "rounds": []}
    context = ""

    for r in range(rounds):
        pro_arg = pro_agent.generate_argument(question, context)
        con_arg = con_agent.generate_argument(question, pro_arg)
        context += f"\nRound {r+1}:\nPro: {pro_arg}\nCon: {con_arg}"
        transcript["rounds"].append({"pro": pro_arg, "con": con_arg})

    decision = judge.decide(question, transcript["rounds"])
    transcript["decision"] = decision
    return transcript
Debate 的变体模式
除了经典的正反双方辩论,Agent Debate 还有几种变体:
多视角辩论:不限于正反两方,可以有多个不同视角的 Agent。评估技术方案时,可以有性能视角、安全视角、成本视角和用户体验视角的 Agent,各自从专业角度提出论据。
红蓝绿对抗:安全评估场景中,红队 Agent 发现漏洞,蓝队 Agent 防御论证,绿队 Agent 提出改进方案。三方博弈形成更完整的评估闭环。
自我辩论:单个 Agent 轮流扮演正方和反方,通过内部对话自我审查。不如多 Agent 辩论有效,但成本更低,适用于资源受限场景。
Debate 的效果与局限
研究表明,Agent Debate 在以下场景中效果显著:
- 需要权衡利弊的决策问题(如技术选型、方案评审)
- 需要多维度评估的风险分析(如安全评估、合规审查)
- 创意生成任务(通过观点碰撞激发新思路)
但 Agent Debate 也有明显的局限:
成本问题:多轮辩论意味着多次 LLM 调用,Token 消耗是单 Agent 的数倍。对简单决策不划算。
收敛问题:辩论可能陷入僵局,双方都无法说服对方,最终还是靠 Judge 裁决。如果 Judge 能力不足,辩论的价值大打折扣。
虚假辩论风险:如果所有 Agent 基于同一个 LLM,它们的"观点差异"可能只是表面文章,实质上仍受模型训练数据偏见影响。真正的多视角需要不同模型或不同参数配置来保证多样性。
7.8 人在回路的多 Agent 系统
人在回路(Human-in-the-Loop, HITL)的多 Agent 系统是指在 Agent 自动化流程的关键节点引入人类决策的协作模式。尽管 LLM Agent 能力在提升,但在高风险决策、模糊判断和创造性任务中,人类参与仍然不可或缺。
为什么需要人在回路
人在回路的需求主要来自:
准确性保障:法律分析、医疗诊断、金融决策等高风险领域,Agent 输出需要人类专家审核后才能执行。完全自动化的风险过高,一个错误决策可能带来严重后果。
模糊性消解:任务描述存在歧义,或 Agent 执行中遇到多种合理路径时,需要人类消解模糊性、选择方向。开放性任务中尤为常见。
创造性引导:创意写作、产品设计等需要人类审美和创造力的任务中,Agent 输出往往需要人类引导和调整才能达到理想效果。
合规与审计:受监管行业中,关键决策必须有人类参与和签字,这是法规要求,不是技术选择。
人在回路的介入点设计
人在回路系统设计的关键是选择介入点。并非每个环节都需要人类参与,过度介入会抵消自动化效率。几种常见介入模式:
审批式介入:Agent 完成全部工作后,结果提交人类审批,人类可以批准、驳回或要求修改。最轻量级的介入,适用于 Agent 能力成熟、错误率低的场景。
python
class HumanApprovalGate:
    def __init__(self, auto_execute=False):
        self.auto_execute = auto_execute

    async def review(self, agent_output, context):
        if self.auto_execute:
            return {"approved": True, "feedback": ""}

        # 展示结果给人类, 等待审批
        display_result(agent_output, context)
        human_response = await wait_for_human_input()

        return {
            "approved": human_response.get("approved", False),
            "feedback": human_response.get("feedback", ""),
            "modifications": human_response.get("modifications", None)
}检查点式介入:在任务流程的特定节点设置检查点,Agent 执行到检查点时擅停,等待人类确认后继续。适用于多阶段任务中关键转折点的质量控制。
交互式介入:人类可以在 Agent 执行过程中随时介入,提供指导、修改方向或纠正错误。最灵活,但对系统实时性要求最高,通常需要 Agent 支持中断和恢复机制。
升级式介入:Agent 遇到无法处理的情况时,主动请求人类帮助。要求 Agent 具备自我评估能力,能识别自身局限。
介入点选择框架
选择介入点时考虑:
| 因素 | 偏向自动化的条件 | 偏向人工介入的条件 |
|---|---|---|
| 风险等级 | 低风险,可逆操作 | 高风险,不可逆操作 |
| 任务复杂度 | 结构化,规则明确 | 非结构化,需判断力 |
| Agent 置信度 | 高置信度(>90%) | 低置信度或不确定 |
| 错误代价 | 错误容易发现和纠正 | 错误代价高或难以发现 |
| 合规要求 | 无特殊合规要求 | 法规要求人工审核 |
| 频率 | 高频重复任务 | 低频一次性任务 |
人在回路的工程实现
工程实现层面,人在回路需要解决几个技术问题:
异步等待:Agent 等待人类响应时需要暂停执行,不占用计算资源,通常通过异步编程和消息队列实现。
上下文保持:人类响应可能需要数小时甚至数天,期间需要保持 Agent 执行上下文,恢复后继续执行。系统必须具备状态持久化能力。
超时处理:人类可能未在预期时间内响应,系统需要定义超时策略:无限等待、使用默认决策、还是标记为失败。
多审批人协作:需要多个审批人时,要定义审批规则:全部同意才通过、多数同意即可、还是有优先级之分。
python
class HITLOrchestrator:
    def __init__(self, agents, checkpoints, timeout=3600):
        self.agents = agents
        self.checkpoints = set(checkpoints)
        self.timeout = timeout

    async def run(self, task):
        state = {"task": task, "results": {}, "status": "running"}

        for step in task.steps:
            # 执行Agent
            result = await self.agents[step.agent].execute(step)
            state["results"][step.id] = result

            # 检查是否需要人工审核
            if step.id in self.checkpoints:
                approval = await self.request_human_review(
                    result, step, state
                )

                if not approval["approved"]:
                    # 根据反馈调整或终止
                    if approval.get("retry"):
                        step.prompt = approval["feedback"]
                        continue  # 重新执行
                    else:
                        state["status"] = "rejected"
                        state["rejection_reason"] = approval["feedback"]
                        return state

        state["status"] = "completed"
        return state

    async def request_human_review(self, result, step, state):
        # 发送通知给人类审核者
        notify_reviewers(result, step)

        # 异步等待响应
        try:
            response = await asyncio.wait_for(
                self.wait_for_approval(step.id),
                timeout=self.timeout
            )
            return response
        except asyncio.TimeoutError:
            return {
                "approved": False,
                "feedback": "审核超时, 已自动拒绝"
            }
人在回路与 Agent 自主性的平衡
人在回路系统的设计本质是在自动化效率和人类控制之间找平衡。过多介入降低效率,Agent 论为"高级表单填写工具";过少介入则错误累积,失去质量保障。
一个有效策略是"动态介入":根据 Agent 置信度和任务风险等级动态调整介入级别。高置信度、低风险自动执行;低置信度、高风险必须人工审核。这既保证关键节点质量控制,又最大化自动化效率。
随着 Agent 能力提升和信任建立,系统可以逐步减少人工介入频率,从"每步审批"过渡到"抽检审核",最终达到"异常触发审核"。渐进式放权策略在工业实践中被广泛采用。
实际应用案例
软件开发领域有一个典型的案例:
需求分析 Agent 自动解析用户需求,生成技术方案草案;架构师(人类)审核方案,确认技术选型和系统架构;开发 Agent 根据审核通过的方案编写代码;代码审查 Agent 做自动化审查,高风险修改需高级开发者(人类)确认;测试 Agent 编写并执行测试用例;测试通过后自动部署到预发环境;发布到生产环境需要运维工程师(人类)最终审批。
流程中人类介入了两个关键节点:方案审核和发布审批。其余环节由 Agent 自动完成,既保证关键决策质量,又保持流程效率。
本章知识点总结
| 知识点 | 核心内容 | 关键要点 |
|---|---|---|
| 多 Agent 系统概述 | 单 Agent 的瓶颈与多 Agent 的优势 | 上下文竞争、角色混淆、工具爆炸是多 Agent 的驱动力 |
| 协作模式 | 层级式、流水线式、并行式、辩论式 | 不同模式适用于不同任务,实际系统常混合使用 |
| 通信协议 | 直接通信与间接通信、消息格式设计 | 语义理解是 LLM Agent 通信的独特挑战 |
| 状态同步 | 一致性问题来源与同步策略 | 强一致性、最终一致性、事件溯源三种模式 |
| 框架对比 | AutoGen、CrewAI、LangGraph | 对话驱动、角色驱动、图驱动三种设计哲学 |
| 角色定义 | 身份、职责、规范、工具集四要素 | 角色定义需避免宽泛、重叠、缺约束 |
| Agent Debate | 多轮辩论提升决策质量 | 包含立场生成、论辩交锋、立场调整、共识综合四阶段 |
| 人在回路 | 关键节点引入人类决策 | 介入点选择应基于风险等级、置信度、合规要求 |
| 任务分配 | 能力匹配、负载均衡、依赖顺序 | 动态角色分配提升系统灵活性 |
| 通信行为类型 | inform/request/query/propose | 借鉴 FIPA ACL 的语义分类设计消息类型 |
| 冲突解决 | 投票、优先级、升级、辩论 | 不同机制适用于不同冲突类型 |
| HITL 介入模式 | 审批式、检查点式、交互式、升级式 | 动态介入根据置信度和风险等级调整级别 |