💕💕作者:计算机源码社
💕💕个人简介:本人八年开发经验,擅长Java、Python、PHP、.NET、Node.js、Spark、hadoop、Android、微信小程序、爬虫、大数据、机器学习等,大家有这一块的问题可以一起交流!
💕💕学习资料、程序开发、技术解答、文档报告
💕💕如需要源码,可以扫取文章下方二维码联系咨询
💕💕Java项目
💕💕微信小程序项目
💕💕Android项目
💕💕Python项目
💕💕PHP项目
💕💕ASP.NET项目
💕💕Node.js项目
💕💕大数据项目
💕💕选题推荐
基于大数据的温室气体排放检测与评估的数据分析与可视化
文章目录
1、研究背景
在全球气候变化加剧和"双碳"目标持续推进的背景下,温室气体排放的监测、评估与治理已成为国家、区域和行业关注的重点。OWID 温室气体排放公开数据覆盖多个国家、地区和年份,包含二氧化碳、甲烷、氧化亚氮、总温室气体、人口、GDP、能源消费、燃料结构、碳强度、温升贡献等大量指标,数据体量大、维度多、时间跨度长,传统单机处理和简单统计方式难以完成高效清洗、计算与多角度评估。Hadoop 与 Spark 技术能够为海量数据的分布式存储和并行计算提供支撑,Python 生态中的 pandas、sklearn 又能为机器学习建模和结果输出提供便利。围绕全球温室气体排放检测评估与可视化需求,构建基于 Hadoop+Spark 的数据分析与可视化系统,能够把原始公开数据转化为可供监管、研究和展示使用的结构化结果,顺应大数据技术在生态环境领域应用的趋势。
2、研究目的和意义
系统开发目的在于依托 OWID 温室气体排放公开数据,建立一套从数据上传、清洗预处理到多维分析、机器学习挖掘和 CSV 结果输出的完整流程,为全球温室气体排放检测评估与可视化提供数据支撑。系统通过 Hadoop/HDFS 完成数据目录管理和原始文件上传,借助 pandas 与 Spark 对国家、年份、ISO 编码、人口、二氧化碳、人均排放、累计排放、全球份额、煤油气排放、GDP、碳强度、甲烷、氧化亚氮、总温室气体等字段进行缺失检查、实体类型划分、中英文映射和数值规范化处理,并围绕排放总量、人均排放、燃料结构、碳强度、能耗强度、气种分布、大洲与收入组差异、全球演变趋势、国家分群、异常识别和压力降维等主题开展计算,形成标准 CSV 分析结果,满足检测评估、风险画像和可视化展示的需要。
系统开发意义体现在数据治理、评估分析和决策支持等多个层面。对科研与教学而言,系统把 OWID 温室气体排放数据转化为可复用的预处理数据和多主题分析结果,能够支持全球排放格局、区域差异、气种贡献和演变趋势的研究。对管理与决策而言,排放总量排名、人均排放、全球份额、累计排放、高排国家清单、国家分群、异常排放识别和综合压力得分等内容,有助于识别重点排放国家、异常排放模式和不同类型国家画像,为减排政策制定、国际比较和风险预警提供参考。对技术应用而言,Hadoop、Spark、pandas、sklearn、KMeans、Isolation Forest 与 PCA 的组合,展示了大数据平台与机器学习方法在温室气体排放检测评估中的实践价值,并为后续 Web 可视化大屏和交互分析系统提供数据接口与结果支撑。
3、系统研究内容
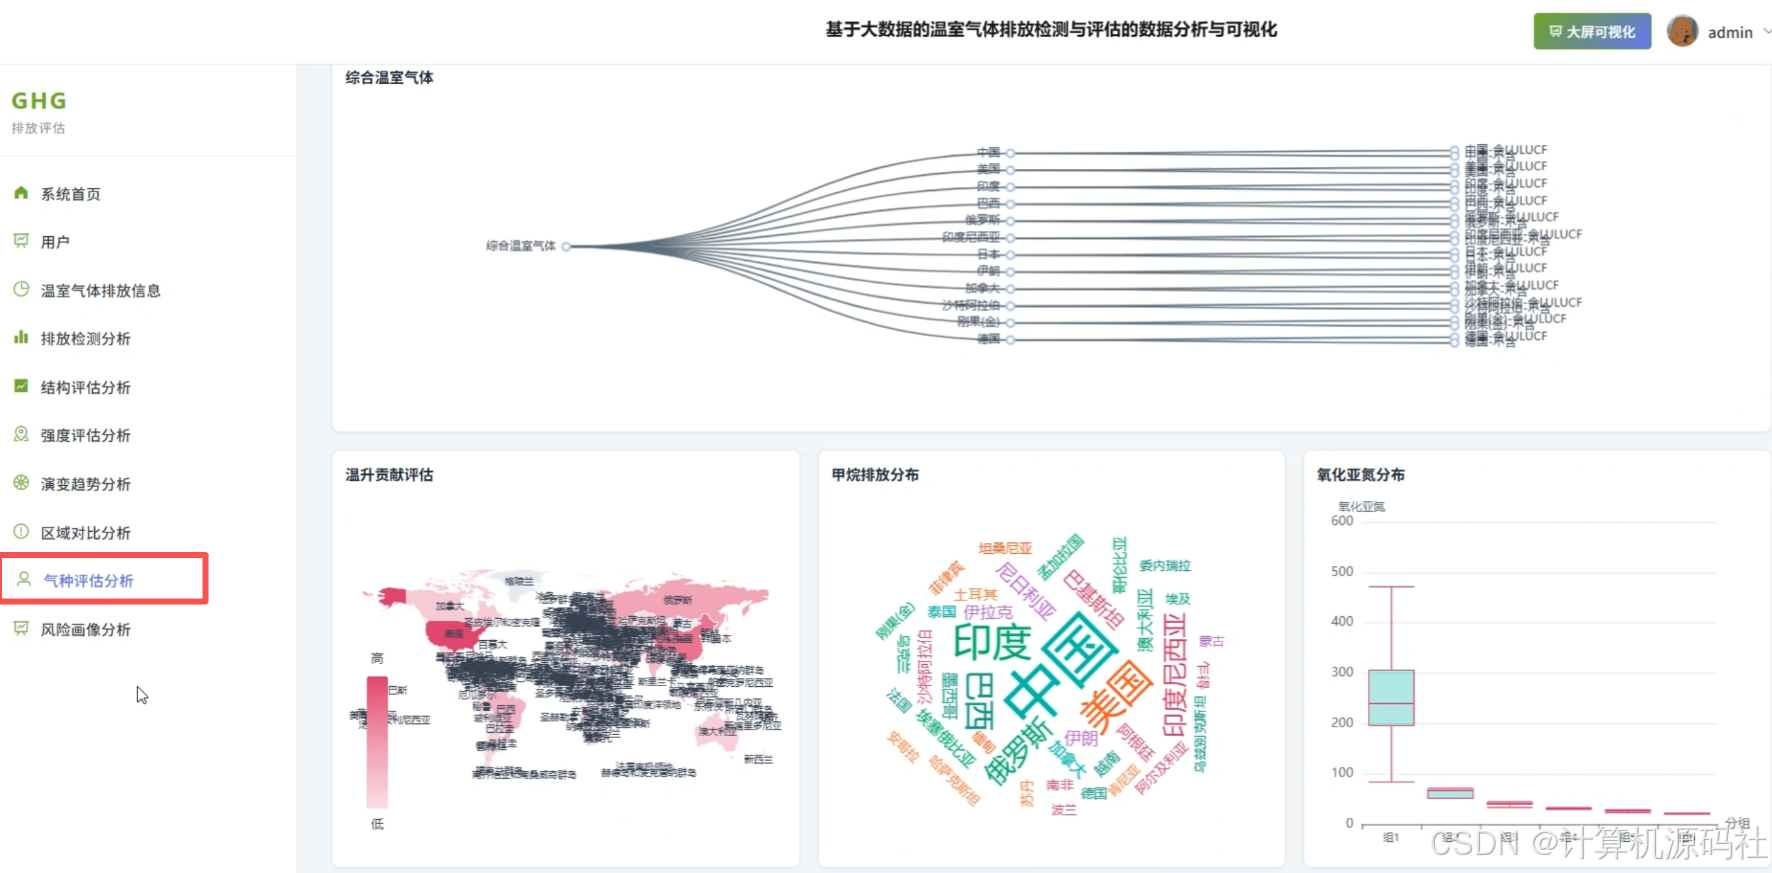
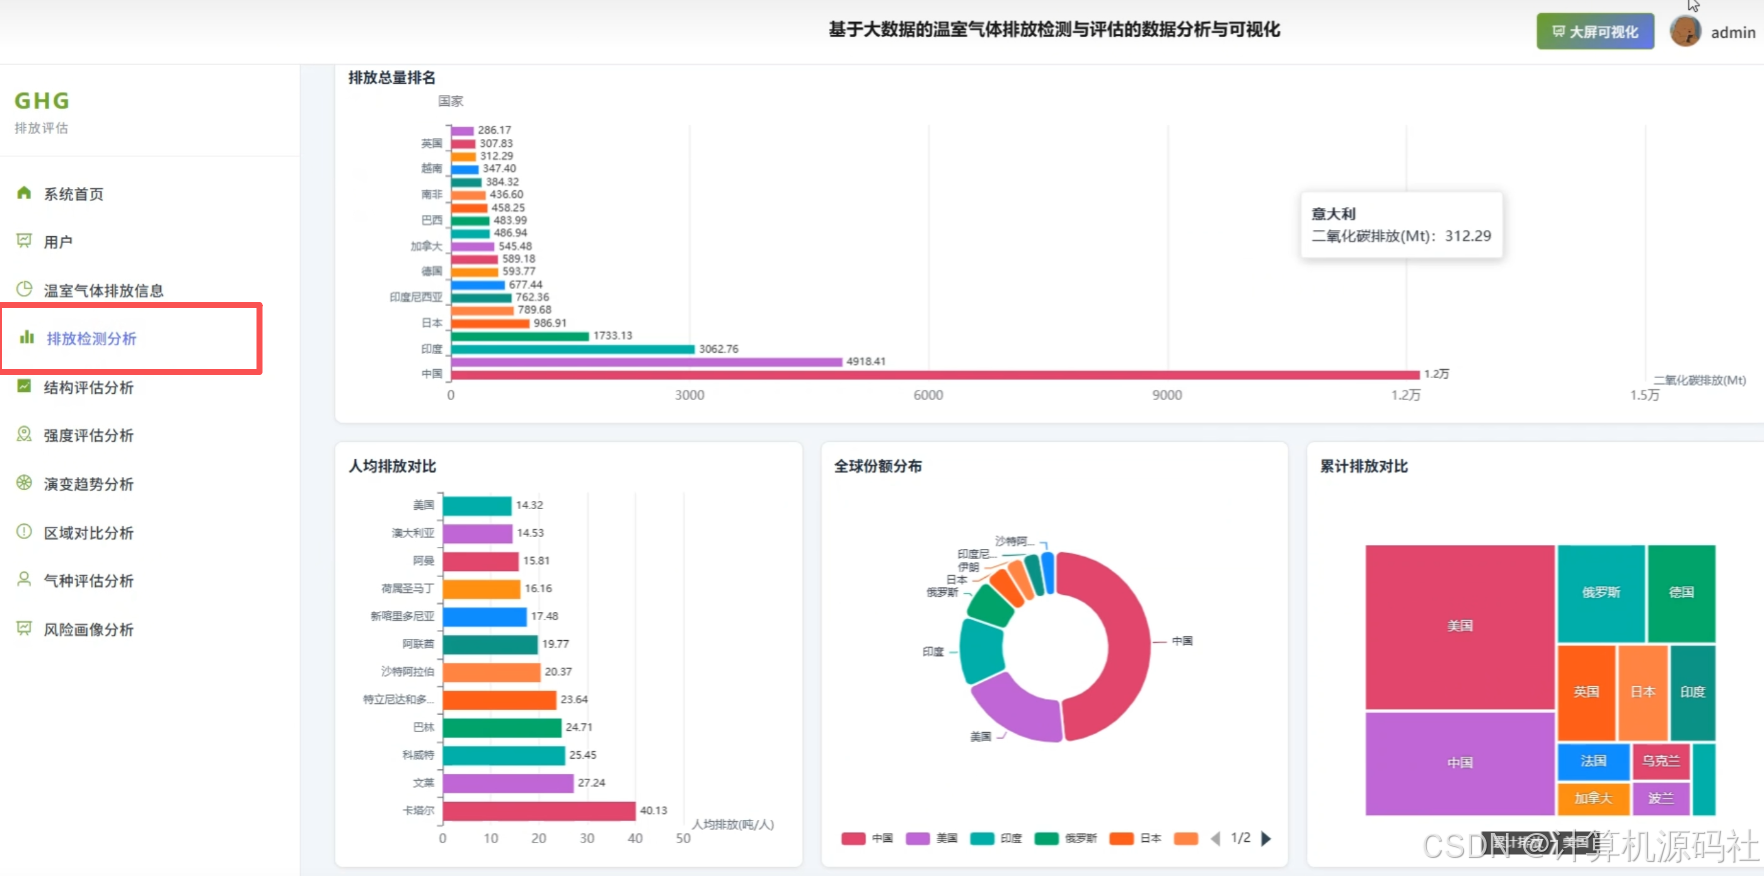
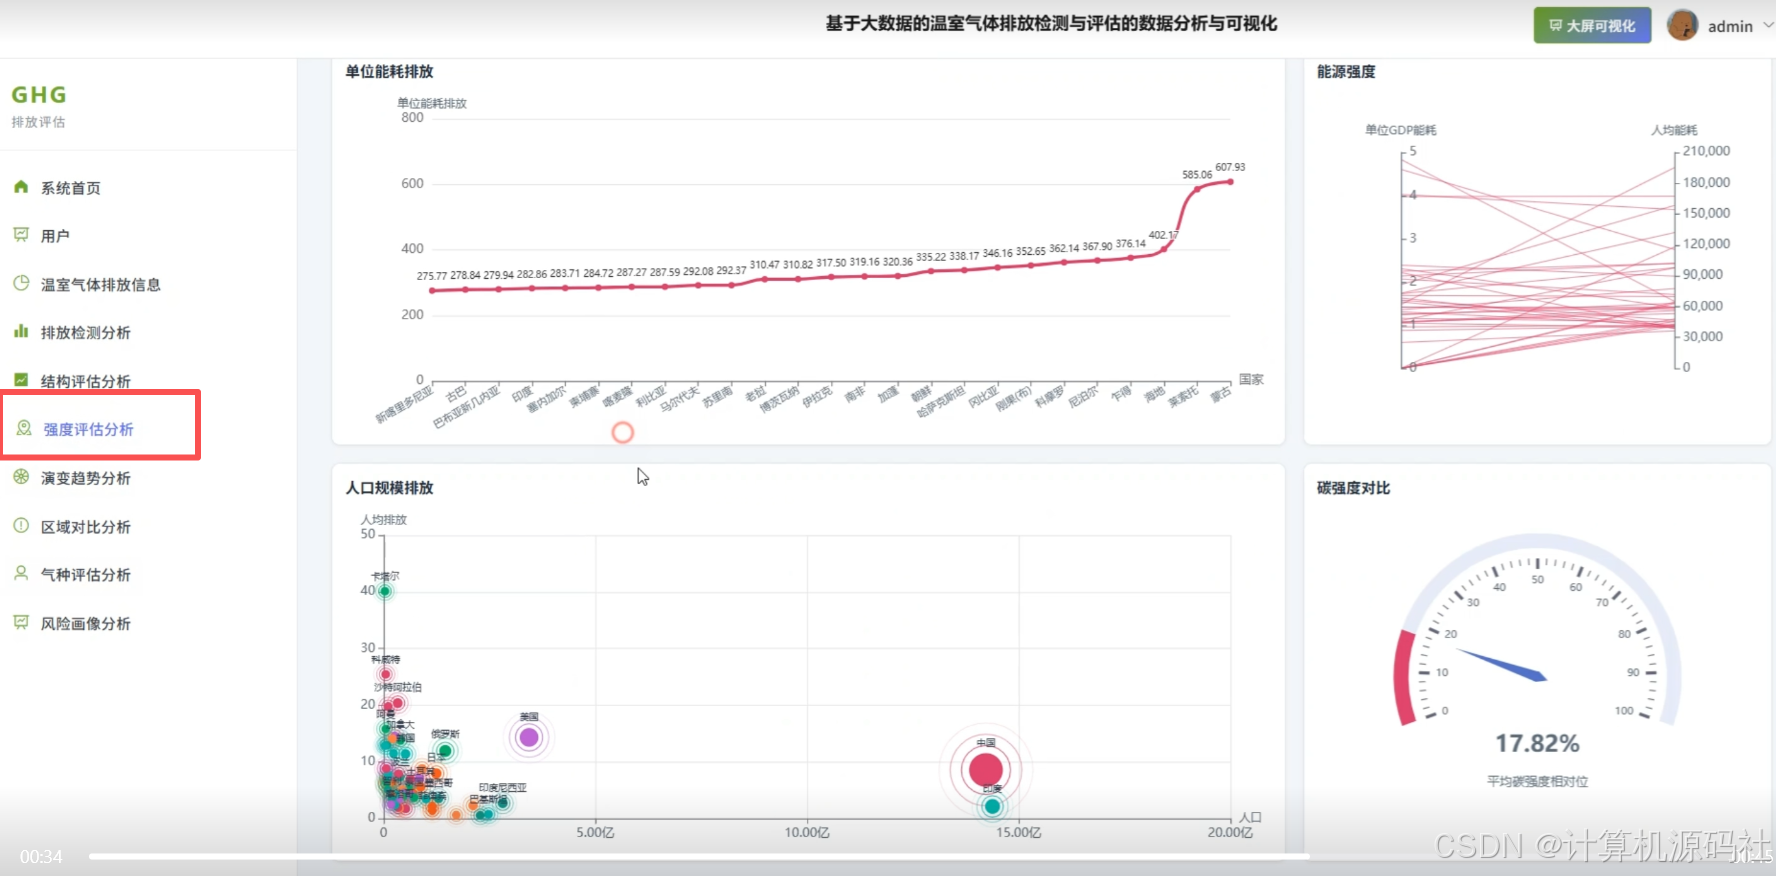
系统开发内容围绕 GreenhouseGasEmissionSystem.py 展开,覆盖原始数据上传、清洗预处理、Spark 分析、机器学习挖掘和 CSV 结果输出。数据上传部分通过 Hadoop 命令检查 SafeMode、重建 HDFS 项目目录,把 owid-co2-data.csv 上传到 dataset 目录;预处理部分读取原始数据,检查核心字段缺失情况,统一 iso_code 空值,完成国家名中英文映射和 entity_type 划分,对浮点字段保留两位小数,并把预处理结果保存到本地和 HDFS。分析部分使用 SparkSession 读取预处理 CSV,按 emission_detect_analysis、structure_assess_analysis、intensity_assess_analysis、ghg_species_analysis、region_compare_analysis、trend_evolution_analysis、risk_profile_analysis 等主题,计算排放总量排名、人均排放、全球份额、累计排放、煤油气结构、水泥占比、火炬排放、能源关联、碳强度、单位能耗排放、能源强度、人口规模排放、甲烷、氧化亚氮、综合温室气体、温升贡献、大洲与收入组差异、高排国家、土地利用、全球曲线、增速变化、累计路径、近年增减态势等内容,并使用 KMeans 进行国家分群、Isolation Forest 进行异常识别、PCA 进行综合压力降维,输出供检测评估与可视化使用的 CSV 文件。
4、系统页面设计
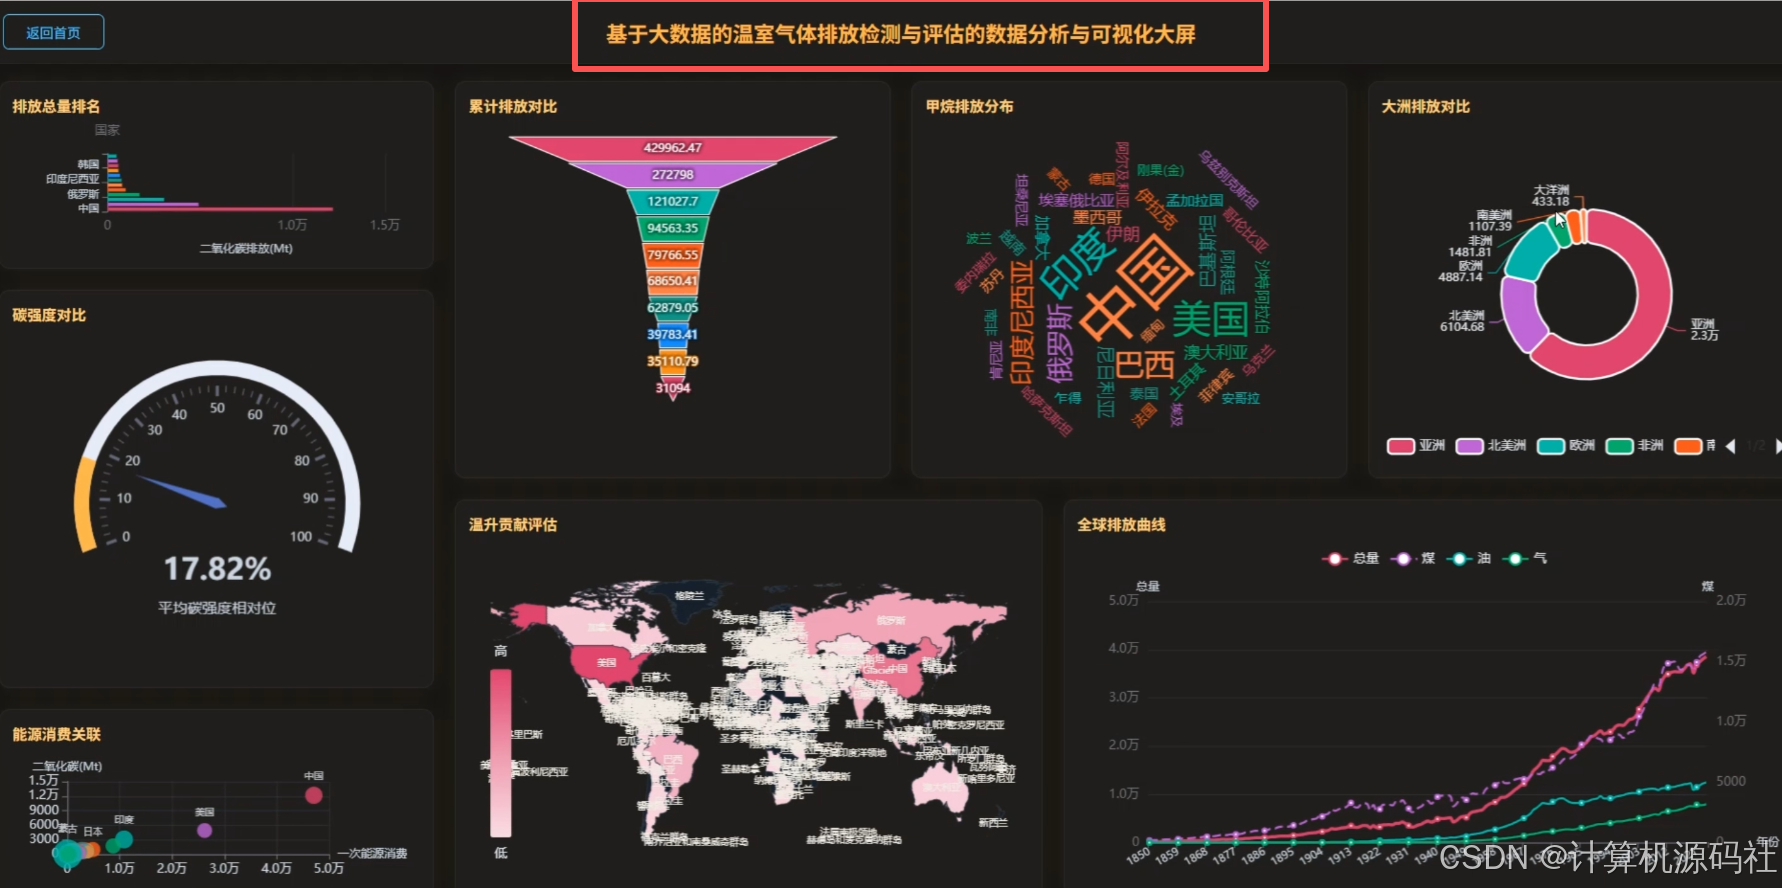
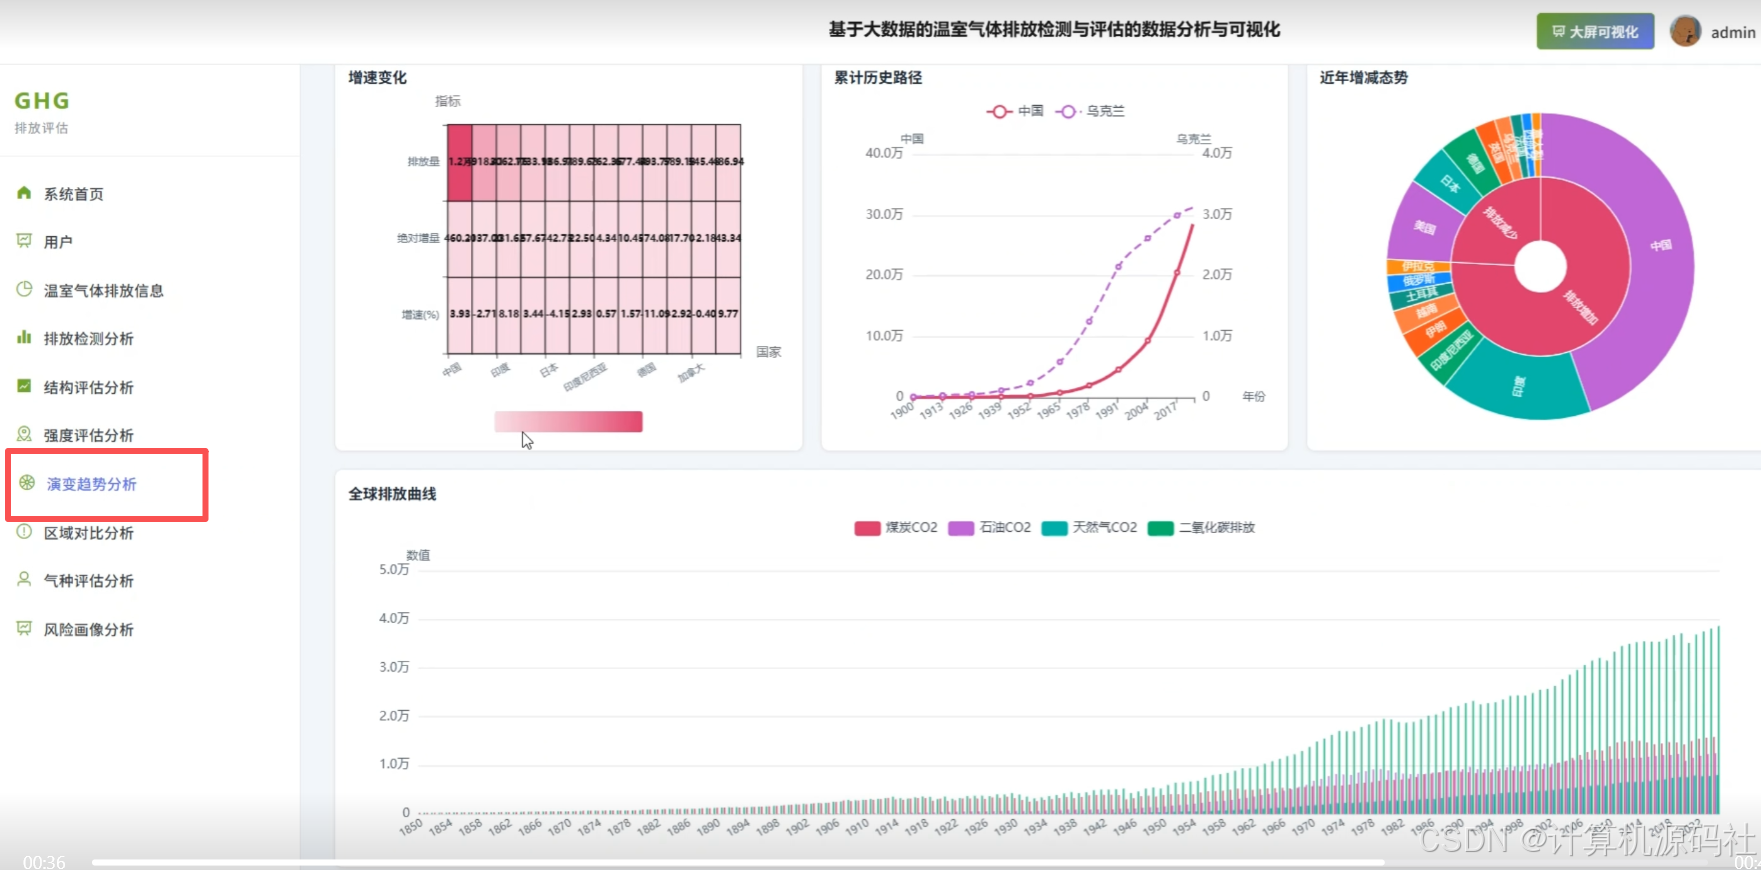
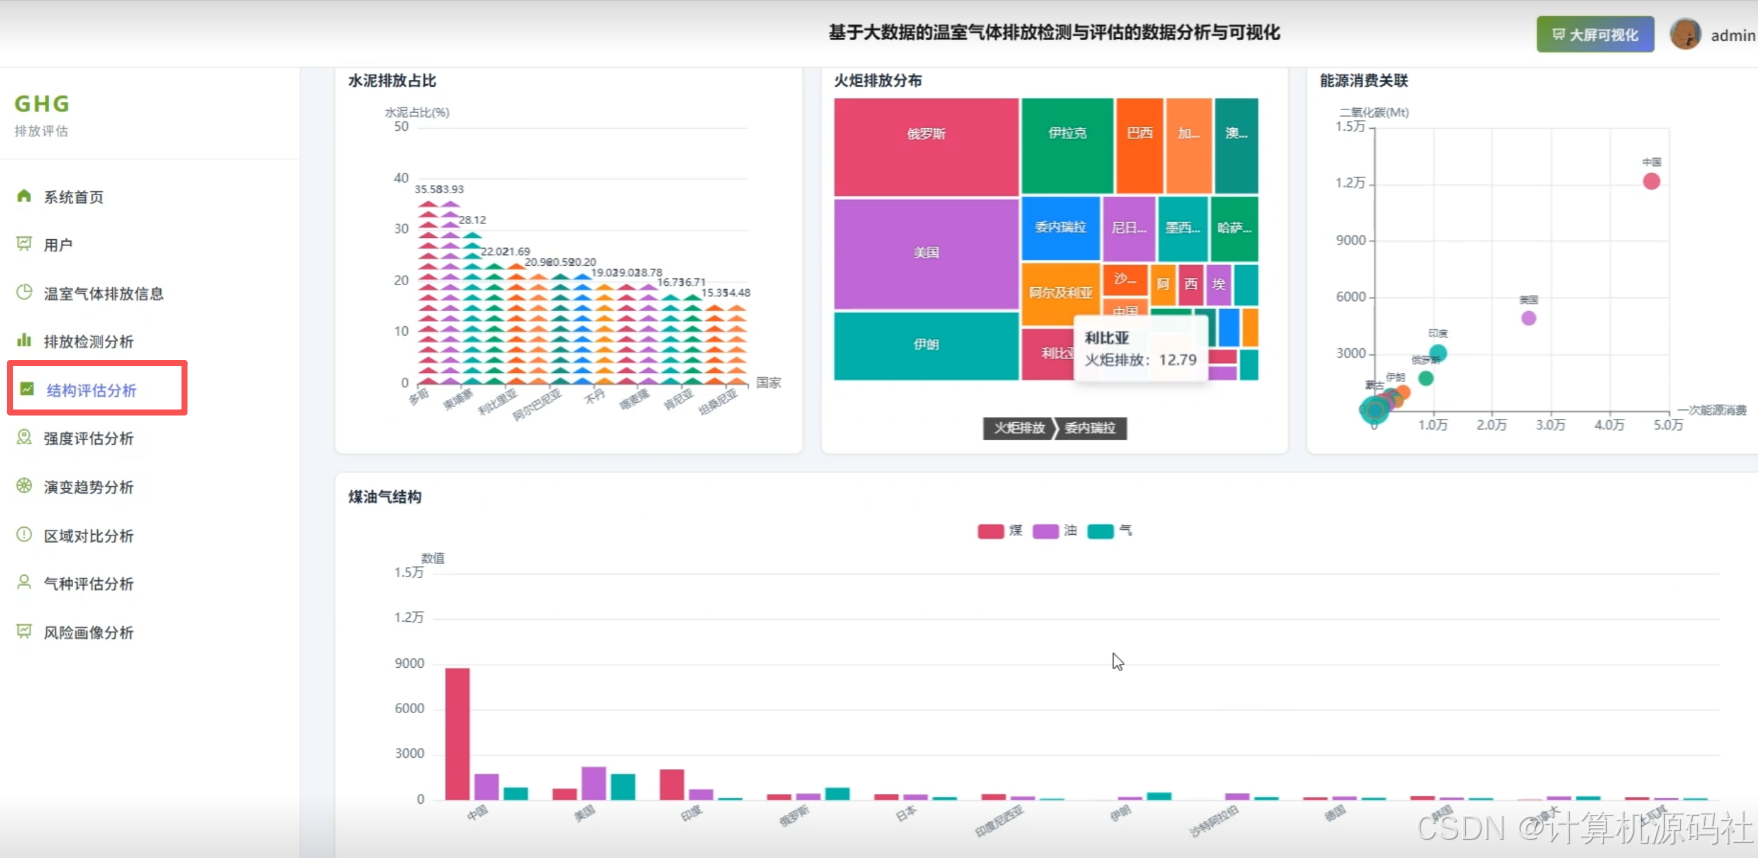
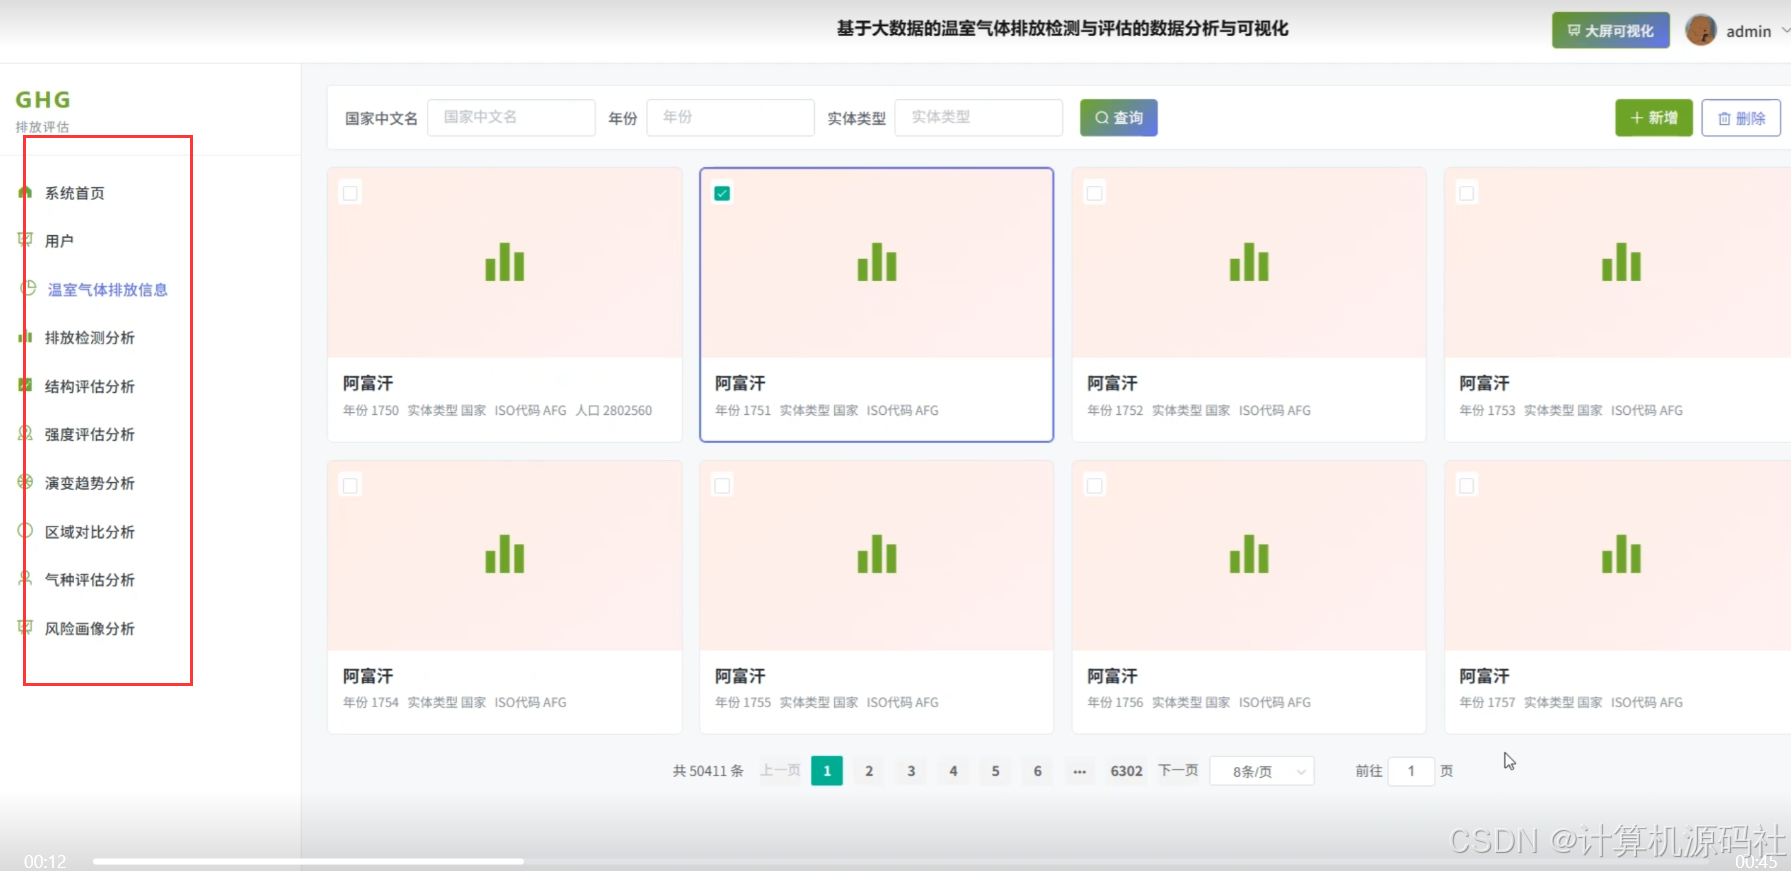
如需要源码,可以扫取文章下方二维码联系咨询
5、参考文献
1宋波. 数据可视化科学球在地理教学中的应用------以全球气候变化教学主题为例J.中小学数字化教学,2026,(3):87-91.
2蒋菡.18项温室气体排放核算国家标准4月1日实施N.工人日报,2025-04-01(004). DOI:10.28277/n.cnki.ngrrb.2025.001912.
3黄双庆.温室气体大数据时空挖掘分析及可视化平台构建D.安徽理工大学,2022.DOI:10.26918/d.cnki.ghngc.2022.000703.
4王祝华.海南政企合建管理平台实现温室气体排放"有迹可循"N.科技日报,2022-03-29(006). DOI:10.28502/n.cnki.nkjrb.2022.001663.
5姜亦飞,王先桥,王丹,等. 海岛温室气体自动观测系统的设计与实现J.海洋技术学报,2021,40(6):89-95.
6汤宏,曾掌权,沈健林,等. 秸秆与水分管理稻田的温室气体排放和碳固定J.环境科学与技术,2021,44(1):41-48.DOI:10.19672/j.cnki.1003-6504.2021.01.006.
7朱雪琰.基于可视图网络模型的时间序列数据分析研究D.天津理工大学,2021.DOI:10.27360/d.cnki.gtlgy.2021.000592.
8吴玉玺.我省7家企业自愿碳披露N.黑龙江日报,2020-12-28(002). DOI:10.28348/n.cnki.nhjrb.2020.005719.
9张婷婷.基于温室气体排放的城市生活垃圾处理策略优化研究D.北京化工大学,2020.DOI:10.26939/d.cnki.gbhgu.2020.000202.
10陈健华,孙亮,陈亮,等. 国内外企业温室气体排放核算标准的比较分析J.气候变化研究进展,2016,12(6):545-553.
11苗茹,姚凌,孙九林,等. 温室气体遥感反演系统的设计与实现J.河南大学学报(自然科学版),2014,44(3):339-346.DOI:10.15991/j.cnki.411100.2014.03.007.
12徐健宁,郑业鲁,万忠. 农田环境监测数据可视化系统的设计与实现J.农业网络信息,2013,(2):40-42.
13姜奕波. 建立温室气体排放数据统计和管理体系------谈谈数据收集方法J.科协论坛(下半月),2010,(10):111-112.
6、核心代码
java
    # 定位原始数据文件路径
    local_data_path = os.path.join(SCRIPT_DIR, 'dataset', INPUT_FILE)
    logger.info(f"读取原始数据: {local_data_path}")
    df = pd.read_csv(local_data_path, encoding='utf-8-sig')
    logger.info(f"读取行数: {df.shape[0]}, 列数: {df.shape[1]}")

    # 记录核心字段缺失情况,不硬填数值,仅记录现状
    core_cols = [
        'country', 'year', 'iso_code', 'population', 'co2', 'co2_per_capita',
        'cumulative_co2', 'share_global_co2', 'coal_co2', 'oil_co2', 'gas_co2',
        'gdp', 'co2_per_gdp', 'methane', 'total_ghg'
    ]
    for col in core_cols:
        if col in df.columns:
            miss_before = int(df[col].isna().sum())
            logger.info(f"字段 {col} 缺失数(处理前): {miss_before}")

    # iso_code 空字符串统一为 NaN,便于后续判定实体类型
    if 'iso_code' in df.columns:
        df['iso_code'] = df['iso_code'].replace('', np.nan)
        iso_miss = int(df['iso_code'].isna().sum())
        logger.info(f"iso_code 空值数: {iso_miss}(多为区域聚合实体)")

    # 国家名中文化:country 列直接写中文,避免英文名触发检测规则
    unmapped = sorted(set(df['country'].dropna().unique()) - set(ZH_MAP.keys()))
    if unmapped:
        logger.info(f"警告: ZH_MAP 未覆盖 {len(unmapped)} 个实体,将保留原文: {unmapped[:20]}")
    df['country_zh'] = df['country'].map(ZH_MAP)
    df['country_zh'] = df['country_zh'].fillna(df['country'])
    df['country'] = df['country_zh']  # 展示列统一为中文
    # USA 编码替换为中文,其余 ISO3 编码保留供过滤使用
    if 'iso_code' in df.columns:
        df['iso_code'] = df['iso_code'].replace({'USA': '美国'})
    mapped_cnt = int(df['country_zh'].isin(ZH_MAP.values()).sum())
    logger.info(f"country_zh 映射完成,命中中文名行数约: {mapped_cnt}")

    # 根据 iso_code 是否为空划分实体类型:非空≈真实国家,空值≈区域聚合
    df['entity_type'] = np.where(df['iso_code'].notna(), '国家', '区域聚合')
    logger.info(f"entity_type 分布: {df['entity_type'].value_counts().to_dict()}")

    # 浮点列统一保留两位小数,year 等整型列不受影响
    float_cols = df.select_dtypes(include=['float']).columns.tolist()
    for col in float_cols:
        df[col] = df[col].round(2)
    logger.info(f"浮点列已统一 round(2),列数: {len(float_cols)}")

    # 检查列名是否全为英文,保证表头规范
    non_ascii_cols = [c for c in df.columns if not all(ord(ch) < 128 for ch in c)]
    if non_ascii_cols:
        logger.info(f"警告: 非英文列名: {non_ascii_cols}")
    else:
        logger.info("表头英文化检查通过")

    # 输出预处理结果到本地 output 目录
    output_dir = os.path.join(SCRIPT_DIR, 'output')
    os.makedirs(output_dir, exist_ok=True)
    local_output_file = os.path.join(output_dir, f'{DATASET_NAME}_preprocessed_data.csv')
    hadoop_output_path = f"hdfs://127.0.0.1:9000/{PROJECT_NAME}/output/{DATASET_NAME}_preprocessed_data"

    if os.path.exists(local_output_file):
        os.remove(local_output_file)
        logger.info(f"已删除现有本地文件: {local_output_file}")

    df.to_csv(local_output_file, encoding='utf-8', index=False)
    logger.info(f"本地写出行数: {len(df)}")
logger.info(f"保存到: {local_output_file} 成功")💕💕作者:计算机源码社
💕💕个人简介:本人八年开发经验,擅长Java、Python、PHP、.NET、Node.js、Spark、hadoop、Android、微信小程序、爬虫、大数据、机器学习等,大家有这一块的问题可以一起交流!
💕💕学习资料、程序开发、技术解答、文档报告
💕💕如需要源码,可以扫取文章下方二维码联系咨询