如果一个语言只能顺序执行、平铺直叙,那它充其量只是电传打字机的一张伸长出来的账单。高级语言真正的生命力,在于控制流的肆意飞掠 与状态空间的向内坍缩。
在上一章里,我们让 4K BASIC 拥有了发出声音与保持沉默的能力。现在,我们将推开两扇最沉重的大门:
LET(变量赋值的符号表内潜) 与GOTO(控制流的物理飞掠)。在现代架构师的视野中,这对应着数据结构里最基础的两个概念:哈希表(Hash Table)与有向图的节点跳转。我们习惯了用
std::unordered_map实现 O(1) 的变量查找,习惯了编译器在编译期将if/else或循环直接翻译成 CPU 体系结构里的jmp相对偏移指令。但在 1975 年那块 4KB 的荒原上,没有哈希表,更没有编译期的地址重定位。一切变量的生灭,一切指令的跳跃,都必须在一块没有任何安全网的物理 RAM 链表上,完成最惊心动魄的肉搏。
1. 向内深潜:变量符号表的 2 字节生存主义
在 790 字节的用户可用空间里,你想开辟多少内存来存储变量名?
如果你允许用户定义任意长度的变量(如 int user_retry_count = 5;),那么光是存储这些变量名的 ASCII 字符串,就会在瞬间榨干全部的 RAM 空间。为了生存,4K BASIC 对用户发起了一场极为苛刻的暴政:所有变量名,长度绝对不能超过 2 个字节。
变量名必须符合一个严格的物理范式:一个字母,或者一个字母后面紧跟一个数字(例如 A, B1, X9)。
1.1 静态内存布局的精妙坍缩
这个看似残忍的物理约束,实际上是保罗·艾伦和比尔·盖茨在 8080 汇编层写出的一个神级架构优化。
由于变量名被死死限制在 2 字节以内,4K BASIC 的运行期根本不需要维护复杂的动态链表或哈希树来支撑符号表(Symbol Table)。它在自由 RAM 的上方,硬编码划出了一块固定长度的"静态变量槽(Static Variable Slots)"。
4K BASIC 变量符号表的物理映射 (2-Byte Hardcoding)
+-----------------------+-----------------------+-----------------------+
|   Slot 0 (变量 A)     |   Slot 1 (变量 B1)    |   Slot 2 (变量 X9)    |
| [2B 名字][4B 浮点值]  | [2B 名字][4B 浮点值]   | [2B 名字][4B 浮点值]  |
+-----------------------+-----------------------+-----------------------+

| <--   6 字节固定步长  --> |
当状态机扫描到 10 LET A = 5 时,LET 执行器(Token: 0x88)会启动如下逻辑:
- 零分配(Zero-Allocation) :它不需要
new任何内存对象。 - 基地址偏移(Base-Offset) :它直接将变量名转换为一个数字索引。如果是单字母
A,其在内存中的地址就是符号表基地址 + 0 * 6。如果是B1,则是符号表基地址 + 索引 * 6。 - 原子覆写 :指针直接原地深潜,将这 6 字节槽位后半部分的 4 字节数据,强行改写为浮点数
5的二进制值。
这种将符号表完全静态化、固定步长化的设计,让 8 位处理器只需要执行简单的移位与加法指令,就能在几个时钟周期内定位到任何变量的物理地址。在 1975 年,这就是绝对的 O(1) 查找速度。
2. 向外飞掠:GOTO 的单向链表长征
如果说 LET 是向内存固定槽位的"精准深潜",那么 GOTO(Token: 0xA2)则是控制流在物理 RAM 链表上的"疯狂飞掠"。
正如我们在第二章中你所绘制的经典架构图一样,BASIC 程序在内存里是以单向链表 的形式线性排布的。每一行的开头,都是指向下一行物理内存首地址的 2 字节指针。
当程序执行到 100 GOTO 20 时,悲剧发生了:硬件根本不知道"第 20 行"对应的物理内存地址在哪个格子里。
2.1 物理寻址的长征时序
为了完成这次跳转,8080 处理器的 PC 指令指针被迫发起了一场极其原始的"长征"。它必须每一次都拉响警报,将指针重置回自由 RAM 的绝对起点($0800),然后顺着单向链表,一节车厢、一节车厢地去对齐行号。
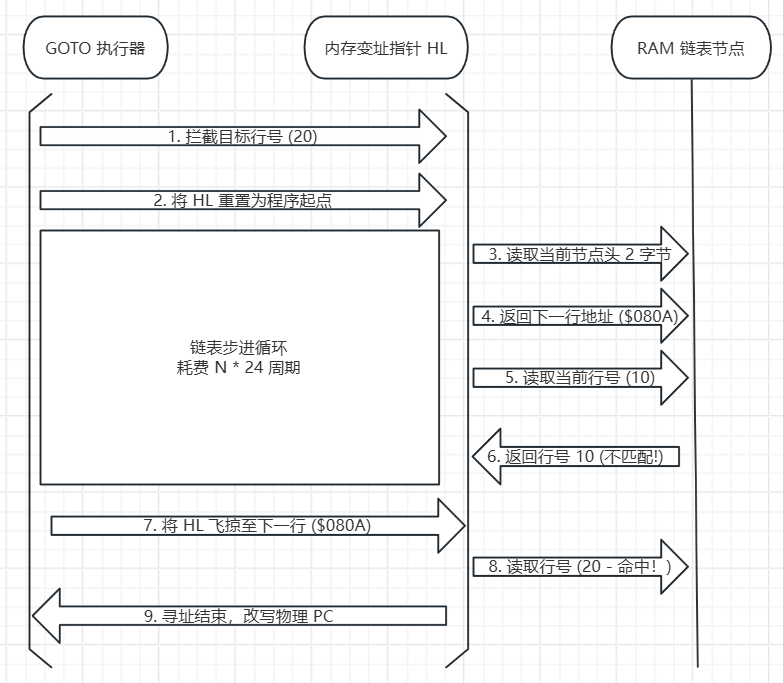
Warning:
这种长征暴露了复古技术中最核心的体系结构缺陷:
GOTO跳转的延迟,与目标行在程序中的深度(第 N 行)成绝对的正比例关系。如果你的循环体在第 200 行,而你执行了一条
GOTO 200,处理器在开始下一次循环前,必须先在内存里做 200 次毫无意义的指针比对(每次比对消耗 8080 至少 24 个时钟周期)。
因此,70 年代真正的极客在编写高性能游戏(如《星际迷航》)时,会逼迫自己玩一个极其反直觉的极限优化:把最核心、执行频率最高的高频算法,全部写在程序的最开头(例如第 1 到第 5 行);而把那些只执行一次的初始化代码和版权声明,扔到行号 9000 之后的内存死角里。
3. 生产级实战:用现代 C++ 模拟 8 位机变量槽与链表飞掠
现在,让我们切换到 MSVC (C++) 的战壕中。
我们将完全抛弃现代 C++ 的 std::map 和动态内存分配。我们将在一块连续的 uint8_t 虚拟内存块上,用原生的指针计算与自旋扫描 ,完整复现 4K BASIC 面对 LET 和 GOTO 时的物理世界。
cpp
#include <iostream>
#include <cstdint>
#include <cstring>

// 模拟 4K BASIC 底层 Token 映射
enum StructureTokens : uint8_t {
    TOKEN_END   = 0x00,  // 行尾溢出符
    TOKEN_LET   = 0x88,  // LET 关键字
    TOKEN_GOTO  = 0xA2   // GOTO 关键字
};

// 严格对齐 1975 物理拓扑的仿真底座
class AltairMachine {
public:
    uint8_t RAM[4096];              // 标配 4KB 物理内存
    uint16_t BaseOffset_Variable;    // 静态符号表基地址
    uint16_t ProgStart;              // 用户程序链表起点起点地址

    AltairMachine() {
        std::memset(RAM, 0, 4096);
        ProgStart = 0x0100;          // 模拟程序加载到 $0100
        BaseOffset_Variable = 0x0E00;// 符号表固化在内存高位 $0E00
    }

    // 辅助工具:在内存中物理编排一条 Token 化的代码行
    void WriteMemoryRow(uint16_t currentAddr, uint16_t nextAddr, uint16_t lineNumber, const uint8_t* payload, size_t size) {
        // 1. 写入前两字节:下一行物理地址指针 (图左侧前两个格子)
        RAM[currentAddr] = static_cast<uint8_t>(nextAddr >> 8);
        RAM[currentAddr + 1] = static_cast<uint8_t>(nextAddr & 0xFF);

        // 2. 写入中间两字节:当前行号 (Big-Endian)
        RAM[currentAddr + 2] = static_cast<uint8_t>(lineNumber >> 8);
        RAM[currentAddr + 3] = static_cast<uint8_t>(lineNumber & 0xFF);

        // 3. 注入数据负载与行终止符 0xFF(继承上一章的硬核神来之笔)
        std::memcpy(&RAM[currentAddr + 4], payload, size);
        RAM[currentAddr + 4 + size] = 0xFF;
    }
};

class MicroInterpreter {
private:
    AltairMachine* machine;
    uint16_t pc; // 模拟 CPU 内部的指令指针寄存器

public:
    MicroInterpreter(AltairMachine* m) : machine(m), pc(m->ProgStart) {}

    // 模拟 LET 状态机:O(1) 基地址偏移直接写符号表
    void HandleLet(const uint8_t* payload) {
        char varName = static_cast<char>(payload[0]); // 比如 'A'
        uint8_t varVal = payload[1];                  // 简化模拟:只存 1 字节标量值

        // 计算物理槽位偏移:变量 'A' 映射到槽位 0,'B' 映射到槽位 1...
        uint16_t slotIndex = varName - 'A';
        uint16_t targetMemoryAddr = machine->BaseOffset_Variable + (slotIndex * 6);

        // 写入物理符号表槽
        machine->RAM[targetMemoryAddr] = static_cast<uint8_t>(varName); // 槽前部:存名字
        machine->RAM[targetMemoryAddr + 2] = varVal;                   // 槽后部:存值

        std::cout << "[LET 状态机] 符号表地址 $0" << std::hex << targetMemoryAddr
                  << " 原位覆写成功: 变量 " << varName << " = " << std::dec << (int)varVal << std::endl;
    }

    // 模拟 GOTO 状态机:拉响警报,重置起点,长征扫描链表
    void HandleGoto(uint16_t targetLine) {
        std::cout << "[GOTO 触发] 正在寻找目标行号: " << targetLine << "..." << std::endl;

        // 核心惩罚:迫使执行流必须重置回自由程序的最起点进行线性检索
        uint16_t scanAddr = machine->ProgStart;
        int hopCount = 0;

        while (scanAddr != 0x0000) {
            hopCount++;
            // 抓取当前节点的下一行指针
            uint16_t nextLineAddr = (machine->RAM[scanAddr] << 8) | machine->RAM[scanAddr + 1];
            // 抓取当前节点的行号
            uint16_t currentLineNum = (machine->RAM[scanAddr + 2] << 8) | machine->RAM[scanAddr + 3];

            if (currentLineNum == targetLine) {
                // 命中目标:将物理 PC 直接飞掠至该节点的负载起始处
                pc = scanAddr;
                std::cout << "  >> 成功命中!控制流飞掠完成。物理地址收敛至: $0"
                          << std::hex << pc << " (共经历单向链表突跳步进: " << std::dec << hopCount << " 次)" << std::endl;
                return;
            }

            // 没命中,顺着链表指针跳跃到下一块物理内存
            scanAddr = nextLineAddr;
        }

        std::cout << "  >> LINE NOT FOUND ERROR" << std::endl;
    }

    void RunEngineStep() {
        // 解析当前行的指令负载
        uint16_t nextLine = (machine->RAM[pc] << 8) | machine->RAM[pc + 1];
        uint8_t token = machine->RAM[pc + 4];

        if (token == TOKEN_LET) {
            HandleLet(&machine->RAM[pc + 5]);
            pc = nextLine; // 正常顺序执行:直接移交至已知的下一行
        } else if (token == TOKEN_GOTO) {
            uint16_t target = (machine->RAM[pc + 5] << 8) | machine->RAM[pc + 6];
            HandleGoto(target); // 强行改写 PC,触发内存长征
        }
    }
};

int main() {
    AltairMachine machine;

    // 我们在内存里编排两行诡异的代码,使其形成一个互锁的死循环
    // 地址 $0100 -> 行号 10: LET A = 7
    uint8_t letPayload[] = { TOKEN_LET, 'A', 7 };
    machine.WriteMemoryRow(0x0100, 0x0110, 10, letPayload, sizeof(letPayload));

    // 地址 $0110 -> 行号 20: GOTO 10 (跳转目标高低字节拆分:0x00, 0x0A)
    uint8_t gotoPayload[] = { TOKEN_GOTO, 0x00, 10 };
    machine.WriteMemoryRow(0x0110, 0x0000, 20, gotoPayload, sizeof(gotoPayload));

    MicroInterpreter interpreter(&machine);

    std::cout << "--- 开始执行 MSVC 符号表与链表寻址仿真 ---" << std::endl;
    interpreter.RunEngineStep(); // 执行行号 10
    interpreter.RunEngineStep(); // 执行行号 20,这会导致 PC 重新飞掠回行号 10
    interpreter.RunEngineStep(); // 再次执行行号 10

    return 0;
}
4. 避坑指南与现代性能优化演进
LET 的空间侵蚀与 GOTO 的时间长征,其底层的物理矛盾直接催生了半个世纪后现代高并发系统架构的防御性设计准则:
4.1 警惕高频业务中的"GOTO 式链表长征"------跳过 O(N) 寻址陷阱
- 古早踩坑:在 BASIC 中,由于执行流不得不频繁地通过单向链表定位行号,导致尾部代码的响应时间呈线性恶化。
- 现代演进 :这与现代很多开发人员在处理高频大数据时,错误选用数据结构的场景完全吻合。在编写基于 MSVC 的服务端长连接路由分配、或者类似游戏服务器的房间查找列表中,绝对不要使用原始链表(
std::list)去承载需要被高频随机访问的句柄 。每一次指针的随机跳跃(Pointer Chasing)都会造成严重的 CPU Cache Miss 。应当学会在初始化阶段构建线性跳转表(Jump Table),以连续的内存物理数组(std::vector)承载状态,将指针的飞掠退化为纯粹的内存基地址偏移(O(1) 访问)。
4.2 符号表的"冷热隔离"与缓存失效防护
- 性能建议:BASIC 将所有的变量不分青红皂白地以固定步长堆在静态区域,但在现代高吞吐量的分布式中间件(如自定义规则引擎、动态指标计算系统)中,这种无差别的符号表设计会带来严重的并发冲突与伪共享(False Sharing)问题。
- 优化策略 :应当针对变量符号表实施"冷热隔离"。高频变动的状态(如计数器、动态游标)必须独占 CPU 核心的 Cache Line(通过 C++20 的
alignas硬件对齐防止伪共享);而那些配置期决定的冷变量,则应该通过只读指针进行线程间共享,从而避免变量在原地覆写时引发的多核总线锁风暴。
数据在方寸格子里内潜,控制流在长长的内存单向链条里飞掠。这组冰冷的物理碰撞,构成了 1975 年那个春天最底层的力量。
下一篇,我们将直面这套解释器最脆弱,但也最伟大的物理核心:
在没有硬件浮点运算器的 8 位微处理器上,人类是如何用仅剩的三千字节,人工缝合出一个支持四则运算与多项式逼近的"心脏"------
第四篇:《三千字节的浮点心脏》(FOR / NEXT)