从 0 到 1:造一个"录制回放 + LLM 自主操作手机"的 Android 自动化测试平台(一)------整体架构与录制引擎
本系列共三篇,这是第一篇:
- 整体架构与录制引擎------把手指动作变成可靠脚本(本文)
- ReAct 引擎与调度对账------让 LLM 自己点手机
- 客户端与后台工程细节------那些让我熬夜的 Bug 们
一、为什么要造这个轮子
做 Android 测试的同学大概率经历过这几件事:
- Appium / uiautomator2 环境又重又脆:装一套客户端、起一个 server、配desired capabilities,跑之前先折腾半小时,版本一升级全崩;
- 录制脚本一跑就碎:录的时候好好的,回放时页面多转了个圈、控件多了个 loading,坐标一点,点到了无关的地方,脚本直接失败;
- 探索式测试没法用脚本表达。"去删掉昨天创建的那条任务"------这种带自然语言理解的目标,写脚本根本无从下手,只能人肉点一遍。
所以我想做的平台形态是双引擎:
- 录制回放:真人拿手指在真机上点一遍,自动生成带多候选定位的脚本,回放稳定;
- LLM 自主探索:给一句自然语言目标,让多模态大模型看着屏幕自己操作真机,一步步逼近目标。
再配上一个 Windows 客户端开箱即用(测试同学不需要懂命令行),一个 Web 后台做资产管理。整个项目的技术栈:
| 端 | 技术 |
|---|---|
| 后端 | FastAPI + SQLite(WAL) |
| 本地代理 | Python agent(DroidRun + adb + scrcpy) |
| 桌面客户端 | Flutter for Windows |
| 管理后台 | Vue3 + Element Plus |
| 真机执行 | DroidRun Portal(无障碍服务)优先 + ADB 直连兜底(双引擎) |
站在 DroidRun 的肩膀上
必须先说明:这个项目不是全部从零写的。真机端的动作执行依赖 DroidRun------一个 9k+ star 的开源移动 Agent 框架(主框架 MIT 协议)。它解决的是"怎么在真机上可靠地执行动作"这个问题:
- DroidRun Portal :安装到真机上的无障碍服务 APK(我们设备上装的是 mobilerun 版本,包名
com.mobilerun.portal),能以无障碍服务身份直接对控件执行点击、输入、滑动------直接作用到控件而非坐标,且不占用 uiautomator 自动化通道。Portal 只通过本地 ADB 通信(TCP 端口转发或 content provider),不对外联网; - SDK 驱动 :本地 Agent 通过 DroidRun 的 Python SDK(包名
mobilerun)驱动 Portal 完成动作; - 内置分发 :Portal APK 直接打包在 Agent 的
assets/里,POST /install/portal一键装到新接入的设备,免去手动下载开启无障碍服务的流程; - 双引擎设计 :执行引擎检测到 droidrun SDK 可用且设备已装 Portal 时走
engine="droidrun"(无障碍通道),否则自动降级engine="adb"(adb + uiautomator dump 解析 + input 命令实现全部动作),两个引擎实现同一个Engine接口,上层无感。
License 合规提一句:DroidRun 主框架 MIT,但 Portal APK 据其文档演进可能切换协议(我们调研时记录过 AGPL-3.0 的提示),商业闭源集成前建议自行确认,内部使用不受影响。
那本文的重头戏------录制链路(getevent 采集、dump 解析、多候选定位)------为什么和 Portal 无关?因为录制走的是纯 ADB 通道 :真人手指的触摸事件来自内核,控件信息来自 uiautomator dump,这些都是系统原生能力,不依赖任何第三方 App。Portal 属于回放和 ReAct 的执行通道,第二篇会再见到它。
二、整体架构:一次点击的完整旅程
先上架构图:
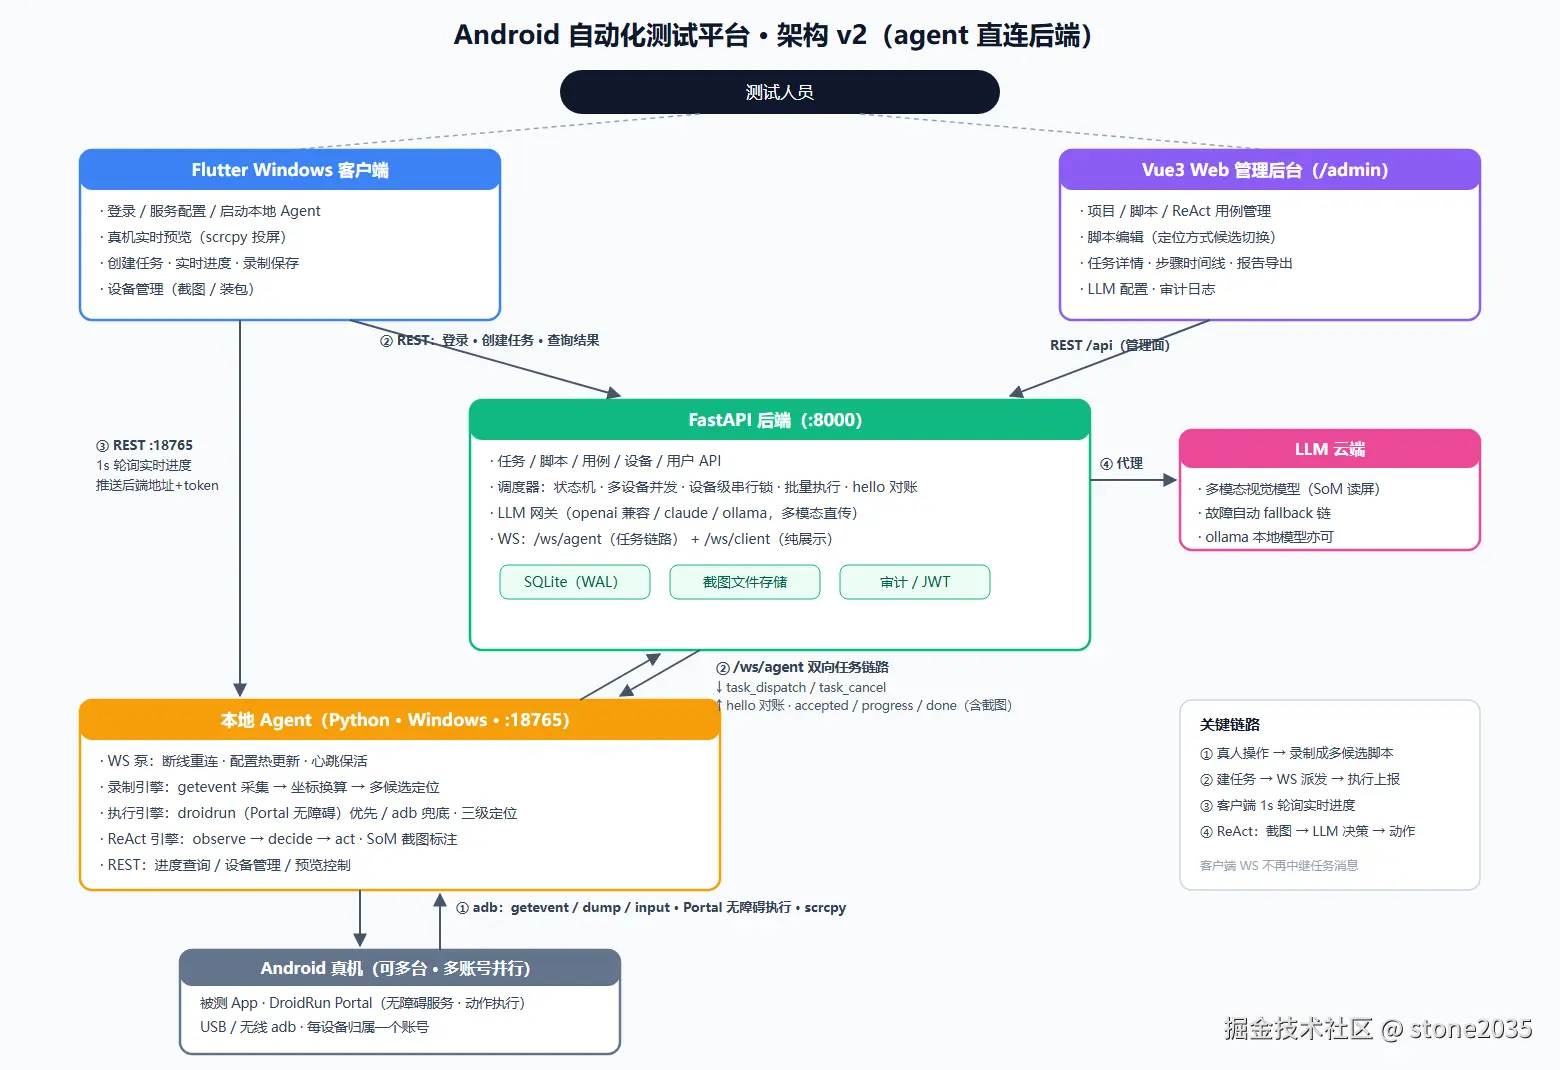
四端各司其职:
- Flutter 客户端:测试同学的日常入口,登录后自动拉起本地 Agent,提供录制脚本、scrcpy 真机投屏、任务执行、实时进度预览;
- 本地 Agent(Python) :装在测试机上,独占所有设备操作------adb、getevent、uiautomator dump、scrcpy 全在这一层;
- FastAPI 后端:资产管理 + 任务调度中心,SQLite 单文件存储,对 LLM 做统一网关代理(API key 不下发到客户端);
- Vue3 Web 后台:项目/脚本/用例管理,任务下发,任务详情的步骤时间线与报告导出。
图里四条编号链路就是平台的核心工作流:
- 录制链路 :真人手指操作真机,Agent 通过
getevent采集触摸事件,换算坐标、匹配 UI 控件,生成多候选定位脚本存到后台; - 任务链路 :客户端建任务 → 后端调度器通过
/ws/agentWebSocket 直发 Agent → Agent 执行并实时上报accepted / progress / done(进度消息里直接内嵌 base64 截图); - 预览链路:客户端每 1 秒轮询 Agent 的 REST 接口,任务执行到哪一步、当前屏幕什么样,全部实时可见;
- ReAct 链路:Agent 截图标注后请求后端 LLM 代理,模型给出决策(点哪里/输什么/等一下),Agent 翻译成 adb 动作。
为什么是 agent 直连后端(架构 v2)?
初版走的是"客户端 WebSocket 中继":后端把 task_dispatch 发给客户端,客户端转发给 Agent。跑起来后问题一大堆------客户端一断线任务就悬空、中继逻辑和 UI 生命周期搅在一起、多任务并发时消息时序混乱。
重构后客户端 WS 退化为纯展示(只收连接状态),任务消息全部走 Agent 与后端之间的专用 WebSocket。这个改动让"任务执行"和"UI 存活"彻底解耦:客户端崩了任务照跑,Agent 重启了靠对账恢复。对账协议的细节留到第二篇展开。
三、录制回放引擎:把手指动作变成可靠脚本
这是整个项目干货密度最高的模块,分三步讲:采集、dump、定位。
3.1 getevent 采集与坐标换算:不换算必炸
录制时 Agent 起一个 getevent -ql 长进程流式读取内核触摸事件。第一个大坑就出在这里------getevent 上报的不是屏幕逻辑坐标,而是触摸轴原始值:
bash
/dev/input/event5: EV_ABS ABS_MT_POSITION_X 00001e5f
/dev/input/event5: EV_ABS ABS_MT_POSITION_Y 00000b2a
/dev/input/event5: EV_KEY BTN_TOUCH DOWN
RMX2202 这台设备上,X 轴 max 是 8639 ,对应屏幕逻辑宽度 1080。也就是说你手指点在屏幕正中间,getevent 报出来的是 4300 多,而不是 540。
换算公式很朴素:逻辑坐标 = 原始值 × 屏幕分辨率 ÷ 轴 max。先解析 getevent -pl 拿到每个输入设备的轴最大值:
python
def touch_axes(self, serial: str) -> dict[str, dict[str, int]]:
    """触摸屏轴最大值:{"/dev/input/eventX": {"x": xmax, "y": ymax}}。

    getevent 上报的 ABS_MT_POSITION_* 是原始触摸轴坐标(常见为逻辑分辨率的
    整数倍,如 8639 对应 1080 逻辑宽),必须按轴 max 换算为屏幕逻辑坐标。
    解析失败返回空 dict(调用方跳过换算)。
    """
    out = self.shell(serial, ["getevent", "-pl"], timeout=15)
    axes = {}
    node, cur = None, {}
    for line in out.splitlines():
        m = re.match(r"add device \d+:\s*(/dev/input/\S+)", line.strip())
        if m:
            if node and cur.get("x") and cur.get("y"):
                axes[node] = cur
            node, cur = m.group(1), {}
            continue
        mx = re.search(r"ABS_MT_POSITION_X\s*:.*?max\s+(\d+)", line)
        my = re.search(r"ABS_MT_POSITION_Y\s*:.*?max\s+(\d+)", line)
        if mx: cur["x"] = int(mx.group(1))
        if my: cur["y"] = int(my.group(1))
    if node and cur.get("x") and cur.get("y"):
        axes[node] = cur
return axes这里有个容易被忽略的细节:一台设备可能有多个触摸设备节点 (电容屏、虚拟按键各自一个 /dev/input/eventX),必须按事件来源的设备路径分别取轴 max,不能全局只存一份。
3.2 uiautomator dump 深坑:exit 0 也可能是假失败
有了逻辑坐标,下一步是把点到的位置映射到真实控件上,这依赖 uiautomator dump 拿到当前 UI 层级 XML。这个命令的坑之密集,值得单独开一节:
坑 1:exit 0 的"假成功"。 在 RMX2202 / Android 14 上,dump 的输出行为完全不一致------有时 stdout 打印 ERROR: could not get idle state. 但退出码是 0,而文件其实写出来了 ;有时错误信息走 stderr、stdout 是空的。所以成功判定绝不能看命令输出,只能把文件读回来验证内容:
python
last_err = "未知原因"
for attempt in range(attempts):
    remote = f"/sdcard/atp_ui_{uuid.uuid4().hex[:8]}.xml"   # 每次唯一临时文件
    try:
        self.shell(serial, ["uiautomator", "dump", remote], timeout=timeout)
    except AdbError:
        pass  # 退出码/消息不可靠,成败以读回文件为准
    text = ""
    try:
        out = self.run(self._with_serial(serial, ["exec-out", "cat", remote]))
        text = out if isinstance(out, str) else out.decode("utf-8", "replace")
    except AdbError:
        pass  # 文件未产出
    self.shell(serial, ["rm", "-f", remote], timeout=5.0)
    if "<hierarchy" in text:
        return text
注意临时文件名带 uuid------早期版本用固定路径 /sdcard/atp_ui.xml,上次 dump 失败残留的旧文件会被下次误读成成功,排查了很久才发现是跨会话互踩。
坑 2:动画饿死 idle。 uiautomator dump 前要等 UI idle,而系统的 window/transition/animator 三类动画缩放只要有一项是 1.0,带动画的页面 idle 永远等不到,dump 必然超时。所以失败自愈的第一步就是关掉三类动画缩放,测试机干脆长期保持 0.0。
坑 3:第三方 instrumentation 抢占自动化通道。 某天 dump 突然全部 OOM 被杀(exit 137),排查发现是设备上残留了一个第三方自动化服务的 instrumentation 进程占着 uiautomator 的通道,force-stop 之后恢复正常。
坑 4:视频流页面天然 dump 不稳定。 短视频/播放器页面在场景切换时会持续吐无障碍事件,实测 5 次里 3 次失败。这种页面不做跨调用重试(重试窗口追不上场景切换的持续时间),直接快速降级到纯截图感知。
3.3 多候选定位:一次点击,五种表达
坐标换算 + dump 就绪后,一次真人点击会被处理成这样一段脚本:
json
{
  "action": "tap",
  "description": "点击「登录」",
  "selector": {"text": "登录", "index": 0},
  "candidates": [
    {"kind": "resource_id", "label": "resource_id: com.app:id/btn_login", "selector": {"resource_id": "com.app:id/btn_login", "index": 0}},
    {"kind": "text", "label": "文本: 登录", "selector": {"text": "登录", "index": 0}},
    {"kind": "inner_text", "label": "内部文本: 立即登录", "selector": {"text": "立即登录", "index": 0}},
    {"kind": "class_index", "label": "Button 第 3 个", "selector": {"class_name": "android.widget.Button", "index": 2}},
    {"kind": "point", "label": "坐标 (540, 950)", "params": {"x": 540, "y": 950}}
  ]
}
核心设计:坐标永远是最后的选择。 一次点击会同时采集所有可行的定位方式存进 candidates,用户在客户端保存时可以逐条切换,后台编辑脚本时也能改。默认选择逻辑(_on_touch_end):
python
node = self._map_point_to_node(x, y)          # 点击点 → UI 节点
if node is not None and is_tap:
    candidates = self._build_candidates(nodes, node, x, y)
    selector = node.to_selector()
    if not _in_scrollable(nodes, node):
        # 非列表区域控件文本稳定:默认优先文本锚点(自身 → 内部子控件)
        text_sel = self._default_text_selector(nodes, node, x, y)
        if text_sel is not None:
            selector = text_sel
    step = {"action": "tap", "selector": selector, "candidates": candidates}
elif is_tap:
    step = {"action": "tap", "description": f"点击坐标 ({x},{y})", "params": {"x": x, "y": y}}
几个设计决策:
- 列表区域(ListView/RecyclerView 内)默认不用文本------列表项文本高度雷同("任务一"、"任务二"),文本定位回放时会点错行,这种情况默认走 resource_id 或坐标;
- 无文本容器很常见------图标按钮自己没 text,但它 bounds 内部往往有子控件带文本,所以候选里专门有一类"内部文本"锚点;
- class+序号是弱锚点------同屏 Button 第 3 个,增删一个按钮就失效,排序永远在文本之后。
匹配节点的降级链是:nearest_clickable(最近的 clickable 控件)→ 内部子控件文本 → smallest_containing(包含点击点的最小节点,仅当它有语义锚点或是足够小的叶子节点)→ 坐标兜底。每一层都保证"宁可记坐标,不可错配"------错配比记坐标更糟,因为坐标失败得明明白白,错配点错得悄无声息。
客户端录制:
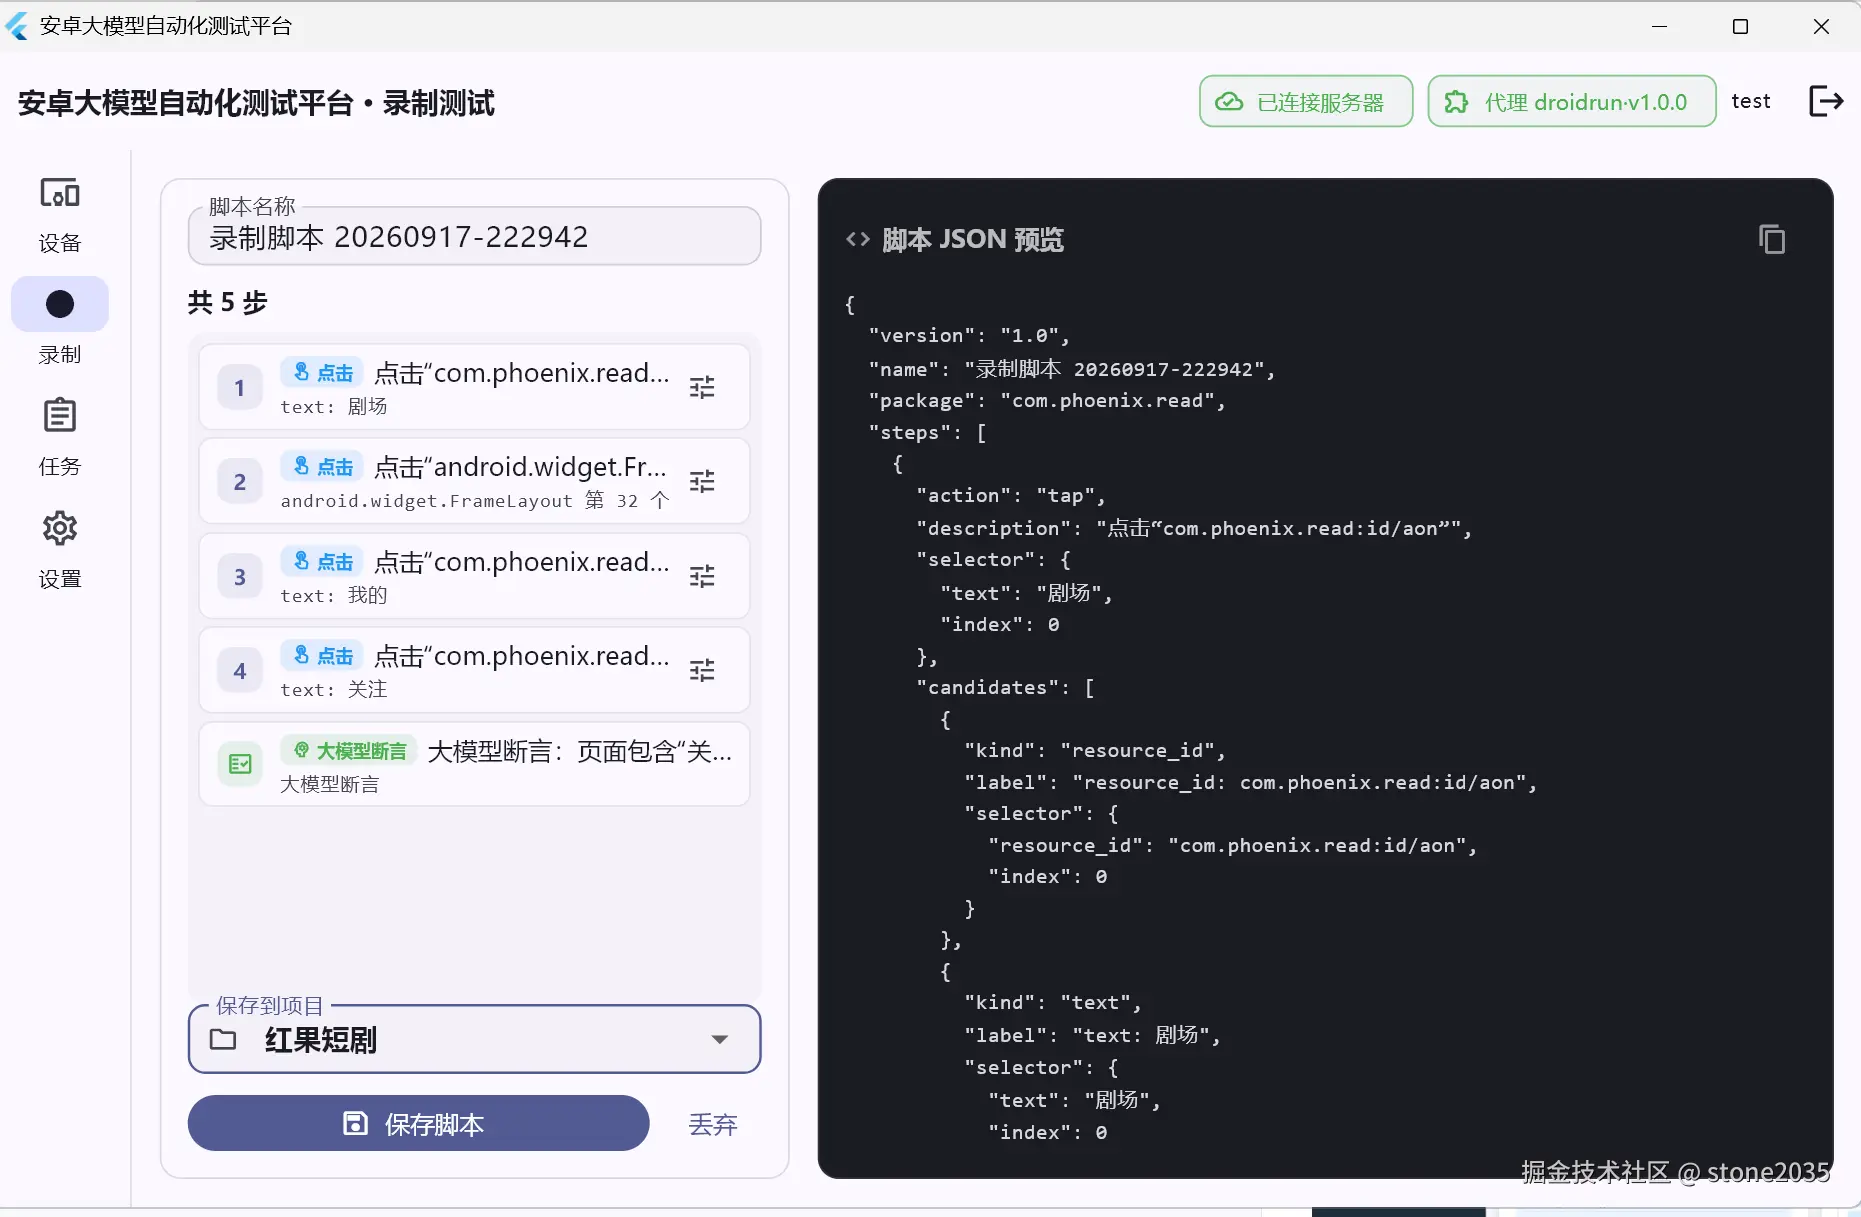
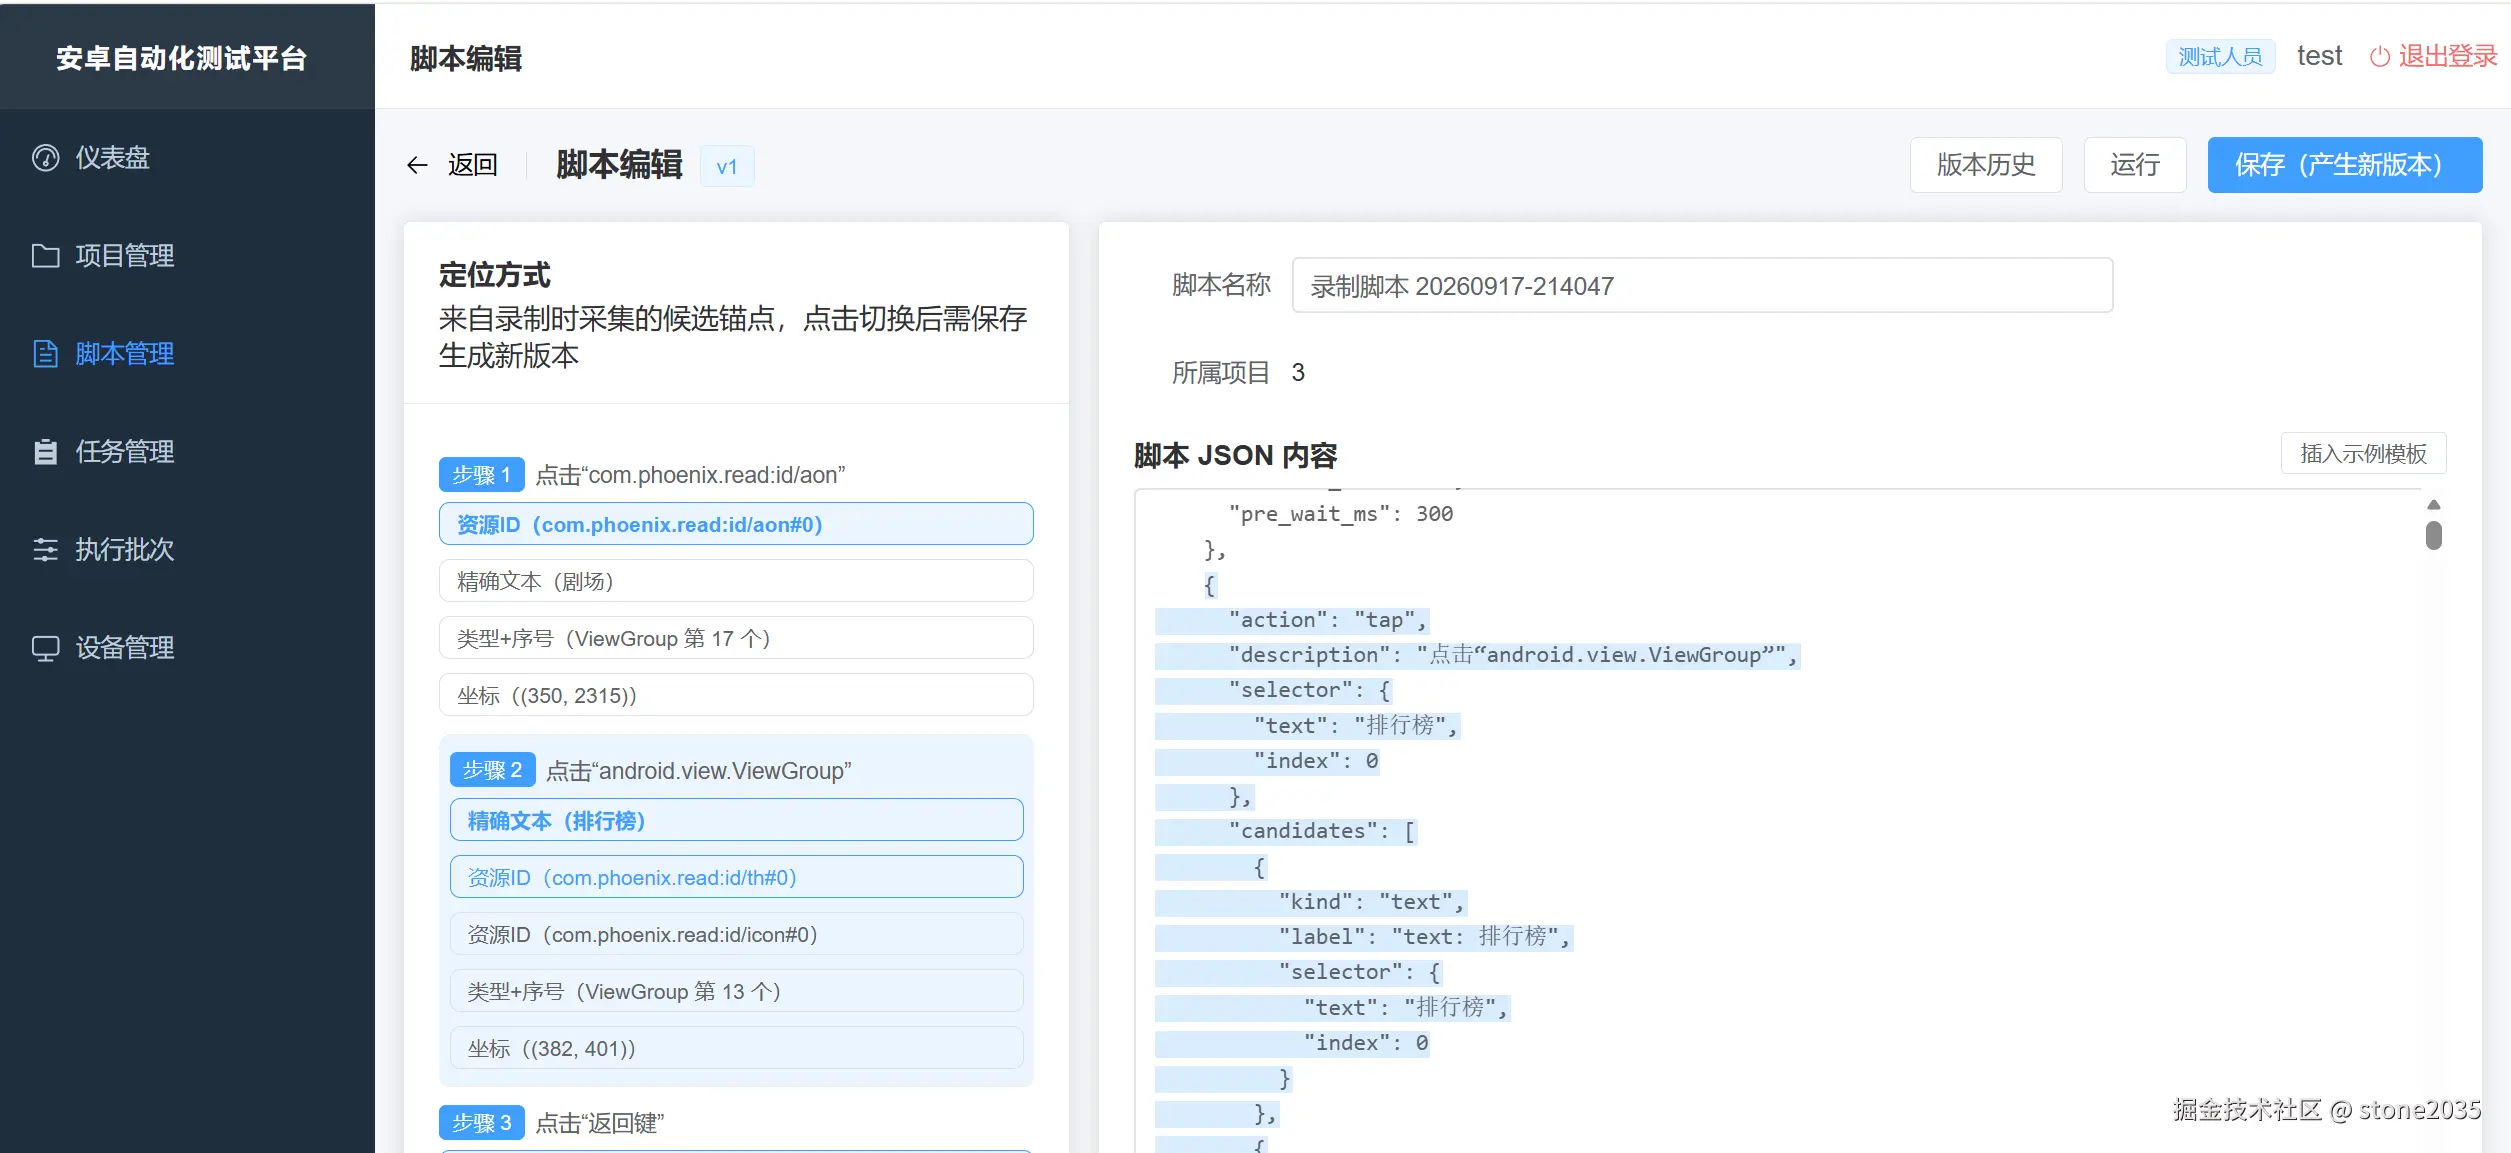
这是后台脚本编辑页面: 已录制好的脚本,可以在后台再次编辑
3.4 为什么大容器反而要保留坐标
有个反直觉的 case:点击落在整屏大的 ViewPager 上时,即使它有 resource-id 也故意记坐标 。原因:selector 回放时定位到的是容器中心,而用户实际点的是容器内的某个具体位置------回放点容器中心必偏。这跟"小图标叶子节点用 class+index 就够"正好是同一条原则的两面:定位表达必须还原用户的操作意图,而不是还原控件本身。
四、本篇踩坑锦集
- 坐标不换算的两种炸法 :一是 raw 值(8639)远超逻辑分辨率(1080),
input tap直接越界无效;二是即使换算系数恰好接近 1 的小屏设备上不越界,所有"用逻辑坐标找控件"的匹配也全失败------表现都是录制下来一堆坐标步骤,回放全靠蒙。 - 录制必须真人手指 :
input tap、scrcpy 投屏鼠标点击这类 ADB 注入的操作不会进入录制事件流(输入通道不同),所以录制期间必须人肉点------工具无法代替手指。 - 断言能力是后补的 :刚开始录制的脚本只有操作没有断言,回放"跑完"≠"跑对"。后来补了两层------录制时采集可断言的控件锚点(assert_candidates),执行侧加了 LLM 兜底断言。教训:校验能力和操作能力一样,是引擎的一等公民,设计期就要想清楚。
- PowerShell 5.1 发中文 JSON 会变
???:Invoke-RestMethod默认把 body 按 ASCII 编码,中文全变问号。要么[System.Text.Encoding]::UTF8.GetBytes手动编码,要么老实用 python 脚本调接口。
结尾
到这里,真人点一遍的操作已经变成了带多候选定位、可回放、可编辑的脚本。但还有个问题没解决------"去删掉昨天创建的那条任务"这种目标怎么测? 这就需要让 LLM 亲自动手了。
下一篇讲 ReAct 引擎:怎么把截图和控件列表喂给多模态模型(SoM 视觉标注)、三级定位优先级怎么设计、失败后怎么把错误信息"回灌"给模型让它自己换策略,以及多设备并发和同设备批量执行的调度设计。
觉得有价值的话点个赞催更,评论区聊聊你现在用的自动化方案踩过什么坑。