前言
近日,Google 发布了新一代旗舰: Gemini 4 Argon。
18 项评测赢了 12 项,80 万行代码迁移,输出上限 100 万 token,价格只有 GPT-6 Astra 的 1/5。
但今天 Carson 不聊跑分,聊一个更实际的问题:这个模型对我们 Android 开发者到底意味着什么?
🤖 它是什么
 上一代旗舰 Gemini 3 系列是 2025 年 11 月的事了。中间半年多,Google 只更新了 Flash 系列。
Argon 是 Gemini 4 世代的第一款旗舰 ,核心定位是:复杂、长周期工作流的深度推理。
关键参数
| 参数 | 数值 |
|---|---|
| 输出 token 上限 | 100 万(上代 6.4 万) |
| 输入定价(推广期) | $2 / 百万 token |
| 输出定价(推广期) | $10 / 百万 token |
| 缓存输入折扣 | 输入价的 5%(打 95 折) |
| 当前状态 | Fairwind 计划限量开放 |
输出从 6.4 万跳到 100 万------15 倍。
这意味着模型可以在单次推理中完成极长的推理链,不需要人为拆分步骤。
三方定价对比
| 模型 | 输入 / 百万 token | 输出 / 百万 token |
|---|---|---|
| Gemini 4 Argon(推广期) | $2 | $10 |
| Claude Opus 5.5 | $4 | $20 |
| GPT-6 Astra | $10 | $50 |
Argon 推广期价格是 GPT-6 Astra 的 1/5 ,正式价格也只有 Astra 的 40%。
同级能力,价格碾压。这对后面 Android Studio 和 ADK 的模型选择有直接影响。
📊 实例跑分说明
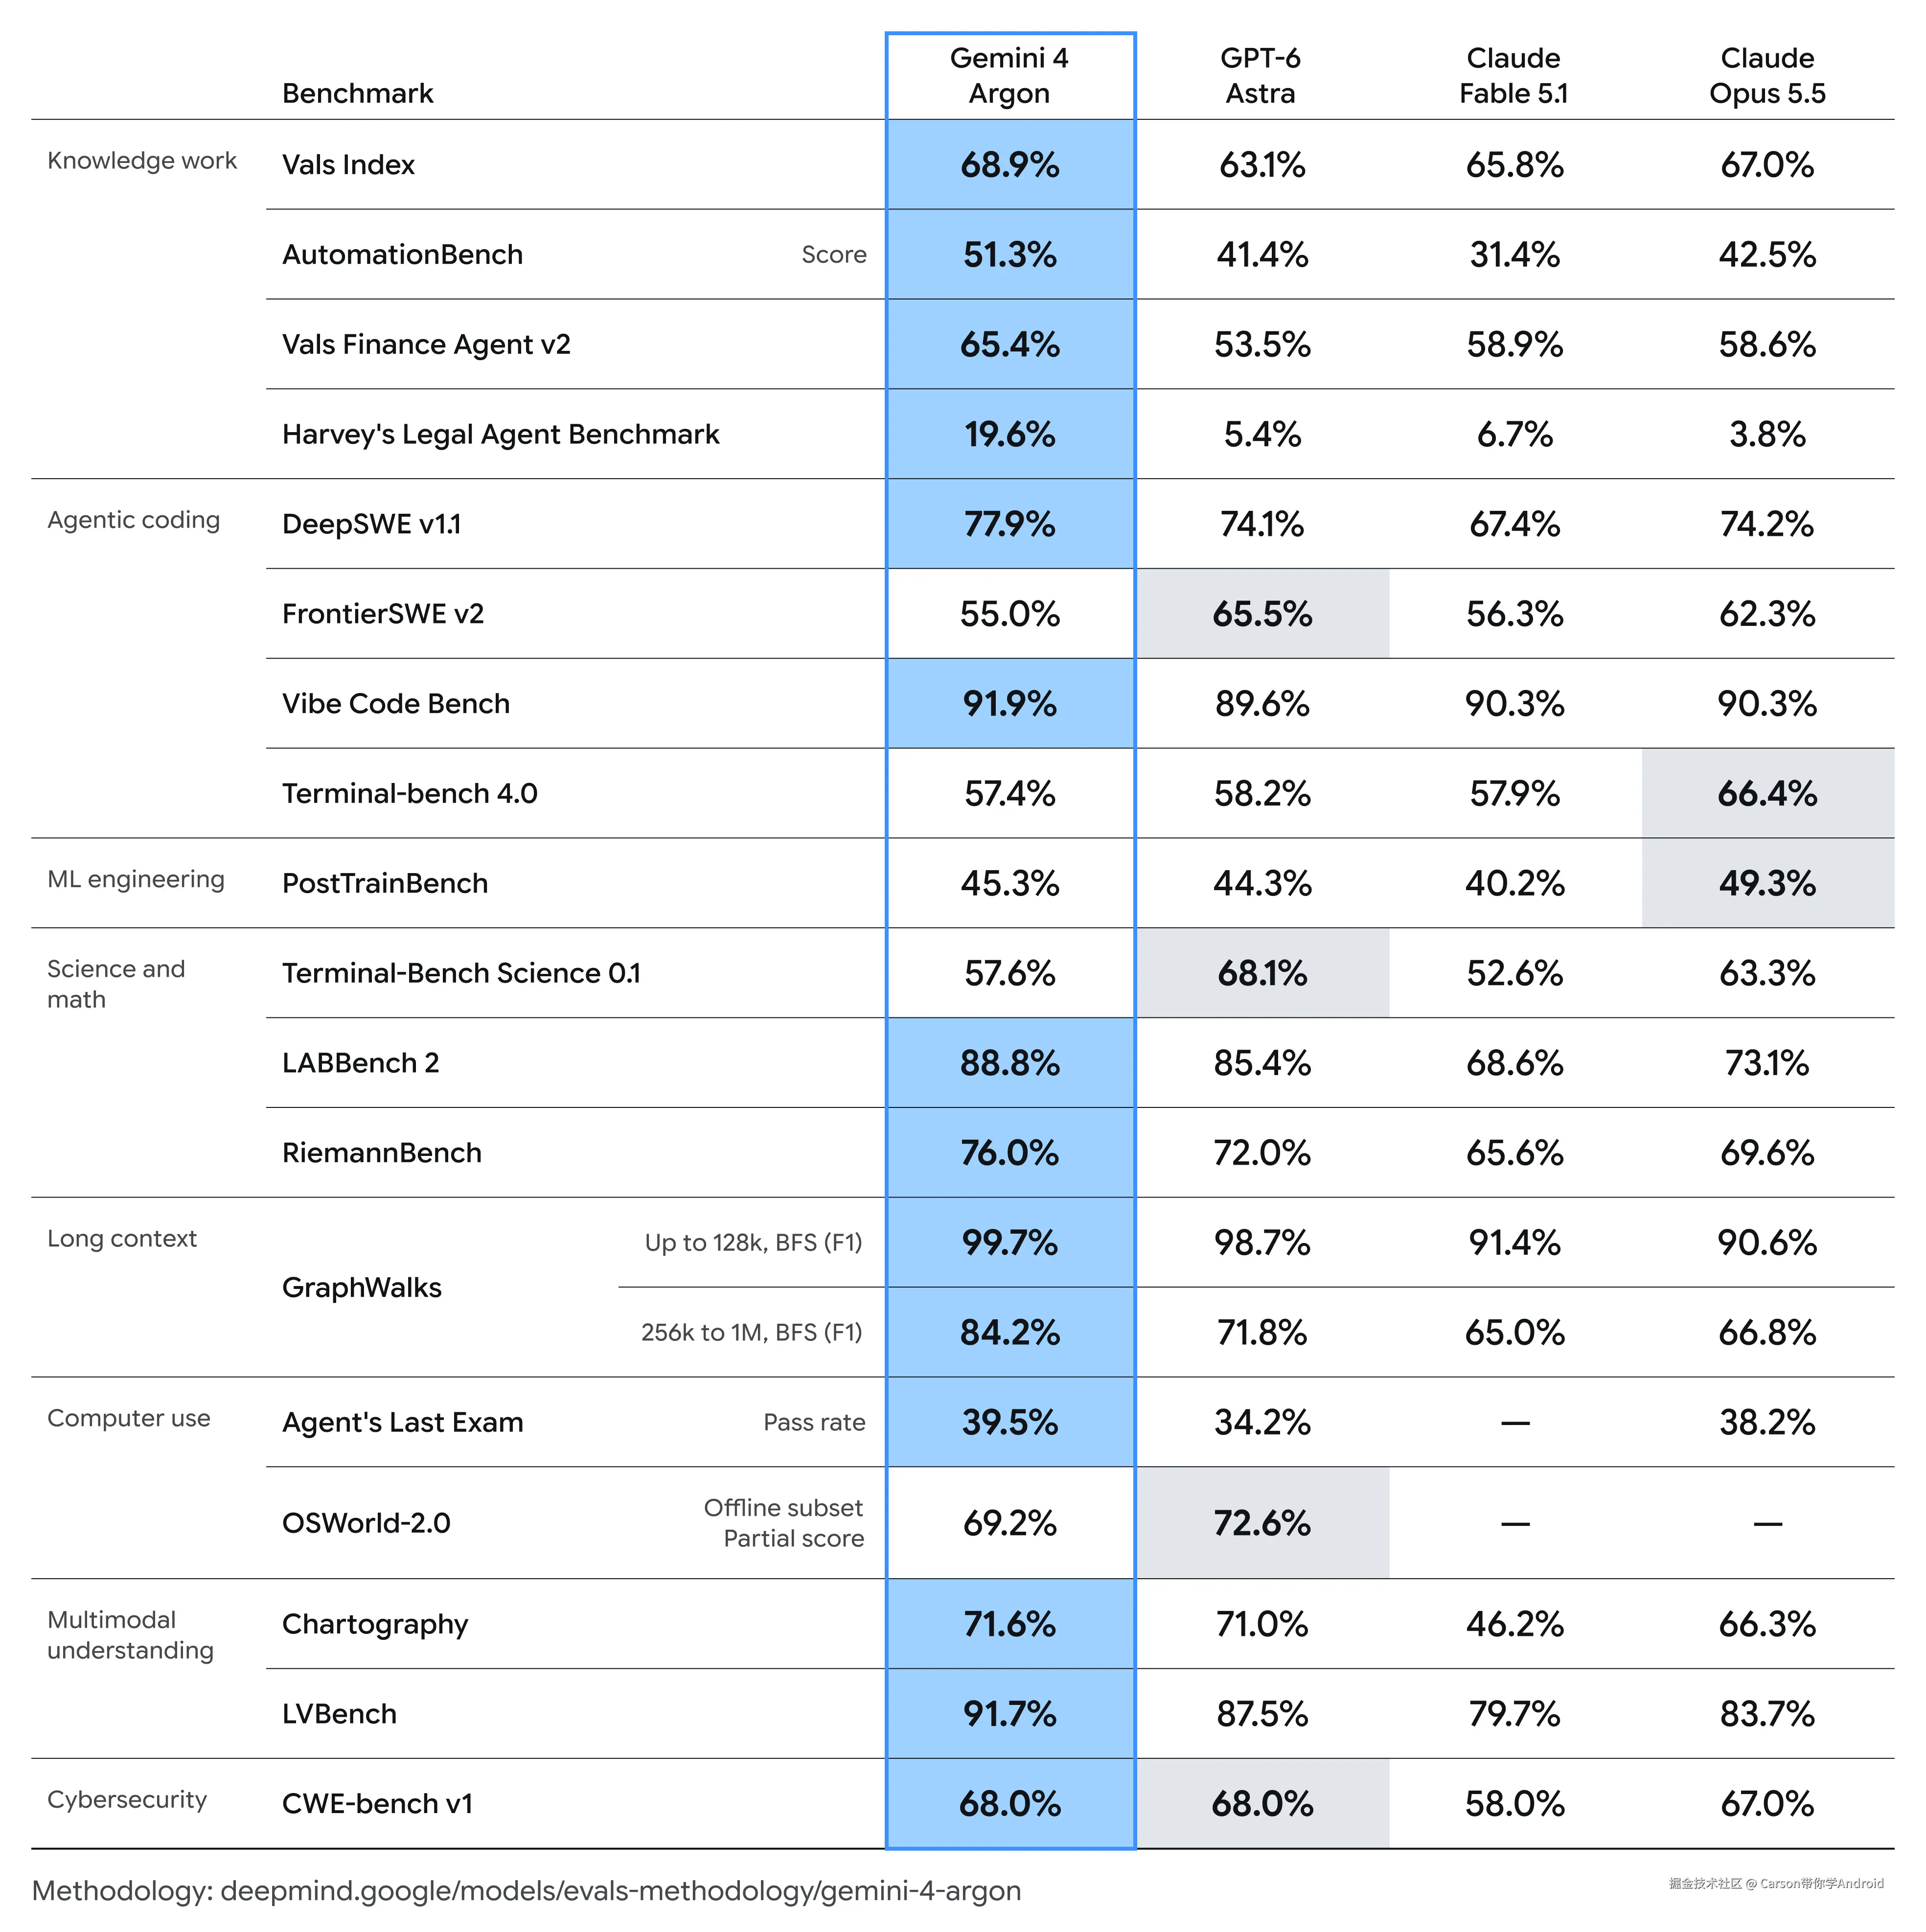
跑分数据很多,我只挑 3 个示例最能说明问题的:
示例1:C++ → Rust 的80 万行代码迁移
Argon Agent 正在帮 Google 内部把 C/C++ 代码迁移到 Rust。
规模不小:
- re2、libgav1 等核心库:数万行;
- Fuchsia Zircon 内核:80 万+ 行。
libgav1 那个案例最有说服力------Argon 替换了约 3.2 万行 SIMD 代码,经过多轮 profile-guided 实验,产出的安全 Rust 代码比原 Rust 移植版快 2.7 倍,视频输出完全一致。
不是"能写代码",而是"能做工程"。
示例2:300 TiB 数据中心内存优化
Argon Agent 自主分析服务器集群的性能遥测数据,已释放超过 300 TiB 内存。
预计总节省量:500 TiB 到 1 PiB。
这不是写个函数的事------它需要理解监控数据、定位瓶颈、提出优化方案。
示例3:量子算法提速 40%
帮量子计算研究人员优化关键子程序的时空资源开销。
几分钟内找到了比已发表基线方案好 40% 的结果。 
总结
Argon 的核心竞争力不在"聊天更聪明",在"能独立完成复杂工程任务"。这才是对开发者真正有意义的能力。
🔗 对 Android 开发者的影响
 Argon 本身目前还用不了。但它的能力会通过 4 条路径渗透到 Android 开发的每个环节。
- Android Studio
- ADK for Kotlin
- Gemini Nano
- Android Bench 2.0
① Android Studio:Agent Mode 要换引擎了
现在 Android Studio 的 Gemini Agent Mode 用的是 Flash 系列模型,现在的 能做的事:
- 单文件代码生成;
- 简单的跨文件重构;
- 测试用例生成。
Argon 的 100 万 token 输出 + 长周期推理能力带来的可能性:
- 整个模块级别的架构重构------不是改一个函数,而是重构一整个 Feature 模块;
- Compose 迁移------把 View 体系的页面自动改写成 Compose,包括 State 管理;
- 多文件联动修改------改了 ViewModel 之后,自动更新对应的 Repository、DAO、UI 层。
⚠️ 现在的 Agent Mode 做多文件联动经常"忘"上下文。100 万 token 输出意味着 Argon 可以在一条推理链中同时持有整个模块的代码,不再需要分步记忆。
深远影响
Android Studio 2027 年的 Gemini Agent Mode,能力可能是现在的 5-10 倍。不是小步迭代,是代际跃迁。
② ADK for Kotlin:Agent 的"大脑"升级了
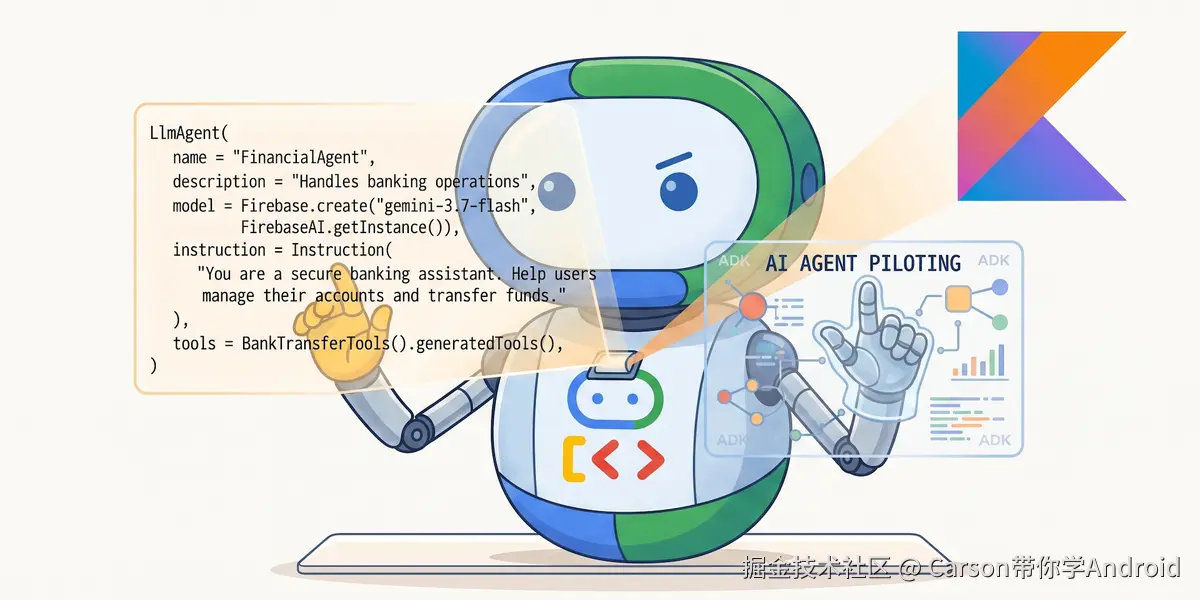 Argon 开放后,ADK Agent 可以接入 Argon 做编排器。
这带来的跟之前Flash系列变化:
| 维度 | Flash 系列 | Argon |
|---|---|---|
| 输出上限 | 8K-64K | 100 万 |
| 复杂任务拆解 | 需要人为拆成小步 | 单次推理完成整条链 |
| 多 Agent 编排 | Router 需要精心设计 | Router 自身就能做深度规划 |
| 长期任务 | 容易丢失上下文 | 100 万 token 内保持完整上下文 |
之前你用 ADK 做一个"代码审查 Agent",可能需要这样拆:
- Agent A:读取 PR 改动;
- Agent B:分析代码风格;
- Agent C:检查安全漏洞;
- Agent D:汇总审查意见。
换成 Argon 当编排器?一个 Agent 可能就够了------100 万 token 的输出空间足够它在单条推理链中完成"读 PR → 分析风格 → 检查安全 → 生成报告"的全链路。
多 Agent 编排不会消失,但"什么时候该拆、什么时候不该拆"的判断标准变了。模型能力够强时,减少编排复杂度反而是更好的工程决策。
③ Gemini Nano:端侧推理的天花板被抬高了
 每次旗舰模型升级,Nano 的下一个版本也会跟着变强。
- Gemini 1.0 → Nano 1;
- Gemini 1.5 → Nano 2(多模态);
- Gemini 2.0 → Nano 3;
- Gemini 3 → Nano 4(当前,基于 Gemma 4 架构)。
按这个节奏,Gemini 4 Argon → Nano 5 只是时间问题。
Nano 5 可能带来什么?
- 更长的端侧上下文窗口------目前 Nano 4 的上下文比较有限,Argon 的长输出能力蒸馏下来后,端侧 Agent 能处理更复杂的本地任务;
- 更强的工具调用能力------Argon 在 AutomationBench 拿了第一,这种"理解任务 → 拆解步骤 → 调用工具"的能力蒸馏到端侧后,蓝心小V、Google Assistant 这类端侧 Agent 的执行准确率会上一个台阶;
- 更低的推理成本------旗舰模型的推理效率提升,蒸馏后端侧模型的功耗也会跟着降。
Argon 不直接跑在手机上,但它决定了下一代端侧 AI 的天花板。
④ Android Bench 2.0:评测标准刚好对上了
巧的是,Google 近日刚发布了 Android Bench 2.0。
2.0 版本的核心变化:从"写一个函数"升级到长周期任务(Long-Horizon Tasks)------架构重构、Compose 重写、无障碍适配、Play Console 合规审查。
这和 Argon 的定位完全吻合:Argon 就是为长周期复杂任务设计的。
| 维度 | Bench 1.0 | Bench 2.0 |
|---|---|---|
| 任务粒度 | 单函数 / 单文件 | 模块级 / 项目级 |
| 执行时长 | 秒级 | 小时级甚至多天 |
| 评估对象 | 模型 | Agent(模型 + 工具 + 编排) |
| 与 Argon 的匹配度 | 一般 | 高度匹配 |
最后
Gemini 4 Argon 的跑分很亮眼,但对 Android 开发者来说,真正重要的不是跑分,而是 4 条渗透路径:
- Android Studio :Agent Mode 从"改函数"升级到"改模块";
- ADK for Kotlin :Agent 的编排器从拼接小模型变成一个大脑搞定全链路;
- Gemini Nano :下一代端侧模型的天花板被 Argon 抬高了;
- Android Bench 2.0 :评测标准和模型能力终于对齐了。
Argon 开放后你最想用它做什么?评论区聊聊!
📎 参考资料 Introducing Gemini 4 Argon(Google 官方博客):blog.google/innovation-...