✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
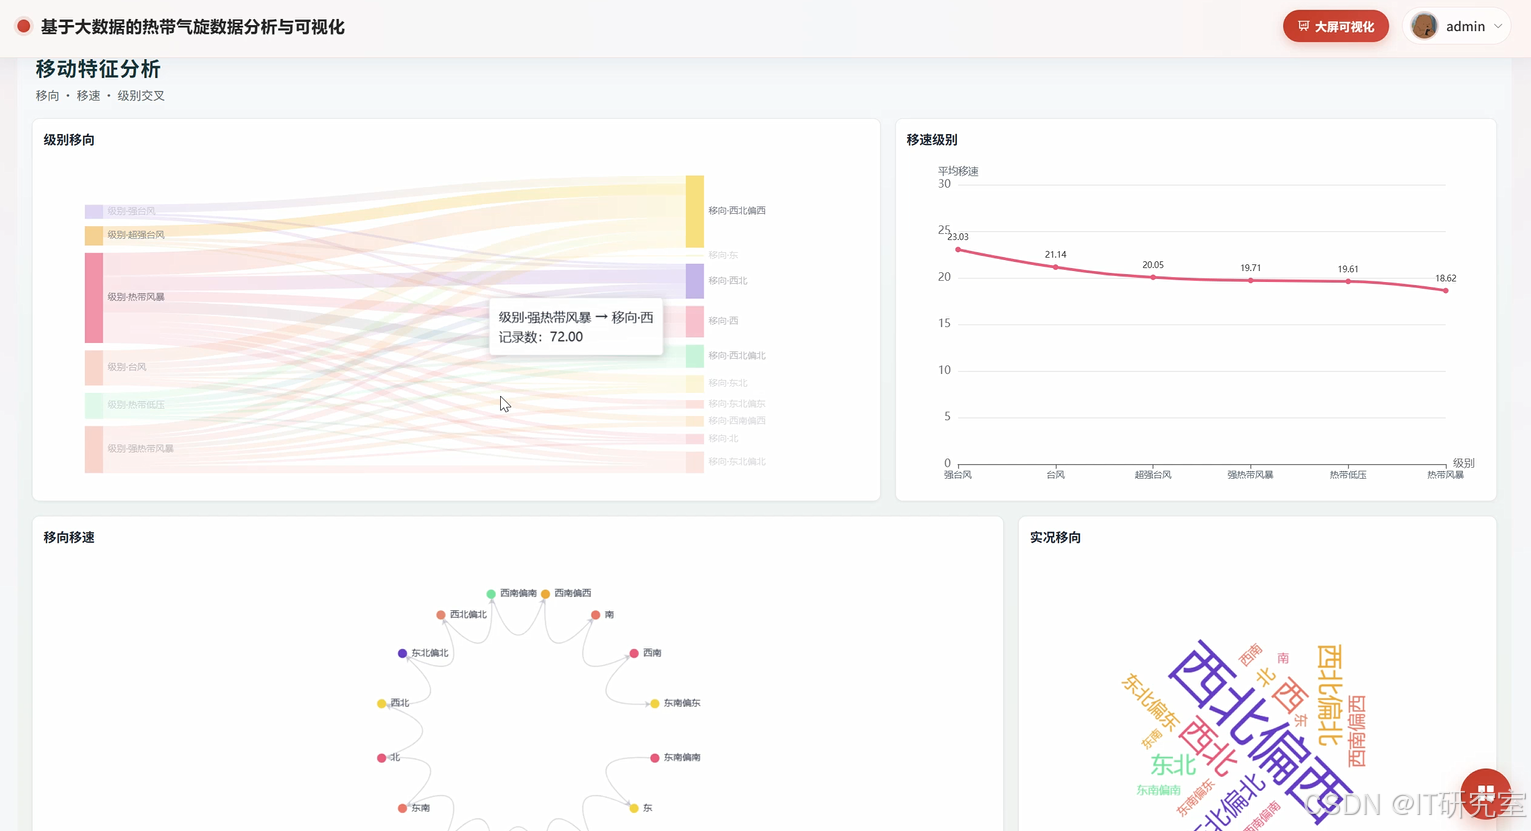
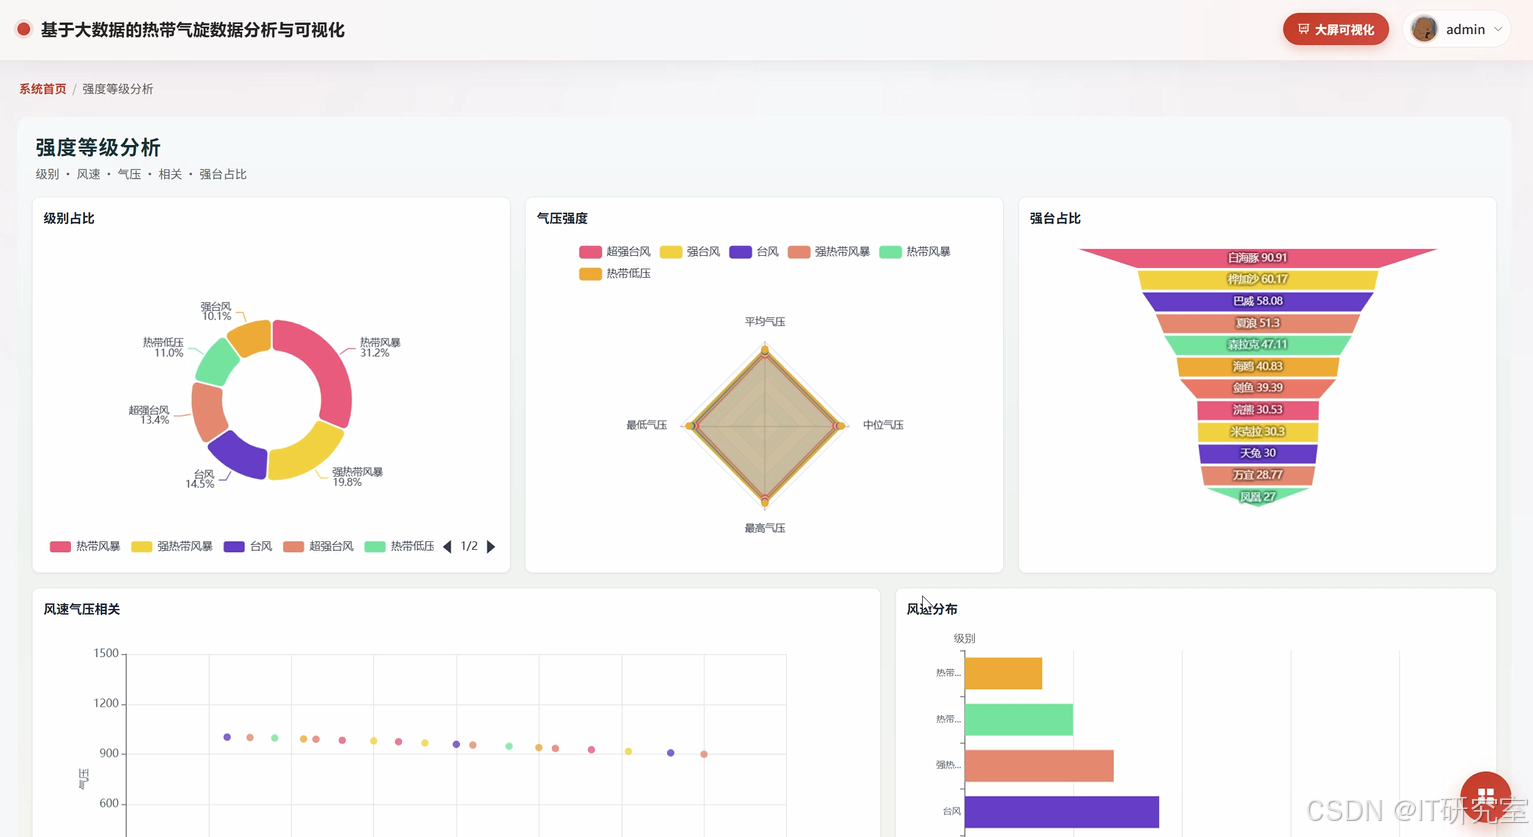
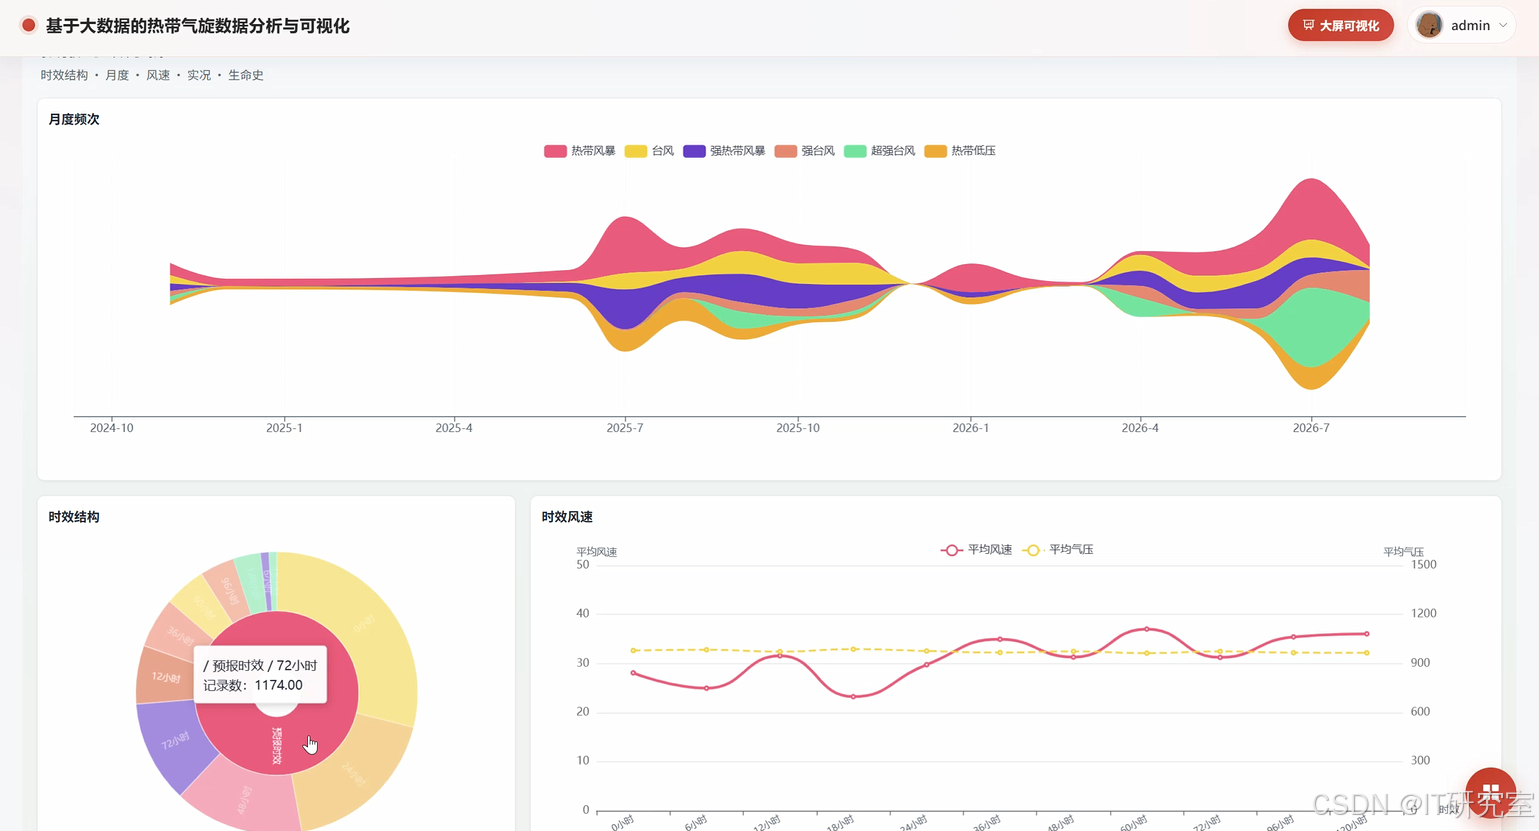
基于大数据的热带气旋数据分析与可视化系统是一套面向气象数据分析场景的毕设项目,整体采用Hadoop与Spark构建大数据处理链路,通过HDFS完成热带气旋原始数据的分布式存储,借助Spark SQL与Pandas、NumPy对气旋信息、移动特征、强度等级、预报时效、路径分布、风圈范围以及风险洞察等维度进行清洗、统计与挖掘,后端分别提供Django与Spring Boot两个版本,前端使用Vue、ElementUI与Echarts完成可视化呈现,数据结果统一存储于MySQL。系统围绕热带气旋信息管理、移动特征分析、强度等级分析、预报时效分析、路径分布分析、风圈范围分析和风险洞察分析等功能展开,能够把原本分散、庞杂的气旋数据整理成相对直观的图表与指标,帮助使用者从路径走向、强度变化、风圈覆盖和风险等级等角度观察热带气旋的演变规律,也为同类气象数据的处理与展示提供一个可参考的实现思路。
选题背景
热带气旋是一种破坏力很强的天气系统,它的移动路径、强度变化和风圈范围会直接影响沿海地区的防灾安排。过去很多气象数据以文本或表格形式保存,数据量一大,普通工具处理起来就吃力,查询和分析也不够灵活。这几年Hadoop、Spark这类大数据技术慢慢成熟,把海量气旋记录放到HDFS上存储,再用Spark SQL做分布式统计,已经能比较快地完成路径、强度和风圈等指标的汇总。不过对很多计算机专业的学生来说,真正把大数据技术用到气象领域,并且做成一个看得见、能操作的系统,仍然缺少合适的参考案例。本课题就想把热带气旋数据和Hadoop、Spark结合起来,配合Django或Spring Boot以及Echarts,做一个集数据存储、分析计算和可视化展示于一体的系统,让气旋数据的处理过程更清晰,也为后续类似课题提供一个可以动手实现的样本。
选题意义
从实际角度看,这个系统能把热带气旋的路径、强度、风圈和风险等信息集中展示出来,比单纯翻表格要直观一些,对气象数据的日常查看和简单分析有一定帮助。从学习角度看,它把Hadoop、Spark、Spark SQL、Django或Spring Boot以及Echarts这些技术串在一起,能让我把课堂上学到的分布式存储、数据统计和可视化知识真正用一遍,对大数据项目的完整流程也会有更具体的体会。从参考角度看,气象类毕设本身不算多,把大数据技术用到热带气旋分析上的案例更少,这个系统做出来以后,或许能给后面选类似题目的同学提供一点思路。当然,它只是一个毕业设计,功能和数据规模都有限,分析深度也谈不上专业气象级别,更多是起到练习和尝试的作用,离真正投入业务使用还有不小距离。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
- 基于大数据的热带气旋数据分析与可视化界面展示:
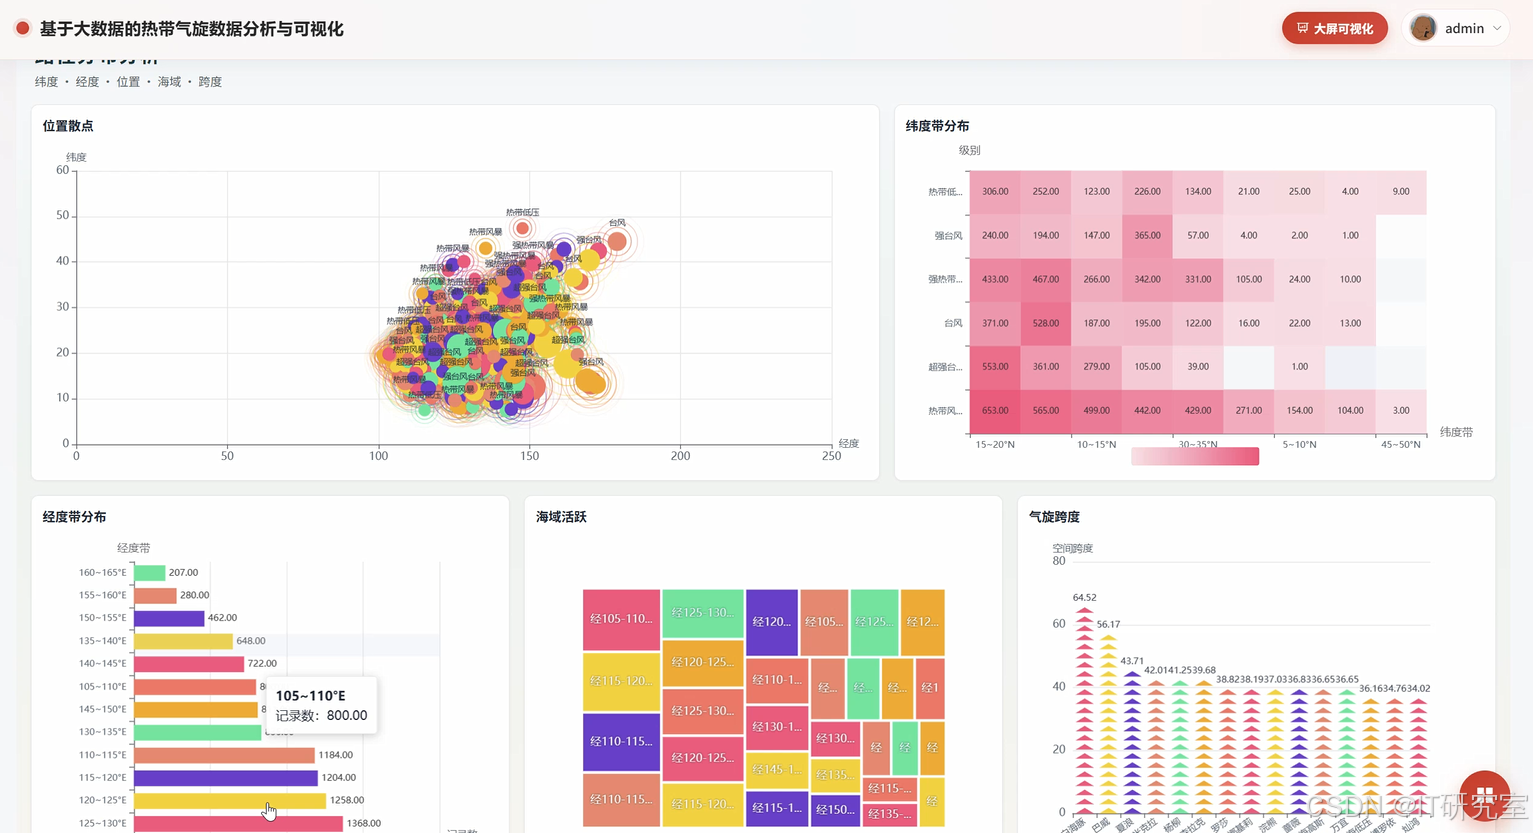
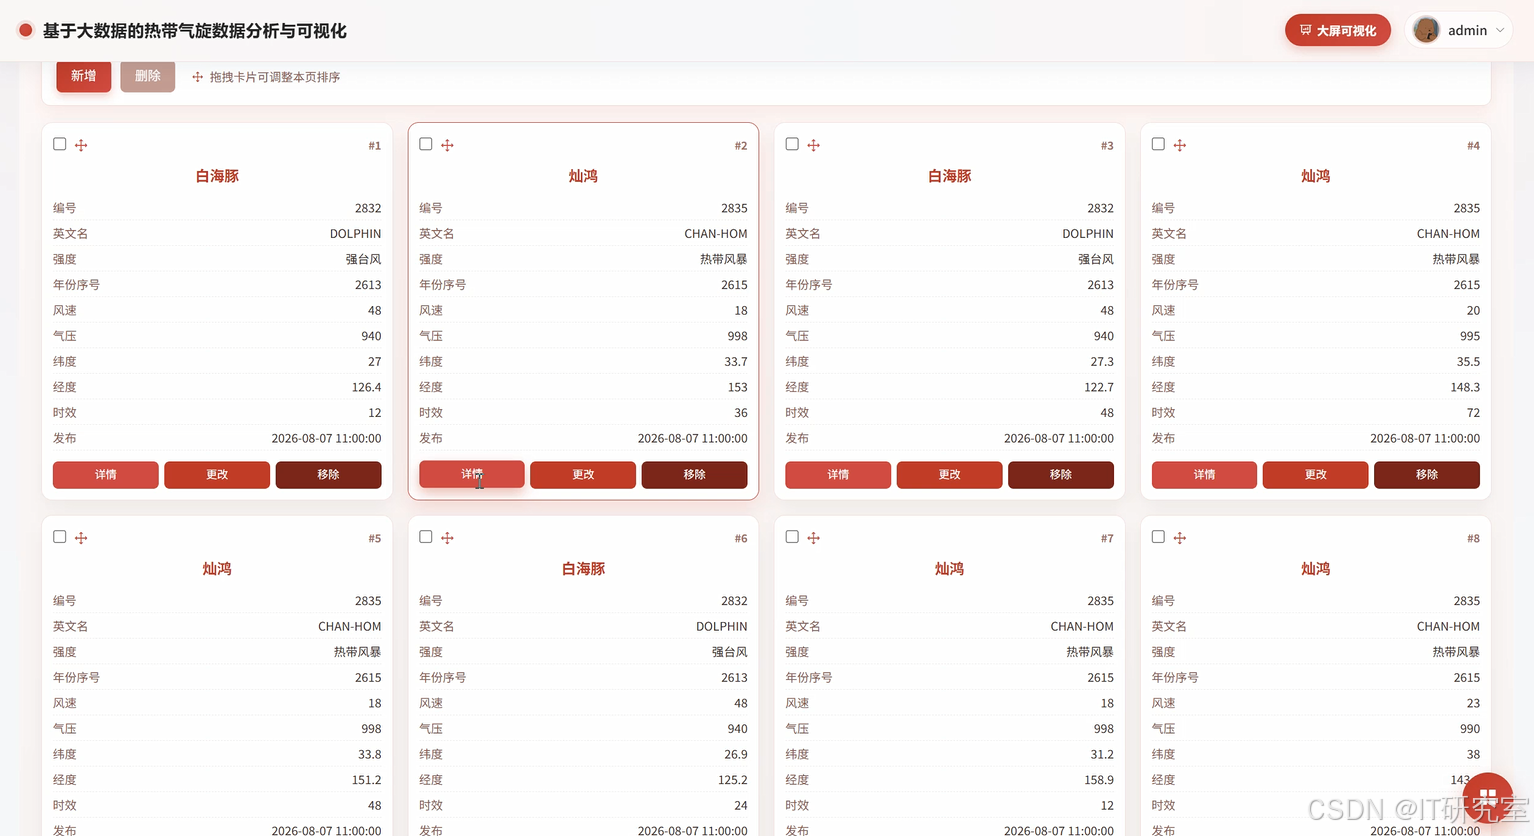
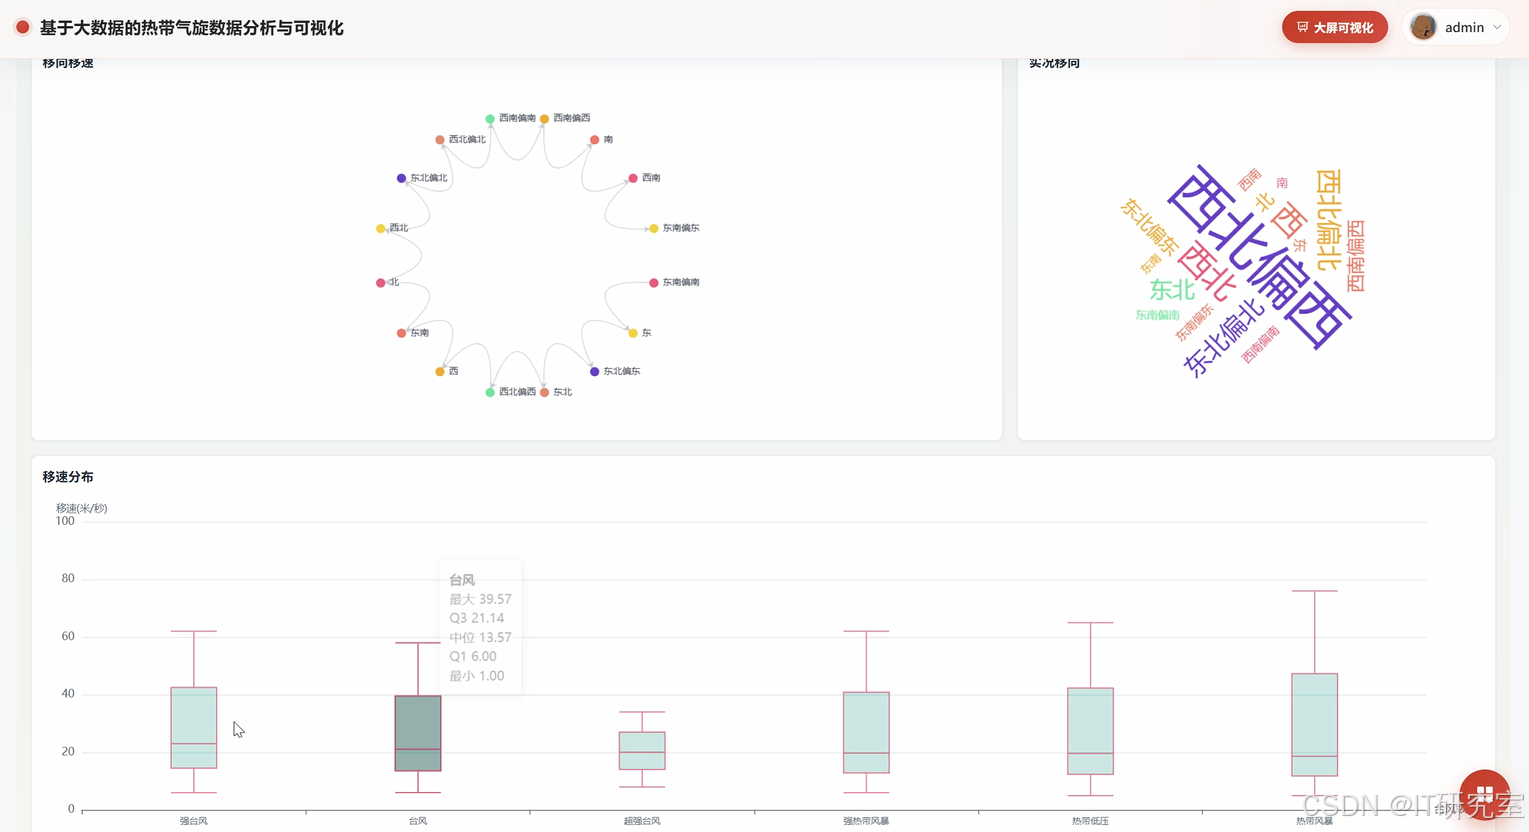
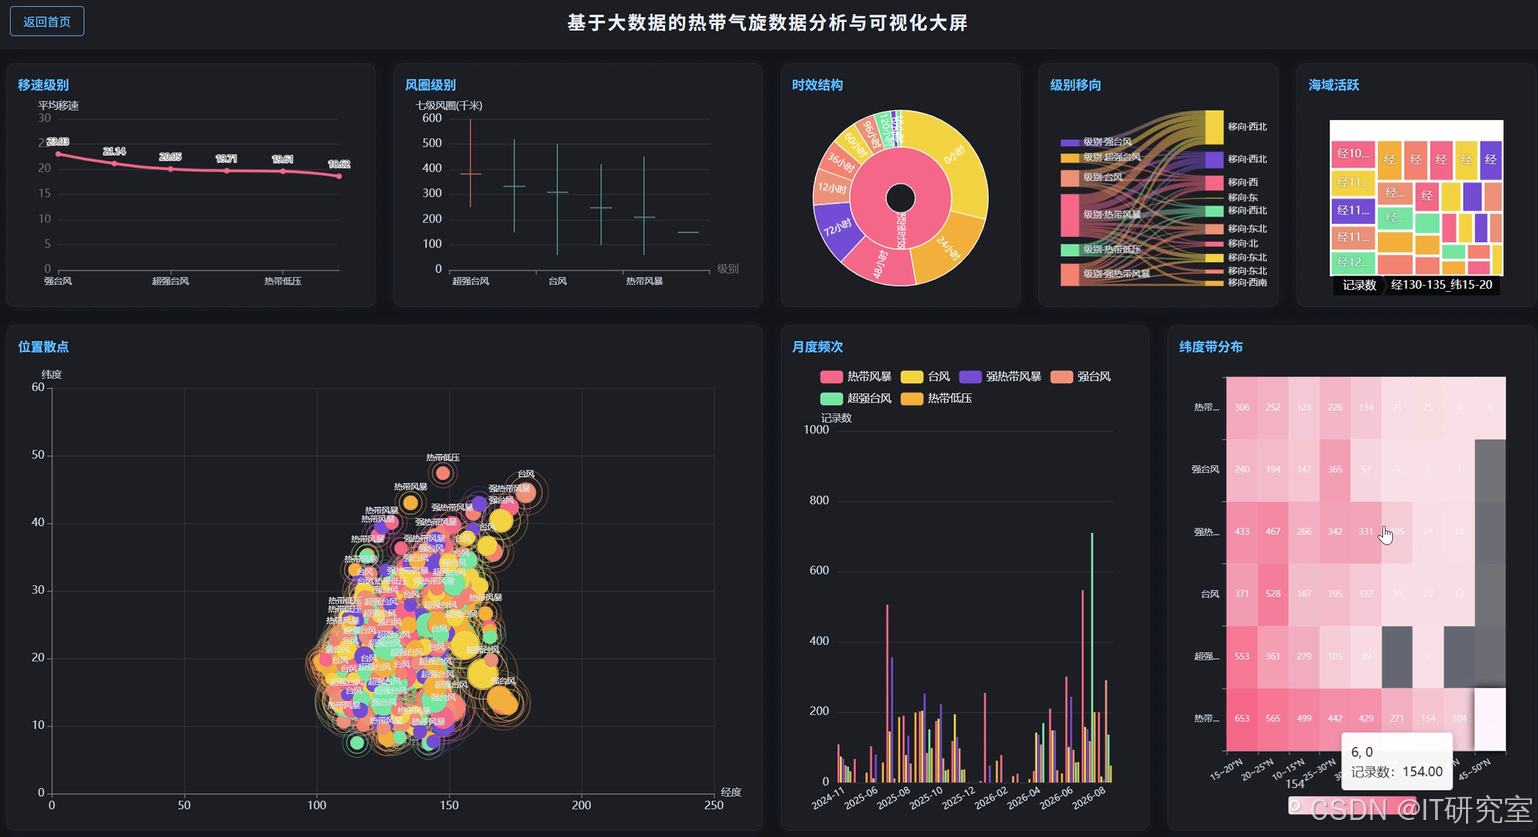
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, avg, max, min, when, desc
import pandas as pd
import numpy as np
spark = SparkSession.builder.appName("TropicalCycloneAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()
cyclone_df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/cyclone/cyclone_info.csv")
cyclone_df.createOrReplaceTempView("cyclone_info")
def analyze_movement_feature():
    movement_df = spark.sql("SELECT cyclone_id, cyclone_name, AVG(move_speed) AS avg_speed, AVG(move_direction) AS avg_direction, COUNT(*) AS track_points FROM cyclone_info GROUP BY cyclone_id, cyclone_name")
    movement_df = movement_df.withColumn("speed_level", when(col("avg_speed") < 10, "慢速").when((col("avg_speed") >= 10) & (col("avg_speed") < 20), "中速").otherwise("快速"))
    movement_result = movement_df.orderBy(desc("avg_speed")).collect()
    for row in movement_result:
        print("气旋编号:", row["cyclone_id"], "气旋名称:", row["cyclone_name"], "平均移速:", row["avg_speed"], "移动方向:", row["avg_direction"], "路径点数:", row["track_points"], "移速等级:", row["speed_level"])
    return movement_result
def analyze_intensity_level():
    intensity_df = spark.sql("SELECT cyclone_id, cyclone_name, MAX(intensity) AS max_intensity, MIN(intensity) AS min_intensity, AVG(intensity) AS avg_intensity, COUNT(*) AS record_count FROM cyclone_info GROUP BY cyclone_id, cyclone_name")
    intensity_df = intensity_df.withColumn("intensity_level", when(col("max_intensity") < 34, "热带低压").when((col("max_intensity") >= 34) & (col("max_intensity") < 48), "热带风暴").when((col("max_intensity") >= 48) & (col("max_intensity") < 64), "强热带风暴").otherwise("台风及以上"))
    intensity_pd = intensity_df.toPandas()
    intensity_pd["intensity_score"] = intensity_pd["avg_intensity"] * 0.6 + intensity_pd["max_intensity"] * 0.4
    intensity_pd = intensity_pd.sort_values(by="intensity_score", ascending=False)
    for index, row in intensity_pd.iterrows():
        print("气旋编号:", row["cyclone_id"], "气旋名称:", row["cyclone_name"], "最大强度:", row["max_intensity"], "最小强度:", row["min_intensity"], "平均强度:", row["avg_intensity"], "强度等级:", row["intensity_level"], "强度得分:", row["intensity_score"])
    return intensity_pd
def analyze_path_distribution():
    path_df = spark.sql("SELECT cyclone_id, cyclone_name, latitude, longitude, intensity, move_speed FROM cyclone_info WHERE latitude IS NOT NULL AND longitude IS NOT NULL")
    path_df = path_df.withColumn("lat_zone", when(col("latitude") < 15, "低纬区").when((col("latitude") >= 15) & (col("latitude") < 25), "中纬区").otherwise("高纬区"))
    path_df = path_df.withColumn("lon_zone", when(col("longitude") < 120, "西部海域").when((col("longitude") >= 120) & (col("longitude") < 140), "中部海域").otherwise("东部海域"))
    path_pd = path_df.toPandas()
    path_group = path_pd.groupby(["lat_zone", "lon_zone"]).agg(path_count=("cyclone_id", "count"), avg_intensity=("intensity", "mean"), avg_speed=("move_speed", "mean")).reset_index()
    path_group["density_level"] = np.where(path_group["path_count"] > 50, "高密度", np.where(path_group["path_count"] > 20, "中密度", "低密度"))
    for index, row in path_group.iterrows():
        print("纬度区域:", row["lat_zone"], "经度区域:", row["lon_zone"], "路径点数:", row["path_count"], "平均强度:", row["avg_intensity"], "平均移速:", row["avg_speed"], "密度等级:", row["density_level"])
    return path_group
if __name__ == "__main__":
    analyze_movement_feature()
    analyze_intensity_level()
    analyze_path_distribution()
    spark.stop()
五、系统视频
基于大数据的热带气旋数据分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的热带气旋数据分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇