关注我的公众号:【编程朝花夕拾】,可获取首发内容。
01 引言
在企业里经常会遇到沉积多年的文档,想要知道某个关键词来自哪个文档,毫无头绪,纵使有类似everything这样的外部工具,但却无法通过内容搜索。
随着AI的发展,很多公司通过建立知识库,达到了快速检索的目的。本节不聊知识库,分享一个极简的文档管理平台Papra ,同样能够达到搜索的目的。
02 简介
Papra 是一个极简的文档管理与归档平台。它的设计目标是简单易用,让人人都能轻松上手。定位类似于Paperless-ngx 的轻量替代品,专注于长期文档存储与管理------把那些"不知道什么时候会用上但丢了就麻烦"的文档(收据、保修卡、合同、发票等)统一存起来,随时全文搜索找回。
Github地址:github.com/papra-hq/pa...
体验地址:demo.papra.app/
03 部署
我们采用Docker部署的方式。
部署文档地址:docs.papra.app/self-hostin...
3.1 生成认证秘钥
Papra的启动需要一个秘钥,可以自己配置,也可以通过工具生成。
命令行:
bash
openssl rand -hex 48通过官网工具直接生成:
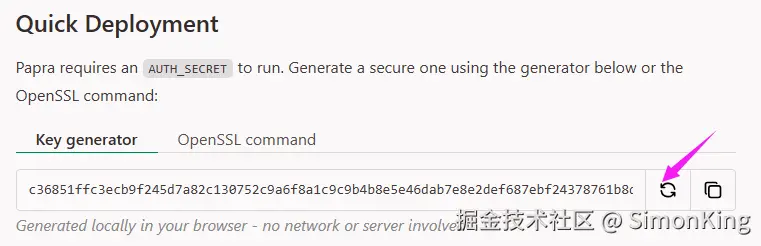
3.2 持久化准备
持久化是可选的,正常使用我们需要持久化我们文档,创建挂载的文档。
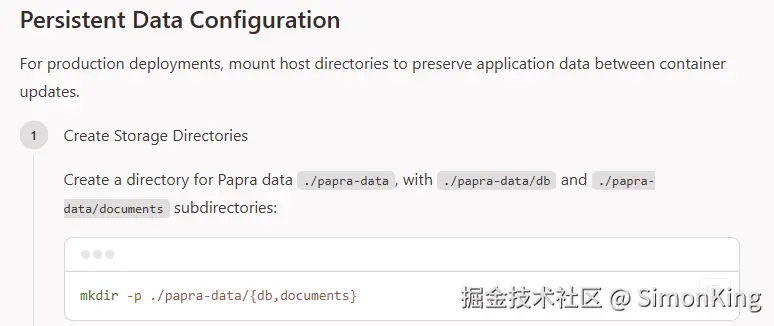
bash
mkdir -p ./papra-data/{db,documents}3.3 拉取镜像并启动
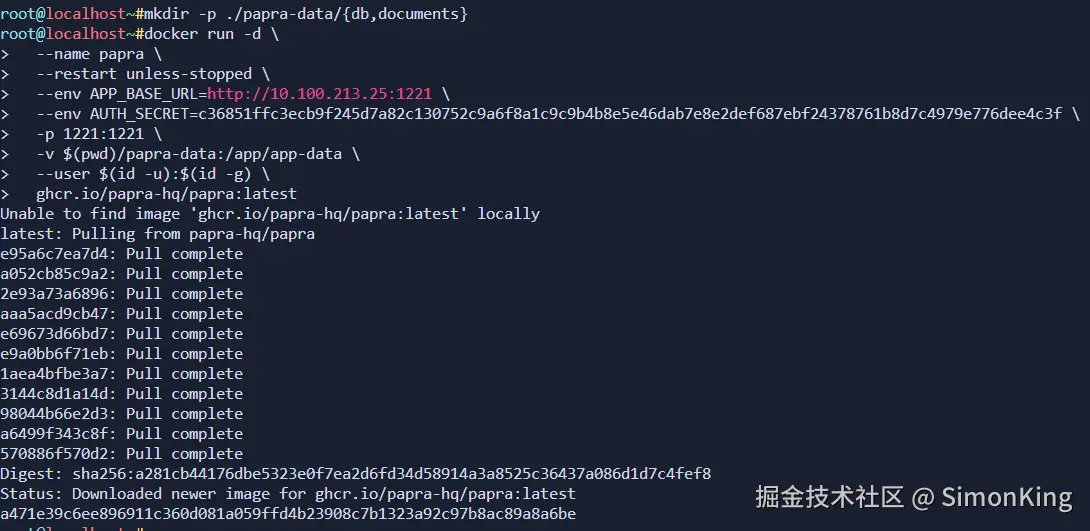
bash
docker run -d \
>   --name papra \
>   --restart unless-stopped \
>   --env APP_BASE_URL=http://xxxxx.25:1221 \
>   --env AUTH_SECRET=c36851ffc3ecb9f245d7a82c130752c9a6f8a1c9c9b4b8e5e46dab7e8e2def687ebf24378761b8d7c4979e776dee4c3f \
>   -p 1221:1221 \
>   -v $(pwd)/papra-data:/app/app-data \
>   --user $(id -u):$(id -g) \
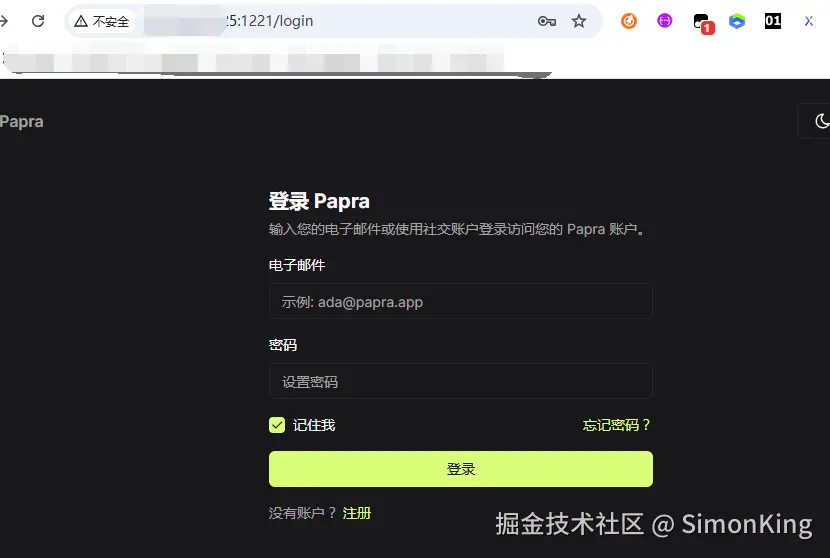
> ghcr.io/papra-hq/papra:latest启动完成之后,访问:http://ip:1221 即可
04 使用
4.1 注册账号
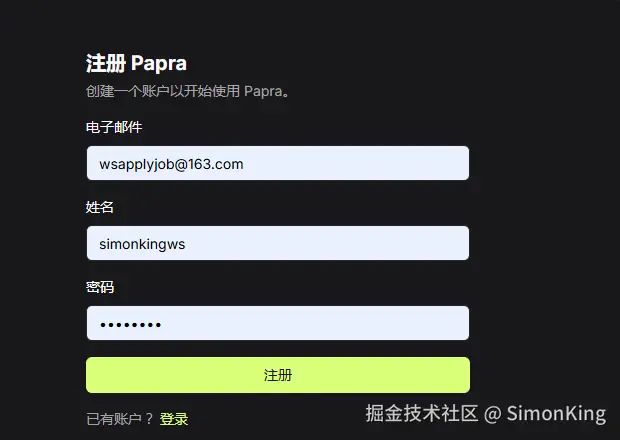
初次进入需要注册账号,我们正常注册即可。
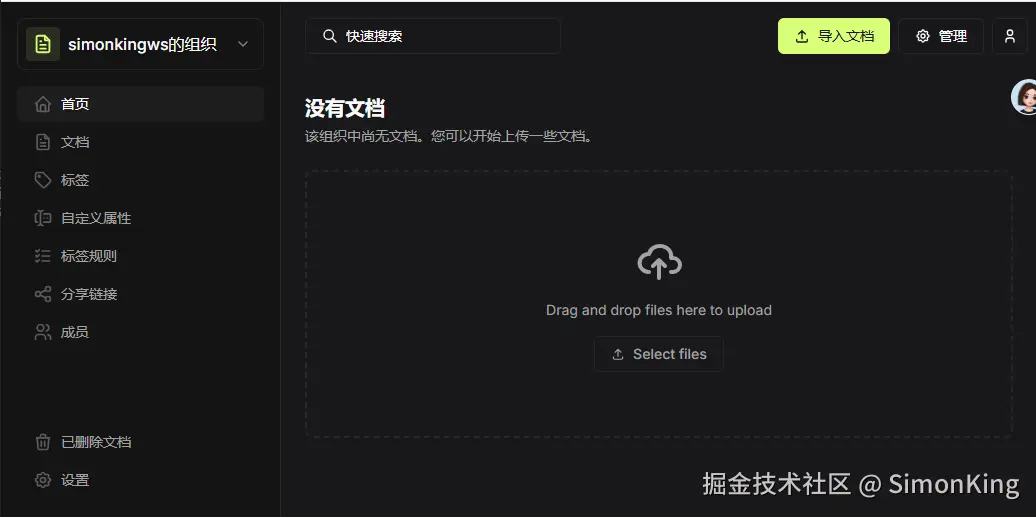
注册完成之后就会进入主页:
4.2 导入文档
进入主页之后,我们就可导入管理的文档。导入的文档就可以展示文档列表。
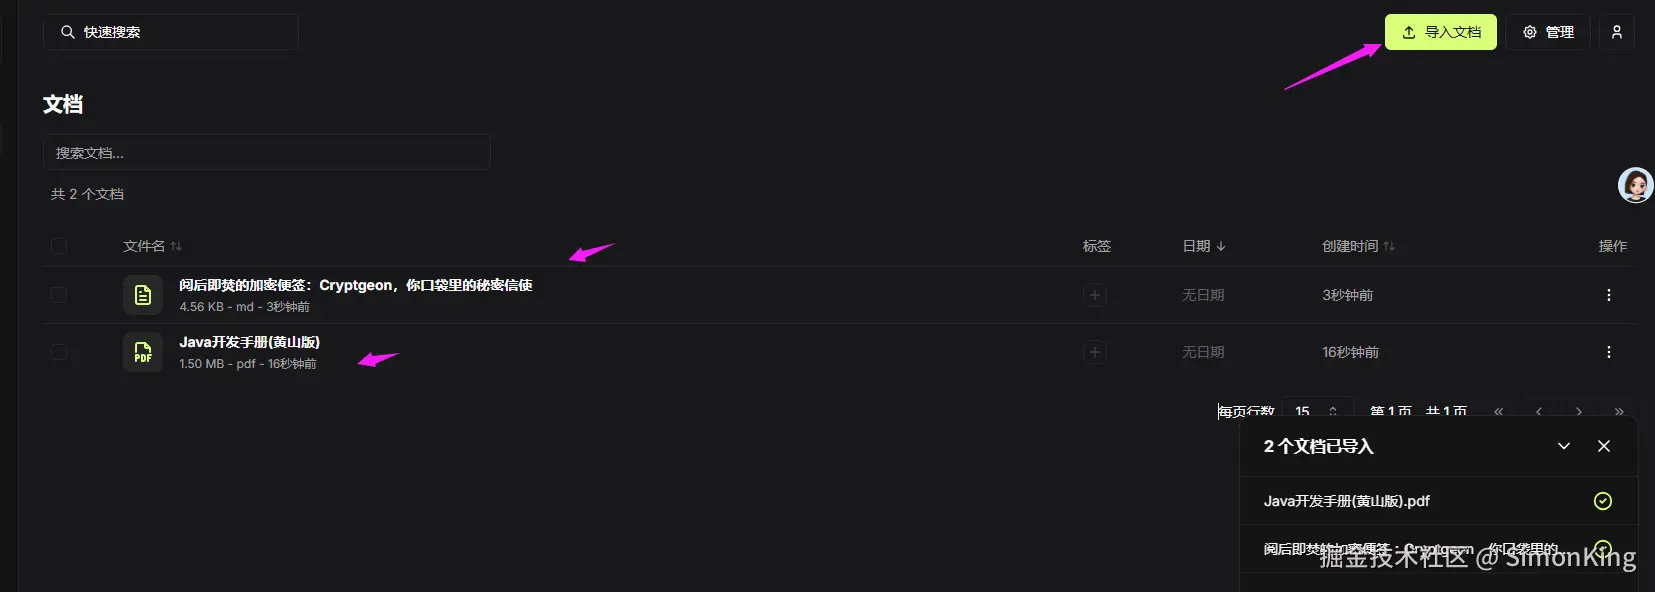
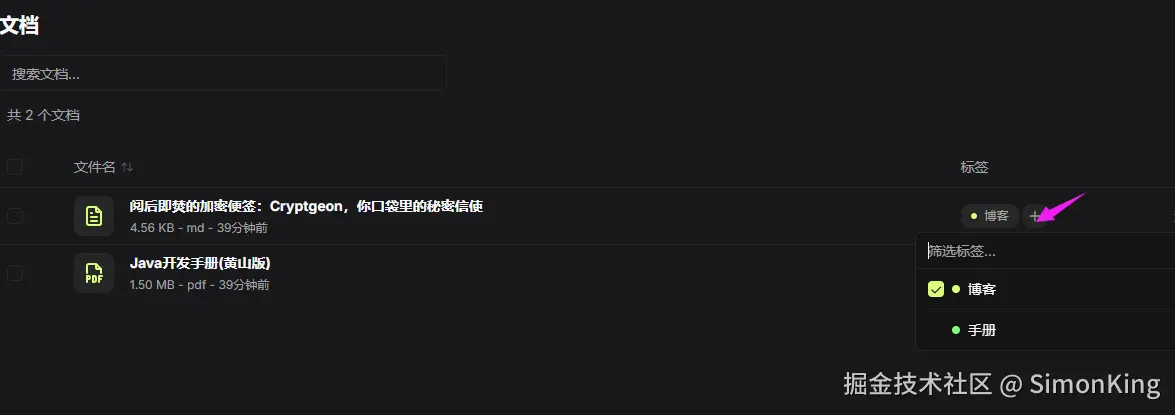
我们还可以为自己的文档打上标签:
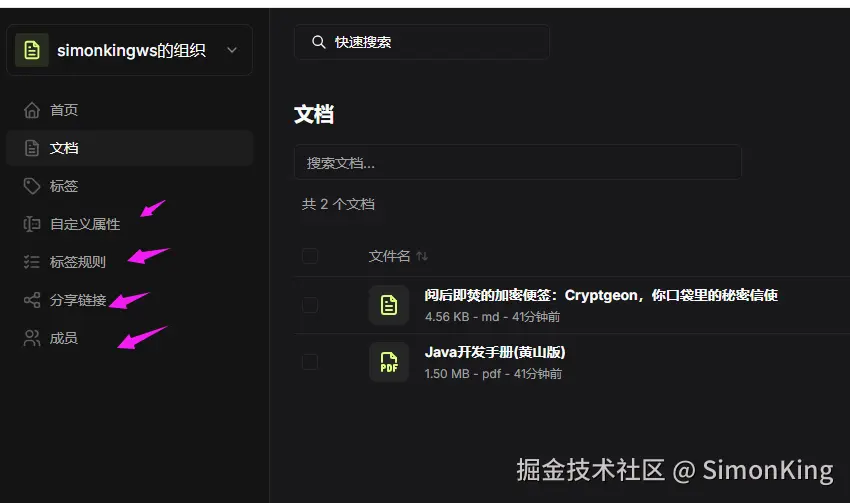
左侧还可以管理属性、标签规则、分享链接以及成员管理:
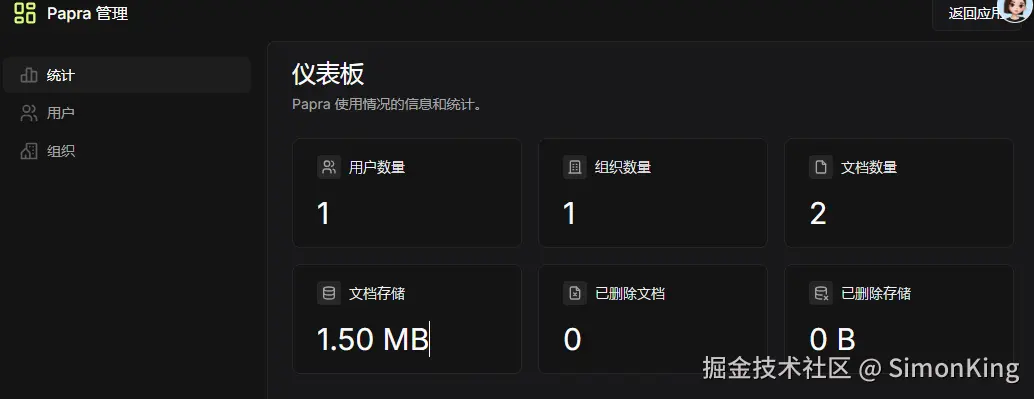
还可以通过右侧的管理直接查看仪表盘等:
4.3 搜索
搜索功能是该项目的主要功能。
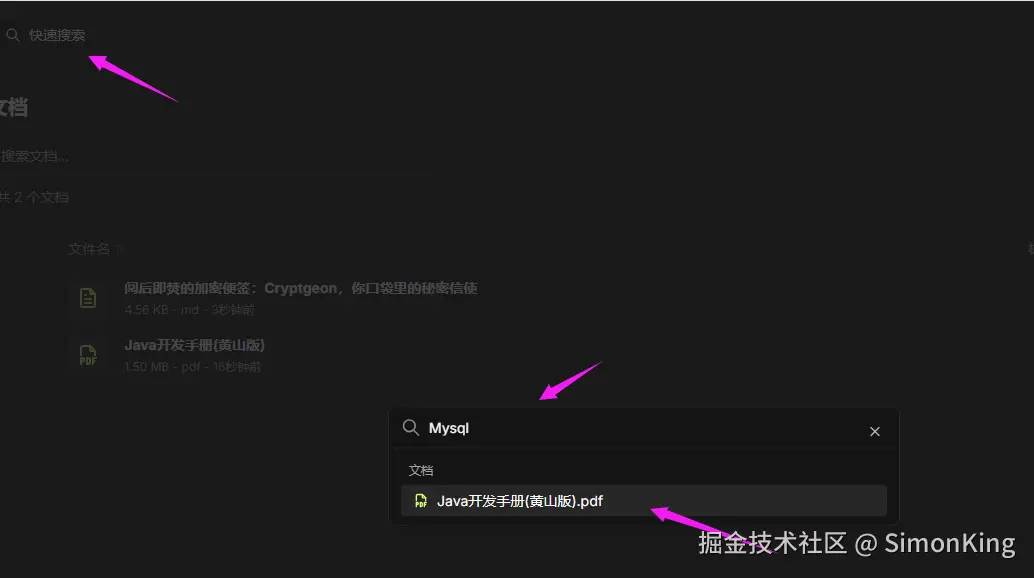
例如我们直接搜索:Mysql
就会直接罗列出包含内容的文档,帮助我们快速找到文档的出处。
找到文档,我们就可以查看文档的详情:
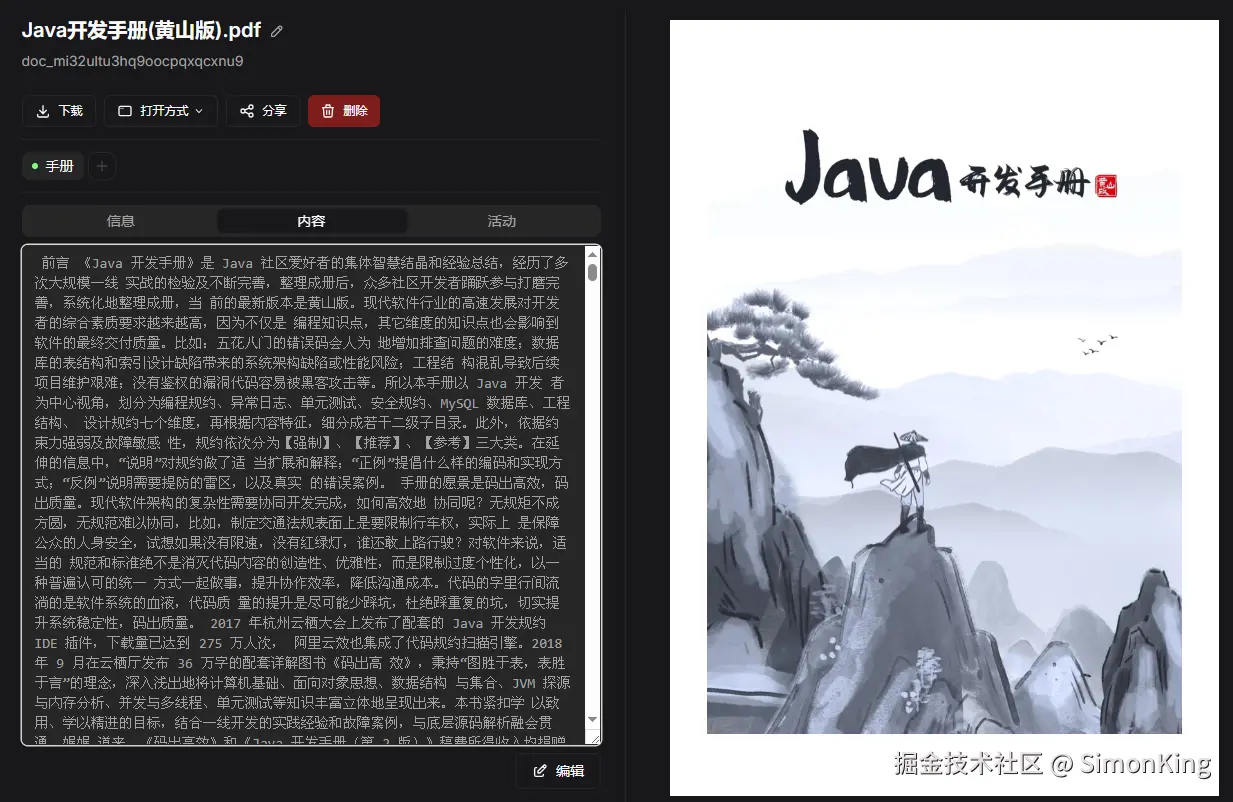
4.4 搜索不到的原因
在测试过程中,并不是内容中所有的文字都可以搜索到。
Papra 用的是 SQLite FTS5(Full-Text Search 5)------SQLite 内置的全文搜索引擎,零外部依赖,数据存在同一个 .sqlite 文件里,默认分词器叫 unicode61,使用过ES或者Solr的朋友可能都知道倒排索引的原理。
05 小结
Papra 是一个定位精准、部署简单、功能够用的文档管理工具。它不追求大而全,而是把"上传 → 提取文字 → 打标签 → 搜索"这条核心链路做到极简。对于不需要 Paperless-ngx 那种重量级系统的个人或小团队来说,Papra 是一个非常合适的自托管选择。