第 2 讲 基础架构:一条 SQL 查询语句是如何执行的
从连接器到存储引擎的完整链路
------ 基于 percona-server-9.7.1-1 源码(MySQL 9.7 LTS)
一、开篇问题引入
你敲下 mysql 客户端、回车执行一条 select * from T where id=5;,在结果返回之前的这几百毫秒里,MySQL 内部究竟经历了什么?很多一线的开发与 DBA 只能答出"走索引"或"全表扫描",但这两个词只是执行器与存储引擎协作后的结果,远不是全貌。一条 SQL 从网络字节流变成结果集,要连续穿过五层组件的协作:连接器、分析器、优化器、执行器、存储引擎。理解这条链路,是读懂后续 44 讲(索引、锁、事务、复制、性能)的前提------你遇到的每一个慢查询、每一次选错索引、每一条"You have an error in your SQL syntax"报错,都能在这五层里找到根因。
本章基于 percona-server-9.7.1-1(MySQL 9.7 LTS)源码,带你把这条链路走通,并指出 9.7 与旧版教材的几个关键差异------其中最重要的一条是:MySQL 8.0 起已经彻底移除了查询缓存,9.7 中那条"先查缓存"的老路径不复存在。
二、原理剖析:MySQL 的逻辑分层
MySQL 整体分为上下两层(见图 2-2):上层是 Server 层,涵盖连接器、分析器、优化器、执行器,以及所有内置函数、日期/数学/加密函数、还有 binlog;下层是存储引擎层,负责数据的存储与提取,插件式架构下可选 InnoDB(默认)、MyISAM、Memory 等。Server 层与存储引擎层之间,通过统一的 handler 抽象接口解耦------执行器并不关心底层是 B+树还是堆表,它只调用 handler 定义的 read_first / read_next / index_read 等虚函数。这也是为什么 InnoDB 能成为默认引擎、而 MyISAM 仍可并存的原因。
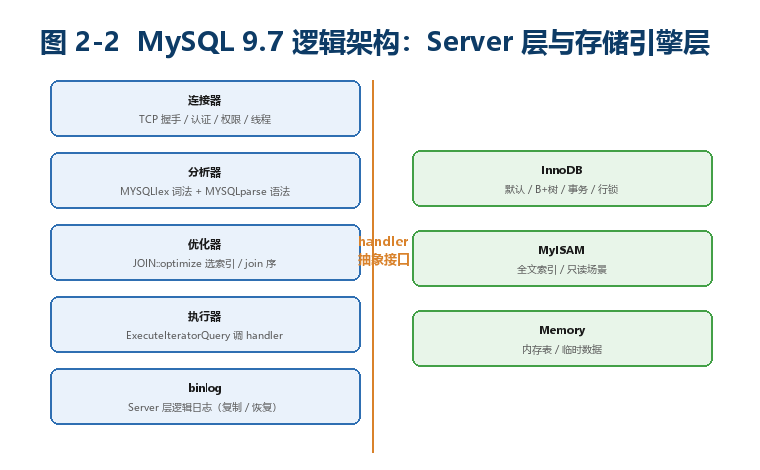
图 2-2 MySQL 9.7 逻辑架构:Server 层与存储引擎层
1. 连接器:谁有权进来、进来后占什么资源
连接器负责与客户端建立 TCP 连接、完成握手、校验用户名密码与主机白名单,并读取该用户的全局权限缓存进线程上下文。认证通过后,连接由连接池中的线程接管(每连接一线程模型,由 connection handler 管理)。这里有两个工程上极易踩坑的点:其一是长连接,连接后的临时内存(如执行计划缓存、net buffer)会一直挂在连接线程上,大量长连接累积会导致内存缓慢上涨,MySQL 5.7 前常因此 OOM;其二是权限的"时点"问题------连接器读到的权限是连接建立那一刻的快照,后续用管理员账号 revoke 权限,已存在的连接不会立即失效,必须等其重连。因此线上长期连接建议设置 wait_timeout 定期回收,或在执行大查询前调用 mysql_reset_connection 复位会话状态,而不必重建 TCP 连接。
2. 查询缓存:9.7 中已被移除
在 MySQL 5.7 及更早版本,分析器之前还有一道"查询缓存":以 SQL 字符串为 key 缓存结果集,命中则直接返回。但 8.0 起官方已彻底删除该模块(9.7 代码中仅 sys_vars.cc、mysqld.cc 等处残留少量历史变量引用,不再有任何 Query_cache 实体实现),原因是其收益极低而代价极高:任何对表的写操作都会使该表相关缓存全部失效,高并发写场景下命中率趋近于零;且缓存的失效与访问都需要全局锁,反而成为瓶颈。结论很明确:在 9.7 上不要再把性能寄托于查询缓存,该用 buffer pool、用业务层缓存(如 Redis)。图 2-1 中我们特意标出"查询缓存已移除",正是为了纠此前的认知惯性。
3. 分析器:词法 + 语法,生成解析树
SQL 是文本,Server 层要先"读懂"它。分析器分两步:词法分析由 MYSQLlex(flex 扫描器,源 sql_lex.cc)把字符流切分成 token,识别出"select / T / where / id / = / 5"等;语法分析由 MYSQLparse(Bison 生成,文法在 sql_yacc.yy)按 MySQL 的语法规则构造解析树,并做语义检查------表是否存在、列是否存在、用户对该表是否有操作权限。任一环节失败都会抛出经典的"You have an error in your SQL syntax"或"Unknown column"。需要强调:权限的粗粒度检查(表级)在分析器阶段完成,而更细粒度的行/列权限会在执行器逐行访问时再校验一次。
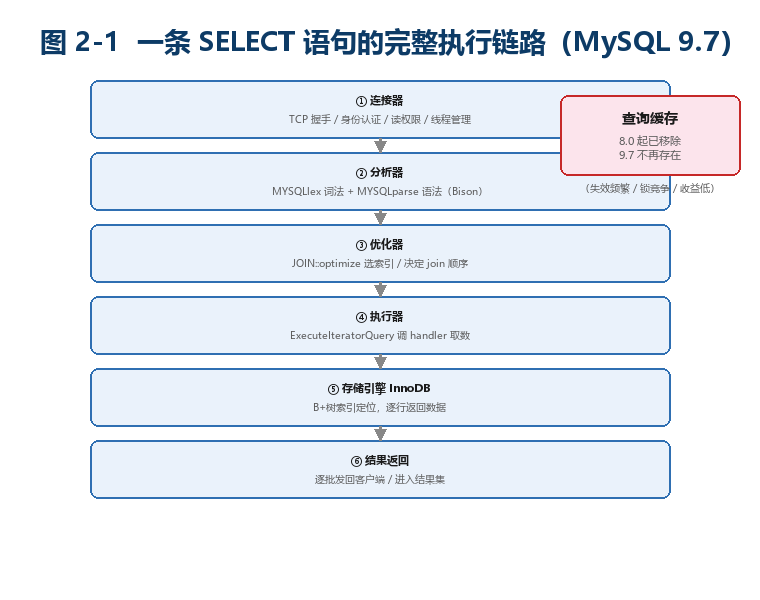
图 2-1 一条 SELECT 语句的完整执行链路(MySQL 9.7)
4. 优化器:决定"怎么做"
分析器只回答"这条 SQL 合法吗",优化器回答"怎么执行代价最低"。当表上有多个索引时(见图 2-3),优化器要决定用哪个索引;多表 join 时要决定驱动表与被驱动表顺序;还要决定是否用覆盖索引、是否做子查询物化。9.7 的优化器以基于代价的模型(cost model,见 sql/opt_costmodel.cc)为核心,结合统计信息与直方图(histogram)估算每个候选计划的 IO 与 CPU 代价,取最小值。正因如此,有时你会看到 MySQL"选错索引"------本质是统计信息过期或直方图缺失导致代价估算偏离真实,解法不是改 SQL 写法,而是 analyze table 更新统计或建立更合适的联合索引。
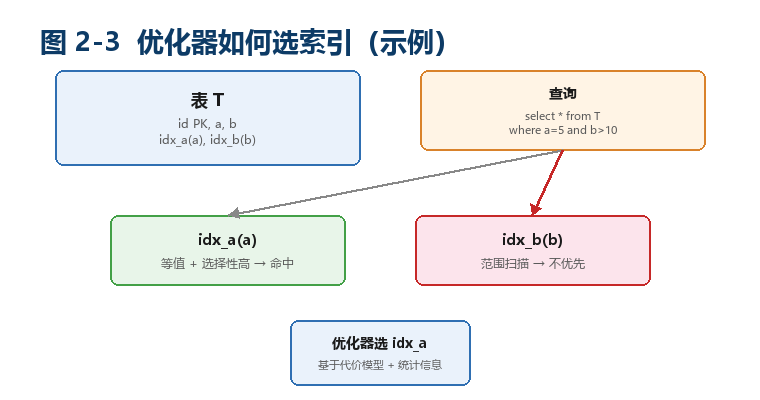
图 2-3 优化器如何选索引(示例)
5. 执行器:真正"干活"的一层
优化器产出执行计划(access path)后,执行器据此调用存储引擎的 handler 接口逐行取数、过滤、计算,再组装成结果集返回客户端。执行前执行器会再做一次权限的细粒度校验(防止越权读列),通过后调用迭代器执行器 Query_expression::ExecuteIteratorQuery 驱动整棵 iterator 树。这里要特别指出 9.7 与 8.0 之前的一个本质变化:早期版本的执行器是"嵌套循环 + 函数调用"(sub_select / do_select / evaluate_join_record),而 9.7 已全面改用迭代器执行器(iterator executor),每个算子是一个实现 Init / Read / End 接口的迭代器对象,执行计划即一棵迭代器树。这一重构让执行路径更清晰、更易被 EXPLAIN / optimizer_trace 观测,也为并行查询、批处理扫描留出统一扩展点。
最后,存储引擎层(以 InnoDB 为例)收到 handler 调用,通过 B+树索引定位到聚簇索引记录,把数据页载入 buffer pool,返回给执行器。整条链路到此闭合。
6. 连接器再深入:连接数、线程模型与典型故障
连接器的稳定性直接决定实例能否接入。全局上限由 max_connections 控制,瞬时新建连接超过它就会报"Too many connections";为避免握手阶段被冲垮,有未accept连接排队参数 back_log。每建立一个连接,MySQL 默认采用"一连接一线程"模型(thread_handling = one-thread-per-connection),连接断开后线程并不立即销毁,而是回收进线程缓存(thread_cache_size),命中缓存可省去线程创建开销------你可用 Threads_created / Connections 比值评估缓存是否够大。这里要把"线程缓存"和"线程池"严格区分开:前者只是复用线程对象,连接的生命周期里依然是一连接一线程;后者才是真正的调度器------Percona 在 Server 层内建了 pool-of-threads 线程池调度器,把大量连接复用为少量 worker 线程组,专治高并发短连接把 CPU 压满的场景,需以 thread_handling = pool-of-threads 启动(只读变量,须重启生效)。连接建立本身有成本:TCP 三次握手、可能的 SSL 协商、密码认证、权限装载,所以应用侧务必用连接池(如 HikariCP)复用连接,而非每条 SQL 新建连接。
长连接的内存隐患在上文提过,这里给一个可直接套用的解法:当连接要执行一个占用大内存的查询前,调用 mysql_reset_connection 复位会话级内存(排序缓冲、临时表、net buffer)并清空用户变量,而不必断开重建 TCP。注意它不会刷新权限(权限仍是连接建立时的快照),也不会回滚未完成事务------这些边界要心里有数。
7. 分析器再深入:从字符到解析树
把 select id from T where id=5 交给分析器,词法阶段 MYSQLlex 先切成 SELECTidFROMTWHEREid=5 这样的 token 流,并丢弃空白与注释;语法阶段 MYSQLparse 按 sql_yacc.yy 的文法把 token 组装成解析树,例如把 where 子句建成一个比较表达式节点(左操作数 id,操作符 =,右操作数常量 5)。若 token 不符合文法(如 select * form T 把 from 拼成 form),在分析阶段末尾就报"You have an error in your SQL syntax";若文法正确但语义非法(如表 T 不存在、列 c 不存在、当前用户无权读该表),则在语义检查阶段报"Unknown table / Unknown column / SELECT command denied"。理解这个区别很重要:语法错误是 SQL 写错了,语义错误是对象或权限问题,二者的排查路径完全不同。解析树随后被优化器消费,优化器并不重新扫描文本,而是直接遍历这棵树生成执行计划。
8. 优化器再深入:代价模型与"选错索引"
9.7 优化器的核心是代价模型(cost model)。它把每个候选执行计划的成本拆成两部分:IO 成本(随机读一页约 1.0、读内存页约 0.25(该值实为 memory_block_read_cost,并非"顺序读"))与 CPU 成本(每评估一行约 0.1),再乘以统计信息估算的行数。统计信息来自表/列统计(records、data_length、null 比例等),对倾斜严重的列还会维护直方图(histogram),让"where status='active'"这种过滤性极强的条件能被准确估算。代价最低的 plan 胜出。于是"选错索引"的本质几乎总是:统计信息过期(长时间未 analyze table,估算行数偏差大)、或缺失直方图导致代价算错、或隐式类型转换让索引失效(见第 18 讲)。典型纠偏手段有三:analyze table 更新统计;对倾斜列建直方图;用 FORCE INDEX 或改写 SQL 临时引导。也可以用 optimizer_switch 微调优化器行为,但要谨慎------它影响的是全局计划选择。
一个常被忽视的细节是范围扫描与 ref 访问的取舍:当 where 条件是等值(如 id=5)走 ref/const 访问,命中聚簇索引只需读极少页;若是范围(如 id>100),优化器要估算范围行数,可能宁可走全表也不走一个选择性差的范围索引。覆盖索引(索引已含查询所需全部列)能避免回表,优化器会优先选它------这正是第 05 讲联合索引与最左前缀的用武之地。
9. 实战:用 EXPLAIN 把图 2-1 落到一条真实 SQL
下面这条建表与查询,恰好贯穿图 2-1 的优化器与执行器两层:
**sql
**CREATE TABLE orders (
id INT PRIMARY KEY,
customer_id INT NOT NULL,
amount DECIMAL(10,2),
KEY idx_cust (customer_id)
) ENGINE=InnoDB;
EXPLAIN SELECT amount FROM orders WHERE customer_id = 100;
/* type=ref, key=idx_cust, rows≈N, Extra=Using index (覆盖索引) */
EXPLAIN 输出里:type=ref 表示用索引等值访问(对应优化器选了 idx_cust);key 显示实际用到的索引(对应图 2-3 的"优化器选 idx");rows 是估算扫描行数;Extra=Using index 表示覆盖索引、执行器无需回表。把这三个字段和图 2-1 的五层一一对应,你就能在慢查询现场快速判断:是没走索引(优化器/统计问题)、还是走了索引仍慢(执行器/引擎 IO 或锁等待)。若想看优化器内部如何算出的代价,打开 optimizer_trace 即可导出完整计算过程。
10. 执行器与存储引擎层的更多细节
执行器调用的是 InnoDB 在 ha_innodb.cc 中实现的 handler 接口。真正的数据存取细节都藏在引擎里:Buffer Pool 命中率(9.7 并未导出名为 Innodb_buffer_pool_read_hit 的状态变量,须用 1 − Innodb_buffer_pool_reads / Innodb_buffer_pool_read_requests 自行计算,越接近 1 越好)是实例健康的核心指标,命中率低意味着大量随机读盘;Adaptive Hash Index 为热点等值访问建立内存哈希加速;Change Buffer 把非唯一二级索引的写操作缓存合并,减少随机 IO------注意它只适用于非唯一索引,因为唯一索引插入必须立即查重、无法延迟合并。这些机制都位于图 2-2 的"存储引擎层",Server 层完全不感知。
11. 各阶段的可观测性速查(SHOW PROCESSLIST)
把连接的状态与图 2-1 五层对应,能快速定位瓶颈:Sleep 表示连接器空闲待命;Query 表示正处在分析器/优化器/执行器任一阶段;executing(旧版本名为 Sending data)表示执行器正在向存储引擎取数,是最常见的高耗时状态;Waiting for table metadata lock(旧版本名为 Locked)表示在等表锁或元数据锁 MDL;Sending to client(旧版本名为 Writing to net)表示结果正在发回客户端。务必注意:9.7 已不再导出 Sending data / Locked / Writing to net 这三个旧状态名,照抄旧资料去匹配 State 列会永远匹配不到。再配合 performance_schema.events_statements_current 查看单语句各阶段耗时拆解,慢查询现场基本无所遁形。
12. 三个常见认知误区
收尾前点破几个高频误区:(1) "查询缓存能加速"------9.7 已彻底移除,别再依赖;(2) "执行器直接读磁盘"------实际先走 Buffer Pool,仅未命中才读盘,所以内存大小直接决定读性能;(3) "优化器永远选最优"------它基于统计信息与代价估算,统计过期就会选错,故 analyze table 是索引类慢查询排障的第一步;(4) "Server 层知道数据存在哪"------Server 只发指令,真正的存取、加锁、刷盘全由存储引擎负责。厘清这四点的,才算真正读懂了 MySQL 的分层架构。
13. Percona Server 9.7 在 Server 层的加固
Percona 在原生 MySQL 之上做了大量 Server 层增强,多数都落在图 2-2 的 Server 层:线程池调度器(pool-of-threads,实现见 sql/threadpool_unix.cc)把高并发短连接复用为少量 worker,避免上下文切换风暴;审计日志(audit_log_filter)组件在连接与查询层留痕以满足合规;更丰富的 INFORMATION_SCHEMA 视图让各层状态更易观测。这些能力不改变"五层链路"的本质,却是生产可用性的关键加成,后续讲复制、诊断时你会反复用到。
14. 本章在全书中的位置
本章是全讲的基石:后续"索引"(第 4-5、9-11 讲)发生在优化器与存储引擎层,"锁与事务"(第 6-8、20-21、30 讲)发生在执行器向引擎请求加锁的环节,"复制与高可用"(第 23-28 讲)正是 binlog 链路的延伸,"性能与诊断"(第 12、16-19、29 讲)则是把各层耗时逐项拆解。先建立这条链路的心智模型,后面每一讲都能准确挂到对应的层上,不至于只见树木不见森林。
有人问"既然优化器可能选错,为何不直接用 hints 写死执行计划?"------FORCE INDEX、optimizer hints 之类是临时纠偏的逃生舱,适合应急,但长期应靠统计信息与健康索引;把计划写死会随数据演化而失效,反而埋雷。这个"动态观点"贯穿全书:没有一成最优的计划,只有与当前数据分布匹配的计划。
顺带一提,连接器的权限缓存、分析器的解析树、优化器的执行计划,在 9.7 中都被 performance_schema 与 optimizer_trace 充分暴露,排障时优先看这些内置观测面,而非凭直觉猜测------这正是本书一以贯之的"用观测代替臆断"原则。当你在慢查询日志里看到 executing 阶段长时间不结束(旧版本称 Sending data),往往不是网络慢,而是执行器在向 InnoDB 逐行取数时遭遇了磁盘读或锁等待;此时应回到图 2-1,判断是优化器选了差的计划(回表多),还是引擎层 Buffer Pool 命中率低,二者解法完全不同。
三、9.7 源码佐证
把上述链路落到一个具体函数,便于你在源码中按图索骥:
mysql_execute_command(THD *thd, bool first_level) ------ sql/sql_parse.cc:3192,所有 SQL 命令的顶层分发入口,按命令类型进入对应的执行分支。
MYSQLlex / MYSQLparse ------ 分析器入口,分别来自 flex 扫描器(sql_lex.cc)与 Bison 文法(sql_yacc.yy / 生成的 sql_yacc.cc)。
JOIN::optimize(bool finalize_access_paths) ------ sql/sql_optimizer.cc:344,优化器主入口,完成索引选择、join 重排、代价估算。
Query_expression::ExecuteIteratorQuery(THD *thd) ------ sql/sql_union.cc:1037,9.7 迭代器执行器入口(取代旧版 sub_select/do_select)。
handler 抽象基类(sql/handler.cc 及 storage/innobase/handler/ha_innodb.cc)------Server 与存储引擎解耦的统一接口。
[cpp]
/* sql/sql_parse.cc:3192 ------ 命令分发入口 */
int mysql_execute_command(THD *thd, bool first_level) {
LEX *lex = thd->lex;
switch (lex->sql_command) {
case SQLCOM_SELECT: ... /* 进入查询执行 */
case SQLCOM_UPDATE: ... /* 进入更新执行(见第 03 讲)*/
}
}

/* sql/sql_union.cc:1037 ------ 9.7 迭代器执行器 */
bool Query_expression::ExecuteIteratorQuery(THD *thd) {
/* 驱动 iterator 树:Init -> Read 循环 -> End */
}
四、实战验证与要点总结
想亲眼看到各阶段,有几个现成抓手:SHOW PROCESSLIST / SHOW PROCESSLIST 的 Command 列能看到连接所处状态(Sleep、Query、executing 等;Sending data 为旧版名称);EXPLAIN 与 EXPLAIN ANALYZE 直接展示优化器选出的执行计划与真实耗时;performance_schema.events_statements_history_long 记录语句级耗时拆解,配合 events_stages_history_long 还能看到各阶段耗时;optimizer_trace 可导出优化器内部的代价计算过程。日常排障时,先判断慢在哪个阶段:是连接建立慢(连接器/网络)、是解析报错(分析器)、是选错索引(优化器/统计信息)、还是取数慢(执行器/引擎/IO),定位才不会跑偏。
**【本章要点】
**• MySQL 分 Server 层与存储引擎层,中间靠 handler 接口解耦;
• 连接器负责认证与连接资源,长连接需注意内存与权限时点问题;
• 9.7 已无查询缓存,性能靠 buffer pool 与业务层缓存;
• 分析器做词法/语法/语义检查,优化器做代价估算选计划;
• 9.7 执行器是迭代器执行器 ExecuteIteratorQuery,非旧版 sub_select。
【思考题】为什么权限检查既出现在分析器、又出现在执行器?查询缓存在 9.7 为何被整体砍掉,而非做成'可按表开关'?
【Percona 9.7 扩展】存储引擎选项 MyRocks
Percona 发行版在 InnoDB 之外还提供基于 LSM-Tree 的 MyRocks 引擎(源码 storage/rocksdb)。但"提供"不等于"开箱可用"------它是默认构建、默认打包、却必须显式启用的动态插件:形态上是 ha_rocksdb.so(storage/rocksdb/CMakeLists.txt:1 设 ROCKSDB_DYNAMIC_PLUGIN 1),RPM 中打包为独立子包 percona-server-rocksdb(build-ps/percona-server.spec:462,产出 spec:1611 的 ha_rocksdb.so),装完还必须执行 ps-admin --enable-rocksdb(spec:933)或 INSTALL PLUGIN ROCKSDB SONAME 'ha_rocksdb.so' 才能真正用上;否则直接 CREATE TABLE ... ENGINE=ROCKSDB 会撞 Unknown storage engine 'ROCKSDB'。源码构建时可用 -DWITH_ROCKSDB=0 或 -DWITHOUT_ROCKSDB=1 关闭:
• 写放大低、压缩率高,适合写密集、大容量 KV 类负载,与 InnoDB 的 B+Tree 形成互补;
• 选型看负载特征:点查/强事务一致→InnoDB;写吞吐与压缩敏感→MyRocks;
【Percona 9.7 扩展】线程池调度器(pool-of-threads)
Percona 在 Server 层内建了线程池调度器(pool-of-threads),这正是社区版 MySQL 所没有的:sql/CMakeLists.txt:118 无条件定义了 -DHAVE_POOL_OF_THREADS,实现见 sql/threadpool_unix.cc。注意它与 thread_cache_size 的"线程缓存"是两回事------后者只是复用线程对象,连接生命周期里仍是一连接一线程;线程池才是把大量连接复用为少量 worker 线程组的真正调度器。启用方式为 thread_handling = pool-of-threads(只读变量,须重启生效),核心旋钮包括 thread_pool_size(线程组数,默认取 CPU 核数)、thread_pool_oversubscribe(每组允许的额外活跃 worker,默认 3)、thread_pool_stall_limit(判定 stalled 的毫秒阈值,默认 500)、thread_pool_max_threads(默认等于 max_connections)。它专治高并发短连接把 CPU 压在上下文切换上的场景;若业务本身是少量长连接,收益有限,反而多一层调度。