做 IP 白名单、按地区统计访问量、把访问日志落库,迟早要把 IP 字符串转成整数。网上的写法基本就一行 reduce,看着没问题,一上线就开始出怪事:算出来是负数、范围查询漏数据、同一个地址在统计里出现两次。
这篇把我实测过的七个坑记下来。环境:Node 25.8、Go 1.25、Python 3。文中代码都是为这篇文章现写的示意代码。
坑一:192.168.1.1 算出来是负数
最常见的写法:
js
const ipToInt = ip => ip.split('.').reduce((acc, o) => (acc << 8) + Number(o), 0)

ipToInt('192.168.1.1')     // -1062731519
ipToInt('255.255.255.255') // -1
原因是 JS 的位运算会先把数字转成 32 位有符号整数。192 左移 24 位之后最高位是 1,结果就成了负数。所有第一段 ≥ 128 的地址(B 类、C 类、整个 192.168 内网)全中招。
两种改法,结果一样:
js
// 1) 最后用无符号右移 0 位,把结果按无符号解释
const a = ip.split('.').reduce((acc, o) => (acc << 8) + Number(o), 0) >>> 0

// 2) 干脆不用位运算,乘 256
const b = ip.split('.').reduce((acc, o) => acc * 256 + Number(o), 0)
// 两个都是 3232235777
我更倾向第二种,读代码的人不用去想 >>> 0 是干嘛的。
坑二:反过来转的时候,>> 和 >>> 差一个符号
整数转回点分十进制,有人这么写:
js
const n = 3232235777
const first = n >> 24   // -64
>> 是有符号右移,会把符号位往右填,于是第一段成了 -64。要么用 >>>,要么每段都 & 255:
js
const intToIp = n => [n >>> 24, (n >>> 16) & 255, (n >>> 8) & 255, n & 255].join('.')
intToIp(3232235777) // '192.168.1.1'
我在 Node 里同时试了三种:n >> 24 是 -64,(n >> 24) & 255 是 192,n >>> 24 是 192。只有第一种是错的,但它恰好是最顺手的写法。
坑三:数据库字段用 INT,一半的地址存不进去
IPv4 转成整数的范围是 0 到 4294967295(2³² − 1),而 MySQL 的 INT 是有符号的,上限 2147483647。凡是第一段 ≥ 128 的地址都超了。
两个常见后果:
- 严格模式下直接插入报错;
- 有人为了"能存进去",在应用层先转成有符号数再存(就是坑一那个负数),于是库里一半是正数、一半是负数,
BETWEEN做网段查询时,跨过 128.0.0.0 的范围会整段查不到。
字段用 INT UNSIGNED 或 BIGINT,存的时候保证是非负数,这事就结束了。Go 里也一样,binary.BigEndian.Uint32 拿到的是 uint32,别图省事转成 int32:
go
ip := net.ParseIP("192.168.1.1").To4()
n := binary.BigEndian.Uint32(ip) // 3232235777
fmt.Println(int32(n))            // -1062731519
坑四:Go 里忘了 To4(),结果是 0
这个坑很隐蔽,因为不报错:
go
ip := net.ParseIP("192.168.1.1")
len(ip)                             // 16
binary.BigEndian.Uint32(ip[:4])     // 0
binary.BigEndian.Uint32(ip.To4())   // 3232235777
net.ParseIP 返回的是 16 字节的切片,IPv4 被存成 IPv4-mapped IPv6 的形式(前面 10 个 0 字节、2 个 0xff,最后 4 字节才是地址)。直接取前 4 字节,拿到的永远是 0。所有地址都转成 0,测试时如果只看"有没有报错",是发现不了的。
新代码可以直接用 net/netip,netip.ParseAddr(s) 拿到 Addr 后 As4() 返回 [4]byte,类型上就不会搞混。
坑五:127.1、0177.0.0.1 也是"合法地址"
这是我觉得最值得记住的一条。把下面几个字符串交给浏览器的 URL 解析器:
js
for (const h of ['127.1', '0177.0.0.1', '0x7f.1', '2130706433', '192.168.257'])
  console.log(h, '→', new URL(`http://${h}/`).hostname)
实测输出:
| 输入 | 解析结果 |
|---|---|
127.1 |
127.0.0.1 |
0177.0.0.1 |
127.0.0.1(0 开头按八进制) |
0x7f.1 |
127.0.0.1(十六进制) |
2130706433 |
127.0.0.1(整数) |
192.168.257 |
192.168.1.1(最后一段可以超过 255,吃掉剩下的字节) |
这套宽松规则来自老的 inet_aton。Python 的 socket.inet_aton('127.1') 和 socket.inet_aton('0177.0.0.1') 也都返回 7f000001。
问题在于:同一个地址可以有好几种写法,而你代码里不同环节用的可能不是同一套规则。 最直观的后果是统计口径乱掉:日志里 127.1 和 127.0.0.1 被当成两个来源,按字符串去重、按字符串匹配黑白名单,都会漏。所以凡是要拿 IP 做比较、去重、匹配的地方,都应该先解析成标准形式再比较,而不是直接对原始字符串做。
反过来,严格的解析器会直接拒绝这些写法:
Go net.ParseIP("0177.0.0.1")      → nil
Go netip.ParseAddr("0177.0.0.1")  → IPv4 field has octet with leading zero
Go netip.ParseAddr("127.1")       → IPv4 address too short
Python ipaddress.ip_address("127.1") → does not appear to be an IPv4 or IPv6 address
所以同一个字符串,在 Go 里是非法的,在浏览器和 inet_aton 里是本机。两边混用时要特别小心。
坑六:parseInt 太宽容,校验形同虚设
自己手写解析时,很多人用 parseInt 做每一段的转换,再判断 0--255:
js
parseInt('1abc') // 1
parseInt(' 12 ') // 12
parseInt('0x1F') // 31
parseInt('')     // NaN
Number('')       // 0
parseInt 遇到非数字字符就停,前面能读出数字就算成功,所以 192.168.1.1abc 每段都能"合法"通过。换成 Number 又有另一个问题:空字符串是 0,192.168..1 会被当成 192.168.0.1。
稳妥的做法是先用正则把格式卡死,再转数字:
js
const SEG = '(25[0-5]|2[0-4]\\d|1\\d\\d|[1-9]?\\d)'
const IPV4 = new RegExp(`^${SEG}(\\.${SEG}){3}$`)

IPV4.test('192.168.1.1')     // true
IPV4.test('192.168.1.1abc')  // false
IPV4.test('0177.0.0.1')      // false,不允许前导 0
IPV4.test('192.168..1')      // false
前导 0 要不要允许,取决于你的下游怎么解析。下游是 inet_aton 一类的宽松实现时,0 开头会被当成八进制,最省心的就是直接拒绝。
坑七:按字符串排序,10.0.0.10 排在 10.0.0.2 前面
日志里按 IP 排序,或者前端表格点"按 IP 排序":
js
['10.0.0.2', '10.0.0.10', '9.1.1.1'].sort()
// ['10.0.0.10', '10.0.0.2', '9.1.1.1']字符串比较是逐字符的,'1' < '2',所以 .10 跑到了 .2 前面,9.x 还排在 10.x 后面。按转换后的整数排就对了:
js
ips.sort((a, b) => ipToInt(a) - ipToInt(b))数据库里同理:存整数、按整数排序和范围查询,比存字符串再做各种 LIKE 和截取要省事得多。
顺手的工具
排查日志时我经常要手动核对一个整数到底是哪个 IP。福兮的 IPv4 地址转换工具(forxi.cn/hub/it-tools/ipv4)就是做这一件事的:点分地址和整数两个方向互转,输出是无符号的,192.168.1.1 给的是 3232235777,不会出现负数。
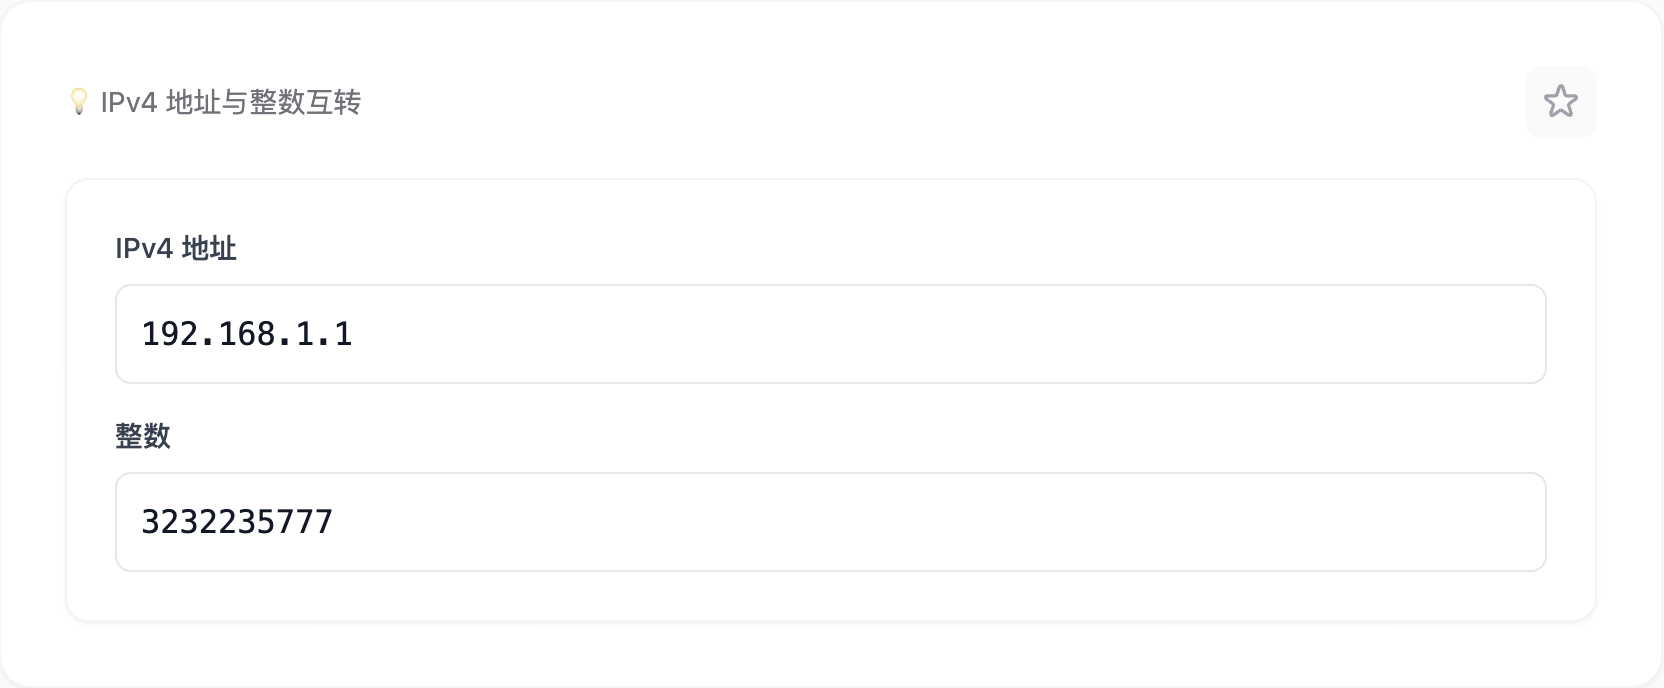
说下它的局限:只做 IPv4 和整数之间的互转,不支持 IPv6,也不做网段(CIDR)计算和子网划分;输入请用标准的四段点分写法,127.1 这类缩写不在它的处理范围里。批量转换或者要做网段判断,还是在代码里用上面的方法自己写。
小结
七个坑,归成三类:
- 位运算的符号问题(坑一、二、三):JS 位运算是 32 位有符号的,数据库 INT 也是有符号的,IPv4 正好用满 32 位无符号,最高位一碰就出事。
- 解析规则不统一 (坑四、五、六):
inet_aton很宽松,Go 和 Python 的新库很严格,浏览器跟着宽松那一派。校验和使用必须用同一套规则,最好都先归一化成标准形式。 - 表示方式(坑七):存储、排序、范围查询都用整数,展示时再转回字符串。
IPv6 是 128 位,JS 的 Number 装不下,得用 BigInt,规则也复杂得多(:: 压缩、IPv4 映射地址、zone id),那是另一篇的内容了。