IN 操作规范:PostgreSQL 元素数量、EXISTS 替代与 = ANY 写法
标签:#PostgreSQL #SQL #性能优化 #查询规范
一、前言
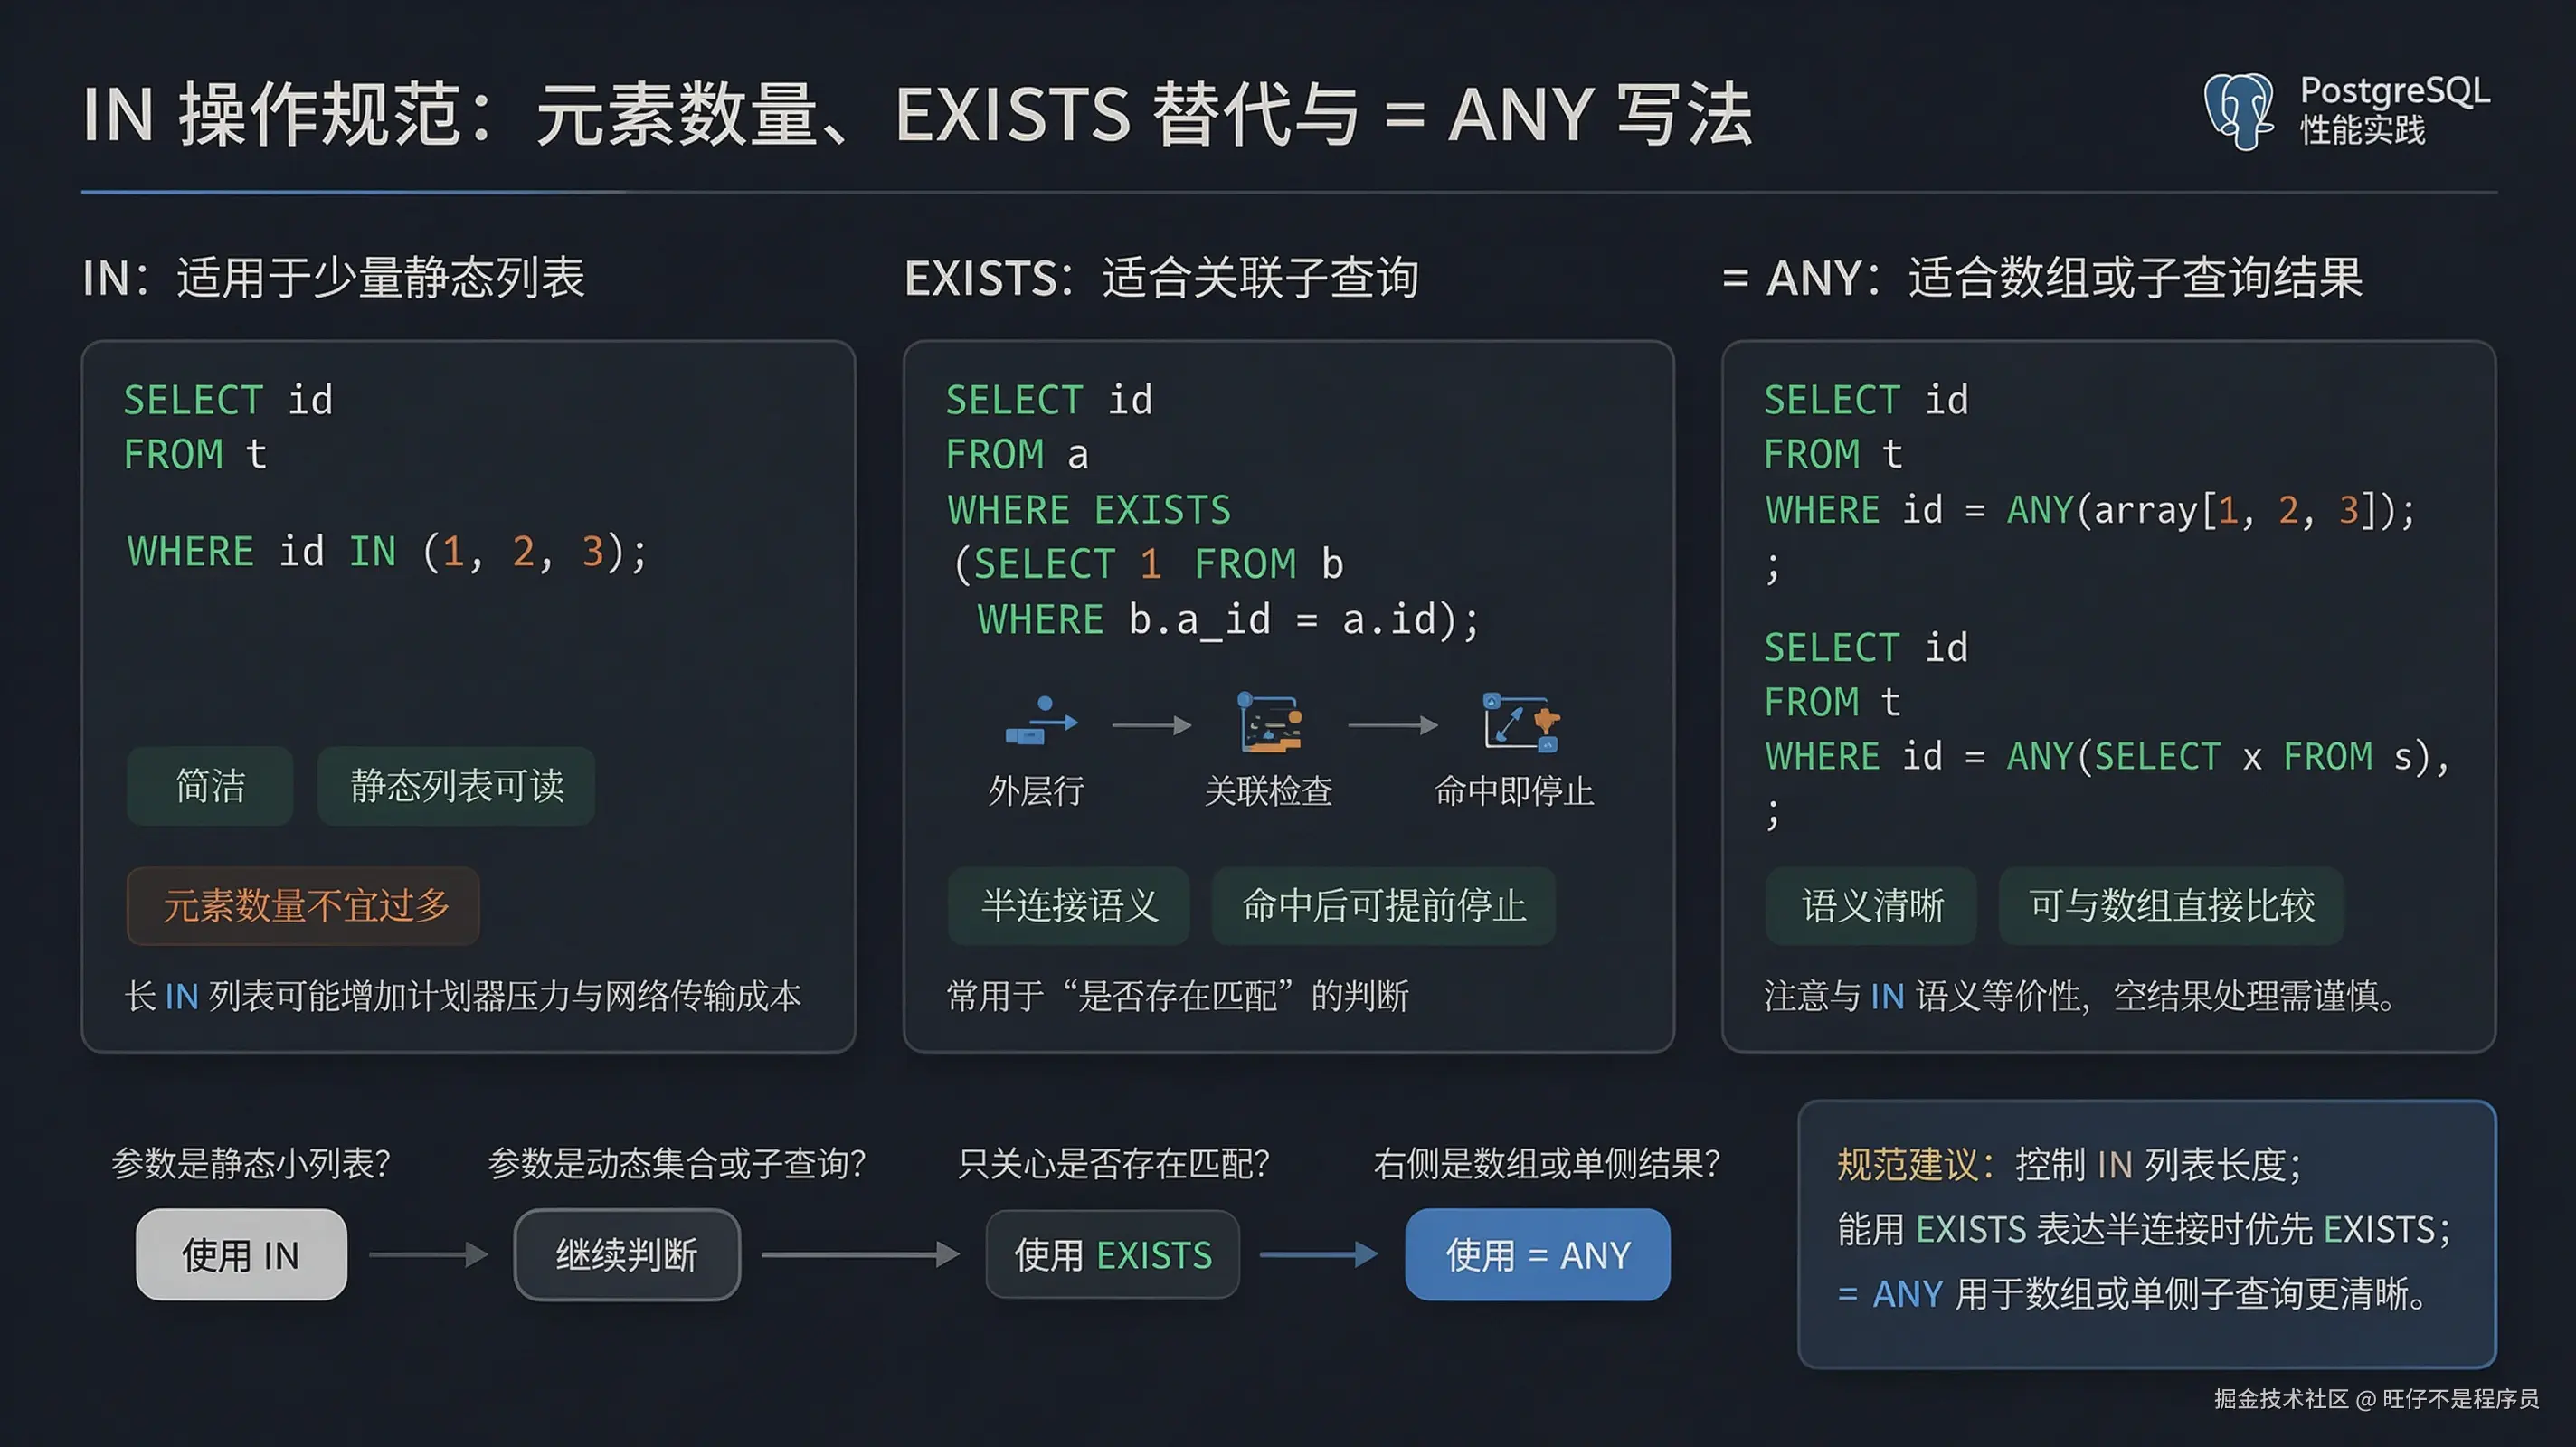
三条 IN 使用规范(团队红线):
-
IN 操作能避免则避免 ;若使用需评估,IN 后边的集合元素数量控制在 50 个之内(实践建议值,非官方硬限制);
-
可以用 EXISTS 代替 IN ------EXISTS 在某些场景比 IN 效率高:
sqlSELECT num FROM a WHERE num IN (SELECT num FROM b); -- 用下面的语句替换: SELECT num FROM a WHERE EXISTS (SELECT 1 FROM b WHERE num = a.num); -
使用
= ANY(array[1,2,3,4])代替IN (1,2,3,4),效果更佳 ;并且尽量不使用 NOT IN。
二、核心开发规范
- IN 能避免则避免 :能拆成 JOIN(第 23 篇:关联列建索引)、能预聚合的先重写;若必须使用,集合元素数量控制在 50 个之内,超过就拆批或改用数组参数;
- 子查询形式用 EXISTS 替代 :
IN (subquery)→EXISTS (SELECT 1 FROM b WHERE num = a.num)------官方 9.24:EXISTS 的子查询只执行到足以确定是否返回至少一行(找到即停),大结果集场景效率更高; - 列表形式用
= ANY(array[...]):与IN (1,2,3,4)语义等价,但数组参数化更友好(Prepared Statement 只需一个参数)、SQL 长度可控; - 尽量不使用 NOT IN :NOT IN 等价
<> ALL(官方 9.25),任一侧含 NULL 时结果为 NULL 而非 true(第 24 篇详述),用 NOT EXISTS 替代。
三、底层原理通俗讲解
- IN 列表 = 等值 OR 的简写 (官方 9.25):
expression IN (value1, value2, ...)是expression = value1 OR expression = value2 ...的简写------元素越多,OR 链越长,解析、规划与执行成本线性上升,50 个以上可读性与计划质量急剧下降; - IN 子查询语义(官方 9.24):"左手边表达式被求值并与子查询结果的每一行比较,找到任何相等的行则 IN 为 true"------子查询结果要逐行比较;
- EXISTS 提前终止 (官方 9.24 原话):"子查询通常只执行到足以确定是否返回至少一行 ,不会执行到完成"------只关心"有没有"时,命中即停,不用物化全量子查询结果;
- 为什么 EXISTS 某些场景更快:子查询结果集很大、外部表相对小、只关心存在性时------EXISTS 一行命中即返回,IN 要拿子查询全量结果逐行比(PG 通常转换为 semi-join,但 EXISTS 显式可控);
= ANY(array)的等价与优势 :数组比较语法(官方 9.25),语义与 IN 列表等价------但数组是一个值:Prepared Statement 参数化只需一个数组参数(IN 每个元素一个参数)、应用层拼接短、长度可控;- NOT IN 的问题 (官方 9.25):
x NOT IN (y)是x <> ALL (y)的简写;左手边产生 NULL、或没有相等右手边值且至少一个右手边值为 NULL 时,结果为 NULL 而非 true------WHERE 中 NULL 被过滤,结果集悄悄变空(第 24 篇已详述)。
四、实战错误案例&优化方案
场景1:IN 列表元素超 50 个(核心红线)
表设计:orders 表,应用层拿到 200 个 user_id 要一次查
❌ 错误写法(IN 列表硬拼 200 个元素)
sql
SELECT * FROM orders
WHERE user_id IN (10001, 10002, 10003, ... , 10200);
-- 200 个等值 OR 展开(官方 9.25:IN 是 OR 简写)
-- 解析/规划开销大、SQL 超长、可读性差、超过 50 元素红线
✅ 正确写法(数组参数 / 拆批,≤50 个一批)
sql
-- 方式一:= ANY(数组参数)------一个参数搞定 200 个值
SELECT * FROM orders
WHERE user_id = ANY(ARRAY[10001, 10002, ..., 10200]);

-- 方式二:应用层拆批,每批 ≤ 50 个,分批查询后合并
-- 批1:user_id IN (10001, ..., 10050)
-- 批2:user_id IN (10051, ..., 10100)
关键结论 :IN 集合元素数量控制在 50 个之内 (评估后使用)------超了用 = ANY(数组) 收成一个参数,或应用层拆批;别让 SQL 变成 200 个 OR 的怪物。
场景2:IN 子查询 → EXISTS 替代(用户标准姿势)
表设计:a(num)、b(num)两表,a 有 1000 万行、b 有 800 万行,查"a 中 num 出现在 b 里的行"
❌ 错误写法(IN 子查询,全量比较)
sql
SELECT num FROM a WHERE num IN (SELECT num FROM b);
-- 官方 9.24:IN 与子查询每一行比较
-- 子查询结果大时,物化/比较开销高
✅ 正确写法(EXISTS 替代,找到即停)
sql
SELECT num FROM a WHERE EXISTS (SELECT 1 FROM b WHERE num = a.num);
-- 官方 9.24:EXISTS 子查询只执行到确定返回至少一行
-- 每行命中即停,不物化 b 全量结果
-- b.num 建索引效果更佳(第 23 篇:关联列建索引)
关键结论 :子查询形式用 EXISTS 代替 IN(用户示例原样收编)------大结果集 + 存在性判断场景,EXISTS 提前终止(官方 9.24)效率更高;配合 b.num 索引(第 23 篇)更稳。
场景3:IN 列表 → = ANY(数组)(效果更佳)
表设计:orders 表,查固定几个状态
❌ 错误写法(IN 列表)
sql
SELECT * FROM orders WHERE status IN ('PAID', 'SHIPPED', 'DONE');
-- 每个元素一个参数(Prepared Statement 要 3 个参数)
-- 列表越长,拼接与参数管理越重
✅ 正确写法(= ANY 数组,效果更佳)
sql
SELECT * FROM orders WHERE status = ANY(ARRAY['PAID', 'SHIPPED', 'DONE']);
-- 语义与 IN 等价(官方 9.25:数组比较)
-- Prepared Statement 只需一个数组参数
-- 数组可在应用层动态组装,长度可控
关键结论 :使用 = ANY(array[1,2,3,4]) 代替 IN (1,2,3,4),效果更佳------一个数组参数取代 N 个元素,参数化友好、SQL 可控、语义等价(官方 9.25)。
场景4:NOT IN 尽量不用 → NOT EXISTS
表设计:orders 表、bad_status 表(含 NULL 的排除列表场景)
❌ 错误写法(NOT IN,NULL 陷阱)
sql
SELECT * FROM orders WHERE status NOT IN ('CLOSED', 'CANCELLED', NULL);
-- 官方 9.25:列表含 NULL → NOT IN 结果为 NULL → 不返回任何行
-- 结果集悄悄变空(第 24 篇:NOT IN 防 NULL 骗)
✅ 正确写法(NOT EXISTS 替代)
sql
SELECT * FROM orders o
WHERE NOT EXISTS (SELECT 1 FROM bad_status b WHERE b.status = o.status);
-- NOT EXISTS 逐行布尔判定,NULL 安全
-- 子查询利用 b.status 索引
关键结论 :尽量不使用 NOT IN ------NOT IN 等价 <> ALL(官方 9.25),NULL 陷阱会悄悄清空结果;一律用 NOT EXISTS 替代(第 24 篇规则延续)。
五、绝对禁止的写法汇总
- IN 集合元素超过 50 个不做评估、不拆批(OR 链爆炸);
- 子查询场景能 EXISTS 却坚持 IN (subquery)(大结果集全量比较);
- 列表场景不用
= ANY(数组)(Prepared Statement 参数爆炸、SQL 拼接失控); - 使用 NOT IN(NULL 陷阱 → 结果集悄悄变空,官方 9.25);
- 改写后不 EXPLAIN 验证(确认 semi-join / 提前终止生效)。
六、最终评审口诀(记住不踩坑)
IN少用,五十内;子查询EXISTS替;
列表ANY数组换;NOT IN防NULL。
七、总结
- 数量红线 :IN 操作能避免则避免 ;若使用需评估,集合元素数量控制在 50 个之内 (实践建议值)------超了用
= ANY(数组)或拆批; - 子查询替代 :
num IN (SELECT num FROM b)→EXISTS (SELECT 1 FROM b WHERE num = a.num)------官方 9.24:EXISTS 子查询只执行到确定返回至少一行,某些场景效率更高; - 列表替代 :
IN (1,2,3,4)→= ANY(array[1,2,3,4]),效果更佳------语义等价(官方 9.25),一个数组参数取代 N 个元素; - NOT IN 禁用 :尽量不使用 NOT IN------等价
<> ALL(官方 9.25),NULL 陷阱悄悄清空结果,用 NOT EXISTS 替代(第 24 篇延续)。
标签:PostgreSQL 数据库 性能优化
参考来源
- PostgreSQL 官方文档 9.24 Subquery Expressions(IN 子查询逐行比较、EXISTS 子查询只执行到确定返回至少一行)------ www.postgresql.org/docs/curren...
- PostgreSQL 官方文档 9.25 Row and Array Comparisons(IN 列表是等值 OR 简写、ANY/SOME 数组比较、NOT IN 等价 <> ALL 及 NULL 语义)------ www.postgresql.org/docs/curren...