在 Agentic AI 时代,决定系统体验的并不只有大模型。数据如何进入系统、知识如何被检索、图片和语音如何被理解,以及结果能否快速返回,都会影响最终的回答质量和响应速度。
9 月 12 日,在 Lance 开发者沙龙(Lance Meetup)上海站现场,英特尔高级 AI 架构师 桂晟 以 LanceDB 和 多模态数据湖 为例,分享了 英特尔 Xeon 6 处理器及 AMX 的能力 ,并结合 LanceDB 向量检索 、Embedding 、CLIP 、语音识别 和 视频处理 等场景,展示 CPU 如何承担更多贴近数据侧的 AI 计算任务。
以下内容摘自演讲实录。
AI 系统的瓶颈,不只在大模型推理
一个完整的 AI 应用,通常要经历数据预处理、向量生成、索引构建、检索召回、模型推理和结果后处理等多个环节。GPU 擅长承载大型模型训练和推理,但向量检索、Rerank、数据清洗以及音视频处理等高频任务,往往发生在数据附近,更适合由 CPU 就近完成。
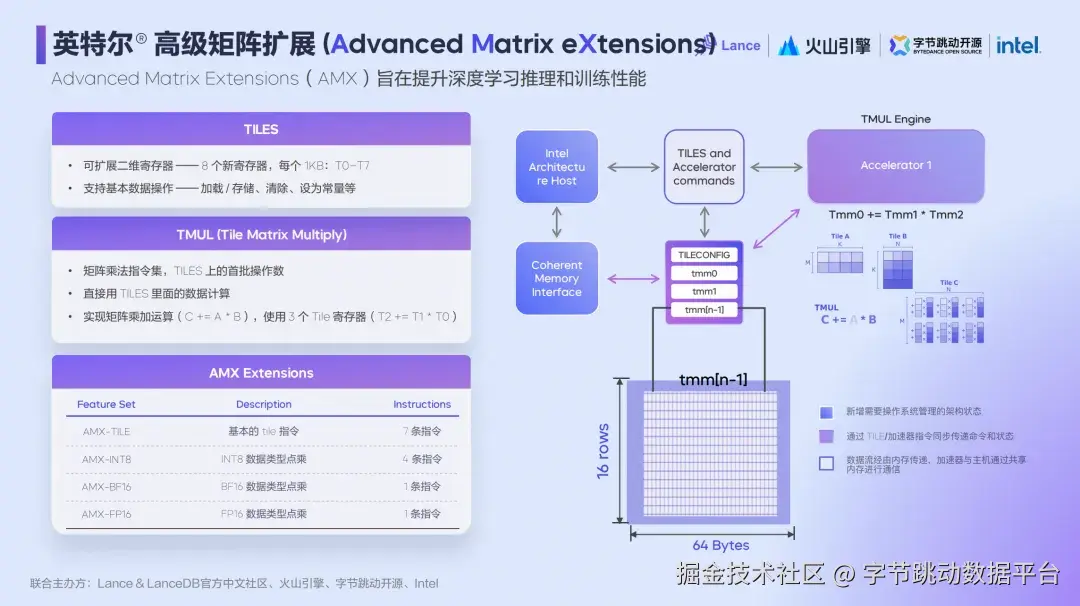
英特尔推出的 AMX(Advanced Matrix Extensions),即高级矩阵扩展,原生适合这种场景。内置于支持 AMX 的 Xeon 处理器核心,由 Tile 寄存器和矩阵乘加单元组成。每个 Tile 可以保存二维数据,一条指令可完成类似"C = C + A × B"的矩阵运算。
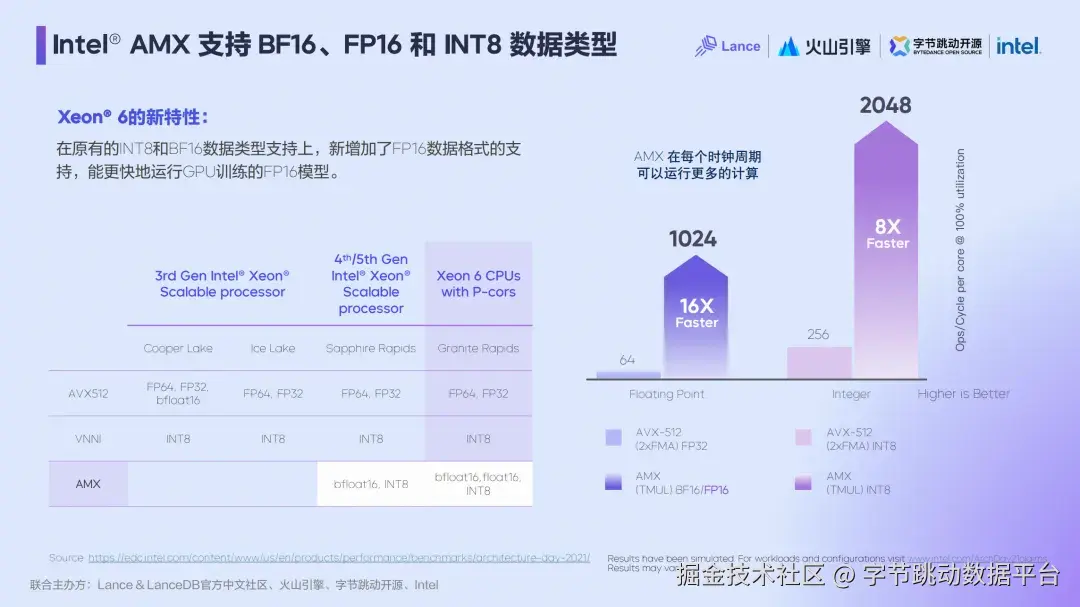
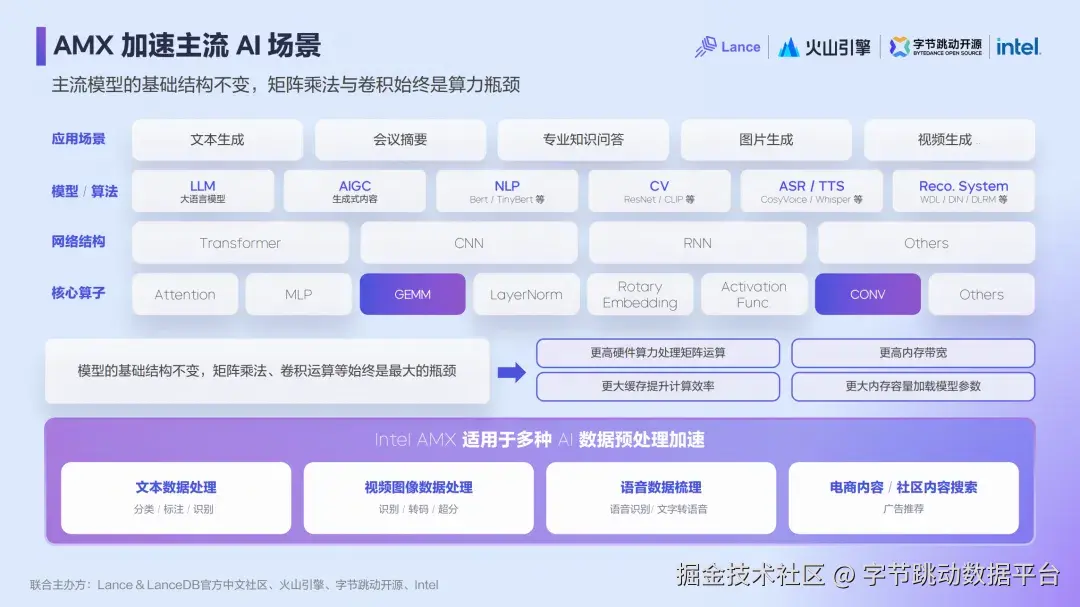
相比每次处理较少数据的向量指令,AMX 更擅长批量计算。如图所示,AMX 每个时钟周期可完成 1024 次 浮点运算 或 2048 次整型运算 ,分别是 AVX-512 对应能力的 16 倍 和 8 倍 。AMX 支持 BF16 、FP16 和 INT8,其中 Xeon 6 新增 FP16 支持,GPU 训练得到的 FP16 模型可以更直接地迁移到 CPU 推理。
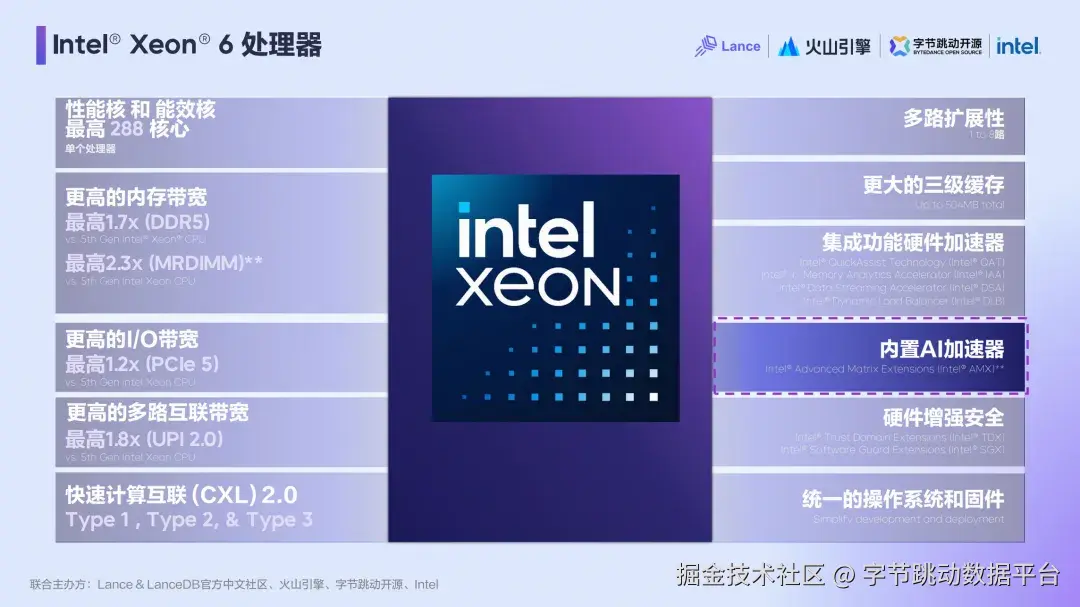
但峰值算力不等于应用性能。软件必须先把零散的小计算整理成适合批量执行的矩阵形状,AMX 才能真正发挥作用。同时,更高的内存带宽、更大的缓存和集成硬件加速器,也让 CPU 更适合承担数据密集型 AI 工作负载。
LanceDB 的关键突破:让精确分区真正可用
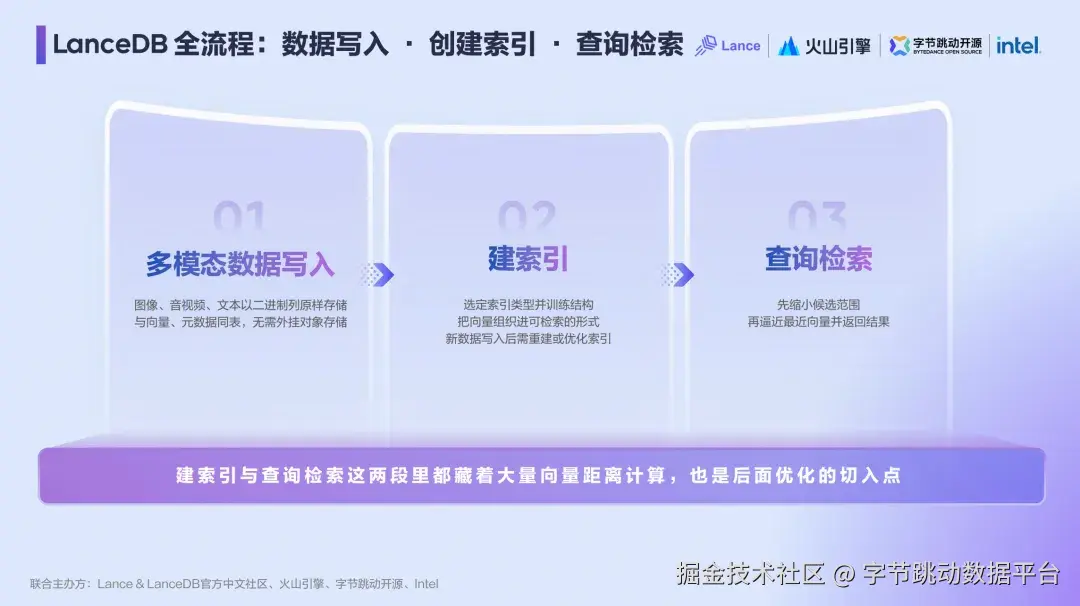
LanceDB 的典型链路包括 多模态数据写入 、建索引 和 查询检索 。图像 、音视频 、文本 及其 向量 和 元数据 可以存放在同一张表里;真正消耗算力的部分,主要集中在建索引和查询阶段的大量向量距离计算。
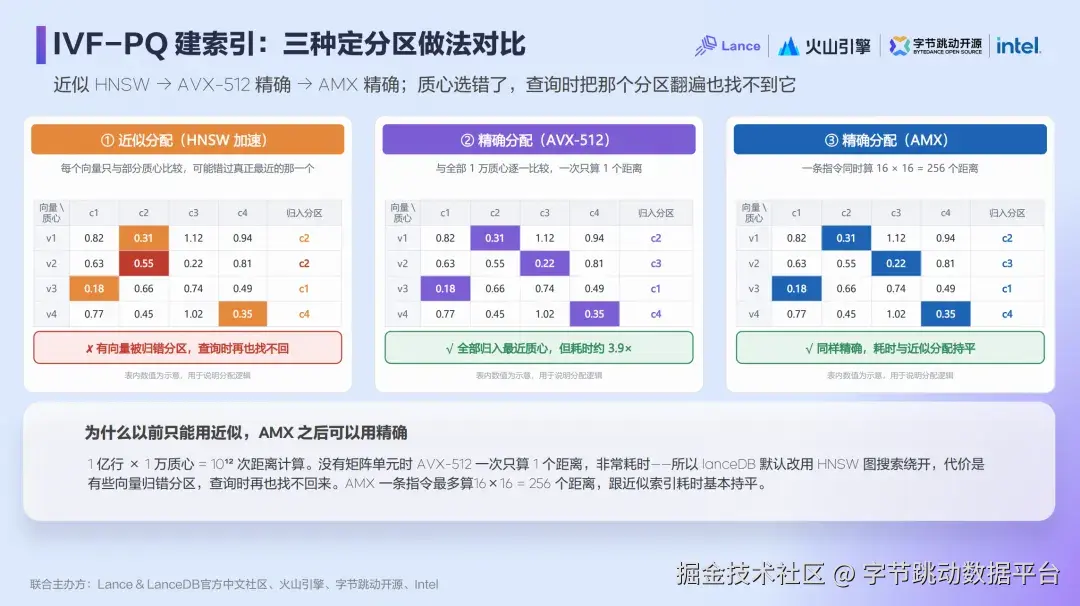
以 IVF-PQ 索引为例,系统需要先训练出质心,再把每条向量分配到距离最近的质心。假设有 1 亿条向量和 1 万个质心,完整比较意味着约 10 的 12 次方次距离计算。
传统精确算法要逐一比较所有质心,计算成本很高。为了缩短建索引时间,LanceDB 默认借助 HNSW 做近似分配,只比较部分质心。速度上去了,但向量可能被放入错误分区。查询时即便把目标分区翻遍,也找不到那条被错放的向量;若想补回召回率,只能扫描更多分区,延迟随之增加。
AMX 不用为了性能去做精度上的取舍。目前 AMX 一次最多可批量计算 16 × 16,也就是 256 个距离,使精确定分区的计算成本降到与近似方案接近的水平。
实测结果:精度与速度不再二选一
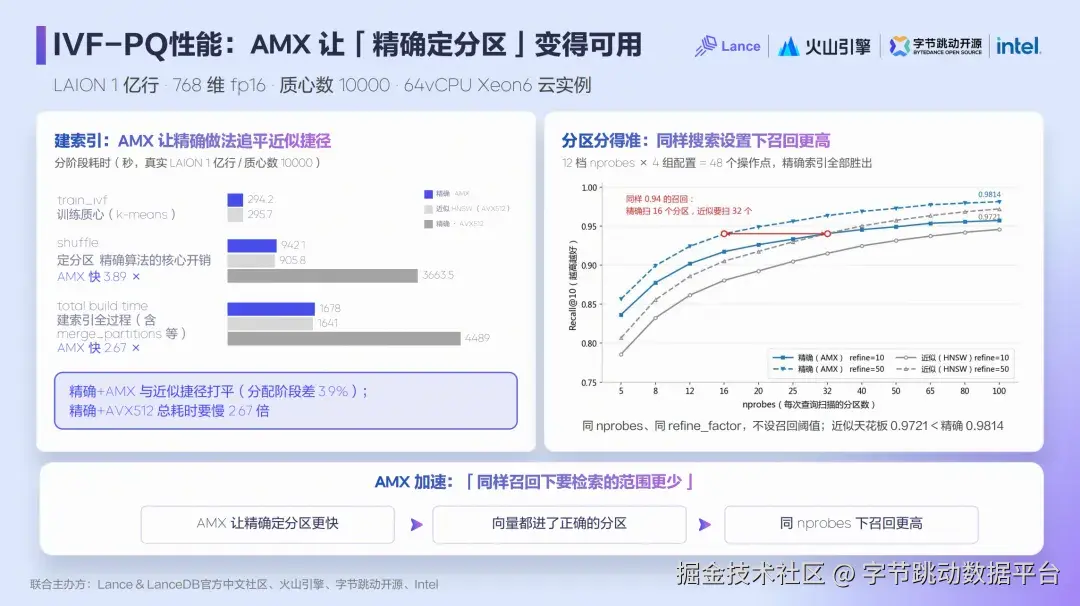
在 LAION 1 亿行、768 维 FP16 向量、质心数 1 万,并在 64 vCPU Xeon 6 云实例上完成的测试中。AMX 精确定分区的耗时与近似方案基本持平,却保留了更高的召回上限。
1.精确·AMX 方案 :定分区耗时为 942.1秒 ,建索引总耗时为 1678秒 ,召回率上限达到 0.9814 ;
2.近似·HNSW 方案 :定分区耗时为 905.8秒 ,建索引总耗时为 1641秒 ,召回率上限为 0.9721 ;
3.精确·AVX-512 方案 :定分区耗时为 3663.5秒 ,建索引总耗时为 4489秒。
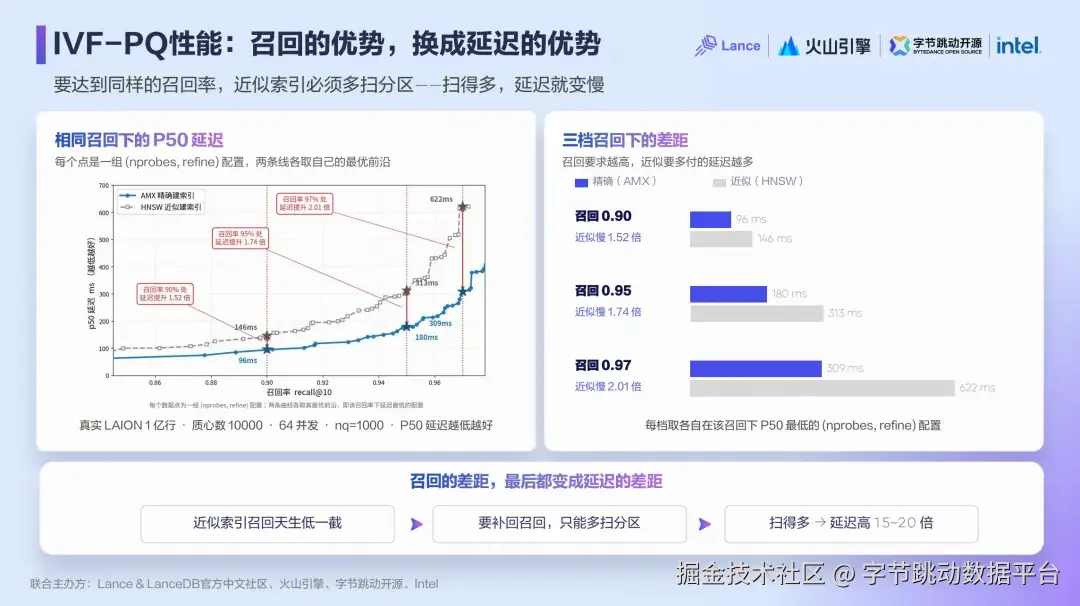
更高的分区准确度还会反向改善查询效率。达到相同召回率时,近似索引需要扫描更多分区;在该测试中,AMX 精确方案的 P50 查询延迟快 1.5~2.0倍。召回要求越高,这个差距越明显。
这项优化的价值不只是"建索引更快",而是让索引从源头更准确,从而减少后续查询的无效计算。
HNSW 查询优化:从逐个计算转向批量计算
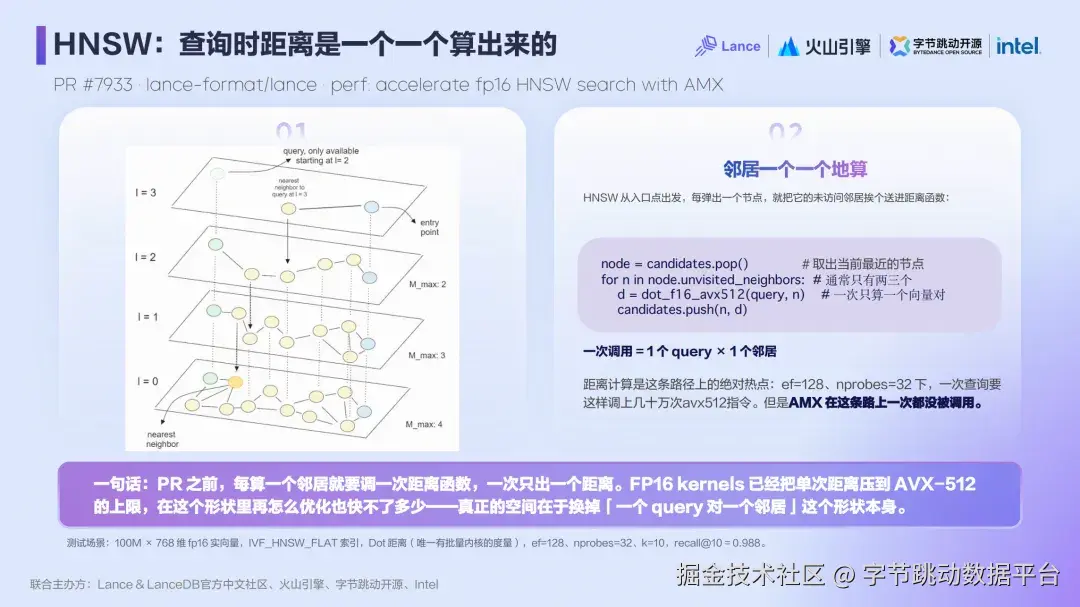
HNSW 查询面临另一类问题。图搜索会不断弹出节点,再逐个计算查询向量与邻居向量的距离。原有 FP16 内核已经接近 AVX-512 的单次计算上限,但一次调用仍只计算一个向量对,AMX 没有机会介入。
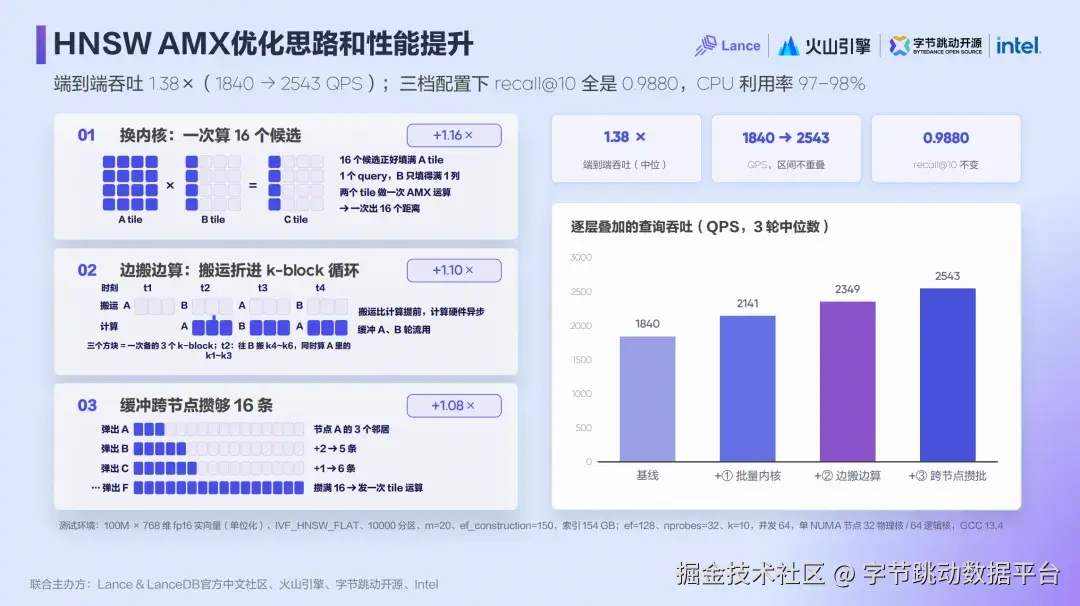
优化团队没有停留在"替换一条指令",而是分三步重组计算过程:
1.把单条距离计算改为批量内核,一次处理最多 16个 候选向量;
2.让数据搬运与矩阵计算重叠,减少等待;
3.跨节点积攒候选,凑满 16条 后再送入 Tile 计算。
在 1 亿条、768 维 FP16 向量的测试中,查询吞吐从 1840 QPS 提升到 2543 QPS ,端到端提升 1.38倍 ,recall@10 保持 0.9880。这个结果再次说明,硬件加速的前提是软件先把工作整理成硬件擅长的形状。
从向量检索走向 AI 数据湖
LanceDB 是 Agent 数据链路的一环。知识库离线构建需要 Embedding,在线查询也要先把问题转换成向量;多模态检索依赖 CLIP;语音与视频还要经历转写、增强和转码。这些任务包含大量矩阵乘法与卷积,也适合在数据所在的 CPU 侧执行。
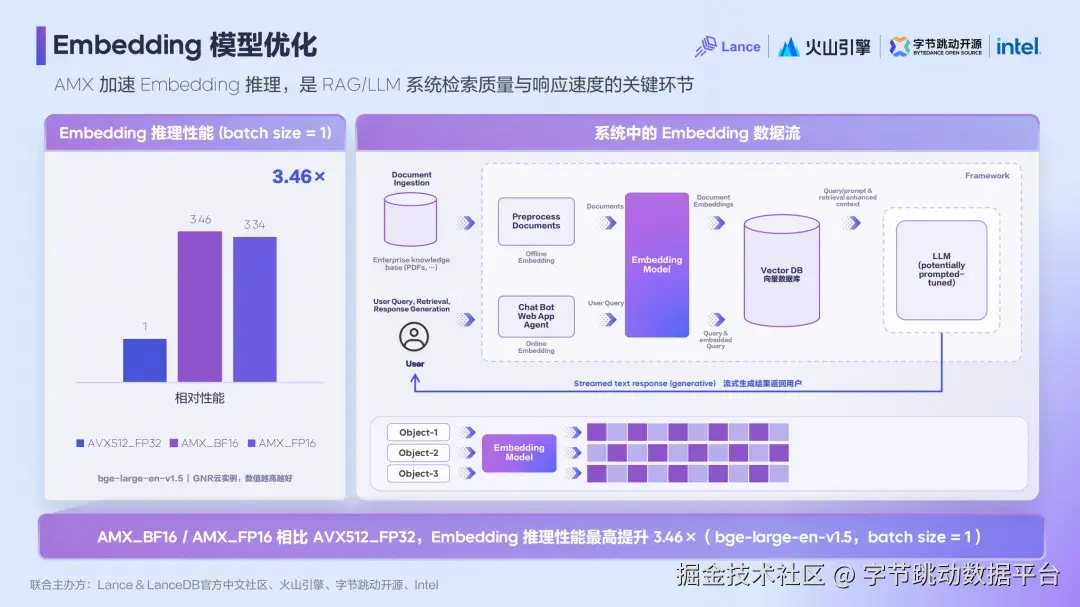
· Embedding:bge-large-en-v1.5 在 batch size = 1 下,AMX BF16/FP16 相比 AVX-512 FP32 最高提升 3.46倍。
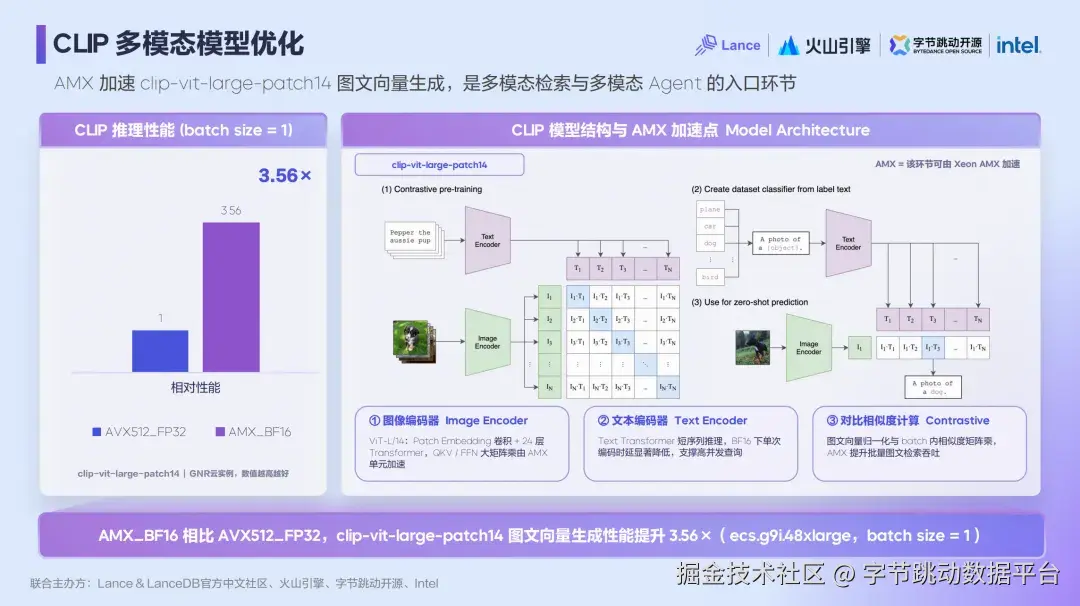
· 图文向量:clip-vit-large-patch14 使用 AMX BF16 后,性能提升 3.56倍。
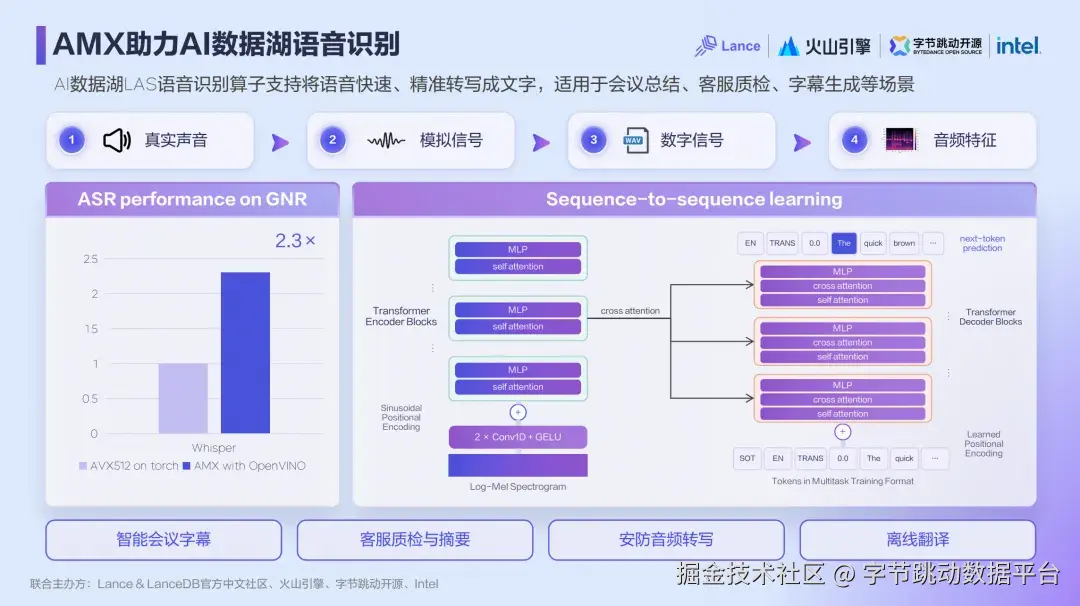
· 语音识别:Whisper 通过 OpenVINO 与 AMX 优化,相比原生 Torch 与 AVX-512 提升 2.3倍。
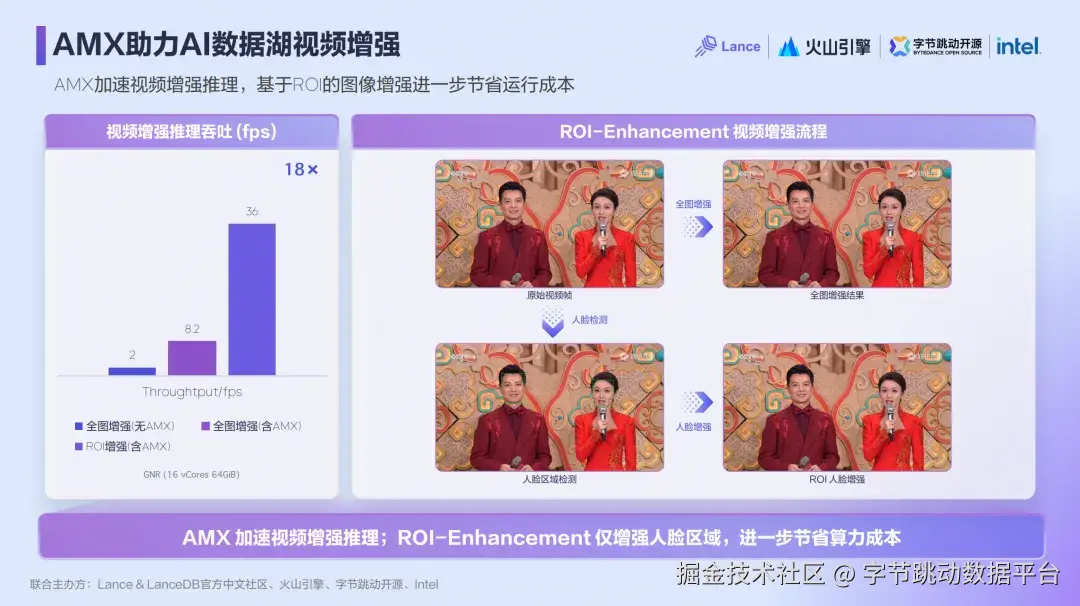
· 视频增强:全图处理从 2 fps 提升到 8.2 fps;只增强人脸等 ROI 区域后达到 36 fps。
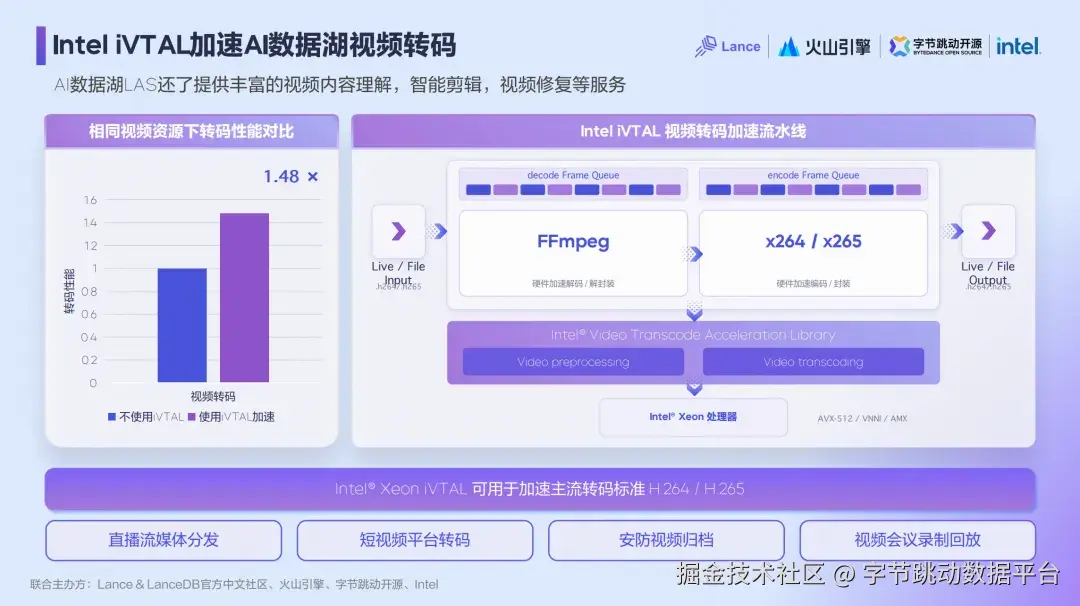
· 视频转码:Intel iVTAL 兼容 FFmpeg 与 H.264/H.265,测试中的转码性能提升 1.48倍。
虽然以上数字来自特定模型、数据集和硬件配置,不能直接外推到所有业务。但它们展示了一条可复用的优化路径:找到矩阵计算热点,批量化数据,把搬运与计算重叠,再结合业务场景减少不必要的处理范围。
CPU 与 GPU 的更合理分工
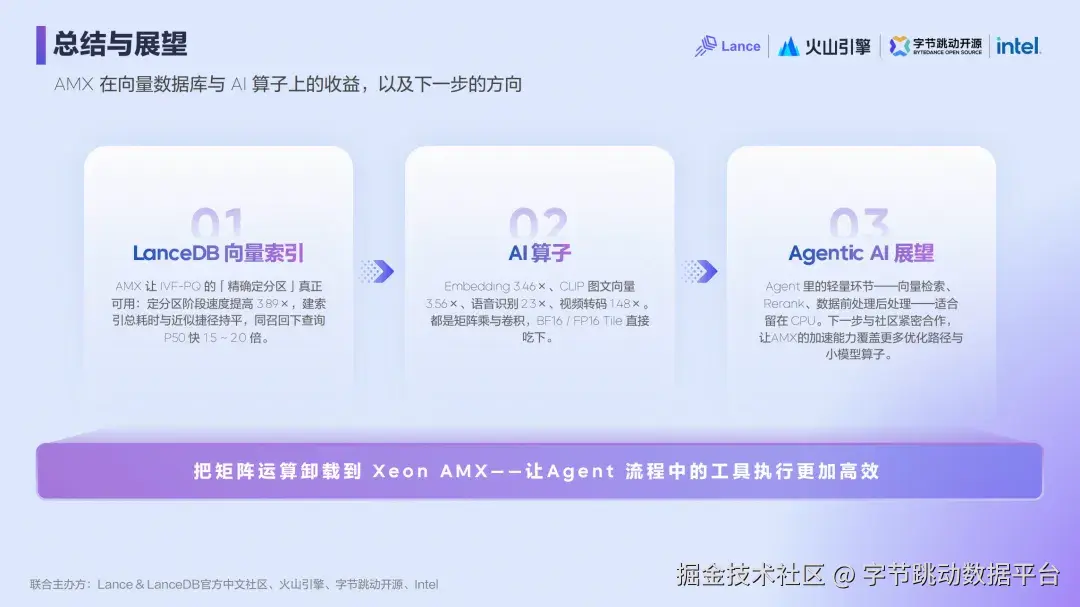
Agentic AI 已经不是单一大模型,而是一条由数据获取、预处理、检索召回、推理生成和工具调用组成的链路。任何一环变慢,都会传导到最终响应时间。
在这条链路上,GPU 仍适合承担规模更大、计算更密集的生成式推理;CPU 则可以处理贴近数据、高并发、轻量但频繁的任务,例如向量检索、Rerank、Embedding 和多模态预处理。这样既能减少数据在设备间搬运,也能让 GPU 把资源集中在更擅长的工作上。
AMX 带来的变化,不只是某个算子更快,而是让 CPU 有能力接住更多 AI 数据链路中的计算。 当精确定分区不再昂贵、零散距离计算能够成批执行、语音和视频处理可以就近完成,系统优化的目标也从单点加速转向整条链路的资源协同。