本文基于一组 Qwen3.8-27B 多平台公开基准测试,重点讨论 Benchmark 方法、推理引擎、Context、MTP、TTFT / Prefill / Decode 的技术关系。不同平台的量化和运行配方并不完全一致,因此本文不把结果当作严格的硬件排名。
 1. 测试对象与复现边界
Qwen3.8-27B 的 4-bit 量化权重约 17GB。公开测试覆盖离散 GPU 与统一内存平台,包括 RTX 5090、RTX 4090/3090、DGX Spark、Mac Studio M4 Max、Ryzen AI Halo。
离散 GPU 测试台为:Ryzen 7 9800X3D、64GB DDR5-5200、Ubuntu 26.04 LTS。测试在条件允许时比较 MTP 开启与关闭。
需要特别注意复现边界:
- llama.cpp:使用 GitHub 最新构建并自行编译,配合 Hugging Face 上的 Unsloth 量化版本,但公开正文未给出精确 commit hash;
- vLLM:采用 vLLM 维护者提供的 Qwen3.8-27B NVFP4 量化与单/双 RTX 5090 配方;
- SGLang:采用与 vLLM 相近的配置思路,但公开正文没有列出完整版本号与全部启动参数;
- 部分曲线只存在于原始图表中,因此不能从文字稿反推完整 raw data。
这意味着一个关键原则:跨引擎数据可以用于观察趋势,但不能把所有差异都归因于硬件。 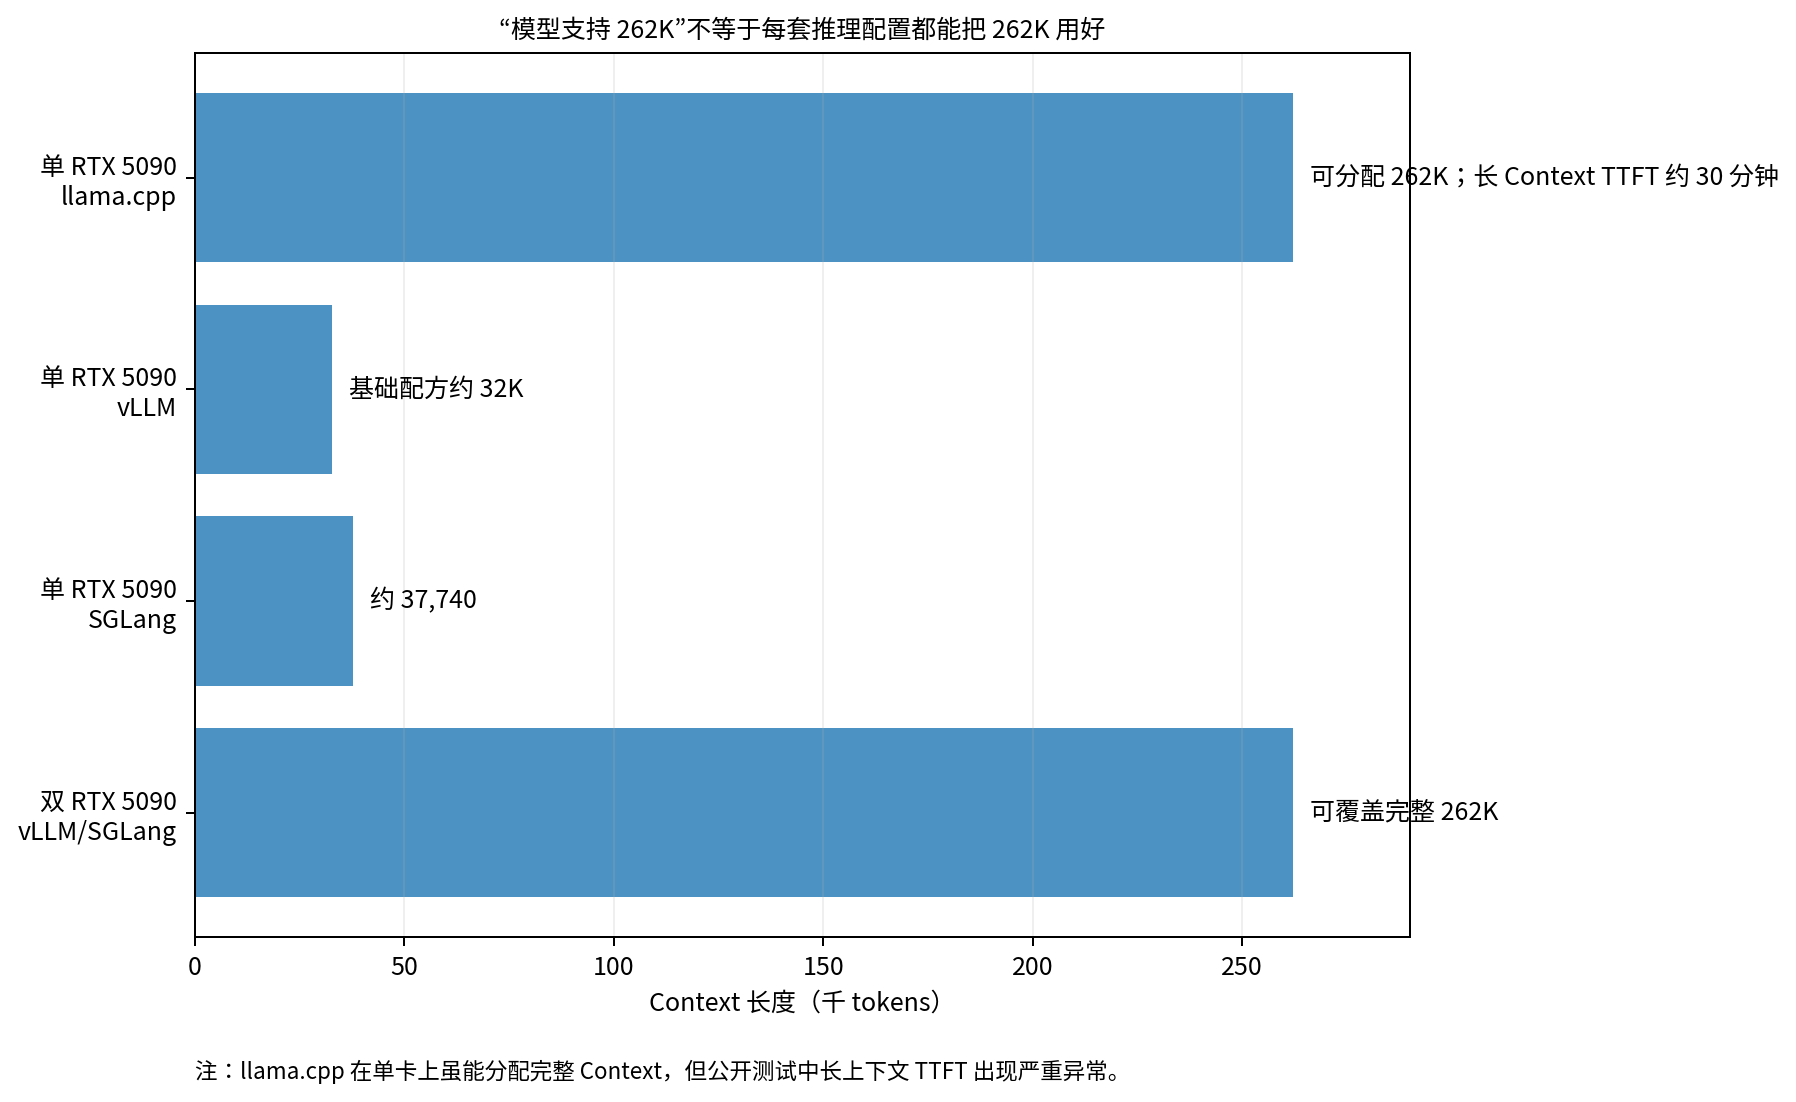
2. 关键结果
| 平台 / 配方 | Context | Decode / 响应 | 技术观察 |
|---|---|---|---|
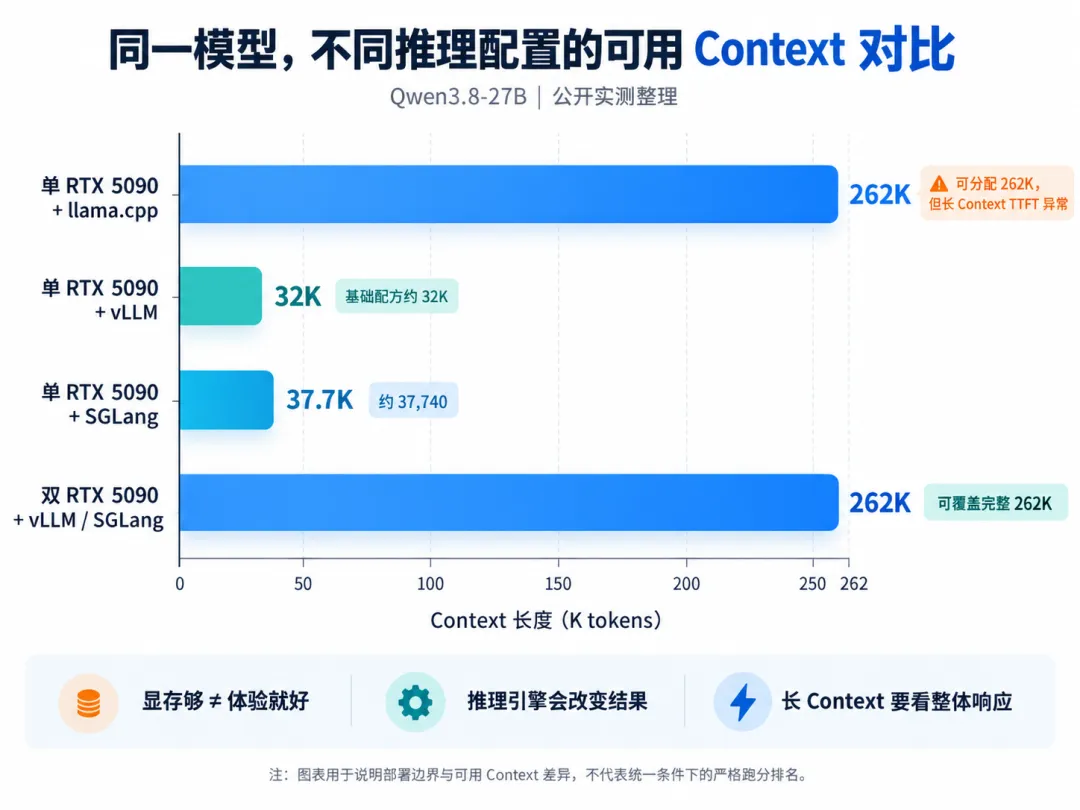
| RTX 5090 + llama.cpp | 可分配 262K | 长 Context TTFT 一度约 30 分钟 | 软件/推理栈出现严重异常,完整 Context 不等于可用 |
| RTX 5090 + vLLM 单卡 | 约 32K | ~20 tok/s,无 MTP | 显存足够加载权重,但不足以同时满足长 Context + MTP |
| RTX 5090 + SGLang 单卡 | 37,740 | 近单卡 vLLM 配方 3× | 推理引擎与部署配方显著改变结果 |
| 2× RTX 5090 + vLLM | 262K | ~70--80 tok/s | 双卡释放 Context 和吞吐空间 |
| 2× RTX 5090 + vLLM + MTP | 262K | ~100--110 tok/s | MTP 显著提高 Decode,前提是资源足够 |
| RTX 3090 / 4090 + llama.cpp | ~112K 接近上限 | 4090 长 Context 断崖,3090 无同样现象 | 24GB 需要压缩 KV Cache 并降低 Context |
| DGX Spark + MTP | 262K | ~20 tok/s,Prefill 较强 | Decode 不是完整体验的唯一变量 |
 3. llama.cpp:为什么"完整 262K"仍然可能不可用
在单 RTX 5090 上,llama.cpp 可以给 Qwen3.8-27B 分配完整 262K Context,但长 Context 下 Prompt processing / TTFT 严重恶化,代表性结果接近 30 分钟。
这说明 Benchmark 不能只记录:
model loaded: yes
context length: 262K
至少还要记录:
TTFT(context)
prefill_tps(context)
decode_tps(context)
peak_vram(context)
否则"支持 262K"只是容量结论,不是交付结论。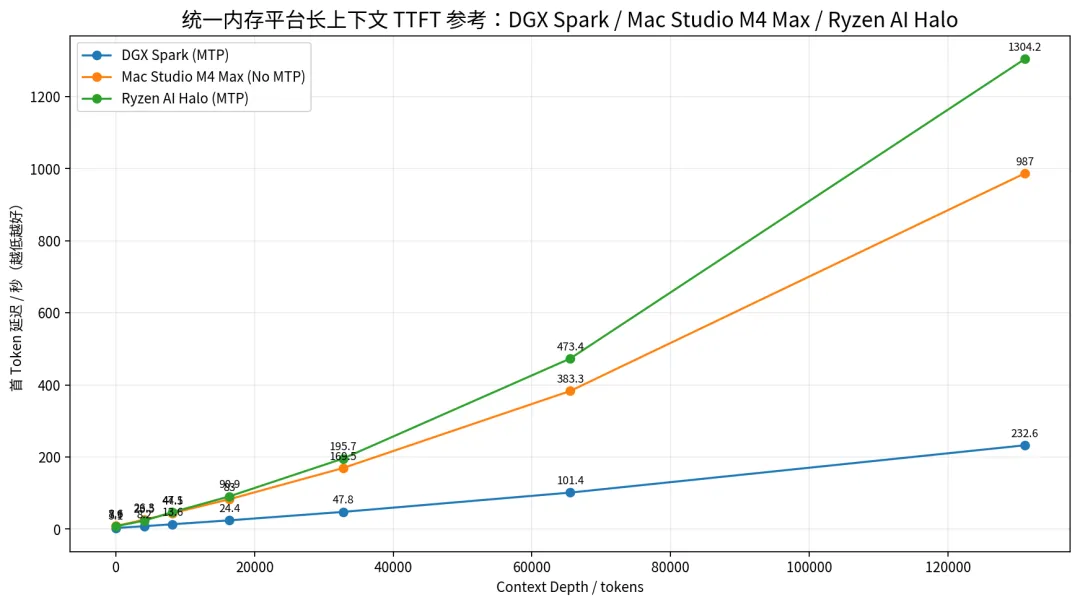
4. vLLM:生产级引擎带来的资源约束
vLLM 单卡配方使用 NVFP4。测试机已有 64GB 主内存,首次成功加载模型时还额外配置了 64GB swap,说明它不是轻量级运行栈。
单 RTX 5090 的基础配方约 32K Context,且没有足够显存启用 MTP;Decode 约 20 tok/s。
双 RTX 5090 后:
- 可覆盖完整 262K Context;
- 无 MTP 时 Decode 约 70--80 tok/s;
- 启用 MTP 后约 100--110 tok/s;
- 代价是更高硬件成本与更复杂的多 GPU 部署。
技术上,这里同时发生了三件事:显存容量增加、tensor parallel 介入、MTP 可用 。因此不能把性能提升简单理解成"多一张卡等于线性翻倍"。
5. SGLang:同硬件不同引擎为什么会差这么多
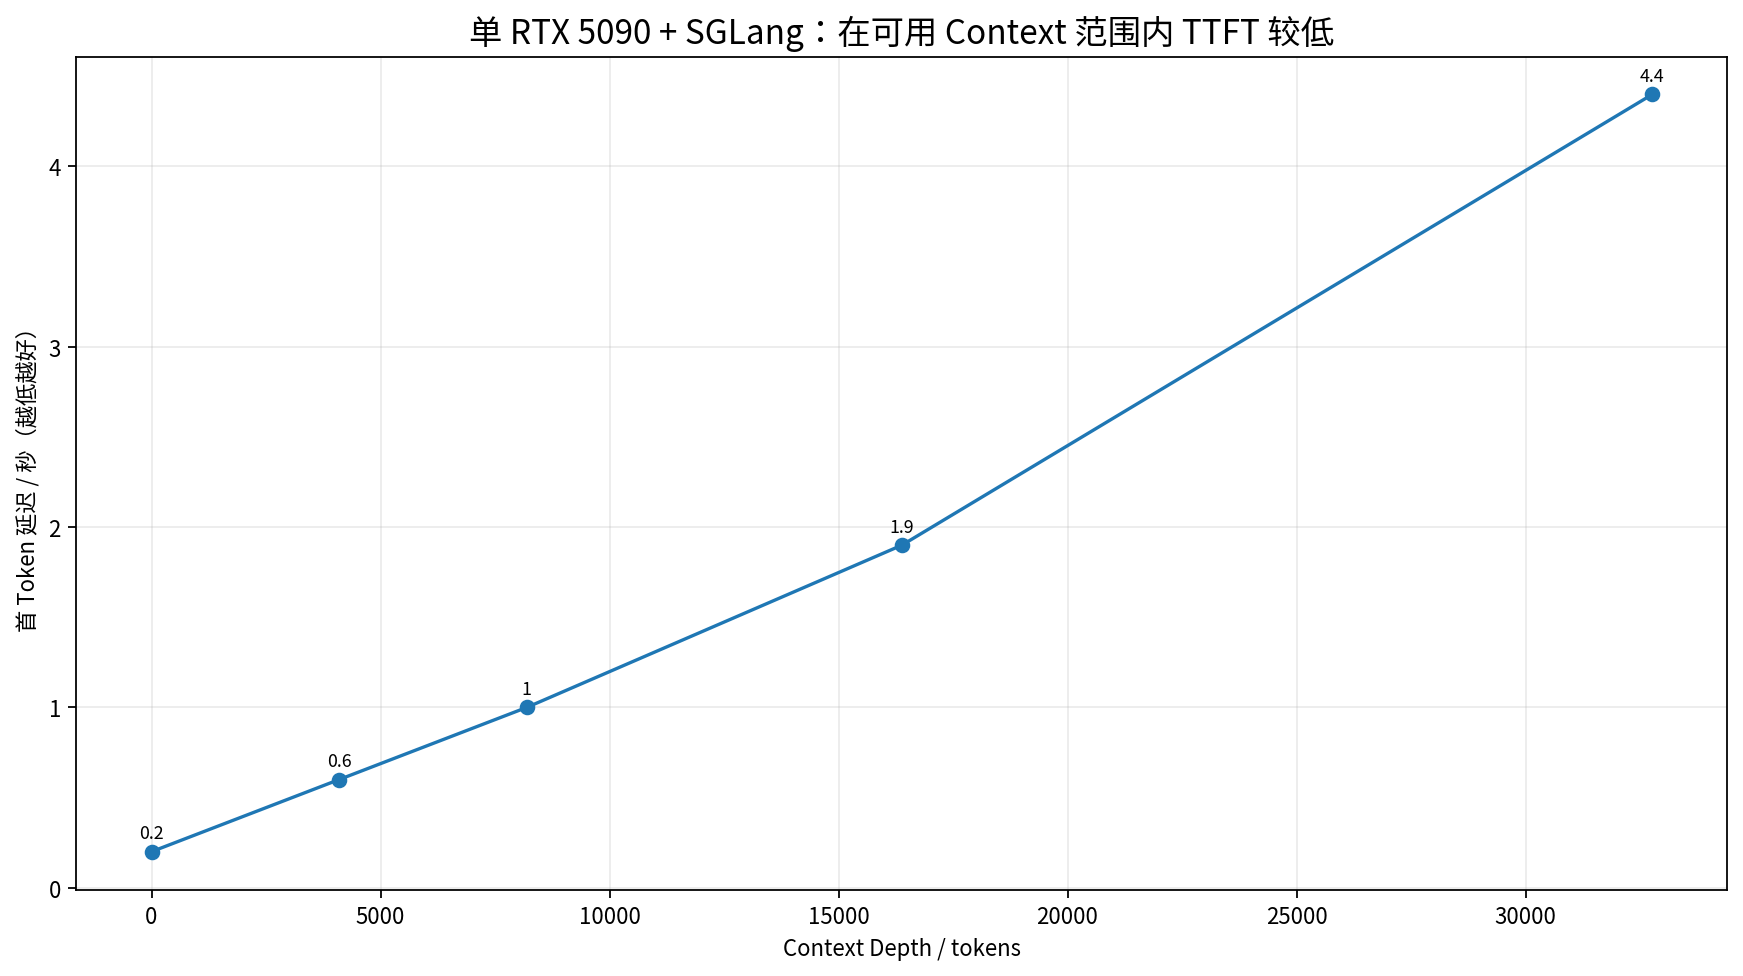
SGLang 在单 RTX 5090 上的公开结果接近单卡 vLLM 配方的 3 倍,可用 Context 约 37,740。它同样支持多 GPU tensor parallel 和多种 speculative decoding 策略。
但要注意:vLLM 与 SGLang 的量化、版本和启动参数并非完全同条件。因此正确的工程结论不是"某引擎永远比另一引擎快 3 倍",而是:
推理引擎必须被视为 Benchmark 的一级变量。
 如果做内部 PoC,建议同一平台至少固定以下变量后再做 A/B:
model checkpoint
quantization
context length
batch / concurrency
KV cache precision
MTP / speculative decoding
GPU memory utilization
output length
6. 24GB GPU:能加载,但 Context 余量更紧
RTX 3090 / 4090 可以在 llama.cpp 下加载 Q4_K_M GGUF,但需要使用 Q8_0 KV Cache,并将 Context 显著限制在模型原生 262K 以下。公开测试约 112K 已接近显存上限。
这对工程选型的意义是:权重大小 < 显存容量,不代表剩余显存足以支持目标 Context 和并发。
另外,RTX 4090 在长 Context 下出现与 RTX 5090 类似的性能断崖,而 RTX 3090 没有,进一步提示存在软件/实现层面的变量。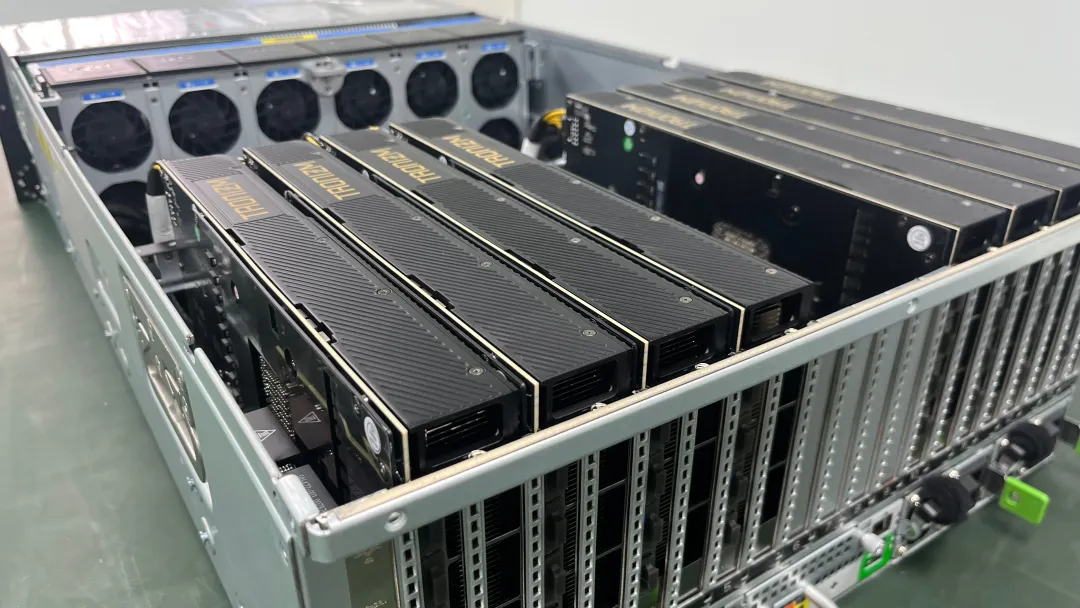
7. DGX Spark / M4 Max:为什么 Decode 高不代表整轮更快
DGX Spark 在 MTP 下 Decode 约 20 tok/s,但 Prefill 较强,因此长 Context 下 TTFT 仍保持相对可交互,并且完整一轮推理可以比 RTX 5090 + llama.cpp 更早结束。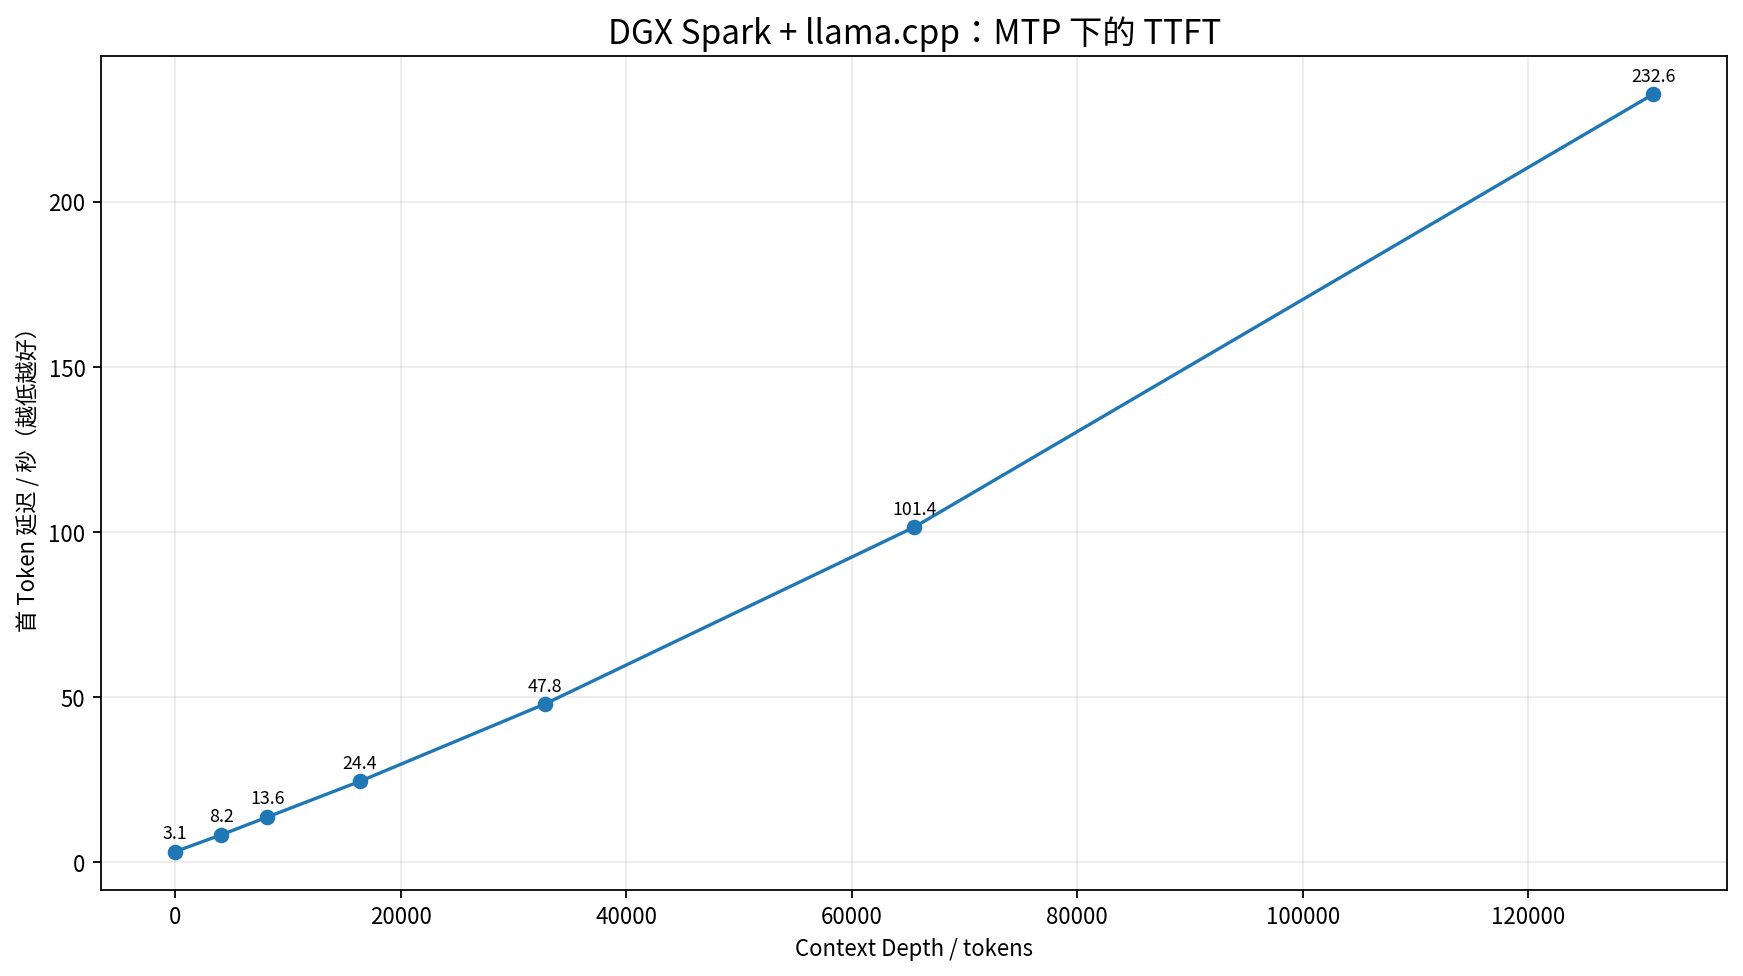
M4 Max 的 Decode 可以高于 Spark,但 Prompt processing 更慢;Context 变长后,总轮次时间被 Prefill 主导。
这提示一个常见 Benchmark 误区:
只比较 decode_tps对于 RAG、代码库、长文档和 Agent,更有意义的是:
turn_latency = prefill_time + decode_time + scheduler/runtime overhead8. 一套更可复用的本地推理 Benchmark 模板
建议把测试矩阵固定成:
| 维度 | 推荐档位 |
|---|---|
| Context | 1K / 8K / 32K / 64K / 能力允许时继续向上 |
| 输出长度 | 128 / 512 / 1K |
| 并发 | 1 / 4 / 8,按实际业务调整 |
| 指标 | TTFT、Prefill tok/s、Decode tok/s、P50/P95、峰值内存、功耗 |
| 稳定性 | 30min / 2h / 长时服务测试 |
如果用于采购或项目验收,还应记录:
- 模型 checkpoint 与量化文件哈希;
- 推理引擎版本 / commit;
- 启动参数;
- 驱动、CUDA / runtime 版本;
- CPU、系统内存、NUMA / 绑核配置;
- 是否开启 MTP、prefix caching、speculative decoding;
- 实际 Prompt token 数,而不是字符数或"目标长度"。
9. 结论
Qwen3.8-27B 这组测试最重要的技术信息不是"哪张卡最快",而是:本地推理性能是硬件容量、内存带宽、Context、KV Cache、Prefill、Decode、推理引擎与优化策略共同交付的结果。
因此:
- "能加载模型"只证明容量满足最低条件;
- "峰值 TPS 很高"不能覆盖长 Context 行为;
- 推理引擎和量化必须进入 Benchmark 条件;
- 面向服务的测试必须补并发、P95、资源占用和稳定性;
- 最终选型应使用与真实业务一致的 Prompt、Context 和并发,而不是只复现空 Context 跑分。