本文作者:小夏 ,TRAE 技术专家
一、从 Karpathy 的一条推文说起
2026 年 4 月 3 日,Andrej Karpathy 在 X 上发了一篇长帖,标题只有三个词:"LLM Knowledge Bases"。
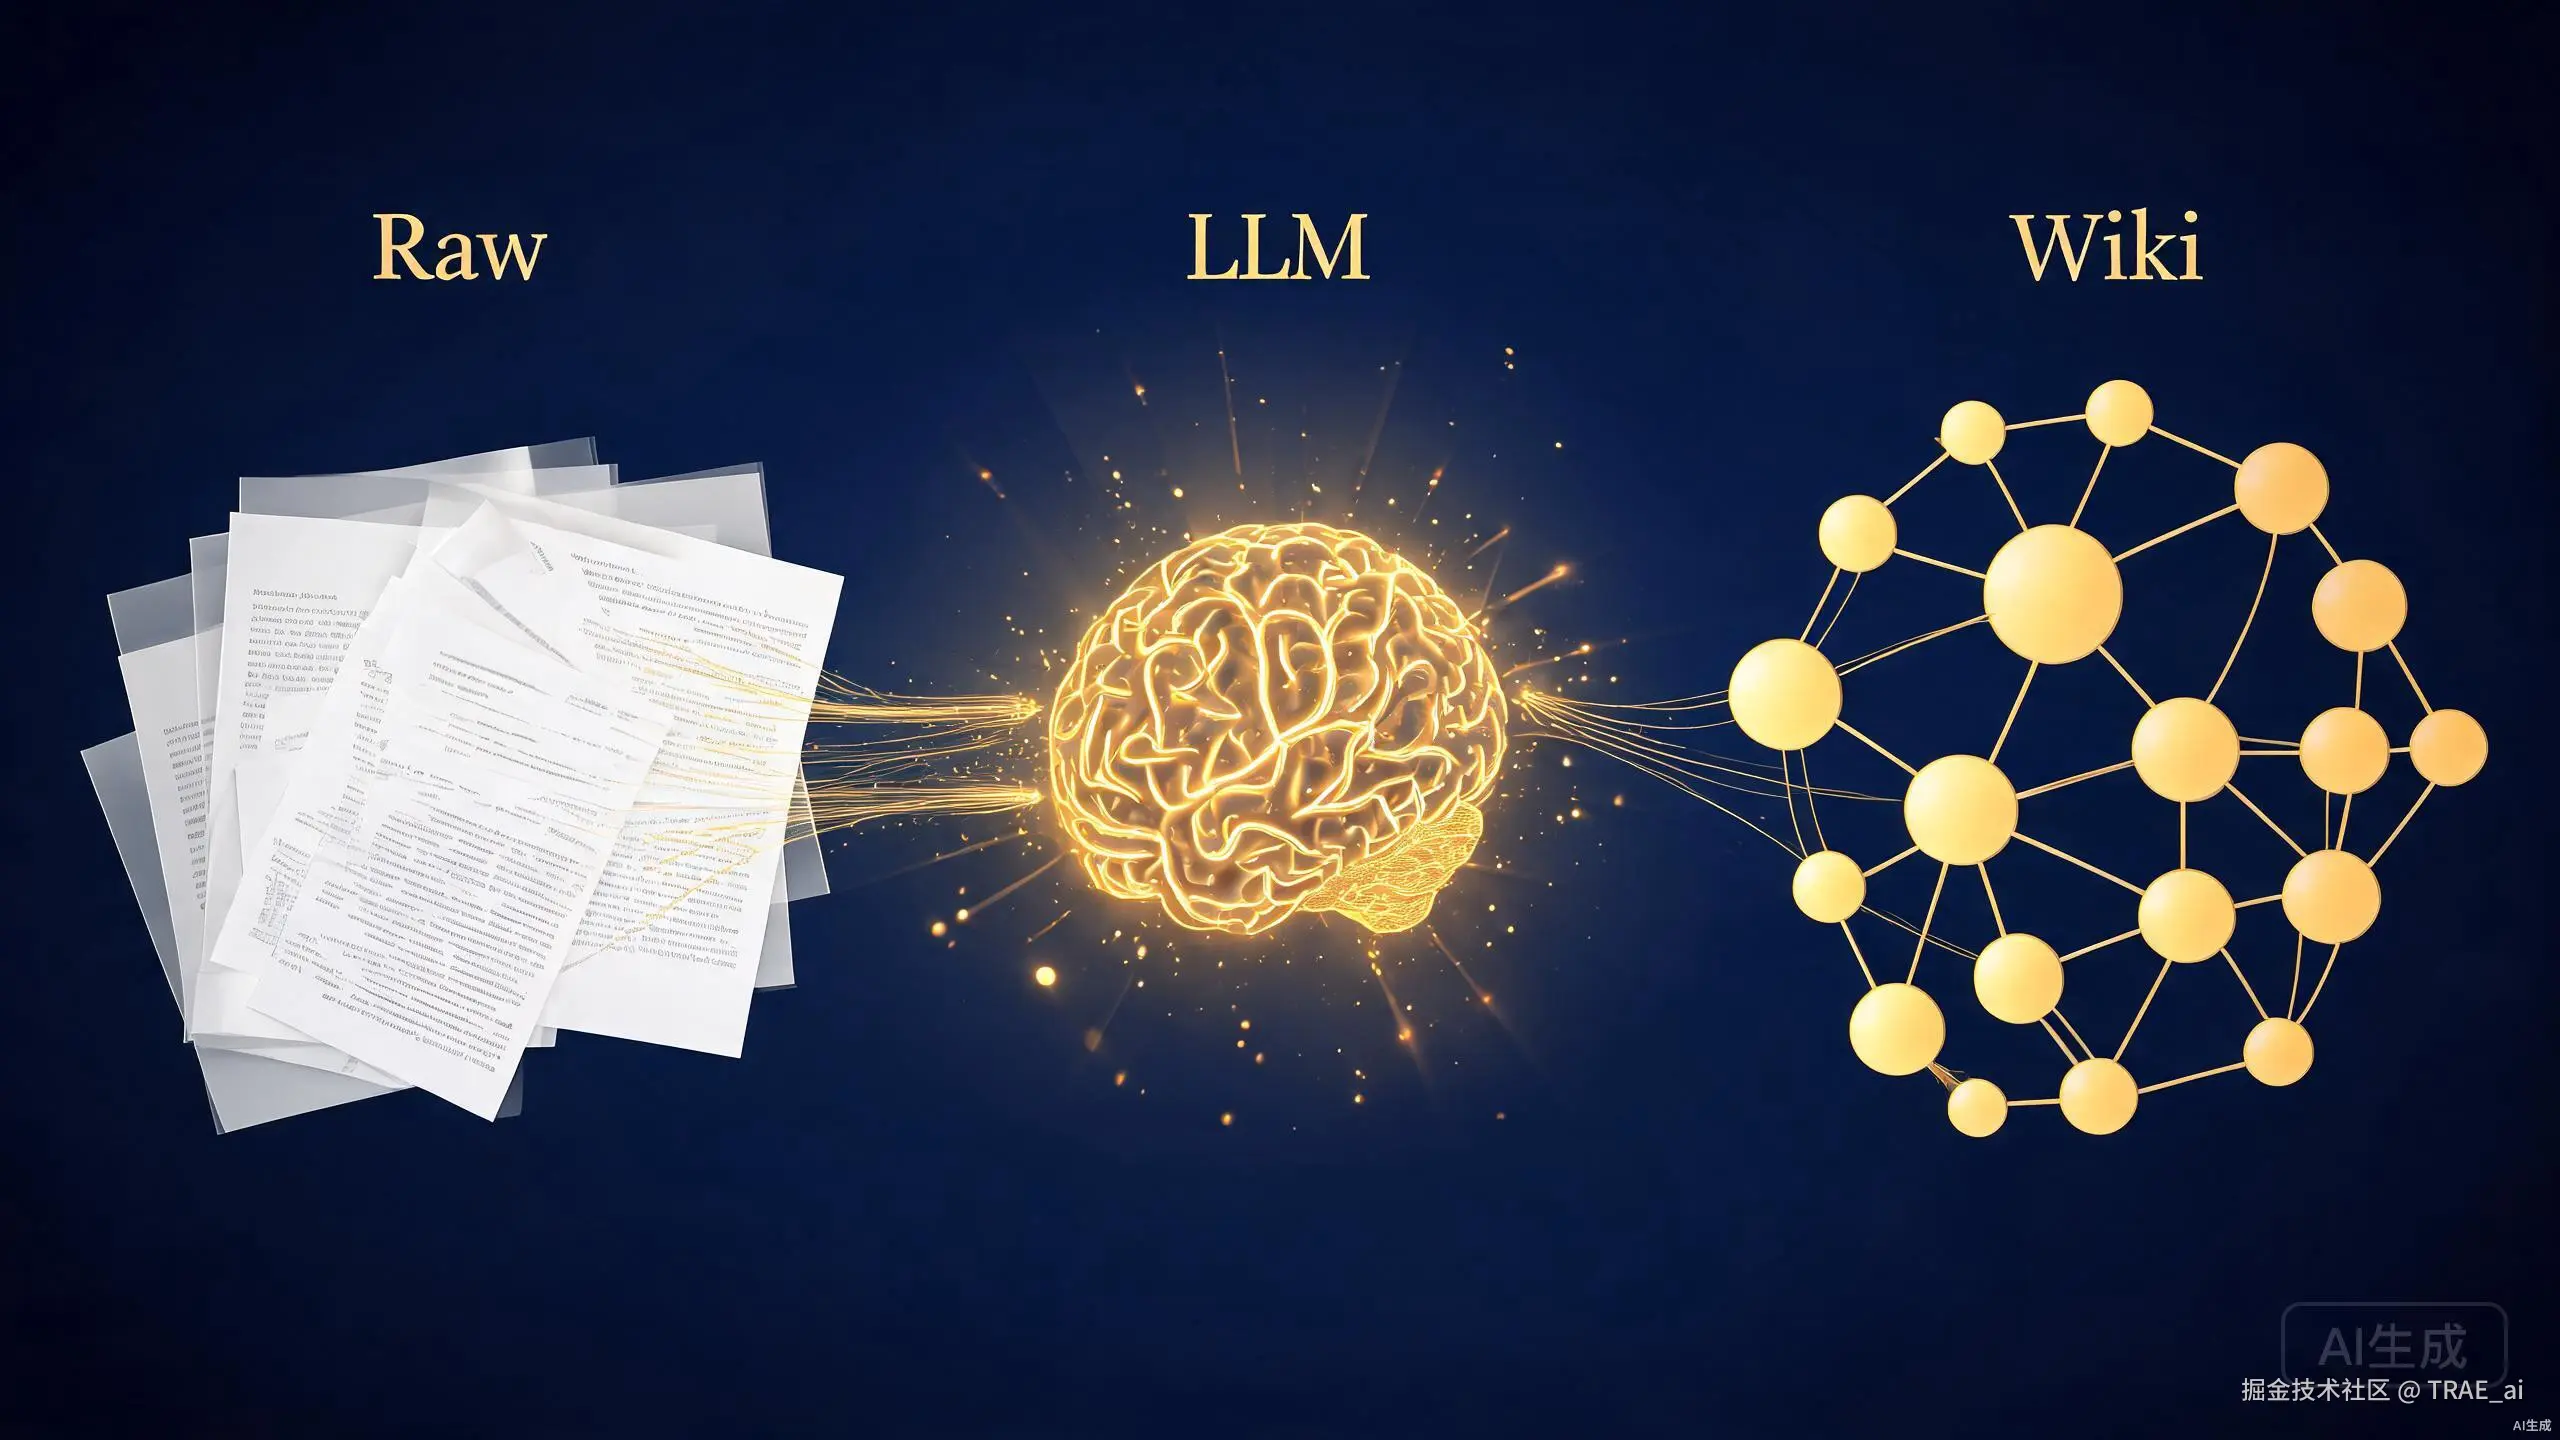
帖子的核心想法简单得惊人:不要每次提问都用 RAG 从原始文件里检索片段,让 LLM 把文件编译成一个结构化的、相互链接的 知识库 Wiki,然后在这个知识库 Wiki 上查询和对话。
这条帖子几小时内引爆了 AI 社区。人们纷纷开始复刻,用 Claude Code、用 Codex、用各种 AI 编程环境尝试构建自己的 LLM Wiki,社区里出现了大量的讨论帖、复刻教程和变体方案。
几天后,Karpathy 在 GitHub 上放出了一个 Gist。这不是一个框架,也不是一个库,甚至不是一个可执行的项目,它是一个 idea 文件,一份设计文档。
你只需要把这个文件发送给你的 AI Agent,不管是 Claude Code、Codex 还是任何支持文件读写和对话的编程环境,Agent 就会按照文件中描述的架构和工作流,帮你构建出一套完整的知识管理系统。
这个 idea 文件定义了三个核心要素:
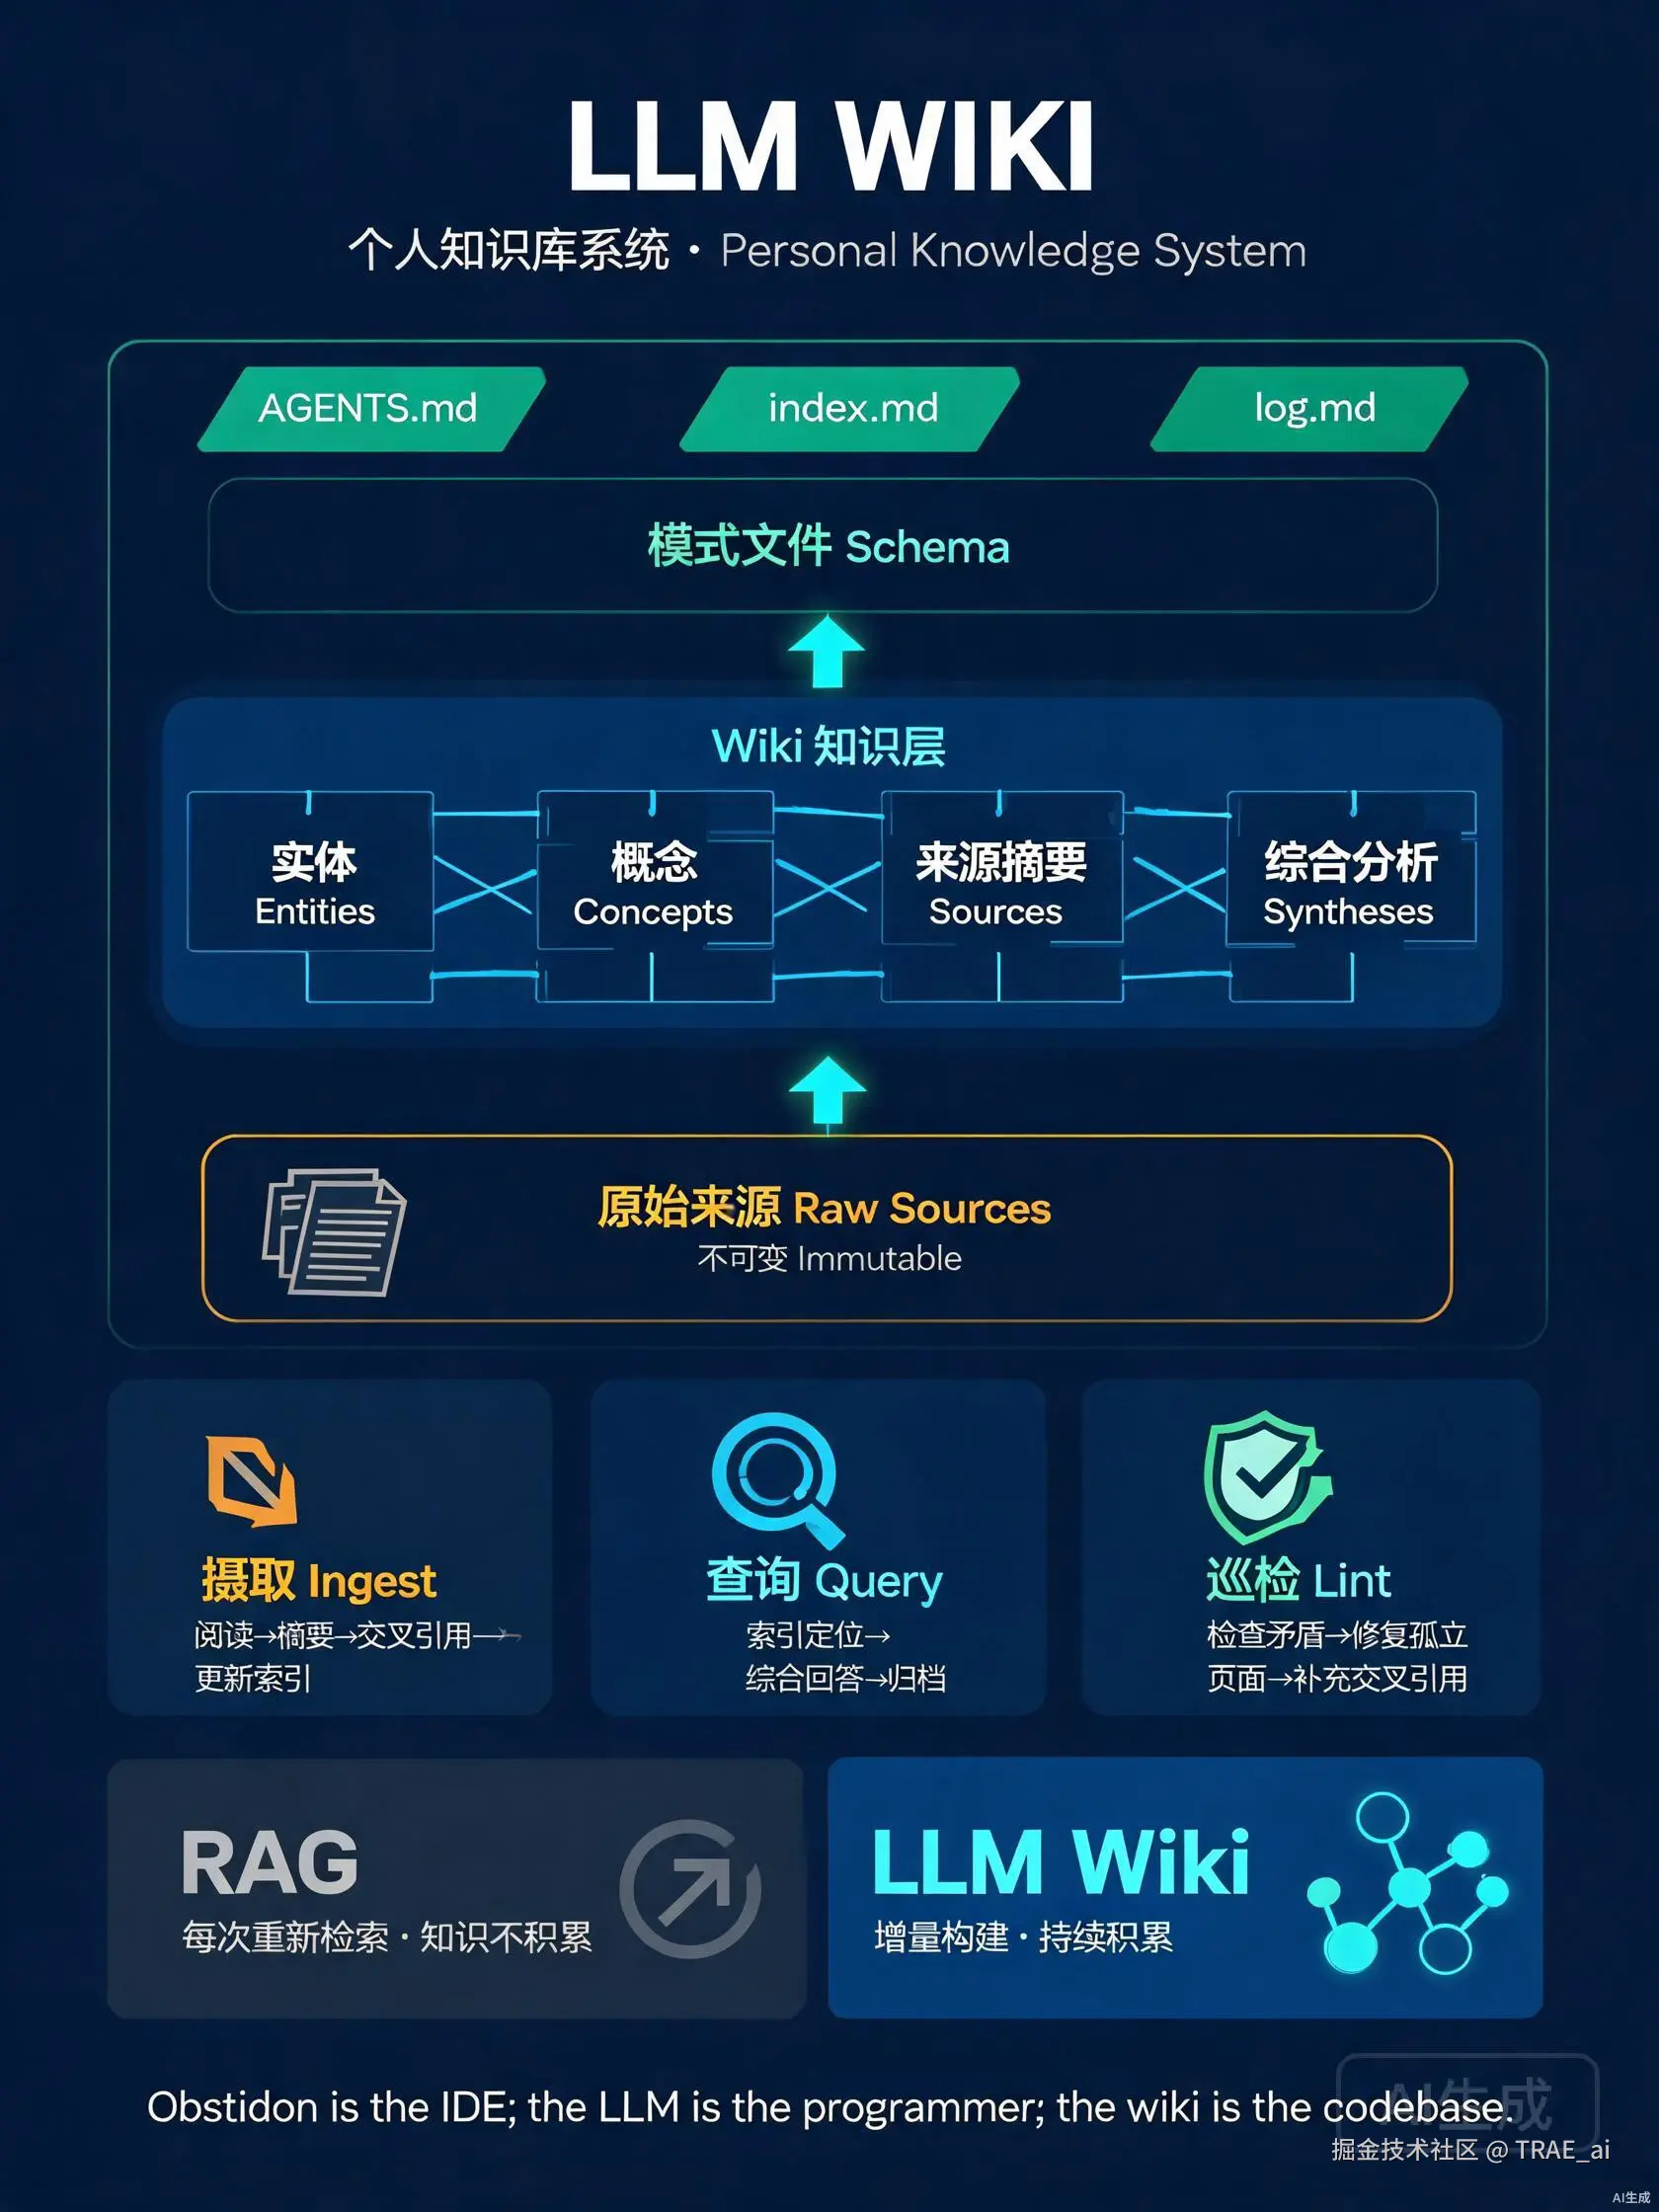
三层架构:
-
Raw sources (
raw/),你精选的原始内容。文章、论文、网页,LLM 只读取不修改。这是事实的根基。 -
The wiki (
wiki/),LLM 生成的 Markdown 文件集合。摘要页、实体页、概念页、综合页。LLM 完全拥有这一层,负责创建、更新、交叉引用和一致性维护。 -
The schema (
AGENTS.md),告诉 LLM Wiki 如何组织、遵循什么约定、执行什么工作流。这是给 LLM 的操作手册,它让 LLM 成为纪律严明的 Wiki 维护者,而非通用聊天机器人。
三大操作:
-
提取(Ingest):放入新素材,LLM 自动阅读、摘要、抽取实体和概念、建立交叉引用。一个素材可能触及 10-15 个 Wiki 页面。
-
查询(Query):基于 Wiki 内容回答问题,有价值的答案归档为新页面。
-
巡检(Lint):定期健康检查,检测矛盾、标记过时、发现孤立页面、补充缺失链接。
角色分工:
"You're in charge of sourcing, exploration, and asking the right questions. The LLM does all the grunt work --- the summarizing, cross-referencing, filing, and bookkeeping."
Karpathy 用了一个精妙的类比来描述这套系统的工作方式:Obsidian(或任何 Markdown 编辑器)是开发环境,LLM 是程序员,Wiki 是代码库。你不需要自己写 Wiki,就像你不需要自己编译代码一样。你提供需求(素材和问题),LLM 负责实现(阅读、摘要、交叉引用、维护)。
这套系统本质上是一套 PKMS (Personal Knowledge Management System)
乍看之下,"LLM Knowledge Bases" 像是一个 AI 工程的小技巧,把文件丢给 LLM,让它帮你整理。但如果把它放到知识管理的长河中审视,你会发现它其实是个人知识管理系统(Personal Knowledge Management System)的最新形态。
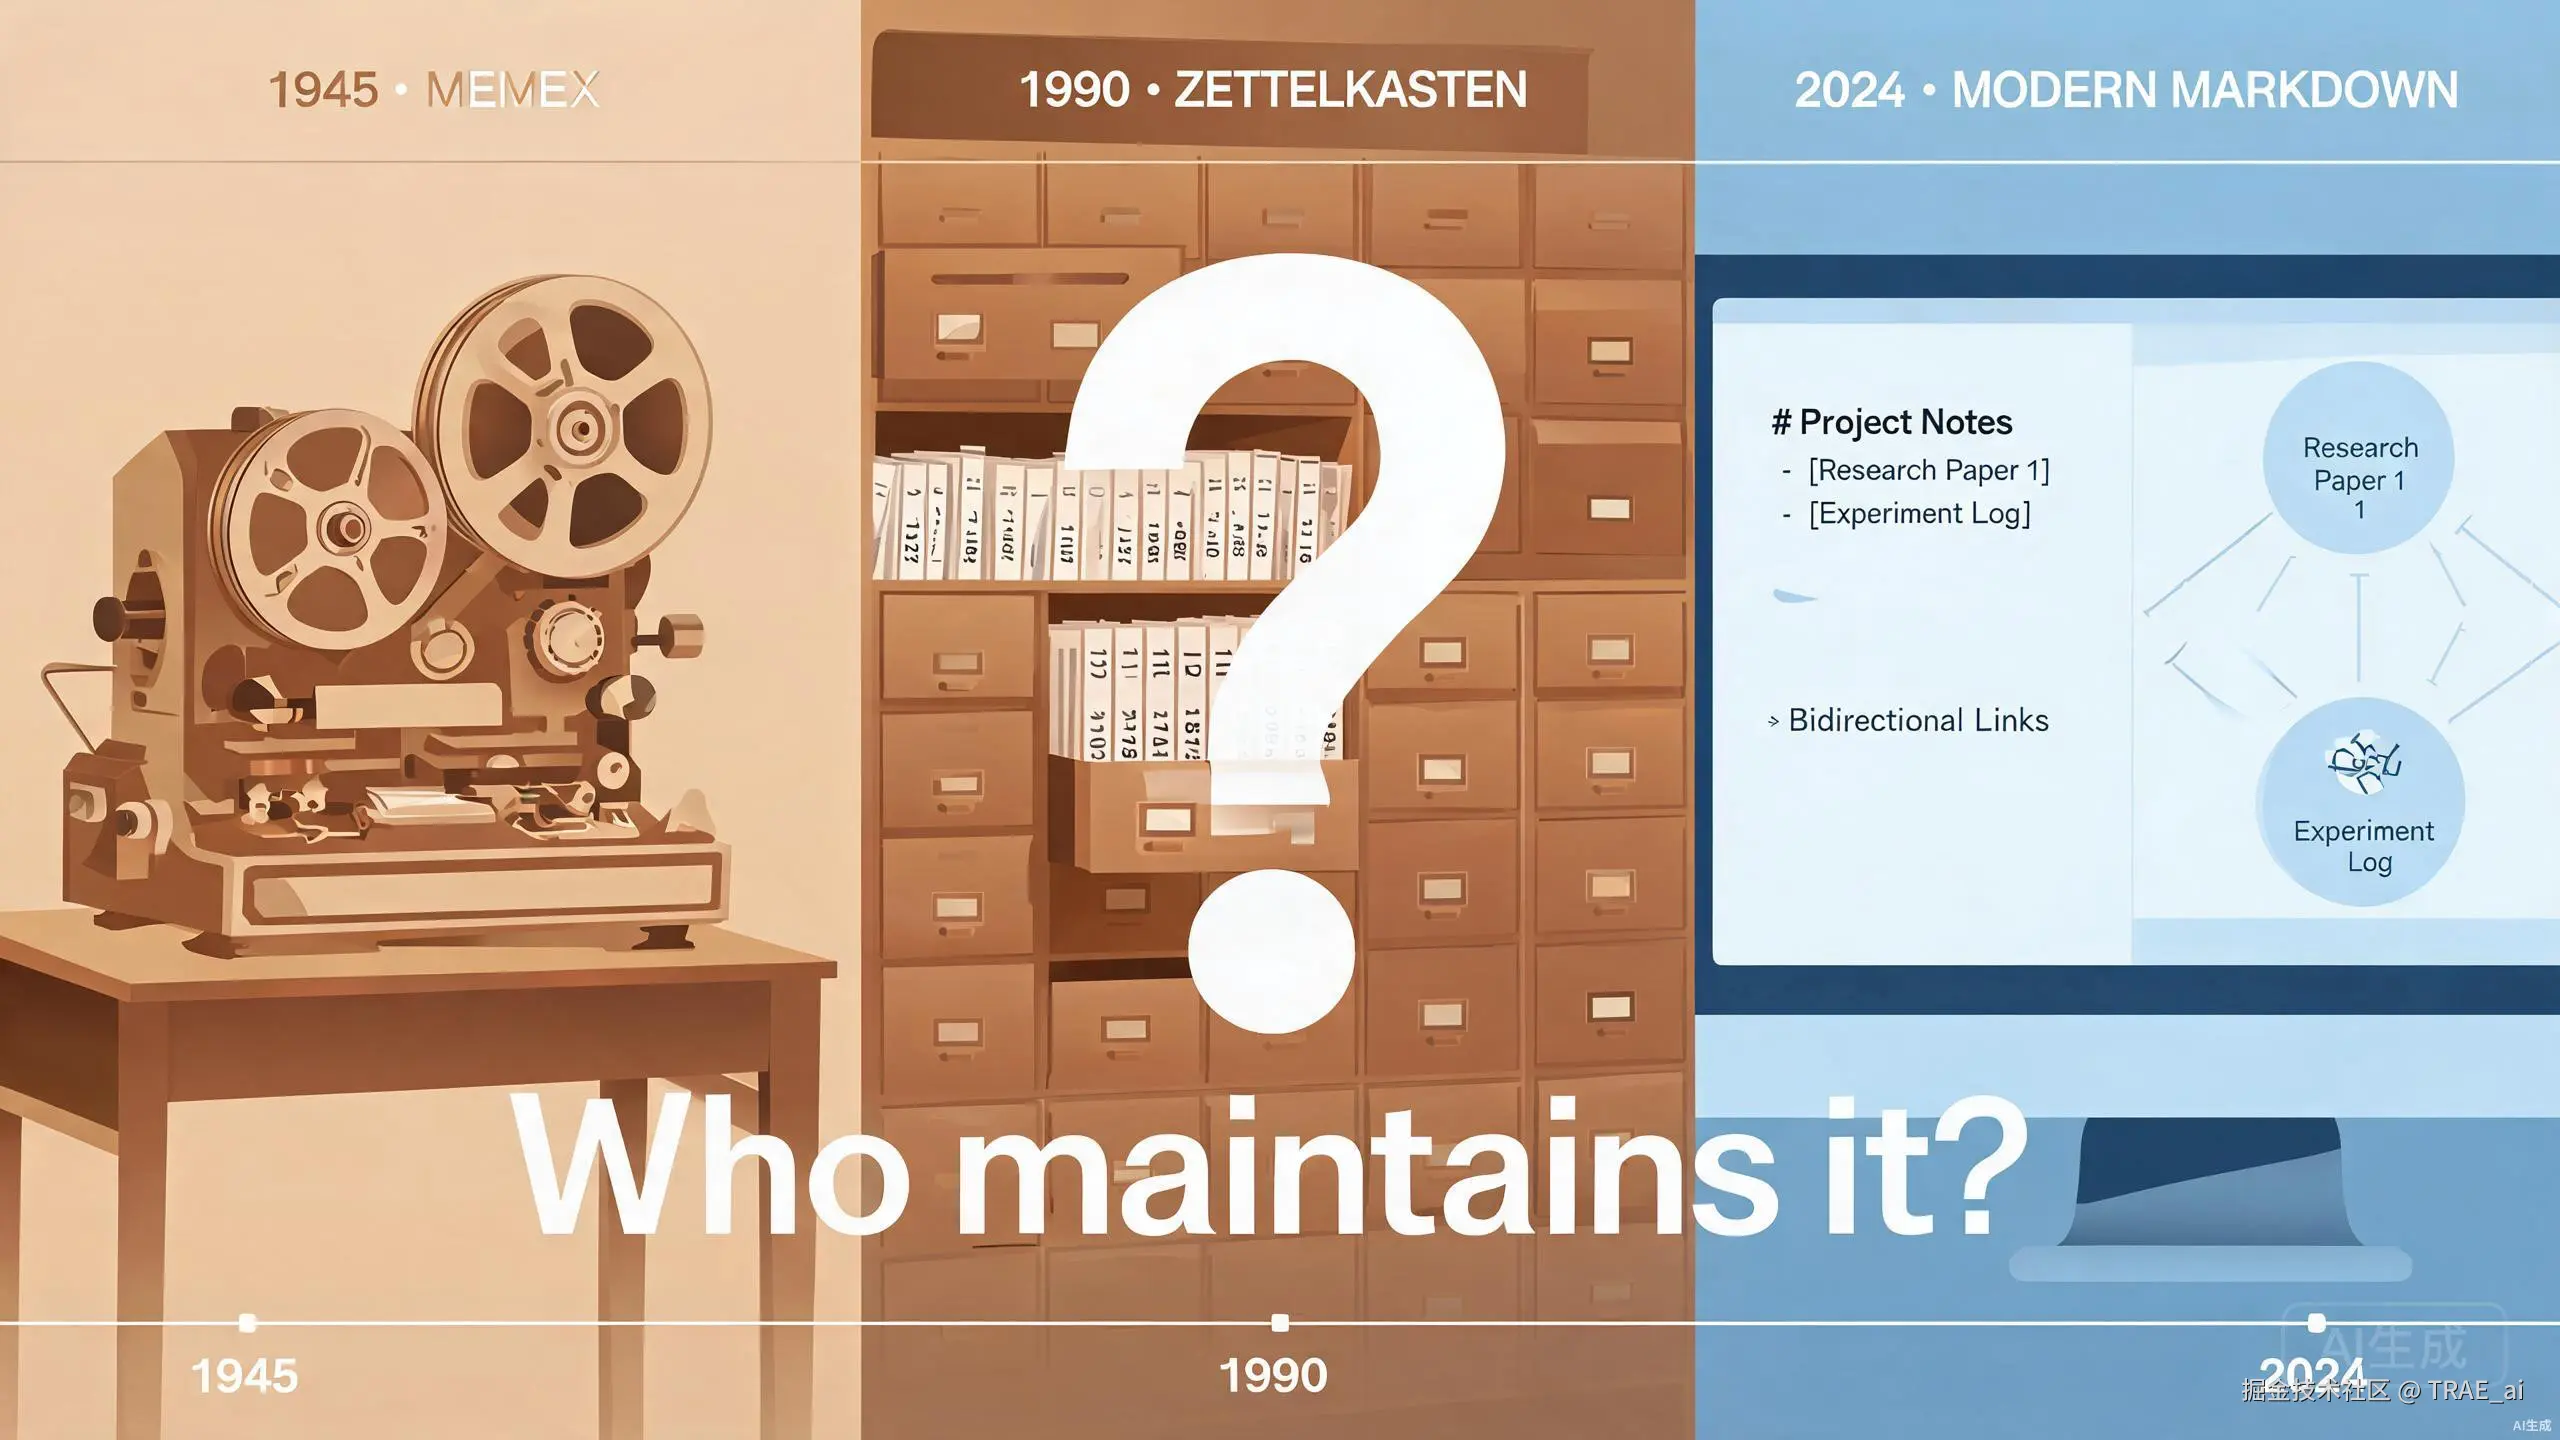
从 16 世纪的 commonplace-book(摘记本),到 Niklas Luhmann 的 zettelkasten(卡片盒),到 Vannevar Bush 1945 年设想的 memex,再到 Roam Research、Obsidian、Notion,人类一直在寻找一种方法,让知识不只是存储,而是积累、互联、涌现。
Karpathy 自己也意识到了这层联系。在 idea 文件的结尾,他写道:
"The idea is related in spirit to Vannevar Bush's Memex (1945) --- a personal, curated knowledge store with associative trails between documents. The part he couldn't solve was who does the maintenance. The LLM handles that."
Bush 80 年前就设想了这样的系统,私人的、主动精选的、文档之间的关联和文档本身一样重要。但他无法解决一个核心问题:谁来维护?LLM 解决了这个问题。
那么,为什么这个 80 年悬而未决的问题,在今天突然变得如此紧迫?为什么 Karpathy 的一条推文能在几小时内引爆社区?我们需要的,究竟是另一套工具,还是另一种思维?
二、为什么我们需要一套新的 PKMS
2.1 80 年的未竟之志:从 Memex 到 Obsidian
「谁来维护知识库」这个问题已经悬而未决了 80 年。
1945 年,Vannevar Bush 在《大西洋月刊》提出 memex 设想:人类思维通过关联运作,因此知识设备的关键不是存储,而是「关联索引」。Bush 的设想极具前瞻性,但「谁来建立和维护这些关联轨迹」始终是空白。他的想法启发了超文本的发展(Engelbart、Nelson、Berners-Lee),但超文本走向了全球信息共享,偏离了个人知识积累的初衷。
手动系统的巅峰是德国社会学家 Niklas Luhmann 的 zettelkasten:90,000 张卡片,50 本书,550 篇论文。但这个成果需要终身的投入和超凡的纪律,不可复制。2020 年代,Roam Research、Obsidian、Notion 等工具用双向链接降低了门槛,但维护负担没有消失:建立什么链接、何时更新摘要、如何检测矛盾,仍然完全依赖人。
回顾这 80 年,问题始终围绕六个维度:
| 局限维度 | 具体表现 |
|---|---|
| 维护负担 | 交叉引用、摘要更新、一致性维护全靠手动 |
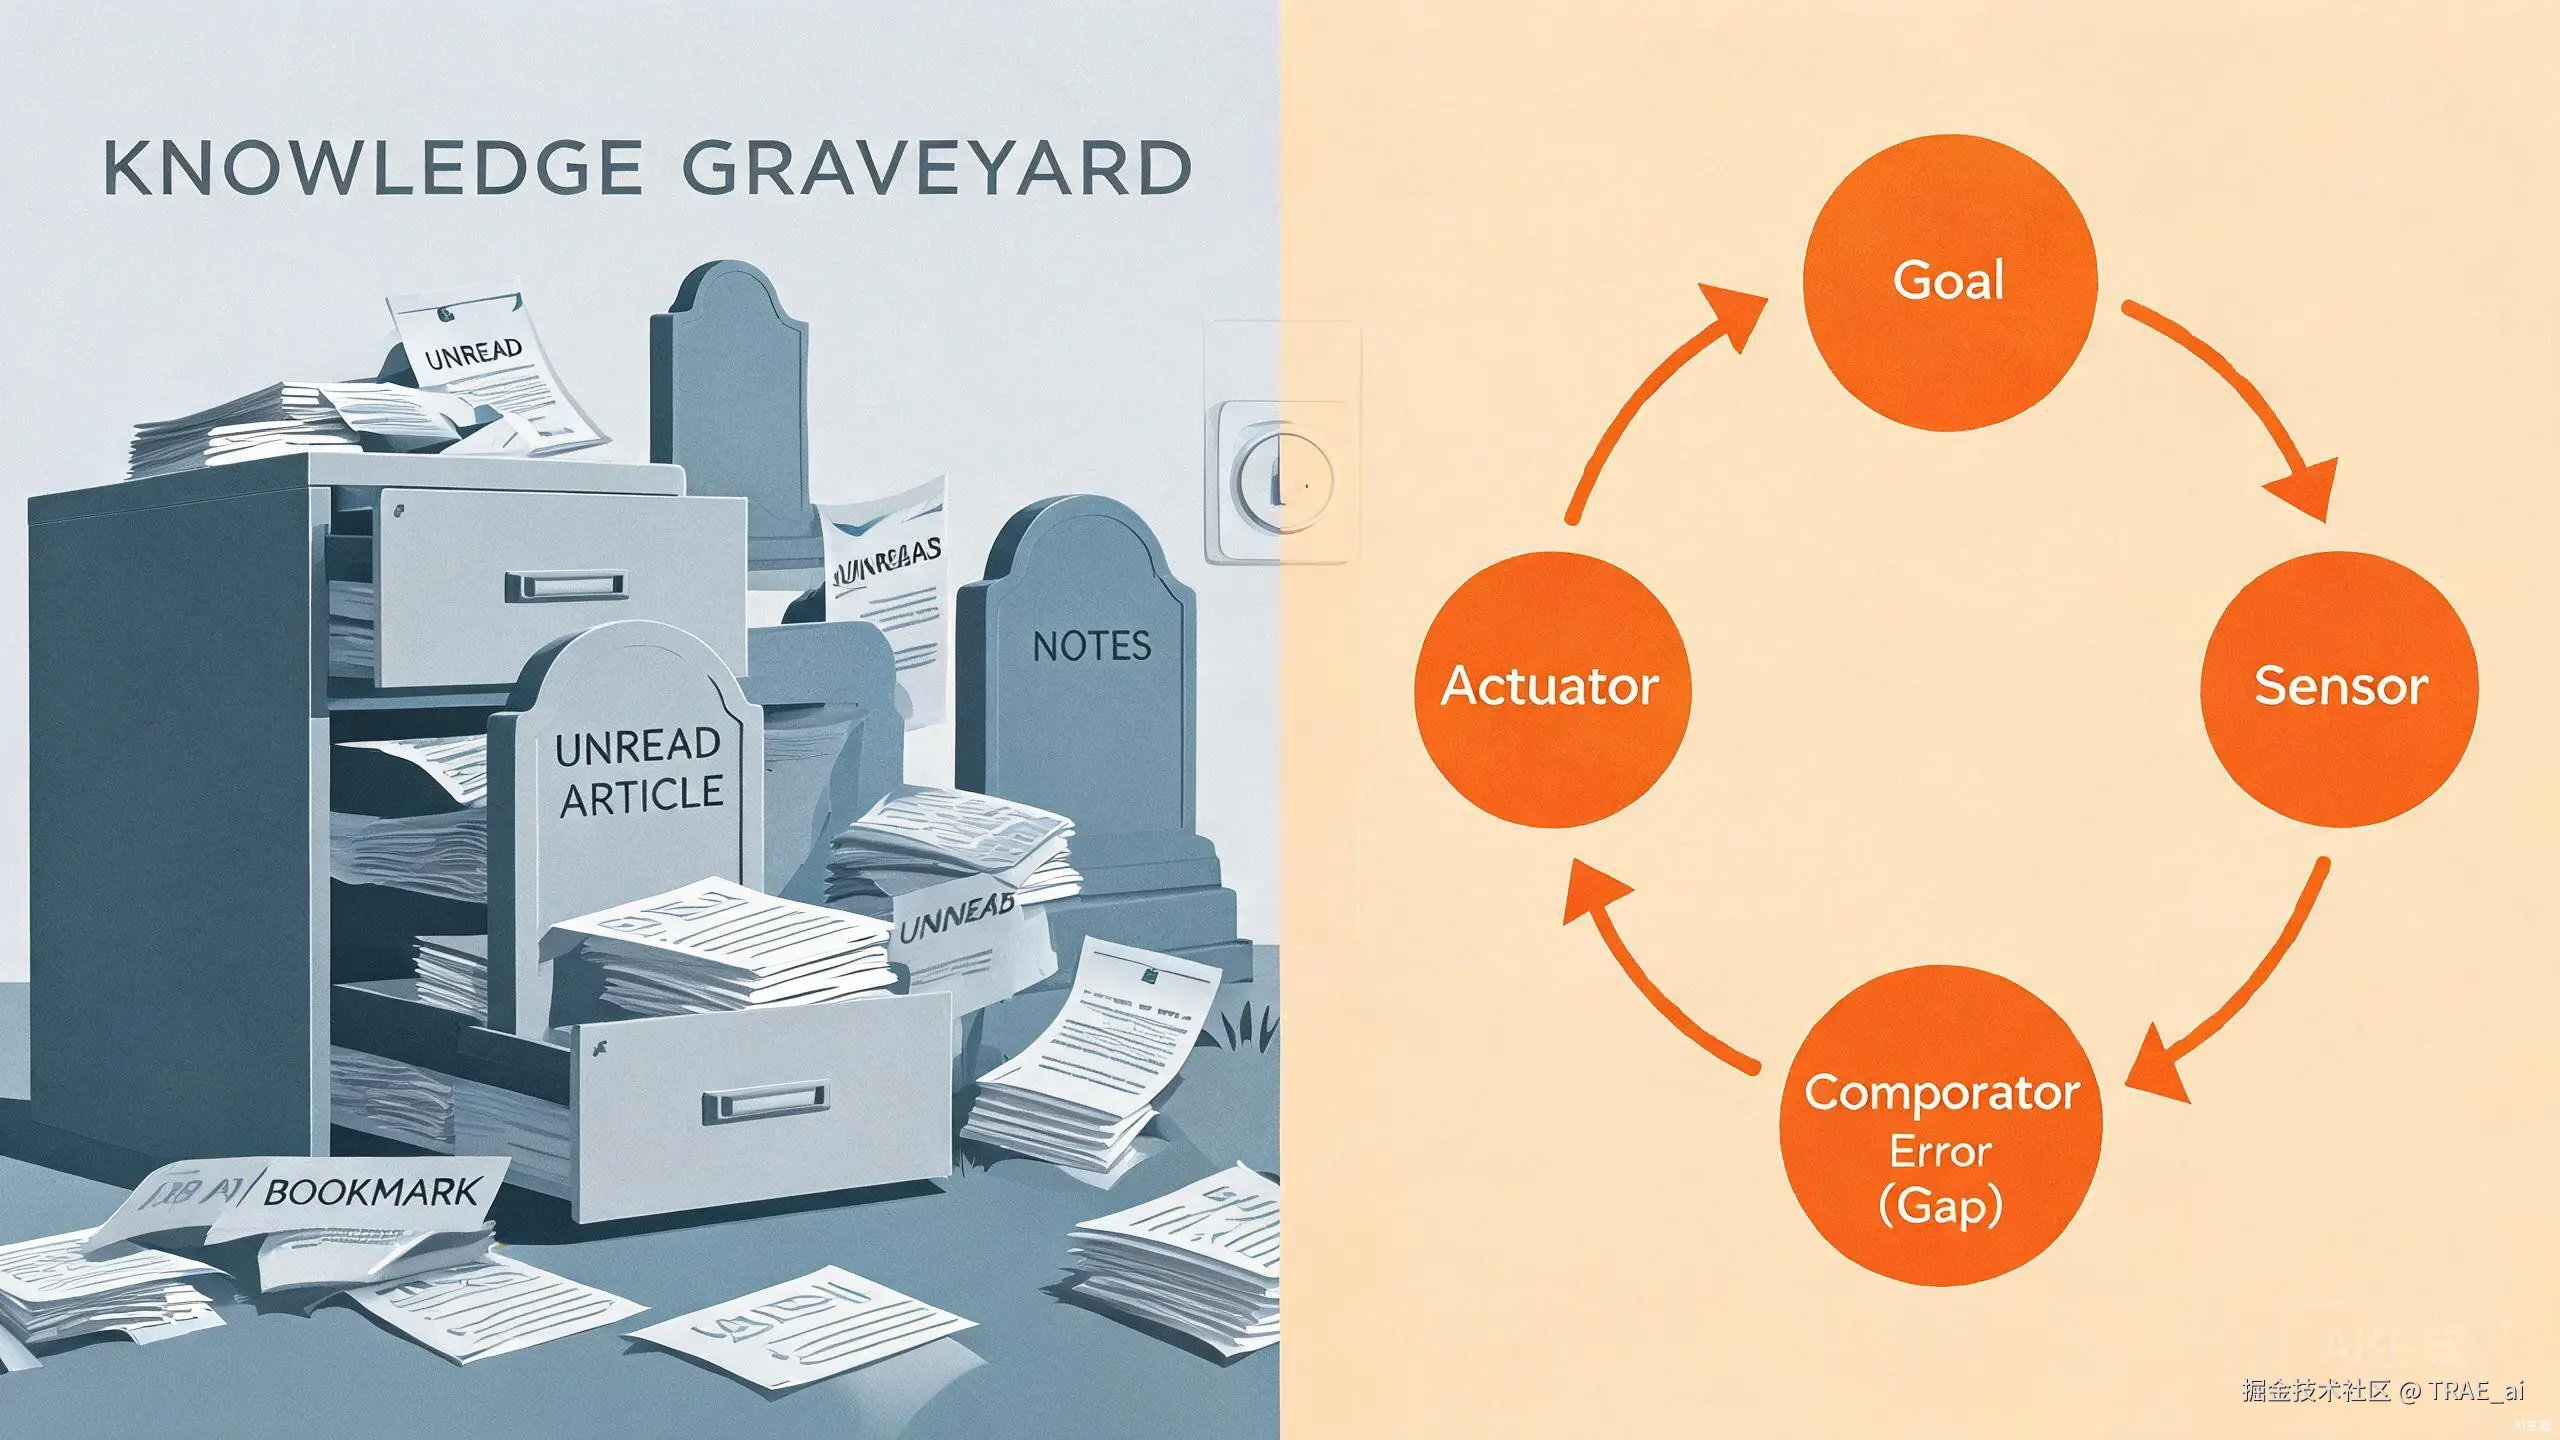
| 知识坟墓 | 收藏后不再查看,存储变成囤积 |
| 搜索错配 | 关键词搜索与人脑的联想方式不匹配 |
| 无矛盾检测 | 新旧笔记矛盾时系统不会标注 |
| 结构缺陷 | 供应商锁定、云端依赖、无自动综合 |
| 规模退化 | 知识库增长后维护成本指数上升 |
工具从纸张进化到 Markdown 文件,关联方式从手动引用进化到双向链接,但「谁来维护」始终没有被真正解决。
2.2 知识坟墓:Dan Koe 对第二大脑的批评
2026 年 8 月,作家和创作者 Dan Koe 在 X 上发了一篇长文,标题是:"If you need to remember it, it's not important"(如果你需要刻意记住它,那它就不重要)。
Dan Koe 的核心批评指向一个我们都不愿承认的事实:第二大脑被广泛误用了。人们热衷于收藏文章、标记书签、录入笔记,然后,再也不看它们了。
"wasted your time thinking you were learning" (你浪费了时间,还以为自己是在学习)
这不是个别人的问题,而是系统性问题。Dan Koe 借用控制论(Cybernetics)解释了为什么会这样。
控制论视角:为什么知识会变成坟墓
控制论源自希腊语 kybernētēs(舵手)。舵手不是一次性设定方向然后就不管了,他持续读取风向、浪潮和当前航向,与预期航线对比,计算偏差,然后不断调整。这是一个反馈循环。
Dan Koe 将这个模型应用到学习上,提出了四个要素:
-
参考信号(目标),系统持有的目标状态
-
传感器(感知),读取当前状态
-
比较器(差距),计算目标与现状的差异,产生误差信号
-
执行器(行为),行动以缩小差距
关键洞察在于:没有目标,就没有误差信号;没有误差信号,就没有过滤器;没有过滤器,信息就不分轻重地堆积。
这就是第二大脑变成知识坟墓的根源。大多数人建知识库时没有明确的创作目标,他们收集是因为「也许将来有用」。但「也许将来有用」不是一个目标,它不产生误差信号,因此大脑无法区分重要和不重要的信息,所有信息被平等地堆入仓库,然后被遗忘。
Dan Koe 认为,知识系统不应停留在「第二大脑」(被动存储),而应进化为「第二潜意识」,能自动标记、分类、语义检索的知识系统。历史上的 commonplace-book 实践者(Marcus Aurelius、Leonardo da Vinci、Mark Twain 等人)作为例子,这些人收集想法是为了服务于创作,而非存储资料。
2.3 两个方向的汇流
Karpathy 和 Dan Koe 在各自的领域触及了同一个问题的不同侧面。
Dan Koe 诊断了问题:知识变成坟墓,是因为没有目标驱动的过滤机制;检索失效,是因为缺少语义层面的关联;系统退化,是因为缺少自动维护。他提出的方向是「第二潜意识」,知识系统应能自动标记、分类和语义检索。
Karpathy 提供了解药:LLM 不会厌倦、不会遗漏交叉引用、可以一次触及 15 个文件。他提出的方案是让 LLM 增量构建并维护持久化的 Wiki,提取时编译,而非查询时检索。
这两个方向在一个关键点上汇流了:知识管理需要的不仅是更好的存储,更是主动的编译。
Dan Koe 从创作者的视角出发,看到的是「筛选比生成更重要」,
"When AI can create anything, curation matters more than ever."
Karpathy 从工程师的视角出发,看到的是「维护成本可以被降到零」,
"The wiki stays maintained because the cost of maintenance is near zero."
汇流的产物就是 LLM Wiki 模式:它用 LLM 的自动化解决了 Dan Koe 描述的维护困境(谁来组织、交叉引用、保持时效),同时用「为创作筛选」的理念回应了 Dan Koe 对知识管理本质的追问,知识库不是仓库,是创作的燃料。
与 RAG 的本质区别
理解 LLM Wiki 的独特性,最好的参照是 RAG(检索增强生成),大多数人对 LLM + 文档的经验来自 RAG。
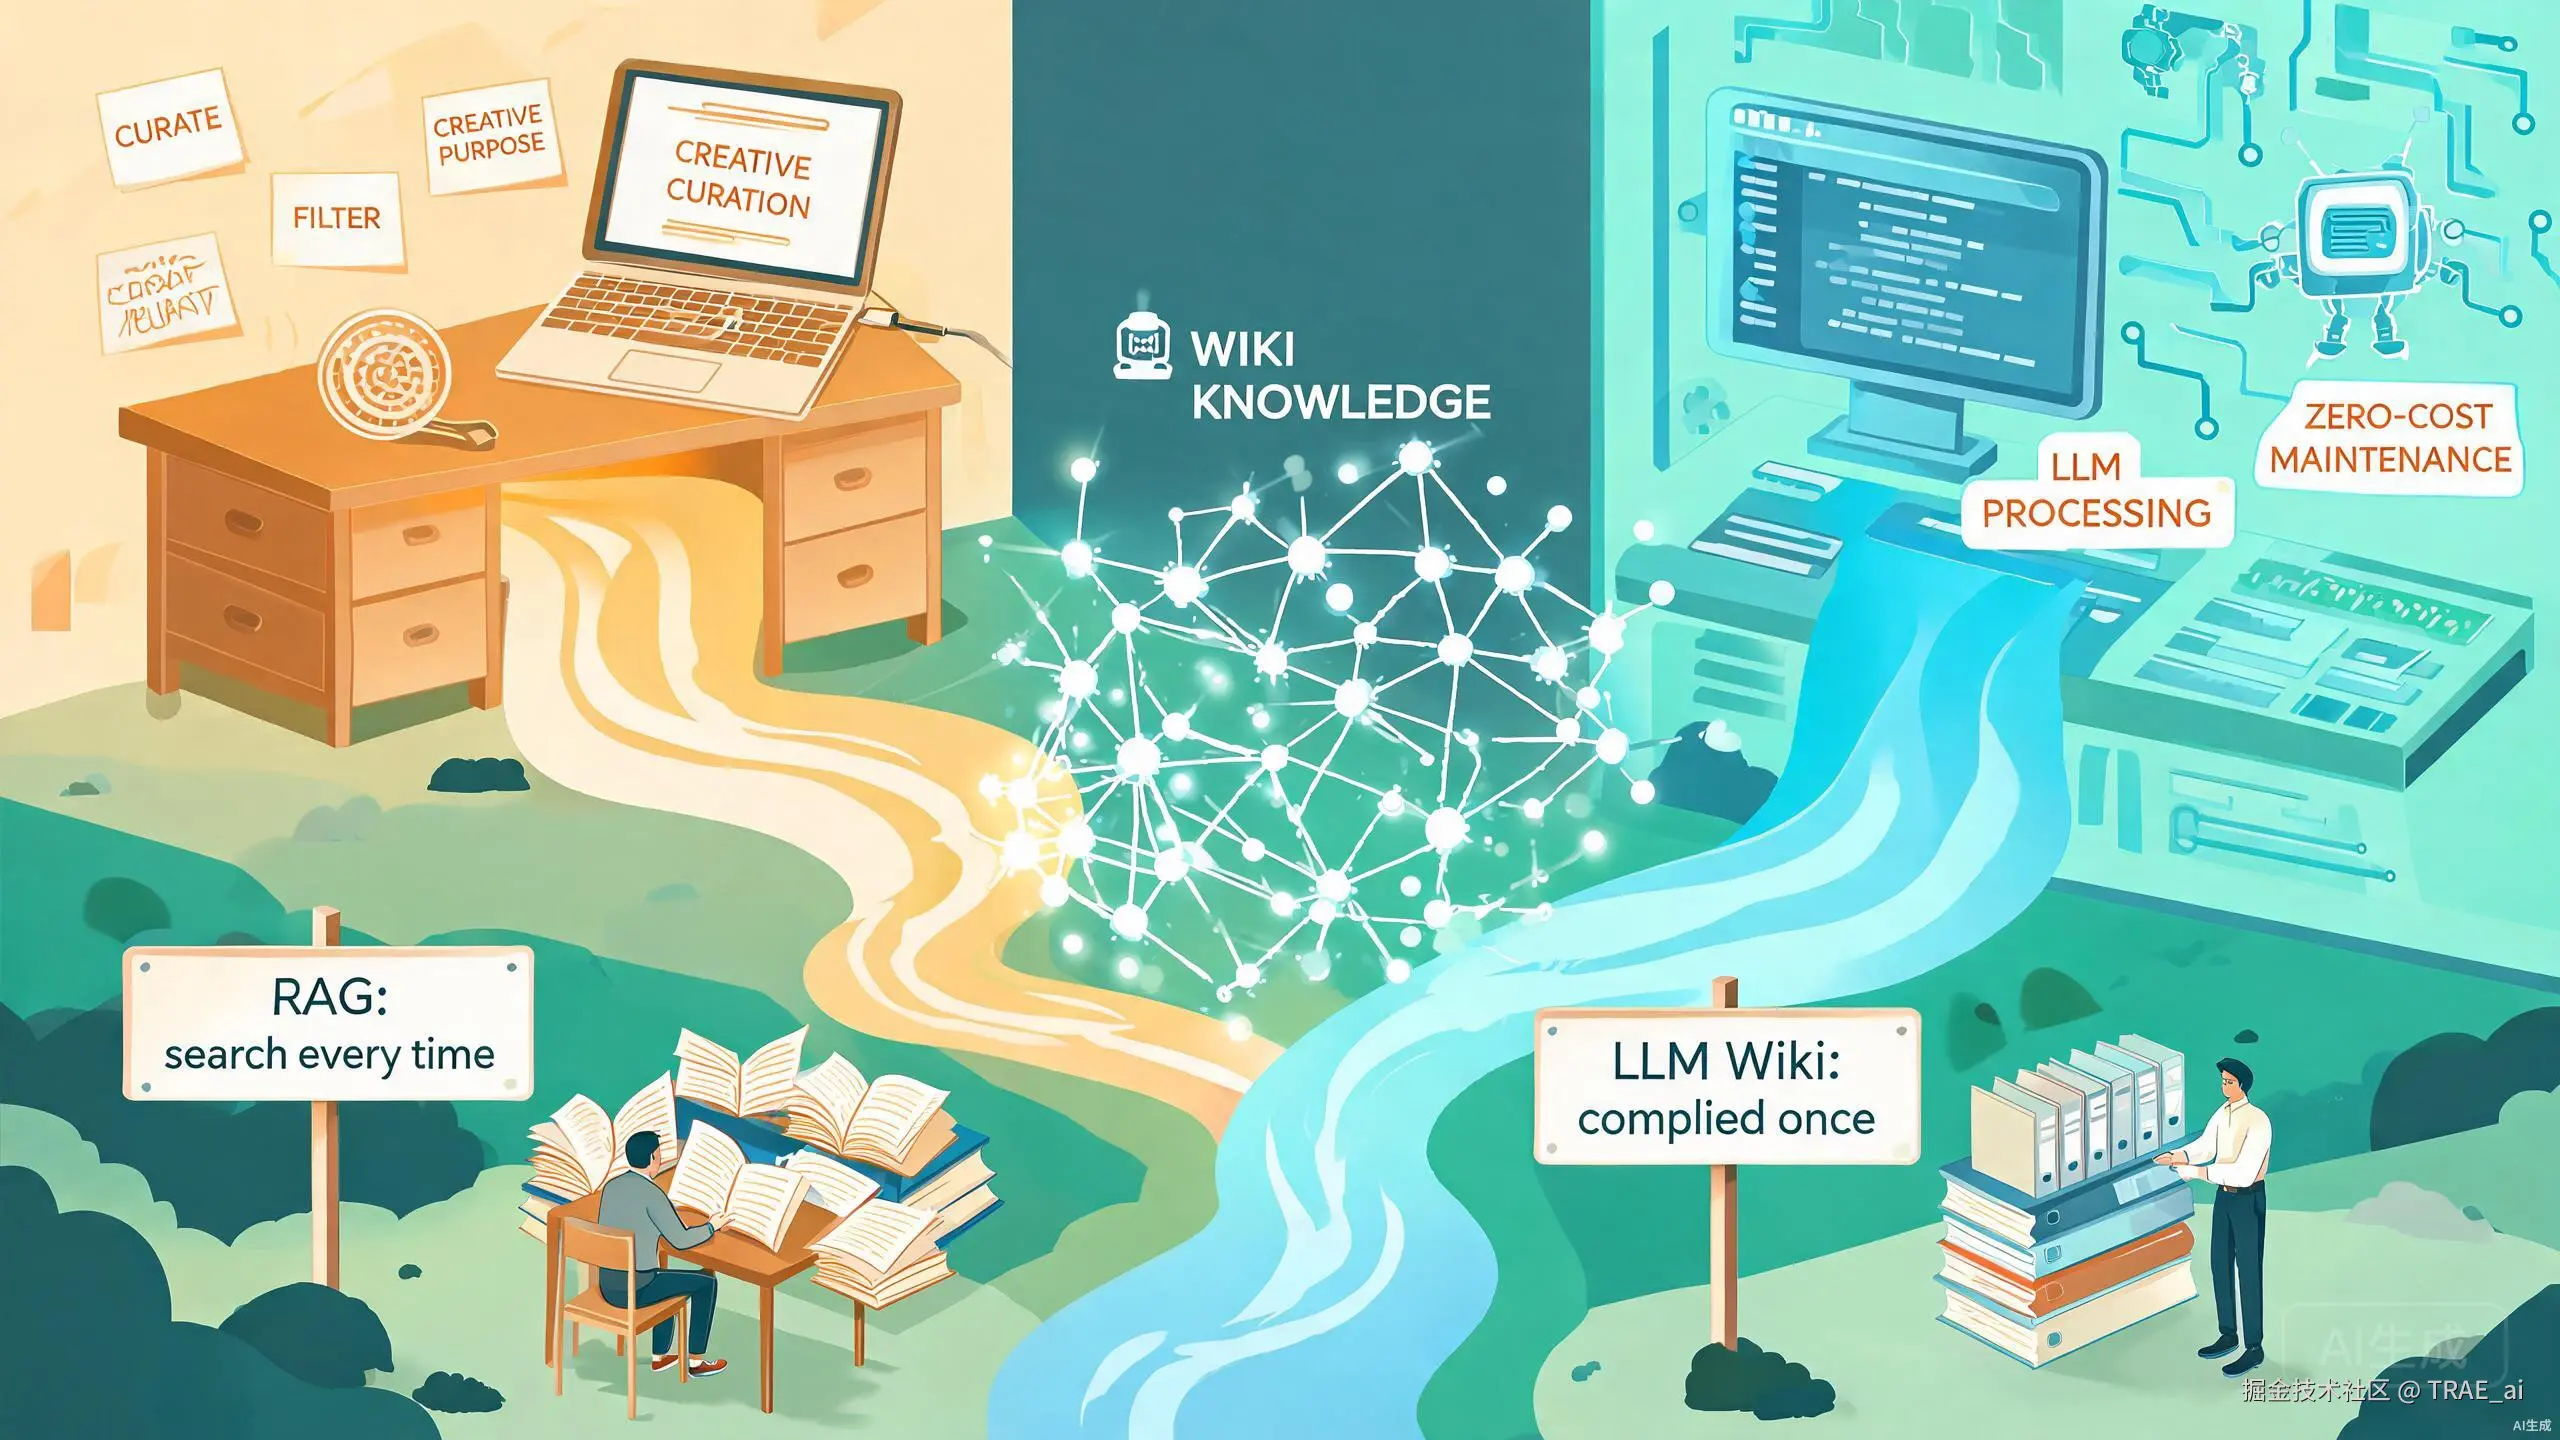
RAG 的工作方式是:你上传文件,每次提问时 LLM 从原始文档检索相关片段,拼接后生成答案。问题在于,知识不积累。每次提问都从零开始重新检索和拼凑,上一次查询的综合分析不会留存到下一次。问一个需要综合五篇文档的问题,LLM 每次都要重新找、重新拼。
LLM Wiki 的方式根本不同:在提取时编译,而非查询时检索。当你放入一篇新文章,LLM 不是索引它等以后检索,而是立即阅读、提取要点、写入摘要页、更新相关实体和概念页、建立交叉引用。知识被「编译」成结构化的 Wiki 一次,然后持续保持更新。
用一个比喻:RAG 像是每次考试都翻书找答案,LLM Wiki 像是提前把书读透、整理成笔记,考试时直接用笔记。前者每次重复劳动,后者一次编译、持续复用。
这就是为什么 Karpathy 的一条推文能引爆社区,它不只是另一个 AI 工具技巧,而是回答了一个 80 年的问题:谁来维护知识库?答案终于不再是「你」。
三、用 TraeCode 从零搭建
3.1 初始化系统
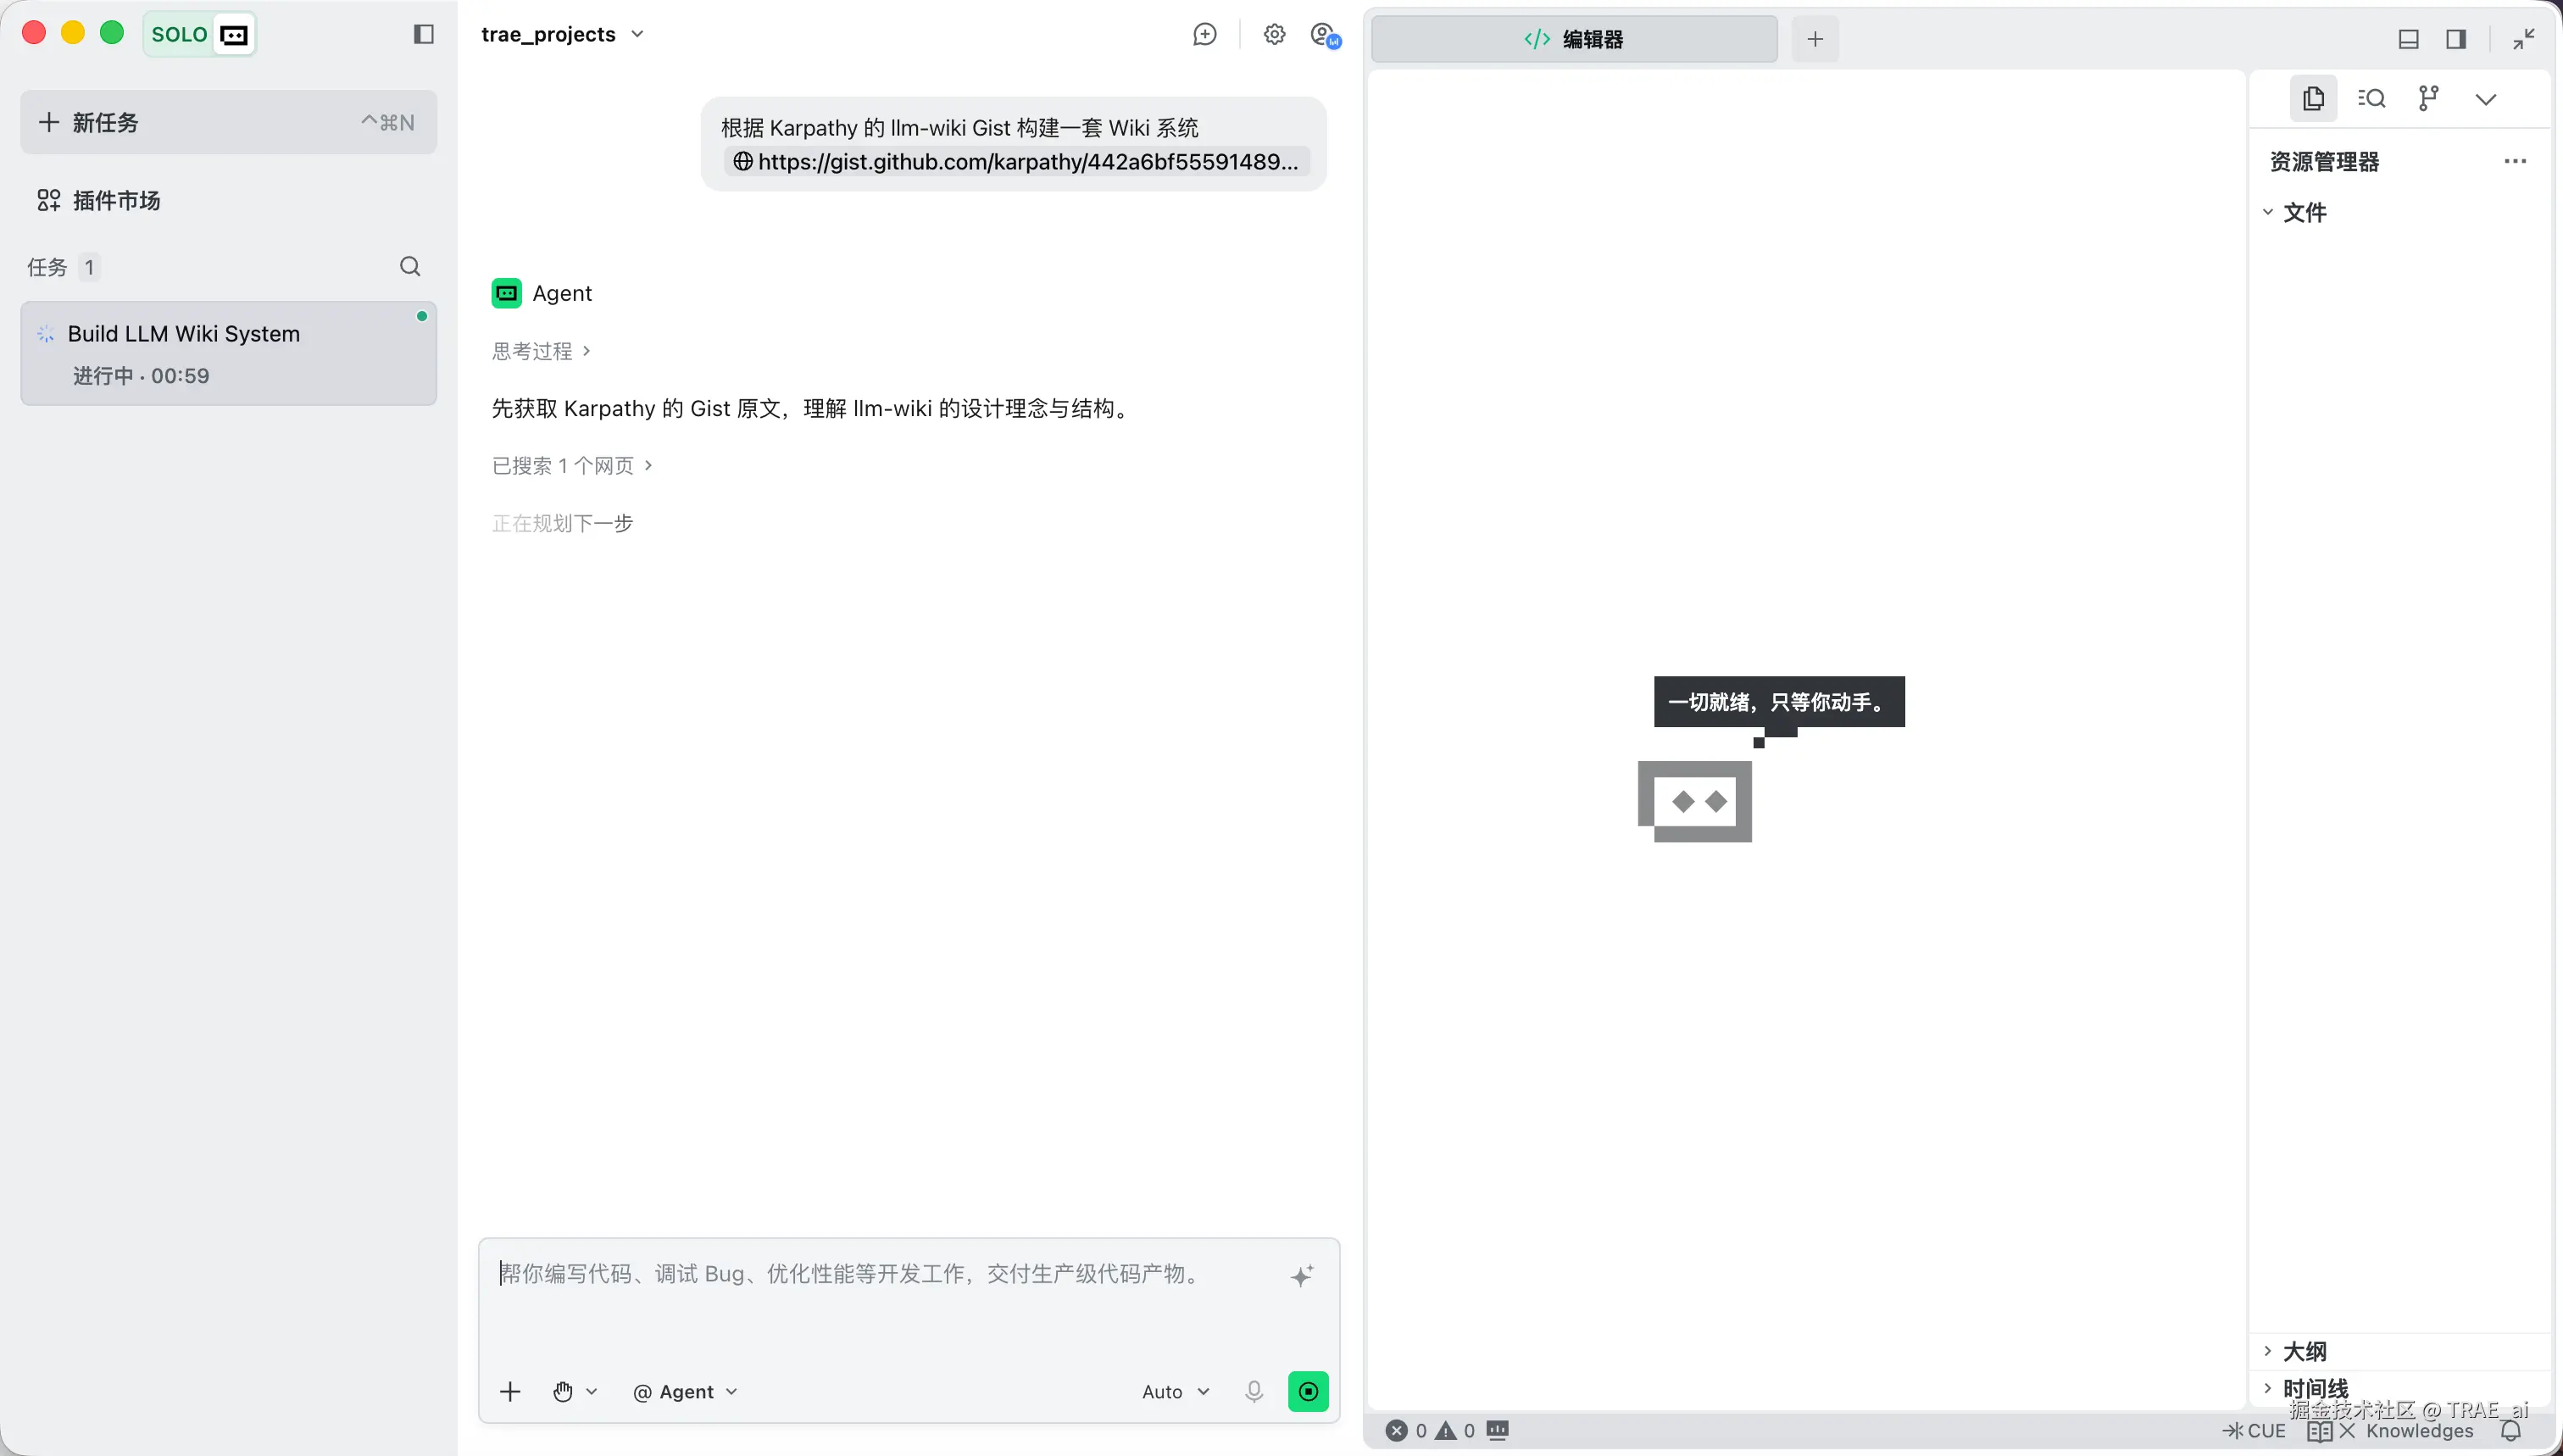
搭建的第一步是创建目录结构和模式文件。在 TRAE Code 中,只需要告诉 Agent:
arduino
根据 Karpathy 的 llm-wiki Gist 构建一套 Wiki 系统
https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
Agent 就会自动完成所有初始化工作。
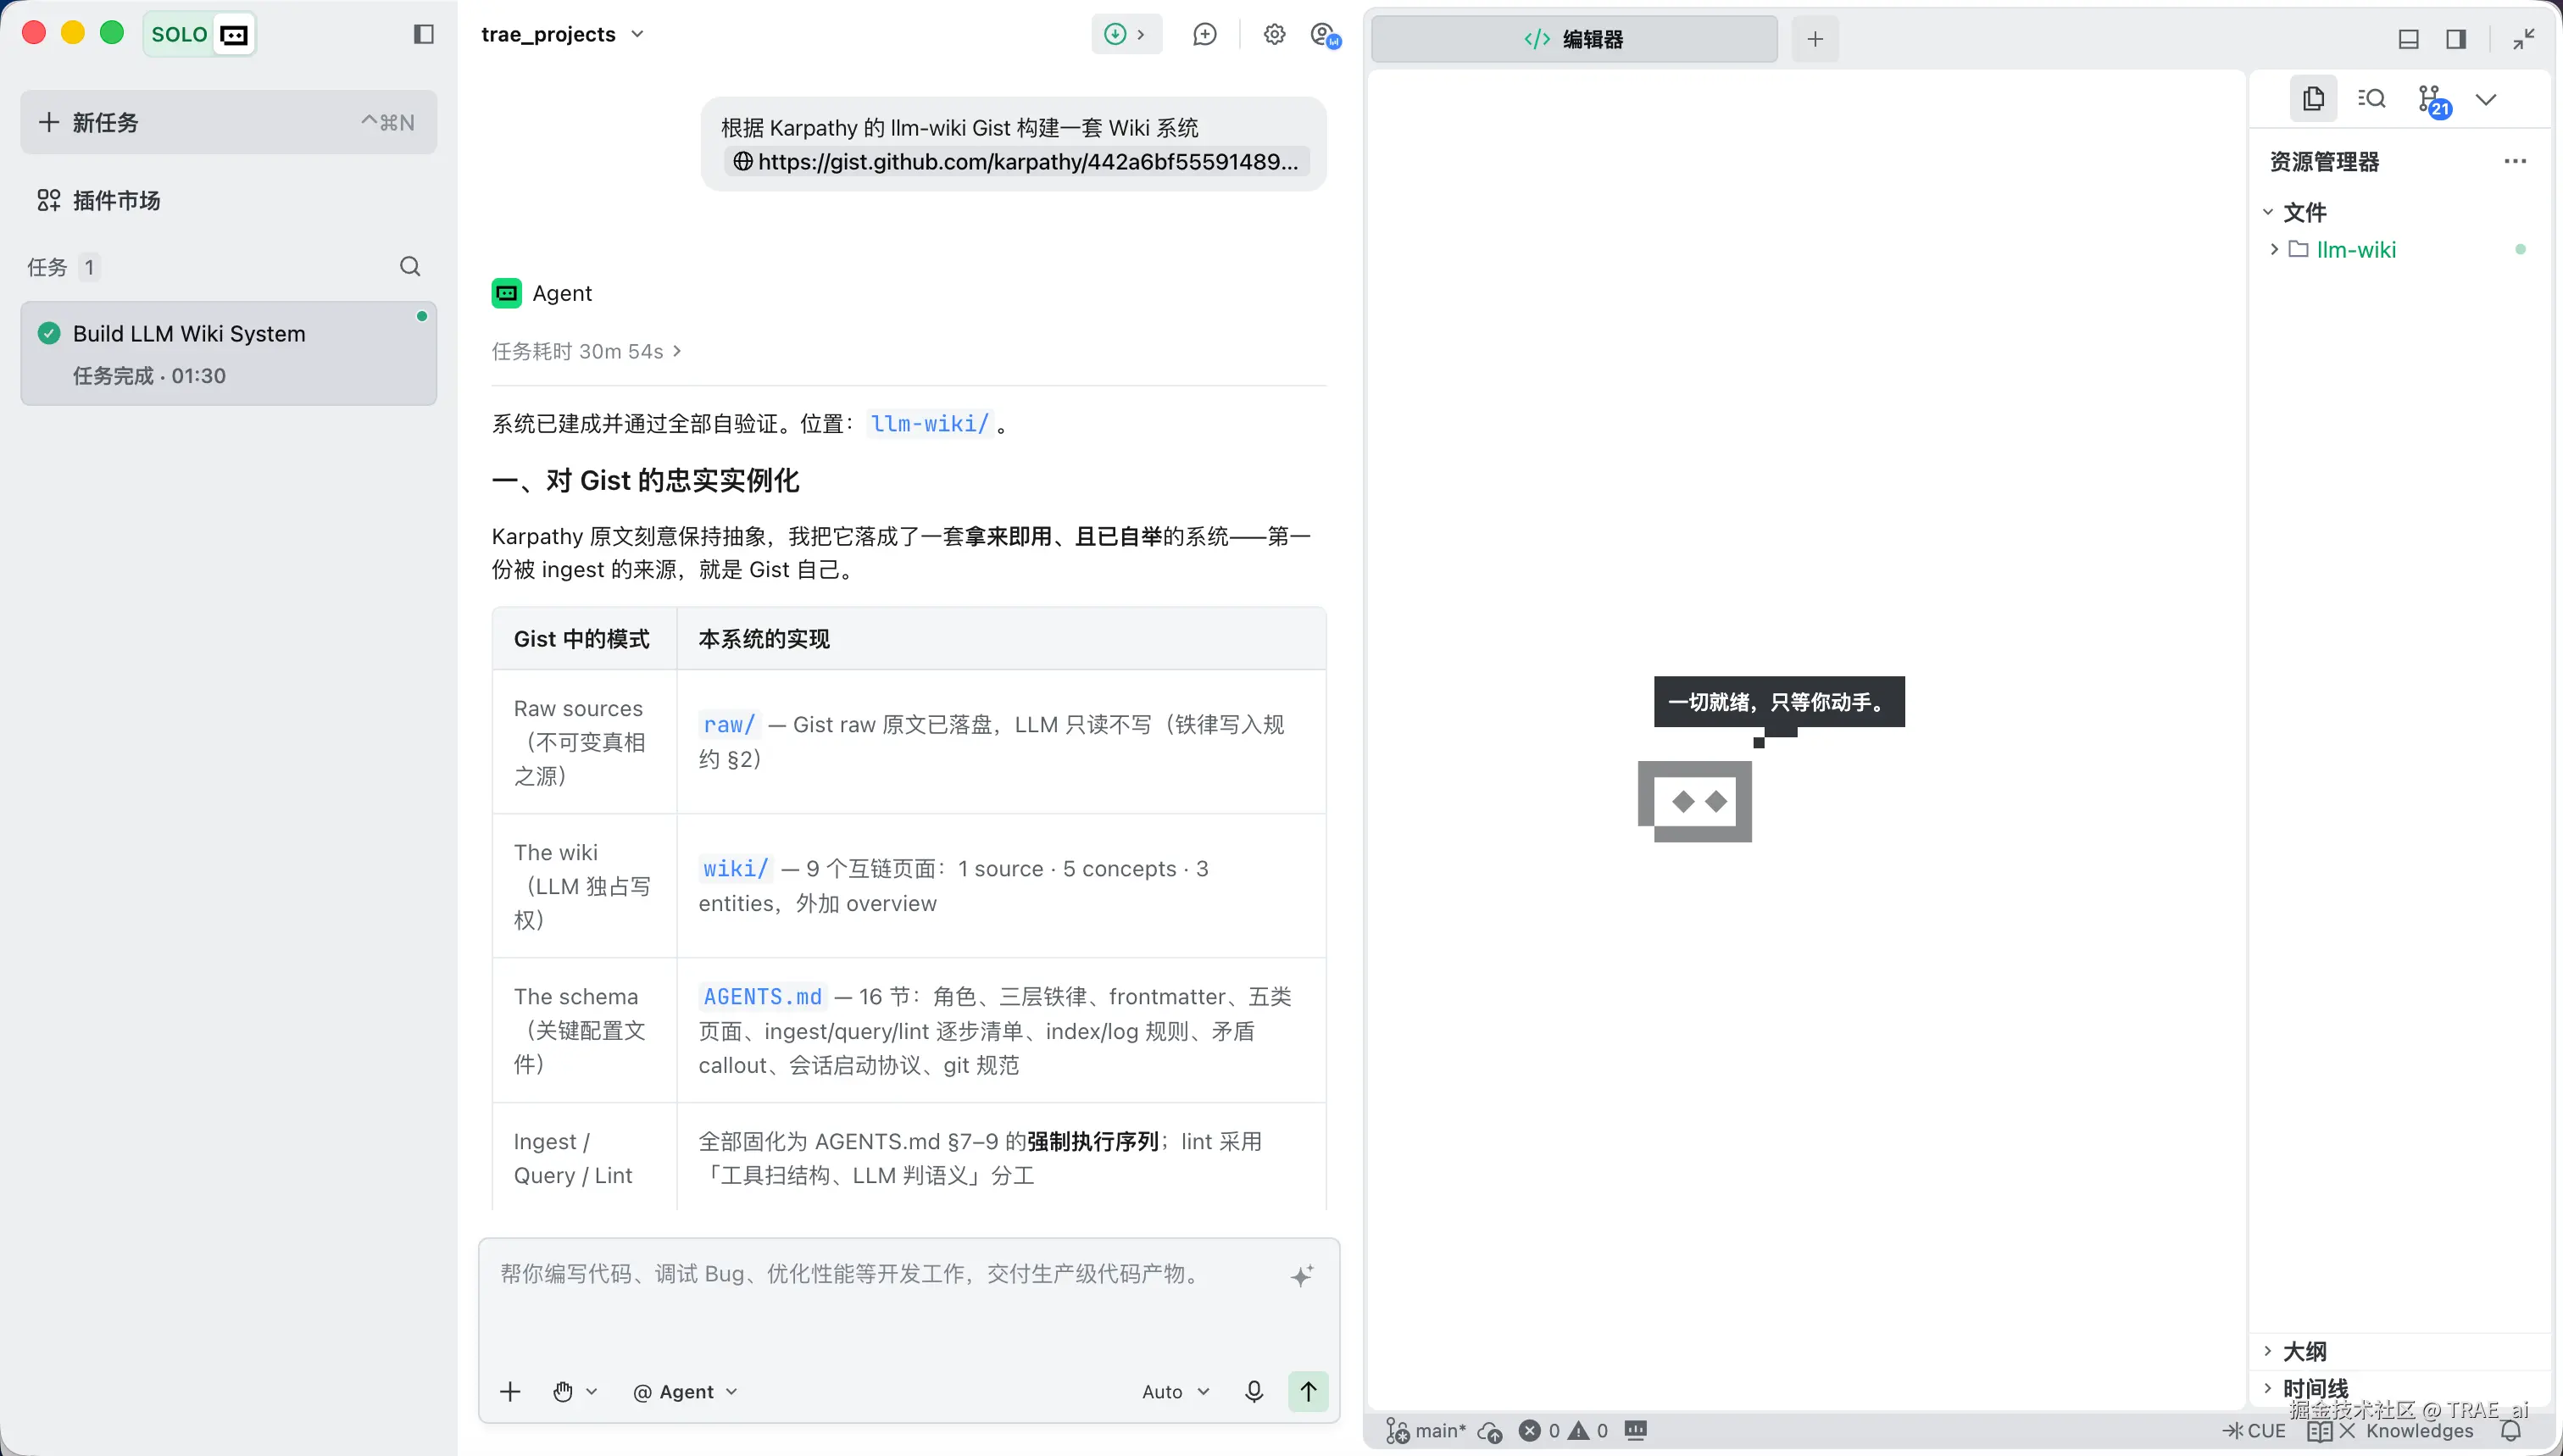
在深入细节之前,有一点需要先说明:下面展示的目录结构、模式文件、页面格式都是实现细节,你不需要记住它们。
作为用户,你只需要做三件事:提供素材、提问、偶尔要求巡检。
至于素材怎么拆解、页面怎么组织、交叉引用怎么建立,都是 LLM 的工作,使用 LLM Wiki 不需要懂它的内部结构。如果你对这些细节不感兴趣,可以直接跳到下一节看实际效果。
如果你好奇背后发生了什么,下面是我利用 TraeCode 生成的结果:
目录结构
系统采用三层架构,目录结构如下:
bash
Wiki/
├── AGENTS.md          # 模式文件(LLM 操作手册)
├── README.md          # 快速入门指南
├── index.md           # 内容目录
├── log.md             # 活动日志
├── browser.py         # Wiki 浏览器服务器(零依赖)
├── raw/               # 原始素材(不可变)
│   └── assets/        # 图片附件
├── wiki/              # LLM 生成的知识页面
│   ├── entities/      # 实体页(人、组织、产品)
│   ├── concepts/      # 概念页(理论、方法)
│   ├── sources/       # 素材摘要页
│   ├── syntheses/     # 综合分析页
│   └── projects/      # 项目页
└── templates/         # 页面模板
AGENTS.md 是整个系统的核心,它是给 LLM 的操作手册,告诉 LLM 系统如何组织、遵循什么约定、执行什么工作流。在 TraeCode 中,项目根目录的 AGENTS.md 会被自动识别为项目规则文件(Project Rule),每次会话开始时 LLM 都会自动读取它。
模式文件包含以下关键部分:
-
系统概述:核心理念(持久化积累 vs RAG 的即时检索)和角色分工(人类把关,LLM 维护)
-
三层架构定义:raw/(不可变素材)、wiki/(LLM 维护的知识网络)、模式文件(AGENTS.md + index.md + log.md)
-
页面格式规范:YAML frontmatter(title, type, created, updated, sources, tags, status)+ 正文结构模板
-
交叉引用约定 :
[[page-name]]格式的 Wiki 链接,按文件名模糊匹配 -
三大工作流:提取(Ingest)、查询(Query)、巡检(Lint)的详细步骤
-
项目工作流:项目作为知识库的消费者和生产者,形成闭环
-
命名约定:kebab-case 命名规则,各类型页面的目录分配
为什么 AGENTS.md 是关键? 因为没有它,LLM 只是一个通用聊天机器人;有了它,LLM 变成一个纪律严明的 Wiki 维护者,知道页面该放哪里、frontmatter 该填什么、提取时要更新哪些交叉引用。在 TraeCode 中,这个文件会被自动注入到每次对话的上下文里,确保跨会话的一致性。
3.2 提取第一个素材
系统初始化后,第一个操作就是将 Karpathy 的 Gist 本身作为素材进行提取,这既是验证系统可用性,也是为 Wiki 填充第一块知识基石。
提取过程
在 TraeCode 中,只需要对 Agent 说:
arduino
录入到系统中并开始提取 https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f 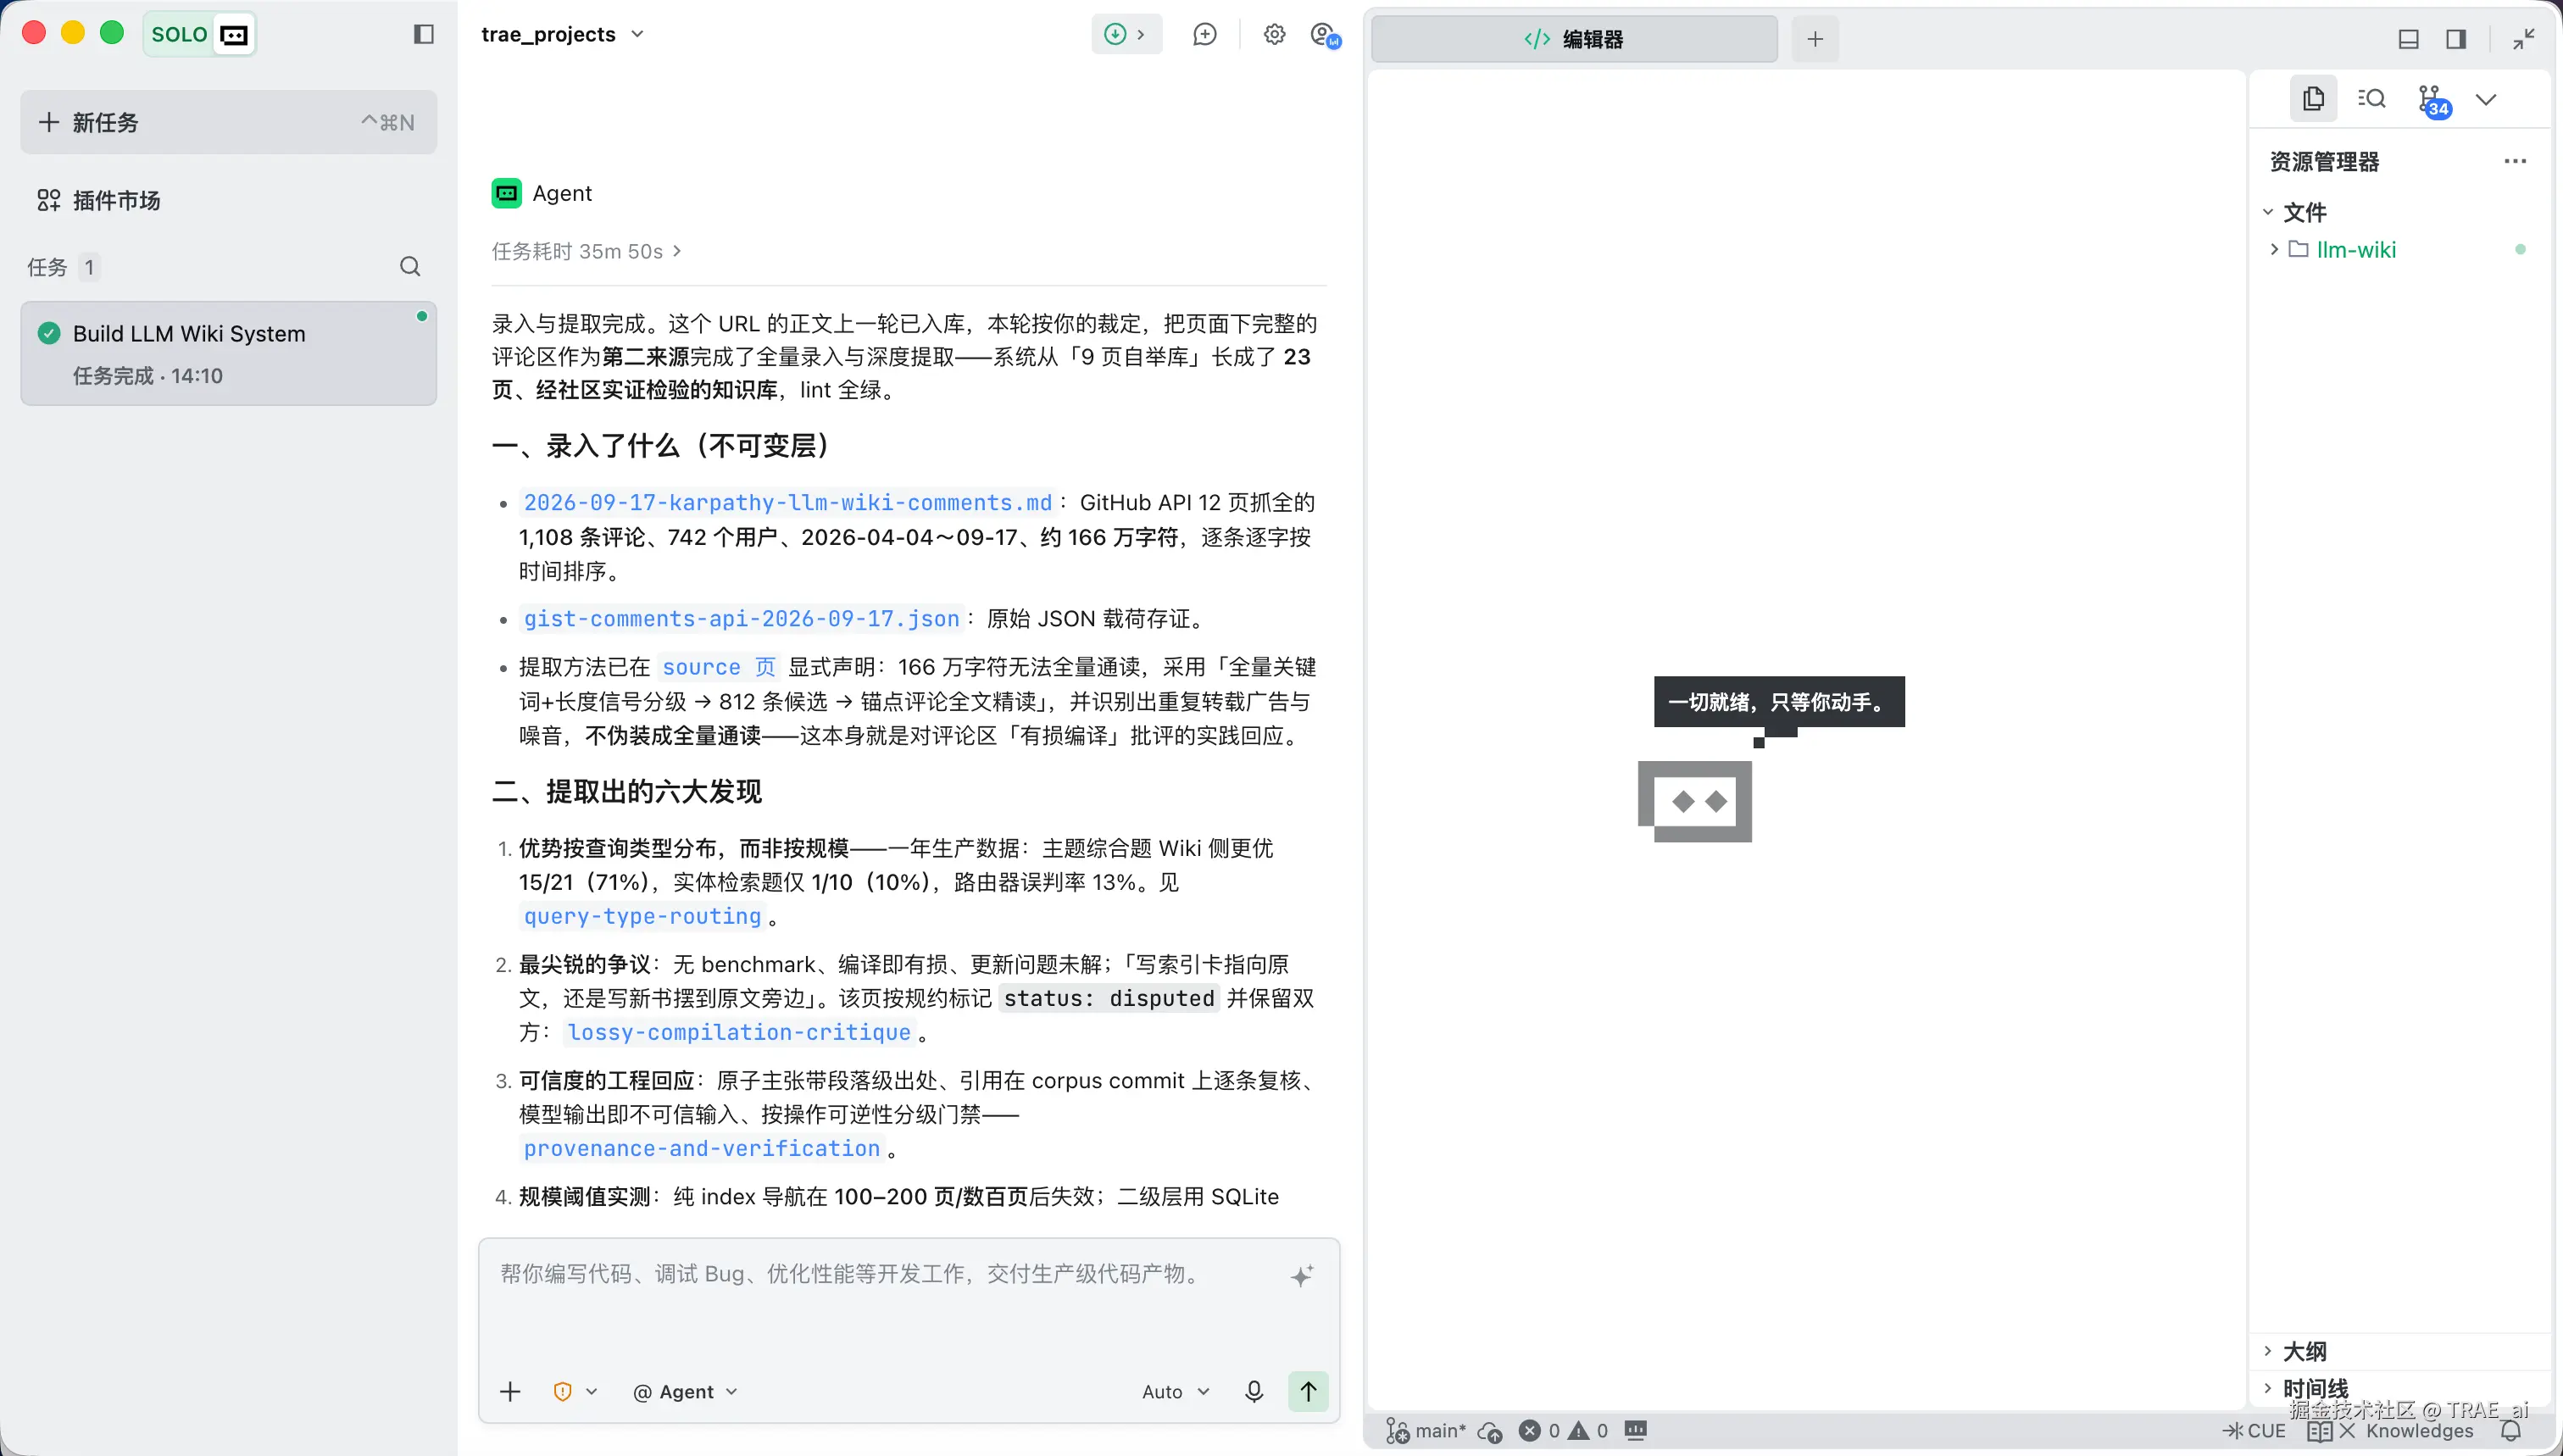
TraeWork Agent 会自动执行完整的提取工作流:
-
获取素材 :通过 WebFetch 获取 Gist 原文,保存为
raw/karpathy-llm-wiki-gist.md -
阅读理解:完整阅读素材内容,提取核心论点、关键要点
-
创建素材摘要页 :在
wiki/sources/karpathy-llm-wiki-gist.md创建结构化摘要,包含元信息、核心论点、关键要点、详细笔记、涉及实体与概念、关键引文 -
抽取实体:识别素材中的重要实体(人物、工具),创建实体页
-
抽取概念:识别素材中的重要概念(理论、方法),创建概念页
-
建立交叉引用 :在所有新页面之间添加
[[wikilink]]链接
一个素材变成了什么呢?
一篇 Gist 文章,经过提取后变成了 6 个相互链接的 Wiki 页面:
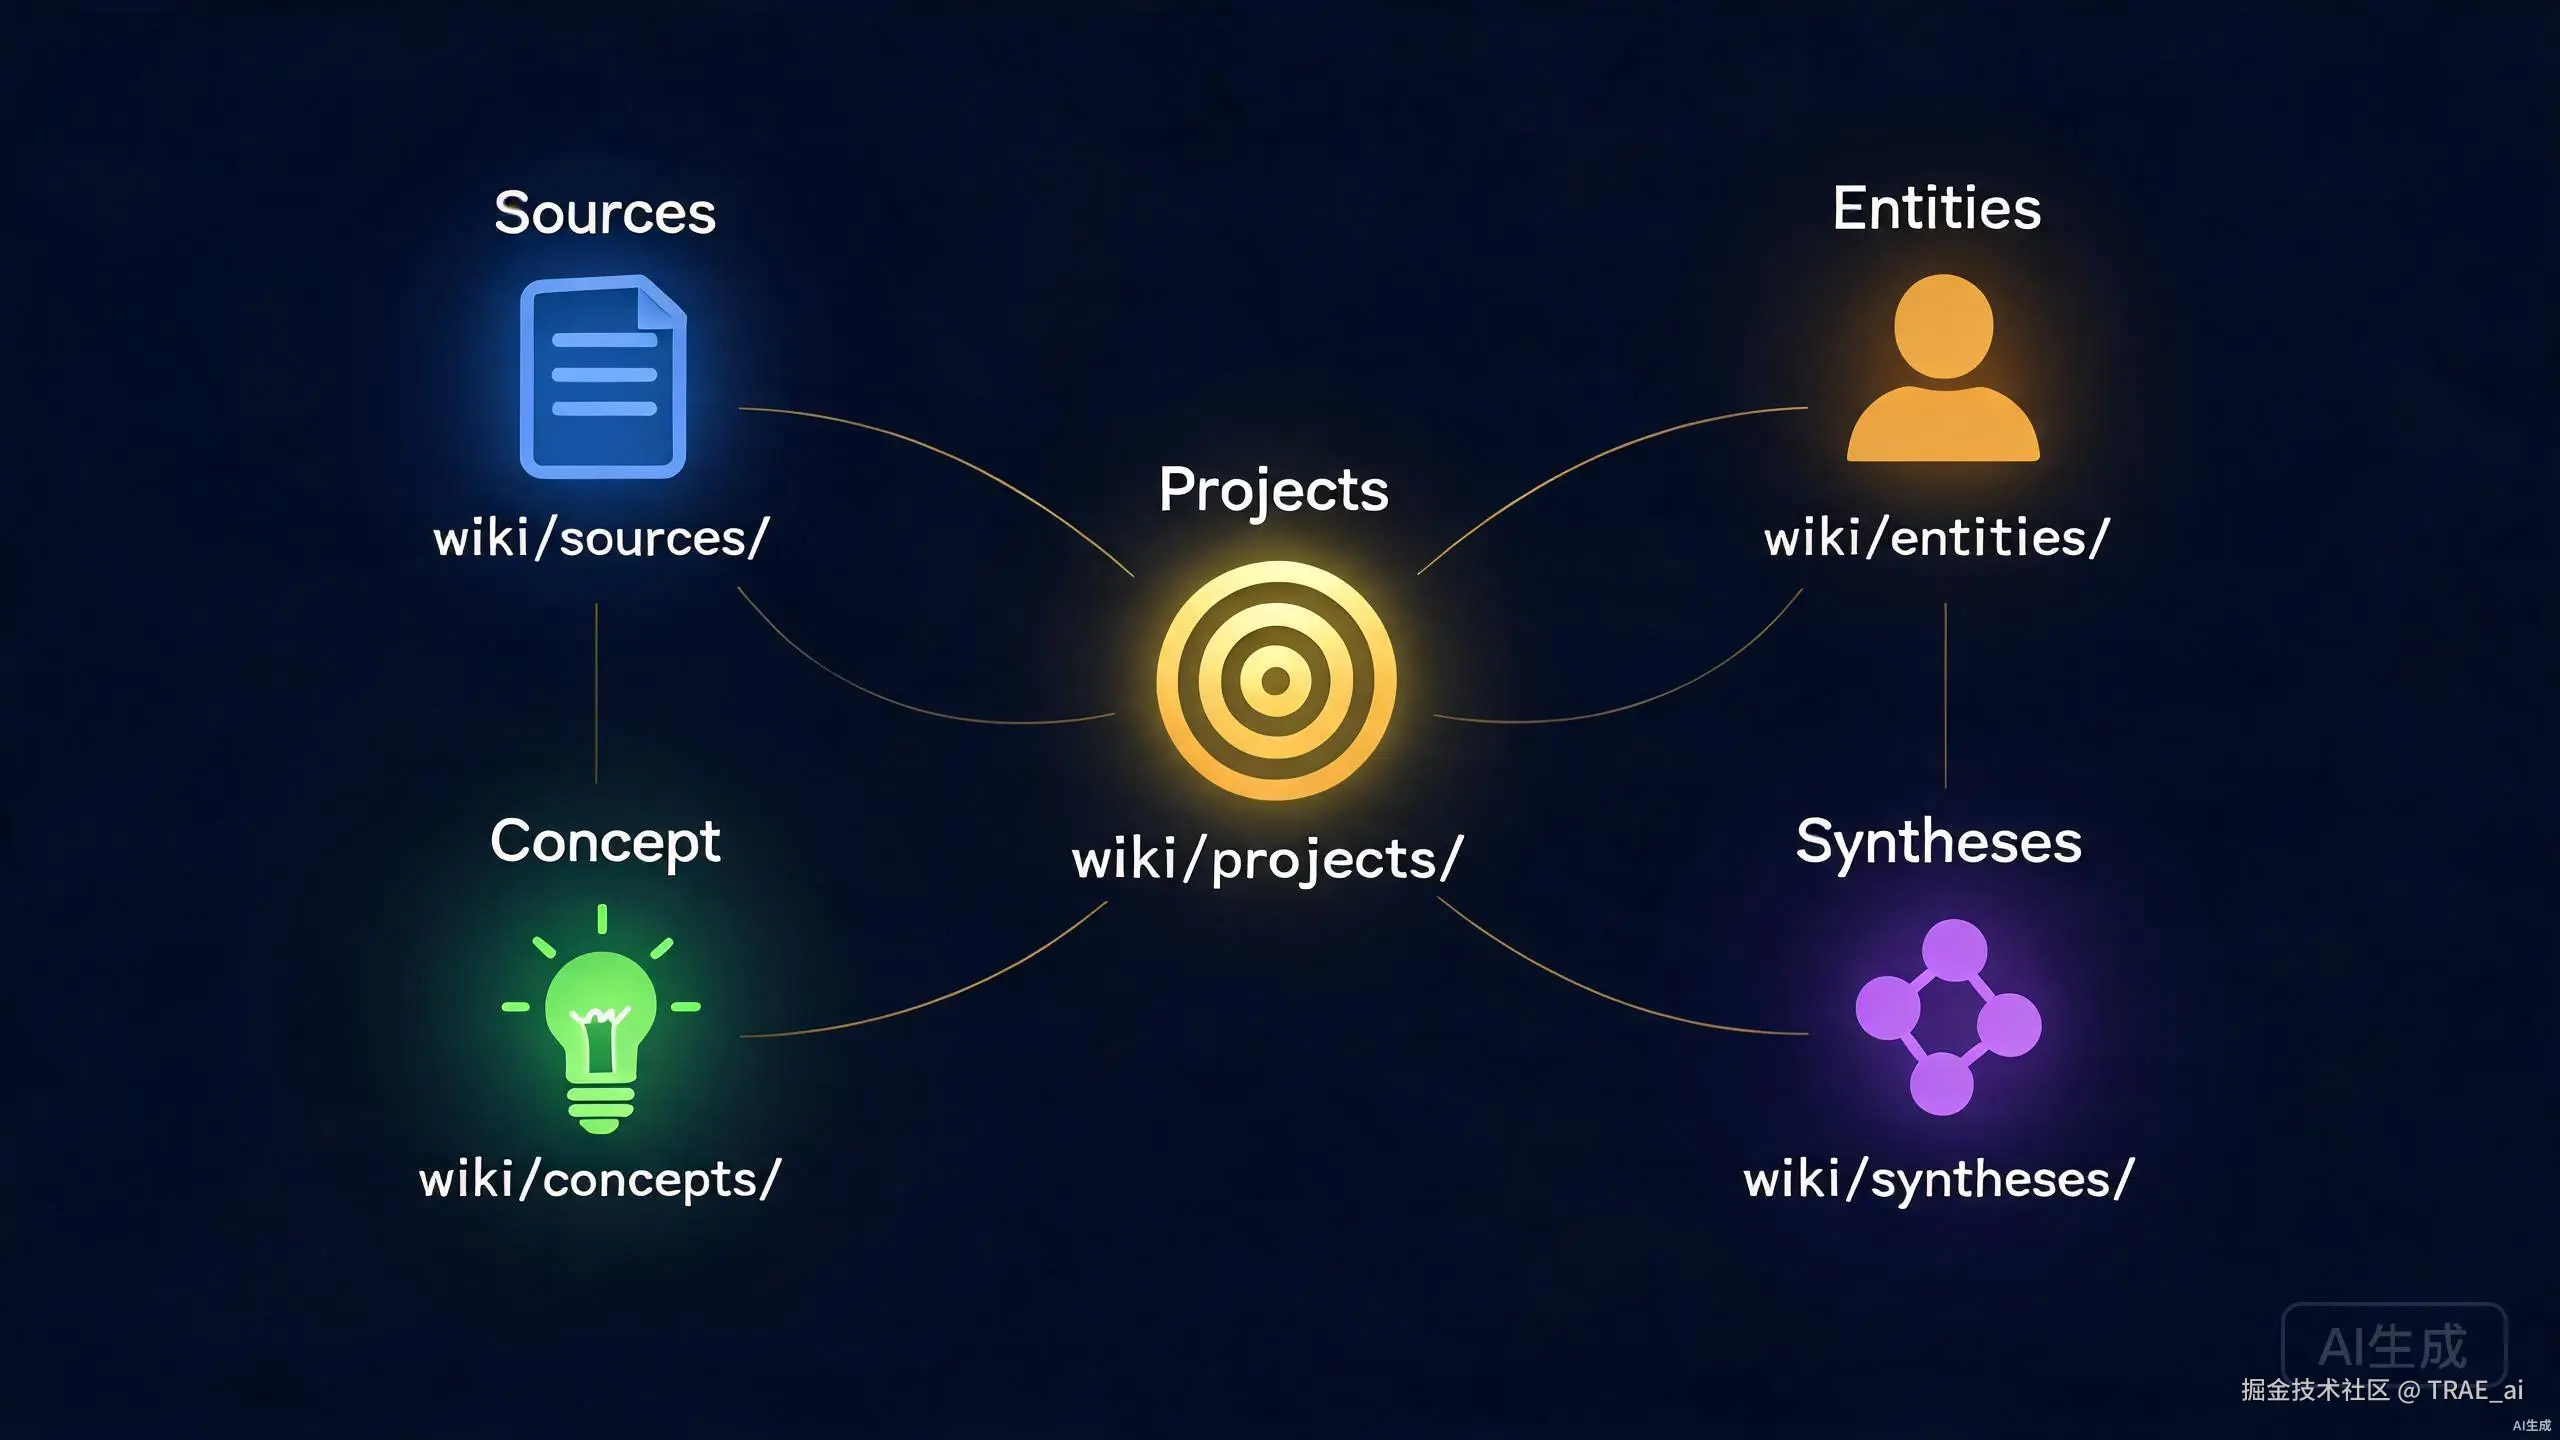
这 6 个页面之间形成了密集的交叉引用网络:
-
素材摘要页引用了所有 5 个实体/概念页
-
每个概念页都反向引用素材摘要页
-
实体页之间也相互关联(如 Karpathy 与 Obsidian 的关系)
关键观察:一个素材 → 6 个 Wiki 页面,这正是 Karpathy 所说的「一个素材可能涉及 10-15 个 Wiki 页面」。而且这一切都是 LLM 自动完成的,人类只需提供素材,LLM 负责所有的阅读、提取、结构化和交叉引用工作。
3.3 交叉引用:知识网络的生长
提取过程中最关键的步骤不是创建单个页面,而是建立页面之间的交叉引用。
[[wikilink]] 是 Wiki 的血管系统,没有它们,页面只是孤岛;有了它们,知识形成网络。
Wiki 链接的工作方式
在 Wiki 页面正文中,任何位置都可以插入 [[page-name]] 格式的链接。LLM 在渲染时会将其转换为可点击的链接,点击后跳转到对应页面。链接解析规则是按文件名(去扩展名)模糊匹配:
-
[[andrej-karpathy]]→wiki/entities/andrej-karpathy.md -
[[llm-wiki-pattern]]→wiki/concepts/llm-wiki-pattern.md -
[[karpathy-llm-wiki-gist]]→wiki/sources/karpathy-llm-wiki-gist.md
随着素材增加,网络如何生长
当第二个素材被提取时,LLM 不只是创建新的摘要页和实体/概念页,它还会检查已有页面,在新页面中添加到已有页面的链接,同时在已有页面中添加到新页面的链接。如果新素材与已有页面内容矛盾,LLM 会在相关页面中标注矛盾。
我们来看一个案例:提取 Dan Koe 的文章如何让网络翻倍
第一个素材(Karpathy Gist)创建了 6 个页面,它们之间形成了一个小网络。当我们来开始提取第二个素材,Dan Koe 在 X 上发布的关于「第二潜意识」的长文时,LLM 执行了完整的提取工作流,同时将新页面与已有网络融合。
你只需对 TraeCode 说:
ruby
将这篇文章作为 markdown 存入系统并开始提取
https://x.com/thedankoe/status/2081415714636996844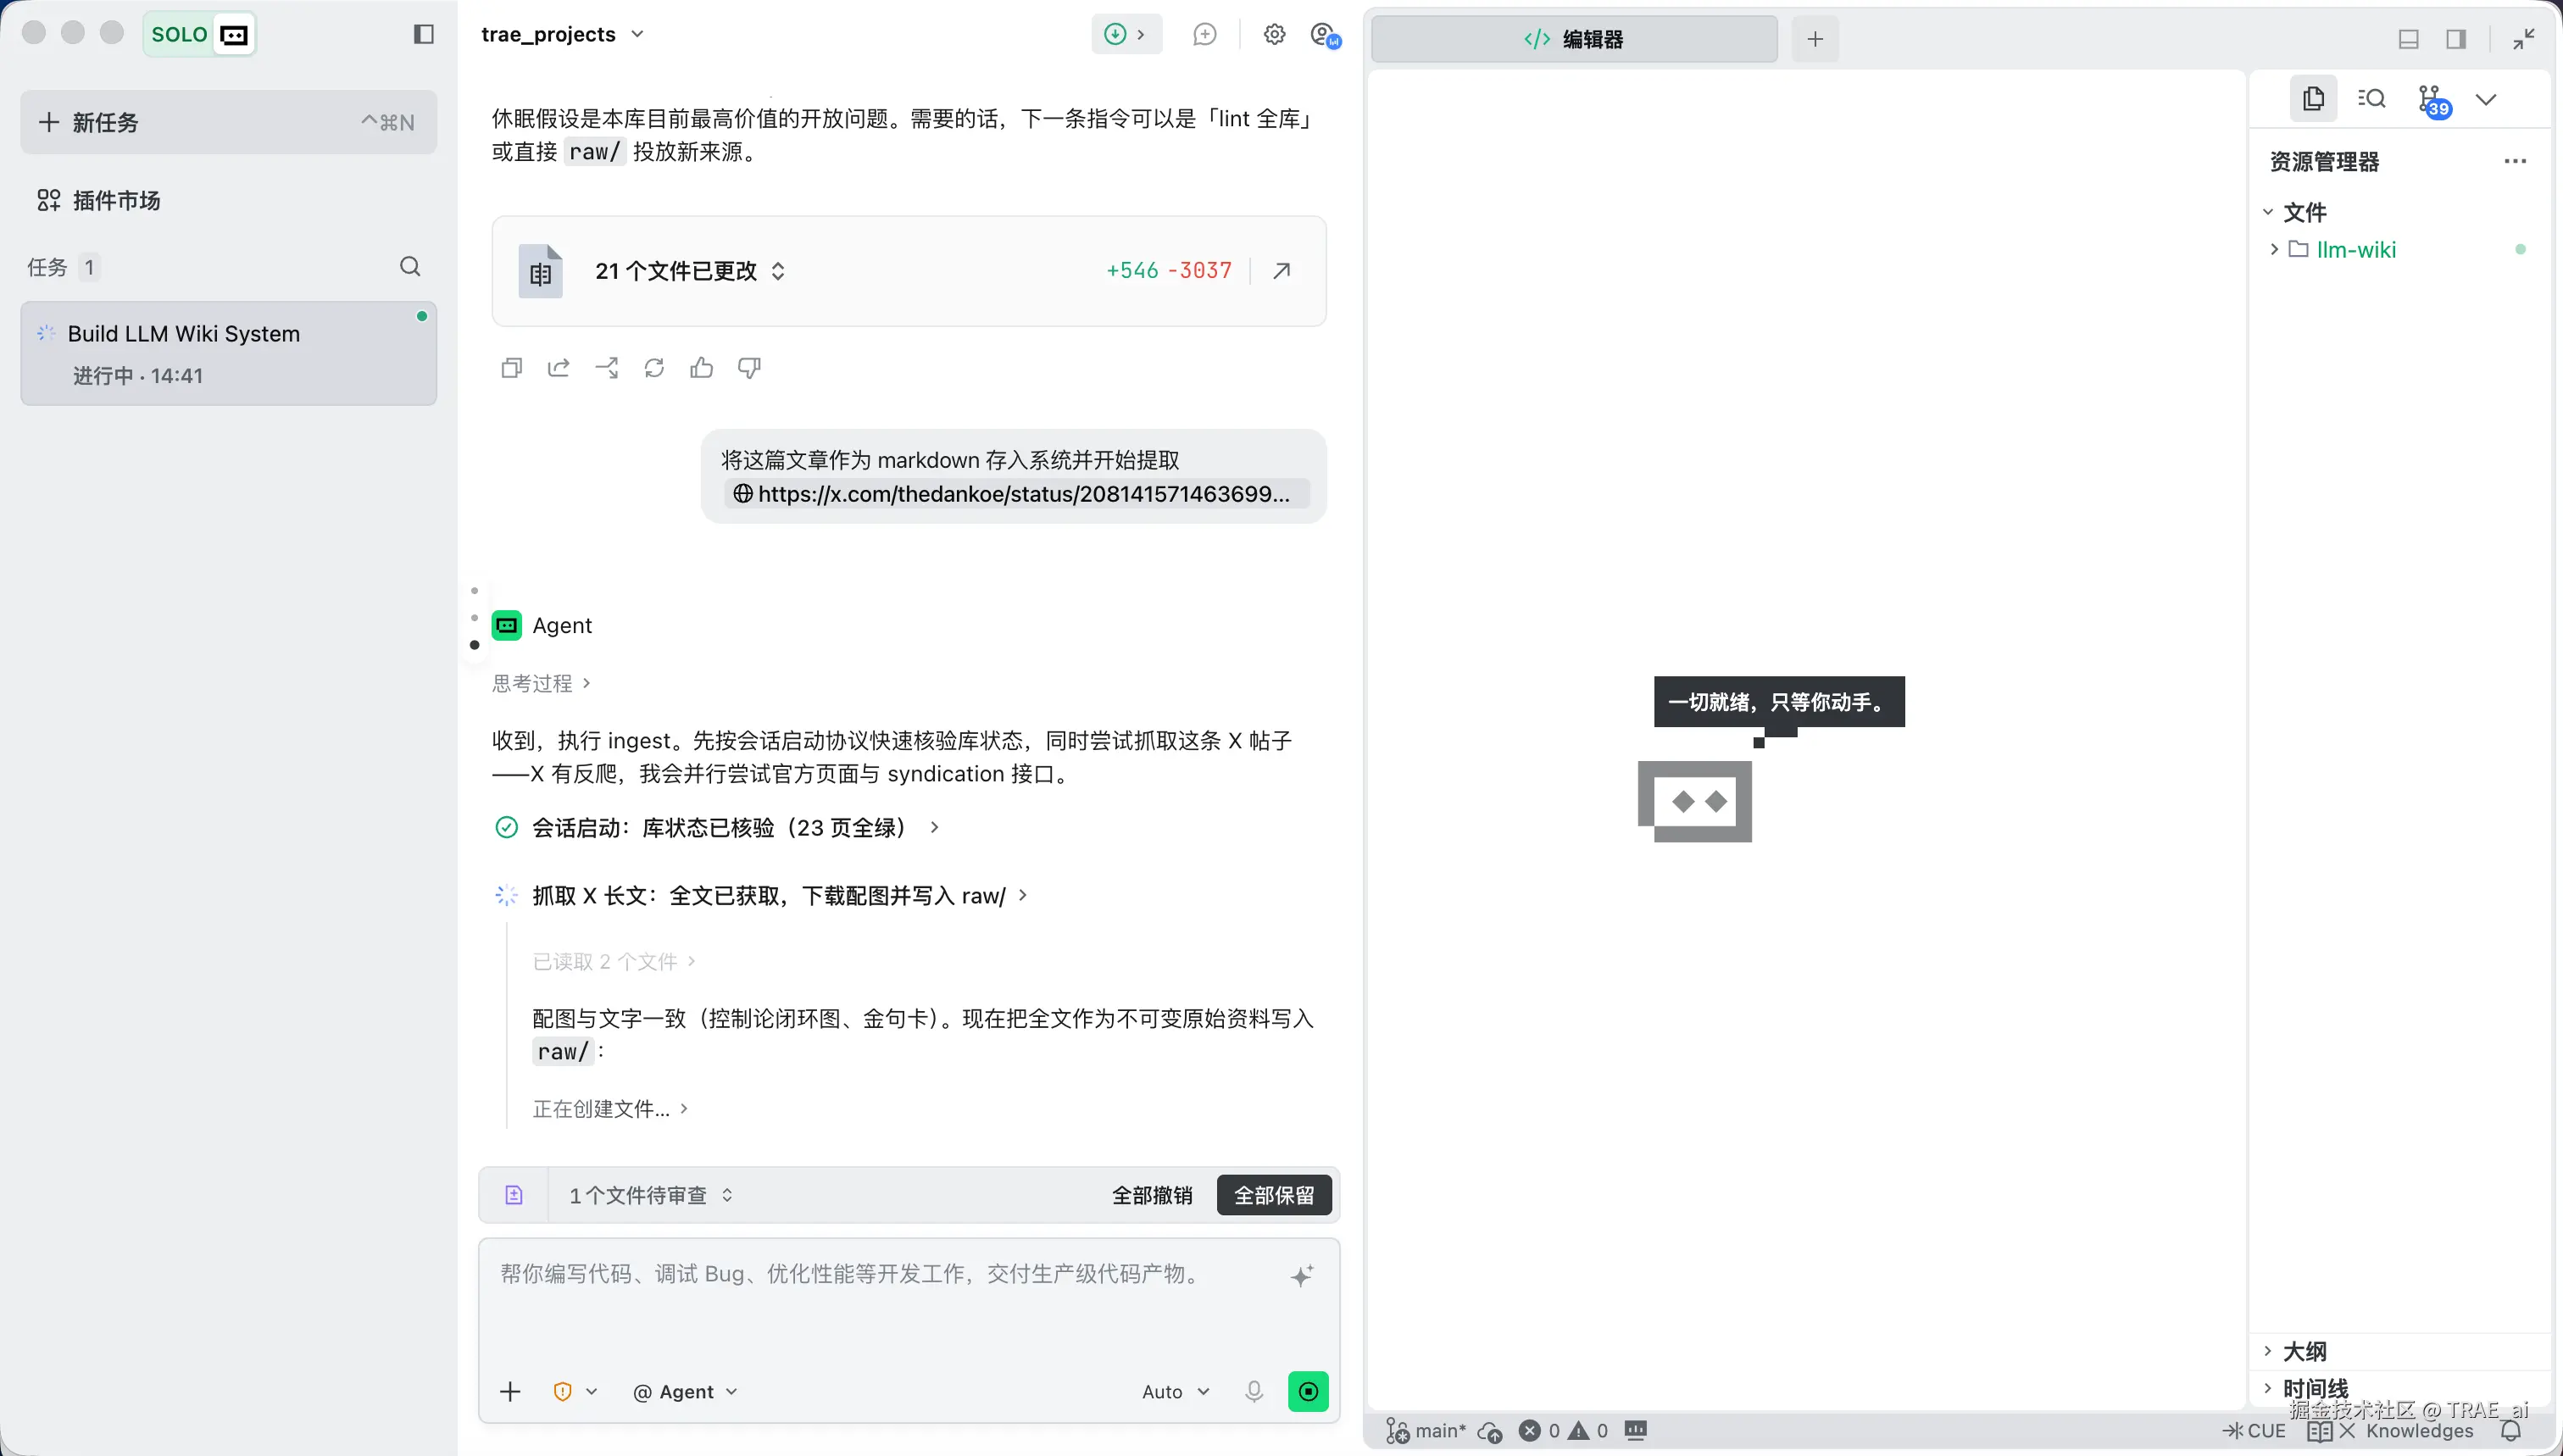
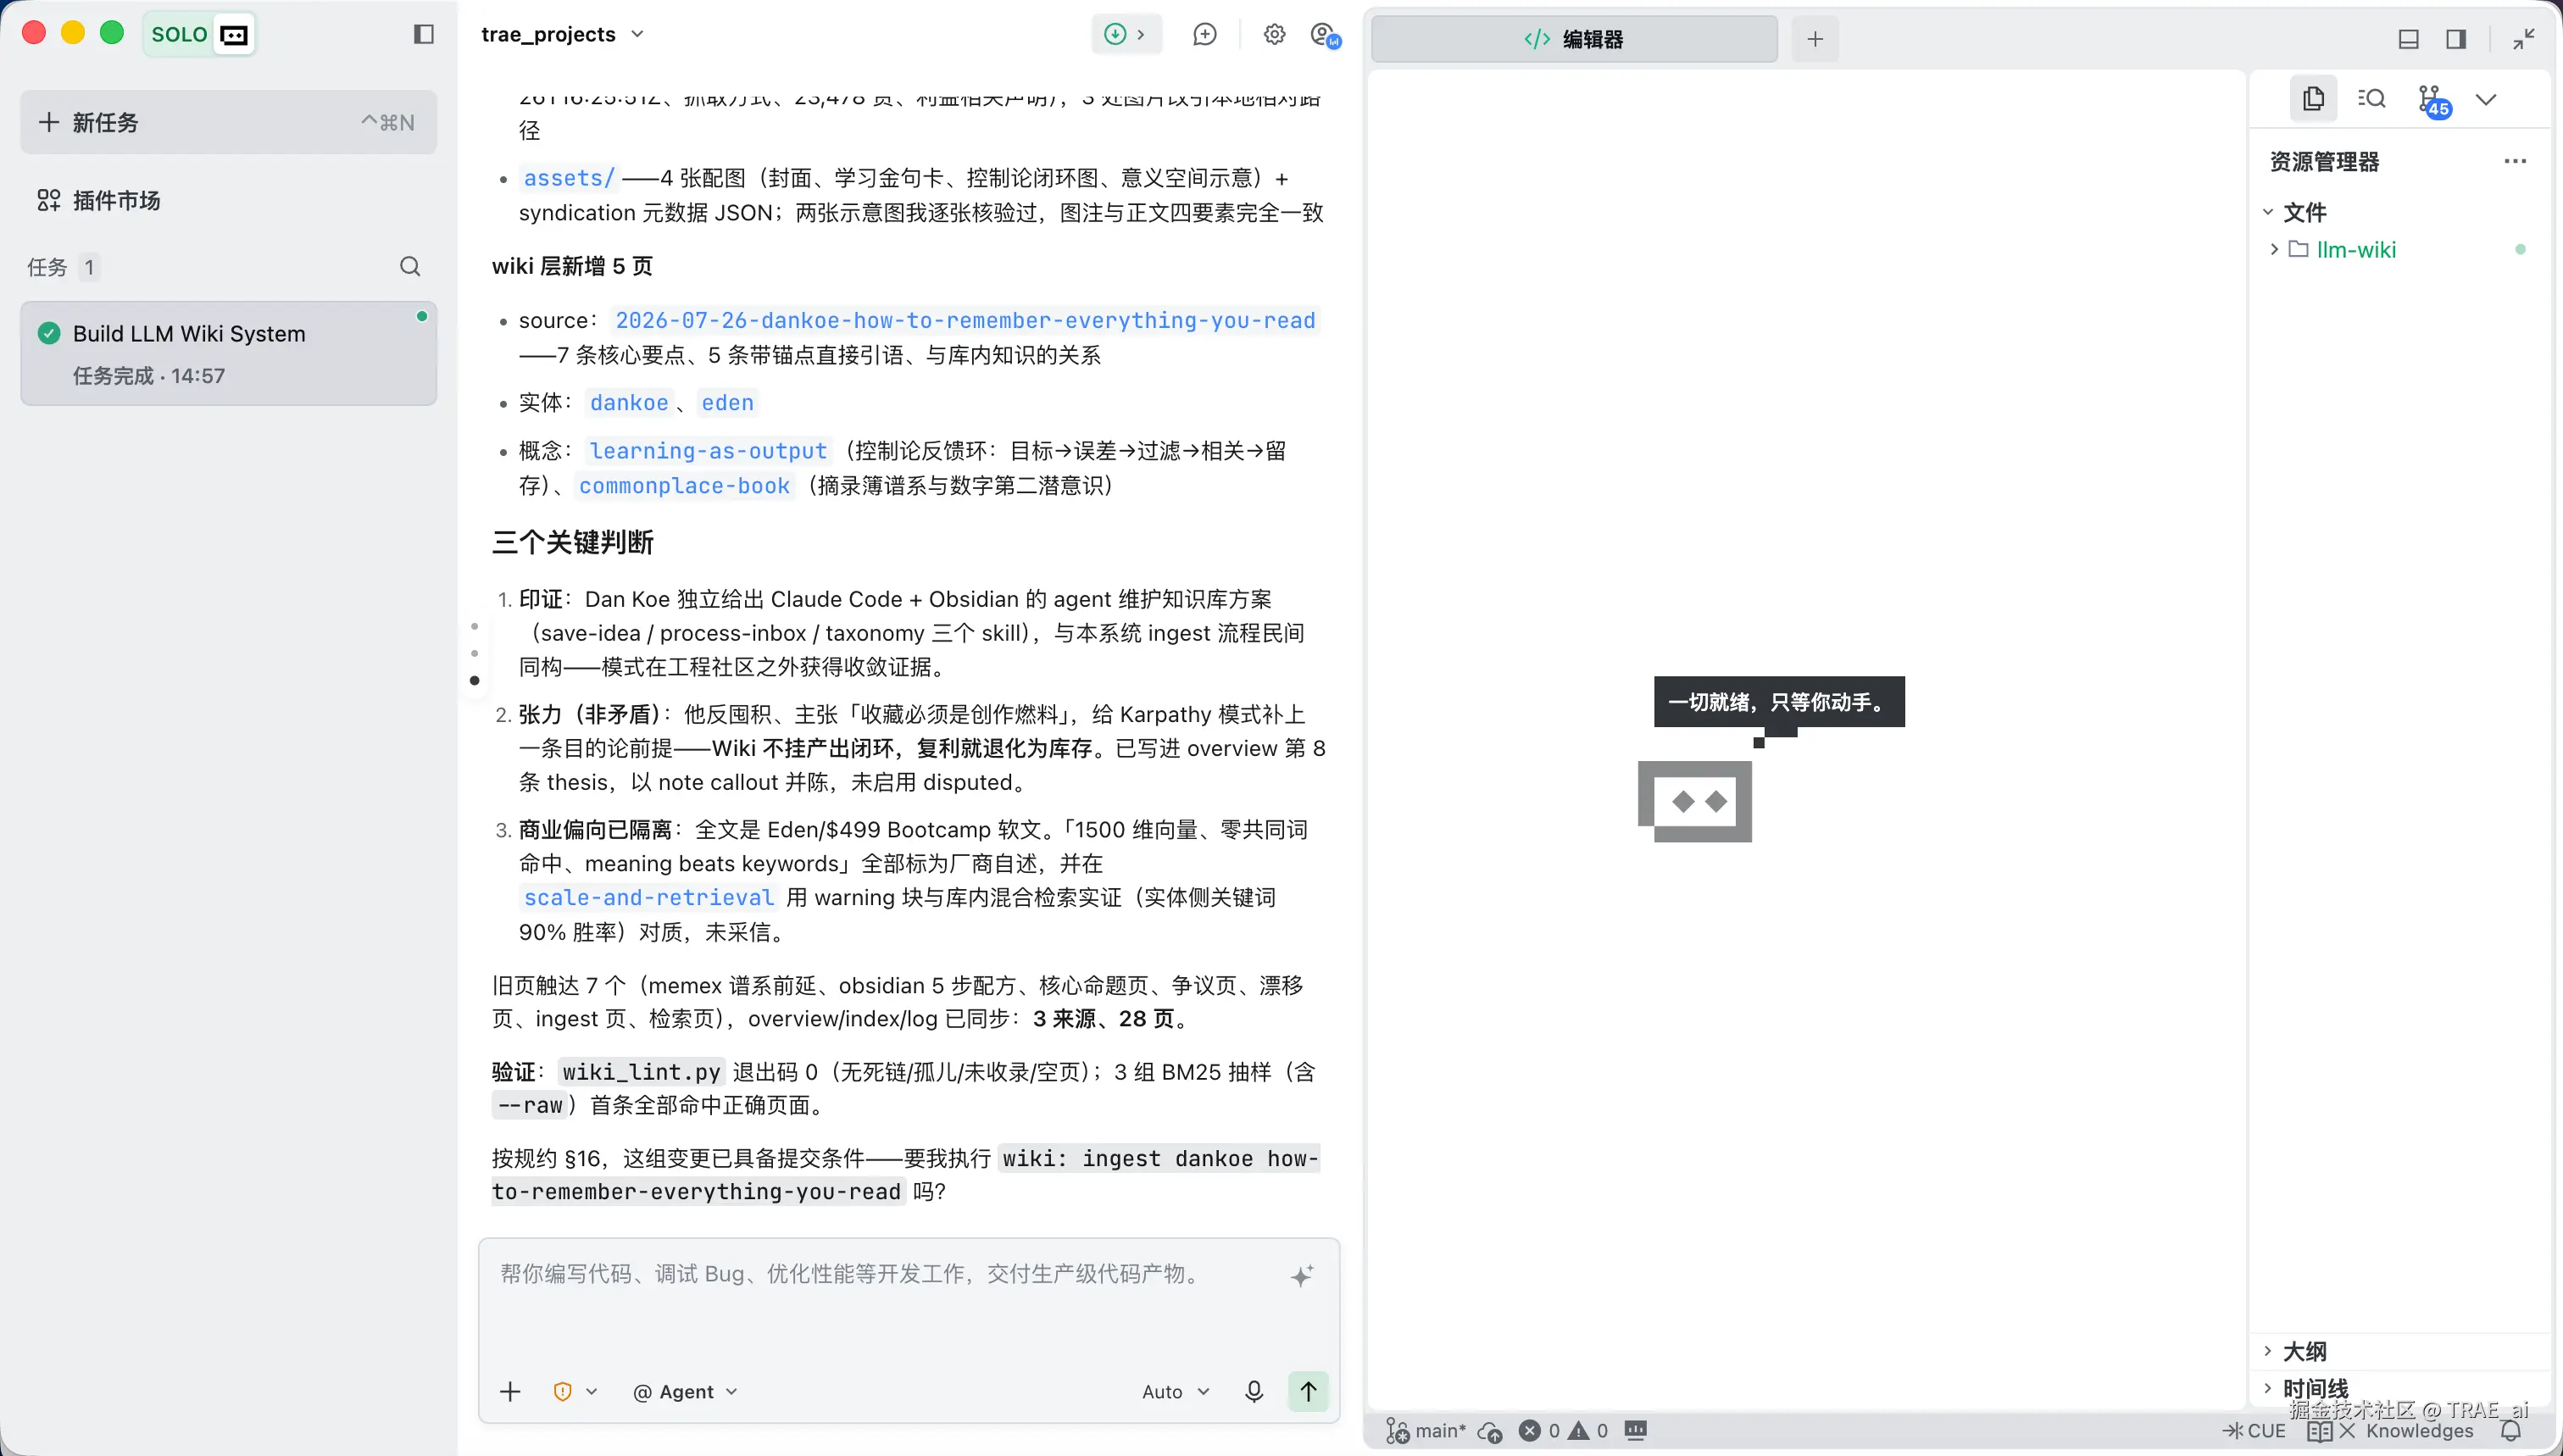
LLM 获取了文章原文,保存为 raw/dan-koe-second-subconscious.md,然后自动创建了 7 个新页面:
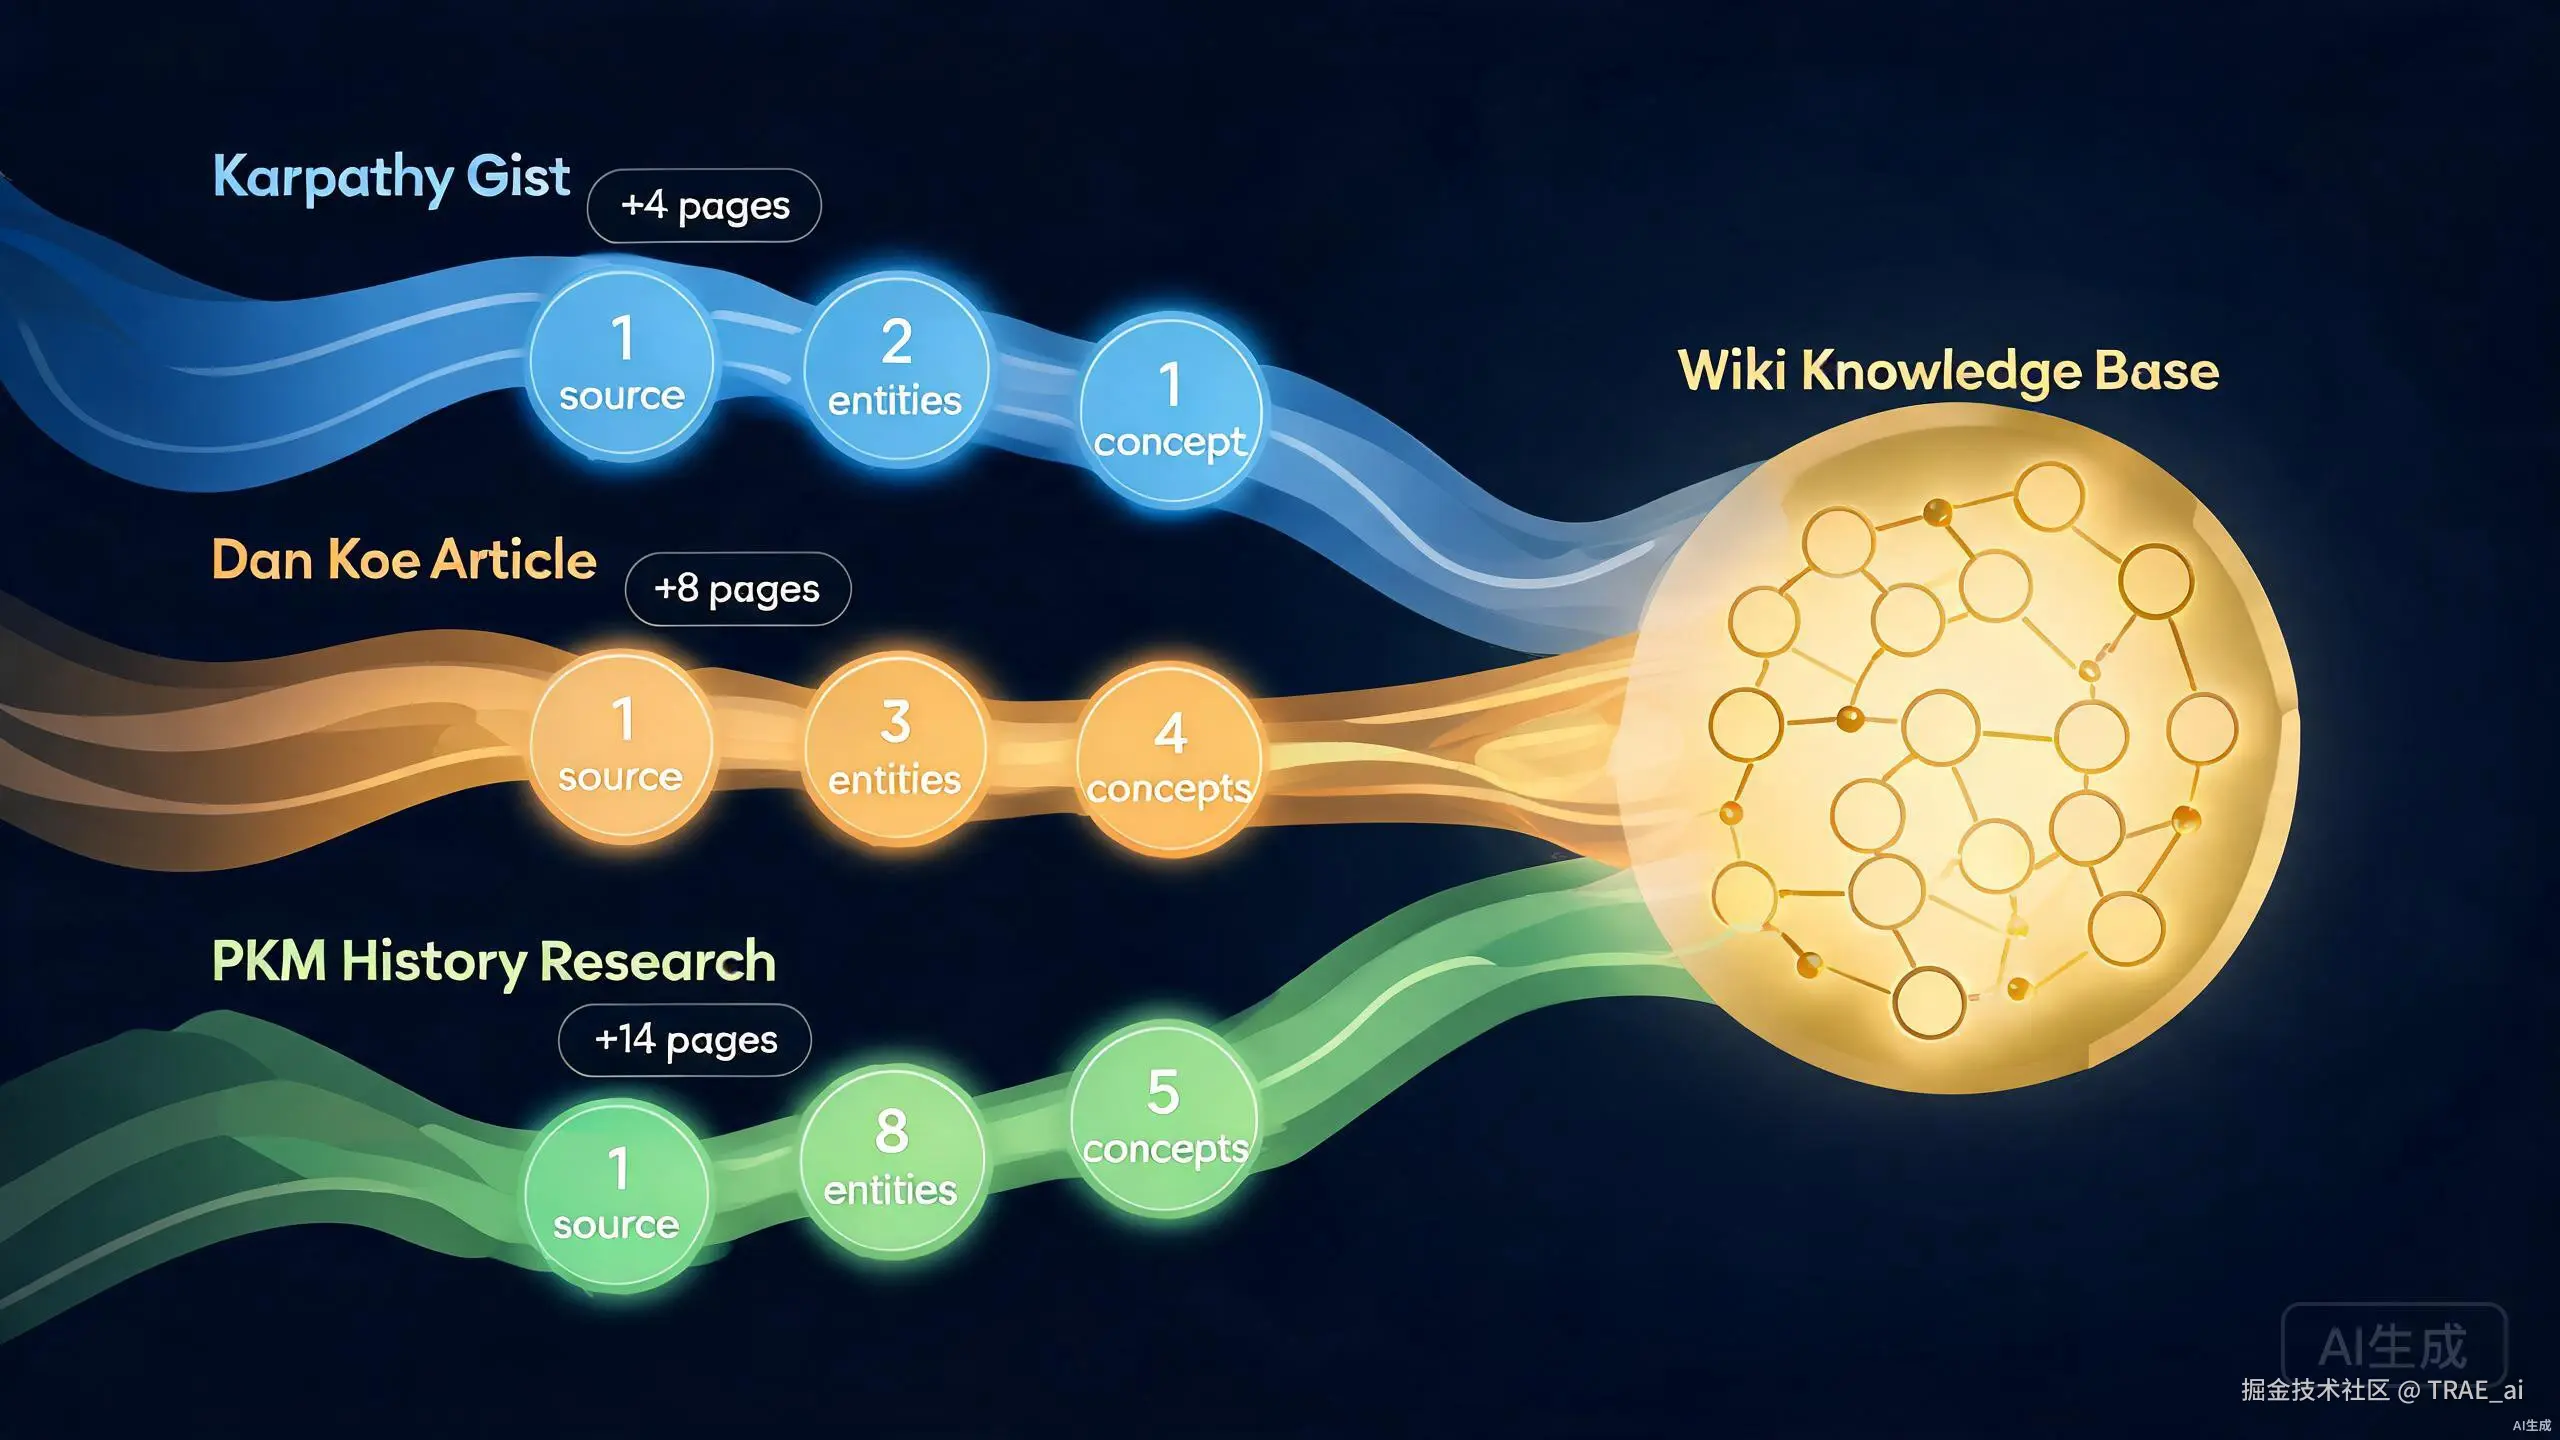
但这不是简单的「加法」。LLM 同时检查了已有的 6 个页面,发现 3 个页面与新内容相关并主动更新了它们的交叉引用:
已有页面也同步更新:
-
Obsidian 实体页新增了 Dan Koe 作为使用者的定位
-
Memex 概念页新增了与「第二潜意识」的关联
-
LLM Wiki 模式概念页新增了 Dan Koe 的批评作为模式动机
结果是:
-
Wiki 从 6 个页面增长到 13 个页面,而且新旧页面之间形成了密集的交叉引用
-
Dan Koe 的素材摘要页引用了 5 个新创建的实体/概念页和 3 个已有页面
-
cybernetics概念页反向引用了素材摘要页和second-brain概念页 -
obsidian实体页获得了来自新页面的入站链接
关键观察:提取不只是「加法」,是「乘法」。每个新页面都可能触发已有页面的更新,已有页面获得了新的出站链接和入站链接。知识网络的密度不是线性增长,而是指数增长。人类只需提供素材 URL,LLM 负责所有的阅读、提取、结构化、交叉引用和已有页面更新。
3.4 研究→提取:从探索到知识库扩展
前面展示了「有现成素材→提取」的流程。
但实际使用中,用户更常见的需求是「我对某个话题感兴趣,帮我研究一下」 ,这时没有现成素材可以丢入 raw/,LLM 需要先做研究,再将结果固化为知识库内容。
这是 LLM Wiki 与传统笔记工具的一个重要区别:
-
传统工具中,研究和笔记是分离的(你用搜索引擎研究,然后手动把笔记录入 Obsidian 之类的工具)
-
但是在 LLM Wiki 中,研究和提取是一体化的,TraeCode 既是研究员,也是 Wiki 维护者。
我们来看一个案例:一次和 AI 的研究性对话如何扩展 13 个页面
场景背景
Wiki 已有 13 个页面(第一次提取 Karpathy Gist 产生的 6 页 + 第二次提取 Dan Koe 文章产生的 7 页),涵盖 LLM Wiki 模式、第二大脑批评、控制论学习模型等。用户想了解更多背景,于是提出了一个开放式研究问题。
第一步:用户提出研究问题
sql
介绍 Personal Knowledge Management System 的历史和演进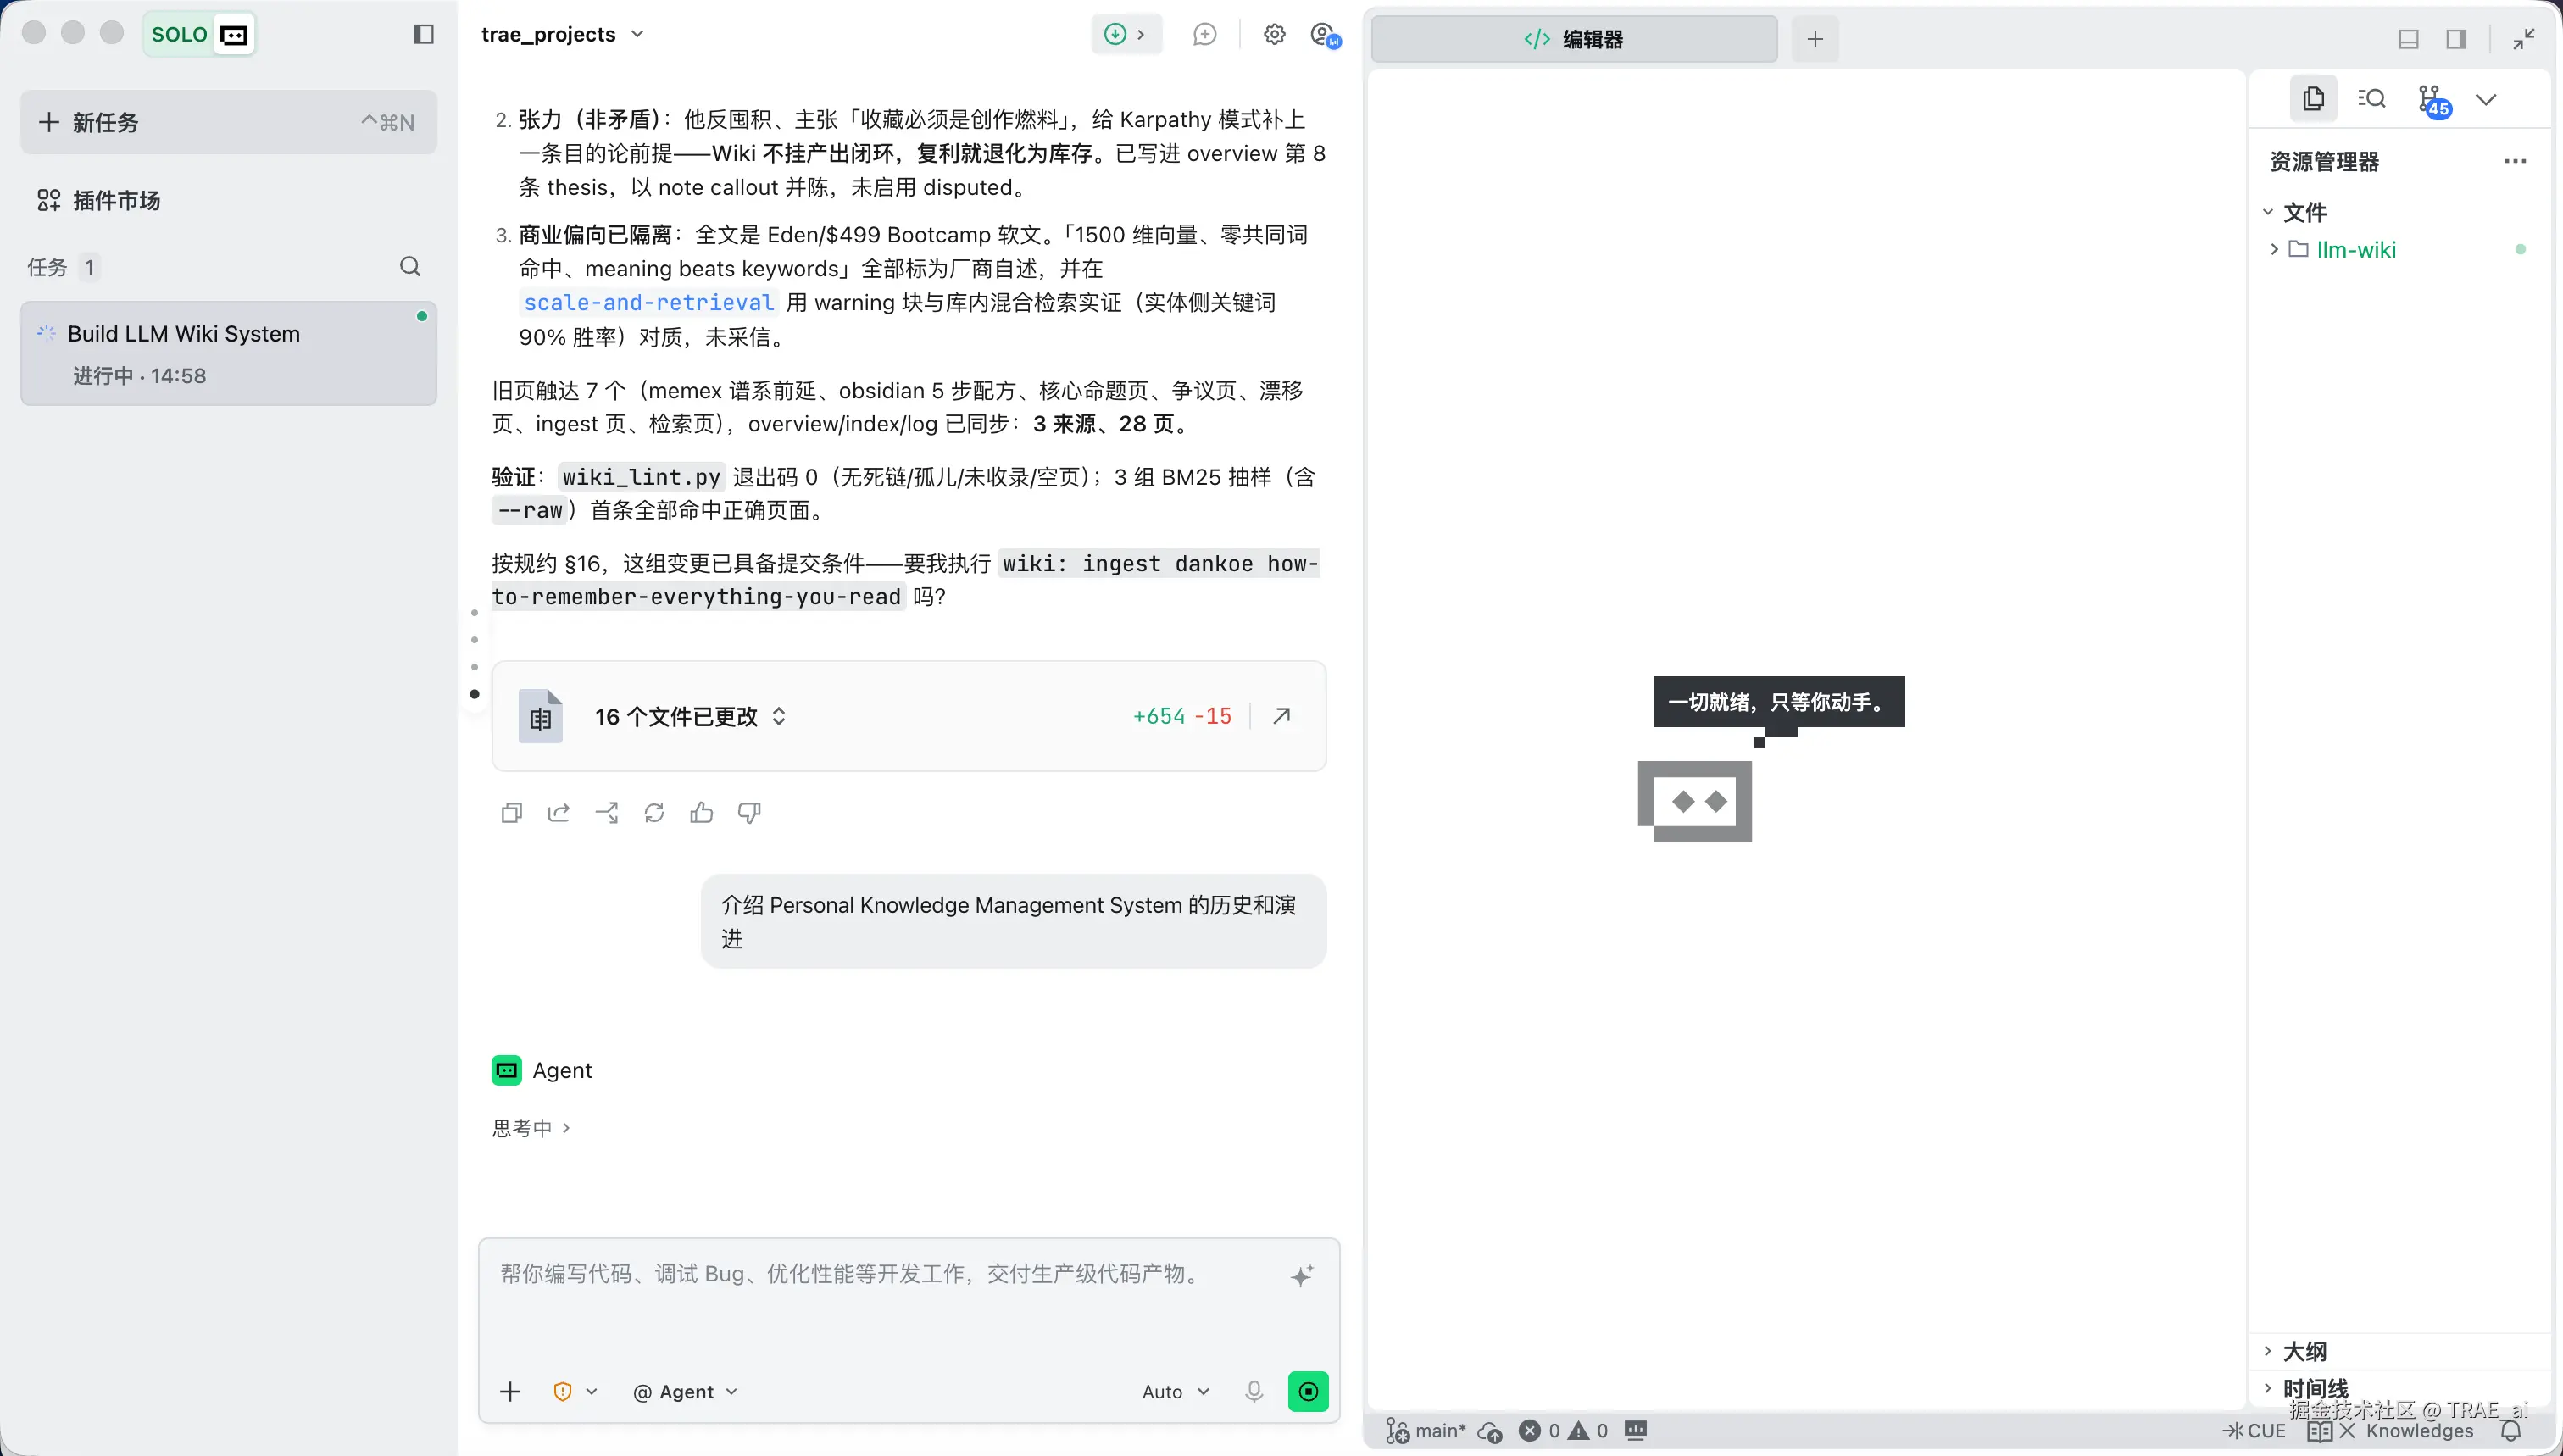
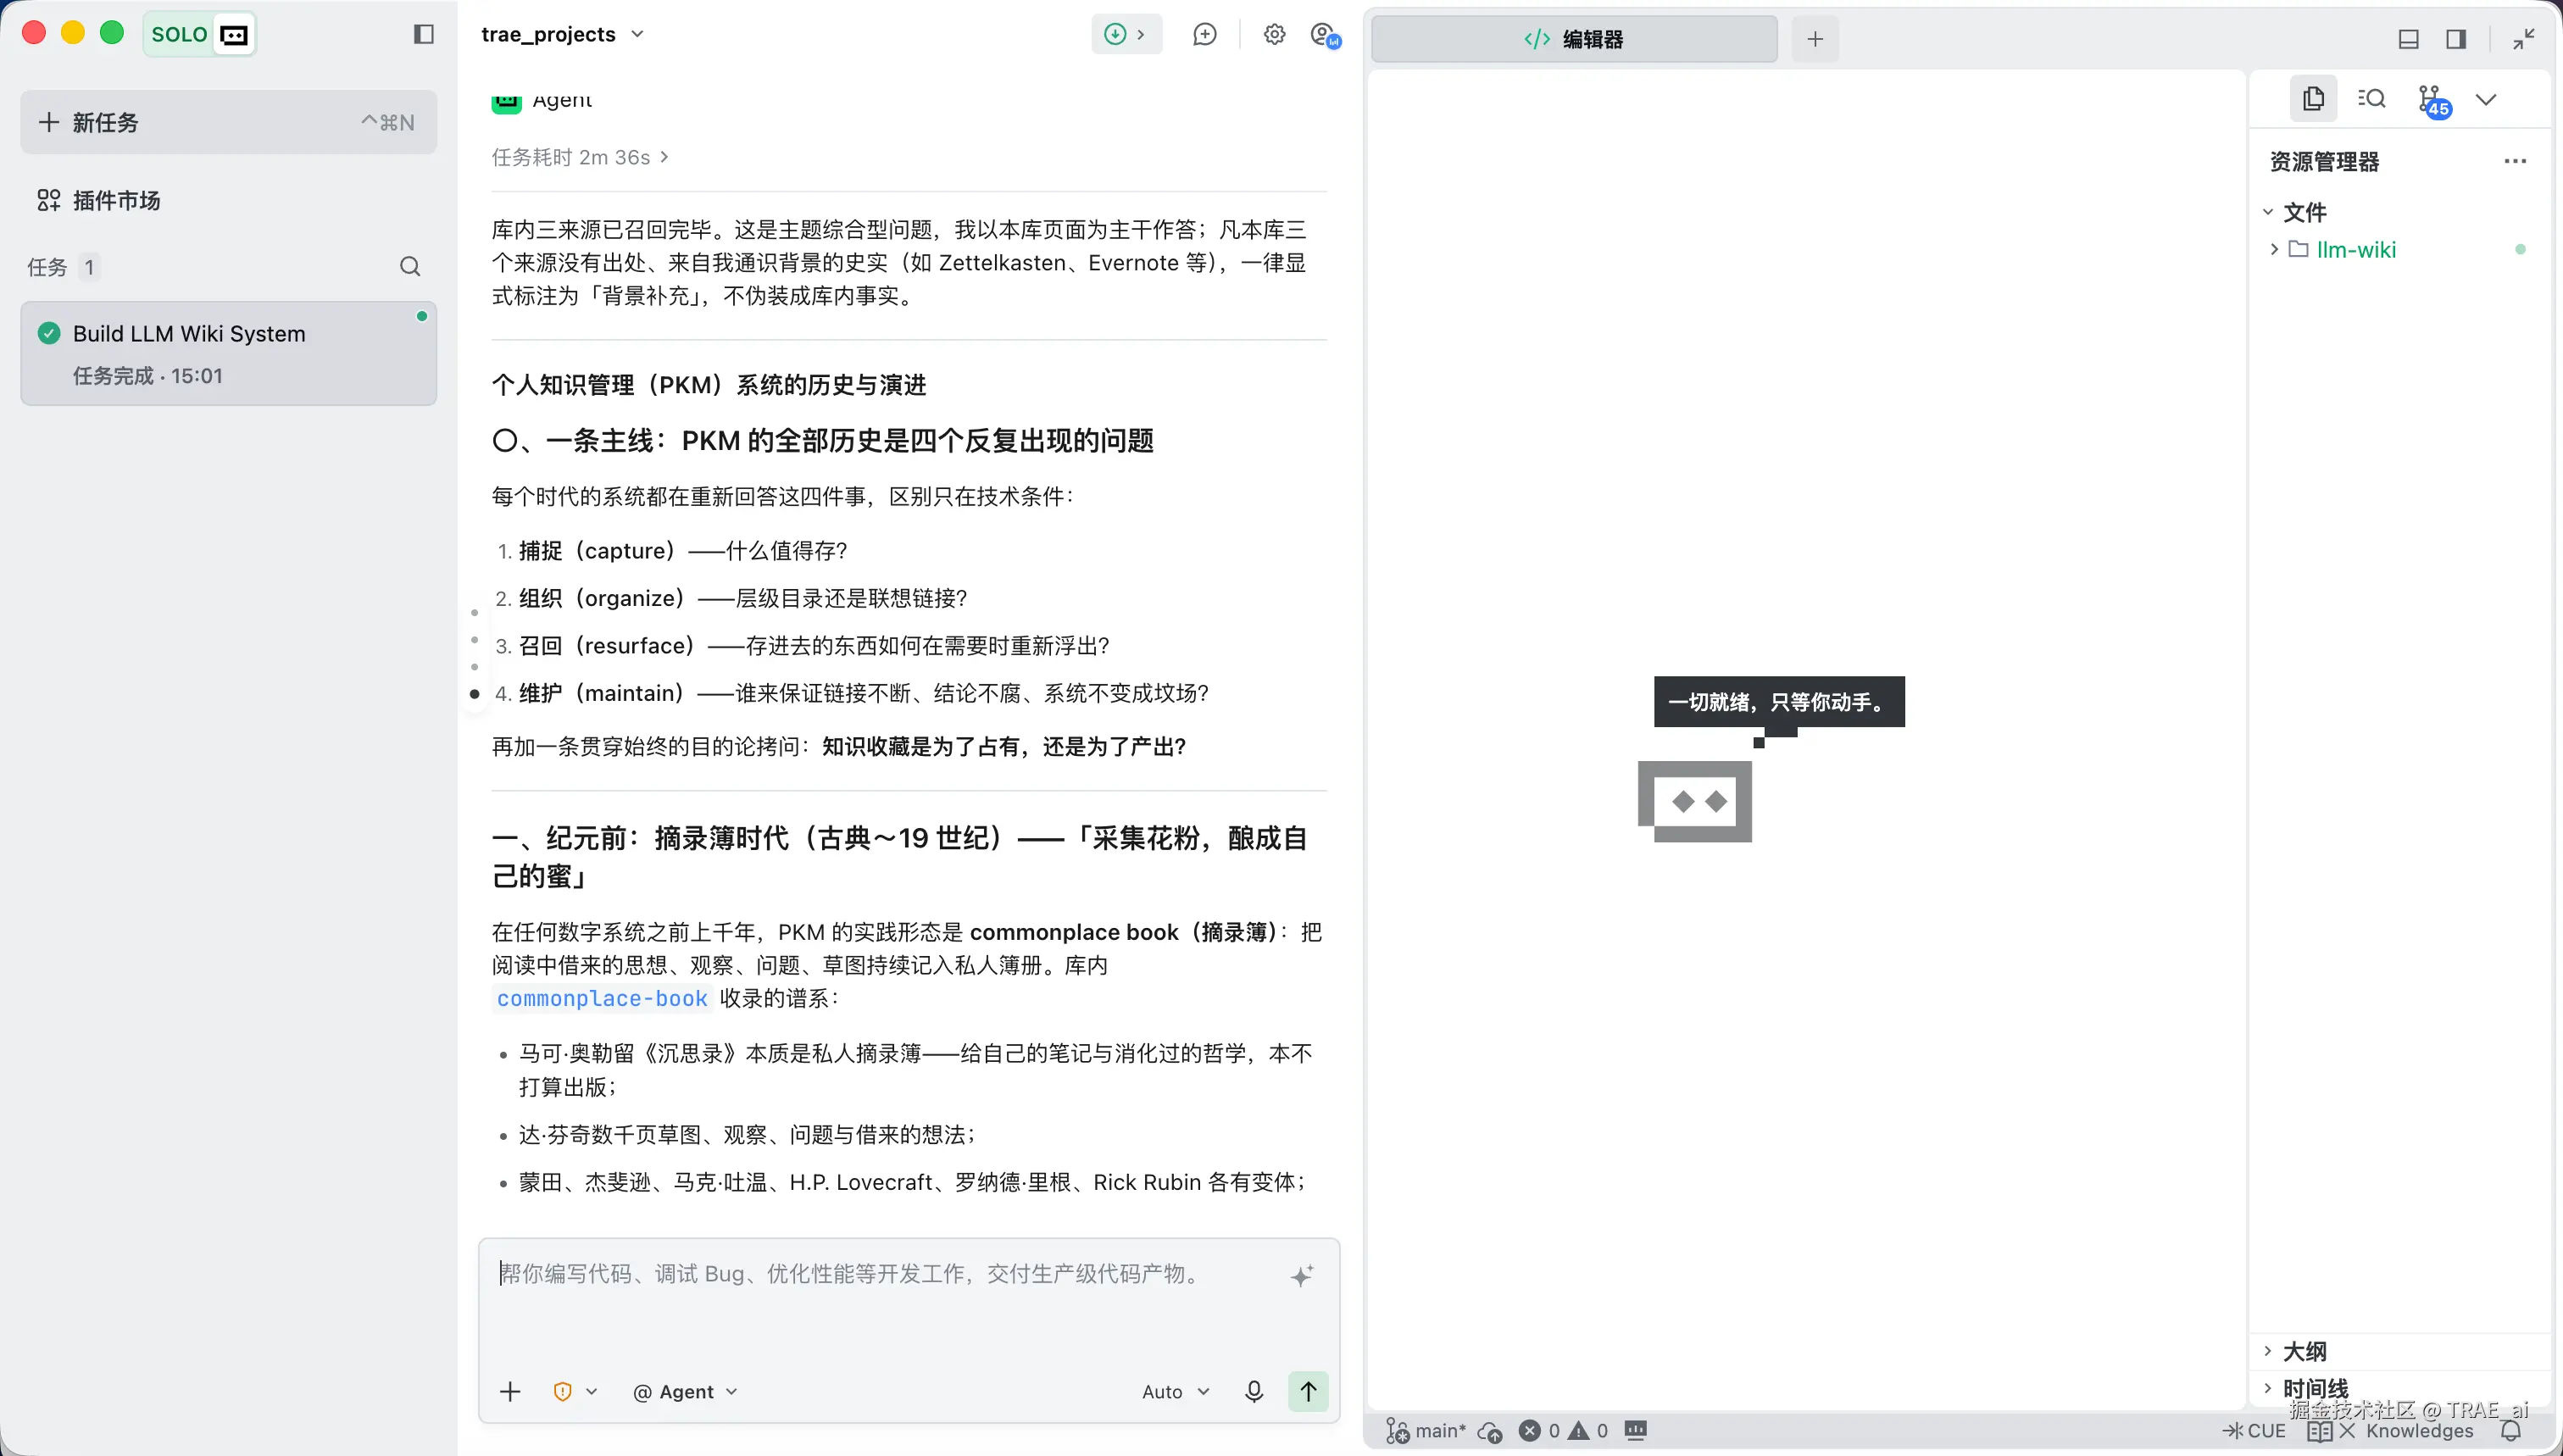
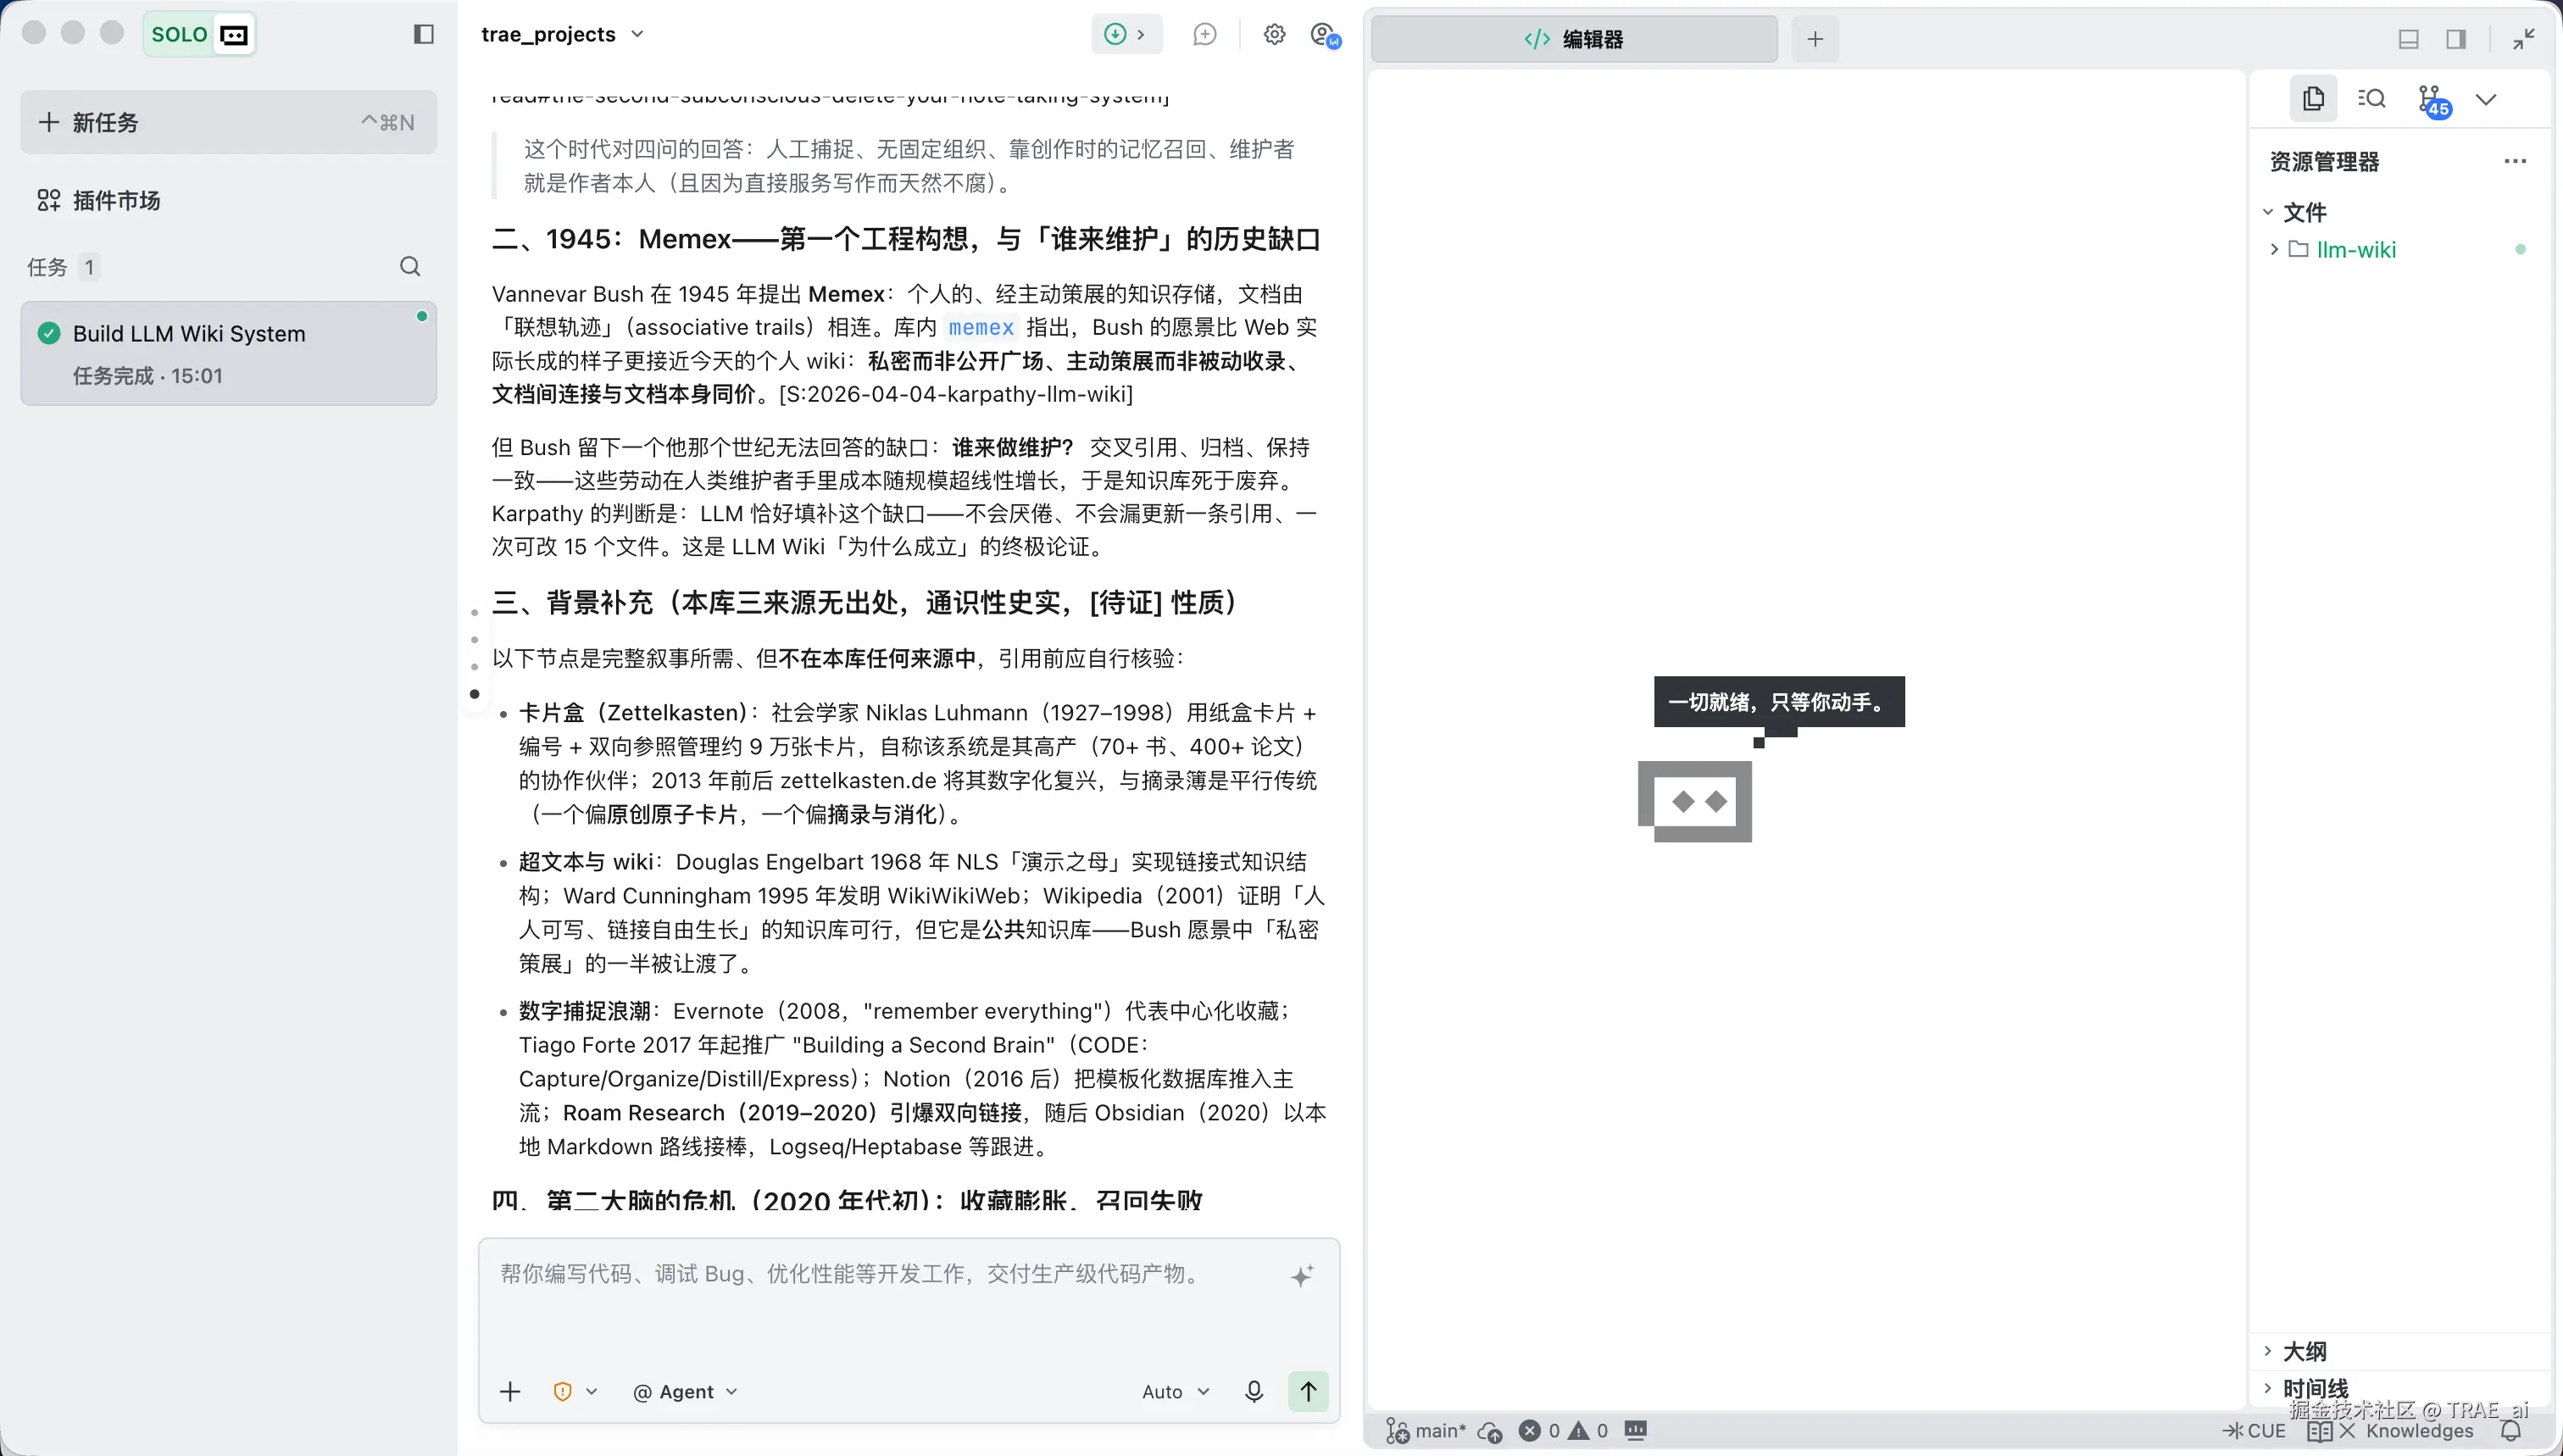
这不是一个可以用一两句话回答的查询,它要求系统性地梳理五个世纪的知识管理实践演进。TraeCode Agent 不会只用模型的训练数据回答,而是启动 Web 研究流程。
第二步:TraeCode 执行互联网搜索
TraeCode 的研究过程遵循「搜索→评估→深入」的迭代循环:
| 轮次 | 搜索方向 | 获取的信息 |
|---|---|---|
| 第一轮 | PKM 历史、关键人物 | Vannevar Bush、Memex、Zettelkasten、Niklas Luhmann 等关键词 |
| 第二轮 | 补充英文权威素材 | Wikipedia 的 Memex 和 Zettelkasten 条目全文 |
| 第三轮 | 现代 PKM 工具 | Roam Research、Obsidian、Notion 的发展脉络 |
研究不是简单搜索,TraeCode 会在每轮搜索后评估已有信息,识别缺口,然后针对性地补充搜索。最终产出一个涵盖五个世纪演进的综合性研究材料。
第三步:固化研究产出为原始素材
研究完成后,TraeCode 将所有发现整合为一个结构化的原始素材文件 raw/pkms-history-and-evolution.md,包含:
-
前数字时代:摘记本 → Harrison 的「学问之舟」→ Luhmann 的 90,000 张卡片
-
Memex 设想(1945):Bush 的关联索引概念及其影响谱系
-
超文本先驱(1960s-1980s):HES → NoteCards → HyperCard → Wiki
-
万维网时代(1990s-2000s):PKM 术语确立,Evernote/OneNote 范式
-
现代 PKM(2020s):Roam Research 的双向链接,Obsidian 的本地优先
这一步是关键,研究的产出不消失在对话历史中,而是被固化为知识库的不可变原始素材。下次对话时,LLM 不需要重新搜索,直接读取这个文件即可。
第四步:提取为 13 个新 Wiki 页面
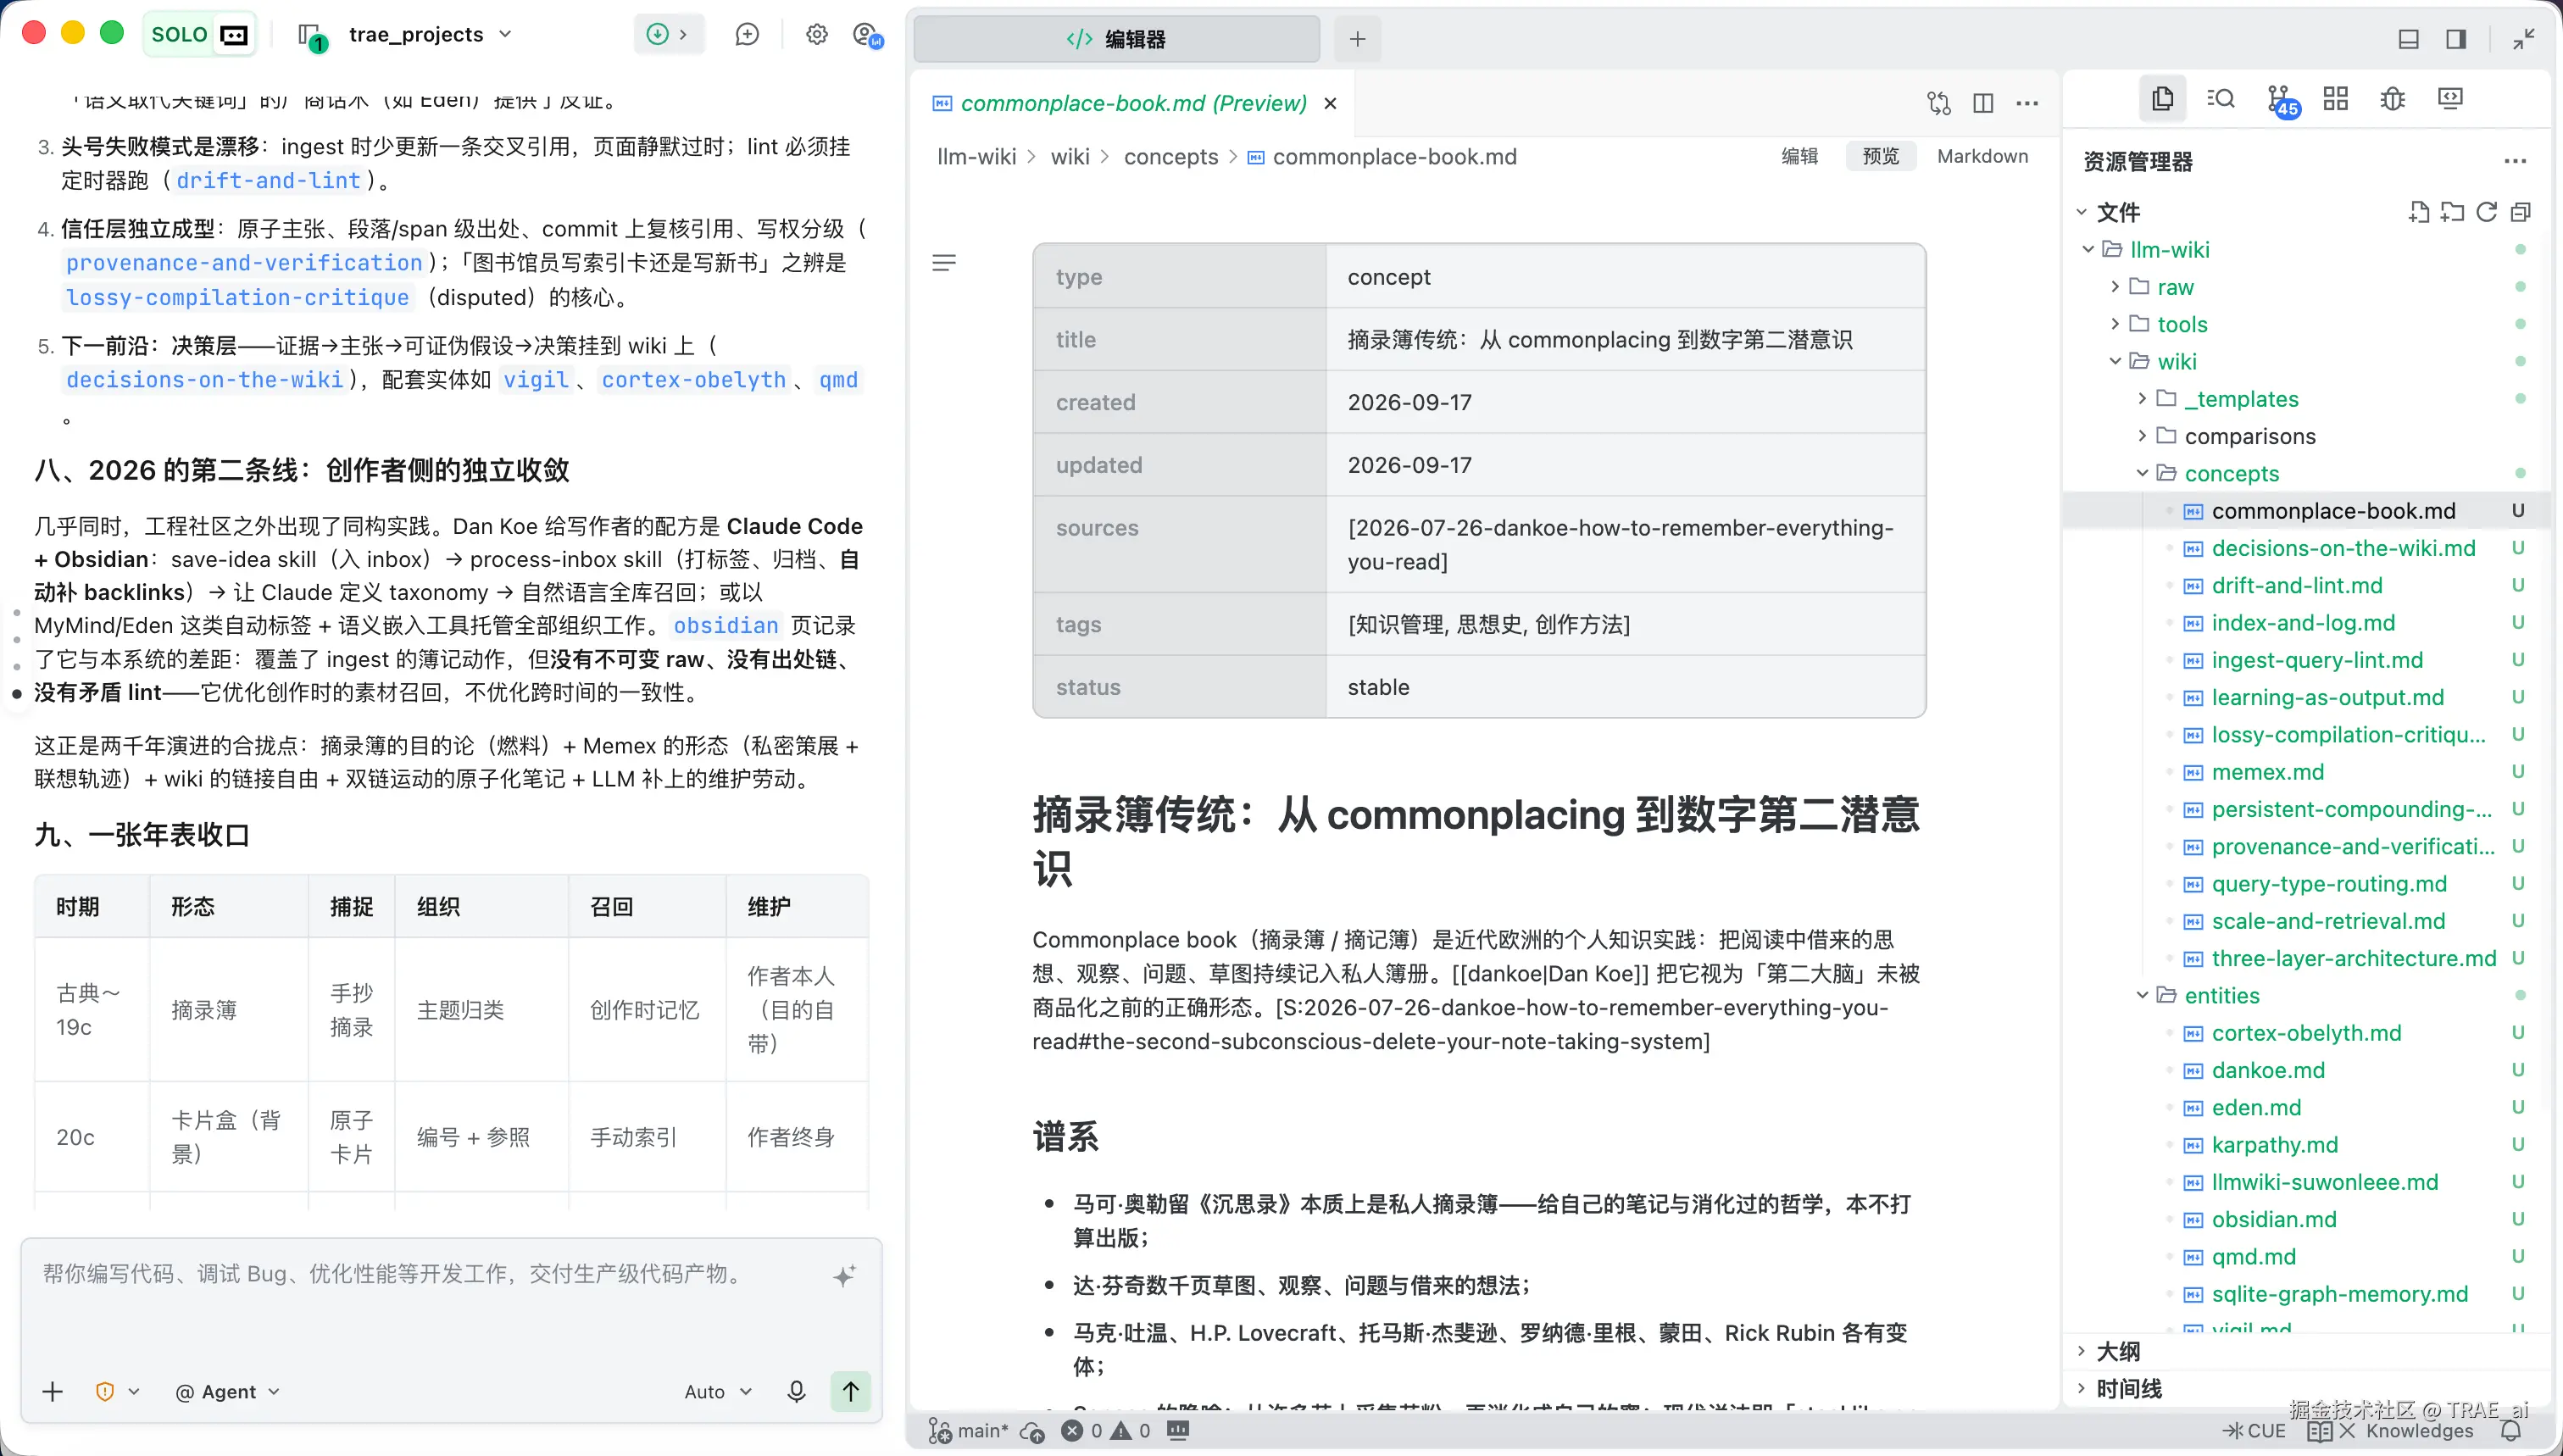
TraeCode 对这个综合性素材执行完整的提取工作流,产出 13 个新页面:
PKM 历史研究为 Wiki 带来了 14 个新页面:1 份素材摘要(PKM 演变史),8 个实体页(Vannevar Bush、Niklas Luhmann、Ted Nelson、Douglas Engelbart、Tim Berners-Lee 等),5 个概念页(Zettelkasten、HyperText、Personal Knowledge Management 等)。
一次研究性对话,Wiki 从 13 页扩展到 26 页,翻了一倍。
第五步:交叉引用,新页面与旧页面的网络融合
最关键的不是新增了 13 个页面,而是新页面与已有 13 个页面之间形成了密集的交叉引用网络:
-
\[memex] 概念页被更新,新增了完整的影响谱系和 Memex Revisited 历史(出处:\[pkms-history-and-evolution])
-
\[commonplace-book] 概念页被更新,新增了从摘记本到卡片系统的演进脉络
-
\[obsidian] 实体页被更新,新增了在 PKM 演进谱系中的定位
-
\[second-brain] 概念页被更新,新增了 Tiago Forte 的 PARA 方法论引用
-
\[llm-wiki-pattern] 概念页被更新,新增了在 PKM 五世纪演进谱系中的终态定位
这意味着提取不只是「加法」,它是「乘法」。每个新页面都可能触发已有页面的更新,已有页面获得了新的出站链接和入站链接。知识网络的密度不是线性增长,而是指数增长。
对话前后的知识库变化
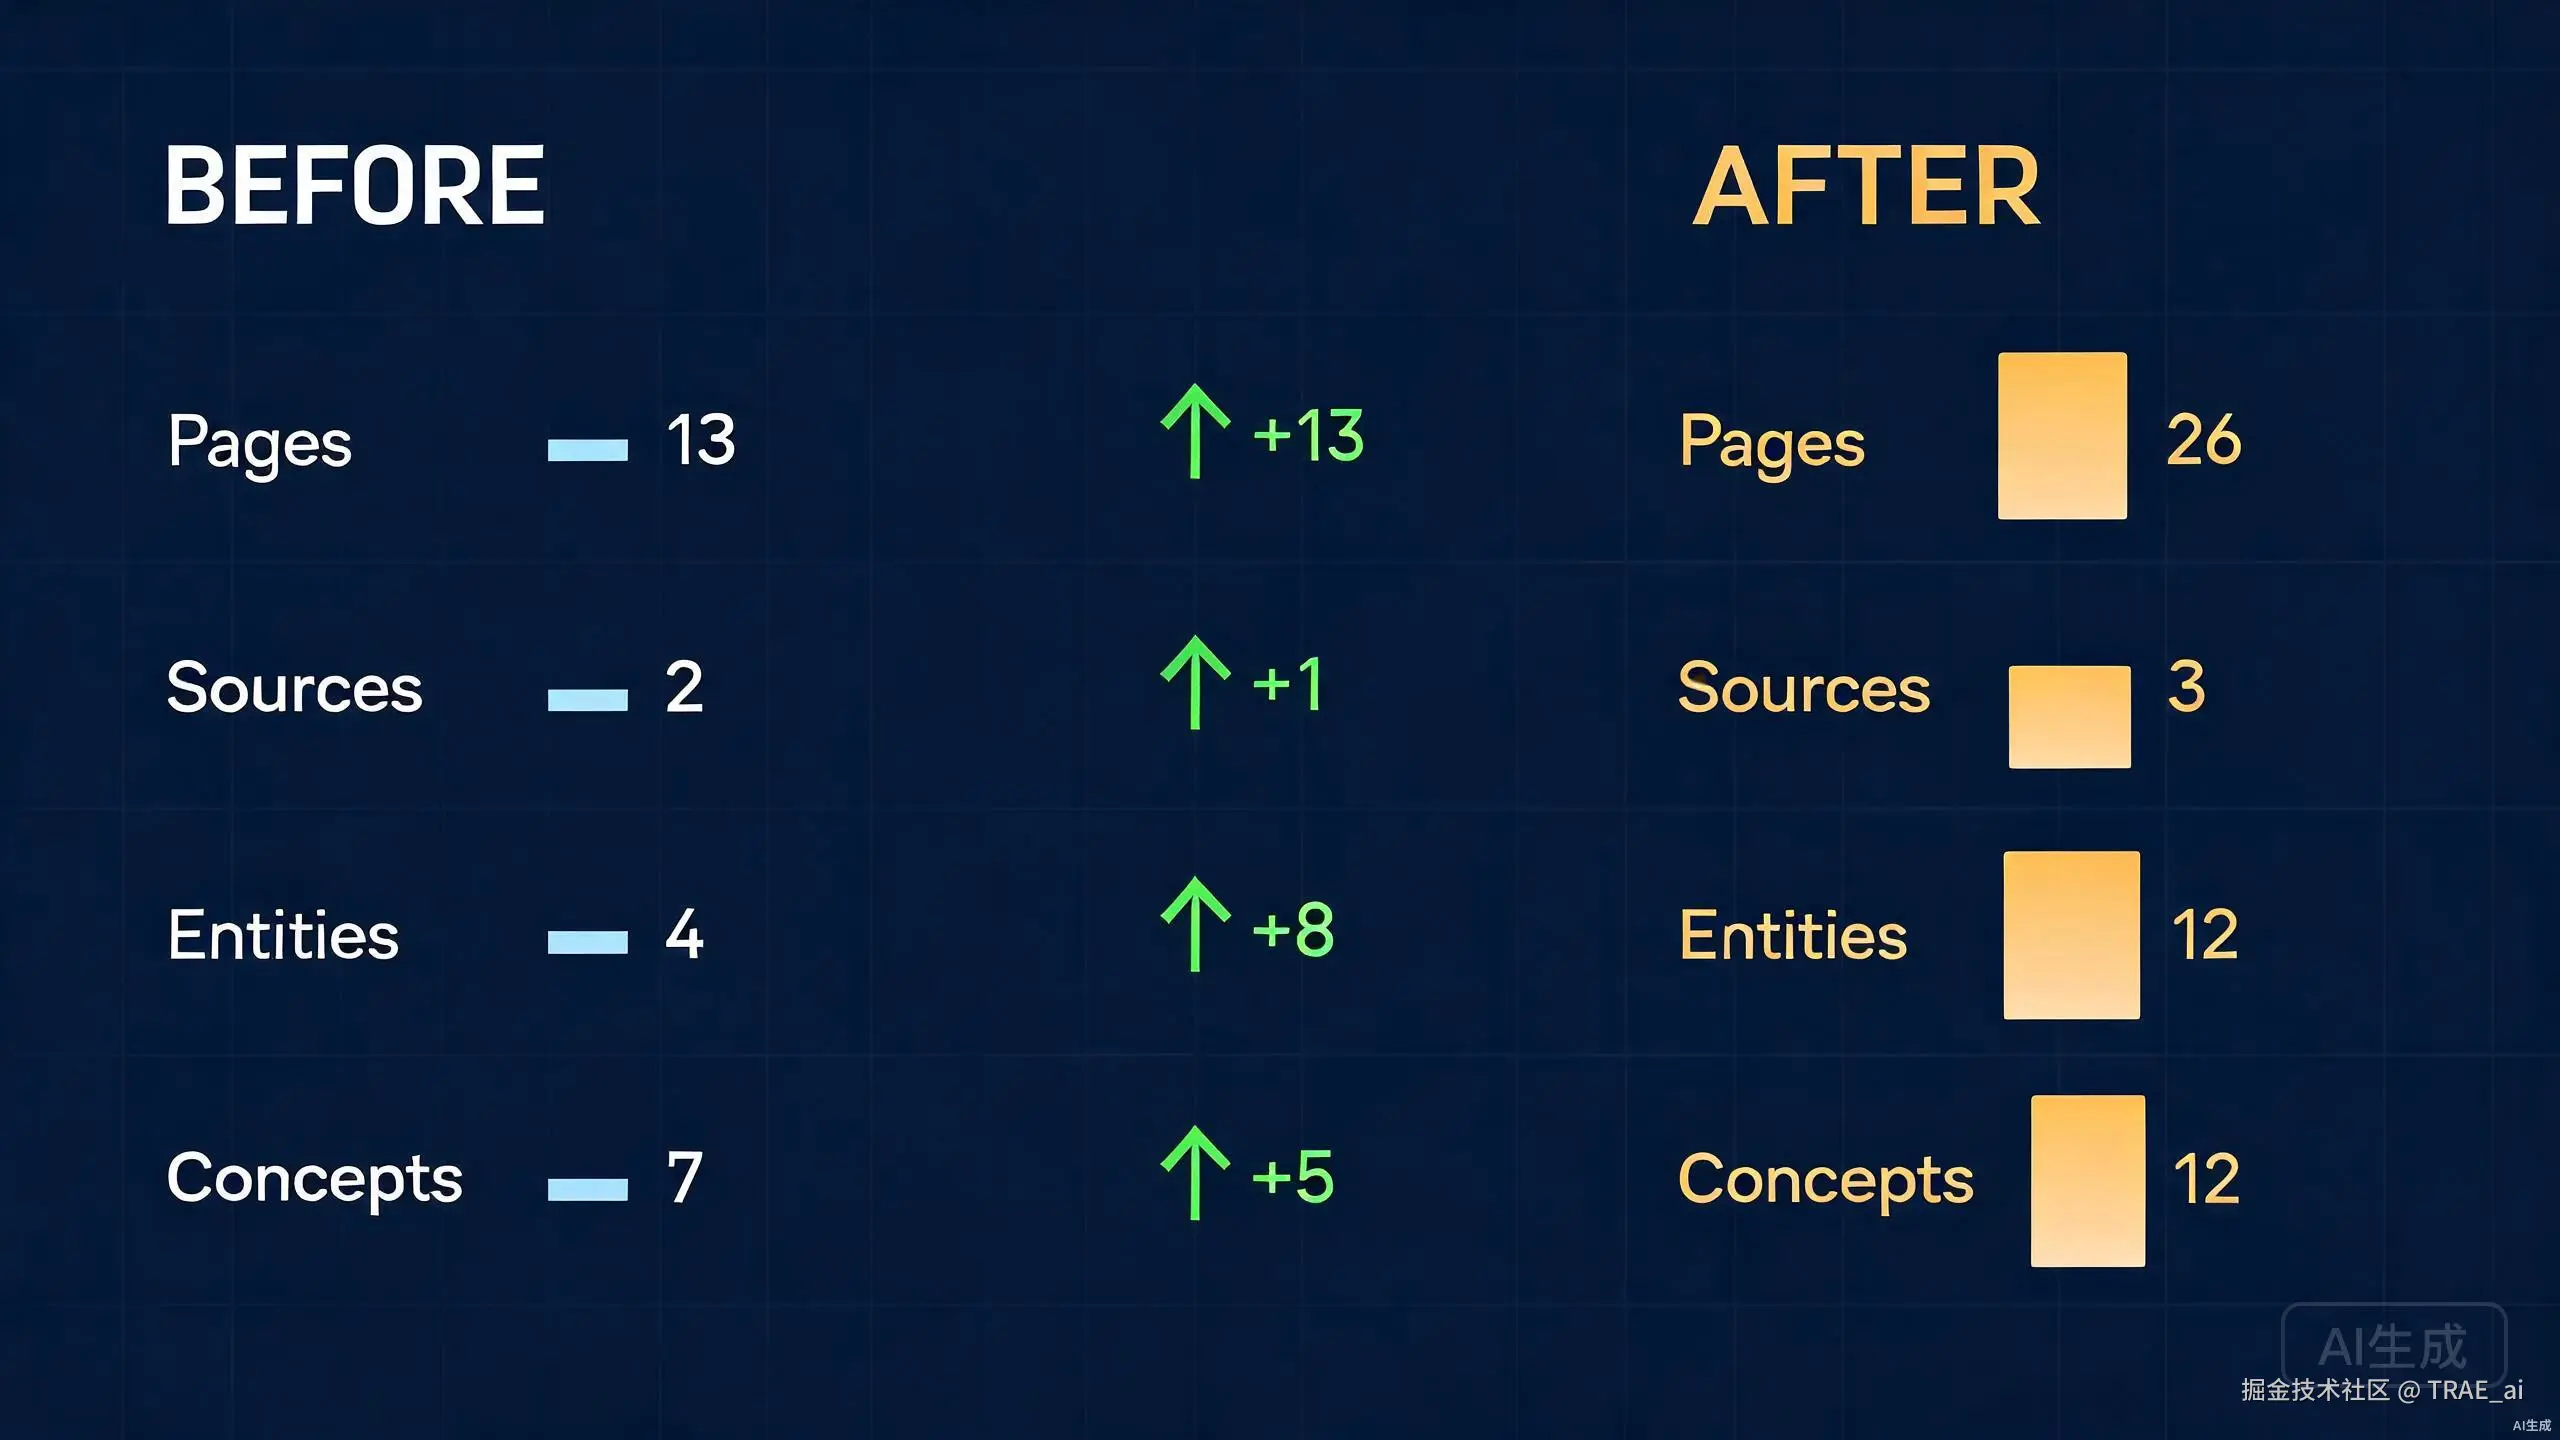
关键观察 :这次对话展示了 LLM Wiki 的一个独特能力:研究即提取。
传统工具中,你用 Google 研究、手动整理笔记、再录入系统,三个步骤完全分离。LLM Wiki 将三者合一:LLM 做研究的同时,自动将发现固化为原始素材、创建摘要页和实体/概念页、建立交叉引用。搜索引擎不是终点,而是原料采集器;研究的产出不消失在对话历史中,而是成为知识库的永久节点。
3.5 查询与综合:通过对话产生新知识
当 Wiki 中积累了足够多的页面后,查询就成为知识变现的主要方式。但 LLM Wiki 的查询不只是「检索+回答」,它是一个知识创造过程:对话本身产出新的综合页,知识库在对话中增长。
案例:一次对话如何产出新知识库内容
以下是 Wiki 系统中真实发生的一次对话,完整展示了从提问到新知识产出的全过程。
场景背景
Wiki 已有 27 个页面(12 实体 + 12 概念 + 3 素材),涵盖 PKM 历史、LLM Wiki 模式、Dan Koe 的批评等。用户在此之前刚分析了传统 PKMS 的六大局限性(limitations-of-traditional-pkms),自然产生了下一个问题。
第一步:用户提问
在 TraeCode 中提问:
我们为什么要使用 PKMS,尤其在 AI 时代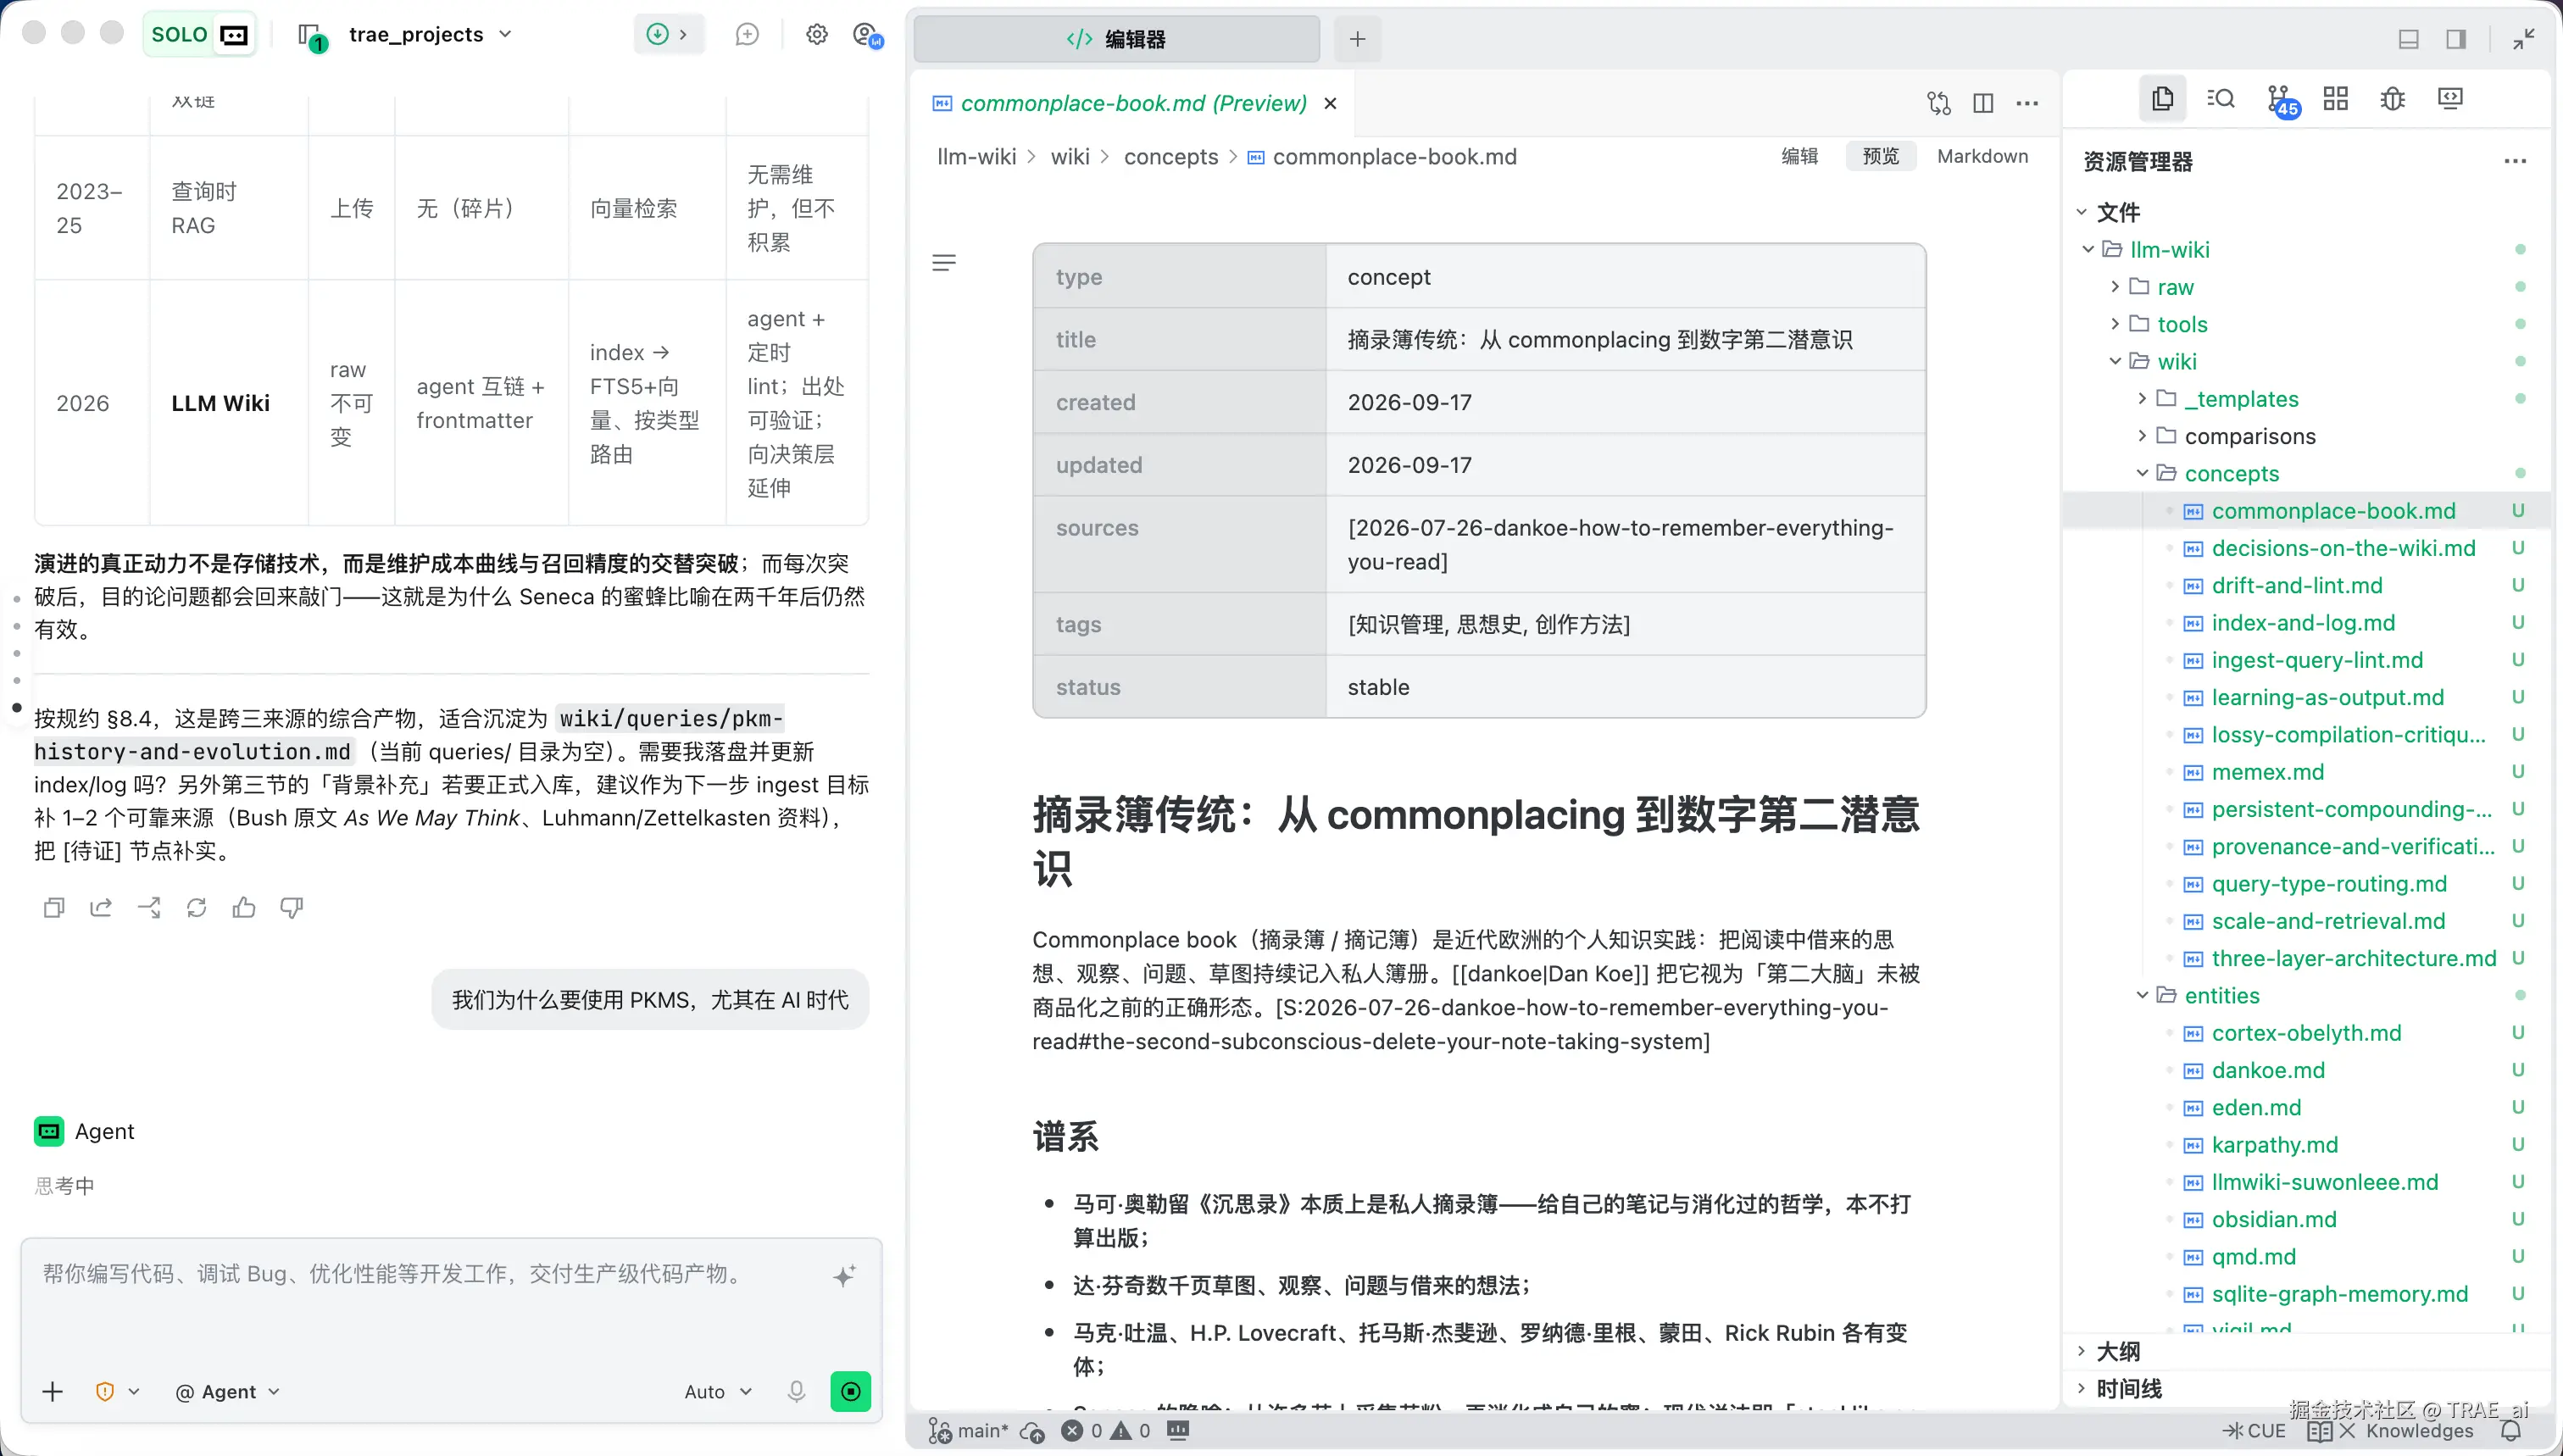
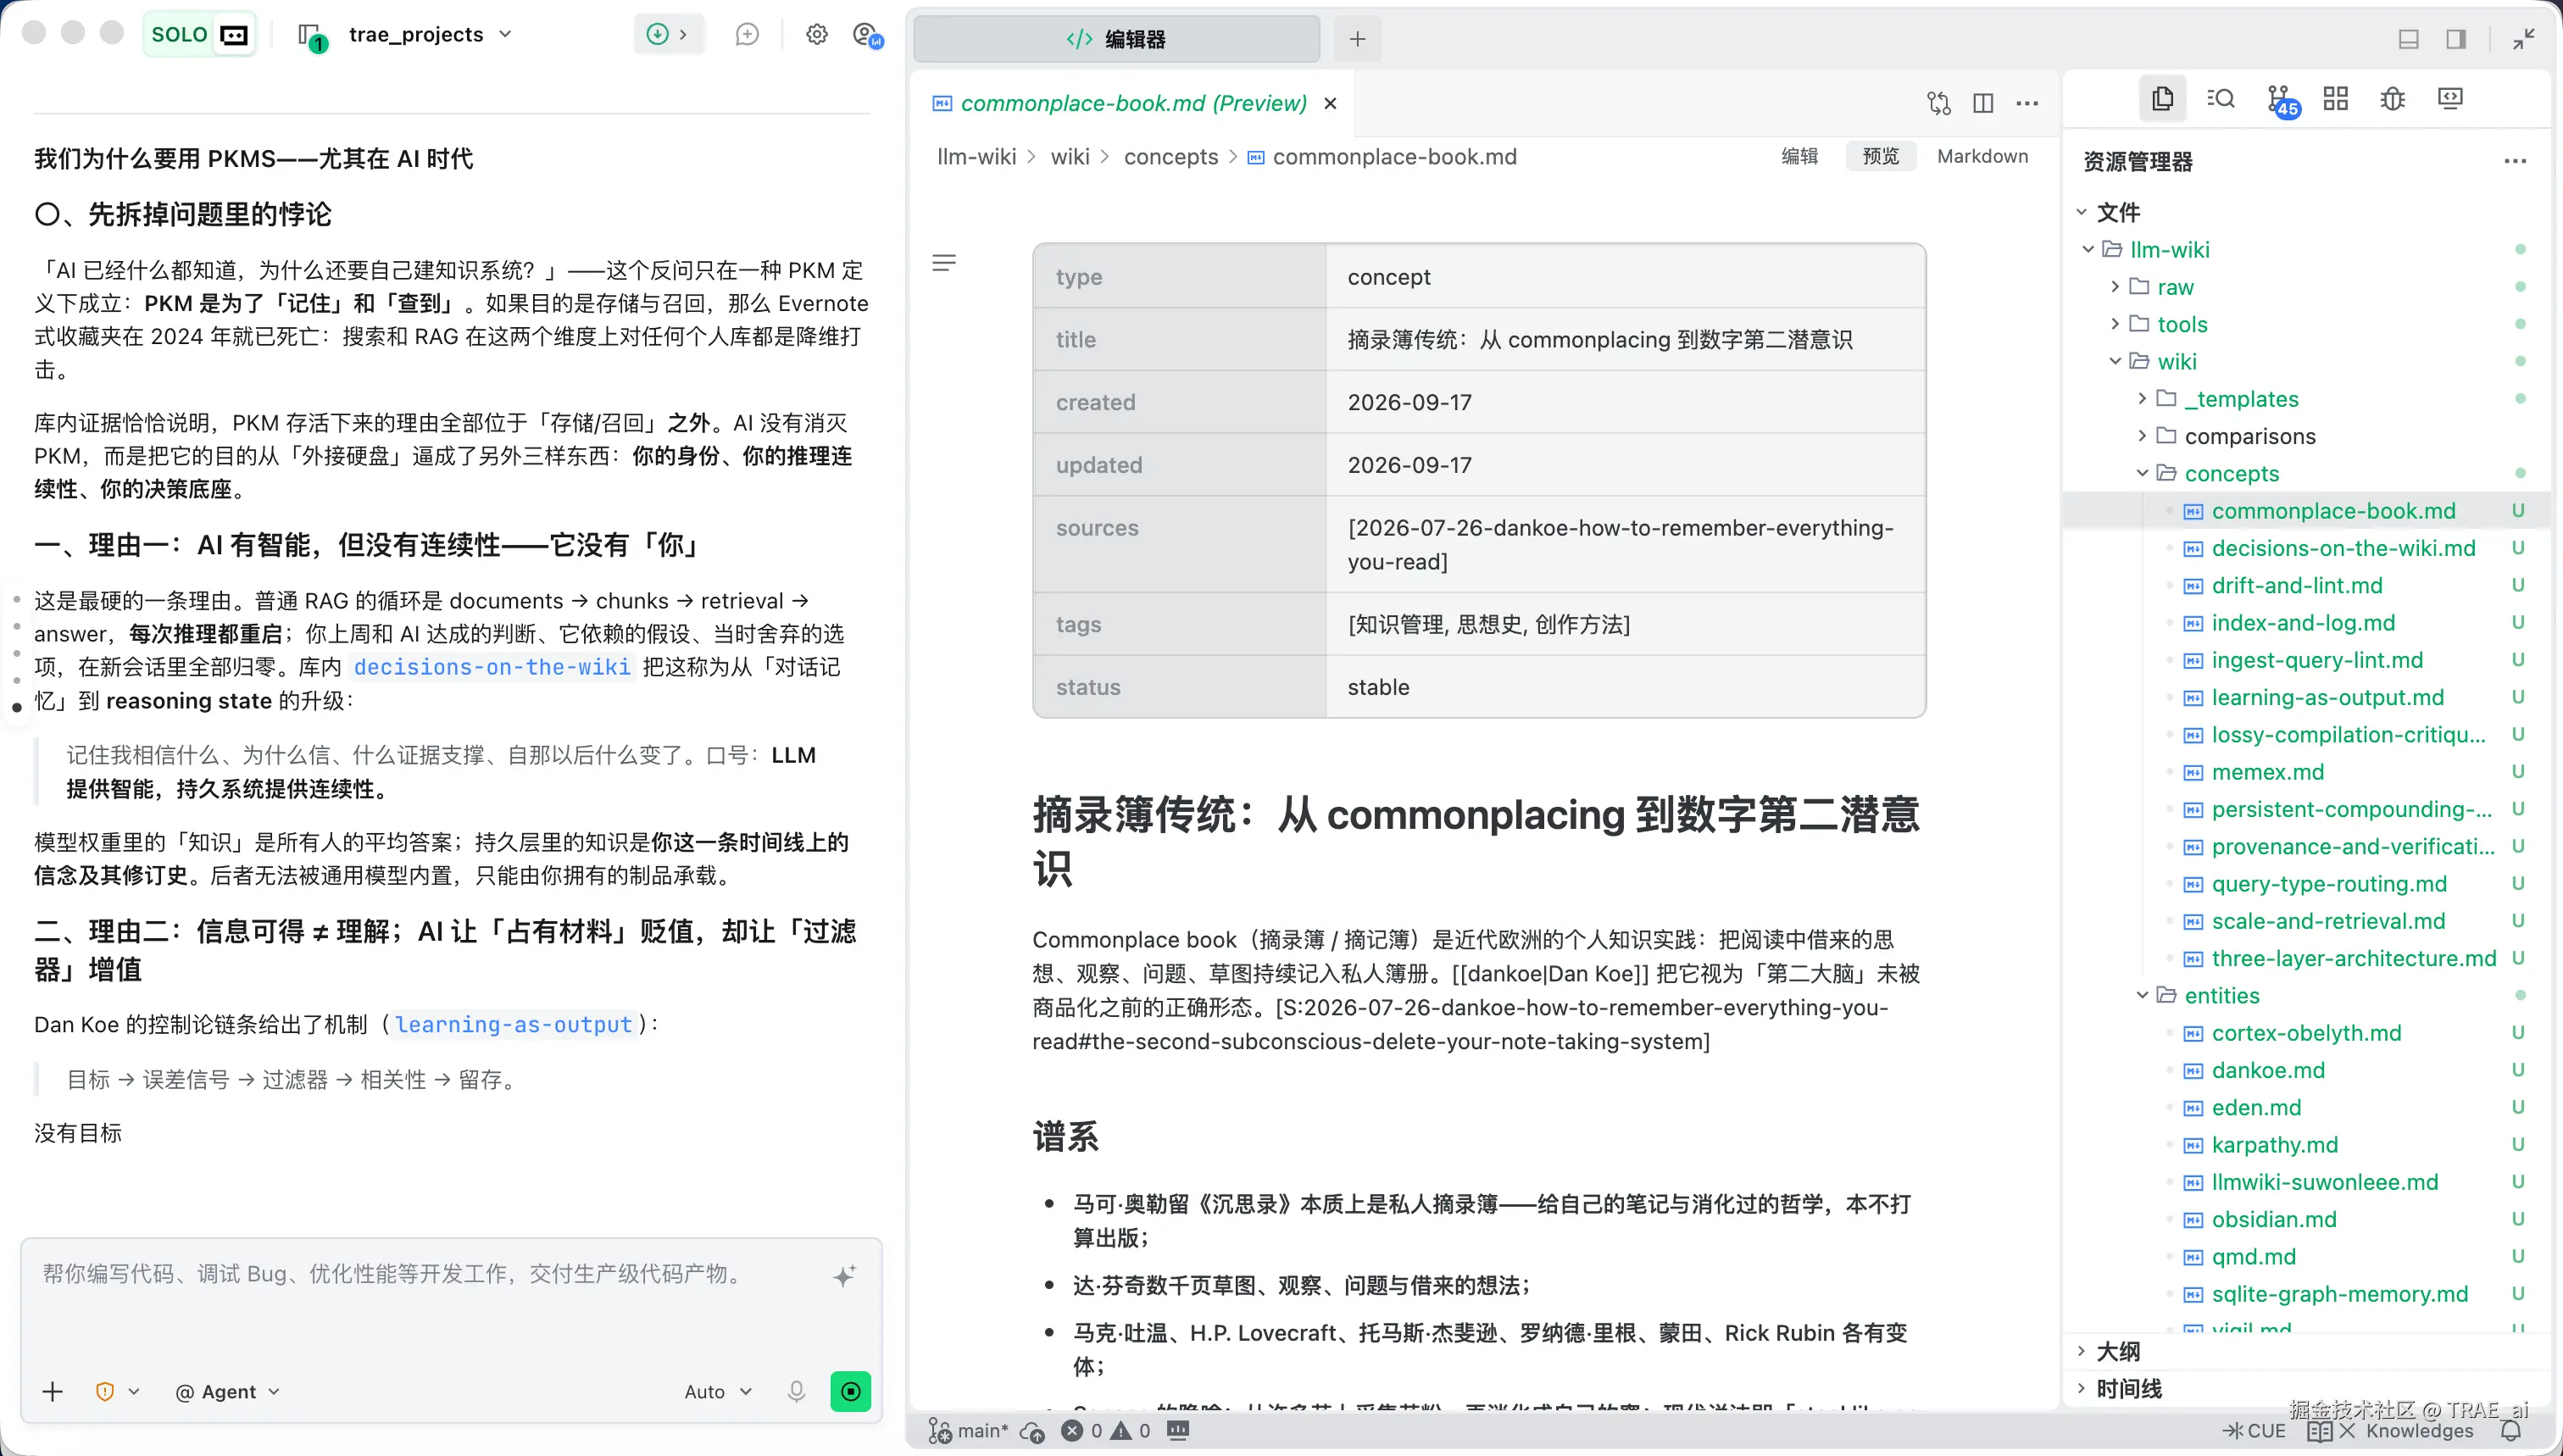
这是一个好问题,它不是简单的事实查询,而是要求跨多个素材综合分析的价值判断。TraeCode Agent 不会直接用训练数据回答,而是从 Wiki 中已有的知识出发。
第二步:LLM 定位并读取相关页面
LLM 首先读取 index.md 扫描全部 27 个页面,然后分两批读取了 9 个相关页面:
| 批次 | 读取的页面 | 读取原因 |
|---|---|---|
| 第一批 | personal-knowledge-management、second-brain、memex、karpathy-llm-wiki-gist | PKM 定义、核心方法论、历史原点 |
| 第二批 | commonplace-book、pkms-history-and-evolution、specific-knowledge | 创作燃料理念、历史脉络、不可替代性论证 |
加上之前已读的 limitations-of-traditional-pkms 和 llm-wiki-pattern,共涉及 9 个页面的内容。
第三步:综合分析,产生新洞见
LLM 不是简单拼接已有内容,而是跨素材综合后产出了 7 个关键发现,其中多个发现是任何单一素材中都不曾明确表述的:
新洞见 1:范式翻转,筛选比生成更昂贵
这个论点不是 Dan Koe 或 Karpathy 单独提出的。它综合了 Dan Koe 的引言("When AI can create anything, curation matters more than ever")和 Karpathy 对 LLM 维护成本的论述,推导出一个新结论:AI 时代 PKMS 的核心价值从「存储检索」转向「筛选判断」。
新洞见 2:特定知识价值上升
Naval Ravikant 的 specific-knowledge 概念原本是关于职业发展的。LLM 将其与 AI 时代的背景结合,推导出一个新论点:AI 使一般性知识商品化,特定知识因此更宝贵,PKMS 是捕获特定知识的工具。这个连接在原始素材中并不存在。
新洞见 3:PKM 动机的历史演进表
LLM 综合四个历史阶段(前数字→计算机→网络 PKM→AI 时代)的动机变迁,产出了一张跨时代的对比表,这张表在任何单一素材中都不存在,是跨页面综合的产物。
第四步:归档为综合页
LLM 将分析结果写入 wiki/syntheses/why-pkms-in-ai-era.md,包含:
-
YAML frontmatter(引用 3 个素材文件)
-
问题陈述
-
7 个主要发现(每个发现都引用了具体素材页面)
-
两张对比表(能力对比 + 动机演进)
-
结论(一句话概括)
-
素材列表(4 个 Wiki 页面引用)
第五步:更新索引和日志
lua
index.md: 页面总数 27 → 28
log.md 追加:
## [2026-08-06] query | AI 时代为什么需要 PKMS
- 阅读页面:[[personal-knowledge-management]], [[second-brain]], [[memex]],
  [[karpathy-llm-wiki-gist]], [[commonplace-book]], [[specific-knowledge]],
  [[pkms-history-and-evolution]], [[limitations-of-traditional-pkms]], [[llm-wiki-pattern]]
- 创建综合页:[[why-pkms-in-ai-era]]
- 分析维度:认知延伸、创作燃料、关联涌现、筛选价值、特定知识、维护瓶颈、AI 赋能新能力
- 更新索引:28 个页面,3 个素材
对话前后的知识库变化
这次综合分析让 Wiki 从 27 页增长到 28 页,综合页从 1 个增加到 2 个。新综合页被 limitations-of-traditional-pkms 和本教程引用,产出了 3 个跨素材洞见:范式翻转、特定知识上升、动机演进。
关键观察:这次对话不是简单的信息检索,用户提出的是一个需要价值判断的问题,LLM 通过跨页面综合产出了任何单一素材中都不存在的新洞见,并将其固化为知识库的新节点。这就是「通过对话产生新知识库内容」:对话本身就是知识生产的引擎。
与 RAG 的本质区别:RAG 每次查询都从零开始检索原始文档,知识不积累,查询不产生新知识。LLM Wiki 的每次查询都站在已有综合的肩膀上,查询 why-pkms-in-ai-era 时,LLM 已经可以引用 limitations-of-traditional-pkms 的分析,而不必重新推导。知识持续增长,每次对话都让 Wiki 更丰富。
3.6 巡检:让系统自我维护
随着 Wiki 增长,页面间的矛盾、过时信息和孤立页面会逐渐积累。巡检(Lint)工作流让 LLM 定期健康检查。
巡检检查项
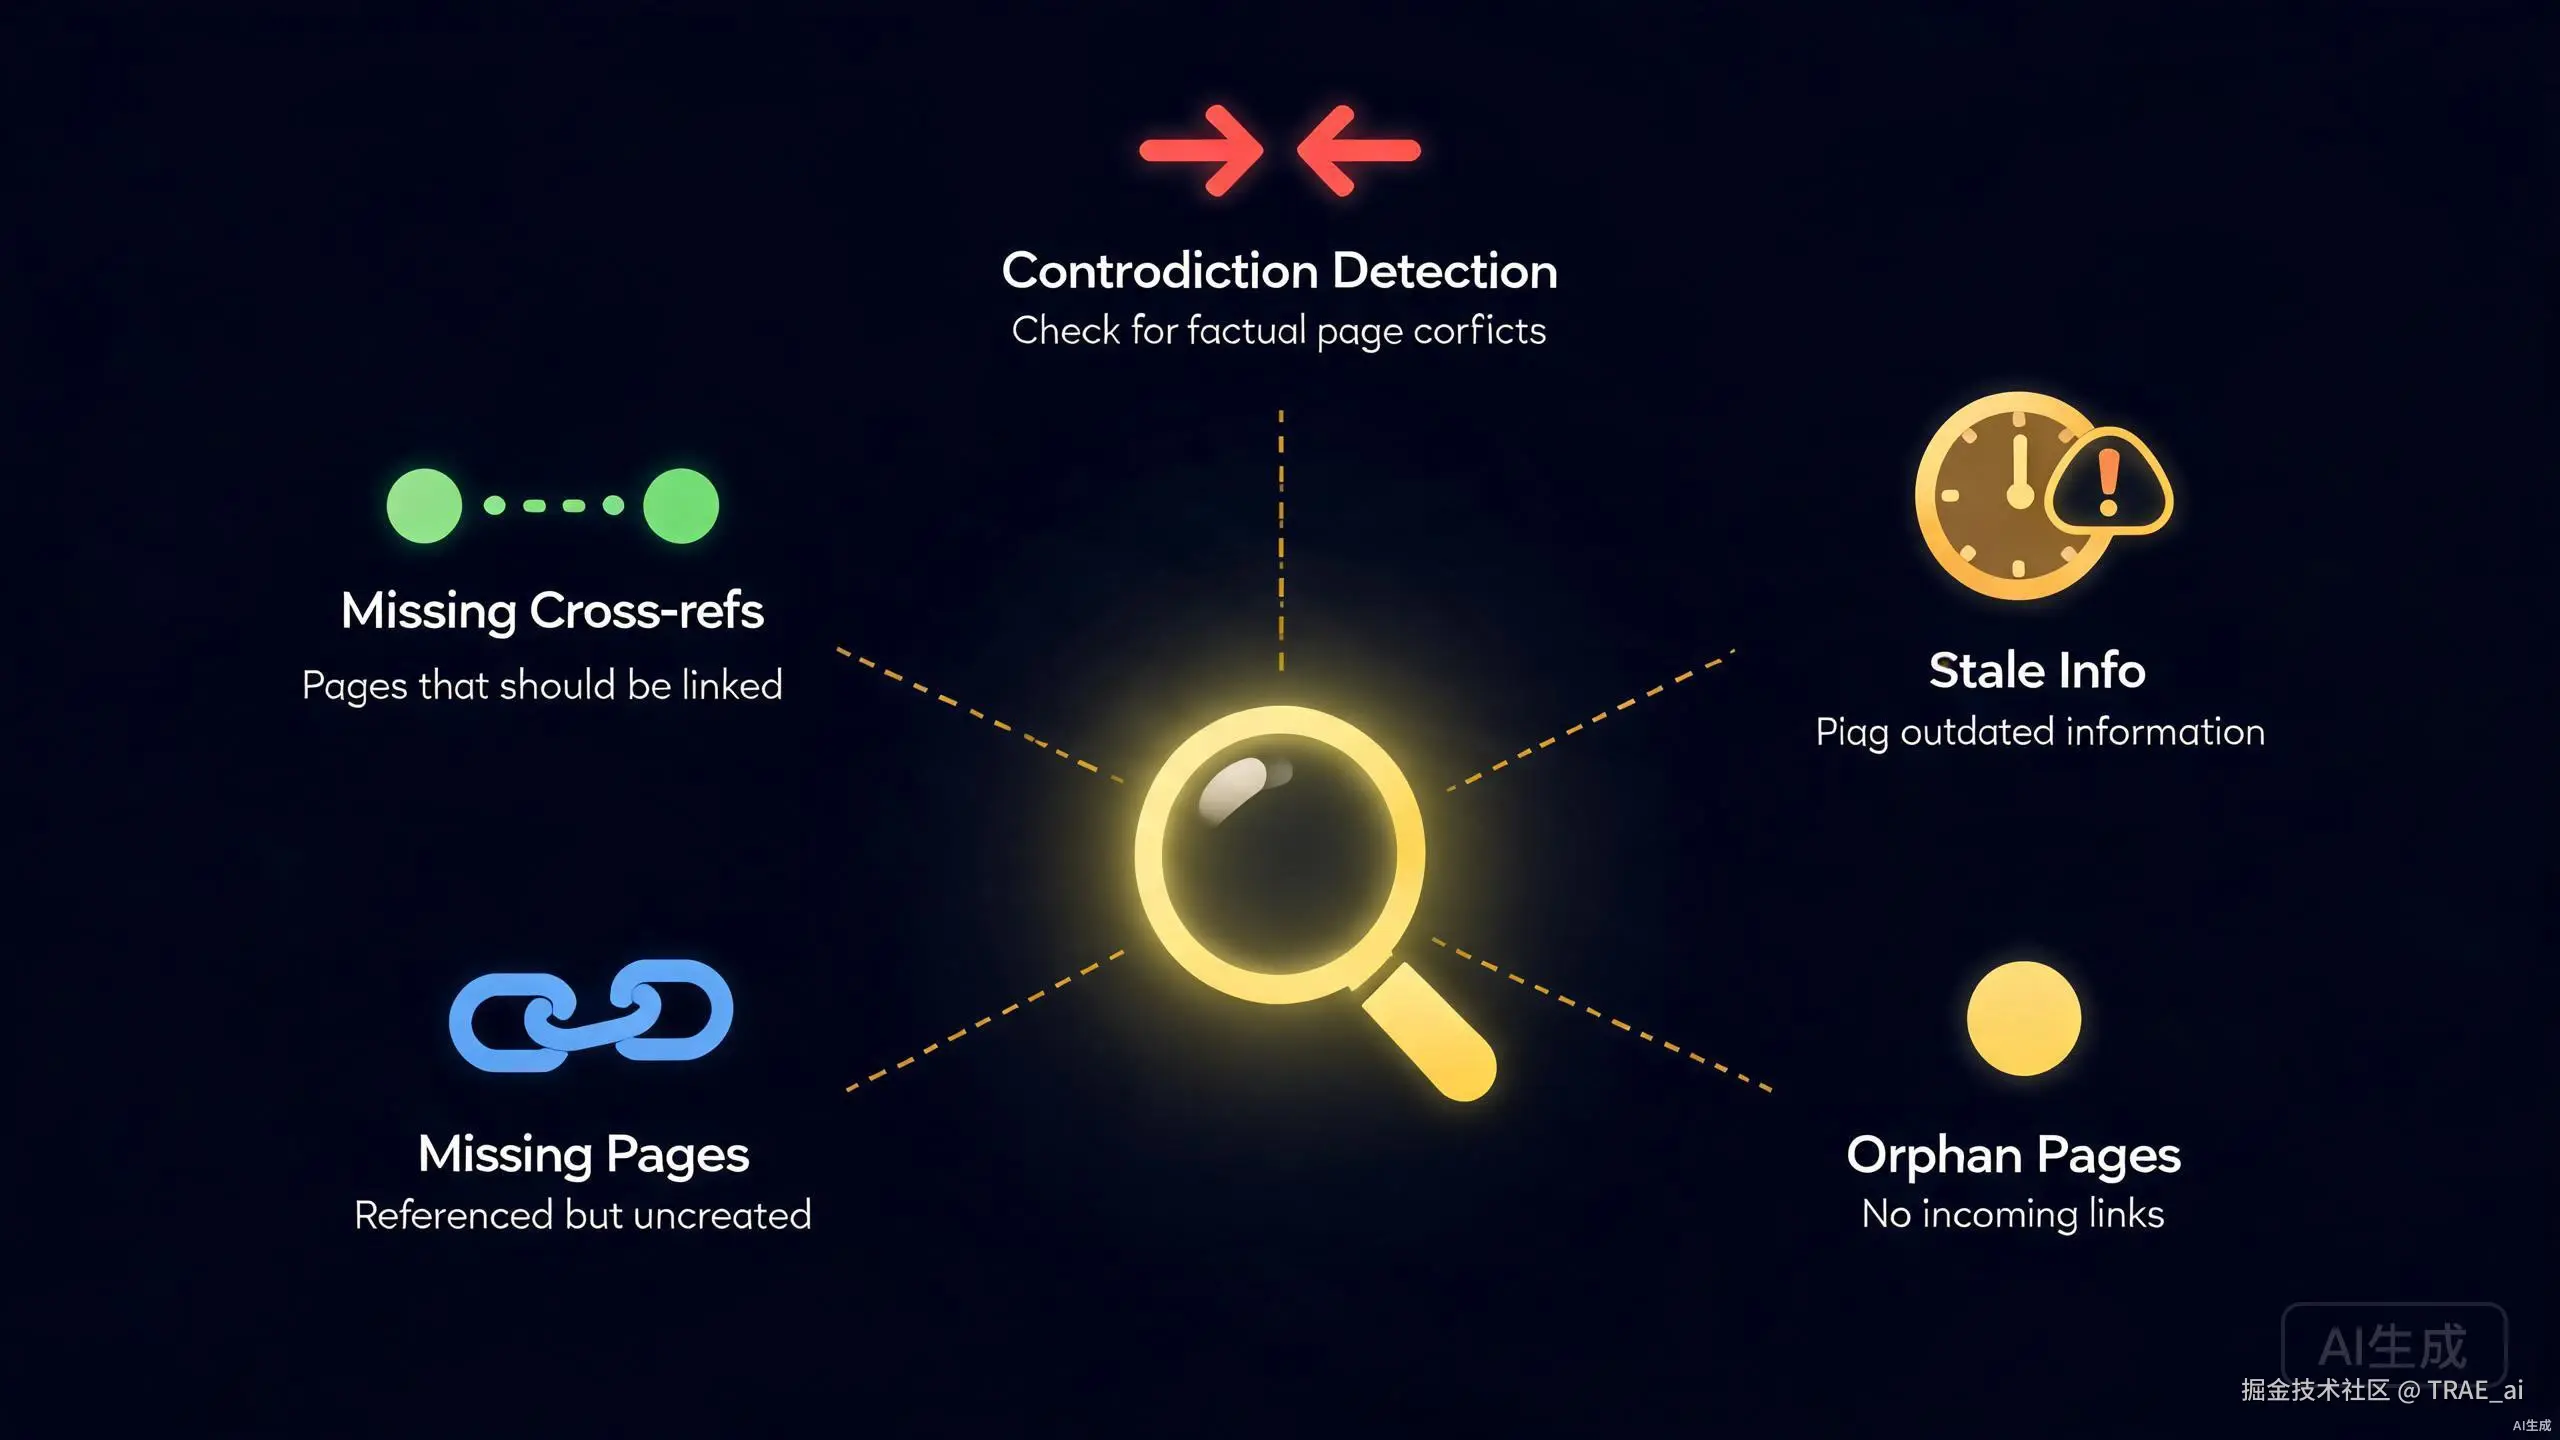
LLM 对明显问题(如缺失交叉引用、孤立页面)直接自动修复,对需要判断的问题(如矛盾、过时信息)生成报告供用户决策。巡检记录会追加到 log.md 中。
3.7 系统进化:从提取到升级的真实案例
前面我们展示了系统的标准操作流程,提取、交叉引用、研究提取、查询、巡检。但 Wiki 系统最令人兴奋的特性不在这些操作之中,而在于一个更深层的能力:系统能够在使用过程中自我进化。
接下来的案例中我们通过提取一篇新文章,产生了对系统的改进想法,然后让 TraeCode 完成了升级。
起因:提取 Dan Koe 的文章
在系统运行过程中,我们提取了 Dan Koe 在 X 上发布的一篇关于「第二潜意识」的长文(dan-koe-second-subconscious)。提取过程照例创建了 7 个新页面并更新了 3 个已有页面(详见 3.3 节的案例)。
但这次提取有一个额外的产出,一个关于系统本身的洞察。Dan Koe 在文中提出:「不要从学习开始,要从项目开始」。这个观点与 Karpathy 的 LLM Wiki 模式有一个尚未被覆盖的交集:系统有提取、查询、巡检三个操作,但没有一个操作专门承载「创作项目」。
从洞察到行动:提出系统升级
在使用系统的过程中发现系统自身的不足,这正是「使用驱动进化」的典型案例。在传统 PKMS 中,发现工具不够用时只能等待工具更新或切换工具。而在 LLM Wiki 中,我们可以直接修改模式文件来扩展系统能力。
只需要对 TraeCode 说:
我非常认可 Dan Koe 关于不要从「学习」开始,而要从项目开始的观点,
我应该如何在当前的 wiki 系统中增加一个项目的概念
TraeCode 理解了需求,并执行了完整的系统升级。
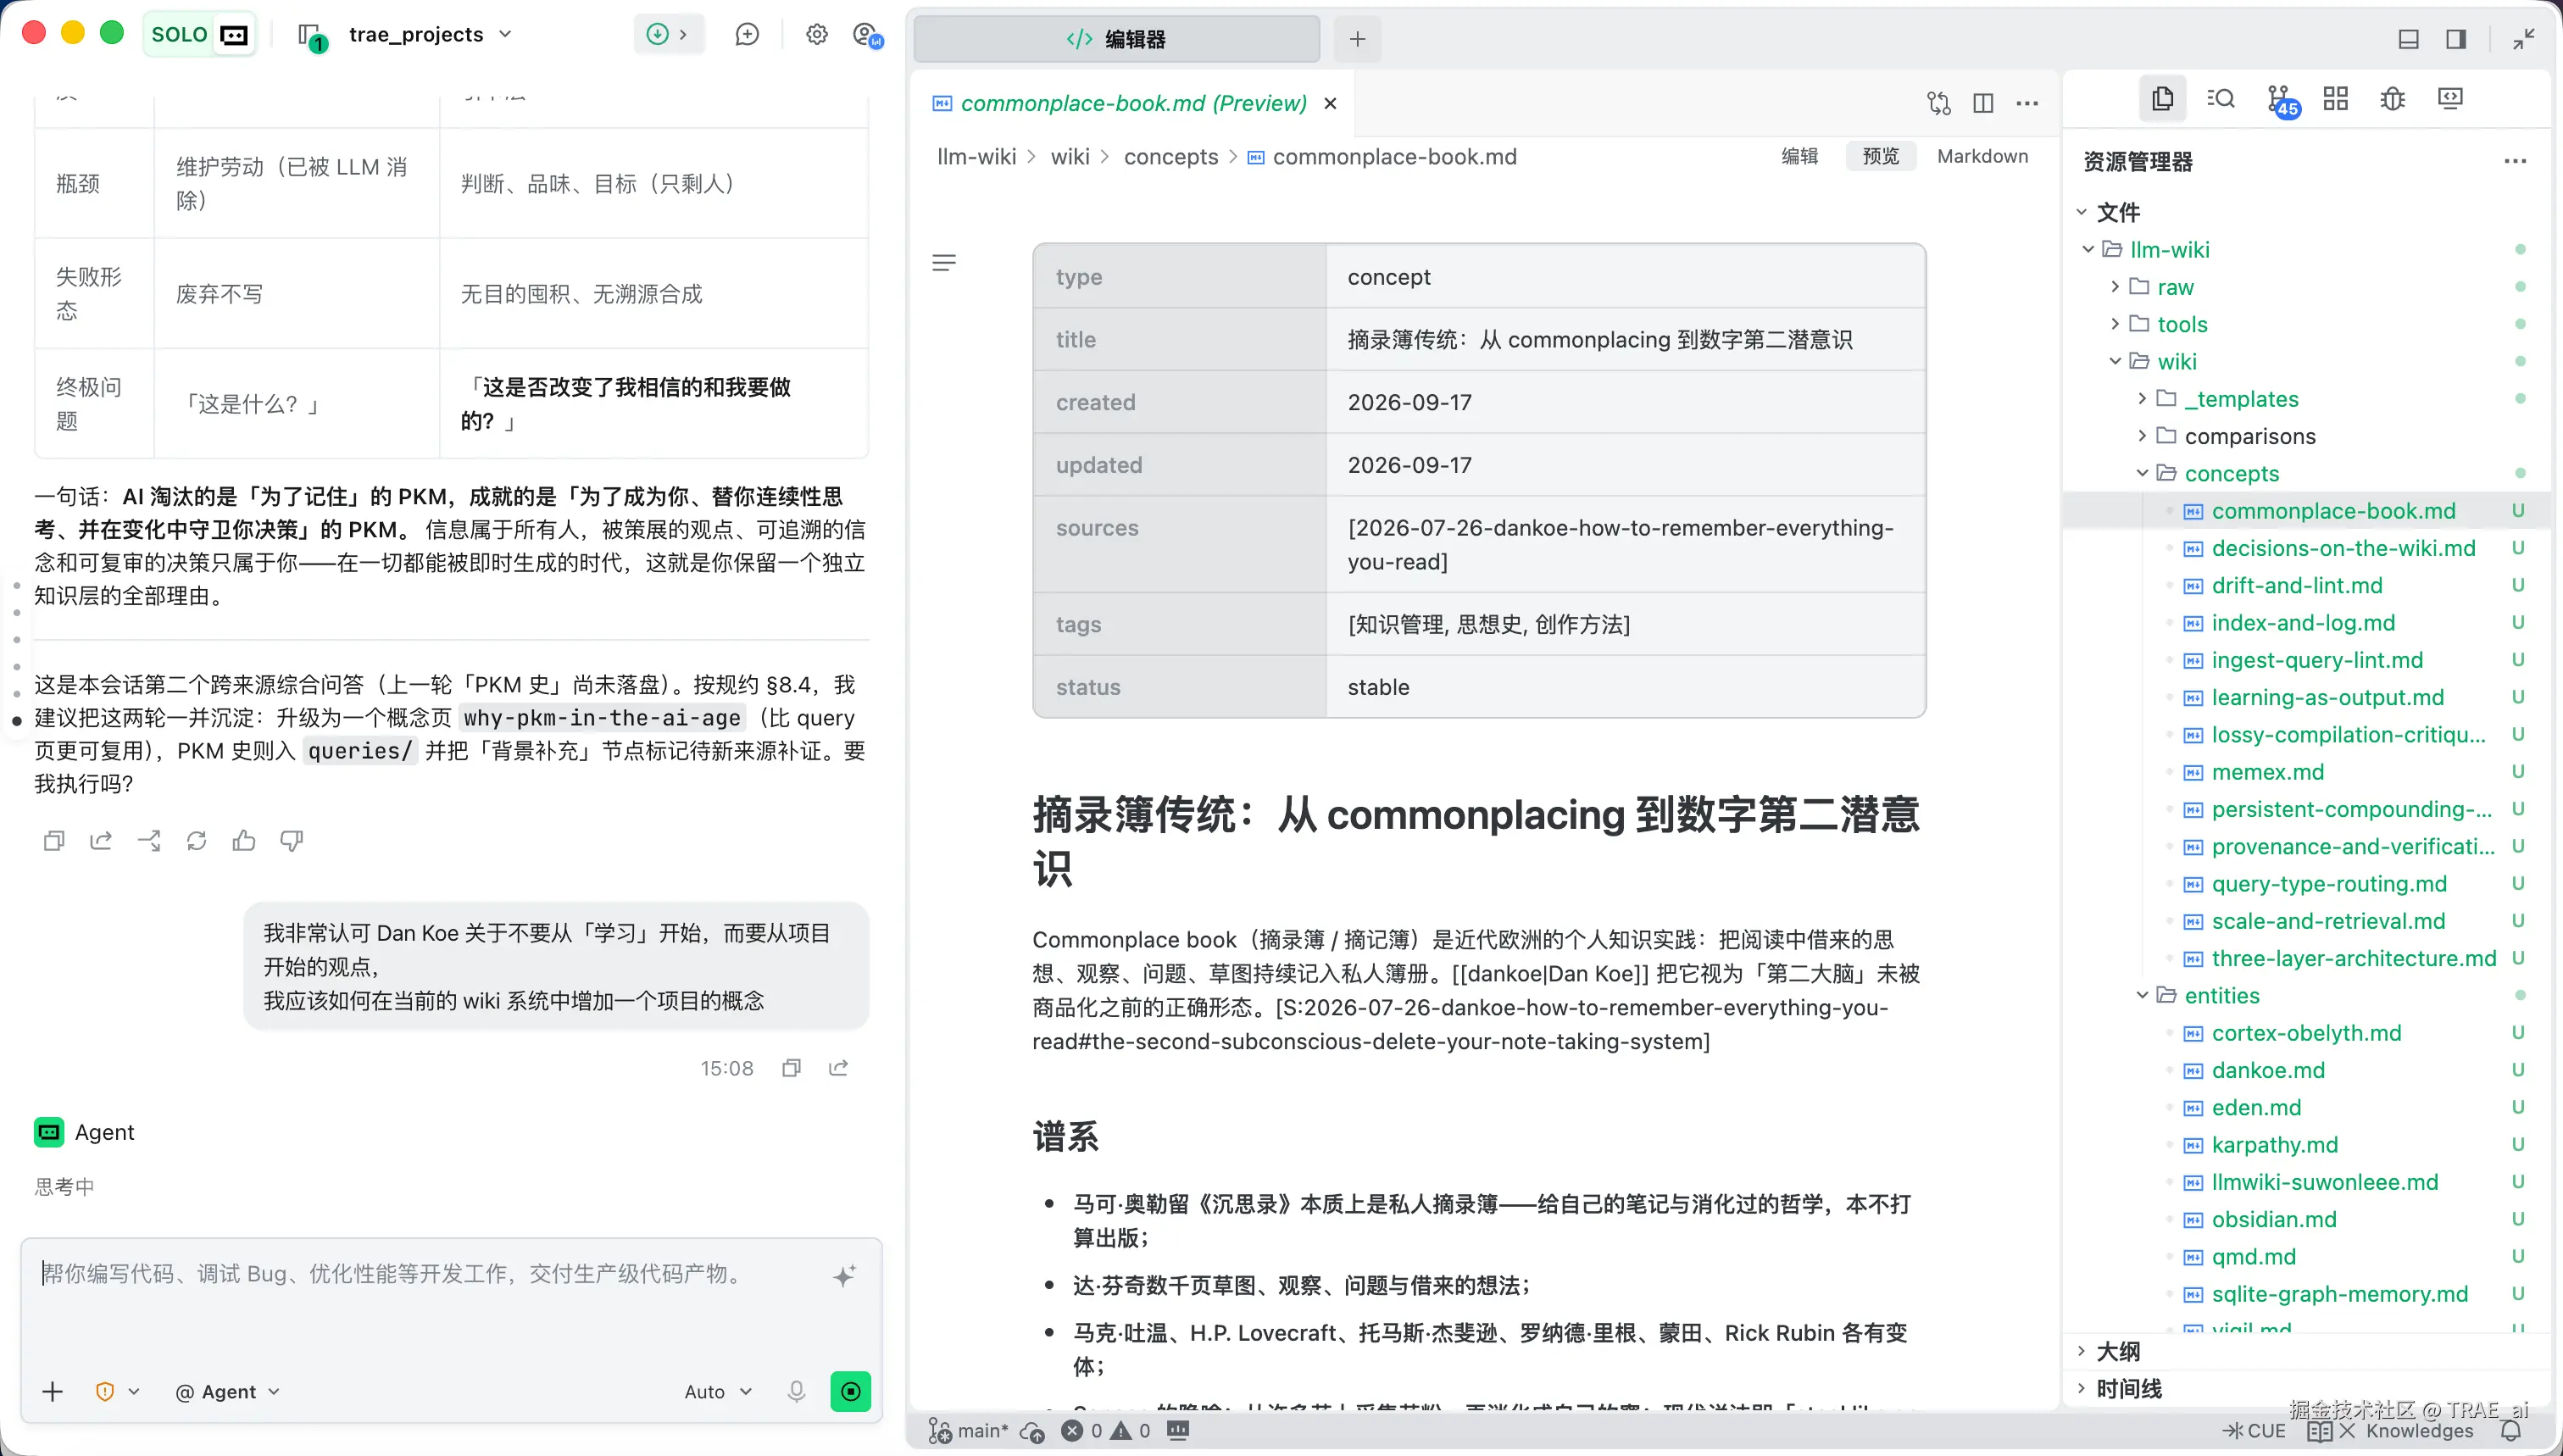
升级全过程
这次升级不是简单的文件修改,而是一套涉及多个文件的系统性变更:
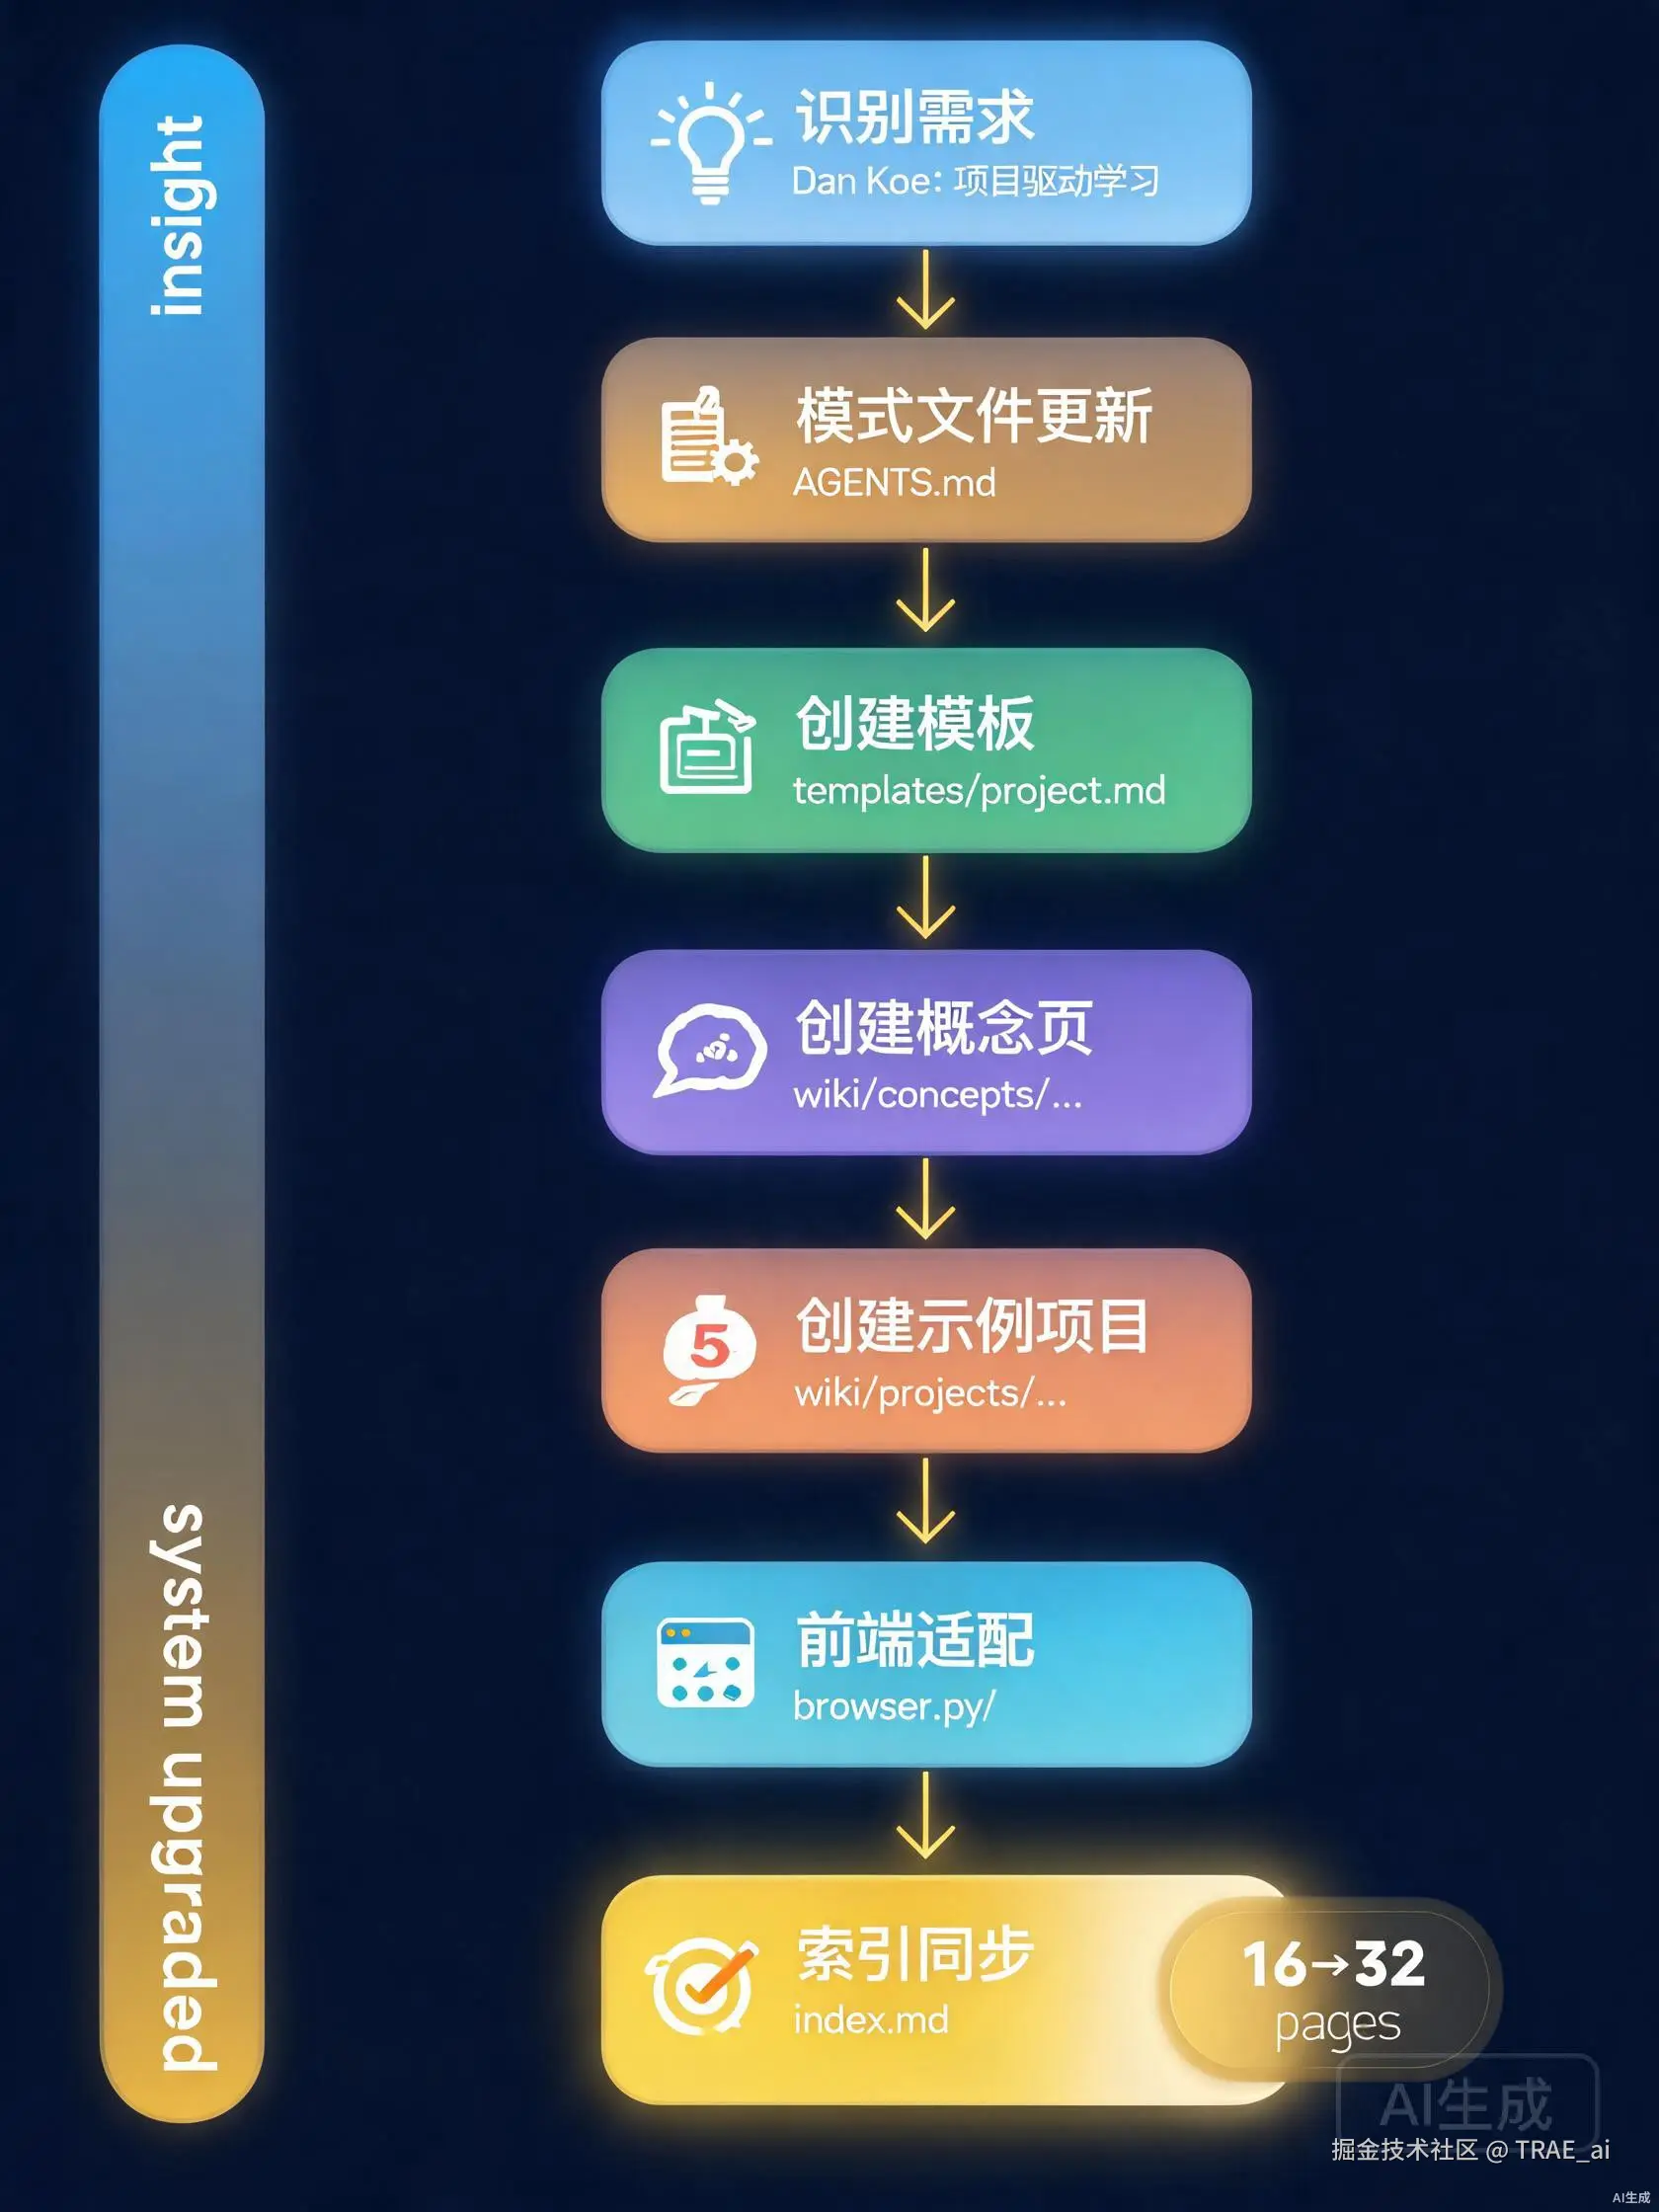
整个过程的核心是第 2 步,更新 AGENTS.md 模式文件。因为 AGENTS.md 是给 TraeCode 的操作手册,一旦它定义了「项目页」这个新类型,LLM 在后续所有会话中都会自动遵循新的规则:知道项目页放在 wiki/projects/、知道项目页的 frontmatter 需要包含 deadline 和 status、知道项目工作流有从 idea 到 archived 的完整生命周期。
模式文件的可演化性
这次升级揭示了三层架构的一个关键设计:模式文件是可演化的。
-
raw/(第一层):不可变,素材一旦存入,永不修改 -
wiki/(第二层):可增长,LLM 持续添加新页面 -
模式文件(第三层):可演化,AGENTS.md 可以随需求扩展
这三层的变易性形成了一个梯度:越底层越稳定,越上层越灵活。原始素材是事实的根基,Wiki 是知识的网络,模式文件是系统的 DNA,修改模式文件就等于修改系统的行为规则,所有后续操作都会自动遵循新规则。
3.8 创建项目:知识库为创作提供燃料
系统通过上一节的进化获得了「项目」能力后,我们就可以在用项目来驱动创作了。项目是知识库的消费者和生产者,所以它也应该存在这个 Wiki 系统中,基于 Wiki 中积累的知识和洞察进行创作,你当前正在读的这篇文章就是在 Wiki 系统中作为项目页创建和推进的。
项目页结构
项目页(wiki/projects/ 目录)承载创作目标,引用知识库中的材料作为燃料,追踪工作流进展。每个项目页包含:
-
目标:项目的核心目标,这就是 cybernetics 中的「参考信号」。目标越清晰,学习过滤越精准
-
知识库引用:扫描已有 sources/concepts/entities,引用相关材料;标记知识缺口(待提取清单)
-
工作流:按 脑暴 → 大纲 → 草稿 推进,在项目页中记录进展
-
产出与回编:项目完成后将产出提取为新素材
我们再来看一个案例:这篇文章是如何创作的
以下是你正在读的这篇文章的真实创作过程,完整展示了项目工作流如何从知识库中汲取燃料。
第一步:创建项目页
用户对 TraeCode 说
Plain
开始一个新项目,我将要写一篇如何用 TraeCode 构建个人知识管理系统的文章TraeCode 开始 在 wiki/projects/ 创建了项目页,设定 status: idea,并自动扫描知识库,在「知识库引用」中列出了 20 个相关页面:
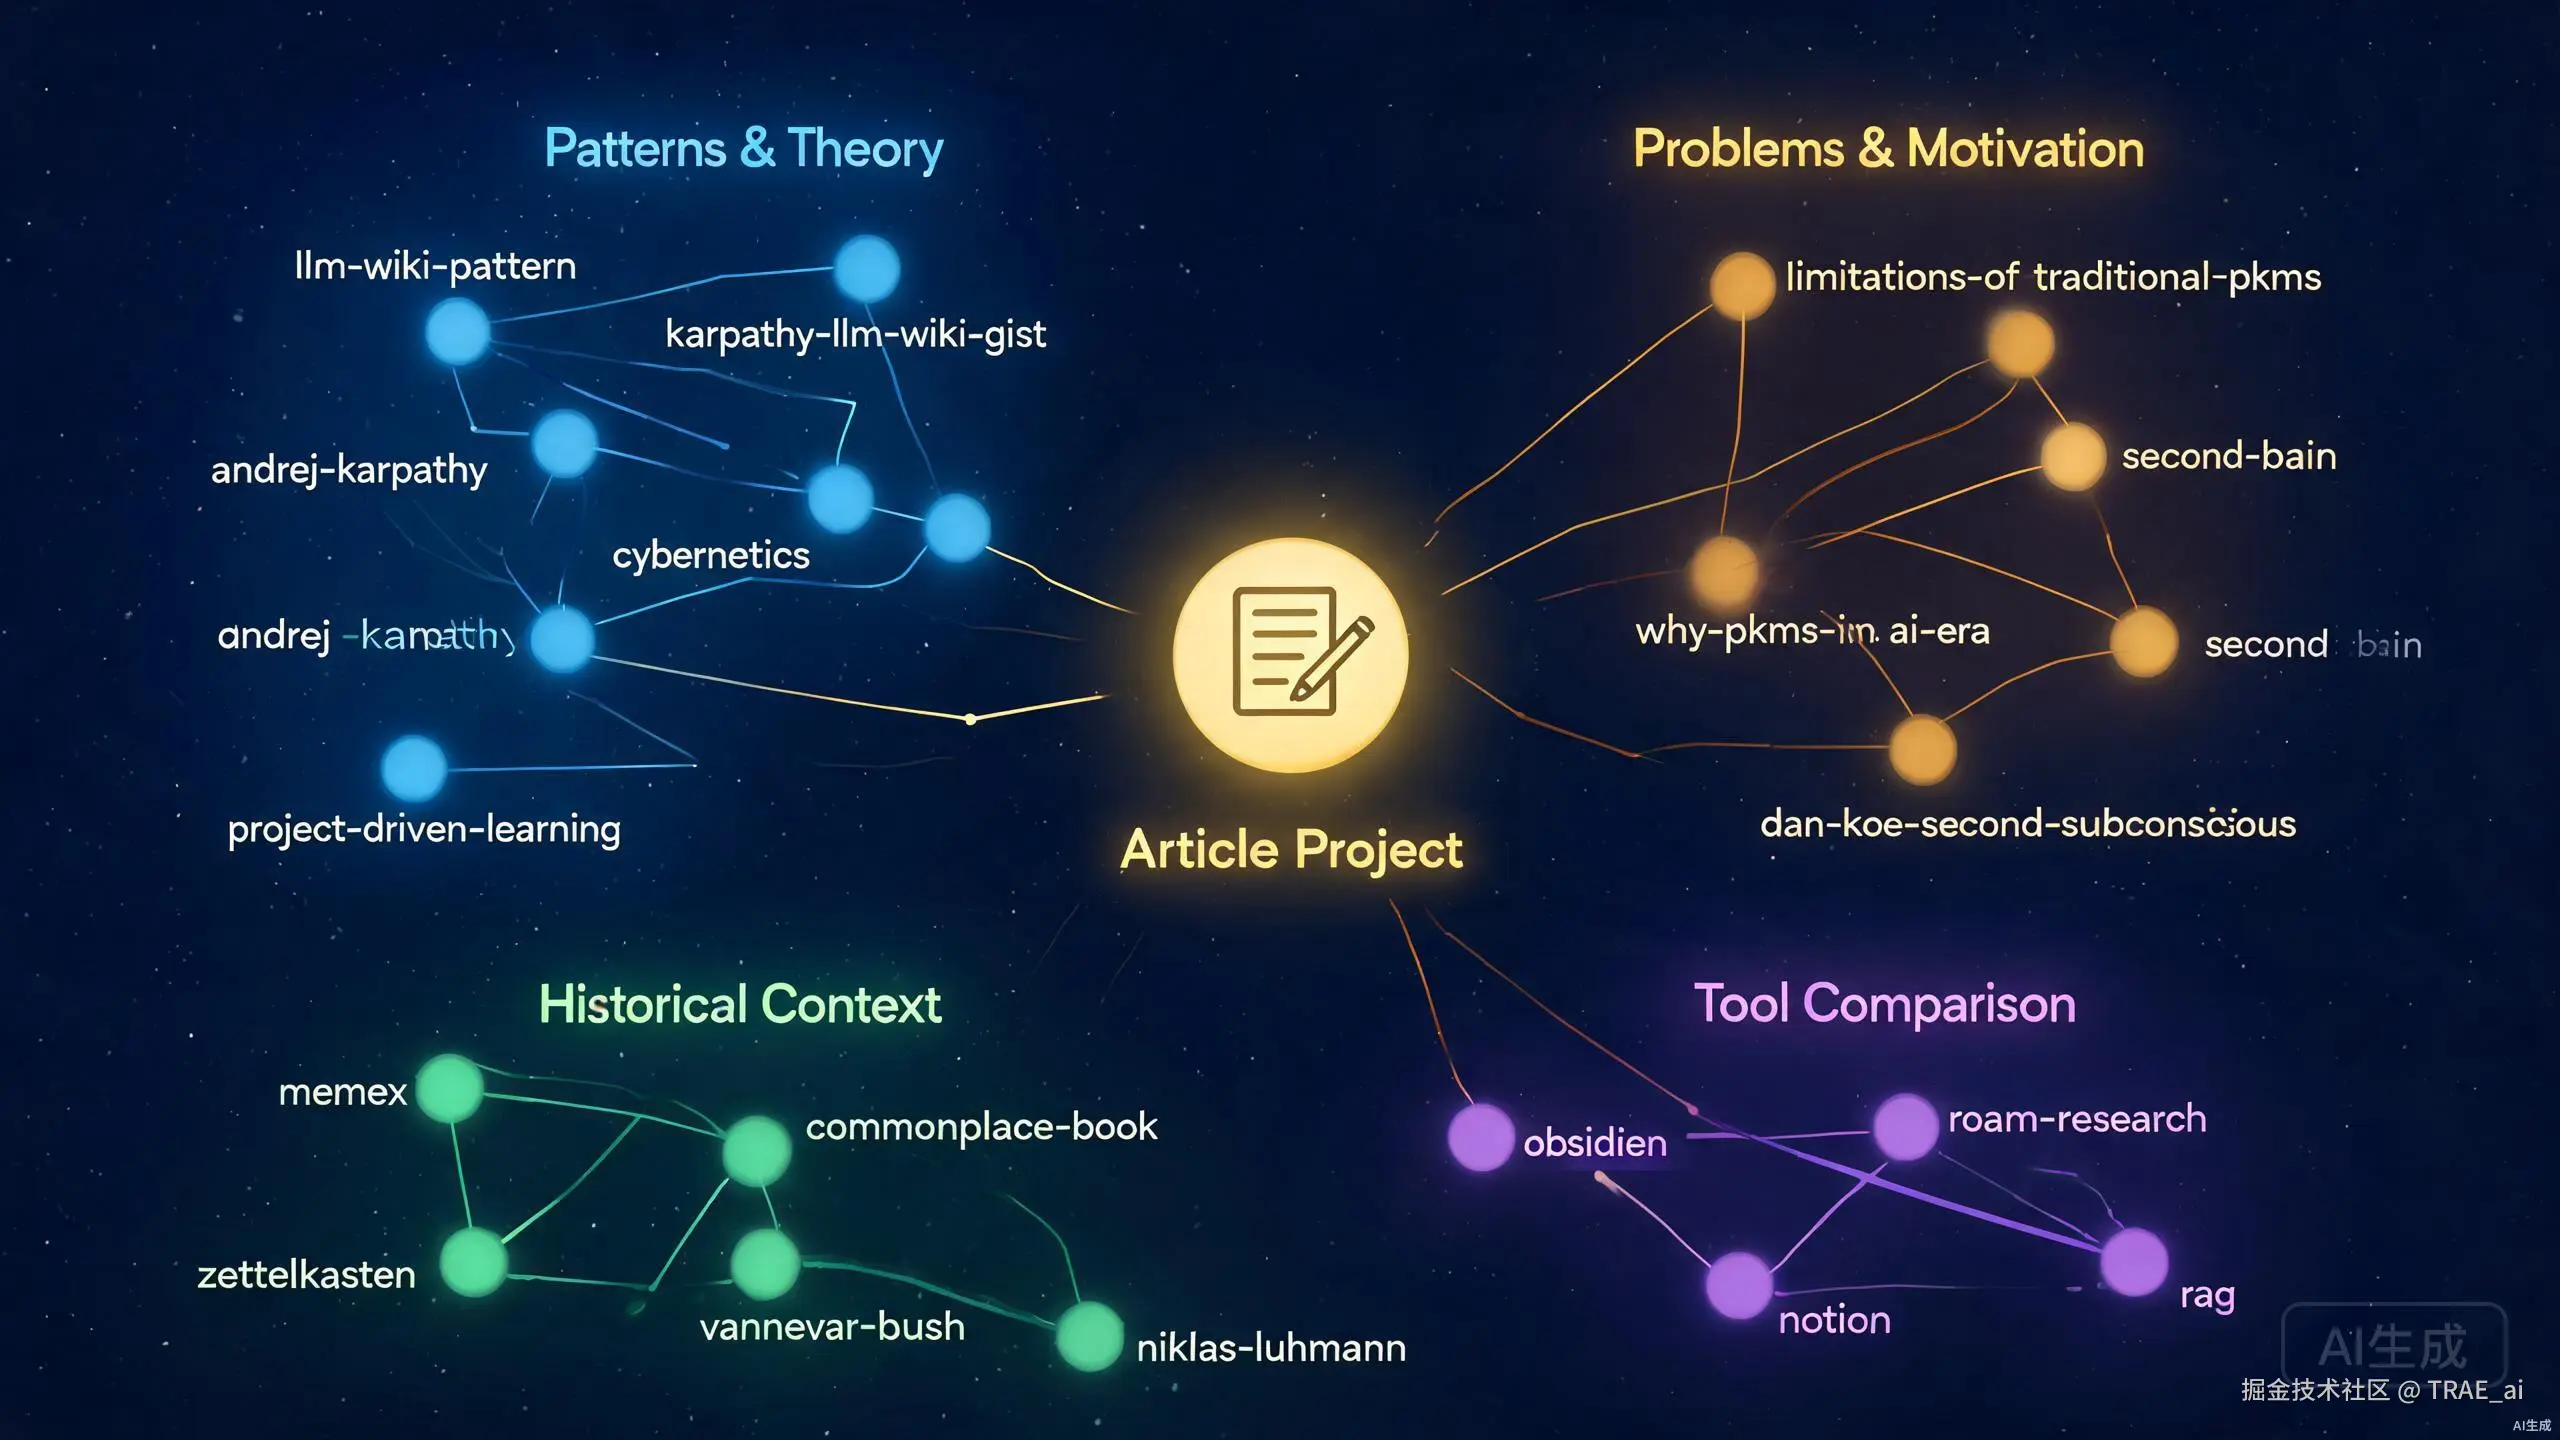
同时标记了 3 个知识缺口:Karpathy X thread 原文、TraeCode 官方文档、操作截图。
第二步:脑暴
LLM 基于知识库引用生成脑暴,确定核心叙事线:从 Karpathy 的 X thread 引爆社区,到开源 idea 文件,到 Dan Koe 的问题诊断,再到用 TraeCode 实践。脑暴中还产生了几个关键洞察,比如「Dan Koe 诊断问题 + Karpathy 提供解药」的汇流叙事,以及控制论视角贯穿全文的叙事设计。
第三步:大纲
经历多轮迭代大纲。初版从 Memex 历史讲起,而后后调整为从 Karpathy 的推文切入。第二章引入 Dan Koe 的观点后,重构为「问题诊断 + 历史脉络 + 汇流」三段式。中间还删除了独立的「三层架构」章节和「RAG 对比」章节,因为前者已融入实践章节,后者已融入第二章。每次大纲调整,LLM 同步更新项目页中的大纲文本,保持脑暴、大纲、草稿三处编号一致。
第四步:草稿
草稿按章节推进。第一章引用了 Karpathy Gist 的原文和三层架构定义;第二章综合了 dan-koe-second-subconscious、memex、zettelkasten 等页面的内容,产出了控制论四要素模型和 80 年历史脉络;第三章基于真实操作记录撰写,将 why-pkms-in-ai-era 的对话过程作为查询案例,将 Dan Koe 文章触发系统升级作为进化案例。
第五步:产出与回编
文章完成后,将作为新素材提取回知识库:保存为 raw/building-pkms-with-trae-work.md,创建素材摘要页,更新相关实体和概念页的交叉引用。
知识闭环
知识库(sources/concepts/entities)→ 为项目提供燃料 → 项目产出 → 提取为新素材 → 知识库增长。这个闭环是系统的核心价值,知识不只是在仓库里堆积,而是被项目消费、重组、产出新知识,新知识又回流入知识库。
这篇文章就是闭环的活样本:它引用了知识库中 20 个页面的内容,写作过程中又产出了新的综合分析(如 Dan Koe 与 Karpathy 的汇流叙事),完成后将回编为新素材,让知识库变得更丰富。
3.9 实时浏览:Wiki 浏览器
由于 TraeCode 也具备强大的 Coding 能力,在搭建完系统后,同样还是在这个 TraeCode 项目里面,我们还让 TraeCode 自己构建了一个 Wiki 浏览器,用于实时浏览和导航 Wiki 中的所有页面。
浏览器功能
-
三栏界面:左侧页面列表(按类别分组 + 实时搜索)、中间 Markdown 渲染(含 frontmatter 元数据卡)、右侧力导向知识图谱
-
节点跳转 :点击
[[wikilink]]链接、侧栏页面项、或图谱节点均可导航到目标页面 -
实时刷新:每次刷新重新扫描文件,反映最新内容变更
-
深色/浅色主题切换
Wiki 浏览器启动后自动扫描项目中所有 .md 文件,解析 frontmatter 和 wikilink,构建页面关系图谱,并提供交互式的前端界面。
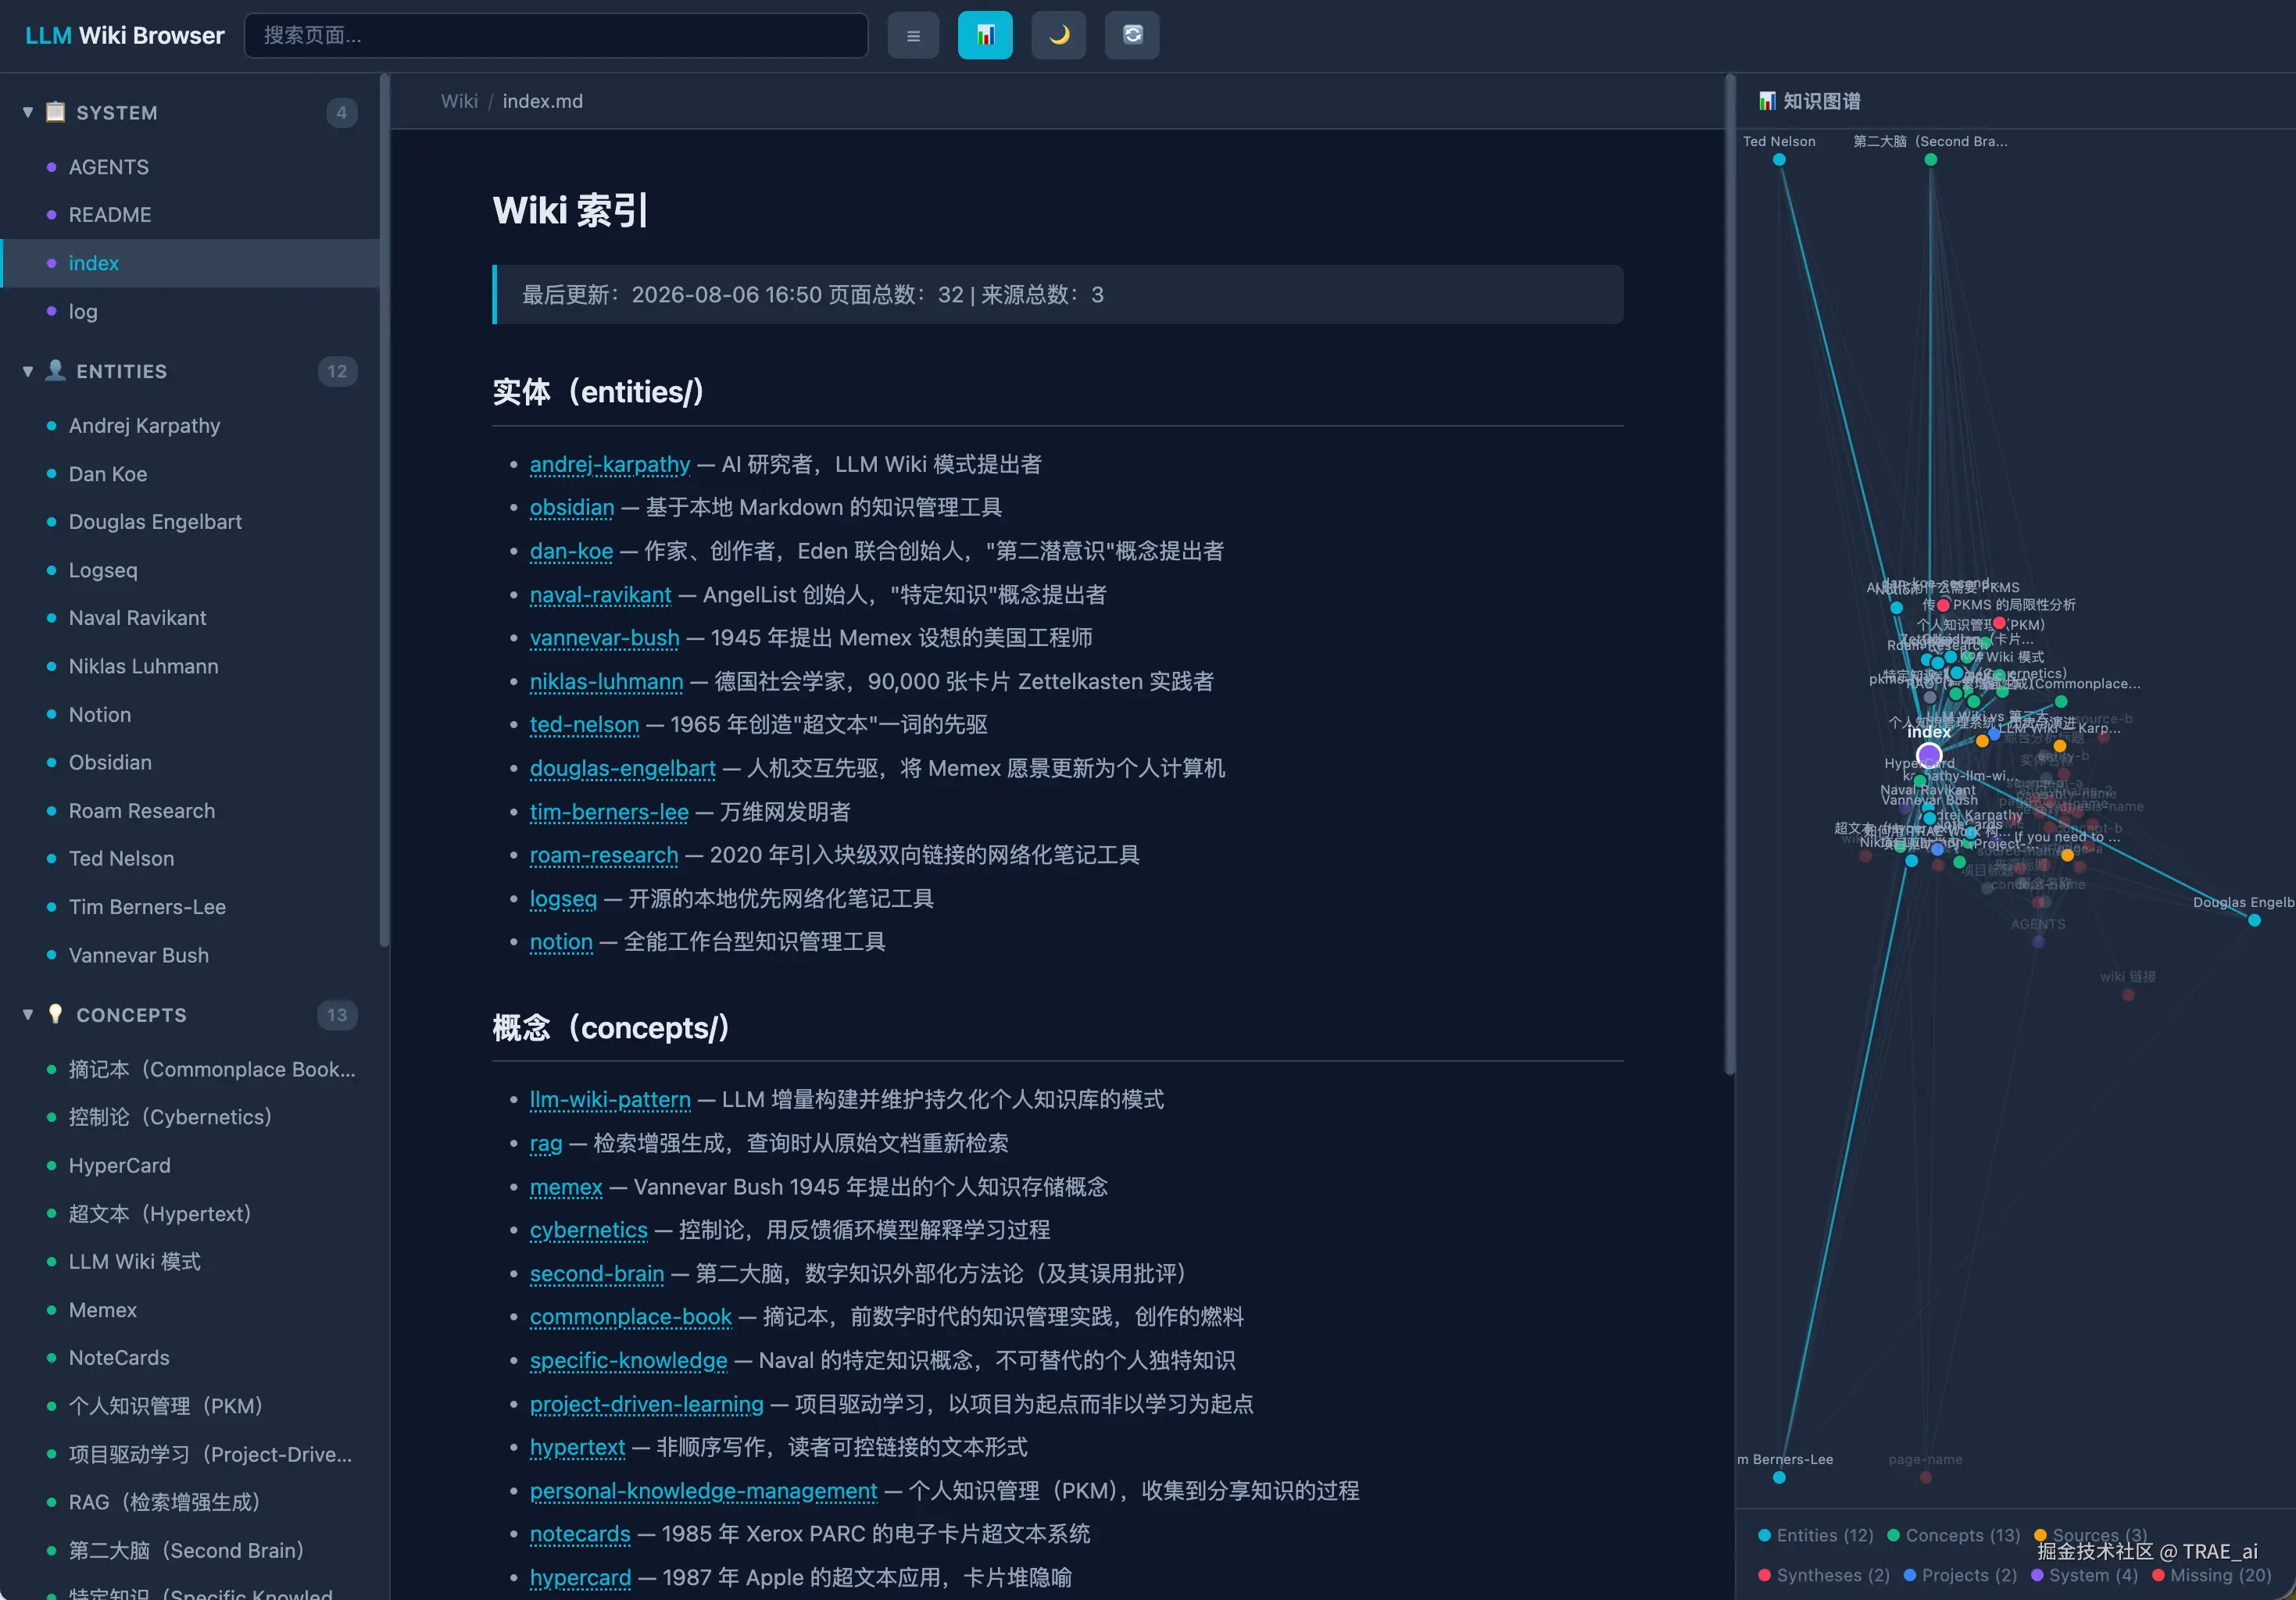
将浏览器沉淀为 Skill
为了让后续会话能快速启动预览,我们将浏览器的启动流程封装为 TraeCode 的 Skill(.trae/skills/wiki-browser/SKILL.md)。后续只需说「打开 Wiki 预览」,LLM 就会自动检查服务器是否在运行、如未运行则启动、然后打开预览页面。
写在最后:不止是知识管理,更是一个自闭环的创作引擎
我们解决的核心问题其实只有一个:谁来维护知识库。
80 年来工具不断进化,但维护负担始终压在个人身上。LLM Wiki 模式让 LLM 直接承担维护本身:人类只做策展来源、探索方向、提出好问题,LLM 负责全部的阅读、摘要、交叉引用、矛盾检测。知识库不再需要人维护,它自己维护自己。
而让这一切成为可能的,是 TraeCode。
整套系统在 TraeCode 中自闭环运作:从摄取、查询、巡检到项目产出,每个操作都用自然语言驱动,无需切换工具或安装依赖。系统能升级自己:摄取一篇文章后意识到缺少「项目」类型,直接告诉 TraeCode,它就修改模式文件、创建模板、适配前端,完成自我进化。
基于 TraeCode 的 Coding 能力和 Skill 生态,系统还能自己构建前端应用(Wiki 浏览器)并沉淀为可复用技能,未来可随时扩展语义搜索、知识图谱可视化等能力。这篇文章本身也是系统的产物,它的提纲基于知识库中 20 个页面的交叉引用,完成后将回摄为新来源,形成知识库→创作→回流的完整闭环。
从一条推文到一套自闭环系统跑通,整个过程不超过一天。你提供想法和方向,TraeCode 负责实现。这或许就是 AI 时代知识管理的最终形态:不是更好的存储工具,而是一个能读、能写、能维护、能进化、能创作的知识伙伴。