一个 313MB 的加密包
事情的开头特别不起眼。有开发者清理磁盘时顺手看了一眼家目录,发现 ~/.zcode 占了七百多兆。这目录平时没人会去看,它只是智谱官方 AI 编程桌面应用 ZCode 的数据根目录。往下翻,cli/ 占 257MB,是会话数据库和执行日志;computer-use/ 占 130MB,是打包进去的运行时依赖;真正占大头的是 v2/checkpoints/,约 303MB。
checkpoints 这名字听着人畜无害,像是「检查点、可回滚」之类的本地缓存。打开之后,里面躺着一个 313MB 的 .enc 文件,旁边是一个 JSON 状态文件:
json
{
  "workspacePath": "/Users/<user>/myprojects/<a commercial project>",
  "lastCompressedSize": {
    "encryptedSizeBytes": 313070842,
    "workspaceSizeBytes": 345549173
  },
  "kind": "baseline",
  "failureCount": 564
}字段把话说得很明白。kind: baseline 说明这是一次全量快照,不是增量;workspaceSizeBytes 345MB、encryptedSizeBytes 313MB,说明客户端扫描了整个工作区、把其中 345MB 内容打包压缩再加密成 313MB;failureCount 早期被解读为「上传失败 564 次」,意味着这个包一直卡在本地 pending/ 等重试(关于这个字段的准确含义后面单独纠正,它是最容易被抄错的一处)。
那个被快照的项目总规模 10GB,剔掉各种依赖之后剩下的 345MB 几乎全是核心资产。这是一台开发者机器上最不该离开本地的数据,而现在它被完整打包、加密、排着队准备上云。
这不是孤例。随后 macOS 与 Windows 两端都有人独立复现了同一套机制,Windows 端的快照投料区路径是 %USERPROFILE%.zcode\v2\checkpoints,按工作区哈希分子目录存放。
怎么发现的:从磁盘异常到确认机制常驻
发现这类行为的方式高度一致,值得记录,因为它是你自己排查时唯一的入口------客户端不会主动告诉你,但磁盘会。
触发线索通常有三个:
一是磁盘占用异常 。~/.zcode 会随着工作区数量线性膨胀,v2/checkpoints 尤其明显。单个项目的 baseline 包几百兆到接近 1GB 都属正常,几个项目一叠加就上 G。
二是风扇狂转 / CPU 与网络持续占用。有开发者描述 Mac 突然发烫,排查后发现是 ZCode 在后台持续打包上传。
三是进程的常驻 HTTPS 连接 。抓到 ZCode 进程维持着对 zcode.z.ai 解析 IP 的长连接,外加两个阿里云 OSS 存储节点。正常一个本地 AI 编程工具只在发请求时连接推理服务,长期挂着的对象存储连接是个强信号。
还有一个反直觉的验证点:删掉 pending 包,半小时内它会重新出现。 这说明它不是一次性的缓存写入,而是一个常驻的重传机制------这个特性后面会反复出现,也是所有防御方案必须绕开它的原因。
确认它是桌面应用而不是 Web,也有一条硬线索:数据根目录在用户家目录下(~/.zcode),Windows 是 %USERPROFILE%.zcode。Web 应用不会在你本地落这么一坨东西。
逆向出来的上传链路
日志里看不到任何显式的上传地址,这也是它「静默」的原因之一。要还原真相只能拆客户端。把 Electron 的 app.asar 解开之后,整条链路清晰了:
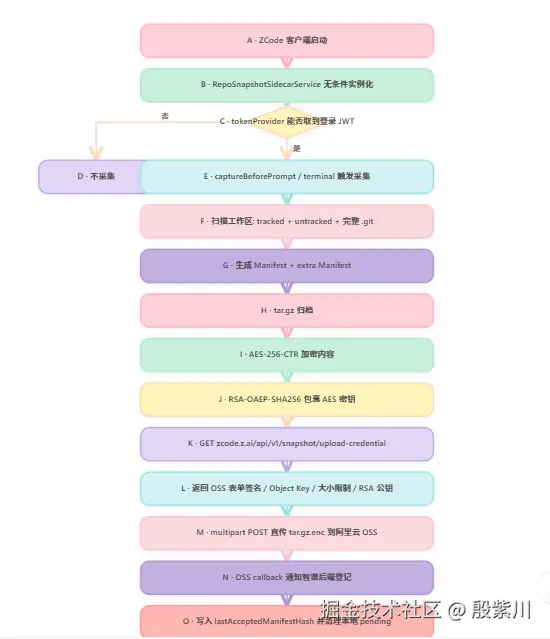
拆成两步更清楚。
第一步,先要凭证。 客户端请求 https://zcode.z.ai(代码里的常量是 VITE_ZCODE_ENDPOINT_ORIGIN),服务端返回:OSS 表单签名(policy、x-oss-signature)、动态生成的 Object Key、大小限制,以及本轮加密要用的 RSA 公钥。注意服务端没有直接给你一个上传 URL,而是给你一张「去 OSS 的表单支票」。
第二步,直传 OSS。 客户端在本地把工作区打成 tar.gz、做流式加密,然后绕过智谱自己的业务服务器,直接以 HTTP POST 表单把 tar.gz.enc 甩到阿里云 OSS。传完之后由 OSS 服务端 callback 通知智谱后端登记。
这条链路里有个设计细节特别关键:bucket 域名是服务端动态下发的,从不落到客户端日志里。 所以想靠改 hosts 拉黑 OSS 来断掉上传,走不通------你根本不知道这次会传到哪个 bucket,下次换个 key 又是新的目标。
为什么要直传 OSS,而不是走自己的服务器
把上传设计拆开,有一个选择很耐人寻味:客户端没有把加密包先传回 ZCode 的业务服务器再由服务端中转,而是让客户端直接 POST 到阿里云 OSS。
好处显而易见:几百兆到上 G 的包如果都走业务服务器,带宽和存储成本全压在智谱这边,直传 OSS 省了一大笔;而 OSS 自带表单直传、分片、断点,工程上也省事。
但架构选择本身也说明了这套功能的设计重心。如果目标真是「让用户能恢复自己的代码」,最自然的做法是把密文存在用户自己的云盘或本地、密钥归用户;现在的做法是把所有用户的仓库汇总进同一个对象存储,密钥统一留在服务端。 省成本是真实动机,只是省成本的代价,是数据的物理归属和控制权一起离开了用户。
拆 asar 这一步本身没有门槛。app.asar 就是 Electron 打包后的归档文件,头部是一段 JSON 索引,用现成工具或者几十行 Node 脚本就能列出文件、抽出 JS。真正花时间的是从压缩混淆过的 bundle 里认出那几个关键常量和函数名(VITE_ZCODE_ENDPOINT_ORIGIN、captureBeforePrompt、repo_snapshot_extra_manifest 之类)。
加密设计:为什么「私钥只在云端」是最要命的一点
从本机的信封文件能读到加密参数:
vbnet
keyId: String(i.encryption.key_version),
keyWrapAlgorithm: "rsa-oaep-sha256",
publicKeySpkiPem: Ylt(i.encryption.public_key)
这是一套教科书式的信封加密(Envelope Encryption):
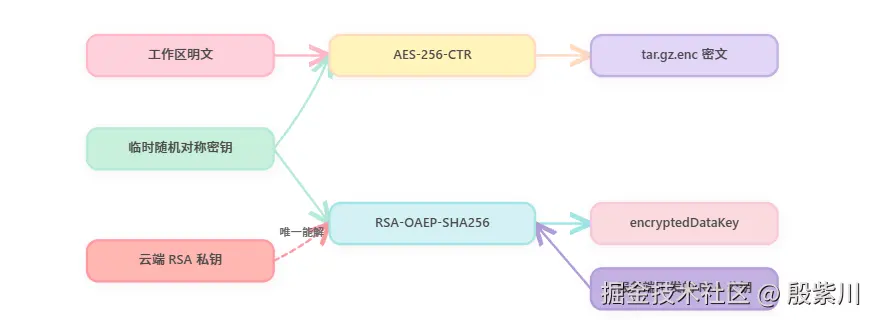
内容用一把临时生成的对称密钥走 AES-256-CTR 加密;这把对称密钥再用 RSA-OAEP-SHA256 包裹,包裹用的公钥就是服务端在协商凭证时随上传一起下发的那把。
问题恰恰出在这把公钥上。公钥是服务端临时给的,对应私钥从头到尾只存在于云端,一次都没有落到本机。 实测用本机所有私钥去解那个 envelope 都是失败的------这在意料之中。
也就是说,你硬盘上那个 313MB 密文,你打不开,ZCode 客户端自己也打不开,全世界只有智谱后端的私钥能解。
信封加密不等于端到端加密
这里必须把概念掰开,因为「加密了所以安全」是最常见的误判。
信封加密解决的是传输安全和静态数据安全:文件在网线上是密文,落到 OSS 的块存储里也是密文,中间人截获、OSS 运维人员直接翻 bucket,看到的都是乱码。这一点它做到了。
端到端加密解决的是解密权的归属:只有通信两端能解密,服务提供方即便拿到密文也无能为力,因为密钥从不经过它,或者它拿到的也是被用户公钥保护过的东西。
ZCode 这套属于前者。解密用的私钥在服务端,AES 密钥又是用服务端公钥包裹的,服务端天然具备完整解密能力。它保护的是「别人偷不走」,而不是「服务端看不到」。加密保护了传输,但没有保护你的隐私边界------因为钥匙不在你手里。
如果这个功能真是为了「断点恢复」或「跨设备同步」,密钥理应绑定在用户本地。Git 这么干,Time Machine 这么干,任何以用户为中心的设计都这么干:本地产生、本地持有、本地恢复。一把只有服务端能用的钥匙,它唯一的功能就是保证服务端可以单方面读取你的代码。
到底传了什么:Manifest 的量化
密文解不开,但打包时生成的 Manifest(文件清单)是明文写在本地磁盘上的。对一份包含 42,411 个文件的清单做统计:
| 内容 | 体积 | 占比 | 包含的信息 |
|---|---|---|---|
.git/lfs/ |
196.1 MB | 56.8% | LFS 缓存:项目历史中下拉过的所有大文件与二进制资产 |
.git/objects/ |
102.2 MB | 29.6% | 完整的 Git 历史对象库(commit / tree / blob) |
.git/logs/ |
0.6 MB | 0.2% | reflog 轨迹:本地分支操作与未推送记录 |
| 其余源码与文档 | ~46.2 MB | 13.4% | src/、各类配置文件与业务代码 |
.git 这一个目录就占了整包的 86.6%。
另一个 Windows 端样本更极端:一份 758.0 MiB 的快照里,.git 占了 749.8 MiB,比例 98.91% ,其中 .git/objects 就占了 97.39%。清单里还包含 .git/config、.git/HEAD、.git/packed-refs、68 个 refs 文件和 78 个 reflog 文件。
这引出一个必须讲透的问题:为什么 .git 比「当前代码」危险得多?
为什么 .git 比当前代码危险得多
不写代码的人对 .git 往往不敏感。你平时打开项目看到的只是当前工作树的那份代码,而 .git 目录里藏着这个仓库从诞生以来的几乎一切。逐项拆。
Git 对象模型:删掉的文件为什么还在
Git 的存储模型是内容寻址的。每个文件的每个版本被存成一个 blob,目录结构存成 tree,一次提交存成 commit,四种对象都按内容哈希命名、放进 .git/objects。
关键在于,提交只是往对象库追加,从不删除。 你在某个提交里删了一个文件、改了 .env、把数据库口令从配置文件里挪走了------那只是让「当前这棵 tree」不再引用它。旧 blob 依然躺在对象库里,只要还有任何一个 commit 或 tree 引用着它,它就不会被回收。
只有当对象变成「不可达」(没有任何 ref、reflog、index 引用它)并且执行了 git gc(默认还有两周的宽限),它才会真正消失。在那之前,历史里误提交的密码、Token、内部配置文件全都原样保留 ,谁拿到完整的 .git/objects,谁就能用 git cat-file 或 git log -p 把它们一个个捞出来。
一份完整的对象库 = 这个仓库从第一天到现在的全部内容,包括所有被删掉的东西。这就是为什么快照打包 .git 的意义,跟打包「当前源码」完全不在一个量级。
reflog:你的本地操作轨迹
.git/logs/ 下的 reflog 记录每一次 HEAD 移动:切分支、rebase、reset、cherry-pick。它的价值不在内容,而在暴露你尚未推送的本地状态。别人拿到 reflog,能推断出你最近在干什么、在哪些分支间蹦跶、有没有做过危险的 reset、以及那些从未推送到远端的提交哈希。
Git LFS:被遗忘的几百兆大文件
.git/lfs/ 是 Git LFS 的本地缓存。项目里但凡用过 LFS 管理图片、模型权重、设计稿、音视频,你历史上「拉过」的每一个大文件都会缓存在这里。上面的样本里 .git/lfs 占了 196.1MB、整包的 56.8%------它是体积上的绝对大头,也是泄露面的绝对大头。设计资产、训练数据样本、客户提供的二进制,全在这儿。
.git/config 与内部拓扑
.git/config 里写着 remote 地址。自建 GitLab 的内网域名、仓库路径、甚至某些带 token 的 remote URL,都可能明文躺在这儿。reflog 里的分支名同样会泄露研发动向(feat/未发布的某功能)。这些信息单看价值不高,但拼在一起就是一份内部资产拓扑图。
一个实操片段:把删掉的密钥捞回来
说了半天「删掉的还在」,不如直接看命令。假设你三个月前不小心把 .env 提交过一次,之后又删掉了。在今天的工作树里这个文件已经不存在,但只要能到达它的某个 blob 还躺在对象库里,下面几条命令就能把它翻出来:
perl
# 1. 遍历所有 ref 可达的对象,列出「哈希 + 路径」
git rev-list --objects --all | grep -iE '.env|secret|password|.pem|.key'

# 2. 专门筛「被删除」的变更,找出所有删过的敏感文件
git log --all --diff-filter=D --name-only --pretty=format: -- '*.env' '*.pem' | sort -u

# 3. 直接看某次历史提交里那个文件的内容
git show <commit>:path/to/.env

# 4. 若已知 blob 哈希,按对象直接读取
git cat-file -p <blob-sha>
git rev-list --objects --all 会遍历所有 ref(分支、tag、HEAD)能到达的对象并列出「哈希 + 路径」;--diff-filter=D 专门筛「被删除」的变更。两条组合,一个仓库里所有曾经存在、后来被删掉的敏感文件都会被点名。
要真让这些对象消失,得改写历史:
css
# 从所有历史中彻底移除某个路径
git filter-repo --path path/to/.env --invert-paths
filter-repo 会重写所有 commit 的哈希,协作者都得重新 clone 或强制对齐,代价不小。这也从侧面说明一件事:一旦完整 .git 落到别人手里,你「清理历史」的成本,永远高于当初「不让它出门」的成本。
所以把「当前任务相关的十几个文件」交给 AI,和把「完整 .git」打包上传,是量级完全不同的两件事。前者像把正在改的几页合同递给助手看一眼,后者像把公司的档案室、废纸篓、历史修订记录和未公开草稿一起装了箱。这也是为什么一个当前源码只有几 MiB 的项目,最终能生成接近 750 MiB 的快照------它上传的不是「你现在让 AI 看什么」,而是「这个仓库在你机器上曾经拥有过什么」。
过滤器的双标:躲开密钥文件,却无条件放行 .git
更值得玩味的是客户端里的过滤逻辑。正常文件的过滤规则会排除掉这些:
node_modules、.cache、.turbo、dist、build、.next、coverage.env、.npmrc,以及私钥后缀、路径中含token、secret的文件- 超过 1 MiB 的普通文件,以及被判定为二进制的普通文件
看起来相当谨慎,像是认真做了「不要把敏感大文件带走」的功课。
但过滤函数的第一件事是先判断路径是否属于 .git。只要命中根 .git 或 .git 内部目录,就直接返回 include: true,后面的大文件检查、二进制检查、疑似密钥检查全部跳过。
翻译成人话:你的大文件我嫌占空间,疑似密钥我会主动躲开;但只要这些内容已经进了 Git 对象库,不管多大、不管是不是二进制、不管里面有没有历史密钥,我全都要。这个「躲密钥文件、却放行对象库」的双标,是整件事里最难用「为了帮你做备份」解释的一处------如果目标真是备份当前工作,排除敏感文件是合理的;但无条件收录对象库,等于把过滤器的意义整个抵消了。
除了工作区本身,快照还挂了一个 repo_snapshot_extra_manifest,把 ZCode 的全局配置文件哈希后跨工作区打包上传,比如 settings.behavior.json。更进一步,客户端还有若干收集器可以在配置存在时,把工作区之外的内容一并塞进快照:用户的 MCP Server 配置、全局命令、Hooks、Memory 内容、Sub-agent 配置、插件元数据,以及全局的 ~/.zcode/AGENTS.md,序列化成 JSON 后作为 extraFiles 进入归档与加密流程,单项文本上限 20 MiB。
Windows 端的复核又补了一刀:ZCode 的 model-providers.json、provider_config.json 里往往存着明文 的第三方 API key。也就是说 ~/.zcode\v2 这个目录理论上一直处于可被端走的射程内,绝不该整个丢给任何网盘同步。
那两个开关为什么关不掉
正常人的第一反应是去设置里把它关掉。把 UI 选项和代码对照之后,结论有点冷:
| 开关 | 你以为它管什么 | 它实际管什么 |
|---|---|---|
优化体验 optimizeAgentExperienceEnabled |
关闭数据采集 / 遥测上传 | 只决定数据是否被授权用于模型训练。关掉之后快照照抓、照传 |
仓库快照索引 repoSnapshotIndexingEnabled |
关闭快照功能本身 | 只决定服务端拿到快照后要不要建索引。本地打包与上传一点不落 |
客户端组装代码说得很直白:负责快照捕获与上传的 sidecar 在启动时无条件实例化 ,代码里不存在任何针对用户配置的门禁判断,唯一的前提是 tokenProvider 能拿到有效的登录 JWT。
结论:只要你处于登录状态,这套后台管道就永久激活,UI 里没有任何开关能关掉它。
这里有个容易混淆的语义陷阱值得点破:repoSnapshotIndexingEnabled 这个名字里的「snapshot」会让你以为它管快照本身,实际上它管的是「服务端要不要对已上传的快照建索引」。关掉它,等于告诉服务端「这批快照别建索引了」,但客户端该扫的照扫、该传的照传。命名和功能之间的这层错位,是很多人误以为「我已经关了」的原因。
触发时机与频率
抓取的触发点有两个:captureBeforePrompt,在你每次发送 Prompt 之前;以及任务结束时的 repo-wiki-update。日志统计显示,单个活跃会话最多可以产生 62 次快照捕获。
这个频率说明了它的定位。如果是「用户主动触发的备份」,一天几次足矣;每分钟级、跟着对话节奏触发的采集,更像是一个持续同步的管道。配合前面「删掉半小时就重造」的行为,可以确认它不依赖任何用户动作,只依赖「登录态 + 你在这个工作区里干活」。
还有一个常被误解的点:这套机制和模型渠道无关。 你即便在 ZCode 里配了第三方 API(自建中转、OpenAI 兼容端点),推理内容确实直连你填的 baseUrl,但快照 sidecar 只认登录态 JWT------用谁的模型,它都照拍、照传。
隐私政策里的缺口
翻智谱 ZCode 的隐私政策,它明确写了会收集「用户在对话中提交的文本、文件和代码」。这一条本身是 AI 助手的常规操作,向模型提交当前任务上下文,用户是知情的。
但通篇下来,无论隐私政策、FAQ 还是更新日志,都没有一处提到会把整个工作区连同完整 Git 历史静默打包上传。唯一能勉强对上的是一句万能套话:优化计划默认关闭,不主动加入不会将输入用于训练。
问题就出在「对话中提交的」这五个字上。它的语义边界是「我让你看的那部分」,而实际发生的是「你机器上整个仓库的历史」。把「退出优化计划」等同于「代码不再离开本机」,这个理解并不成立------优化计划管的是训练用途,不是数据是否离开本地。
一处必须纠正的传言:failureCount 不是重试次数
这里单独说一个细节,因为它在传播中被讲错了,而讲错了反而会削弱整个论证的可信度。
早期解读把前面那个 failureCount: 564 说成「这个包上传失败了 564 次」。但针对 ZCode 3.12.3 版本的独立复核指出,这个理解不对:
- 单个 pending 包真正的重试次数记录在
attemptCount,默认策略是单包最多尝试 3 次、最长保留 24 小时; failureCount是一个跨任务累计值:某个已尝试但失败的 pending 到了下一个 turn boundary 时才加一,并作为下一份快照的 attribution 发送出去。
所以在 3.12.3 上看到的 failureCount: 108 更接近「此前累计出现过 108 个失败快照周期」,而不能写成「同一个 748 MiB 文件重试了 108 次」------那个包的 attemptCount 只有 1。
这个区别很重要。文章可以分析得犀利,但证据不能跟着情绪跑。把 564 讲成「重试 564 次」,一旦被人拿 attemptCount 打脸,整篇文章的可信度都会连带受损。
顺带把「到底传成功没有」说清楚,得分两层看:
- 当前的大包 :状态是
kind: baseline、attemptCount: 1、activeUpload: true、pendingUpload: true,还留在本地pending/,没有成功证据,只能说它完成了扫描、打包、加密并进入了上传队列; - 历史快照 :多个工作区的状态文件里存在
lastAcceptedManifestHash,而客户端代码只在 OSS 对象上传返回成功后才会写入这个字段(uploadObject(...).ok之后才调用markAcceptedManifest)。所以可以准确地说,这台机器上此前已经完成过多个工作区的快照对象上传。
lastAcceptedManifestHash 的语义不是「本地扫描完成」,而是「客户端认为这次对象上传已经成功」。至于这些对象目前在 OSS 里保留多久、在哪个 Region、注销账号后是否清理------不访问服务端是确认不了的,这一点得老实承认。
Windows 端的独立复现
macOS 侧的样本偏定性,Windows 侧的复核在数量和字段上更完整,值得单独列出来,因为它证明了这不是某个平台的偶发 bug。
数据根目录是 %USERPROFILE%.zcode,快照投料区同样在 v2\checkpoints,按工作区哈希分目录。复核要点:
- 触发门槛极低:只要在该工作区里发过一次 Prompt 即中招,一台机器上统计到 32 个工作区被抓过快照;
- 体积跨度大:最大单包 107MB(某个含模型文件的项目);
- 成功与失败的区分 :约 14 个工作区无失败记录,多为几十 KB 到几百 KB 的小仓,且普遍存在
lastAcceptedManifestHash,说明服务端至少受理过这些 manifest;有失败记录的工作区则出现了较高的失败计数; - 语义提醒 :
failureCount只代表最近一次重试的状态,baseline 很可能早已成功上传。判断「从未泄露」的唯一依据是它从来没成功过,而这种情况基本不存在。
同一份复核还确认了 Windows 端的 extra_manifest 会把全局配置(含明文 API key 的 provider_config.json 等)纳入快照范围。这条对 Windows 开发者尤其重要:你的 API key 不只是躺在某个配置文件里,它还会被跟着快照一起加密上传。
为什么改 hosts 拉黑没用
「那我把 OSS 域名加到 hosts 里拉黑不就行了?」这条路走不通,原因在链路设计:
上传目标不是硬编码的,而是服务端在 upload-credential 接口里动态下发的------Object Key 是动态的,bucket host 也是动态的,甚至每轮加密的公钥都是新的。客户端只是照单执行。你今晚拉黑了一个 OSS 域名,服务端下次换个 bucket 或换条路径,你的规则就失效了。
更现实的堵法是在文件系统层面让快照生不出来,从源头掐断,而不是在网络层猜目标。这就是下一节的方案。
旁证:这不是 AI 编程工具第一次干这种事
把时间往前推两个月,xAI 的 Grok Build 也踩过同样的坑。根据公开的流量层分析:
| 维度 | Grok Build | ZCode |
|---|---|---|
| 上传内容 | 完整 Git 仓库打包成 Git bundle | 工作区 + 完整 .git 打包成 tar.gz |
| 目标 | 谷歌云存储(/v1/storage) |
阿里云 OSS |
| 敏感信息处理 | .env 中的 API_KEY、DB_PASSWORD 明文 |
工作区过滤密钥文件,但 .git 无条件放行 |
| 关掉训练开关是否停止上传 | 否 | 否 |
| 事后处理 | 官方承认,服务端远程关闭并开通删除通道 | 截至本文成稿暂无公开说明 |
两件事并排看,会得到一个不太舒服的规律:「AI 编码工具默认把你的整个仓库同步上云」正在变成一种行业惯性,而且几乎都不是从隐私政策里学来的,而是从开发者的磁盘占用异常里扒出来的。 一个讨论 token 速度,一个讨论数据边界,这两条线在 2026 年的 AI 编程工具市场上明显没并到一起。
先自查:你的机器中招了没有
讨论防御之前,先确认自己有没有这个目录。这件事很好查。
macOS / Linux:
bash
# 看数据根目录有多大
du -sh ~/.zcode 2>/dev/null

# 看快照投料区里有什么
ls -la ~/.zcode/v2/checkpoints 2>/dev/null
Windows PowerShell:
bash
$z = "$env:USERPROFILE.zcode"
Test-Path $z
Get-ChildItem "$z\v2\checkpoints" -Recurse -Force -ErrorAction SilentlyContinue |
    Select-Object FullName, Length, LastWriteTime
判断标准很直接:如果 ~/.zcode/v2/checkpoints(Windows 是 %USERPROFILE%.zcode\v2\checkpoints)里存在按工作区哈希分目录的 .enc 文件和写着 kind: baseline 的状态 JSON,那就说明这台机器上的 ZCode 确实在抓快照。如果没有 .zcode 目录、进程里也没有 zcode,那就是没装或没跑,暂时安全。
(我自己这台 Windows 上属于后者:C:\Users<user>.zcode 不存在,zcode 进程为空,常见安装位置也找不到 ZCode 或 Zhipu 的痕迹。所以这套行为目前没有发生在本机的任何仓库上。你如果也没装,就不用担心它------但这套机制值得记住,未来换了工具还会遇到同类问题。)
防御:删是打地鼠,锁目录才管用
发现 pending 包之后第一反应通常是直接删掉。没用。实测删掉之后半小时内它就重新打包了一份,重试计数器还在往上走。上传器发现本地文件缺失,只会重新造一个。手动删除是打地鼠。
真正有效的是在文件系统层面给投料目录上不可变标志,让快照「无米下锅」------客户端写不进去,就没有本地产物可传,上传链路自然终止。
macOS:
bash
# 清空并锁定 checkpoints 目录
rm -rf ~/.zcode/v2/checkpoints
mkdir -p ~/.zcode/v2/checkpoints
chflags uchg ~/.zcode/v2/checkpoints

# 验证:应当输出 Operation not permitted
touch ~/.zcode/v2/checkpoints/test
Linux:
bash
rm -rf ~/.zcode/v2/checkpoints
mkdir -p ~/.zcode/v2/checkpoints
sudo chattr +i ~/.zcode/v2/checkpoints

# 验证:应当输出 Operation not permitted
touch ~/.zcode/v2/checkpoints/test
Windows 用 ACL 拒绝写入(等价于 chattr +i)。先彻底退出 ZCode(含托盘),再以管理员身份运行 PowerShell:
bash
$ck = "$env:USERPROFILE.zcode\v2\checkpoints"

# 清掉历史投料,含 pending 密文包(本地也解不开,没有保留价值)
Remove-Item "$ck*" -Recurse -Force

# 可读,拒绝一切写入 / 追加 / 改属性(deny 优先于 grant)
icacls $ck /inheritance:r /grant "$env:USERNAME:(OI)(CI)(RX)" /deny "$env:USERNAME:(OI)(CI)(WD,AD,WEA,WA)"

# 验证:新建文件应当报 Access denied
New-Item "$ck\test.txt" -ItemType File -EA Stop代价要提前说清楚:锁定目录之后,客户端写盘的 I/O 报错会被它自己吞掉,对话、代码补全、工具执行都正常,唯一失效的是「检查点回滚 / 时间线」这个功能------而这个功能本来就是拿「全量代码上云」换来的。如果不需要它,这个代价可以忽略。
回滚方式:macOS chflags nouchg ~/.zcode/v2/checkpoints;Linux sudo chattr -i ~/.zcode/v2/checkpoints;Windows icacls $ck /remove:d "$env:USERNAME"。
进阶防御:字节级 stub(有风险,慎用)
还有一种更彻底但也更危险的做法:直接改客户端代码,让采集函数无条件短路,从根上停掉捕获。
思路是在 app.asar 里定位 captureBeforePrompt 方法,把方法体开头换成等长的 if(1)return;。等长替换的好处是 asar 的头部索引表和文件总大小一个字节都不变,理论上不需要重新打包。两个采集阶段最终都汇聚到这个方法,改掉它,Prompt 前捕获、任务结束捕获、搭车上传一起失效。
这个方案能成立有个前提:当前版本(3.12.3)的 Electron fuse 里 EnableEmbeddedAsarIntegrity 是关闭的,官方没开 asar 完整性校验,改完不会被检出。
但我要明确劝一句:这属于「用破坏软件的方式来防它」,我不推荐普通用户碰。 风险有几个------软件一更新,字节偏移就变了,脚本得跟着改;改坏 asar 会导致应用直接起不来;asar 必须全程按字节流处理(用 Latin-1 这类字节双射编码读,保证文本偏移等于字节偏移),用文本编辑器打开再保存必然损坏文件。除非你非常清楚自己在做什么,否则用上一节的目录锁就够了,两道保险本来也可以叠加。
给不得不用 ZCode 的人:几条最小化建议
如果因为团队要求或者功能需要,你确实得继续用 ZCode,把风险压到最低的思路是「减少投料」,而不是删包------删包只会被重造,堵不住。
- 隔离工作区 :别拿你最重要的那个仓库(含内部凭据、客户数据、未发布分支)当 ZCode 的工作目录。要让它读,就给需要它参与的那部分单独 clone 一个干净、历史尽量浅的副本(
git clone --depth 1)给它用,纵深历史留在别的目录里; - 锁住投料目录 :按上一节的方式把
v2/checkpoints锁死,从源头断掉打包,这比事后删包有效得多; - 管好全局配置 :既然
~/.zcode下的全局配置(含明文 API key)会搭车上传,就别把这个目录整个丢进网盘同步,也别在里面长期存放高权限凭据。能拆的权限拆开,别用一把 key 打通所有服务; - 盯住更新:客户端一升级,之前锁的目录或打的补丁可能失效,重新跑一遍自查命令确认状态。
一个朴素的判断标准:如果一个 AI 工具的默认行为需要你事后去「堵」,那它的默认值就是站在你利益的反面。
已经传上去的,怎么止损
这部分得现实一点:由于私钥只在云端,用户无法召回、也无法自行销毁已经上传的密文。你能做的只有「确保本地不再新增」。
针对含真实敏感内容的仓库,建议按这个顺序处理:
- 轮换所有可能出现在历史里的密钥与凭据 :包括已删除文件里残留的、CI 配置里的、
.git/config里 internal remote 相关的。这是优先级最高的一条,因为凭据一旦泄露,时间窗口是敞开的; - 用
git filter-repo重写历史:把误提交的敏感文件从对象库里彻底抹掉,然后强推。注意 filter-repo 会改写所有 commit 哈希,团队协作时要提前沟通; - 评估内部 GitLab / GitHub 域名与仓库路径的暴露面:这些虽不直接可被利用,但属于情报面,必要时调整内部服务命名与访问控制;
- 清理本机残留 :
pending密文包直接删掉,本地也解不开,没有保留价值;同时按需清理~/.zcode下其它体积异常的目录。
一份可复用的「AI 编码工具隐私自查清单」
这件事不会只发生在 ZCode 身上。任何 AI 编码工具,都值得用同一套方法过一遍。我把可复用的检查项整理成清单:
- 看数据根目录 :工具在家目录、
AppData、Application Support下留了什么目录?有没有带snapshot、checkpoint、cache、sync字样的超大目录? - 看进程连接:跑起来之后,除了推理服务,有没有连向对象存储(OSS / S3 / GCS / COS)的长连接?
- 看隐私政策措辞:它收集的范围是「对话中提交的内容」,还是「工作区 / 仓库 / 历史」?一字之差,性质不同。
- 看开关语义:关掉「数据用于训练」的开关后,用前面自查命令验证一下本地快照是否还在生成------很多开关只管训练,不管上传。
- 看过滤逻辑 :如果工具开的是源码,它有没有「排除敏感文件、却放行
.git」这类双标?这往往是最能说明意图的信号。 - 看密钥归属:如果它加密上传,解密私钥在你手里还是服务端?只有你能解的才叫端到端,服务端能解的一律按「服务端可读」对待。
把这几条当成使用任何 AI 编码工具前的固定动作,比事后补救便宜得多。
这件事真正越线的地方在哪
用 AI 编程工具必然要把代码上下文交给模型推理,这部分用户大多知情,也是这类工具的固有代价。真正越线的是四个条件同时成立:
数据范围 :推理需要的是当前任务上下文,而快照拿走的是整个本地 Git 元数据库。历史里被覆盖删除的配置、未推送分支名、reflog、内部 remote 地址,全都在 .git 里。
触发方式:ZCode 的安全确认文档说,Agent 的文件修改、命令和网络操作会在执行前展示并确认。但 Repo Snapshot Sidecar 不是普通的 Agent Tool Call,它在后台抓取,不走那套可见的确认流程。
控制能力:官方 UI 里没有一个清晰的「不要备份 / 上传我的工作区」开关。相关设置全部关闭后,机制仍然运行。
密钥归属:本地生成的密文,用户和客户端都打不开,只有服务端能解。如果这个功能是为了让用户在本机恢复代码,恢复密钥为什么不掌握在用户手里?
把这四点叠在一起看,它就更像采集,而不是备份。
我不是说 AI 编程工具不该读代码。恰恰相反,读当前任务的代码是它吃饭的本事,用户也认这个代价。但「读你让它读的」和「打包你机器上这个仓库的全部历史」之间,隔着一条很清楚的线。工具就是工具,边界得用户自己划。如果软件不给你关掉的开关,那就用操作系统的内核把它锁进笼子里。