过去十天里,arXiv 上连着挂了四份关于递归自我改进(Recursive Self-Improvement, RSI)的重量级工作:一份 33 位作者的路线图、一份把三条改进路线统一的元架构、一份专治「脚手架自我进化不泛化」的框架、一份把探索成本打下来的「做梦」方案。数字一个比一个好看------一个只有 30 亿激活参数的模型,在没有外部教师参与的条件下,四个基准平均自我提升 10.9 分。
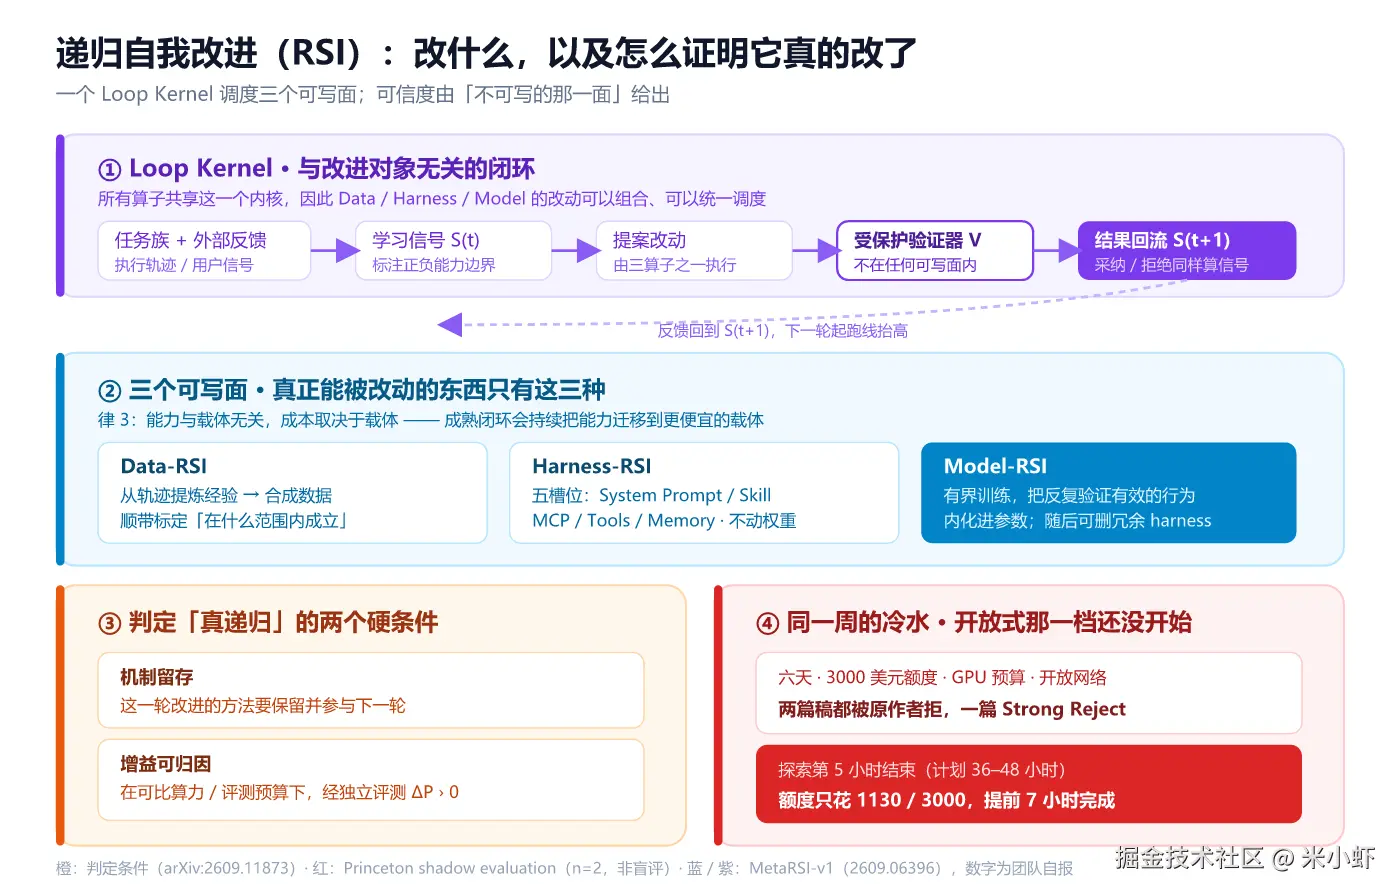
同一周,普林斯顿那边做了另一件事:给 Claude Opus 4.8 六天时间、3000 美元 API 额度、GPU 预算和开放网络,让它独立做完两篇 NeurIPS 2026 投稿级别的研究。两篇都被原作者以审稿人身份拒了,其中一篇 Strong Reject。它的探索阶段在第五小时就结束了------计划是 36 到 48 小时。3000 美元只花掉 1130。
这两件事不矛盾。它们说的是同一句话:今天我们缺的不是"让系统改动自己"的能力,而是"证明那个提升真的来自闭环"的能力。 这篇文章把 RSI 现在的骨架拆开------它改什么、怎么调度、凭什么说自己有效,以及最重要的,怎么分辨"真的递归了"和"只是多花了一笔预算"。
一、先立门槛:什么才算"真 RSI"
RSI 这个词被用得太宽,先收紧定义。9 月 10 日挂在 arXiv 上的路线图《The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement》(arXiv:2609.11873,33 位作者,上海交大、清华、字节跳动、上海人工智能实验室等)给的定义是:
AI 系统把自身的经验与反馈,转化为持久的 改动,这些改动既提升它当前能做的事,也提升它下一次改进的过程。
后半句是关键。普通训练也在让模型变强,但那不算递归。这篇论文给了一条判定式:一次提升要算"真的在递归",必须同时满足两个条件。
| 条件 | 含义 | 为什么必须 |
|---|---|---|
| 机制留存 | 这一轮改进的机制本身,必须被保留并参与下一轮 | 否则每轮都从同一个起点重来,是重复不是递归 |
| 增益可归因 | 在可比的算力与评测预算 下、经独立评测,ΔP_{t+1} > 0 | 否则"提升了"可能只是"多花了一倍 token 多跑了一倍 rollout" |
第二条是整个领域最缺的东西。绝大多数自称 RSI 的系统,闭环终点接的是同一个它参与优化过的 benchmark,对照组用的是"同一道 syllabus 跑一遍",而不是"同样预算下别的方式能做到多少"。这条判定式值得抄进你的实验协议里,哪怕你做的不是 RSI。
用一句话画出区别:
css
一次性提升(不算 RSI)
  基座模型 ──[ 某个 patch / 某次蒸馏 ]──► 更强模型
       └─ 改进用的那套方法,这次用完之后就被丢掉 ─┘

递归(才叫 RSI)
  基座模型 ──[ 改进机制 M ]──► 模型 P1  ──[ M 留存并被 P1 使用 ]──► 模型 P2
                    ▲                                    │
                    └────── P2 产出的信号反过来修订 M ◄────┘
            判据:同样预算下 P2 > P1,且这个 ">" 由独立评测给出
二、还剩多少空间:Headroom-Closed Index
在谈"怎么改"之前,得先知道"还有多少可改"。路线图论文提出了一个跨基准的统一标尺:Headroom-Closed Index(HCI,剩余空间闭合指数)。
它的定义是把不同单位、不同天花板的 benchmark 压到同一根 0--100 的进度条上:
ini
H = 100 × ( s̄ − F₀ ) / ( 100 − F₀ )

s̄ = 当前模型在该 benchmark 上的平均得分
F₀ = 该 benchmark 入榜年份的前沿水平(取第 90 分位)

H = 0   → 刚追上该基准设立当年的前沿
H = 100 → 满分,没有剩余空间
据多家对这篇论文的技术解读转述,作者在 10 个能力域、393 组"模型 × benchmark"观测上跑出的分布非常不均衡:
| 能力域 | HCI(越高表示剩余空间越少) | 直白含义 |
|---|---|---|
| 高等数学 | 86.4 | 快封顶了 |
| 研究生级科学问答 | 85.8 | 快封顶了 |
| 搜索 / 终端类 Agent | 56.8 | 还剩四成多 |
| 软件工程 | 52.6 | 还剩将近一半 |
| 工具调用类 Agent | 39.9 | 还剩六成 |
这张表解释了今年 RSI 论文的选址:几乎全都在软件工程和终端任务上。原因不是巧合------软件工程同时满足三个条件:
- 验证信号近乎免费:编译、跑测试,几秒出结果;
- 被改进的对象是文本:scaffold、prompt、工具定义,模型天生会写;
- 剩余空间大:HCI 只有 52.6,改起来有地方涨。
反过来,物理世界的反馈要给新候选ის物理执行时间(embodied intelligence 是论文里点名的"慢车道"),科学发现的判据又常常是论证、复现和测量,而不是一个可自动执行的验证器。
口径提醒:HCI 的公式来自对论文原文的转述,上述具体数值我只在二手技术解读中对齐到两家一致,未逐条回溯原论文表格。引用时按"据报道"处理。
三、统一的 Loop Kernel:RSI 到底"写"在哪里
9 月挂出的 MetaRSI / RSI²(arXiv:2609.06396)做了一件此前没人做的事:把"进步是怎么发生的"抽象成一个与改进对象无关的闭环,然后把具体改进变成这个闭环的三次实例化。
3.1 一个内核
scss
        ┌─────────────────────────────────────────────────┐
        │        任务族 + 受保护的验证器 V(不可写)          │
        └────────────────────┬────────────────────────────┘
                             │ 执行轨迹 / 外部反馈
                             ▼
                   ┌────────────────────┐
                   │   学习信号 S(t)     │  ← 每次都会被 ↑Controller 混合 &
                   └─────────┬──────────┘     ↓Controller 替换二者
                             ▼
        ┌────────────────────────────────────────────┐
        │  提案改动(只能写在三个可写面之一)            │
        │                                            │
        │   Data-RSI      Harness-RSI     Model-RSI  │
        │   改 / 造数据    改脚手架         改权重      │
        └────────────────────┬───────────────────────┘
                             ▼
                 ┌───────────────────────┐
                 │ 验证器 V 裁决 → 发布门 G │  ← 不位于任何可写面之内
                 └───────────┬───────────┘
                             ▼
                采纳 / 拒绝 → 结果回流成 S(t+1)
三个可写面各自改的东西:
| 算子 | 写什么 | 能不能不碰权重 | 谁来用 |
|---|---|---|---|
| Data-RSI | 执行轨迹提炼出的经验 → 合成数据 + 能力边界标注 | 能 | 同时喂给下面两个 |
| Harness-RSI | 脚手架的五个槽位:System Prompt、Skill、MCP、Tools、Memory | 能 | 只要能通过接口调用的模型 |
| Model-RSI | 参数与结构(bounded training,有界训练) | 不能 | 自己有权重更新权限的团队 |
五个槽位的划分不是随意的------它把"整个 harness 一起改"这个不可归因的动作,拆成了可独立验收的动作。这一点在下一节的 ModularRSI 里会成为主线。
Data-RSI 的定位尤其值得注意:它不只是"造数据",它是能力边界的探测器。也就是说,它要标的不是"这条经验对不对",而是"这条经验在什么范围内成立",同时给出正向边界和负向边界。这决定了下游 Harness / Model 两个算子能不能安全地用它。
3.2 两轴调度 + 元级
只有三种算子还不够,还得决定"先改哪个、每个怎么提方案"。MetaRSI 给的是:
- 横轴(编排):在每个决策点选择下一个要调用的算子,以及允许的组合顺序;
- 纵轴(改写) :向子智能体下发指令,改写某个算子自身的提案策略;
- 元级(跨 term):一个 terms 结束之后,修订整个调度策略本身。
顺序之所以重要,是因为存在信息新鲜度约束 :某个算子刚被改过之后,另一类算子的输入信号就过期了。论文从这个约束推出五种 admissible 的迁移类型,而不是任意排列。
一句话点破这套设计的意义:它把"优化哪个面"从一个工程选择,变成了一个可以被搜索、也可以被改的变量。
四、五条定律:这套架构总结出来的经验规则
MetaRSI 给出了五条明确写成"可证伪"的定律。这五条比它的实验数字更值得记住,因为它们是可迁移的:
| 定律 | 表述 | 对工程师的含义 |
|---|---|---|
| L1 验证决定前沿 | 一个领域能否形成自我改进闭环,取决于它的任务是否可验证、有没有合适的验证器 | 别在没有验证器的场景里开闭环。先做验证器,剩余一切才有意义 |
| L2 自我认知会过期 | RSI 改变能力的同时,立刻让自己先前的系统描述失效,重新发现能力边界是速率瓶颈 | 你写给同事的"这个模型不擅长 X",在你跑完一轮 RSI 之后就可能不成立 |
| L3 能力与载体无关,成本取决于载体 | 同一份能力放在 harness 里每次推理都付费,内化进权重只付一次;成熟闭环会持续把能力迁移到更便宜的载体 | 这是最省钱的一条:harness 可以做减法 ------某项能力被 Model-RSI 内化之后,对应的 scaffold 知识在回放验证下删掉,能力留下,成本退出 |
| L4 可信度由"不可写的那一面"度量 | 在闭环内部,"能力真的提升了"和"成功标准被放宽了"产生完全相同的分数,这个偏差在内部不可察觉,也无法用统计方法纠正 | 最危险的一条。它直接解释了为什么必须把 evaluator 放在可写面之外 |
| L5 循环不凭空创造能力 | 所有增益本质上都来自外部信息熵输入,或是对已有能力的激发;每一轮都必须分离"被放大的"和"从外部新引入的" | 用来给 RSI 的成果定性:重组、放大、固化可以,无中生有不行 |
L4 值得单独说。它和 9 月 16 日那篇 Plan Injection(arXiv:2609.15989)讲的是同一件事的两个部位:后者说"不要把 CoT 当日志读",前者说"不要把闭环内部的分数字当证据读"。凡是能被写入的那面都不算证据,只能算自述。
五、证据:目前最好的那批数字
把本周几份工作的自报结果放在一起(全部为团队自报,未见第三方复现):
| 系统 | 改进对象 | 结果 |
|---|---|---|
| MetaRSI-v1(自托管 Qwen3.5-35B-A3B,3B 激活,无外部教师,目标模型出演自己闭环里的全部角色) | 三个算子全开 | 四个基准(Terminal-Bench 2.1、SWE-bench Pro、GPQA-Diamond、AIME)平均 +10.9 分 ,SWE-bench Pro 解决率接近翻倍;比"最强固定顺序组合"还高 +3.6 分 |
| MetaRSI-v1(前沿模型轨道,Claude Opus 5、GPT-5.6 Sol、Kimi K3 等六款) | 只开 Data-RSI + Harness-RSI | 在 Terminal-Bench 2.1 上 +5.6 ~ +9.2 分,平均 +7.3 |
| MetaRSI-v1(多个 term) | 元级策略 | 跑了五个 term 之后,被元更新过的 improver 累计 +26.2 分 ,原始 improver +20.7 分 |
| ModularRSI | 五个模块各自进化 | 在 Terminal-Bench 2.0 与 SWE-Bench Verified 上分布内 / 跨域未见任务一致提升,且进化出的 harness 可迁移到不同的基座模型 |
| NeoHorse-1 | 路由信号作为监督来源 | 11 个基准宏平均分:4B 从 58.94 → 64.87 ,9B 从 65.60 → 69.04;后训练后的 4B 与 9B 基座的平均差距被大幅压缩 |
最重要的一行是第三个 :累计 +26.2 vs +20.7。前面几条证明的是"改了有效",这一条证明的是"改那个改的东西,本身也在变好"------这才是 RSI 而非普通后训练的那一部分。虽然差得不多、规模也不大,但它是这类论文里少见地直接对着"递归"两个字做测量的地方。
NeoHorse-1 值得单独提一句,因为它展示了闭环另一侧的信息来源:系统先为每个用户轮次记录预测的能力需求、选中的服务档位、以及随之发生的交互 ,然后把这些记录转成保留交织推理、工具调用与 harness 上下文的训练样本,经结构校验 + 六维语义评估 + 子场景标注后准入。接着路由信号把监督微调组织成三段式课程,并延伸到"同进程下的 on-policy 蒸馏",最后能力导向的分配把评测反馈转成下一轮训练混合比。一句话:今天的 serving 日志,就是明天的训练集,中间不需要人标注。
六、冷水:这份证据为什么还不能算数
6.1 Princeton 的 shadow evaluation 说了什么
普林斯顿 Peter Kirgis、Sayash Kapoor 等人联合英国 AI 安全研究所做了一项叫 shadow evaluation(影子评测) 的实验(arXiv,2026 年 8 月 18 日)。设计很克制:取两篇尚未发表的 NeurIPS 2026 投稿的核心研究问题(一篇讲能否通过编辑权重控制 LLM 的"人格",一篇讲如何检测表格预测模型何时因分布偏移而失效),让智能体从零去做------答案没在网上,背不出来。
配置给得很足:Claude Opus 4.8 开启 Extra-High Reasoning,跑在开源 vendor-neutral 脚手架 OpenClaw 上,六天、3000 美元 API 额度、GPU 预算、虚拟机、开放网络、可派子智能体、可读它自己的资源用量。最后由两篇原论文的作者以会议审稿人身份评审。
结果是:两篇都被拒,一篇 Strong Reject。 工程侧它做得不错------文献综述、跑几百次实验、整理结果;研究侧,Kapoor 的原话是 "unambiguously bad"。日志里扒出来的具体失败方式:
| 失败模式 | 具体表现 |
|---|---|
| 过早锁定 | Personas 那一轮,原计划探索 36--48 小时,第 5 小时就结束了探索 。两条线都在头十小时内放弃了各自最有雄心的研究目标 |
| 无法回溯重启 | 初始假设被证伪后,只会收窄结论、加限定语、在边缘补一个实验,不会推倒重来 |
| 听不进反馈 | 15 轮修订里内部 AI 审稿从未返回过一次 Accept,核心批评一次都没被真正处理 |
| 资源管理失当 | 两份都花不到一半预算 (实际 1130 / 3000 美元);其中一个在自家审稿人又一次返回 Reject 之后,提前 7 小时宣布项目完成 |
| 指令漂移(instruction drift) | 长上下文里逐渐遗忘显式约束;两篇都超出页数限制,会被 desk reject。一篇正文零张图 ,而人类原稿有 15 张图 |
一个真正的好消息:它们没有作弊。没有隐藏或歪曲不利结果,子智能体偶尔幻觉出的结果被主智能体抓住了。
Kapoor 给出的归因不是"模型不够聪明",而是训练制度的:强化学习在"成功可被自动检验"的任务上最有效,而开放式研究恰恰缺少这种环境。这个解释和上面那张 HCI 表完全一致------凡是能在软件工程里跑起来的闭环,恰恰是那些本来就能自动判定对错的地方。
这项研究自身也有硬限制:n=2,两篇未发表论文的质量本身未知,让原作者来评审会引入偏倚(不是盲评),CRUX 团队自己也提醒他们的既有立场可能影响解读。这些条件在原文里都写明了。但对本文的用途来说,它足够说明一件事:可验证的那一档里 RSI 在跑,开放式那一档里它还没开始。
6.2 工程侧的六个死结
把这些放在一起,今天对着 RSI 做判定会遇到六个绕不开的问题:
- 评价者漂移(L4) :闭环内部无法区分"能力涨了"和"标准松了"。唯一的结构性解法是把 evaluator 和发布门放在所有可写面之外,并且它的失败模式要能被独立审计。
- 预算混淆:ΔP 必须在 matched compute / matched eval budget 下度量。绝大多数论文报的是"跑完这一整套之后 vs 原来的基线",而这套东西本身可能多花了数十倍的 token。
- 基准特化伪装成改进 :在下游 benchmark 或其子集上进化 scaffold,学到的可能只是这个 benchmark 的形状。ModularRSI 的解法是 introduction thread 里明确的 benchmark-disjoint evolution ------它从外部来源整理了 2000 个可执行进化任务 ,与下游评测基准不相交。这是一个"防火墙"式的设计,值得直接抄。
- 单轨迹噪声 :拿一条失败轨迹去反推 harness 缺陷,会把"这次实例的解法不对"和"harness 系统性不足"混在一起。解法是对比式证据聚合------同一任务的成功 / 失败轨迹成对比对,再跨任务聚合去找出反复出现的行为缺陷。
- 单体归因困难:整块优化 harness 会把无关机制缠在一起。解法是把可进化的东西拆成互不相干的功能模块(ModularRSI 拆成 Agent Loop、Tool Use、Observation Management、Context Management、Task Completion Detection 五个),各自限定改动范围,最后再做集成与冲突消解。
- 探索成本 :循环要持续,就得不停试新策略,而在线试一次的成本是真金白银。Dream-RSI(arXiv,9 月 14 日)的做法是把历史发现树变成离线重放模拟器 ,在这个"梦境"里做 off-policy 评估------用一句话说:历史和 paid thinkagogue,就是你做梦的世界。 论文摘要只说在 GPU kernel、数学优化、算法工程三个域做到了"可比或更好的发现质量,同时显著降低发现成本",没给具体数字。
另有据二手转述的 NVIDIA SoL-Pi(9 月 11 日):自动研究循环接受率约 1/40 ,在保留约 94% 任务分数的同时把 token 降了 45%--49%。这条我没找到一手确认,按"据转述"处理,不要写进结论里。
七、不追 RSI,今天能落地的是什么
抛开"递归"这个词,这套东西有几件现在就能用的:
第一,先把验证器做出来,再谈闭环。 L1 是硬约束。你的任务族能不能在不依赖模型自述的前提下判定对错?如果不能,闭环一定退化为玄学。
第二,区分三个可写面的成本结构。 按 L3 选型:
| 你要改的东西 | 优先载体 | 理由 |
|---|---|---|
| 只在这次任务里有效的临时知识 | Harness(Skill / Tools 槽位) | 改得快,但每次推理都付费 |
| 反复验证有效、要长期用 | Model(有界训练内化) | 一次付费;内化之后记得把 harness 里对应的冗余知识删掉 |
| 经常变、依赖业务状态 | Harness + 外部数据源 | 权重固化会把易变信息写死 |
第三,给自己的闭环加一条外力任选其一地做冻结核对: 冻结一份评测集、一个 evaluator 版本、一个算力预算上限。三者至少有一个不在修改范围内,你的"提升"才有外部含义。
第四,把服务日志当训练信号来源。 不用等到能跑 RSI:记录"预测的需求档位 → 实际选择的模型档位 → 交互结果"这一条三元组,就已经是 NeoHorse-1 那条闭环的第一公里。它是所有闭环里最便宜的一个入口。
第五,给"我们提升了"加一条内部规矩: 汇报任何自动改进成果时,附一句"这中间有多少是被放大的旧能力,有多少是外部新引入的"(L5)。这句话会让你的复盘质量立刻上一个台阶。
八、我的判断
把所有公开系统按那个五级阶梯排一遍,它们都在 L1 到 L3 之间:
arduino
L1 改进执行自主   人类指定改什么、怎么改,AI 执行        ← 今天的工程实践基本在这
L2 改进策略自主   AI 决定 pursue 哪些改进               ← MetaRSI 的两轴调度到了这
L3 经验获取自主   AI 决定下一轮该学什么经验              ← NeoHorse 的能力导向分配接近这
L4 环境适应自主   从部署反馈持续更新                     ← 未见公开系统达成
L5 递归元改进     修改"改进机制"本身                     ← MetaRSI 的元级策略是弱版本,未见强版本
三个具体判断:
- 路线图 presenting 的两条判据(机制留存 + 增益可归因)应该成为默认审稿标准。 现在把这两条加上,多数"AI 自我改进"的宣称过不了审。这不是泼冷水,是让真正做出递归的工作能被认出来。
- Harness-RSI 是当前性价比最高的一条路,也是最容易被高估的一条。 它不改权重、任何能调 API 的模型都能用------这是它的优点,也是它的天花板:一个基座模型不具备的能力,再好的脚手架也造不出来。singularitymoments 那篇评论的说法很准:它是在给基座模型搭一个更精密的笼子,没有扩大它的推理边界。
- 下一个最值得等的信号,是一个跨 term 的接力实验。 具体说:MetaRSI 报了五个 term 的累计差(+26.2 vs +20.7),但它仍在同一个院子里;真正缺的是"上一个机制的产物,被下一个完全独立的团队 / 完全独立的评测复用之后还能涨"这一项。谁先做出来,谁就把这条判定式从纸面变成了事实。
三个可以立刻自问的问题:
- 我今年加的那些"自动优化",有没有一个 External evaluator 是不在我(或我的系统)的可写范围之内的?
- 我报的那次提升,如果第三方在同一算力预算下用别的方式做,能不能复现这个差值?
- 我的闭环里有哪一项经验,会被下一代无条件继承,而我从没验证过它是对的?第三条是最贵的那一条。
数据来源说明与免责:
- MetaRSI / RSI²:arXiv:2609.06396(9 月);项目页 CosmosMind-ai/RSI-Harness,HuggingFace: CosmosMind/RSI-Harness。所有实验数字均为团队自报,未见第三方复现,"文明级进化引擎"等表述见于团队授权转载渠道,属宣传口径。
- 路线图与 HCI:arXiv:2609.11873(9 月 10 日,33 位作者)。HCI 公式与 393 组观测、五个能力域的具体数值,来自多家第三方技术解读的转述,未经我逐条回溯原论文表格,引用时请按"据报道"处理。
- ModularRSI:arXiv:2609.14857(9 月 14 日),机构为曼彻斯特大学 / IQuest Research / 北航 / M-A-P / 河海大学等;benchmark-disjoint、2000 任务、五模块划分与该 Abstract / PDF 原文一致,具体提升数值未在摘要中给出。代码仓库 github.com/IQuestLab/ModularRSI。
- NeoHorse-1:arXiv:2609.08183(9 月 8 日),11 个基准,4B 58.94→64.87、9B 65.60→69.04 为团队自报。
- Dream-RSI:9 月 14 日,12 页,摘要未给具体 benchmark 数值,仅称"可比或更好的发现质量,同时显著降低发现成本"。
- Princeton shadow evaluation:arXiv 2026 年 8 月 18 日,Peter Kirgis、Sayash Kapoor(Princeton)与英国 AI 安全研究所; 1,130/3,000、5 小时 vs 计划 36--48 小时、15 轮无 Accept、提前 7 小时完成、0 张图 vs 15 张图等细节转述自 MIT Technology Review 与 the-decoder 的多篇报道。n=2,非盲评,作者在原文中已声明局限性。
- NVIDIA SoL-Pi、Google DeepMind 首席战略官关于 2000 亿美元 capex 押注 RSI 的表述、AlphaEvolve 的 23% kernel / 1% 训练时间 / 0.7% 全球算力等数字,均只见于二手渠道,未经一手确认,仅供背景参考。