1.数据结构的基本概念
1.1基本概念和术语
• 数据:数据是对客观事物的符号表⽰,是所有能输⼊到计算机中并被程序处理的符号的总称。它是 信息的载体,可以是数字、字符、字符串、图像、声⾳等。如: 101, "张三", 95, "男" 这些 独⽴的数字和字符串都是数据。
• 数据元素:是数据的基本单位,在计算机程序中通常作为⼀个整体进⾏考虑和处理。⼀个元素可以 由若⼲个数据项构成,数据项是数据不可分割的最⼩单位。如: {学号:101, 姓名:"张三", 成绩:95, 性别:"男"} 是⼀名学⽣的完整信息就是⼀个数据元素,其中 学号:101 就是⼀个 数据项。
• 数据对象:具有相同性质的数据元素的集合,是数据的⼦集。如:全班学⽣的花名册就是⼀个数据 对象。它包含了学⽣A数据元素 ,学⽣B数据元素 ,学⽣C数据元素
• 数据对象(集合)⊇数据元素(个体)⊇数据项(属性),所有这些都是数据的表现形式
cs
typedef struct
{
 int id; // 学号
 char name[20]; // 姓名
 char gender[3]; // 性别
 double score; // 绩点
}Student;

int main()
{
 // 结构体变量arr[i]中每个成员就是⼀个数据项
 // 结构体变量arr[i]就是⼀个数据元素
 // 结构体数组arr就是⼀个数据对象
 Student s[] = { {10001, "张三", "男", 3.0},
 {10002, "李四", "⼥", 3.5},
 {10003, "王五", "男", 2.0}, };
}
1.2数据结构三要素
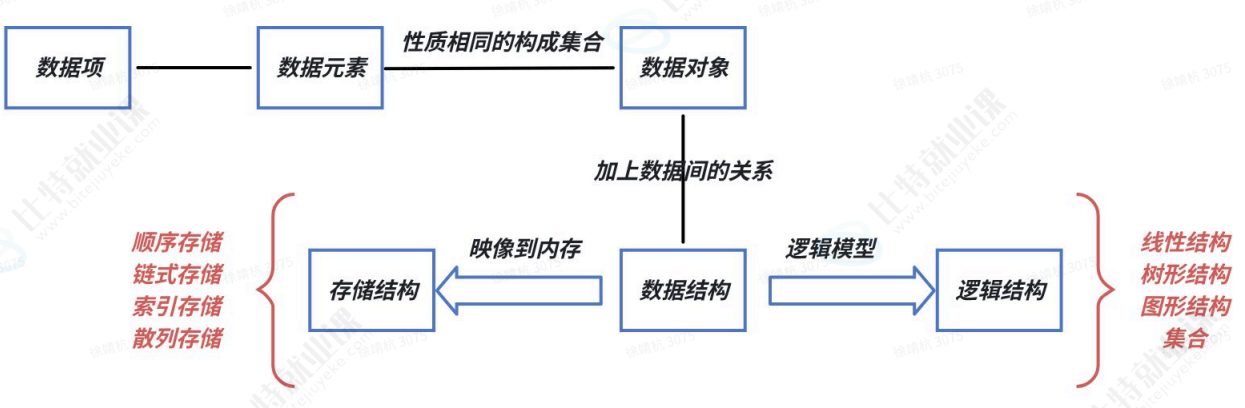
• 什么是数据结构:数据元素之间不是孤⽴存在的,它们之间存在某种关系,数据元素互相之间的关 系称为结构,或者说数据结构是带结构的数据元素的集合。
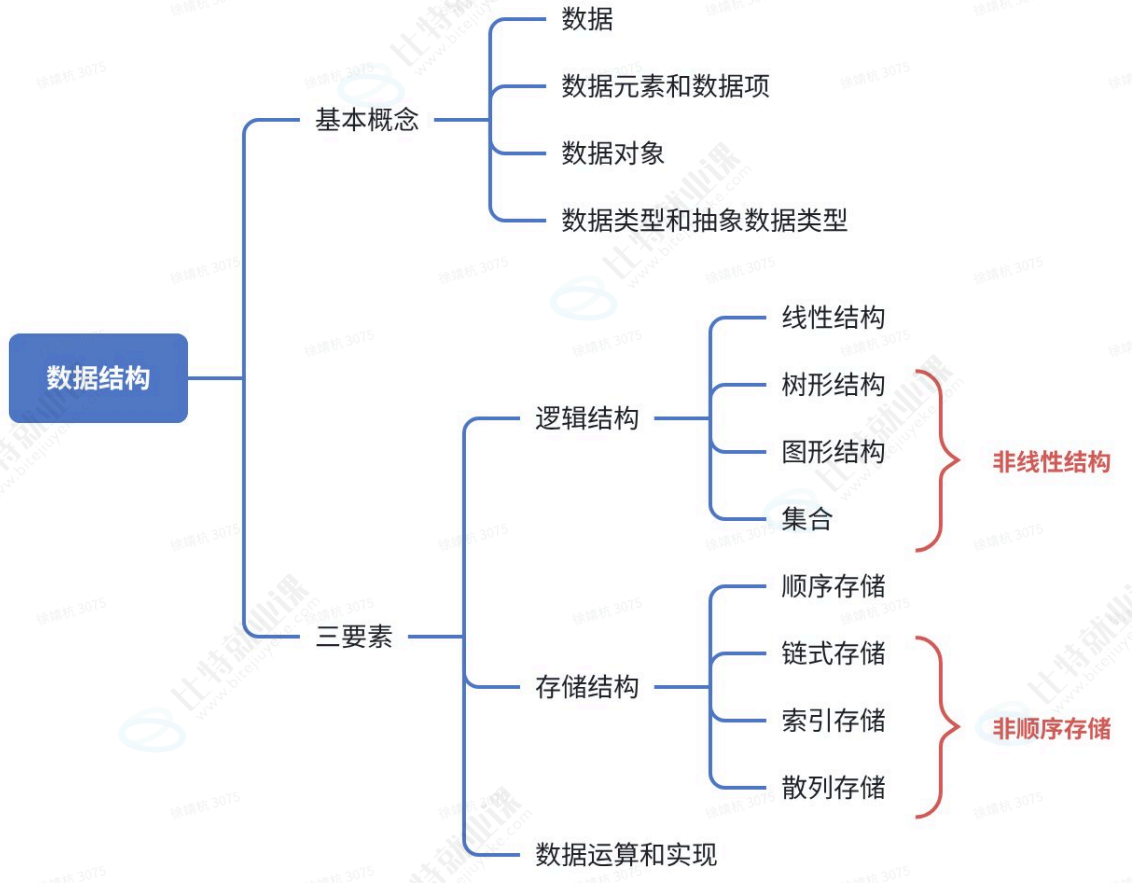
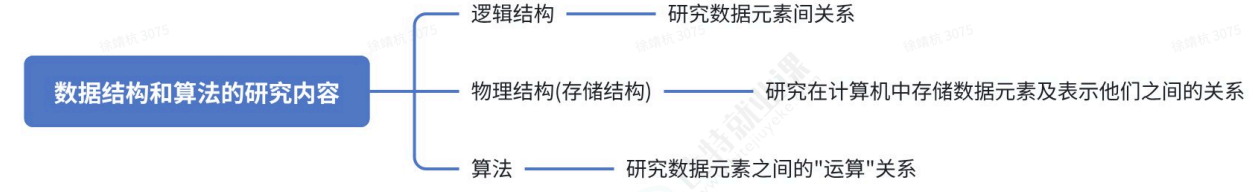
• 数据结构包含三个⽅⾯的内容(三要素):逻辑结构、物理结构(存储结构)、数据运算和实现
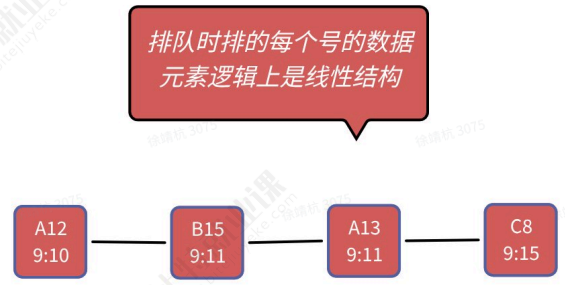
• 逻辑结构:描述数据元素之间的逻辑关系。逻辑结构可以分为:线性结构、树形结构、图形结构(⽹ 状结构)、集合;也可以直接分为线性结构和⾮线性结构(树形、图形、集合)。
a. 线性结构中的数据元素之间存在⼀对⼀的关系,除了第⼀个元素,所有元素都有唯⼀前驱,除 了最后⼀个元素,所有元素都有唯⼀后继。⾮线性结构可能有多个直接前驱和直接后继。
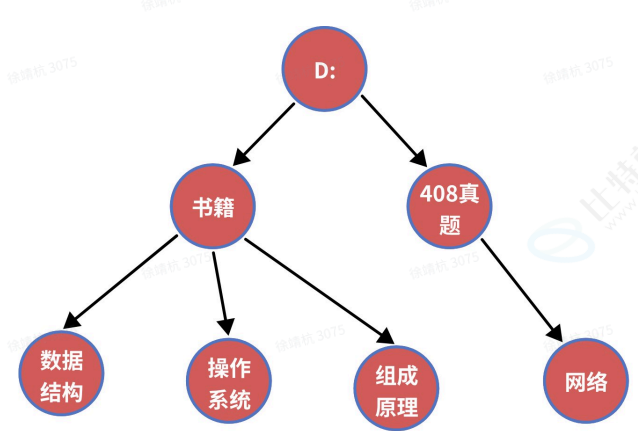
b. 树形结构中的数据元素之间存在⼀对多的关系
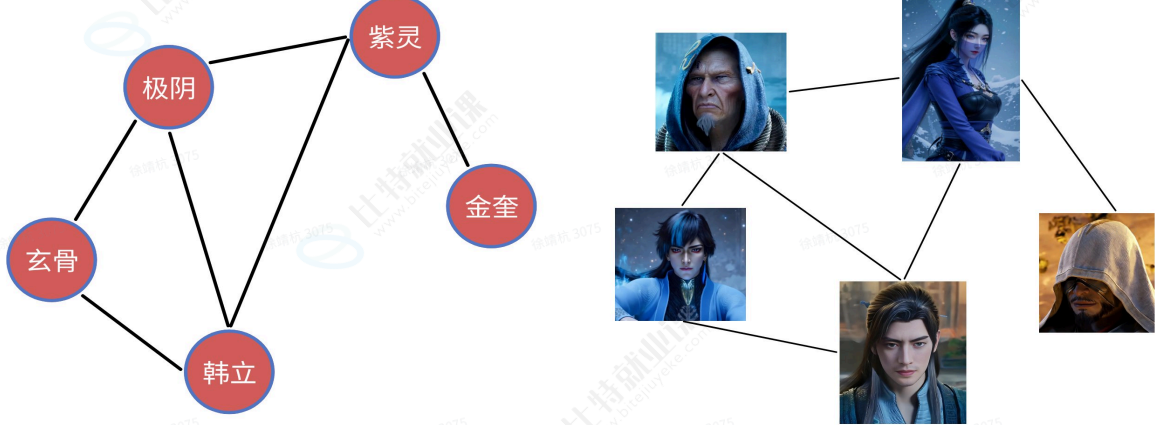
c. 图形结构中的数据元素之间存在多对多的关系
d. 集合中的数据元素属于⼀个集合,除此之外别⽆其他关系
• 物理结构(存储结构):数据元素及其关系在计算机存储结构中表⽰(映像),物理结构主要有四种:顺 序存储、链式存储、索引存储、散列存储。
a. 顺序存储:把逻辑上相邻的数据元素存放在⼀段连续物理存储单元中,数据元素之间的逻辑关 系可以由物理存储关系体现。
b. 链式存储:逻辑上相邻的数据元素存储在任意的⼀组物理存储单元中,数据元素之间的逻辑关 系⽤指针来表⽰
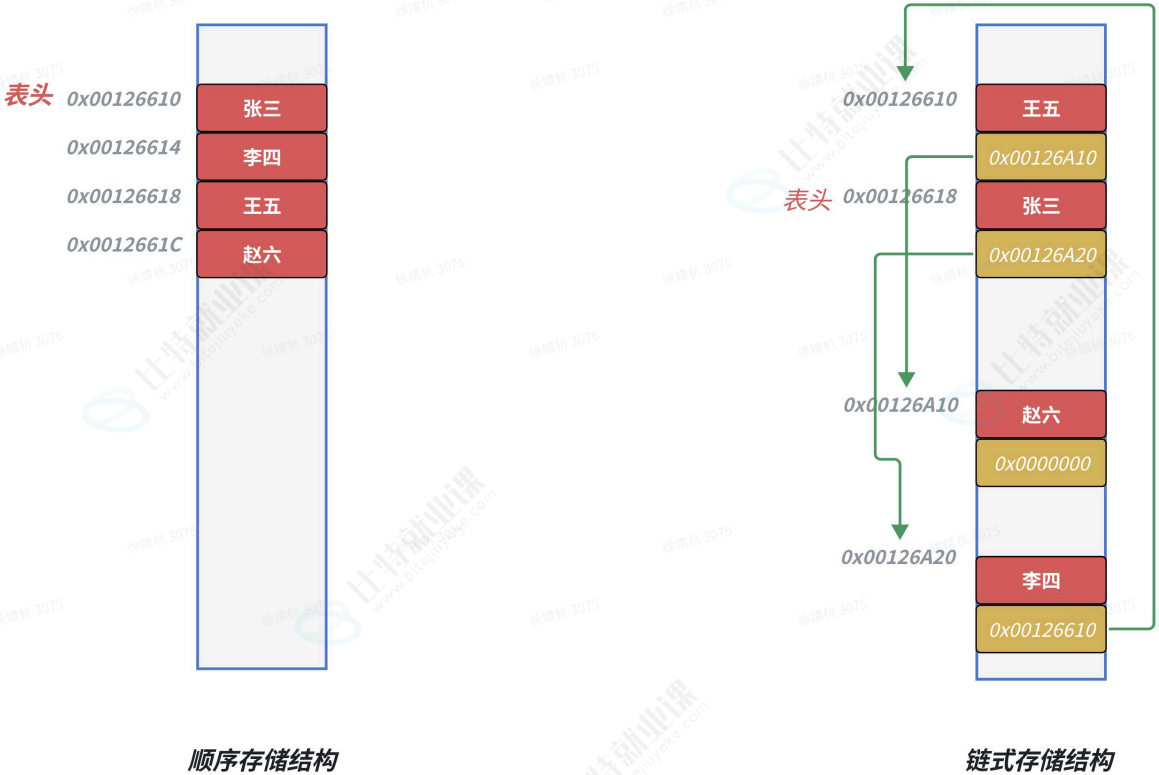
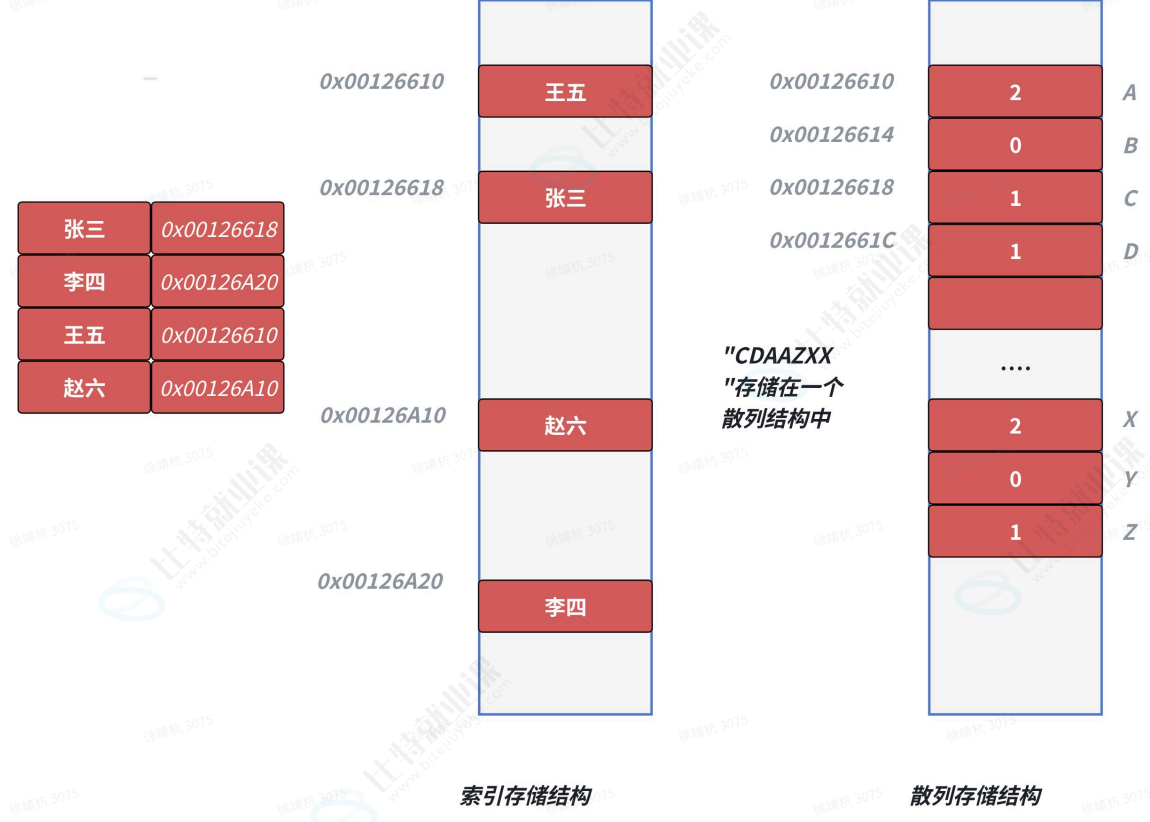
c. 索引存储:存储元素信息的同时,还建⽴了索引表,索引表中的每项称为索引项,索引项的⼀ 般形式为(关键字,地址)
d. 散列存储:根据数据元素中的关键字计算出该数据元素的存储地址。
• 数据运算和实现:对数据元素可以施加的操作,以及这些操作在相应的存储结构上的实现。
1.3数据类型和抽象数据类型
• 数据类型是⼀个值的集合和定义在这个值集上的⼀组操作的总称,数据类型⼀般可分为:原⼦类型和结构类型。
a. 原⼦类型:原⼦类型的值是不可以再分解的。如C语⾔的int、double、char等基本数据类型
b. 结构类型:结构类型的值是由若⼲成分按某种结构组成,是可以分解的。如C语⾔中定义的⼀个 结构体类型。
• 抽象数据类型:抽象数据类型(Abstract Data Type,ADT)是⼀种数学模型加上在该模型上定义的 ⼀组操作的集合,它定义了数据对象、数据关系以及对数据的操作,但隐藏了具体实现细节。
cs
// ADT = 数据对象(D) + 数据关系(S) + 基本操作(P)
ADT Stack {
 数据对象:D = {aᵢ | aᵢ ∈ ElemType, i = 1,2,...,n, n ≥ 0}
 数据关系:S = {<aᵢ₋₁, aᵢ> | aᵢ₋₁, aᵢ ∈ D, i = 2,...,n}
 约定aₙ为栈顶,a₁为栈底
 基本操作:
 InitStack(&S): // 初始化栈
 操作结果:构造⼀个空栈S
 DestroyStack(&S): // 销毁栈
 初始条件:栈S已存在
 操作结果:销毁栈S

 StackEmpty(S): // 判断栈空
 初始条件:栈S已存在
 操作结果:若栈空则返回TRUE,否则FALSE

 Push(&S, e): // ⼊栈
 初始条件:栈S已存在
 操作结果:插⼊元素e为新的栈顶元素

 Pop(&S, &e): // 出栈
 初始条件:栈S已存在且⾮空
 操作结果:删除S的栈顶元素,并⽤e返回其值

 GetTop(S, &e): // 获取栈顶
 初始条件:栈S已存在且⾮空
 操作结果:⽤e返回S的栈顶元素(不删除)
}
1.4总结
2.算法的基本概念
2.1 算法和数据结构
• 算法(Algorithm)是解决特定问题的求解步骤的⼀种描述,是⼀系列解决问题指令的有限序列。它描 述了如何通过⼀系列操作将输⼊转换为期望的输出。算法代表着⽤系统的⽅法描述解决问题的策略 机制,精⼼设计的算法可以带来更⾼的运⾏效率。
• 前⾯我们讲到数据元素不是孤⽴存在的,它们之间存在着某种关系,数据元素互相之间的关系称为 结构,也就是说数据结构是相互之间存在⼀种或者多种特定关系的数据元素的集合。精⼼选择的数 据结构可以带来更⾼的运⾏或者存储效率。
• 算法+数据结构=程序(Algorithms+Data Structures=Programs),这意味着的程序的好和快 是直接由程序所采⽤的数据结构和算法决定的。提出这⼀公式的瑞⼠计算机科学家尼克劳斯·沃斯 (Niklaus Wirth)是1984年图灵奖得主,Pascal之⽗。
• 数据结构和算法的是紧密耦合、相辅相成的,数据结构通过算法实现操作,算法根据数据结构设计 实现细节。同⼀个问题,采⽤不同的数据结构,其算法可能完全不同,效率可能也有很⼤差别。⽐ 如我们要排序⼀组数据,数据分别存储在数组中和链表中,就要选择适合的排序算法,实现细节和 效率都是有很⼤的差别的。
2.2 算法的特性
• 有穷性:算法必须在有限步骤内结束,不能⽆限循环或永远不终⽌。
• 确定性:算法的每⼀步骤必须有确切、⽆歧义⽆⼆义性的定义。对于相同的输⼊必须得到相同的输 出。
• 可⾏性:算法是可执⾏的,算法中描述的操作都是通过已经实现的基本运算执⾏有限次来实现。
• 输⼊:算法有零个或多个输⼊,这些输⼊取⾃特定的对象集合。
• 输出:算法有⼀个或多个输出。输出是算法处理输⼊后得到的结果,与输⼊有特定关系。
2.3 算法设计的要求
• 正确性:算法能正确的解决求解的问题。
• 可读性:算法的思路是便于理解的,可读性强的。
• 健壮性:当输⼊数据⾮法时,算法也能适当的做出进⾏处理,⽽不会产⽣莫名其妙的结果。
• ⾼效率与低存储要求:⾼效率就是执⾏之间尽可能低,低存储就是执⾏过程中使⽤更少的存储空 间。
3.算法的时间复杂度
3.1 如何分析算法的时间效率
• 对于同⼀个问题可以有许多不同的算法去解决,那么我们如何评价哪个算法是更好的呢?⼀个好的 算法⾸先要满⾜的是正确性,其次就是可读性、健壮性,在这三点都满⾜的情况下,我们主要就通 过评估算法效率的优劣来进⾏选择,算法效率分为时间效率和空间效率。
• 时间效率是算法运⾏时所耗费的时间,空间效率是算法运⾏过程中额外耗费的存储空间。
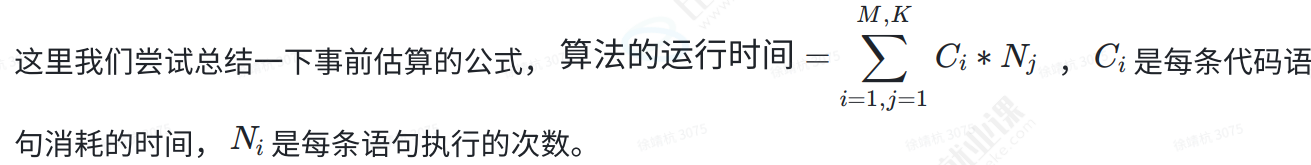
• 时间效率有两种⽅法可以分析,⼀种实现算法后运⾏统计(事后统计),但是这种⽅法需要先实现算 法且严重依赖环境,如编程语⾔、CPU、编译器等,容易掩盖算法本⾝的优劣。另⼀种⽅法叫事前 估算。
cs
// 这⾥我们给出了⼀个简单的summation累加算法,根据上⾯的事前估算公式可以得到
// 算法的运⾏时间f(N) = C1*1 + C2*1 + C3*(N+1) + C4*N + C5*N + C6*1
int Summation(int N) { // 消耗时间 执⾏次数
 int ret = 0; // C1 1
 int i = 1; // C2 1
 while (i <= N) { // C3 N+1
 ret += i; // C4 N
 i++; // C5 N
 }
 return ret; // C6 1
}
• 上⾯的事前估算公式中,每条代码语句消耗的时间Ci本质跟算法是⽆关的,它跟实现的编程语 ⾔、编译器、CPU等环境因素相关,那么我们这⾥是进⾏事前估算,既然是估算我们可以简单的假 设每条语句消耗的时间是⼀样的Ci=1 ,这样事前估算就可以简化为所有代码语句的执⾏次数之 和,这样我们就可以脱离软硬件等环境因素来分析算法的时间效率了。如Summation函数的时间 效率就可以⽤⼀个函数 f(N) = 1 + 1 + (N+1) + N + N + 1 = 3*N + 4 来表⽰。
3.2 时间复杂度渐进表⽰法

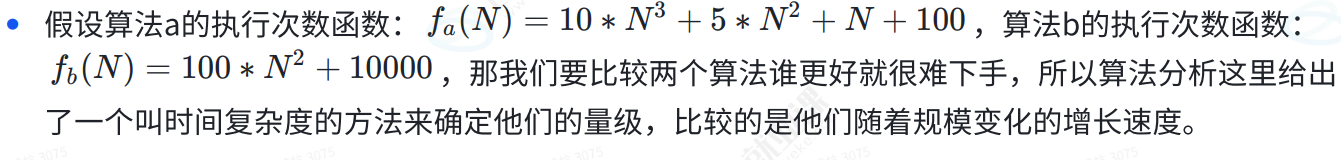
◦ 当N=50时:算法a执⾏5000次,算法b执⾏2500次,算法b更快。
◦ 但是当N=1000时:算法a执⾏100000次,算法b执⾏1000000次,算法a更快。
◦ 当N⽐较⼩的时候或许算法b更快,但是随着N不断增⼤,算法a总是更快的,所以我们事前估算 应该关注算法执⾏次数随着规模变化的增⻓速度,关注算法执⾏次数的量级。
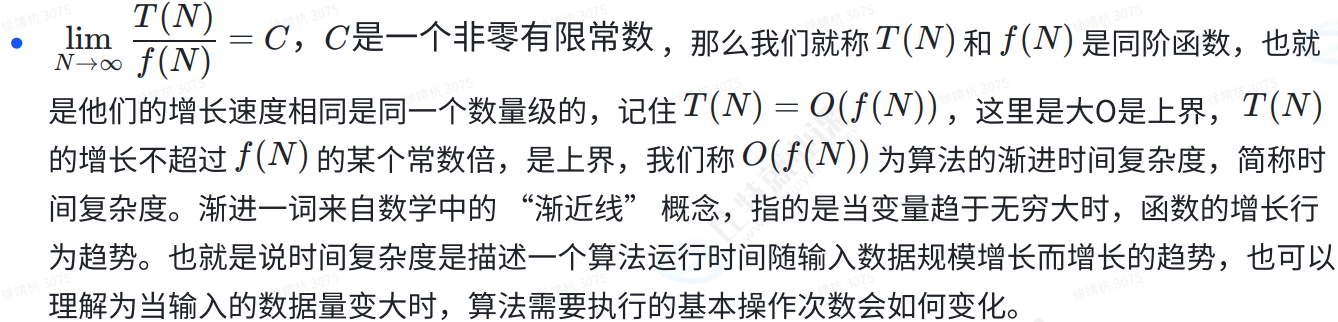
• 通俗易懂的求T (N) 的⽅式,对f(N) 函数:
a. 仅保留最⾼阶项,因为当N⽆限⼤,最⾼阶项对函数增⻓起决定性作⽤
b. 去除最⾼阶项的系数,因为当N⽆限⼤,这个系数对结果的量级没有影响
c. 去除常数项,因为当N⽆限⼤,这个常数项对结果的量级也没有影响
d. 若没有跟N相关的项,只有常数项,则时间复杂度为O(1)

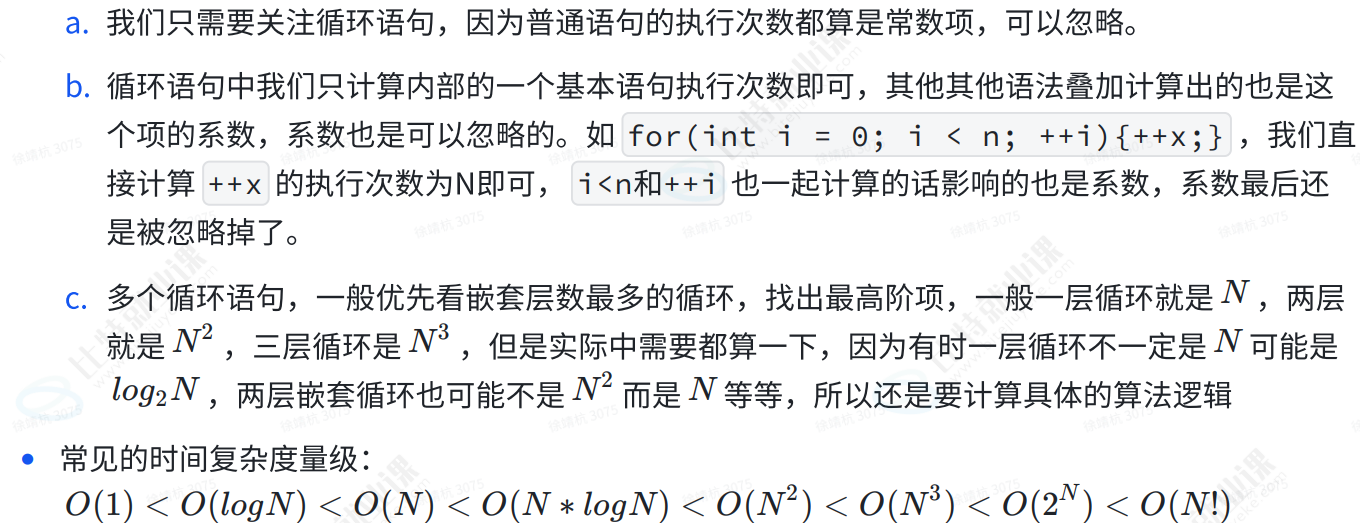
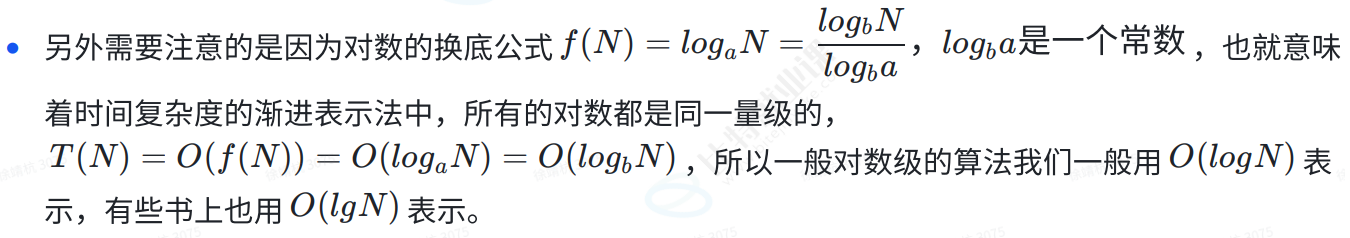
• 计算时间复杂度本质是估算算法属于哪个数量级,那么我们实际中还需要先求出它的执⾏次数 f(N) ,在求出T(N)吗?这样就太⿇烦了,所以是不需要的,我们其实可以直接计算的,根据前 ⾯讲的规则总结⼀下:
3.3 时间复杂度经典样例分析
3.3.1 样例1:O(N)级
根据时间复杂度计算规则,Summation算法的时间复杂度T (N) = O(N)
cs
int Summation(int N) {
 int ret = 0;
 int i = 1;
 while (i <= N) {
 ret += i;
 i++;
 }

 return ret;
}
3.3.2 样例1:O(N^2) 级
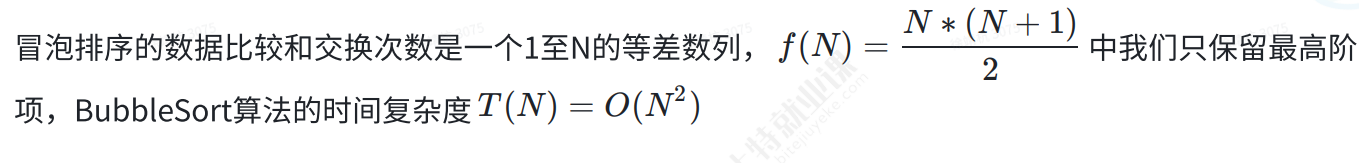
cs
// 计算BubbleSort的时间复杂度?
void BubbleSort(int* a, int n) {
 assert(a);
 for (size_t end = n; end > 0; --end) {
 for (size_t i = 1; i < end; ++i) {
 if (a[i-1] > a[i]) {
 Swap(&a[i-1], &a[i]);
 }
 }
 }
}
3.3.3 样例3:O(N^3)级
MatrixMultiply是⼀个矩阵相乘并打印结果的算法,O(f(N))中我们只保留最⾼阶项,那么矩阵 相乘部分的执⾏次数阶数明显⾼于打印结果部分的执⾏次数,所以我们只关注矩阵相乘部分, MatrixMultiply算法的时间复杂度T(N)=O(N^3)
cs
#define N 3

void MatrixMultiply(int A[][N], int B[][N], int C[][N]) {
 // 矩阵相乘
 for (int i = 0; i < N; i++) {
 for (int j = 0; j < N; j++) {
 C[i][j] = 0;
 for (int k = 0; k < N; k++) {
 C[i][j] += A[i][k] * B[k][j];
 }
 }
 }

 // 打印结果
 for (int i = 0; i < N; i++) {
 for (int j = 0; j < N; j++) {
 printf("%d ", C[i][j]);
 }
 printf("\n");
}
}
3.3.4 样例4:O(logN) 级
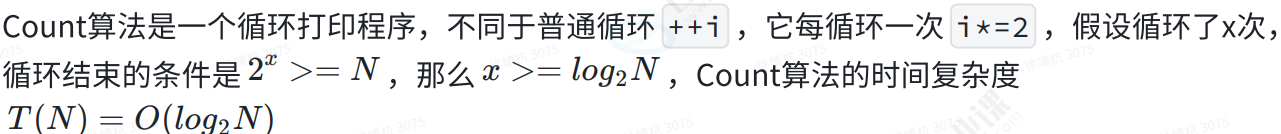
cs
#include <stdio.h>

void Count(int n) {
 for (int i = 1; i < n; i *= 2) {
 printf("%d\n", i);
 }
}

int main() {
 Count(100);
 return 0;
}
3.3.5 样例5:O(1)级
Print100算法是⼀个循环打印程序,它的循环最多循环100次打印前100个数,Print100算法时间复 杂度是T(N) = O(1)
cs
void Print100(int* a, int n) {
 for (int i = 0; i < n && i < 100; i++) {
 printf("%d ", a[i]);
 }

 printf("\n");
}
3.3.6 样例6:O(M+N) 级
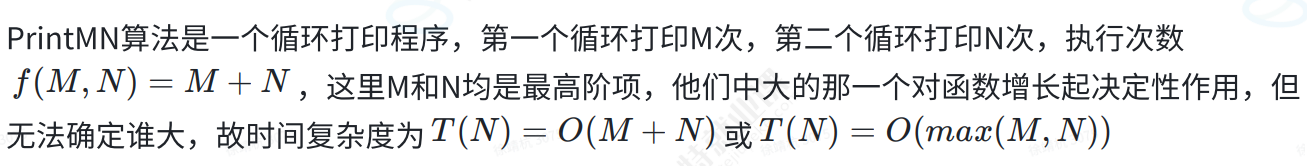
cs
void PrintMN(int m, int n){
 for (int i = 0; i < m; ++i){
 printf("hello\n");
 }

 for (int i = 0; i < n; ++i){
 printf("hello\n");
 }
}
3.3.7 样例7:存在最好和最坏不同情况
有的情况下算法的执⾏次数跟问题的输⼊有关,可以分为最好、最坏、平均三种情况去讨论,如下 ⾯样例5的Find算法。⼀般情况下我们⽐较算法的时间复杂度都是讨论最坏情况,这样可以保证算 法最差也不会超过这个量级,这是⼀种底线思维,是⼀种保守的估算。
i. 最坏时间复杂度:最坏情况下的时间复杂度
ii. 最好时间复杂度:最好情况下的时间复杂度
iii. 平均时间复杂度:所有输⼊实例等概率出现的情况,算法期望运⾏时间
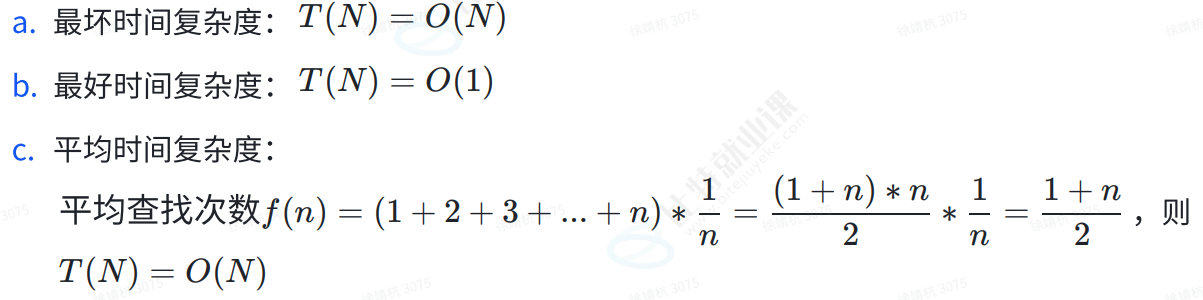
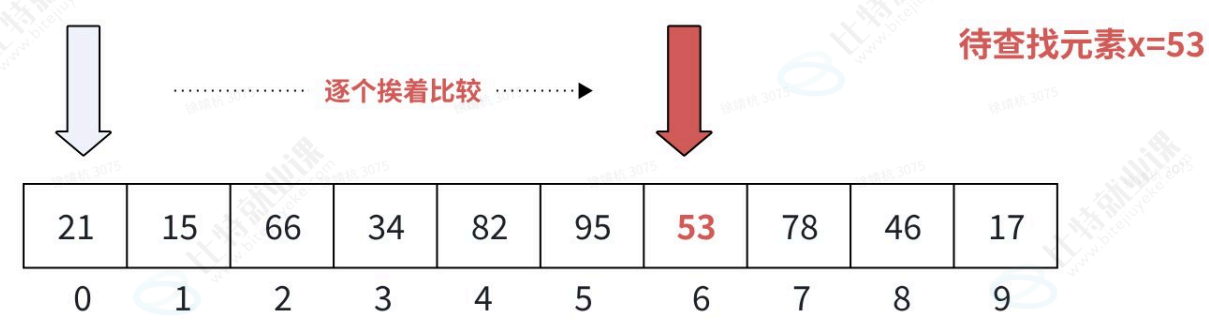
cs
int Find(int* a, int n, int x) {
 for (int i = 1; i < n; i++) {
 if (a[i] == x)
 return i;
 }
 return -1;
}
Find算法实现了在数组a中顺序查找⼀个值为x的元素的下标,要查找的值x在第⼀个位置就是最好 情况;最后⼀个位置就是最坏情况;假设x在数组中任意⼀个位置的概率均是1/N,把每个位置值都 查找⼀遍的平均次数(期望)就是平均情况。
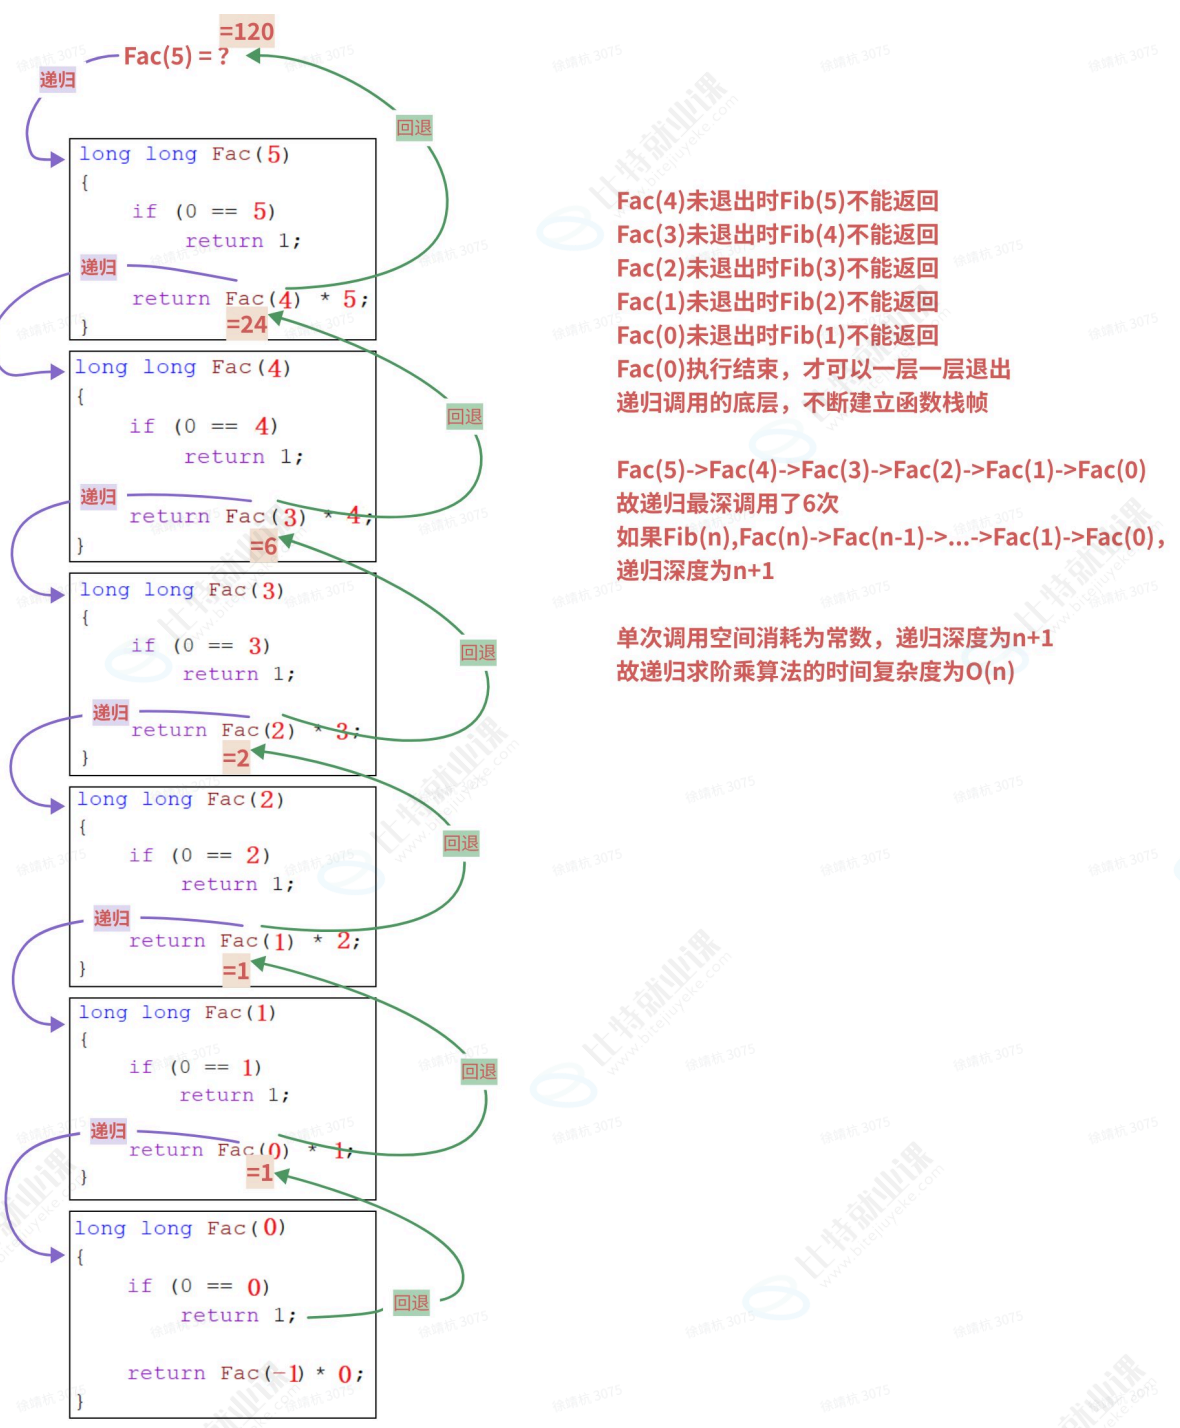
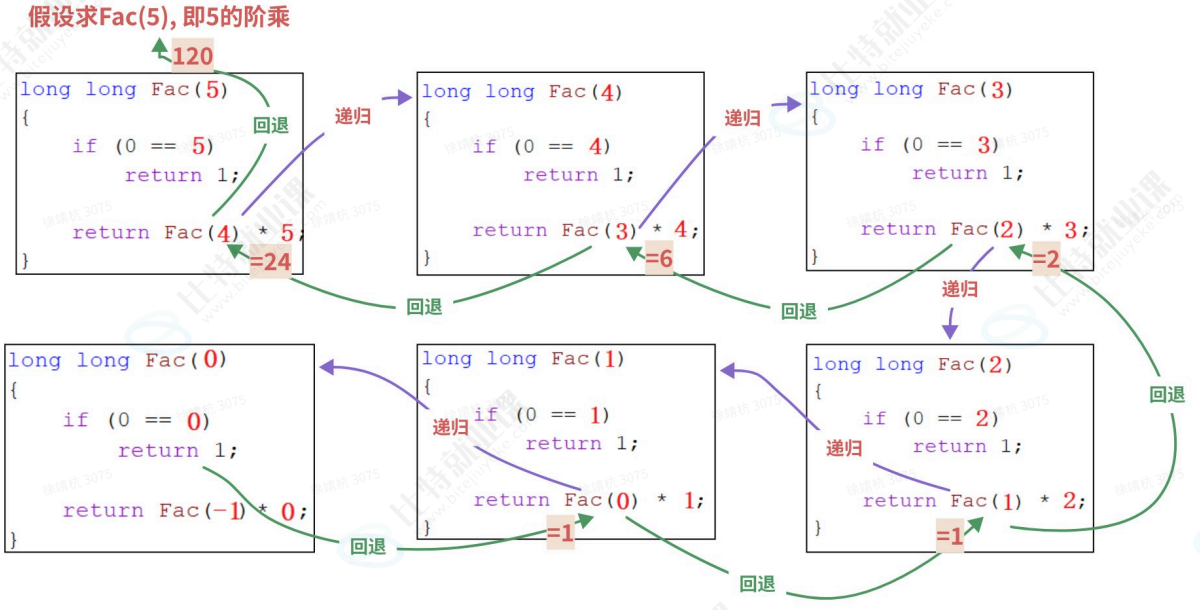
3.3.8 样例8:递归算法
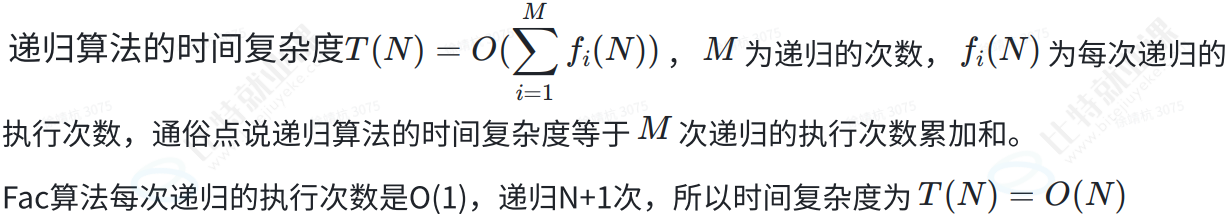
cs
long long Fac(size_t N){
 if(0 == N)
 return 1;

 return Fac(N-1)*N;
}
4. 空间复杂度渐进表⽰法
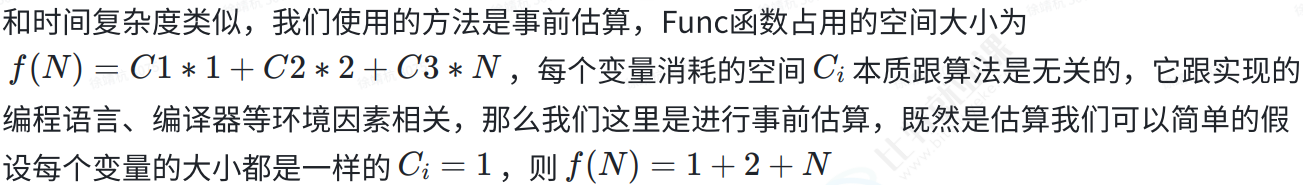
cs
// 算法的运⾏空间F(N) = C1*1 + C2*2 + C3*N
double Func(int N) { // 空间⼤⼩(字节) 变量个数
 double ret = 0; // C1 1
 int i = 1; // C2 1
 char tmp[N]; // C3 N
 while (i <= N) {
 ret += i;
 i++;
 }
 return ret;
} 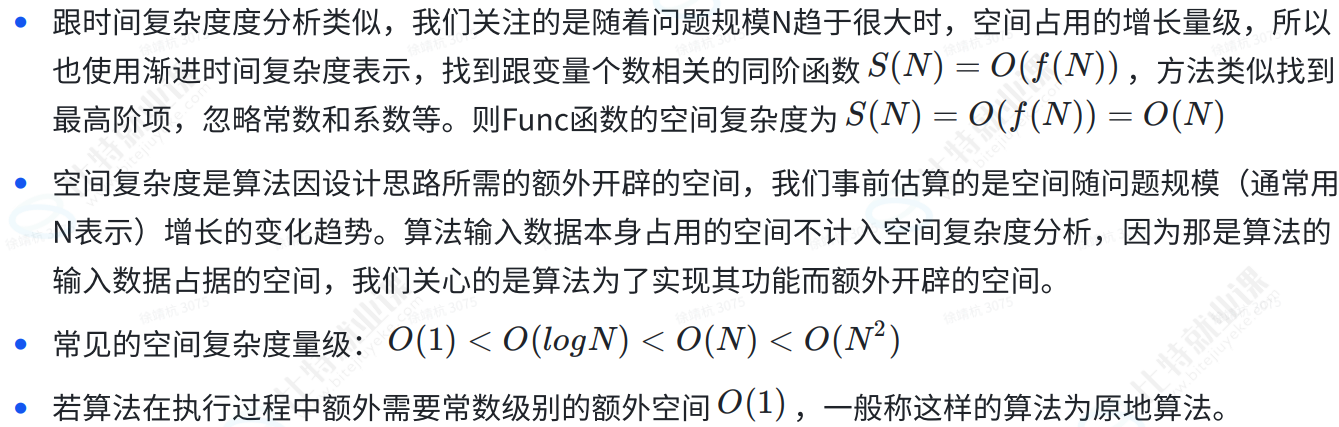
4.1空间复杂度经典样例分析
4.1.1 样例1:O (1)级
Summation算法申请了常数个变量,所以空间复杂度S(N) = O(1)
cs
int Summation(int N) {
int ret = 0;
 int i = 1;
 while (i <= N) {
 ret += i;
 i++;
 }

 return ret;
}
4.1.2样例2:旋转数组时间复杂度为O(N2) ,空间复杂度为O(1)的解题思路
给定⼀个整数数组nums ,将数组中的元素向右轮转k 个位置,其中k 是⾮负数。189.轮转数 组-⼒扣(LeetCode)如果我们采⽤每次将数组中数据右轮转⼀位,轮转k次的思路,则时间复杂 度为T(N)=O(N2) ,空间复杂度为S(N)=O(1) ,需要注意的是leetcode这道题⽬有时间要 求,这个算法思路⽆法达到要求,所以⽆法AC。(AC是Accepted的意思,在OJ(Online Judge)中所 有测试⽤例通过叫AC)
cs
void rotate(int* nums, int numsSize, int k) {
 // 轮转N次相当于回到原来的顺序,所以k⼤于N时,只需要轮转余数次
 k %= numsSize;

 // 轮转k次
 while(k--) {
 // 向右轮转⼀个位置
 int tmp = nums[numsSize-1];
 for(int i = numsSize - 1;i > 0 ;i--)
 {
 nums[i] = nums[i-1];
 }
 nums[0] = tmp;
 }
}
4.1.3 样例3:旋转数组时间复杂度为O(N^2) ,空间复杂度为O(1) 的解题思路
给定⼀个整数数组nums ,将数组中的元素向右轮转k 个位置,其中k 是⾮负数。189.轮转数 组-⼒扣(LeetCode)如果我们采⽤新的思路空间换时间,开辟⼀个额外的跟nums⼀样⼤的临时 数组tmp,将nums的后k个数据挪动到tmp的前k个位置,再将nums前n-k个挪动到tmp的后n-k个 位置,再将tmp数组中的值拷⻉回到nums数组,则时间复杂度为T(N)=O(N) ,空间复杂度为S(N)=O(N)
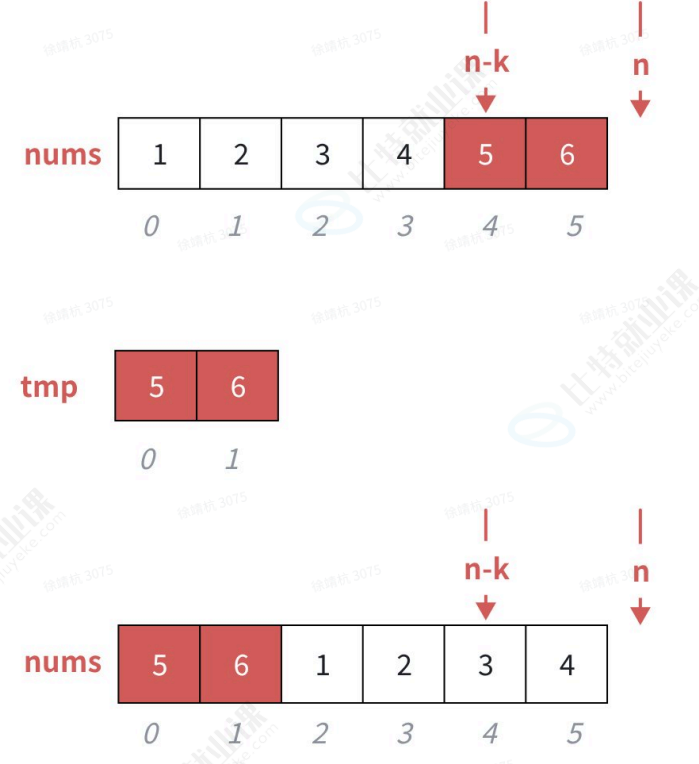
cs
void rotate(int* nums, int numsSize, int k){
 k %= numsSize;
 if(k == 0)
 return;

 int tmp[k];
 // 拷⻉nums中的后k个到tmp的前k个位置
 int j = 0;
 for(int i = numsSize-k; i < numsSize; ++i) {
 tmp[j++] = nums[i];
 }

 // 从后往前拷⻉nums前n-k个到后n-k个位置
 for(int i = numsSize-k-1; i >= 0; --i) {
 nums[i+k] = nums[i];
 }

 // 将tmp数组中的值拷⻉回到nums数组
 for(int i = 0; i < k; ++i) {
 nums[i] = tmp[i];
 }
}
4.1.4样例4:旋转数组时间复杂度为O(N) ,空间复杂度为O(K) 的解题思路
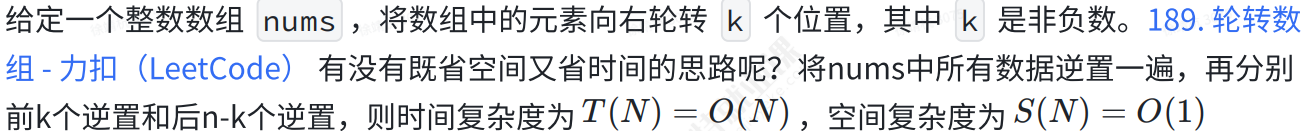
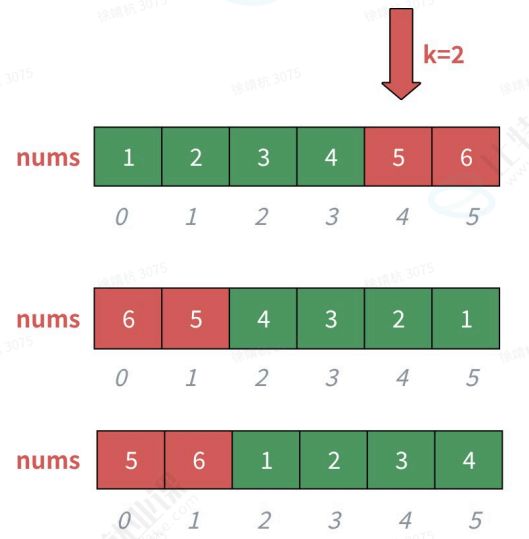
cs
void reverse(int* a, int left, int right) {
 while(left < right) {
 int tmp = a[left];
 a[left] = a[right];
 a[right] = tmp;
 ++left;
 --right;
 }
}

void rotate(int* nums, int numsSize, int k){
 k %= numsSize;

 // 整体逆置
 reverse(nums, 0, numsSize-1);
 // 前k个逆置
 reverse(nums, 0, k-1);
 // 后n-k个逆置
 reverse(nums, k, numsSize-1);
}
4.1.5 样例5:递归算法
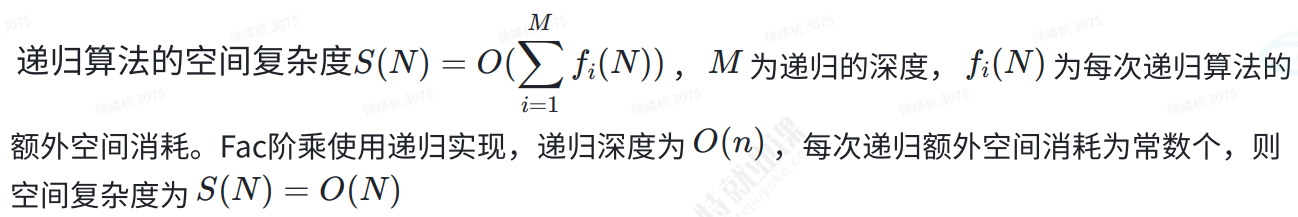
cs
// 计算递归求阶乘Fac算法的空间复杂度?
long long Fac(size_t N){
 if (N <= 0)
 return 1;
 return Fac(N - 1) * N;
}