九月中旬,AI圈突然被一个奇怪的名字刷屏,Jev。它没有炫酷的对话演示,没有让人惊呼的写作能力,甚至官方明确表示这东西不会生成文本。但正是这份反常,让它在Hacker News、Reddit、X上引发了一轮真假难辨的激烈讨论。这篇文章带你把Jev的来龙去脉、核心概念和潜在应用彻底捋一遍。
一、来龙去脉,一个ChatGPT元老的转身
Jev出自一家叫TypeSafe AI的实验室,创始人是Diogo Almeida,他的履历不算普通,曾在OpenAI参与打造让语言模型学会遵循指令、进行对话的核心方法,这套方法后来正是ChatGPT背后的研究支撑之一 。
按官方博客的说法,Almeida在潜心研究了两年后,带着团队走出隐身模式,在2026年9月15日正式发布了公司首款产品,Jev 。他给出的问题很直接,语言模型在聊天场景里已经强到超人类水平好几年了,但自动化这件事怎么迟迟没有真正落地。他认为答案在于,整个行业都在拼命堆砌System 2式的深思熟虑型模型,而大多数软件系统真正需要的是System 1式的快速直觉判断 。
这个命名本身就藏着一个彩蛋,Jev这个名字致敬的是经济学家William Stanley Jevons,而System One/System Two的说法则借用了心理学家丹尼尔·卡尼曼在《思考,快与慢》里提出的双系统理论,System 1对应快速直觉,System 2对应慢速理性推理 。TypeSafe把现有的GPT、Claude这类带链式思考的大模型统统归入System 2阵营,而Jev是他们定义的全新品类,System One模型的第一个公开代表。
从时间线上看,这不是一次孤立的营销事件。TypeSafe选在9月15日发布博客文章,DataCamp和AI News等技术媒体在16到18日陆续跟进报道 ,Hacker News上的讨论帖也几乎同步出现,评论区里既有对性能数字的赞叹,也有大量对校准概率这个说法是否名副其实的质疑 。可以说,Jev一出场,就是带着争议长大的。
二、核心概念拆解,这东西到底新在哪
想理解Jev,得先弄明白它和ChatGPT、Claude这类大家熟悉的大语言模型到底差在哪一层。下面这张图大致勾勒出两条路线的分野。
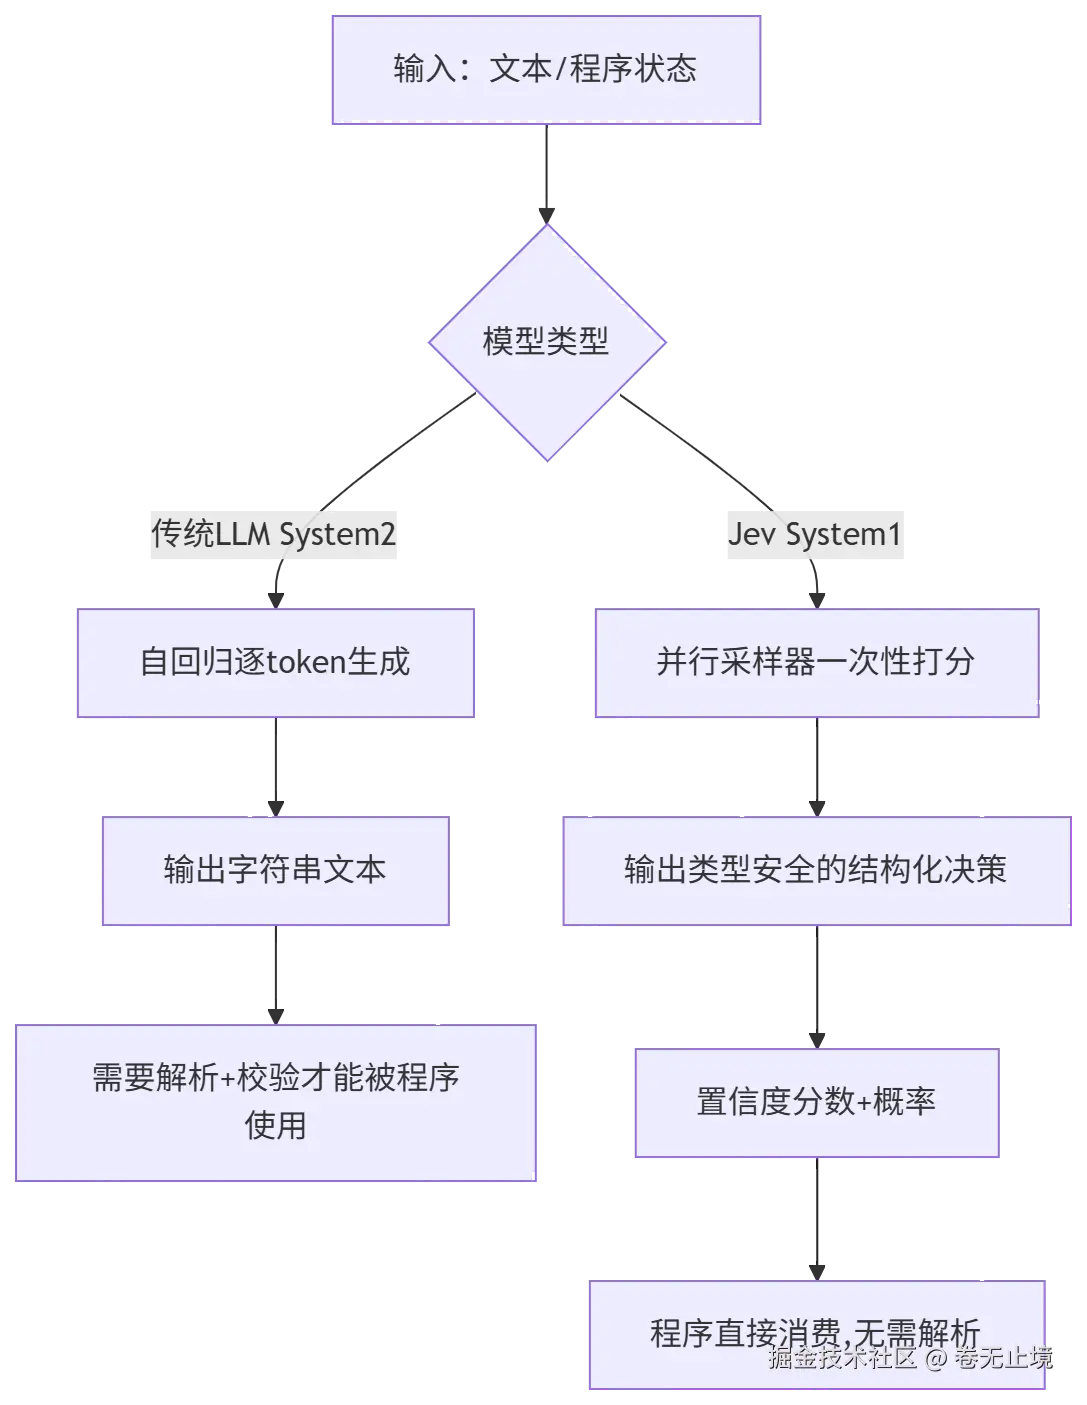
2.1 不生成文本,只输出类型安全的结构化决策
这是Jev最颠覆直觉的一点。普通LLM的工作方式是自回归 ,一个token接一个token地往外蹦,每个新token都要基于前面已经生成的内容来预测,这也是为什么大模型回答起来总要等上几秒甚至更久 。Jev反其道而行,它接收的是非结构化的程序状态,输出的却是提前在架构里定义好的类型化结构值 ,比如一个枚举选项、一个分类标签、一个带置信度的判断,而不是一段自然语言 。因为可能的输出空间是提前锁死的,模型理论上不会犯语法层面的类型错误,官方也据此宣称它不会产生幻觉,当然这个说法在业内争议不小,毕竟幻觉的定义本身就存在模糊地带。
2.2 并行采样,而不是逐字接龙
传统LLM响应一次请求要3到329秒 ,这个区间放在需要毫秒级响应的自动化系统里显然是不够用的。Jev用的是硬件感知的并行采样器,一次查询把所有候选结果同时算出来,官方给出的端到端延迟是70到500毫秒 ,AI News那边的独立测算甚至给出过最高193.6倍的执行速度提升,当然这个数字是在特定的固定计算图任务上跑出来的,不能简单当成普适倍率 。
2.3 RLCD,一种专为校准概率而生的训练方法
传统大模型主要靠两种强化学习方式打磨,一种是基于人类反馈的RLHF,优化的是人类觉得读起来舒服的回答,另一种是基于可验证奖励的RLVR,常用于数学、代码这类能自动判分的任务 。TypeSafe则提出了第三条路,叫做面向校准决策的强化学习 ,简称RLCD。它优化的目标不是让人喜欢答案的措辞,而是让模型给出的置信度分数和实际准确率真正对齐,也就是说,如果模型说自己有90%的把握,那么在类似情境下大约就应该有九成的正确率,而不是那种嘴上说"我很确定"实际却经常翻车的过度自信 。这种概率校准的思路,其实在统计学和机器学习里早有基础,只是TypeSafe把它系统性地用到了决策类模型的训练目标上。
2.4 成本结构的巨大落差
价格方面的对比也很戏剧化。常见前沿大模型的输入token价格从每百万token0.2美元到10美元不等,输出token通常还要贵上五倍左右 。Jev的输入定价是每百万token0.042美元,输出因为不走生成式采样,官方直接标注为免费,理由是便宜到不值得计量 。DataCamp的独立测评把这套账算得更细,在他们跑的四项工作流基准上,Jev准确率大约68%,和GPT-5.6 Terra这类中档大模型相当,但成本能便宜40到400倍,速度快20到200倍 。
三、应用场景,从游戏机器人到petabyte级数据处理
TypeSafe官方和后续报道给出了几类颇具代表性的落地场景。
- 软件里的智能if语句,把原本靠人工硬编码、容易变得脆弱的分支逻辑,替换成模型驱动的分类、路由、打分、抽取判断,思路上更像是给传统程序装了一个模糊推理的插件 。
- 超大规模数据的批处理,面对petabyte级别的数据,用Jev做特征提取和洞察挖掘,靠的正是它并行、低成本的优势,这在过去用大模型逐条处理是根本负担不起的 。
- 实时交互场景,官方专门提了一个例子,让Jev以每秒10次查询的频率操控一个《毁灭战士》游戏里的实时反应机器人,运行成本大约每小时7美元,这背后考验的正是毫秒级响应能力 。
- 网络路径规划测试,团队还做了一个Wiki百科链接寻路的测试,评估模型在密集的百科词条网络里选择跳转路径的效率,结果显示它比一些非推理型模型走的步数更少,也更少出现选到死胡同的情况 。
- AI输出的守门人 ,用来给别的大模型的提示词、推理链或最终输出打分、验证、加护栏,甚至检测越狱攻击,这个方向在Reddit上有用户实测过,称在几个公开基准上对有害内容分级任务的表现明显优于其他方案 。
下面这张表把Jev和传统前沿LLM的定位差异梳理得更直观一些。
| 维度 | 传统前沿LLM(如GPT系列、Claude系列) | Jev(System One模型) |
|---|---|---|
| 输出形式 | 自然语言字符串 | 预定义模式下的类型化结构值 |
| 生成方式 | 自回归逐token | 并行一次性采样 |
| 训练目标 | RLHF/RLVR,人类偏好或可验证奖励 | RLCD,校准概率 |
| 响应速度 | 数秒到数百秒 | 约70到500毫秒 |
| 典型场景 | 聊天、写作、编程助手、复杂推理 | 高频重复决策、实时分类路由、大规模数据处理 |
四、潜力有多大,争议又在哪
Jev最吸引人的地方,是它填补了一个此前被忽视的空白,就是那些不需要人类阅读答案 的场景。写文章、聊天机器人、代码生成这些任务天生需要文本这种载体,但软件系统内部大量的分支判断、分类打分、路由决策,本质上根本不需要一段文字,只需要一个带置信度的答案,这恰恰是Jev瞄准的市场 。如果这个方向真的跑通,未来的软件架构里可能会出现一种新的组件形态,不是调用API拿一段文本再拿去解析,而是像调用一个函数一样直接拿到结构化的判断结果,官方自己就把它形容为前沿智能的函数调用 。
不过质疑的声音同样不小。Hacker News上的讨论里,有人对校准决策 这个说法本身提出追问,认为概率优化和实际业务价值之间到底是什么关系,官方给出的解释还不够透明 。也有技术博主写文章分析,认为Jev展现出的很多能力,本质上或许是把现有大模型的置信度输出、结构化输出功能做了一次专门化和效率优化的封装,而不是凭空造出了一种全新的智能形态 。这种争论其实挺健康,毕竟任何声称两个数量级性能提升的说法,都值得放到更广泛、更中立的第三方基准里再跑一遍才能真正立住。
从更长远的视角看,Jev代表的这条路线,如果能在准确率和成本之间找到更好的平衡点,很可能会催生出一整类专门服务于机器对机器 决策场景的模型产品,和目前主流的机器对人对话模型形成互补而非替代的关系。这大概也是为什么TypeSafe选择用System One/System Two这个框架来讲故事,它不是在说Jev比GPT或者Claude更聪明,而是在说,自动化世界里本来就存在两种截然不同的智能需求,过去大家一直在用同一把锤子敲两种钉子。
参考资料
TypeSafe AI, Introducing System One Models & Jev , typesafe.ai/blog/introd...
DataCamp, Jev: TypeSafe's System One Model That Never Hallucinates , www.datacamp.com/blog/system...
AI News, ChatGPT pioneer launches Jev model for programmatic logic , www.artificialintelligence-news.com/news/chatgp...
Hacker News讨论帖, Introducing System One Models and Jev , news.ycombinator.com/item?id=497...
dev.to, This New AI Model Refuses to Write Text. That Is Exactly Why It Runs 100x Faster , dev.to/jamilxt/thi...