最近两年问AI知识库怎么搭的人特别多,很多技术团队看了几篇RAG教程,觉得不就是文档切块+向量化+大模型问答嘛,自己也能做。结果真上手了才发现,Demo做出来容易,做成一个能让几百人天天用的生产系统,坑比想象的多得多。
这篇文章就从技术架构的角度,拆解一个企业级AI知识库应该包含哪些核心模块,每个模块最容易出问题的地方在哪里。
整体架构:四层结构,缺一不可
一个完整的企业AI知识库,从下到上应该分成四层:数据层、处理层、引擎层、应用层。很多开源框架只帮你做了中间的检索引擎层,剩下的数据处理、权限、应用都要自己补,这也是为什么很多团队自己搭到一半发现工程量远超预期。
先讲最底层的数据层。这一层是最容易被低估的,因为企业里的知识根本不是整整齐齐的Word文档------它散落在PDF、Excel、PPT、扫描件、图片、网页、Wiki、甚至群聊记录里。你需要支持的不只是文本解析,还要能处理表格、图片里的文字、带格式的文档、甚至扫描件的OCR。
这里有个坑:很多开源解析库处理中文PDF会乱码,处理带合并单元格的表格会错位,处理扫描件的识别率很低。如果你要处理的文档里有大量工程图纸、合同扫描件、复杂Excel报表,通用的解析方案根本不够用,必须单独做适配。
然后是数据同步机制。知识库不是一次性导入就完事了,企业里的文档天天在更新:产品手册改了、制度更新了、出了新的销售政策。系统必须支持从企业网盘、OA、Wiki自动同步增量更新,而不是每次改了文档都要手动重新上传一遍,否则不出三个月库里的内容就过时了。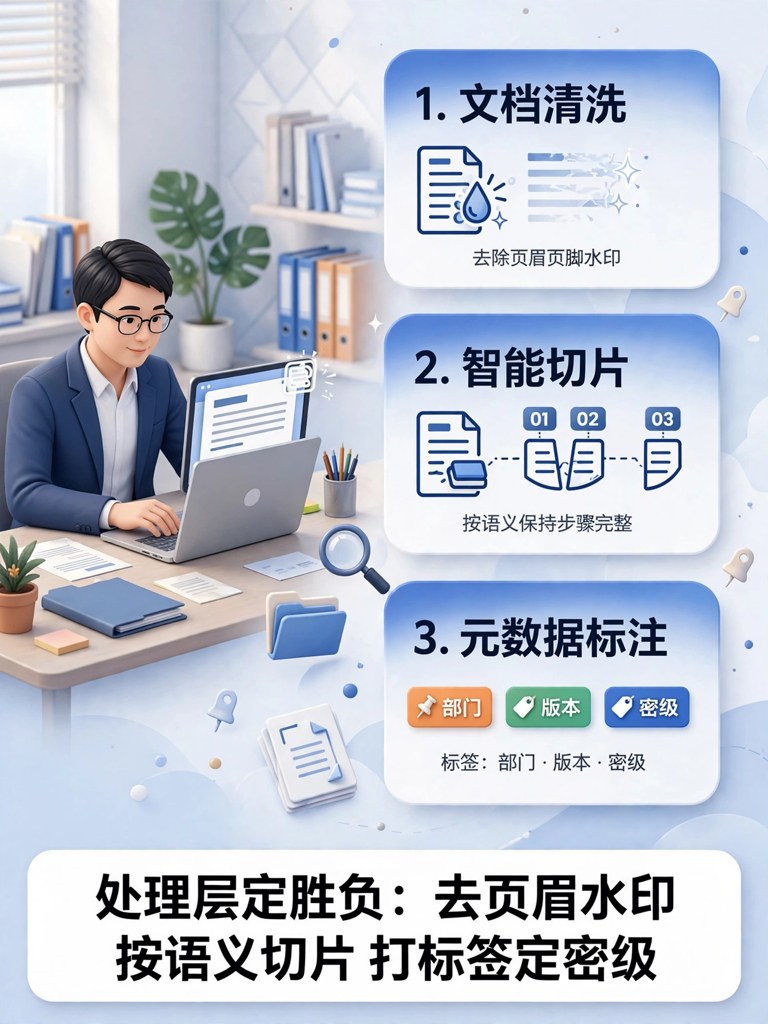
处理层:80%的准确率问题出在这里
文档解析完不是直接切块存向量就完事了,处理层做的好不好,直接决定最后回答的准确率。这一层核心要做四件事:文档清洗、智能切片、知识结构化、元数据标注。
文档清洗要去掉页眉页脚、水印、目录、重复段落,这些内容如果进了向量库,会严重干扰检索结果。很多系统回答不准,就是因为切块的时候把"XX公司内部资料 第X页"这种页眉也切进去了,检索的时候经常命中这些无效片段。
智能切片是最考验经验的地方。很多人图省事按固定字符数切(比如每500字切一块),这是最差的方案。正确的做法是按语义切片:保持一个完整的段落、一个完整的操作步骤、一个完整的问答在同一个块里。比如操作指南里的"第一步、第二步、第三步"就不应该被切开,否则检索到第二步但看不到第一步和第三步,大模型根本理解不了。
还有元数据标注。每个知识块必须打上标签:属于哪个部门、哪个产品、哪个版本、密级是多少、更新时间是什么时候、负责人是谁。这些元数据一方面用于权限过滤,另一方面用于检索的时候做加权------最新版本的内容优先级高于旧版本,官方发布的制度优先级高于讨论稿。
引擎层:检索比模型更重要
很多人选型的时候只关心用什么大模型,其实RAG系统的效果,70%取决于检索做得好不好,模型只占30%。检索做得差,再聪明的模型也没用------你都没把正确的内容召回给它,它再怎么编也是错的。
企业级的检索一定是混合检索,不能只靠向量相似度。至少要三路召回:关键词检索(BM25)解决专有名词、型号、数字的精确匹配;向量检索解决语义理解,比如用户问"怎么请假"能匹配到"考勤休假管理办法";知识图谱检索解决实体关系,比如问"XX产品的售后政策"能关联到对应的质保条款、售后流程、联系方式。
三路召回之后还要做重排序(Rerank),把最相关的结果排到前面。因为大模型的上下文窗口是有限的,你不可能把所有召回的内容都塞给它,必须把最相关的3-5条挑出来。很多系统回答不准,根本原因是重排序没做好,正确的内容被排到了后面,根本没进到上下文里。
还有一个必须有的模块:引用溯源。每个AI回答必须标注引用了哪几个知识块、出自哪份文档、页码是多少,用户可以一键跳转到原文。这不仅是建立信任的问题,也是合规的要求------尤其是在金融、医疗、制造这些行业,给出的建议必须有依据,不能是AI瞎编的。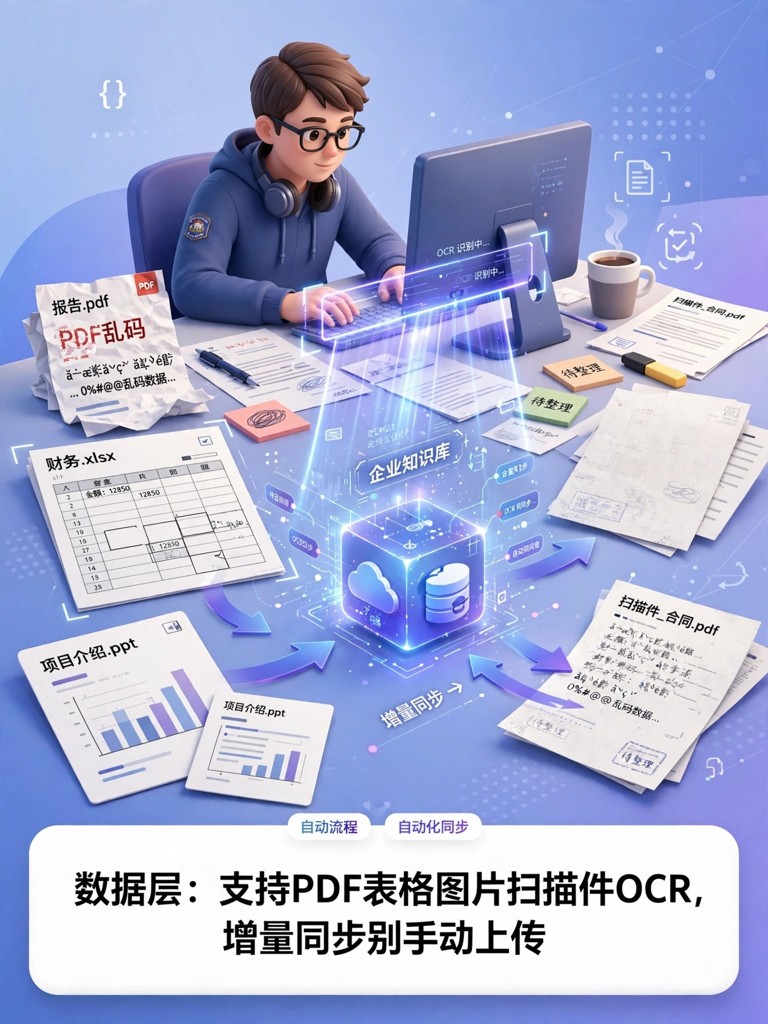
应用层:用户用不用,全看这一层
引擎做得再好,用户端不好用也是白搭。应用层最少要包含几个核心模块:
- 多端入口:Web端、企业微信/钉钉机器人、飞书插件、API接口,用户在哪个场景都能用上,不用特意打开一个网站。
- 权限体系:和企业组织架构打通,按角色、部门、密级做行级权限控制,检索的时候就做权限过滤,用户看不到、也搜不到他没权限的内容。
- 反馈与审核:每个回答有"对/错"反馈按钮,点错了进入人工审核队列,管理员可以修正答案、标记错误,这些反馈数据反过来用于优化检索和切片策略,形成持续优化的闭环。
- 数据后台:看什么问题被问得最多、哪些问题搜不到答案、哪些文档命中率最高、用户满意度是多少,这些数据指导运营人员持续补充内容、优化知识库。
很多团队做知识库,只做了"文档上传+AI问答"这一个功能,剩下的权限、反馈、运营、系统集成都没做,这样做出来的东西充其量是个Demo,根本不可能在企业里真正用起来。
最后说成本问题。很多人以为搭个知识库花不了多少钱,实际上如果要做成生产可用的系统,工作量远不止写个RAG调用脚本。如果企业自己的技术团队没有相关经验,从零开始踩坑的成本其实很高,不如找做过同类项目的团队基于成熟框架定制开发,把精力放在梳理自己的业务知识、设计内容运营机制上,这才是知识库真正能跑起来的核心。