用 AI 开发 3D 坦克世界《钢铁洪流》的系列文章,继续!
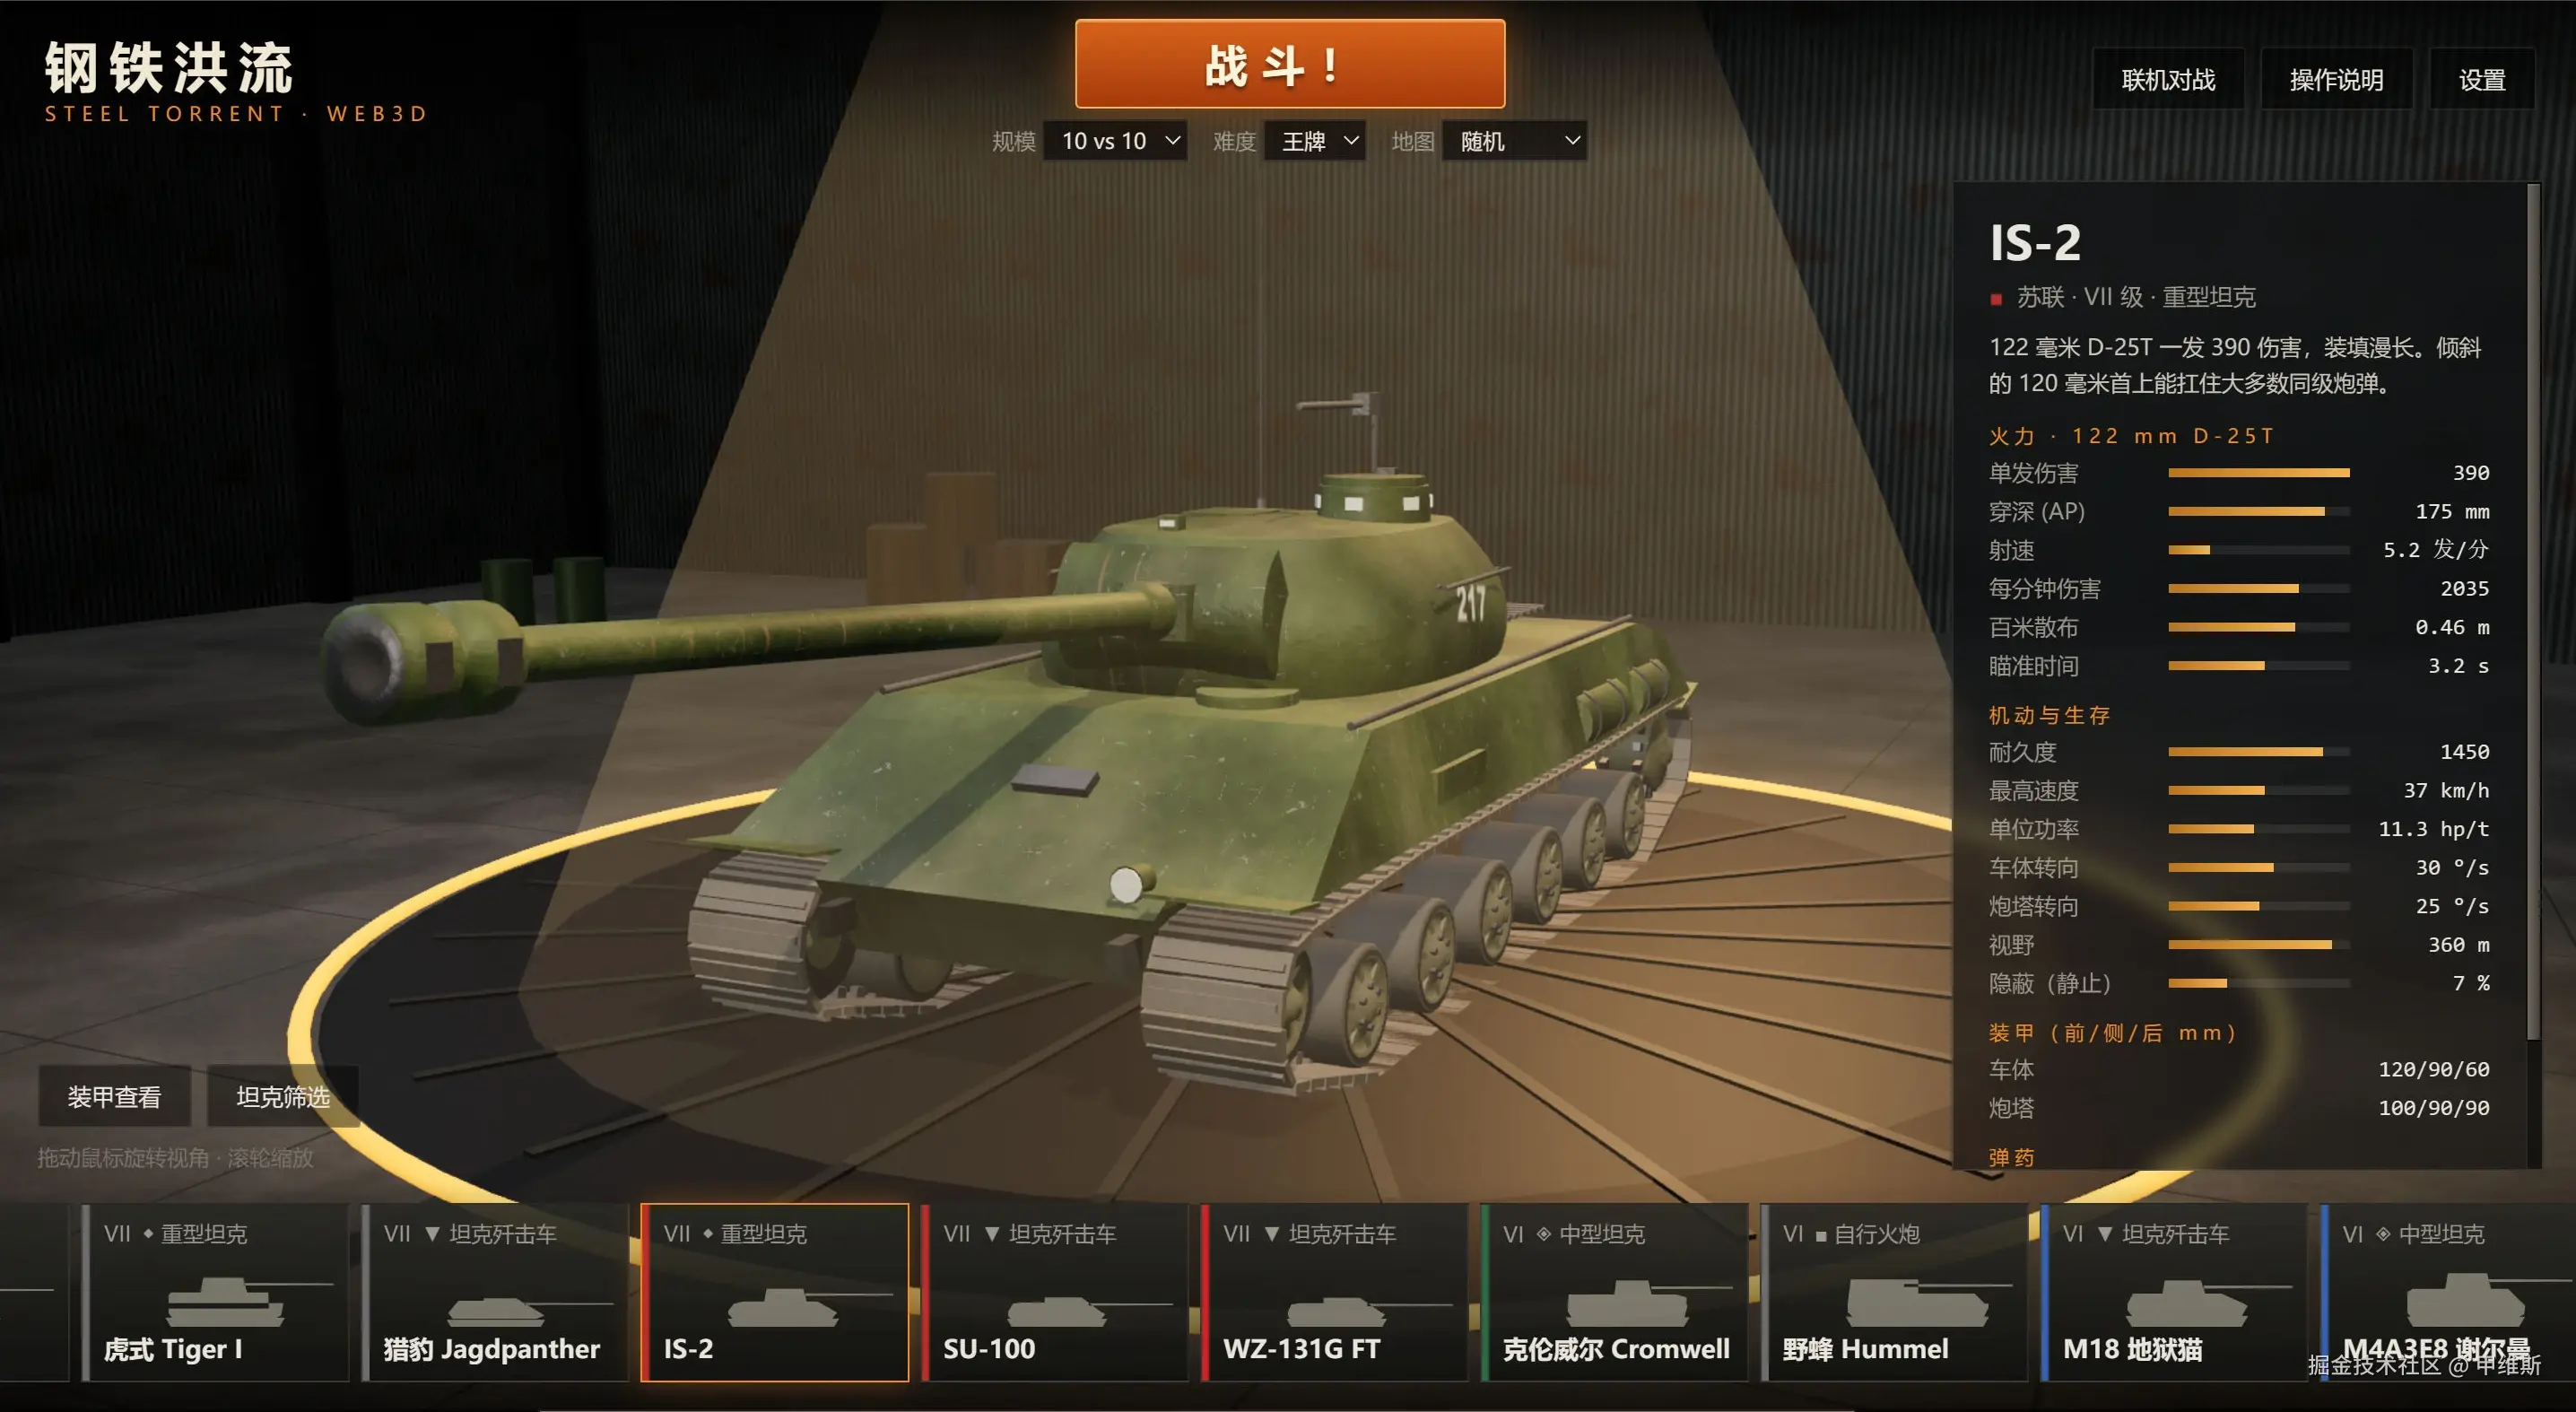
在此之前,已经通过几句话,开发了 V1 版游戏和游戏官网,整体来说都挺不错的。
今天要做一个游戏升级。
重点是升级"AI 玩家",也就是陪我们一起玩的那些电脑玩家,也可以叫 NPC 玩家。
它们演得好不好,直接决定我们的体验。
第一个版本,只是能玩,但是不够智能。今天给它们上点强度,增加一下可玩性。
我们虽然是开发笔记,但是不会有一行代码,这一点请放心。
但是,本文有一定难度,越到后面信息量越大,可以先收藏,也可以选择性阅读。
不想关注实现细节的,可以直接去在线体验:
下面进入正文。
为了修改 AI 策略,我们需要先了解它的机制。
1、一台 AI 坦克的一生
不看任何代码,把一台 AI 坦克从出生到阵亡会经历的事顺着讲一遍。
出生时,它会被分到一条进攻路线。
地图上有三条:村庄中路、山脊侧路、河道侧路。
分路不是随机的,而是按车种偏好抽签:
重坦偏向中路硬顶,轻坦偏向山脊跑视野,歼击车偏向中路但停在靠自己一侧远距离输出,中坦比较平均。
同队已经有人选了某条路,这条路的权重就会下降,避免 14 台车挤在一起。
分完路它会拿到两个航点:先去路线的中途点,后期再推向敌方基地。
倒计时阶段它不动,只把炮塔转向战场正前方。
行军时它沿 A* 算出的路径走。
路径是在一张 100×100 的格子代价图上算出来的,这张图在开局加载时构建一次。
坡太陡、水太深的格子直接标成不可通行;树林、歪坡、地图边缘加代价;公路和桥打折。
所以 AI 会自然地顺着路走、绕开陡坡和建筑,而不是直线撞山。
每 0.25 秒它重新想一次:
现在能看见哪些敌人、该打谁、该处在什么状态。状态只有四种------行军、交战、占领、防守。
发现敌人靠的是全队共享的视野系统,AI 不作弊也不比玩家灵敏:
敌车要么进了 50 米的近距离无条件发现圈,要么在自己观察距离内且有通畅视线,并且对方的隐蔽系数没把有效距离压下来。
被发现后这个信息会保留 3 秒再消失。
AI 在此之上还要自己再确认一次视线通畅才会选为目标。
选目标目前很简单:
在 480 米内的已发现敌人中,挑「距离近 + 血少」的那个,对玩家略有偏好,对当前目标有黏性(避免来回换目标)。
瞄准分三步:
先选瞄准点,再加误差,再加提前量。
瞄准点不是车体中心,而是从 6~7 个候选位置(车体上下前后、炮塔正面)挑一个。
对每个候选点做一次护甲射线,算出入射角折算后的等效厚度,再跟自己当前弹种的穿深比一下,选最容易打穿的那个。
找到后叠加一个按车手水平和距离放大的高斯误差,再按炮弹飞行时间和目标速度加一个提前量。
这个瞄准点每次开火后重新算一遍。
开火要同时满足一串条件:
反应时间过了、装填好了、有炮弹、仰角够得到、炮口指向和火控解算角都落在瞄准圈容差内、瞄准圈已经收缩、弹道上没有地形和友军。火炮例外,它是吊射,只检查落点附近有没有友军。
交战时站在哪是有讲究的。
中远距离时它会去找一个「缩回去敌人看不到、往前开几米就能露出炮口」的掩体位,躲在后面装填,装填快好了再前出开火------装填长的车打完会缩回去,装填短的车就留在探头点。没有掩体可用时,重坦和歼击车会停下来对射(重坦还会把车体斜过去 25 度),中坦和轻坦会在装填期间左右挪动躲炮。
挨打之后它只做两件事:
需要的话用消耗品(灭火最快、修理次之、急救包最慢),以及血量低于阈值、敌人还剩三台以上时往自己半场退 130 米找掩护。新兵水平的车手不会撤退。
卡住了它会察觉:
油门给着但速度上不来超过 2.5 秒,就反方向加满舵倒 1.6 秒脱困;如果是倒车时卡住(多半在钻掩体),就放弃这个掩体。
履带被打断时它老实停着等修,只有固定炮座的车会把车体转向目标。
后期:
要么基地被占而回防(自家占领分超过 15 且自己离家不远),要么推到敌方基地圈里占领。敌人剩两台以下、或者时间拖久了,全队放弃磨蹭直接压上去。
上面这些就是核心规则,其实已经有点智能了。
Opus 5 用一个小时写的代码逻辑,我光看中文都需要花很久才能看完,我的大脑完全没办法一下子吸收这么多规则。
本来这篇文章第二章叫:关键子系统的细节。由于实在是太长,太细了。我就不写了!
2、当前水平
第二章,我们简单地来看一下,当前的 AI 玩家都是什么水平。
当前水平主要和"难度"有关,开始战斗前的「难度」下拉框选一次,全队 14 台车共用同一档。每档只有三个数字,再加四处硬编码的行为开关。
具体看下面的表格:
| 新兵 | 老兵 | 王牌 | |
|---|---|---|---|
瞄准误差 aimError |
2.2 | 1.2 | 0.6 |
反应时间 reaction(秒) |
1.4 | 0.8 | 0.45 |
激进度 aggression |
0.6 | 0.85 | 1.0 |
| 弱点瞄准概率 | 15% | 65% | 100% |
| 提前量质量 | 35% | 75% | 100% |
| 残血撤退 | 不撤 | 25% 血以下 | 35% 血以下 |
| 使用掩体 | 不用 | 用 | 用 |
所以现在三档的差别,绝大部分体现在"手准不准、反应快不快"上,战术层面的差别只有「撤不撤退」和「用不用掩体」两条。
3、现在的短板
我们就从玩家的视角来看一下这个事情,了解一下 AI 对手的策略。
1. 一局里所有 AI 都一个样。
车手水平是整队统一的,14 台车的参数完全相同,差异只来自随机数。玩家感受到的是「这局 AI 准不准」,而不是「这台 IS-2 的车手是个老手、那台 T-34 是个新兵」。
2. 敌人一消失,它立刻忘干净。
目标脱离发现状态的瞬间,target 就变成 null,炮塔在一两秒内转回行进方向。真人会继续压住那个墙角等对方出来。AI 没有任何关于「最后已知位置」的记忆。
3. 被打了不做反应。
背后吃一炮,它的目标、车体朝向、掩体选择一个都不变。被击中的信息其实已经记下来了,但只用来决定要不要用消耗品。
4. 会对着打不穿的装甲反复开火。
弱点瞄准只是在候选点里挑「相对最好」的那个,即使所有候选点的击穿比都不到 1 也照样开火。同时评分里不看威胁,所以它可能盯着一台正面硬顶的重坦,而无视旁边正把侧面暴露给它的脆皮。
5. 没有团队配合。
分路只在出生时分一次,之后没有集火、没有侦察分工、没有互相掩护,一路被打崩了也不会有人补位。
6. 车体角度是死的。
只有重坦会斜车体,固定 25 度,斜向哪边在出生时就定了,不跟着威胁方向转,被两面夹击也不调整。
7. 新兵和王牌的区别主要只是手抖。
开火纪律、站位选择、目标判断三档差异都很小。但真实的「菜」主要体现在决策错误上------打得太远、没收缩就开枪、用错弹种、追残血追进对方火力圈。
4、改进方案
改进方案的细节也非常多,我选比较重要和比较容易理解的部分。
1. 从"全队一档"改成"每台车一套技能"
核心思路是把现在的三个难度参数扩成一个十来项的技能向量,每台车出生时各自抽一份 ,而难度下拉框不再直接控制参数,改成决定这一局双方的车手构成比例(两队用同一分布,保证公平),每台车再叠 ±15% 的个体噪声。
| 技能项 | 影响什么 | 新兵 → 王牌 |
|---|---|---|
| 瞄准误差 | 散布大小 | 2.2 → 0.6 |
| 反应时间 | 发现到开始瞄 | 1.4s → 0.45s |
| 提前量 | 打移动目标 | 35% → 100% |
| 弱点瞄准 | 是否挑软处打 | 15% → 100% |
| 开火纪律 | 是否等瞄准圈收缩 | 差 → 好 |
| 掩体意识 | 是否利用掩体、选得好不好 | 不用 → 精于此道 |
| 威胁评估 | 选目标时多大程度看威胁 | 不看 → 完全看 |
| 车体角度 | 斜置质量、是否跟随威胁 | 5° 固定 → 32° 动态 |
| 记忆时长 | 目标消失后压枪多久 | 1.5s → 6s |
| 团队配合 | 是否听队伍调度 | 无视 → 配合 |
| 自律 | 残血撤退、装填后撤、不乱追 | 差 → 好 |
| 慌乱 | 被命中后短时间内能力下降幅度 | 大 → 几乎没有 |
构成比例建议(新兵 / 老兵 / 王牌):
| 难度选项 | 构成 | 玩家感受 |
|---|---|---|
| 新兵 | 70 / 25 / 5 | 大部分菜,偶尔碰上一个难缠的 |
| 老兵 | 25 / 55 / 20 | 有菜有强,接近真实对局 |
| 王牌 | 5 / 35 / 60 | 大部分难缠,偶尔有个送的 |
2. 让它记住敌人去哪了
给每台 AI 一张「接触记录」表:
每个见过的敌人记下最后位置、速度、时间和血量。视线断掉之后,按自己的记忆时长继续把炮口压在预测位置上,期间可以选择朝最后位置机动或者绕后。
3. 威胁评估与被打反应
算一张威胁表:
对每个已知敌人,用现成的护甲模块按自己当前朝向估一下对方能不能打穿我,再考虑一下另外几个维度:它的输出、是否正指着我、距离远近。
4. 打不穿就别硬打
弱点瞄准算完之后加一个下限判断:
如果所有候选点的击穿比都低于 0.9,就不要继续送炮弹,而是换弹种、改打履带把它定住、换个目标、或者机动绕到侧面。
5. 决策从 if 链改成打分仲裁
把 decide() 里那串 if 换成候选行为打分:撤退、修理灭火、掩体探头、原地对射、绕侧、推进、占领、防守、侦察蹲点、反炮兵,每个算一个效用值,取最高的执行。
6. 车种剧本
给不同的坦克一个不同的剧本。
轻坦前期去高隐蔽点蹲 20 秒做被动侦察,而不是跟着大队一起冲;
歼击车用预设的几个射击阵地,而不是每 6 秒重新找;
中坦走二线补刀;重坦顶路口并动态斜置;
火炮做反炮兵并按目标路径预测落点。
7. 低成本高收益的修改
没有目标时炮口指向最近的威胁方向或路口,而不是一律朝正前;
装填剩一半以上时缩回掩体、剩三成以下时前出;
友军阵亡或身边落炮时进入短暂警觉、往掩体靠;
把新兵的「犯错」具体化:
超远距离就开枪、没收缩就开枪、用错弹种、卡石头上转半天、追残血追进对方火力圈。
Opus 5 还帮我做了性能预算:
现在 14 台 AI 一帧合计约 1.1 ms。加威胁表和记忆预计增加 0.3~0.5 ms,可以接受。
牛逼👍,可以精确到 0.x 毫秒!
5、实施顺序和落地情况
这次策略升级,我们规划了三期。
第一期:每车一套技能 + 车手构成、被命中反应、目标记忆与预瞄、威胁加权选目标、打不穿的处置、名单里显示车手水平
第二期:决策仲裁重构、动态车体角度、装填节奏、车种剧本
第三期:队伍层(集火、分路再分配、侦察指派)、火炮反炮兵
第一期的实测结果
10v10「王牌」难度、模拟 139 秒:
| 档位 | 台数 | 命中率 | 伤害 / 车 | 承受 / 车 | 击毁 |
|---|---|---|---|---|---|
| 王牌 | 11 | 73.5% | 450 | 289 | 6 |
| 老兵 | 6 | 43.8% | 289 | 431 | 2 |
| 新兵 | 2 | 25.0% | 176 | 664 | 0 |
可以说差异很明显,改进得不错!
第二期的实测结果
decide() 里的 if 链换成了效用打分:每次思考给八个行为各算一个分数,取最高的执行。现任行为加 15% 分并有最短持续时间(交战 1.2s、撤退 3s、蹲点 5s...),只有分数高出现任一半以上才允许提前打断。
八个行为在一局 7v7 里全部出现过:
| 行为 | 采样占比 | 触发条件 |
|---|---|---|
| engage 交战 | 47% | 有目标,距离越近分越高 |
| arty 炮兵阵地 | 18% | 自行火炮的默认活 |
| advance 推进 | 10% | 兜底;残局或时间紧时加分 |
| snipe 蹲阵地 | 8% | 歼击车,出生时选三个预设阵地 |
| cap 占点 | 4% | 圈内 1.7 分,压过交战(占领只要求停住,炮塔照样开火) |
| scout 侦察蹲点 | 4% | 轻坦前 110 秒 |
| retreat 撤退 | 3% | 残血线 = 0.16 + 自律 × 0.2,或者起火 |
| defend 回防 | 1% | 按自家基地被占点数与自己离家距离加权 |
行为切换每车每局平均 4.8~9.5 次,没有抖动。
之前会出现五辆车隔着三百米对着最后一个敌人站到时间耗尽的僵局,现在人数占优或剩余时间不足 150 秒时,推进与占点的分数会压过远距离对枪。
动态车体角度:
实测一台老兵重坦上限 19.2°、当前 -13.5°,说明平分线项真的在起作用
装填节奏:
纪律好的车手按装填比例进退------装填过半缩回掩体、剩三成以下再前出;纪律差的还是老样子傻等
车种剧本:
轻坦前期去侧翼高地蹲点(scoutSpot())
歼击车轮换三个预设阵地(nextPost(),被打到就换)
中坦按 PREF_RANGE 站二线(200 米)
正面打不穿时绕到目标侧后方七成距离处(flankGoal())
改完之后实测开销:
7v7 整帧 0.911.27 ms,其中 AI 0.110.15 ms;10v10 的 AI 为 0.23 ms。
第三期的实测结果
效果用同一局里的对照组量:
两队都跑队伍层算出同样的呼叫,但 0 队算完就把命令收走(只留影子记录),1 队照常执行。统计每 0.5 秒「领到呼叫的车是否真的在打这个呼叫」
统计结果如下:
| 对照(不执行) | 执行队伍层 | |
|---|---|---|
| 第 1 局 | 75.6% | 86.9% |
| 第 2 局 | 68.3% | 76.0% |
| 第 3 局 | 55.3% | 86.2% |
三局都有提高,平均 +16.6 个百分点。对照组本身就有 55~76%,说明队伍的价值判断和单车自己的判断大方向一致,集火是在「两个目标差不多」的时候起作用,而不是把车拽去打不该打的目标。
改算法这个东西还是有点复杂的!
单单是验证修改效果,也花了很多时间。
还好,这一切,全部由 AI 完成。
我主要负责看懂它的描述,然后说一下,执行第一期,执行第二期,执行第三期。
最后,就是打开玩一下!
最终效果是明显提升了不少,我不敢一个人冲过去了,否则被打成筛子。
这次修改还顺带做了一个优化!
由于加载内容的时候,有 LOD 分级。超过 160 米,setLOD 会把部分细节隐藏掉:
| 隐藏 | 换成 |
|---|---|
逐节履带 trackMesh |
每侧一个长方块 (bandMeshes,尺寸 = 履带宽 × 履带高 × 车长) |
负重轮 wheelMesh |
同上,被这个块盖住 |
| 主动轮 / 诱导轮 / 托带轮 | 同上 |
这本来是一种优化性能的策略,但是这里有一个特殊情况,就是我开镜的时候。
一旦我开镜,距离大概率会有好几百米,这个时候我就会看到一辆简化版的坦克,很粗糙,这样会影响游戏体验。
所以要对狙击镜中的画面做特别优化。一旦开镜,LOD 判断逻辑就要修改!
8 倍镜下阈值变成 1280 米,超过视野上限 445 米,等于狙击时永不降级。
改完之后也做了一个验证:
在一局 7v7 里直接读每辆车的 LOD 状态:
| 目标距离 | 肩视角(阈值 160) | 2× 镜(320) | 8× 镜(1280) |
|---|---|---|---|
| 171 m | 方块 | 完整履带 | 完整履带 |
| 230 m | 方块 | 完整履带 | 完整履带 |
| 514 m | 方块 | 方块 | 完整履带 |
退出狙击镜后全部恢复成方块,没有残留。另外单独挑了一辆 431 米外的 IS-2 在 8× 镜下确认:lodFar=false、负重轮网格 visible=true、简化履带已隐藏。控制台无报错。
性能情况:
| 视角 | 帧耗时 | 降级中的车 |
|---|---|---|
| 肩视角 1× | 3.22 ms | 11 / 14 |
| 狙击镜 2× | 3.45 ms | 7 / 14 |
| 狙击镜 8× | 3.00 ms | 0 / 14 |
没有代价,8× 反而略快,因为视锥窄,大部分车根本不进管线,波动在 ±0.3 ms 内!
居然木有代价,这优化爽歪歪!
这篇文章信息量还是很大的,我已经删减很多了,我把所有涉及到代码的技术细节全部屏蔽了。
代码留给 AI 去看,我们主要理解业务逻辑就可以了。
作为一个用自然语言编程的 AI 程序员,重点还是做方案分析以及结果验证,还有一个重点,要把重要信息提炼到文档中!
Claude 居然把对话历史给弄丢了,一个失误,又覆盖了日志,啥都没有了。还好只是对话记录而已,不是代码!!!
当然上面的几个重点都可以让AI辅助,我们只要抓重点中的重点。
在这种模式中,AI 靠不靠谱很重要。
所以实际开发中,我只用 Anthropic 和 OpenAI 的最强模型!
调用成本虽然高,但是整体收益也很高。
最后 ,联机版已经发布,大家可以测试下,由于服务器在 国外 ,对战中可能会出现一定延迟和卡顿。