C 程序从源文件到运行:预处理、编译、汇编、链接重定位与执行环境
- [C 程序从源文件到运行:预处理、编译、汇编、链接重定位与执行环境](#C 程序从源文件到运行:预处理、编译、汇编、链接重定位与执行环境)
- [1. 阅读前问题卡:C 程序的翻译、链接与运行](#1. 阅读前问题卡:C 程序的翻译、链接与运行)
- [1.1 阅读前先看这几个问题](#1.1 阅读前先看这几个问题)
- [1.2 读完后完成这 3 道高频问题](#1.2 读完后完成这 3 道高频问题)
- [1.3 自检清单](#1.3 自检清单)
- [2. 前言](#2. 前言)
- [3. 目标](#3. 目标)
- [4. 翻译环境和运行环境](#4. 翻译环境和运行环境)
- [5. 翻译环境](#5. 翻译环境)
- [5.1 预处理(预编译)](#5.1 预处理(预编译))
- [5.2 编译](#5.2 编译)
- [5.2.1 词法分析](#5.2.1 词法分析)
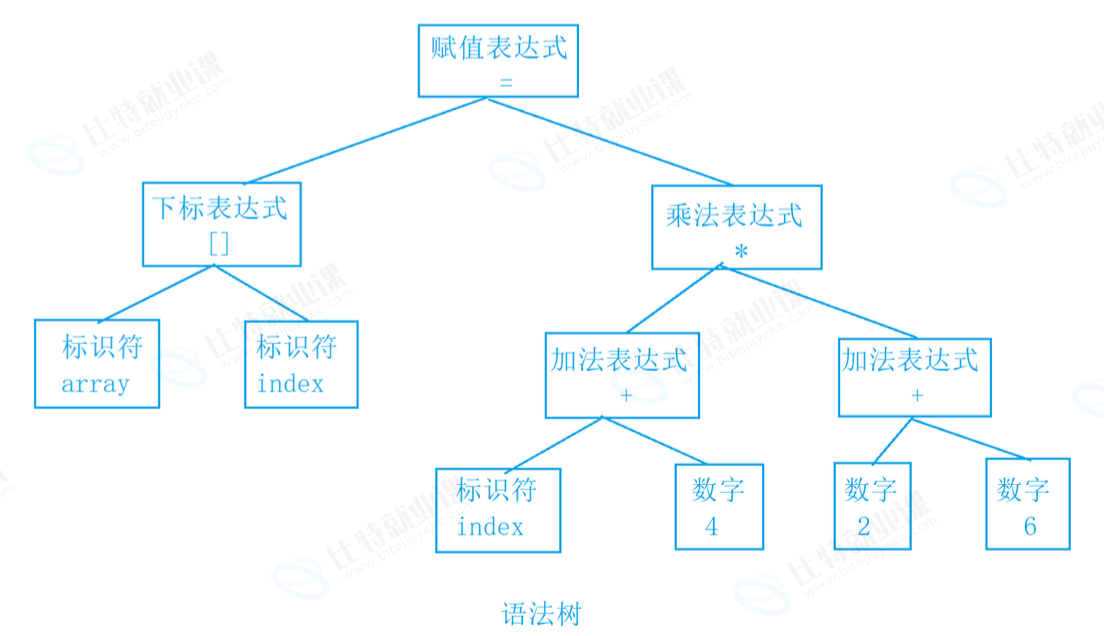
- [5.2.2 语法分析](#5.2.2 语法分析)
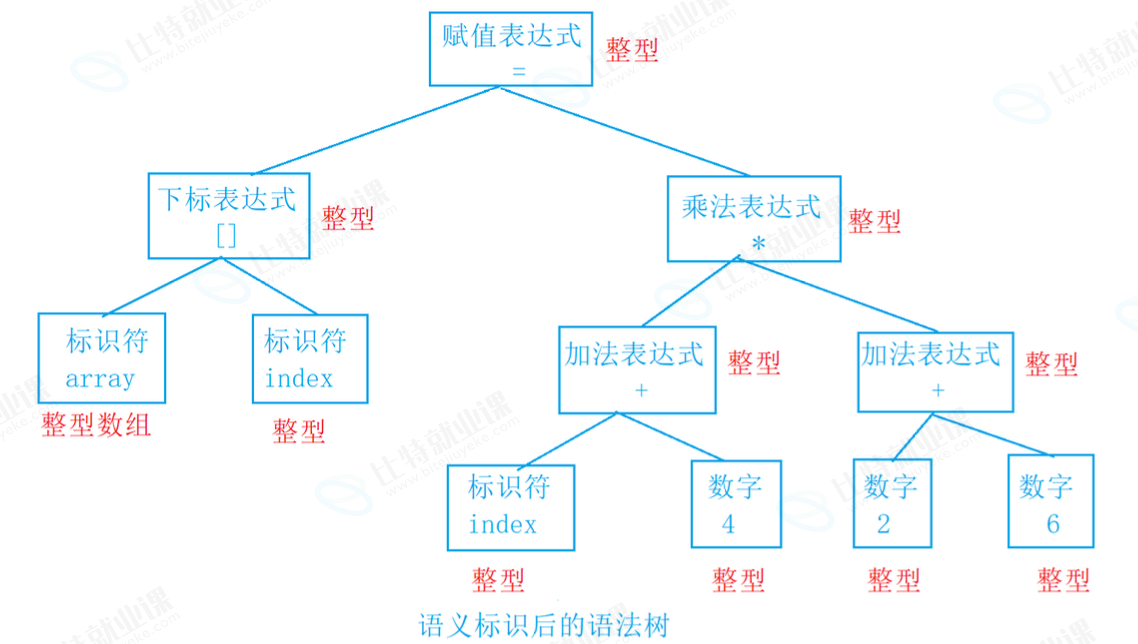
- [5.2.3 语义分析](#5.2.3 语义分析)
- [5.3 汇编](#5.3 汇编)
- [5.4 链接](#5.4 链接)
- [6. 运行环境](#6. 运行环境)
1. 阅读前问题卡:C 程序的翻译、链接与运行
建议先读:先看第 4 节区分翻译环境与运行环境,再沿第 5 节的预处理、编译、汇编、链接顺序阅读。
1.1 阅读前先看这几个问题
- ANSI C 实现中的翻译环境和运行环境分别负责什么,二者如何衔接?
- 多个
.c文件如何分别生成目标文件,并与链接库一起形成可执行程序? - 预处理、编译和汇编分别接收什么文件、生成什么文件,文档给出的
gcc命令各是什么? - 对表达式
array[index] = (index + 4) * (2 + 6);进行词法分析、语法分析和语义分析时,信息如何逐步变化? - 预处理阶段如何处理宏、条件编译、头文件、注释、行号与
#pragma指令? - 单独编译
test.c时为什么无法确定Add和g_val的地址,链接器如何通过符号查找和重定位解决这个问题? - 可执行程序进入运行环境后,从载入内存、调用
main到终止会经历哪些步骤,运行时堆栈和静态内存分别保存什么?
1.2 读完后完成这 3 道高频问题
1.2.1 高频问题 1:请从源文件开始,完整说明 C 程序经过翻译环境生成可执行程序,并在运行环境中启动和终止的主要流程。
1.2.2 高频问题 2:预处理、编译、汇编分别完成什么工作?它们的输入、输出和 gcc 命令有什么区别?
1.2.3 高频问题 3:为什么多文件程序需要链接和重定位?请结合 test.c、add.c、Add 和 g_val 说明符号决议如何解决地址未知问题。
1.3 自检清单
- 我能区分翻译环境和运行环境,并说明二者的衔接点。
- 我能按顺序说出预处理、编译、汇编、链接及其主要产物。
- 我能列出预处理阶段处理的主要内容,并说明查看
.i文件的用途。 - 我能区分词法分析、语法分析和语义分析的产物与关注点。
- 我能用
test.c和add.c的例子解释符号决议与重定位。 - 我能复述程序载入、调用
main、使用运行时存储并最终终止的过程。
2. 前言
读这篇文档,可以把问题分成三组。第一组关注"代码怎样逐步变成机器能执行的形式";第二组关注"多个文件怎样拼成一个程序";第三组关注"程序生成后怎样真正跑起来"。
第一组像把一份手写稿送进印刷厂:编辑先展开缩写、补齐引用并删掉批注,排版人员再检查句子结构和含义,最后制版机把排好的内容转换成机器可读的版面。对应到 C 程序,预处理器处理宏、条件编译、头文件、注释、行号和 #pragma,编译器继续做词法、语法、语义分析及优化,汇编器再把汇编语句翻译成机器指令,依次得到 .i、.s 和 .o 等产物。
第二组像把几位作者分别写好的章节装订成一本书。每位作者只知道自己章节里的内容,引用别人的章节时先留下一个名字;装订时再根据名字找到真正的页码,并把引用位置改成最终页码。多文件 C 项目也是如此:每个 .c 文件单独生成目标文件,链接器把目标文件与运行时库或第三方库放在一起,进行地址和空间分配、符号决议与重定位。test.c 对 Add 和 g_val 的引用在单独编译时地址未知,链接阶段才由链接器查找并修正。
第三组像一场演出从装台到谢幕:演出前要把布景搬到场地,开场后按入口进入主流程,演出中需要临时道具和长期布景,结束时还要处理正常或意外退场。程序运行时,程序先被载入内存,随后调用 main;函数局部变量和返回地址使用运行时堆栈,静态内存中的变量在整个执行期间保留值,最后程序正常终止或意外终止。
3. 目标
- 掌握 C 语言的翻译环境和运行环境。
- 可以拆解和理解翻译环境中预编译、编译、汇编、链接的核心工作。
- 理解 C 语言程序是怎么变成二进制指令的,理解编译器的重要性。
- 理解计算机语言,像 C 语言其实是为人设计的语言,以及为什么要有计算机语言。
4. 翻译环境和运行环境
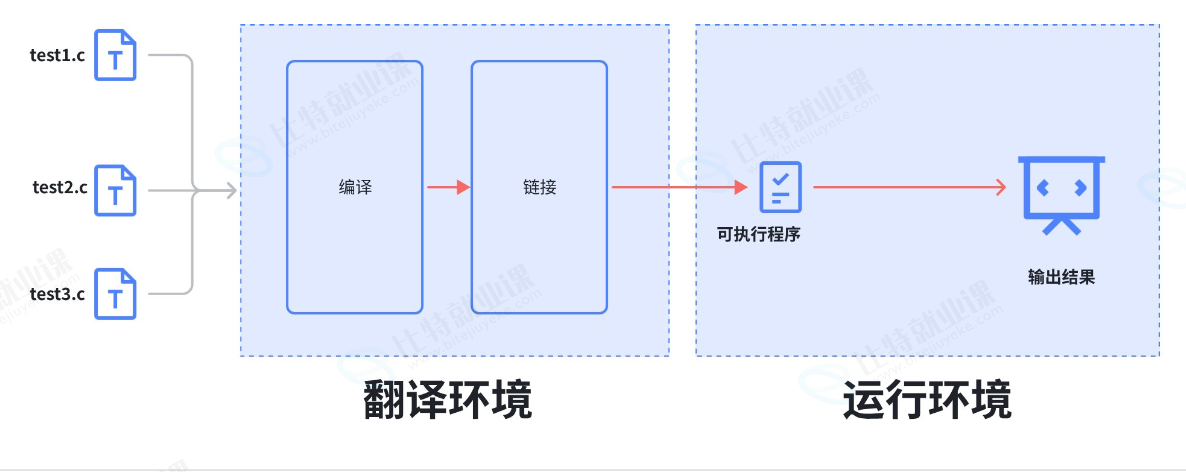
在 ANSI C 的任何一种实现中,存在两个不同的环境。
- 第 1 种是翻译环境,在这个环境中源代码被转换为可执行的机器指令(二进制指令)。
- 第 2 种是执行环境,它用于实际执行代码。
5. 翻译环境
那翻译环境是怎么将源代码转换为可执行的机器指令的呢?这里我们就得展开讲解一下翻译环境所做的事情。
其实翻译环境是由编译 和链接 两个大的过程组成的,而编译又可以分解成预处理(有些书也叫预编译)、编译、汇编三个过程。
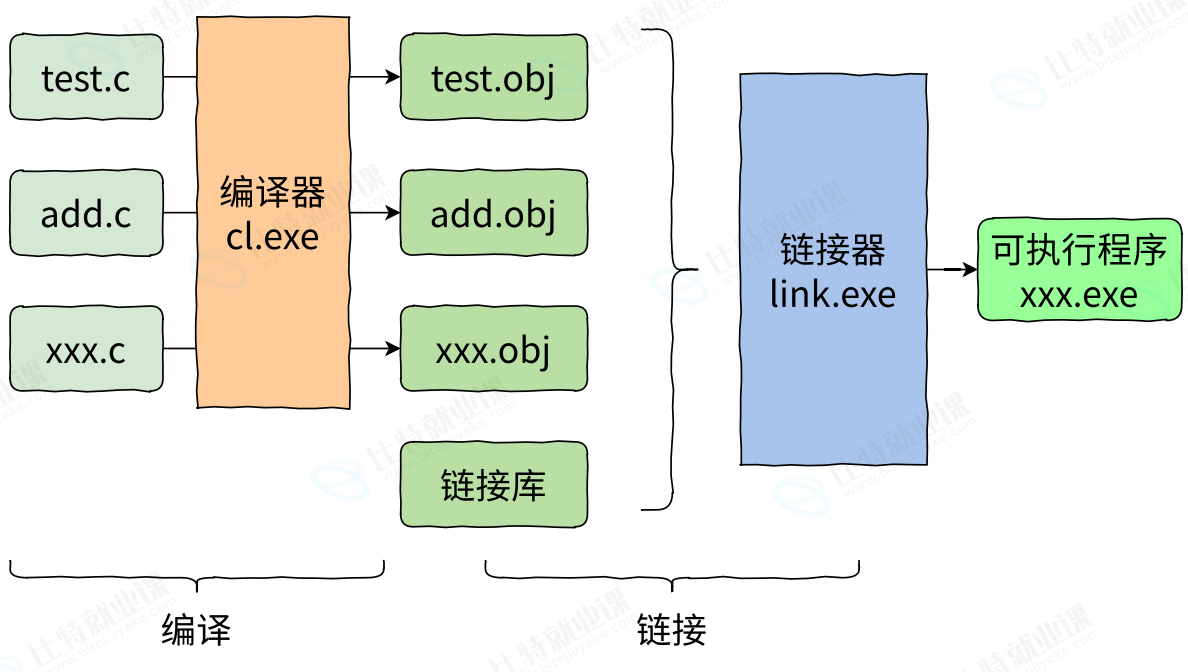
一个 C 语言的项目中可能有多个 .c 文件一起构建,那多个 .c 文件如何生成可执行程序呢?
- 多个
.c文件单独经过编译器,编译处理生成对应的目标文件。 - 注:在 Windows 环境下,目标文件的后缀是
.obj;Linux 环境下,目标文件的后缀是.o。 - 多个目标文件和链接库一起经过链接器处理,生成最终的可执行程序。
- 链接库是指运行时库(它是支持程序运行的基本函数集合)或者第三方库。
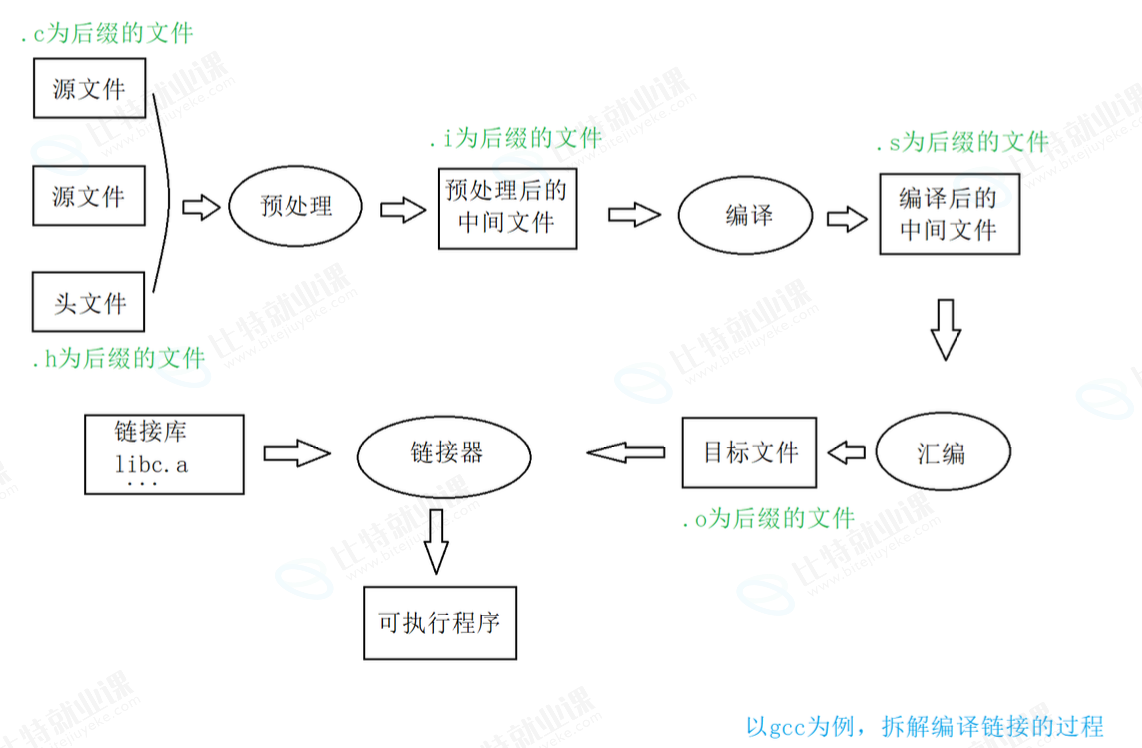
如果再把编译器展开成 3 个过程,那就变成了下面的过程:
5.1 预处理(预编译)
在预处理阶段,源文件和头文件会被处理成为以 .i 为后缀的文件。
在 gcc 环境下想观察 test.c 文件预处理后的 .i 文件,命令如下:
bash
gcc -E test.c -o test.i预处理阶段主要处理源文件中以 # 开始的预编译指令 ,比如 #include、#define。处理规则如下:
- 将所有的
#define删除,并展开所有的宏定义。 - 处理所有的条件编译指令,如
#if、#ifdef、#elif、#else、#endif。 - 处理
#include预编译指令,将包含的头文件内容插入该预编译指令的位置。这个过程是递归进行的,也就是说,被包含的头文件也可能包含其他文件。 - 删除所有的注释。
- 添加行号和文件名标识,方便后续编译器生成调试信息等。
- 保留所有的
#pragma编译器指令,编译器后续会使用。
经过预处理后的 .i 文件中不再包含宏定义,因为宏已经被展开,并且包含的头文件都被插入到 .i 文件中。所以当我们无法知道宏定义或者头文件是否包含正确的时候,可以查看预处理后的 .i 文件来确认。
5.2 编译
编译过程就是将预处理后的文件进行一系列的词法分析、语法分析、语义分析及优化,生成相应的汇编代码文件。
编译过程的命令如下:
bash
gcc -S test.i -o test.s对下面代码进行编译的时候,会怎么做呢?假设有下面的代码:
c
array[index] = (index + 4) * (2 + 6);5.2.1 词法分析
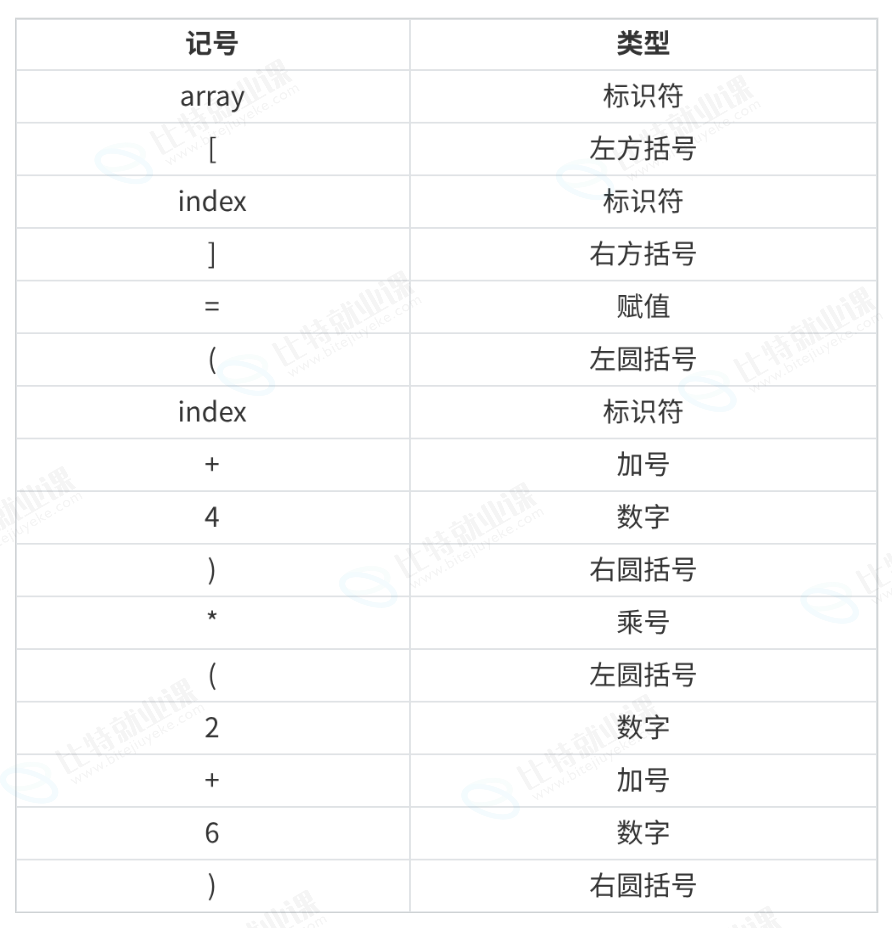
源代码程序被输入扫描器 。扫描器的任务就是简单地进行词法分析 ,把代码中的字符分割成一系列的记号(关键字、标识符、字面量、特殊字符等)。
上面程序进行词法分析后得到了 16 个记号:
5.2.2 语法分析
接下来,语法分析器 将对扫描产生的记号进行语法分析,从而产生语法树。这些语法树是以表达式为节点的树。
5.2.3 语义分析
由语义分析器来完成语义分析,即对表达式的语法层面分析。编译器所能做的分析是语义的静态分析。静态语义分析通常包括声明和类型的匹配、类型的转换等。这个阶段会报告错误的语法信息。
5.3 汇编
汇编器是将汇编代码转变成机器可执行的指令(2 进制的指令),每一个汇编语句几乎都对应一条机器指令。就是根据汇编指令和机器指令的对照表一一进行翻译,也不做指令优化。
汇编的命令如下:
bash
gcc -c test.s -o test.o5.4 链接
链接是一个复杂的过程,链接的时候需要把一堆文件链接在一起才生成可执行程序。
链接过程主要包括地址和空间分配、符号决议和重定位等步骤。
链接解决的是一个项目中多文件、多模块之间互相调用的问题。
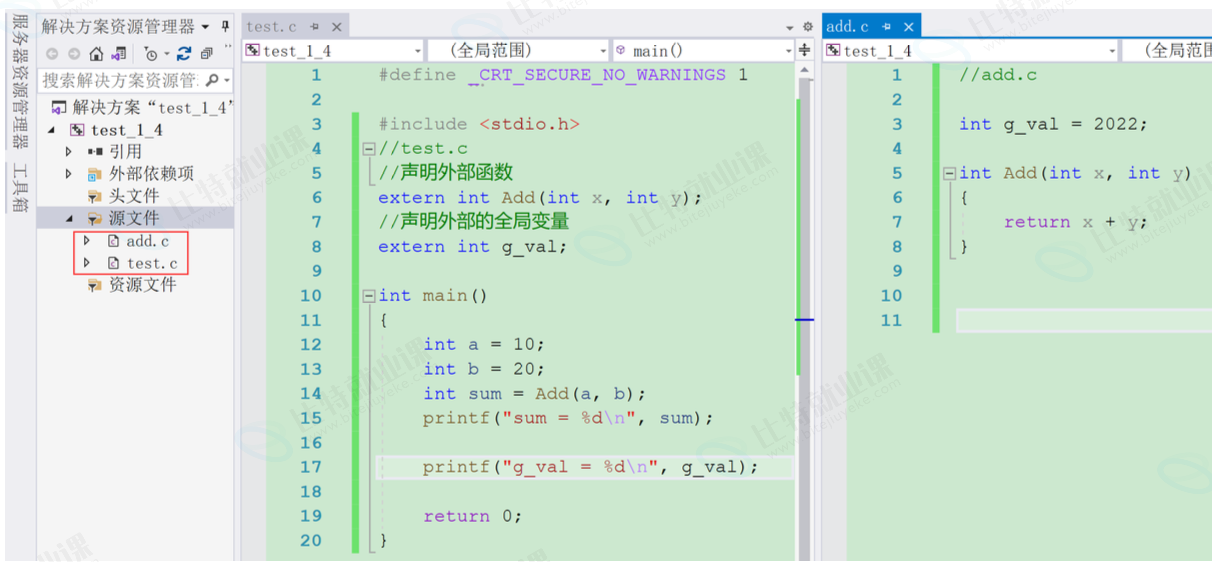
比如,在一个 C 项目中有 2 个 .c 文件(test.c 和 add.c),代码如下:
test.c
c
#include <stdio.h>
//test.c
//声明外部函数
extern int Add(int x, int y);
//声明外部的全局变量
extern int g_val;

int main()
{
    int a = 10;
    int b = 20;
    int sum = Add(a, b);
    printf("%d\n", sum);
    return 0;
}
add.c
c
int g_val = 2022;

int Add(int x, int y)
{
    return x + y;
}
我们已经知道,每个源文件都是单独经过编译器处理,生成对应的目标文件。
test.c经过编译器处理,生成test.o。add.c经过编译器处理,生成add.o。
我们在 test.c 文件中使用了 add.c 文件中的 Add 函数和 g_val 变量。
我们在 test.c 文件中每一次使用 Add 函数和 g_val 的时候,必须确切地知道 Add 和 g_val 的地址。但是由于每个文件是单独编译的,在编译器编译 test.c 的时候并不知道 Add 函数和 g_val 变量的地址,所以暂时把调用 Add 的指令的目标地址和 g_val 的地址搁置。等待最后链接的时候,由链接器根据引用的符号 Add 在其他模块中查找 Add 函数的地址,然后将 test.c 中所有引用到 Add 的指令重新修正,让它们的目标地址为真正的 Add 函数的地址。对于全局变量 g_val,也是用类似的方法来修正地址。这个地址修正的过程也被叫作重定位。
前面我们非常简洁地讲解了一个 C 程序如何编译和链接,并最终生成可执行程序的过程。其实很多内部的细节无法展开讲解,比如目标文件的格式 elf,链接底层实现中的空间与地址分配、符号解析和重定位等。如果你有兴趣,可以看 《程序员的自我修养》 一书来详细了解。
6. 运行环境
- 程序必须载入内存中。在有操作系统的环境中,一般由操作系统完成;在独立的环境中,程序的载入必须由手工安排,也可能是通过可执行代码置入只读内存来完成。
- 程序的执行便开始,接着调用
main函数。 - 开始执行程序代码。这个时候程序将使用一个运行时堆栈(
stack) ,存储函数的局部变量和返回地址。程序同时也可以使用静态(static)内存,存储于静态内存中的变量在程序的整个执行过程一直保留它们的值。 - 终止程序。正常终止
main函数,也有可能是意外终止。
7.回答问题卡的问题
问题 1:ANSI C 实现中的翻译环境和运行环境分别负责什么,二者如何衔接?
答:
翻译环境负责把环境中的源代码转换为可执行的机器指令(二进制指令)
执行环境负责实际的执行代码
翻译环境通过编译和链接把源代码转换为可执行程序,运行环境再负责载入并执行这个程序。通过链接器衔接,链接过程主要包括地址和空间分配、符号决议和重定位等步骤。链接解决的是一个项目中多文件、多模块之间互相调用的问题。
问题 2:多个 .c 文件如何分别生成目标文件,并与链接库一起形成可执行程序?
答:
-
多个
.c文件单独经过编译器,编译处理生成对应的目标文件。 -
注:在 Windows 环境下,目标文件的后缀是
.obj;Linux 环境下,目标文件的后缀是.o。 -
多个目标文件和链接库一起经过链接器处理,生成最终的可执行程序。
-
链接库是指运行时库(它是支持程序运行的基本函数集合)或者第三方库。
问题 3:预处理、编译和汇编分别接收什么文件、生成什么文件,文档给出的 gcc 命令各是什么?
答:
预处理接收源文件和头文件,生成以.i为后缀的文件,命令为gcc -E test.c -o test.i
编译接收预处理后的文件,生成相应的汇编代码文件,命令为gcc -S test.i -o test.s
汇编将汇编代码代码变成机器可执行的指令(二进制)命令为gcc -c test.s -o test.o
问题 4:对表达式 array[index] = (index + 4) * (2 + 6); 进行词法分析、语法分析和语义分析时,信息如何逐步变化?
答:
-
先进行词法分析:源代码程序被输入扫描器 。扫描器的任务就是简单地进行词法分析 ,把代码中的字符分割成一系列的记号(关键字、标识符、字面量、特殊字符等)。
再进行语法分析:语法分析器 将对扫描产生的记号进行语法分析,从而产生语法树。这些语法树是以表达式为节点的树。
最后进行语义分析:由语义分析器 来完成语义分析,即基于语法结构做静态语义检查。编译器所能做的分析是语义的静态分析。静态语义分析通常包括声明和类型的匹配、类型的转换等。这个阶段会报告错误的语义信息。
问题 5:预处理阶段如何处理宏、条件编译、头文件、注释、行号与 #pragma 指令?
答:
-
将所有的
#define删除,并展开所有的宏定义。 -
处理所有的条件编译指令,如
#if、#ifdef、#elif、#else、#endif。 -
处理
#include预编译指令,将包含的头文件内容插入该预编译指令的位置。这个过程是递归进行的,也就是说,被包含的头文件也可能包含其他文件。 -
删除所有的注释。
-
添加行号和文件名标识,方便后续编译器生成调试信息等。
-
保留所有的
#pragma编译器指令,编译器后续会使用。
问题 6:单独编译 test.c 时为什么无法确定 Add 和 g_val 的地址,链接器如何通过符号查找和重定位解决这个问题?
答:
我们在 test.c 文件中每一次使用 Add 函数和 g_val 的时候,必须确切地知道 Add 和 g_val 的地址。但是由于每个文件是单独编译的,在编译器编译 test.c 的时候并不知道 Add 函数和 g_val 变量的地址,所以暂时把调用 Add 的指令的目标地址和 g_val 的地址搁置。等待最后链接的时候,由链接器根据引用的符号 Add 在其他模块中查找 Add 函数的地址,然后将 test.c 中所有引用到 Add 的指令重新修正,让它们的目标地址为真正的 Add 函数的地址。对于全局变量 g_val,也是用类似的方法来修正地址。这个地址修正的过程也被叫作重定位。
问题 7:可执行程序进入运行环境后,从载入内存、调用 main 到终止会经历哪些步骤,运行时堆栈和静态内存分别保存什么?
答:
- 程序必须载入内存中。在有操作系统的环境中,一般由操作系统完成;在独立的环境中,程序的载入必须由手工安排,也可能是通过可执行代码置入只读内存来完成。
- 程序的执行便开始,接着调用
main函数。 - 开始执行程序代码。这个时候程序将使用一个运行时堆栈(
stack) ,存储函数的局部变量和返回地址。程序同时也可以使用静态(static)内存,存储于静态内存中的变量在程序的整个执行过程一直保留它们的值。 - 终止程序。正常终止
main函数,也有可能是意外终止。
高频问题 1:请从源文件开始,完整说明 C 程序经过翻译环境生成可执行程序,并在运行环境中启动和终止的主要流程。
答:
从源文件开始,每个 .c 文件先经过预处理,得到 .i 文件;再经过编译,完成词法、语法、语义分析和优化,得到 .s 汇编文件;汇编器把它转换成 .o 或 Windows 下的 .obj 目标文件。多个目标文件与运行时库或第三方库交给链接器,链接器完成地址和空间分配、符号决议和重定位,生成可执行程序。进入运行环境后,程序先被载入内存,随后调用 main 并开始执行;执行中使用运行时堆栈保存局部变量和返回地址,静态内存中的变量持续保留值,最后正常或意外终止。
高频问题 2:预处理、编译、汇编分别完成什么工作?它们的输入、输出和 gcc 命令有什么区别?
答:
预处理接收源文件,连同头文件处理宏、条件编译、包含关系和注释等内容,输出 .i 文件,命令是 gcc -E test.c -o test.i。编译接收 .i 文件,进行词法、语法、语义分析和优化,输出 .s 汇编文件,命令是 gcc -S test.i -o test.s。汇编接收 .s 文件,把汇编语句转换成机器指令,输出 .o 目标文件,命令是 gcc -c test.s -o test.o。
高频问题 3:为什么多文件程序需要链接和重定位?请结合 test.c、add.c、Add 和 g_val 说明符号决议如何解决地址未知问题。
答:
多文件程序需要先分别编译,是因为每个源文件可以独立生成目标文件;但 test.c 中引用的 Add 和 g_val 可能定义在 add.c 或其他模块中,单独编译时无法知道它们的最终地址。链接器把 test.c、add.c 等目标文件和库组合起来,根据符号名找到 Add 和 g_val 的定义,再把 test.c 中相应的调用和访问位置修正为最终地址。这个查找定义的过程属于符号决议,修改引用地址的过程属于重定位。