C / C++ 核心知识点梳理与详解
本文档基于原始学习笔记整理重构而成。
整理思路:先 C 后 C++,先语法基础后面向对象,最后补充底层与工具;对原文中表述不清、缺失背景、只有结论没有推演的知识点补全了原理推导与可运行示例;对原文中散落的图片资料按主题重新归位。
约定:文中所有可运行的代码均以 C++ 风格给出(除特别注明为 C 的部分)。标注 ⚠️ 的为易错点,标注 💡 的为理解要点。
目录
- [第 0 章 阅读本书前的基础约定](#第 0 章 阅读本书前的基础约定)
- [第一部分 C 语言核心细节](#第一部分 C 语言核心细节)
- [第 1 章 变量、存储与作用域](#第 1 章 变量、存储与作用域)
- [第 2 章 字符与字符串](#第 2 章 字符与字符串)
- [第 3 章 数组与循环控制](#第 3 章 数组与循环控制)
- [第 4 章 递归](#第 4 章 递归)
- [第 5 章 整型常量与类型提升](#第 5 章 整型常量与类型提升)
- [第 6 章 枚举类型](#第 6 章 枚举类型)
- [第二部分 C++ 面向过程部分](#第二部分 C++ 面向过程部分)
- [第 7 章 内存分区与堆区管理](#第 7 章 内存分区与堆区管理)
- [第 8 章 引用](#第 8 章 引用)
- [第 9 章 函数:默认参数、占位参数与重载](#第 9 章 函数:默认参数、占位参数与重载)
- [第三部分 C++ 面向对象](#第三部分 C++ 面向对象)
- [第 10 章 类与对象基础](#第 10 章 类与对象基础)
- [第 11 章 构造函数与析构函数](#第 11 章 构造函数与析构函数)
- [第 12 章 深拷贝与浅拷贝](#第 12 章 深拷贝与浅拷贝)
- [第 13 章 对象成员、静态成员与 this 指针](#第 13 章 对象成员、静态成员与 this 指针)
- [第 14 章 const 与成员函数/对象](#第 14 章 const 与成员函数/对象)
- [第 15 章 友元](#第 15 章 友元)
- [第 16 章 运算符重载](#第 16 章 运算符重载)
- [第 17 章 继承](#第 17 章 继承)
- [第 18 章 多态](#第 18 章 多态)
- [第四部分 文件操作与底层补充](#第四部分 文件操作与底层补充)
- [第 19 章 文件操作](#第 19 章 文件操作)
- [第 20 章 汇编与 DOS 指令入门](#第 20 章 汇编与 DOS 指令入门)
- [附录 A 易错点速查表](#附录 A 易错点速查表)
第 0 章 阅读本书前的基础约定
在正式进入知识点之前,先约定几个贯穿全文的概念,否则后面的很多"为什么"会讲不通。
0.1 内存四区模型
程序运行时,内存被划分为若干区域。理解这块是理解"生命周期""作用域""深浅拷贝"的前提。
| 区域 | 存放内容 | 何时分配 | 何时释放 |
|---|---|---|---|
| 代码区 | 函数体的二进制机器指令 | 程序加载时 | 程序结束时 |
| 全局区(静态区) | 全局变量、静态变量、字符串常量 | 程序加载时 | 程序结束时 |
| 栈区 | 函数形参、局部变量 | 函数调用时由编译器自动分配 | 函数返回时自动释放 |
| 堆区 | new / malloc 申请的空间 |
程序员手动申请 | 程序员手动 delete / free |
💡 一句话记住 :栈是"自动的、小的、快的";堆是"手动的、大的、慢的"。
局部变量住在栈区,所以函数一返回它就没了------这是后面"不要返回局部变量的引用/指针"的根本原因。
0.2 栈的生长方向与形参入栈顺序
大部分主流平台(x86/x64)上:
- 栈从高地址向低地址生长;
- 函数实参从右往左依次入栈。
这个细节解释了 C++ 的两条硬性规则:
- 有默认值的形参必须放在形参列表最右边(因为从右往左匹配,缺省的只能是尾部);
- 栈上的局部变量超出作用域即失效。
第一部分 C 语言核心细节
第 1 章 变量、存储与作用域
1.1 初始化值的两种命运:随机值 vs 默认 0
原始笔记中的表述:没有加 static 默认为 auto 型,此时不给初值,变量或数组(包括字符数组)的初值是随机的 ;但加了 static 不给初值,初值默认为 0。
严格地说,这个规律更准确的划分依据是变量的存储期 而非 auto 关键字:
| 存储位置 | 未显式初始化时的初值 | 举例 |
|---|---|---|
| 栈区(自动存储期) | 不确定值(原有内存残留数据),读到什么全凭运气 | 局部变量、局部数组 |
| 全局区(静态存储期) | 一律为 0(数值 0 / 空指针 / 空字符) | 全局变量、static 变量、static 局部变量 |
cpp
#include <iostream>
using namespace std;

int g_arr[5];          // 全局数组 → 全部为 0
static int s_num;      // 静态变量 → 0

void test() {
    int a;             // ⚠️ 局部变量,未初始化 → 不确定值
    int arr[5];        // ⚠️ 局部数组,未初始化 → 全部为不确定值
    static int sa;     // 静态局部变量 → 0

    cout << "sa = " << sa << endl;   // 稳定输出 0
    // cout << a << endl;            // 千万别这样用:结果不可预期
}

int main() {
    for (int i = 0; i < 5; i++) cout << g_arr[i] << " ";  // 0 0 0 0 0
    cout << endl;
    test();
    return 0;
}
⚠️ 易错点:不要依赖"局部变量是 0"或"局部变量是某个固定值"。这是典型的未定义行为(UB),换一个编译器、换一次编译优化,结果都可能不同。
为什么静态变量可以是 0?
因为静态存储期的变量在程序加载阶段 就由操作系统/加载器把所在内存段整体清零了(对应可执行文件的 .bss 段)。而栈区空间是复用的------上一次函数调用的残留数据还在那里,所以是"脏"的。
1.2 静态局部变量
定义 :在函数内部用
static修饰的局部变量。只在第一次 调用时初始化,之后每次调用函数都不再重新初始化,而是保留上一次函数调用结束时的值。
cpp
#include <iostream>
using namespace std;

void counter() {
    static int cnt = 0;   // 只执行一次
    cnt++;
    cout << "第 " << cnt << " 次调用" << endl;
}

int main() {
    counter();  // 第 1 次调用
    counter();  // 第 2 次调用
    counter();  // 第 3 次调用
    return 0;
}
输出:
第 1 次调用
第 2 次调用
第 3 次调用三个关键特征:
- 生命周期是全局的(程序结束才销毁);
- 作用域仍然局限在函数体内部(外面访问不到);
- 未初始化时默认为 0。
💡 常见用途:函数调用计数器、只需初始化一次的昂贵资源(懒加载)。
1.3 静态全局变量
与普通全局变量的区别 :普通全局变量可以被整个项目(多个
.c/.cpp文件)共用;静态全局变量只能被当前文件内的函数访问。
cpp
// ---- fileA.cpp ----
static int secretA = 100;   // 只在 fileA.cpp 内可见
int shareA = 200;           // 全项目可见(需在别的文件 extern 声明)

// ---- fileB.cpp ----
extern int shareA;          // ✅ 可以链接到
// extern int secretA; // ❌ 链接错误:找不到符号可以把静态全局变量看作被限制了作用域的全局变量------它依然是全局生命周期,但链接器不给它对外暴露符号名。
💡 工程价值:避免多个源文件中的同名全局变量发生符号冲突(重定义错误)。
1.4 变量的三种生存期小结
| 变量种类 | 作用域 | 生命周期 | 未初始化值 |
|---|---|---|---|
局部变量(auto) |
本函数 | 本函数调用期间 | 不确定 |
静态局部变量(static) |
本函数 | 整个程序 | 0 |
| 全局变量 | 整个项目 | 整个程序 | 0 |
静态全局变量(static) |
本文件 | 整个程序 | 0 |
第 2 章 字符与字符串
这一章是整个笔记中信息密度最高、也最容易出错的部分之一。
2.1 空字符 '\0'
'\0' 是转义字符,代表空字符 ,其 ASCII 码值为 0。
cpp
char c = '\0';
printf("%d\n", c);   // 输出 0
printf("%c\n", c);   // 输出不可见字符(视觉上像空格,但并不是空格)
printf("%d\n", ' '); // 空格的 ASCII 码是 32
这是初学者最容易混淆的地方,下面把三种"看起来空的东西"彻底区分开:
| 写法 | 名称 | ASCII 值 | 说明 |
|---|---|---|---|
' ' |
空格字符 | 32 | 一个真实的、占据显示位置的字符 |
'\0' |
空字符 / NUL | 0 | 字符串结束标志,不占显示位置 |
NULL |
空指针宏 | 通常是 0 | 用于指针,表示"不指向任何地址" |
⚠️ 空字符的三种等价写法需要按场景区分:
- 字符层面:
'\0'- 指针层面:
NULL(或 C++11 起的nullptr)- 数值层面:
0它们数值上是同一个 0,但语义完全不同,混用会让代码可读性急剧下降。
关于"'\0' == 0"这句话 :原文写作"低位常量转为高位量",更准确的表述是------在整型提升(integer promotion)规则下,char 类型参与比较/运算时会先被提升为 int,即 '\0' 先变成 int 型的 0,再与字面量 0 比较。因此表达式 '\0' == 0 的结果为真。
cpp
if ('\0' == 0) cout << "两者数值相等" << endl; // 会输出2.2 字符串常量与结束符
编译器会自动 在字符串常量末尾追加一个 '\0'。
cpp
"abc" // 实际占 4 个字节:'a' 'b' 'c' '\0'💡 这一条是理解后面所有"数组开小了"错误的钥匙。
2.3 字符数组 vs 字符串数组 vs 字符指针
(1)字符数组与字符串数组的区别
- 字符数组 :逐个把字符常量初始化给数组元素,可以没有
'\0',此时它只是一个"装字符的容器",不是字符串。 - 字符串数组 :必须以
'\0'结尾,否则所有字符串函数(strlen、strcpy、printf("%s"))都会越界读下去。
cpp
char a[5] = {'a', 'e', 'i', 'o', 'u'};  // 字符数组,没有 '\0',不是字符串
char b[6] = {'a', 'e', 'i', 'o', 'u', '\0'}; // 手动补 '\0',成为字符串
char c[] = "aeiou";                     // 编译器自动加 '\0',长度 6
(2)字符指针指向字符串
cpp
char *ps1 = "form one";
// 等价于:把存放字符串常量的"无名常量存储区"的首地址赋给 ps1
// ps1 指向字符串的第一个字符 'f'
为什么叫"无名常量存储区"? 因为 "form one" 这种字符串字面量没有变量名,编译器把它放在只读数据段里,你只能通过地址访问它。
cpp
char str[] = "form two";
char *ps = str;      // ps 指向 str 的第一个字符 'f'
(3)通过赋值运算让指针指向字符串
cpp
char *ps1;
ps1 = "from one";    // ✅ 合法:让指针改指另一块字符串常量
2.4 字符数组与字符指针的本质区别(重点)
| 对比项 | char mark[] = "abc"; |
char *pmark = "abc"; |
|---|---|---|
| 本质 | 数组:在栈上开辟 4 字节,把字符拷贝进去 | 指针:只存一个地址,指向常量区的字符串 |
| 能否重新赋值 | 不能(除初始化阶段外,数组名是常量,不可整体赋值) | 可以,可随时改指别的字符串 |
| 指向内容能否修改 | 可以(mark[0] = 'x' 合法) |
⚠️ 不可以(常量区只读,修改是 UB) |
| 长度是否可变 | 固定 | 灵活,可改指不同长度的字符串 |
cpp
char *pmark = "abc";
pmark = "hello";          // ✅ 指针改指,长度变了也没问题
// pmark[0] = 'H';        // ❌ 运行时崩溃:试图修改只读常量区

char mark[] = "abc";
strcpy(mark, "xy");       // ✅ 逐字符写入,合法(前提是空间够)
mark[0] = 'X';            // ✅ 合法
// mark = "hello";        // ❌ 编译错误:数组名不是可修改的左值
💡 一句话记忆:数组名是"地址常量",指针是"地址变量"。
2.5 字符串赋值的经典误例辨析
题目 :以下能正确进行字符串赋值、赋初值的语句是?答案是 (2)。
cpp
(1) char s[5] = {'a', 'e', 'i', 'o', 'u'};
// ❌ 错误:这只是字符数组,没有 '\0',不能作为字符串使用。

(2) char *s;  s = "good";
// ✅ 正确:先用指针指向无名常量存储区的字符串,再通过指针赋值。

(3) char s[5] = "good!";
// ❌ 错误:"good!" 含 5 个可见字符 + 1 个 '\0' = 6 字节,
//          但只分配了 5 字节,空间溢出。

(4) char s[5];  s = "good";
// ❌ 错误:s 是数组名,不是可修改的左值,不能被整体赋值。
//          正确写法是 strcpy(s, "good");(并确保空间足够)
第 (3) 条特别值得展开:
cpp
char s[5] = "good!";   // 编译期就可能报错/告警,或运行期栈被破坏
char s[6] = "good!";   // ✅ 刚好装下
char s[7] = "good!";   // ✅ 稍有富余,安全
⚠️ 在 Visual Studio 下这种"字符串过长"通常直接编译报错;在 GCC 下可能只是警告,然后运行期悄悄破坏相邻的栈数据------这类 bug 极难排查。
2.6 字符串的输入输出
2.6.1 scanf("%s", 字符串的首地址)
cpp
char str[15];
scanf("%s", str); // 注意:数组名本身就是地址,不需要 &str四个必须记住的注意点:
-
遇到空格或回车会作为分隔符 ,并被自动替换为
'\0'。cpp// 输入:hello world char s[20]; scanf("%s", s); printf("[%s]\n", s); // 输出 [hello] ------ world 留在了输入缓冲区 -
输入项是数组元素地址时,从该位置开始写入。
cppchar str[15]; scanf("%s", str + 1); // 从 str[1] 开始存,str[0] 保持原样 -
⚠️ 输入项是指针变量时,必须确保指针已指向足够空间。
cppchar *p; // ❌ 野指针,指向不明地址 scanf("%s", p); // 运行期崩溃 char buf[100]; char *p = buf; // ✅ 指向已分配的合法空间 scanf("%s", p); -
⚠️
scanf本身不做长度检查 ------输入超过数组长度就会越界。这正是后文scanf_s存在的原因。
2.6.2 gets(str) ------ 可以接收空格
cpp
char str[100];
gets(str);   // 从标准输入读一整行,直到遇到回车
关键特性 :允许输入包含空格;读入后回车符会被替换为 '\0'。
⚠️ 安全提示:
gets完全不检查输入长度,是历史上最著名的危险函数之一,C++11 起已从标准中移除 。现代代码请用fgets(str, sizeof(str), stdin)或 C++ 的std::getline。
cpp
char str[100];
fgets(str, sizeof(str), stdin);   // ✅ 现代替代方案
2.6.3 puts(字符串的起始地址) ------ 输出字符串
cpp
char str[] = "hello";
puts(str);   // 输出 hello 并自动换行
注:字符串数组的首地址即为字符串的首地址。因为编译器会自动在字符串常量后添加结束符,所以
puts能知道在哪里停下来。
2.6.4 输入输出方式对比
| 函数 | 是否接收空格 | 是否检查长度 | 是否自动加 \0 |
是否输出换行 |
|---|---|---|---|---|
scanf("%s", s) |
❌ 遇空格即停 | ❌ 不检查 | ✅ | ❌ |
gets(s) |
✅ | ❌ 不检查 | ✅ | ❌ |
fgets(s, n, stdin) |
✅ | ✅ 检查 | ✅ | 行尾 \n 会一起读入 |
puts(s) |
--- | --- | --- | ✅ |
printf("%s", s) |
--- | --- | --- | ❌ |
2.7 VS 提供的安全版本函数
Visual Studio 认为传统 C 字符串函数不安全,提供了一批 _s 后缀的版本。
2.7.1 scanf_s
cpp
char arr1[20];
scanf_s("%s", arr1, sizeof(arr1));- 有三个参数,第三个是变量所占空间大小(单位:字节);
- 可以直接写字节数,也可以用
sizeof(变量名); sizeof是求字节数的运算符(不是函数)。
返回值规律(原文表述):
- 若字符串实际长度大于 数组长度,
scanf_s返回 0; - 反之返回 1。
而且不会向数组写入内容 (普通 scanf 则会一部分一部分地写),因此不会出现栈空间被破坏的情况。
cpp
#include <stdio.h>

int main() {
    char arr1[5];
    int ret = scanf_s("%s", arr1, (unsigned)sizeof(arr1));
    printf("返回值 = %d\n", ret);   // 输入 "abcdefg" → 返回 0,arr1 未被写入
    return 0;
}
💡 这正是"安全性"的代价:宁可输入失败,也不破坏内存。
2.7.2 strcpy_s
与其它字符串处理函数不同,
strcpy_s需要指定目标缓冲区的大小。
使用步骤:
- 定义目标字符串首地址(可以是数组,也可以是指向字符串的指针),用于存放源字符串;
- 设置目标缓冲区的最大长度;
- 第 3 个参数是源字符串首地址。
cpp
char strDest[100];
const char *strSource = "hello world";
strcpy_s(strDest, 100, strSource);
⚠️ 常见误解:原文把第 2 个参数写成"源字符串最大长度"。准确地说,它是目标缓冲区的大小 ------函数用它来判断源串是否能完整放下。
也可以用更省心的模板版本:
strcpy_s(strDest, strSource);(需包含<string.h>且目标是真实数组,编译器会自动推导大小)。
2.8 空指针与 NULL
将
NULL作为指针变量的初始化值,即得到空指针。空指针可用于条件语句,检查一个指针是否已被赋值。
cpp
int *ptr = NULL;
if (ptr == NULL) {
    /* 指针 ptr 未被赋值,是一个空指针 */
}在实际开发中,这样可以避免指针变量在未初始化时的随机状态。
cpp
#include <iostream>
using namespace std;

int main() {
    int *p = NULL;          // 初始化,明确表示"暂不指向任何对象"

    if (p == NULL) {
        cout << "p 目前是空指针" << endl;
    }

    int a = 10;
    p = &a;                 // 现在指向了合法对象
    if (p != NULL) {
        cout << "*p = " << *p << endl;   // 10
    }

    delete p;               // ⚠️ 错误!p 指向栈变量,不能 delete
    return 0;
}
💡 C++11 起推荐用
nullptr替代NULL。原因:NULL本质上常被定义为整型0,在函数重载时可能被误匹配成int版本;而nullptr有独立的类型std::nullptr_t,不会产生歧义。
cpp
void f(int);
void f(char*);

// f(NULL);      // ⚠️ 歧义或误调用 f(int)
f(nullptr);      // ✅ 明确调用 f(char*)
2.9 结构体指针与成员访问
结构体指针变量
p必须指向一个真实存在的结构体变量,否则就是野指针 。先把一个具有合法空间的结构体变量的首地址赋给它,再去访问。
访问方式上的差别:
| 访问主体 | 使用的运算符 | 示例 |
|---|---|---|
| 结构体变量 | .(点号) |
stu.age |
| 结构体指针 | ->(箭头) |
p->age |
两者等价关系:
cpp
(*p).age <=> p->age💡 为什么必须有
->?因为*p已经是一个结构体值了,再用.语法上要写成(*p).age,括号不能省。->只是它的语法糖,少写两个字符、可读性更好。
cpp
#include <iostream>
#include <string>
using namespace std;

struct Student {
    string name;
    int age;
};

int main() {
    Student stu = {"小明", 18};
    Student *p = &stu;

    cout << stu.age   << endl;   // 18(变量用 .)
    cout << p->age    << endl;   // 18(指针用 ->)
    cout << (*p).age  << endl;   // 18(等价写法)

    // ⚠️ 未指向任何对象的指针:
    Student *q;                  // 野指针
    // cout << q->age << endl;   // 未定义行为
    return 0;
}
第 3 章 数组与循环控制
3.1 二维数组与"行退化"
定义二维数组
int Array[2][3],则Array[0]相当于该二维数组第一行的所有元素构成的一维数组。
cpp
int Array[2][3] = { {1, 2, 3},
                    {4, 5, 6} };

// Array[0] 是第 0 行的首地址,类型为 int(*)[3] → 退化为 int*
// Array[0][0] 就是 1用指针算术解释:
cpp
Array[i][j] <=> *(*(Array + i) + j)Array + i:跳过 i 行(每行 3 个 int,共 12 字节);*(Array + i):得到第 i 行的首地址,即Array[i];+ j:在第 i 行内跳过 j 个元素;- 再解引用,得到具体元素。
cpp
#include <iostream>
using namespace std;

int main() {
    int a[2][3] = {{1,2,3},{4,5,6}};
    cout << a[1][2] << endl;              // 6
    cout << *(*(a + 1) + 2) << endl;      // 6,完全等价
    return 0;
}
💡 理解要点 :二维数组在内存中是连续的一维排布 ,
a[i][j]的行列写法只是给人看的语法糖。
3.2 for 循环的执行顺序
for语句的执行顺序是:初始化 → 判断 → 循环体 → 迭代(步进) → 判断 → 循环体 → 迭代 → ......也就是说:先迭代循环变量,再判断是否开启下一次循环。
原文的例子:
cpp
for (b = 1; b < 3; b++)- 第 1 次循环:
b = 1,判断1 < 3成立 → 执行循环体; - 第 1 次迭代:
b变成 2; - 第 2 次循环:判断
2 < 3成立 → 执行循环体; - 第 2 次迭代:
b变成 3; - 第 3 次判断:
3 < 3不成立 → 循环结束,没有第三次循环。
所以循环体总共执行 2 次。
完整展开形式 (理解 for 的最好方式):
cpp
for (init; cond; step) { body; }

// 完全等价于:
init;
while (cond) {
    body;
    step;
}
⚠️ 常见误区:以为"
b++到 3 之后就一定不再判断"。实际上正是迭代后还会再判断一次,才发现条件不成立而退出。
3.3 break 关键字
break用于中断循环 或switch语句 。当程序执行到break时,对应的循环或switch会立即终止 ,跳出该代码块,并继续执行其后的代码。
break只能存在于循环语句或switch语句的语句块中,不能单独使用。
cpp
#include <iostream>
using namespace std;

int main() {
    // 例1:在循环中提前退出
    for (int i = 0; i < 10; i++) {
        if (i == 3) break;      // i == 3 时立即跳出整个 for
        cout << i << " ";       // 输出:0 1 2
    }
    cout << endl;

    // 例2:在 switch 中防止"穿透"
    int x = 2;
    switch (x) {
        case 1: cout << "one" << endl; break;
        case 2: cout << "two" << endl; break;   // 命中并跳出
        case 3: cout << "three" << endl; break;
        default: cout << "other" << endl;
    }
    return 0;
}
break 与 continue 的区别:
| 关键字 | 作用 | 影响范围 |
|---|---|---|
break |
立即终止 整个循环 / switch |
跳出最近的一层结构 |
continue |
跳过本次循环的剩余部分,直接进入下一次迭代 | 只影响当前这一轮 |
cpp
for (int i = 0; i < 5; i++) {
    if (i == 2) continue;   // 跳过 i == 2 这一轮
    cout << i << " ";       // 输出:0 1 3 4
}
💡
break只跳出最内层 的那一层循环。要从多层嵌套循环中一次性跳出,需要配合标志变量或goto。
第 4 章 递归
4.1 递归的本质
递归就是函数调用自身 。它之所以能正确工作,依赖的是函数的调用栈机制。
必须设置一个临界点(基准情形 / base case)用于结束递归调用。
每次执行到"函数调用自身"的语句时,就会在栈上为这一层调用插入一个新的函数语句块 (栈帧)。
抵达递归终点后,终点处的函数把返回值交给它的上层复合函数,上层得以继续向下执行,随后也把返回值返回给更上一层,以此类推(回溯)。
调用栈图解
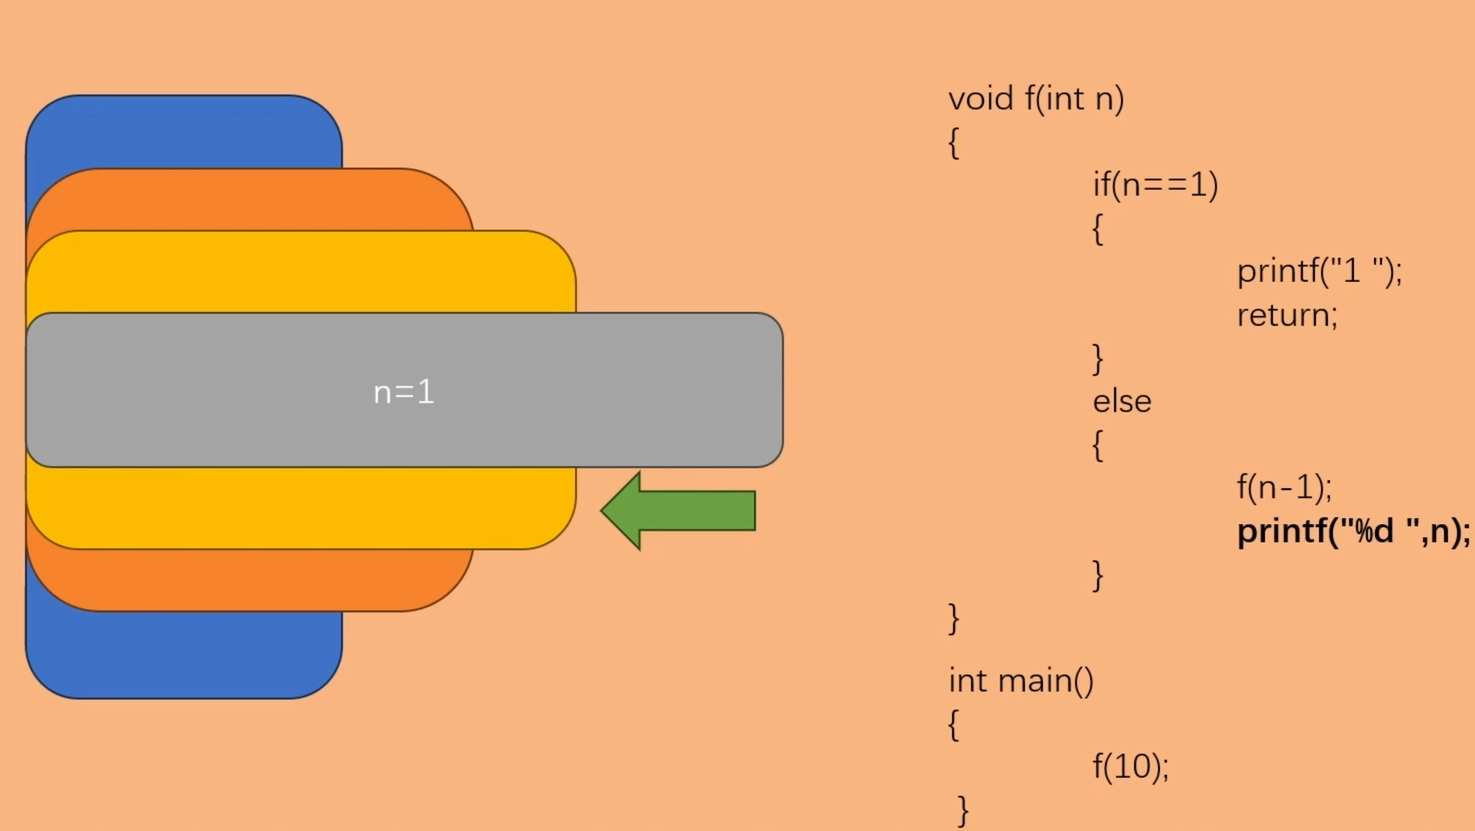
图中的程序用于逐个输出从 1 到 n 的数字:
cpp
void f(int n) {
    if (n == 1) {          // ← 临界点:递归终点
        printf("1 ");
        return;
    } else {
        f(n - 1);          // ← 递归调用,先一路"深入"到 n == 1
        printf("%d ", n);  // ← 回溯阶段才执行
    }
}

int main() {
    f(10);                 // 输出:1 2 3 4 5 6 7 8 9 10
}
注意 :递归语句中的
(n - 1)结果作为实参 传递给形参int n。每一层都有自己的n,互不干扰------这正是栈帧独立的意义。
4.2 递归的两个阶段
以 f(3) 为例:
阶段一:深入(递推,pressure)
f(3) → 需要 f(2) → 需要 f(1) → 命中临界点阶段二:回溯(return)
f(1) 打印 "1 "  → 返回
f(2) 打印 "2 "  → 返回
f(3) 打印 "3 " → 返回栈的变化过程:
| 步骤 | 栈内容(自底向上) | 说明 |
|---|---|---|
| 1 | f(3) | 主调用入栈 |
| 2 | f(3) f(2) | f(3) 调用 f(2) |
| 3 | f(3) f(2) f(1) | f(2) 调用 f(1) |
| 4 | f(3) f(2) | f(1) 命中临界点并返回 |
| 5 | f(3) | f(2) 执行 printf 后返回 |
| 6 | (空) | f(3) 执行 printf 后返回 |
💡 理解要点 :递归的"代码顺序"和"执行顺序"是不同 的。
f(n-1)写在printf前面,意味着打印发生在回溯阶段。如果交换这两行,输出顺序就会反过来(10 9 8 ... 1)。
4.3 经典递归示例
示例 1:阶乘
cpp
long long factorial(int n) {
    if (n <= 1) return 1;        // 临界点
    return n * factorial(n - 1); // 递推关系
}
// factorial(5) → 5*4*3*2*1 = 120
示例 2:斐波那契数列
cpp
int fib(int n) {
    if (n <= 2) return 1;                    // 临界点:fib(1)=fib(2)=1
    return fib(n - 1) + fib(n - 2);          // 两个递归分支
}
⚠️ 这个写法存在大量重复计算 (时间复杂度 O(2ⁿ)),
fib(40)就会卡顿。工程中应改用记忆化或迭代。
示例 3:递归求数组最大值
cpp
int maxOf(const int a[], int n) {
    if (n == 1) return a[0];                 // 临界点
    int m = maxOf(a, n - 1);                 // 先求前 n-1 个的最大值
    return a[n-1] > m ? a[n-1] : m;
}
4.4 递归的使用要点
- 必须有临界点 ,否则会无限递归 → 栈溢出(Stack Overflow)。
- 必须有收敛趋势 :每次递归的规模必须严格减小(如
n → n-1)。 - 递归层数不能太深:每层调用都占栈空间。默认栈大小通常只有 1~8 MB,递归几万层就可能崩溃。
- 性能权衡:递归代码简洁、贴近数学定义,但有函数调用开销;尾递归可被编译器优化为循环,普通递归不行。
第 5 章 整型常量与类型提升
5.1 整型常量的类型确定规则
一个整型字面量(如 32768)究竟被当成什么类型?C/C++ 有一套"类型提升"规则。
整型常量类型对照表
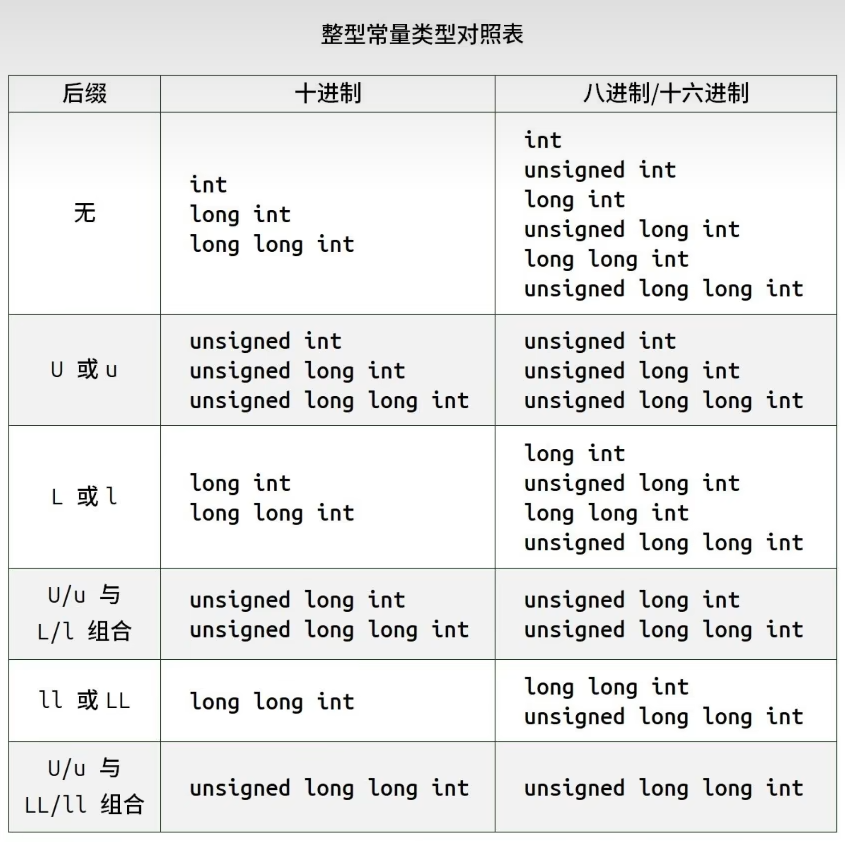
从表中可以读出的规律:
- 带
u后缀 的常量,都是无符号类型; - 不带
u后缀 的常量:- 十进制一定是有符号数;
- 八进制 / 十六进制 则优先尝试用有符号数表示,装不下时才使用无符号数。
5.2 各类型的取值范围
| 类型 | 字节数 | 最小值 | 最大值 |
|---|---|---|---|
int |
4 | -32768* | 32767* |
unsigned int |
4 | 0 | 65535* |
long |
4 | -2147483648 | 2147483647 |
unsigned long |
4 | 0 | 4294967295 |
long long |
8 | -9223372036854775808 | 9223372036854775807 |
unsigned long long |
8 | 0 | 18446744073709551615 |
5.3 实例解析
cpp
32768 => long int推演过程 :32768 无后缀,是十进制,所以先尝试用 int 表示。若 int 为 2 字节(范围 -32768 ~ 32767),32768 超出范围 ,于是按 long int 处理。
cpp
0x8000 => unsigned int推演过程 :0x8000 是十六进制。按规则,八进制/十六进制优先尝试有符号类型,但 0x8000 = 32768 超出 2 字节 int 的范围,于是转为 unsigned int ------ 恰好 0x8000 正是 unsigned int 能表示的值。
cpp
1234567890123L => long long int推演过程 :带 L 后缀表示至少是 long,但该值超出了 4 字节 long 的范围,于是继续提升为 long long int。
5.4 为什么要关心这个?(类型提升的坑)
cpp
#include <iostream>
using namespace std;

int main() {
    // 坑 1:无符号与有符号混合运算
    unsigned int u = 10;
    int i = -20;
    if (u + i > 0) {
        cout << "u + i > 0" << endl;   // ⚠️ 实际会输出这句!
    }
    // 原因:i 被隐式转换为 unsigned,-20 变成巨大的正数

    // 坑 2:常量类型影响重载决议
    // f(32768) 在 16 位 int 平台上会选到 long 版本,而不是 int 版本

    return 0;
}
⚠️ 工程建议 :有符号与无符号整数混用是 C/C++ 中最经典的 bug 来源之一。循环里
for (unsigned i = n - 1; i >= 0; i--)会死循环,就是这个原因。
第 6 章 枚举类型
6.1 基本语法与用途
枚举(enum)用于定义一组具名的整型常量,让代码更可读。
cpp
enum Color { RED, GREEN, BLUE };
// RED = 0, GREEN = 1, BLUE = 2(默认从 0 开始依次 +1)
可以显式指定值:
cpp
enum HttpStatus {
    OK = 200,
    NOT_FOUND = 404,
    SERVER_ERROR = 500
};
6.2 关键特性
枚举表中的枚举成员可以直接使用,不需要先定义枚举变量。
cpp
#include <iostream>
using namespace std;

enum Weekday { MON = 1, TUE, WED, THU, FRI, SAT, SUN };

int main() {
    // ✅ 直接用枚举成员,无需声明 Weekday 变量
    cout << MON << endl;              // 1
    cout << SUN << endl;              // 7

    // 也可以定义变量并使用
    Weekday today = WED;
    if (today == WED) cout << "今天是周三" << endl;

    // 枚举值本质是整型,可参与运算
    cout << SAT - MON << endl;        // 5
    return 0;
}枚举的三大好处:
- 可读性 :
if (status == NOT_FOUND)比if (status == 404)直观; - 类型安全(相对宏定义):编译器能做一定检查;
- 避免魔法数字:一处定义,多处使用。
6.3 未定义行为
未定义行为 :语言标准没有规定结果,由编译器自行决定,无法确定结果。
cpp
int i = 0;
i = i++ + ++i;    // ⚠️ 未定义行为(UB)
为什么会 UB? 因为这行代码在一个表达式中多次修改了同一个变量 i,中间没有序列点。C/C++ 标准对此明令"未定义",编译器可以做任何事。
不同编译器的实际表现(原文记录):
| 编译器 | 等价展开 | 结果 |
|---|---|---|
| GCC | ++i; ++i; i = i + i; |
6 |
| Clang | a = ++i; b = ++i; i = a + b; |
5 |
GCC 的展开推演:
cpp
i = 1;
i = ++i + ++i;
// → ++i;       i = 2
// → ++i;       i = 3
// → i = i + i; i = 3 + 3 = 6
Clang 的展开推演:
cpp
i = 1;
i = ++i + ++i;
// → a = ++i;   a = 2, i = 2
// → b = ++i;   b = 3, i = 3
// → i = a + b; i = 2 + 3 = 5
💡 正确的态度 :不要试图记住"GCC 是 6、Clang 是 5",而要记住------这类代码本身就是错的。工程规范中,任何"在同一表达式中既读又写同一变量"的写法都应避免。
⚠️ 更危险的现实:编译器优化开关变化时,结果也会变 。开启
-O2后 Clang 也可能给出 6。所以这不是"平台差异",是"你写了 UB"。
第二部分 C++ 面向过程部分
第 7 章 内存分区与堆区管理
7.1 new 与 delete
C++ 中利用
new运算符 在堆区 开辟数据。堆区开辟的数据由程序员手动开辟、手动释放 ,释放使用
delete运算符。语法:
new 数据类型
new创建的数据会返回该数据对应类型的指针。
示例 1:基本语法
C++ new 操作符
C++ 中利用new操作符在堆区开辟数据
堆区开辟的数据,由程序员手动开辟,手动释放,释放利用操作符 delete
语法:new 数据类型
利用 new 创建的数据,会返回该数据对应的类型的指针
cpp
int* func()
{
    int* a = new int(10);
    return a;
}

int main() {
    int *p = func();

    cout << *p << endl;
}
cpp
#include <iostream>
using namespace std;

int* func() {
    int* a = new int(10);   // 在堆区开辟一个 int,初值为 10
    return a;               // ✅ 可以返回:堆区数据不会随函数返回而销毁
}

int main() {
    int *p = func();
    cout << *p << endl;     // 10
    delete p;               // ✅ 手动释放
    p = NULL;               // 避免悬空指针
    return 0;
}
💡 对比理解:如果写
int a = 10; return &a;就会返回栈上局部变量的地址 ------函数一返回,这块空间就失效了,是典型的野指针。小括号中的值即"开辟内存空间中的初始值":
new int(10)中10就是初值。
示例 2:堆区开辟数组
cpp
//堆区开辟数组
int main() {

    int* arr = new int[10];

    for (int i = 0; i < 10; i++)
    {
        arr[i] = i + 100;
    }

    for (int i = 0; i < 10; i++)
    {
        cout << arr[i] << endl;
    }

    //释放数组 delete 后加 []
    delete[] arr;

    system("pause");

    return 0;
}
cpp
// 堆区开辟数组
int main() {
    int* arr = new int[10];      // 开辟 10 个 int 的连续空间

    for (int i = 0; i < 10; i++) {
        arr[i] = i + 100;
    }

    for (int i = 0; i < 10; i++) {
        cout << arr[i] << endl;  // 100 101 ... 109
    }

    delete[] arr;                // ⚠️ 释放数组必须加 []
    return 0;
}
指针算术说明 :arr 是整型指针,arr[1] 等价于 *(arr + 1),以此类推。
⚠️ 最重要的规则 :
new配delete,new[]配delete[]。用delete释放new[]的数组是未定义行为(可能导致只调用第一个元素的析构函数,或直接崩溃)。
7.2 new / delete 与 malloc / free 的对比
| 对比项 | new / delete |
malloc / free |
|---|---|---|
| 语言归属 | C++ 运算符 | C 库函数 |
| 是否调用构造/析构 | ✅ 会(这是关键的类对象管理差异) | ❌ 不会 |
| 返回类型 | 具体类型的指针 | void*,需强转 |
| 失败行为 | 抛 std::bad_alloc 异常 |
返回 NULL |
| 数组语法 | new int[10] / delete[] |
malloc(10 * sizeof(int)) |
💡 C++ 中请一律使用
new/delete。只有在维护遗留 C 代码时才用malloc/free,且绝不可混用 (new出来的用free释放 = UB,反之亦然)。
7.3 常见内存错误清单
| 错误类型 | 典型代码 | 后果 |
|---|---|---|
| 内存泄漏 | int* p = new int(1); 却没有 delete |
堆区不断被占满 |
| 重复释放 | 对同一指针 delete 两次 |
崩溃 |
| 悬空指针 | delete p; 后又 *p = 5; |
UB |
| 释放栈地址 | int a; delete &a; |
崩溃 |
| 越界写入 | new int[5] 后写 arr[5] |
破坏堆区结构 |
| 匹配错误 | new[] 配 delete |
UB |
cpp
// 好的习惯
int* p = new int(10);
// ... 使用 p ...
delete p;
p = nullptr;      // ⚠️ delete 后立刻置空,防止悬空

delete p;         // ✅ 对 nullptr 做 delete 是安全的(标准保证)
第 8 章 引用
8.1 引用语法
语法 :
数据类型 &别名 = 原名;
cpp
int a = 10;
int &ref = a;    // ref 是 a 的别名
ref = 20;        // 等价于 a = 20
cout << a << endl;   // 20
💡 理解要点 :引用不是 新变量,它不占独立的内存空间(编译器层面通常用地址实现,但语言层面认为它就是原名本身)。所以对引用做任何操作,就是对原名做操作。
8.2 引用传递
cpp
//3. 引用传递
void mySwap03(int& a, int& b) {
    int temp = a;
    a = b;
    b = temp;
}

int main() {

    int a = 10;
    int b = 20;

    mySwap01(a, b);
    cout << "a:" << a << " b:" << b << endl;

    mySwap02(&a, &b);
    cout << "a:" << a << " b:" << b << endl;

    mySwap03(a, b);
    cout << "a:" << a << " b:" << b << endl;
}
三种交换函数的对比:
cpp
#include <iostream>
using namespace std;

// ① 值传递 ------ ❌ 交换失败
void mySwap01(int a, int b) {
    int temp = a;
    a = b;
    b = temp;      // 只交换了形参副本,实参纹丝不动
}

// ② 地址传递 ------ ✅ 交换成功
void mySwap02(int* a, int* b) {
    int temp = *a;
    *a = *b;
    *b = temp;
}

// ③ 引用传递 ------ ✅ 交换成功,且调用语法更简洁
void mySwap03(int& a, int& b) {
    int temp = a;
    a = b;
    b = temp;
}

int main() {
    int a = 10, b = 20;

    mySwap01(a, b);
    cout << "值传递后:a = " << a << " b = " << b << endl;   // 10 20

    mySwap02(&a, &b);
    cout << "地址传递后:a = " << a << " b = " << b << endl; // 20 10

    a = 10; b = 20;
    mySwap03(a, b);
    cout << "引用传递后:a = " << a << " b = " << b << endl; // 20 10
    return 0;
}
解析 :mySwap03 中给 main 里的 a 和 b 在子函数中分别起了别名。在子函数中操纵别名交换值,等价于本体也交换了值------这是因为引用的本质是指针常量。
💡 引用传递 vs 地址传递:
- 效果等价;
- 引用传递的调用方语法更简洁 (不用写
&),且函数体内不用写*;- 引用不能为空,因此比指针更安全;
- 引用一旦绑定不能改绑,指针可以。
8.3 引用作函数返回值
cpp
// ❌ 1、不要返回局部变量的引用
int& test01() {
    int a = 10;     // 局部变量存放在四区中的栈区
    return a;       // 函数返回后 a 已被销毁
}

// ✅ 2、函数的调用可以作为左值
int& test02() {
    static int a = 10;   // 静态变量存放在全局区,程序结束后系统才释放
    return a;
}
cpp
int main() {
    // int& ref1 = test01();
    // cout << ref1 << endl;   // ⚠️ 第一次可能侥幸输出 10,第二次就是垃圾值

    int& ref2 = test02();
    cout << "ref2 = " << ref2 << endl;   // ref2 = 10

    test02() = 1000;                     // ✅ 函数调用作左值,相当于给 a 赋值 1000
    cout << "ref2 = " << ref2 << endl;   // ref2 = 1000
    return 0;
}两条关键结论:
- 因为局部变量存放在栈区 ,函数返回后其栈帧即被回收,返回它的引用就是返回一块"已失效的内存"。声明为
static后可以解决------静态变量存放在全局区,函数返回后依然有效。 - 函数的调用要能作为左值,该函数的返回值类型必须是引用。因为只有引用返回才能"代表某一处真实存在的存储空间"。
⚠️ 不要返回局部变量的引用,也不要返回局部变量的指针------同一个陷阱。
8.4 引用的本质
引用的本质就是一个指针常量。
cpp
void func(int& ref) {
    ref = 100;      // ref 是引用,编译器内部转换为 *ref = 100
}

int main() {
    int a = 10;

    // 自动转换为:int* const ref = &a;
    // 指针常量是指针的指向不可改,这也解释了为什么引用一旦初始化后不可更改
    int& ref = a;

    ref = 20;       // 内部发现 ref 是引用,自动帮我们转换为:*ref = 20;

    cout << "a: "   << a   << endl;   // a: 20
    cout << "ref: " << ref << endl;   // ref: 20

    func(a);
    cout << "a: " << a << endl;       // a: 100
    return 0;
}编译器视角的等价转换:
| 你写的 | 编译器看到的 |
|---|---|
int& ref = a; |
int* const ref = &a; |
ref = 20; |
*ref = 20; |
func(a);(形参 int& ref) |
传递 a 的地址,函数内用 *ref |
💡 一句话总结 :
引用的本质是指针常量 ------指向不可改(所以引用不能换绑),但指向的值可改(所以能通过引用修改原变量)。
这同时解释了"引用必须初始化"和"引用不能重新绑定"这两条规则。
第 9 章 函数:默认参数、占位参数与重载
9.1 占位参数
占位参数只有类型没有名字,调用时也必须填补。占位参数也可以有默认值。
cpp
// 函数占位参数,占位参数也可以有默认参数
void func(int a, int) {
    cout << "this is func" << endl;
}

int main() {
    func(10, 10);   // ⚠️ 占位参数必须填补
    // func(10);    // ❌ 编译错误:参数个数不足
    return 0;
}
如果给占位参数加上默认值,就可以不传:
cpp
void func2(int a, int = 10) {
    cout << "ok" << endl;
}
int main() {
    func2(5);       // ✅ 编译通过
    return 0;
}
💡 占位参数的实际用途:一是为未来扩展预留接口 (如运算符重载中的
int占位用于区分前置/后置++);二是在重载体系中强制调用方传参。
典型应用:区分前置与后置 ++
cpp
class Int {
public:
    Int& operator++()        { /* 前置 ++ */ return *this; }
    Int  operator++(int)     { /* 后置 ++,int 是占位参数 */ return *this; }
};
9.2 默认参数
在 C++ 中,允许在自定义函数的形参列表中给形参一个默认值。调用时如果传了实参,就按实参使用;如果没传,形参就使用默认值。
cpp
int add(int a, int b = 10, int c = 20) {
    return a + b + c;
}

int main() {
    cout << add(1)       << endl;   // 1 + 10 + 20 = 31
    cout << add(1, 2)    << endl;   // 1 + 2 + 20  = 23
    cout << add(1, 2, 3) << endl;   // 1 + 2 + 3   = 6
    return 0;
}
两条硬性规则
规则一:有默认值的参数必须放在形参列表的最右边。
原因:参数传递顺序是从右至左入栈。如果默认参数在左边,编译器无法判断中间省略的是哪个。
cpp
int f(int a = 1, int b);       // ❌ 编译错误
int g(int a, int b = 2);       // ✅ 正确
规则二:声明与定义不可同时指定默认值。
当函数需要提前声明时,若形参存在默认参数,则声明部分 可以指定默认值,而函数定义部分不再指定。
cpp
int f(int a, int b = 10);      // ✅ 声明处指定

int f(int a, int b) {          // ✅ 定义处不再写 = 10
    return a + b;
}

// int f(int a, int b = 10) { ... }  // ❌ 重复指定,编译错误
⚠️ 最常见的新手错误:在头文件里写了默认值,又在
.cpp的实现里再写一遍,导致"重定义默认参数"。
9.3 函数重载
定义 :编译器根据调用方传入参数的类型、个数以及传入顺序,自动选择最适合的一个函数进行绑定调用。
cpp
#include <iostream>
using namespace std;

void print(int x)     { cout << "int 版本:"    << x << endl; }
void print(double x)  { cout << "double 版本:" << x << endl; }
void print(char x)    { cout << "char 版本:"   << x << endl; }

int main() {
    print(10);      // int 版本:10
    print(3.14);    // double 版本:3.14
    print('A');     // char 版本:A
    return 0;
}
函数重载的三个条件
- 同一个作用域(如都是全局作用域);
- 函数名称相同;
- 参数类型不同、个数不同或顺序不同。
⚠️ 函数的返回值类型不可以作为函数重载的条件。
cpp
int  f(int a);      // ❌
double f(int a);    // ❌ 仅仅返回值不同,不构成重载,编译报错
为什么? 因为在调用 f(10); 时,编译器无法从调用现场推断你到底想要哪种返回类型------返回类型不参与重载决议。
重载解析实例
cpp
#include <iostream>
using namespace std;

int add(int a, int b) {
    cout << "(int ,int)\t";
    return a + b;
}

double add(double a, double b) {
    cout << "(double ,double)\t";
    return a + b;
}

double add(double a, int b) {
    cout << "(double ,int)\t";
    return a + b;
}

double add(int a, double b) {
    cout << "(int ,double)\t";
    return a + b;
}

int main() {
    cout << add(2, 3)       << endl;   // (int ,int)      5
    cout << add(2.9, 15.3)  << endl;   // (double ,double) 18.2
    cout << add(10, 9.9)    << endl;   // (int ,double)   19.9
    cout << add(11.5, 5)    << endl;   // (double ,int)   16.5
    return 0;
}
为了确认哪个函数得到执行,我们在每个函数内部加了一句
cout输出语句,用来区分哪个函数被调用。
匹配规则(重载决议的优先级):
- 精确匹配(含数组到指针、函数到指针等轻量转换);
- 提升转换 (如
char→int、float→double); - 标准转换 (如
int→double); - 用户自定义转换;
- 若有多个候选处于同一级别 → 二义性(ambiguous),编译报错。
9.3.1 重载注意事项一:引用作为重载条件
cpp
void func(int &a) {
    cout << "func(int &a)调用" << endl;
}

void func(const int &a) {
    cout << "func(const int &a)调用" << endl;
}

int main() {
    int a = 10;
    func(a);      // ✅ 实参是变量 → 匹配 func(int &a)
    func(10);     // ✅ 实参是常量 → 匹配 func(const int &a)
    return 0;
}规则:
- 当实参是一个变量 时,与上边的函数(
int&)匹配; - 当实参是一个常量 时,与下边的函数(
const int&)匹配。
💡 补充说明 :
const int &a与传入的常量实参进行初始化时,编译器会隐式优化为一个临时变量:
cpp// func(10) 的内部等价形式: int temp = 10; const int &a = temp;这就是"常量引用可以绑定临时量(右值)"的原理。普通引用
int&不能绑定10这种右值,所以只能匹配const int&版本。
9.3.2 重载注意事项二:重载碰到默认参数
cpp
void func2(int a, int b = 10) {
    cout << "func2(int a, int b) 的调用" << endl;
}

void func2(int a) {
    cout << "func2(int a) 的调用" << endl;
}

int main() {
    func2(10);    // ❌ 二义性!两个函数都能匹配,编译报错
    return 0;
}
原因 :当只传入一个实参时,上边的函数(借助默认参数)和下边的函数都可以匹配 ,因而产生二义性(ambiguity)。
💡 结论:在函数重载时应尽量避免使用默认参数。 这是一条经验性规范。
第三部分 C++ 面向对象
第 10 章 类与对象基础
10.1 类与对象的概念
类是相同性质对象集合的抽象概括,如"一个人"作为对象,归属于"人类"。
对象的属性与行为:如人作为对象,属性有年龄、身高;行为有走、跑。
封装 :将属性和行为作为一个整体,用以表现生活中的事物,并将属性和行为加以权限控制。
cpp
class 类名 {
访问权限:
    属性      // 成员变量
    行为      // 成员函数
};- 类的成员变量即为属性;
- 类的函数即为方法;
- 属性和方法统称为成员。
10.2 三种访问权限
| 权限 | 类内成员 | 派生类(子类) | 类外/对象 |
|---|---|---|---|
public |
✅ 可访问 | ✅ 可访问 | ✅ 可访问 |
protected |
✅ 可访问 | ✅ 可访问 | ❌ 不可访问 |
private |
✅ 可访问 | ❌ 不可访问 | ❌ 不可访问 |
private:最封闭。被它声明的成员仅仅能被该类里的成员访问,外界不能访问。protected:比private稍微公开一些。除了类内自己的成员可以访问外,它的子类也可以访问。public:完全公开。可以被该类的任何对象访问。
10.3 class 与 struct 的区别
| 对比项 | class |
struct |
|---|---|---|
| 默认访问权限 | private | public |
| 默认继承方式 | private | public |
| 其他能力 | 完全相同(都能有成员函数、构造析构、继承多态) | 完全相同 |
💡 C++ 中的
struct不是 C 的struct的简单延续。在 C++ 里struct和class几乎是同一个东西,唯一区别就是默认权限。保留struct主要是为了兼容 C 代码。
10.4 完整示例:设计一个圆类
cpp
#include <iostream>
using namespace std;

// 设计一个圆类,求一个圆的周长
const double PI = 3.14;   // 定义一个常量

class Circle {
public:
    // 属性
    int m_r;              // 半径

    // 行为
    // 获取圆的周长
    double calculateZC() {
        return 2 * PI * m_r;
    }
};

int main() {
    // 通过圆类,创建一个具体的圆(对象),即:类实例化为一个对象
    Circle c1;

    // 给圆对象的属性赋值
    c1.m_r = 10;

    cout << "圆的周长为 " << c1.calculateZC() << endl;   // 62.8
    return 0;
}
💡 注意 :成员函数内直接使用属性,无需定义形参和传参 。因为成员函数知道自己属于哪个对象(通过隐含的
this指针)。
10.5 类成员的存储方式(重要前置知识)
C++ 中成员变量和成员函数是分开存储的 。
只有非静态成员变量 才属于类对象,存在为该对象分配的内存空间中,为该对象特有。
每一个非静态成员函数只会诞生一份函数实例,由同类的所有对象共享。
cpp
class Person {
    int m_a;                   // 非静态成员变量:占对象空间
    static int m_b;            // 静态成员变量:不占对象空间(在全局区)
    void func() {}             // 非静态成员函数:不占对象空间
    static void sfunc() {}     // 静态成员函数:不占对象空间
};

int main() {
    cout << sizeof(Person) << endl;   // 4(只有 m_a 占空间)
    return 0;
}
💡 空类占 1 字节 :
class Empty {};的sizeof是 1,而不是 0。这样做的目的是保证每个对象都有独一无二的内存地址。
第 11 章 构造函数与析构函数
11.1 概念
这两个函数会被编译器自动调用 。如果我们不提供构造和析构,编译器会自动生成函数体为空的构造和析构函数。
- 构造函数 :用于在创建对象时对对象的成员属性赋值(初始化),无需手动调用。
- 析构函数 :用于在对象销毁前系统自动调用,执行一些清理工作。
cpp
class Person {
public:
    Person()  { /* 构造函数 */ }
    ~Person() { /* 析构函数 */ }
};
11.2 构造函数要点
cpp
类名() {}- 没有返回值,也不写
void; - 函数名称与类名相同;
- 可以有参数,因此可以发生重载;
- 在创建对象时程序会自动调用,且仅调用一次。
11.3 析构函数要点
cpp
~类名() {}- 没有返回值,也不写
void; - 不可以有参数,因此无重载(一个类只能有一个析构函数);
- 在对象销毁前程序会自动调用,且仅调用一次。如局部对象在弹出栈区销毁前会调用一次析构函数。
11.4 完整示例
cpp
#include <iostream>
#include <string>
using namespace std;

class Student {
public:
    Student() {
        cout << "默认构造函数调用" << endl;
        m_name = "未命名";
    }

    Student(string name) {
        cout << "有参构造函数调用" << endl;
        m_name = name;
    }

    ~Student() {
        cout << "析构函数调用:" << m_name << endl;
    }

private:
    string m_name;
};

void test() {
    Student s1;             // 默认构造函数调用
    Student s2("小明");      // 有参构造函数调用
}                          // 函数结束 → 栈上对象逆序析构
                           // 析构函数调用:小明
                           // 析构函数调用:未命名

int main() {
    test();
    cout << "test 已返回" << endl;
    return 0;
}
💡 析构顺序是构造顺序的逆序(栈的后进先出)。这一点在多对象、对象成员场景下非常重要。
11.5 构造函数的分类与调用
分类方式
| 分类依据 | 类别 |
|---|---|
| 按参数 | 有参构造 / 无参构造 |
| 按类型 | 普通构造 / 拷贝构造 |
三种调用方式
(1)括号法
cpp
Student ob1;          // ✅ 调用默认构造函数
Student ob2(10);      // ✅ 调用有参构造函数
Student ob3(ob2);     // ✅ 调用拷贝构造函数
⚠️ 注意 :
Student ob1;不能写成Student ob1();因为
Student ob1();会被编译器识别为一个函数声明 (返回Student、无参数的函数ob1),这被称为"最令人困惑的解析(most vexing parse)"。
(2)显示法
cpp
Student ob1;
Student ob2 = Student(10);
Student ob3 = Student(ob2);
⚠️ 注意 :
Student(10);这种形式是一个匿名对象 。特点 :当前行执行完毕后,系统会立即回收 掉这个匿名对象。
在本例中,该匿名对象调用的是有参构造。
cpp
Student(10); // 这一行执行完,对象就被销毁了(析构函数立刻被调用)(3)隐式转换法
cpp
Student ob1;
Student ob2 = 10;      // 等价于 Student ob2 = Student(10);
Student ob3 = ob2;     // 等价于 Student ob3 = Student(ob2);
💡 隐式转换之所以能成立,是因为构造函数可以接受单个参数时被当作转换函数 使用。
如果不希望发生隐式转换,可以在构造函数前加
explicit:
cppexplicit Student(int a); // 此时 Student ob2 = 10; 会编译报错这是工程中强烈推荐的写法。
11.6 拷贝构造函数
拷贝构造函数与普通构造函数的唯一区别 是其形参为
const 类名 &别名。
cpp
// 假定有一个类 Person
Person(const Person &p) { }
解析 :当传入一个同类对象时,为该对象创建一个别名,并且限定为只读(const),避免在拷贝构造函数的函数体当中误操作、改变传入对象的成员属性。
⚠️ 为什么必须是引用 而不能是值传递?
因为如果是值传递
Person(Person p),那么把实参传给形参p时又要调用一次拷贝构造函数,从而无限递归。
范例代码:
cpp
#include <iostream>
#include <string>
using namespace std;

class Student {
private:
    int num;        // 学号
    string name;    // 名字
    int score;      // 成绩

public:  // 构造函数必须在公共作用域
    Student();
    Student(int a);
    Student(const Student &p);
};

Student::Student() {
    cout << "默认构造函数调用" << endl;
}

Student::Student(int a) {
    num = 114514;
    name = "cgw";
    score = a;
    cout << "有参构造函数调用" << endl;
}

Student::Student(const Student &p) {
    num   = p.num;
    name  = p.name;
    score = p.score;
    cout << "num = " << num << " name = " << name
         << " score = " << score << endl;
    cout << "拷贝构造函数调用" << endl;
}

void test1() {
    Student ob1;        // 调用默认构造函数
    Student ob2(10);    // 调用有参构造函数
    /* 创建一个对象 ob3 的同时,编译器会自动调用构造函数,
       将对象 ob2 作为实参传入。函数重载决议后,调用的是拷贝构造函数,
       将 ob2 的属性都拷贝给新创建的 ob3 */
    Student ob3(ob2);
    return;
}

int main() {
    test1();
    return 0;
}
11.7 构造函数调用规则
| 情形 | 编译器行为 |
|---|---|
| 用户未定义任何构造函数 | 自动提供无参构造 (空体)+ 拷贝构造(逐成员拷贝) |
| 用户定义了有参构造 | 不再提供无参构造,但仍提供默认拷贝构造 |
| 用户定义了拷贝构造 | 不会提供任何其他构造函数(有参和无参都不提供) |
cpp
class A {
    A(int x) {}    // 定义了有参构造
};
// A a;            // ❌ 错误:编译器不再提供无参构造
// A b(10);        // ✅
// A c(b);         // ✅ 编译器仍提供拷贝构造

class B {
    B(const B&) {} // 定义了拷贝构造
};
// B b;            // ❌ 错误:无参构造不被提供
// B b2(10);       // ❌ 错误:有参构造不被提供
💡 实践建议 :一旦自己定义了任何一个构造函数,最好把无参构造、有参构造、拷贝构造 都补齐(C++11 起可用
= default/= delete显式声明)。
cpp
class Student {
public:
    Student() = default;                          // 显式要求生成默认构造
    Student(const Student&) = default;            // 显式要求生成拷贝构造
    Student& operator=(const Student&) = delete;  // 显式禁止拷贝赋值
};
11.8 构造函数的初始化列表
cpp
struct Test {
    int m_a;
    int m_b;
    Test(int a, int b) : m_a(a), m_b(b) {}   // 初始化列表
};

int main() {
    Test t1(10, 20);
    cout << t1.m_a << "  " << t1.m_b << endl;   // 10  20
    return 0;
}
初始化列表 vs 函数体内赋值:
cpp
// 写法 A:函数体内赋值(先默认构造,再赋值)
Test(int a, int b) {
    m_a = a;    // 先调用 m_a 的默认构造,再调用 operator=
    m_b = b;
}

// 写法 B:初始化列表(直接构造)
Test(int a, int b) : m_a(a), m_b(b) {}   // ✅ 效率更高
⚠️ 必须使用初始化列表的三种情况:
const成员变量(常量不能先默认构造再赋值);- 引用成员变量(引用必须初始化);
- 没有默认构造函数的类类型成员。
💡 初始化顺序 :成员变量的初始化顺序只取决于它们在类中声明的顺序 ,与初始化列表的书写顺序无关。这也是常见的坑------如果初始化列表里m_b依赖m_a,必须保证m_a声明在前。
第 12 章 深拷贝与浅拷贝
12.1 概念
-
浅拷贝 :即调用默认拷贝函数。编译器生成的默认拷贝函数能够将一个对象的所有成员属性拷贝给另一个新创建的对象进行初始化。
⚠️ 对于指针成员,浅拷贝只是拷贝指针的值(地址) ,两个对象的指针会指向同一块内存。
-
深拷贝 :在堆区重新申请空间,进行拷贝操作。
✅ 对于指针成员,深拷贝会为新对象分配独立的堆空间,并把原对象指向的内容复制过去。
12.2 完整示例
cpp
#include <iostream>
using namespace std;

class Person {
public:
    int P_age;
    int* P_height;      // 承接堆分配空间的地址

    Person(int age, int height);
    Person(const Person& p);
    ~Person();
};

Person::Person(int age, int height) {
    P_age = age;
    P_height = new int(height);      // 堆区申请
    cout << "有参构造函数" << endl;
}

Person::Person(const Person& t) {
    P_age = t.P_age;
    // ✅ 如果不利用深拷贝在堆区申请新内存空间,
    //    会导致浅拷贝带来的重复释放堆区问题
    P_height = new int(*t.P_height); // 动态分配一个整型空间,赋值为 (*t.P_height)
    cout << "拷贝构造函数" << endl;
}

Person::~Person() {
    if (P_height != NULL) {          // 空指针指向地址 0
        delete P_height;
        P_height = NULL;
    }
    cout << "析构函数的调用" << endl;
}

void test() {
    Person P1(10, 150);
    cout << P1.P_age << "  " << *P1.P_height << endl;

    Person P2(P1);                   // 调用拷贝构造
    cout << P2.P_age << "  " << *P2.P_height << endl;
}

int main() {
    test();
    return 0;
}
12.3 浅拷贝为什么会出问题?
如果不自定义拷贝构造函数,使用默认拷贝函数,那么在 P2 初始化时,拷贝函数中会出现:
cpp
P_height = t.P_height; // t 为 P1 的别名推演后果:
P1.P_height ──┐
              ├──► 同一块堆内存
P2.P_height ──┘
那么 P1 和 P2 对象的成员指针 P_height 都指向了同一块堆整型内存空间 。在这两个对象销毁时,会分别调用各自的析构函数,这块内存空间会被释放两次------这是不允许的。
~P1() → delete P_height;  ✅ 第一次释放成功
~P2() → delete P_height;  ❌ 重复释放,程序崩溃(double free)
⚠️ 重复释放(double free)是 C++ 中最经典的崩溃之一,且往往不是立刻崩溃 ------可能破坏了堆管理器的内部链表,在后续某次
new时才炸,极难定位。
12.4 浅拷贝 / 深拷贝对比图
| 浅拷贝 | 深拷贝 | |
|---|---|---|
| 谁来实现 | 编译器默认生成的拷贝构造 | 需要手动编写 |
| 对普通成员 | 逐个赋值(正确) | 逐个赋值(正确) |
| 对指针成员 | 只复制地址 → 共享同一块内存 | 新申请内存 + 复制内容 → 互相独立 |
| 风险 | 重复释放、修改互相影响 | 无(但要注意手动释放) |
| 适用场景 | 类中没有需要手动管理的资源 | 类中持有堆区资源(指针成员) |
12.5 三法则(Rule of Three)
如果你需要自定义析构函数、拷贝构造函数、拷贝赋值运算符中的任何一个,那么通常三个都需要自定义。
cpp
class Person {
public:
    Person(const Person& t);             // 拷贝构造
    Person& operator=(const Person& t);  // 拷贝赋值
    ~Person();                           // 析构

private:
    int* P_height;
};
💡 C++11 之后扩展为五法则,再加上移动构造和移动赋值运算符。
12.6 补充:三个易错场景
场景 1:对象作函数形参
对象作函数形参属于值传递。
当该函数未调用时,函数的形参并不存在。只有当该函数被调用时,形参才会被创建并送入栈区,并使用实参传入的值进行初始化。
当函数被调用、某同类对象作为实参传入时,作为形参的局部对象才会被创建并初始化。该过程等价于:
cpp
student p(stu1);p为作为形参的局部对象;stu1为传入的实参对象。
所以在对象 p 的创建和初始化过程中,系统调用的是类中的拷贝构造函数。
在该函数执行将结束时,调用类中的析构函数并销毁对象 p。
cpp
void func(Student p) {   // ← 这里会调用一次拷贝构造
    // ...
}                        // ← 这里会调用一次析构

int main() {
    Student stu1;
    func(stu1);          // 传值:拷贝构造 + 析构各一次
    return 0;
}
💡 性能提示:这就是"对象作为函数参数应尽量传引用"的原因------传引用可以避免一次拷贝构造 + 一次析构。
场景 2:值方式返回局部对象
cpp
Person test() {
    Person T;      // T 是局部对象
    return T;      // 编译器会创建一个临时对象,
                   // 即"临时变量名(T)",
                   // 所以在临时变量初始化中会调用类中的拷贝函数
}执行过程:
- 创建局部对象
T(调用无参构造); return T;→ 编译器创建临时对象,用T初始化它(调用拷贝构造);- 局部对象
T被销毁(调用析构); - 临时对象被用来初始化接收方(现代编译器通常会优化掉这一步,即 RVO/NRVO)。
💡 返回值优化(RVO) :现代编译器在
-O2下通常能直接在被调用方的空间里构造对象,省掉拷贝构造与析构。所以在 C++17 之后,这类代码的实际开销可能为 0。
场景 3:成员函数内访问对象属性都隐式带 this 指针
cpp
m_age = age;              // m_age 是对象属性,age 是成员函数形参
// 等价于:
this->m_age = age;
该 this 指针用于表明该属性属于哪个对象。
第 13 章 对象成员、静态成员与 this 指针
13.1 A 类对象作为 B 类成员(对象成员)
注意 :成员对象先 创建并初始化,然后本类对象再创建。
cpp
#include <iostream>
#include <string>
using namespace std;

class Phone {              // 手机类
public:
    Phone(string name) {
        m_PhoneName = name;
        cout << "Phone 构造:" << name << endl;
    }
    ~Phone() {
        cout << "Phone 析构" << endl;
    }
    string m_PhoneName;
};

class Person {             // 人类
public:
    Person(string name, string pName)
        : m_Name(name), m_Phone(pName) {}   // 初始化列表
    // 该构造函数调用时,m_Phone(pName) 等价于 m_Phone = pName;
    // 即隐式转换法初始化

    ~Person() {
        cout << "Person 析构" << endl;
    }

    string m_Name;
    Phone  m_Phone;        // A 类的对象可以作为 B 类的成员,称为对象成员
};

int main() {
    Person p("张三", "iPhone");
    return 0;
}输出顺序:
Phone 构造:iPhone      ← 成员对象先构造
Person 构造(隐含)      ← 本类对象后构造
Person 析构             ← 本类对象先析构
Phone 析构              ← 成员对象后析构
💡 构造顺序 :先成员、后自身;析构顺序:先自身、后成员。整体符合"栈式"的先进后出。
⚠️ 这也是必须用初始化列表的场景之一:如果成员对象没有默认构造函数,就只能在初始化列表中构造它。
13.2 静态成员
在某类中,在成员变量和成员函数前加
static,称为静态成员。
13.2.1 静态成员变量
cpp
class Person {
public:
    static int m_A;      // 类内声明
};

int Person::m_A = 10; // ⚠️ 类外初始化(必须!)三个特征:
- 同一个类的所有对象共享静态成员变量 。假如调用某个该类对象对应的静态成员变量赋新值,那么该类其他对象对应的静态成员变量也会同步共享;
- 在编译阶段分配内存(不占对象空间);
- 类内声明,类外初始化 。语法:
int Person::m_A = 10;
cpp
#include <iostream>
using namespace std;

class Person {
public:
    static int m_A;
};

int Person::m_A = 10;

int main() {
    Person p1, p2;
    p1.m_A = 100;
    cout << p2.m_A << endl;    // 100 ------ 共享同一份数据

    cout << Person::m_A << endl;  // 100 ------ 也可以通过类名访问
    return 0;
}
13.2.2 静态成员函数
- 同一个类的所有对象共享同一个函数;
- 静态成员函数只能访问静态成员变量。
cpp
class Person {
public:
    static int m_A;      // 静态成员变量
    int m_B;             // 非静态成员变量

    static void func() {
        m_A = 100;       // ✅ 可以访问静态成员变量
        // m_B = 200;    // ❌ 错误:静态函数内没有 this 指针,
                         //    无法确定 m_B 属于哪个对象
    }
};
为什么静态成员函数不能访问非静态成员? 因为它没有 this 指针 。非静态成员变量的访问必须通过 this->(隐式),而静态函数不与任何具体对象绑定。
13.2.3 静态成员变量的访问方法
-
通过对象进行访问
cppPerson p; cout << p.m_A << endl; -
通过类名进行访问
cppcout << Person::m_A << endl;
注 :静态成员函数的访问方法与变量相同,也可以用
对象.函数()或类名::函数()两种形式。
13.3 this 指针
13.3.1 空对象
空对象占 1 字节的内存空间,这里为了每个对象都有独一无二的地址。
cpp
class Empty {};
cout << sizeof(Empty) << endl;   // 1
13.3.2 this 指针概念
C++ 中成员变量和成员函数是分开存储 的。只有非静态成员变量才属于类对象,存在于为该对象分配的内存空间当中,为该对象特有。
每一个非静态成员函数只会诞生一份函数实例 ,由同类的所有对象共享 。所以非静态成员函数有自己独立的内存空间,且不位于同类中的任意一个对象的内存空间。
那么,非静态成员函数通过
this指针区分是哪个对象调用自身。
this指针指向调用成员函数的对象 (构造函数等也属于成员函数)。this指针是隐含在每一个非静态成员函数内的指针。
内存布局示意:
对象 p1:  [ m_age | m_name ]  ──┐
对象 p2:  [ m_age | m_name ]  ──┤
                                │  共享调用
代码区:   [ showPerson(this) ] ──┘  this 指向 p1 或 p2
13.3.3 this 指针的用途一:解决名称冲突
cpp
class Person {
public:
    int age;

    Person(int age) {
        age = age;   // ⚠️ 当成员变量名与形参同名时,
                     // 在成员函数内部,成员变量被屏蔽(名字查找就近原则),
                     // 所有 age 都认为是形参 age ------ 结果是给形参自己赋值
    }
};改写为:
cpp
Person(int age) {
    this->age = age;   // ✅ this->age 明确指向成员变量
}
💡 命名规范上建议用
m_前缀(如m_age)来避免这种冲突,这也是 Google C++ 风格指南的做法。
13.3.4 this 指针的用途二:返回对象本身(链式编程)
cpp
#include <iostream>
using namespace std;

class Person {
public:
    int age;

    Person(int age) {
        this->age = age;
    }

    // ✅ 返回值类型为引用,返回对象本身
    Person& PersonAddAge(const Person &p) {
        age += p.age;
        return *this;   // this 是 P2 的对象指针
        // 当返回对象本身时,函数返回值类型为引用,
        // 相当于给返回的对象取一个与本名相同的别名
    }
};

int main() {
    Person P1 = 10;
    Person P2(0);

    P2.PersonAddAge(P1).PersonAddAge(P1);   // 链式编程
    cout << P2.age << endl;                 // 输出结果为 20

    return 0;
}推演:
P2.PersonAddAge(P1)  →  P2.age = 0 + 10 = 10,返回 P2 的引用
        .PersonAddAge(P1)  →  P2.age = 10 + 10 = 20,返回 P2 的引用
最终 P2.age == 20  ✅
13.3.5 ⚠️ 陷阱:返回类型写成类名(值返回)
cpp
#include <iostream>
using namespace std;

class Person {
public:
    int age;

    Person(int age) {
        this->age = age;
    }

    // ⚠️ 以值传递的方式返回,等价于 Person 临时对象 = *this;
    //    创建了一个匿名对象,传入一个对象进行初始化
    Person PersonAddAge(const Person &p) {
        age += p.age;
        return *this;
    }
};

int main() {
    Person P1 = 10;
    Person P2(0);

    P2.PersonAddAge(P1).PersonAddAge(P1);   // 链式编程失效
    cout << P2.age << endl;                 // 输出结果为 10 ⚠️
    return 0;
}
为什么会这样?
在 P2.PersonAddAge(P1) 阶段,传入的实参对象是 P2:
-
第一次调用在
P2上执行,P2.age变成 10; -
return *this;以值方式 返回 → 编译器创建一个匿名对象 (拷贝自P2),该匿名对象在本次调用完后会立即销毁; -
链式编程中,再由这个匿名对象 调用
PersonAddAge(P1)------ 修改的是这个临时对象,此时对P2的属性值无影响; -
所以
P2.age保持 10。P2.PersonAddAge(P1) → P2.age = 10,返回匿名对象 copy(age=10)
copy.PersonAddAge(P1) → copy.age = 20,但 copy 立即销毁
P2.age 仍然是 10 ❌
💡 一句话总结 :要支持链式编程,就必须返回引用;返回值类型写出类名(值返回)会返回一个副本,链式调用就断链了。
13.3.6 空指针调用成员函数
cpp
#include <iostream>
using namespace std;

class Person {
public:
    int m_age;

    void showPersonAge() {
        if (this == NULL) {   // ✅ 判断,保证代码不崩溃(健壮性)
            return;
        }
        cout << m_age << endl;
        // 成员函数中调用对象属性前都隐含 this 指针,用于指示该属性属于哪个对象,
        // 即 this->m_age; 但因为可能使用空指针调用成员函数,
        // 此时 this 指针为 NULL,访问属性就会崩溃
    }

    Person(int age) {
        m_age = age;
    }
};

int main() {
    Person* p = NULL;
    p->showPersonAge();   // ⚠️ 能编译,能运行;因为函数体内没访问成员变量
    return 0;
}
⚠️ 重要理解 :
p->showPersonAge();当p为NULL时并不会立即崩溃 ,因为成员函数不依赖对象内存(在代码区)。只有当函数体内真正访问了成员变量(即this->m_age)时,对空指针解引用才会崩溃。这也是为什么加一句
if (this == NULL) return;能防崩。
第 14 章 const 与成员函数/对象
14.1 const 修饰指针的三种情况
这是 C++ 中最容易混淆的一组概念,务必掌握"看 const 在 * 的哪一边"的判断法。
14.1.1 常量指针(const int * p)
cpp
const int * p = &a;- 别名:常量指针;
- 特点 :指针的指向可以修改 ,但是指针指向的值不可以改。
cpp
*p = 20;   // ❌ 错误:指针指向的值不可以改
p  = &b;   // ✅ 正确:指针指向可以改
💡
const紧挨着int,所以被 const 修饰的是"int(指向的值)"。
14.1.2 指针常量(int * const p)
cpp
int * const p = &a;- 别名:指针常量;
- 特点 :指针的指向不可以改 ,指针指向的值可以改。
cpp
*p = 20;   // ✅ 正确:指向的值可以改
p  = &b;   // ❌ 错误:指针指向不可以改
💡
const紧挨着p,所以被 const 修饰的是"指针本身"。⚠️ 注意这与第 8.4 节"引用的本质是指针常量"呼应:
int& ref = a;等价于int* const ref = &a;------指向不可改,所以引用不能换绑。
14.1.3 既修饰指针又修饰常量(const int * const p)
cpp
const int * const p = &a;- 特点 :指针的指向 和指针指向的值都不可以改。
cpp
*p = 20;   // ❌ 错误
p  = &b;   // ❌ 错误
14.1.4 三种情况速记表
| 写法 | 名称 | *p = 20 |
p = &b |
记忆口诀 |
|---|---|---|---|---|
const int * p |
常量指针 | ❌ | ✅ | const 在 * 左 → 锁值 |
int * const p |
指针常量 | ✅ | ❌ | const 在 * 右 → 锁指针 |
const int * const p |
两者都是 | ❌ | ❌ | 两边都有 → 都锁 |
💡 读法技巧 :从右往左读英文。
const int * p读作 "p is a pointer to const int"(p 是指向常量的指针);int * const p读作 "p is a const pointer to int"(p 是常量指针)。
14.2 const 修饰成员函数(常函数)
cpp
#include <iostream>
using namespace std;

class Person {
public:
    mutable int m_A;   // mutable 关键字:即使在常函数中也可以修改
    int m_B;

    Person() : m_A(10), m_B(20) {}

    void showPerson() const {
        // 每一个成员函数(构造函数等也是成员函数)内都有一个 this 指针,
        // 隐含在函数体内每个对象属性前,指示该属性所属对象
        this->m_A = 100;   // ✅ 可以修改(因为 m_A 是 mutable)
        // this->m_B = 200; // ❌ 不可以修改
    }
    /* this 指针的本质是:指针常量(指向不可改,指向对象的属性值可改)
       在成员函数后加 const,修饰的是 this,
       即变成 const Person * const this;
       让 this 的指向和指向对象的属性值均不可改 */
};

int main() {
    Person P1;
    cout << P1.m_A << endl << P1.m_B << endl;   // 10  20

    P1.showPerson();

    cout << P1.m_A << endl << P1.m_B << endl;   // 100  20
    return 0;
}
核心理解 :普通成员函数中的 this 类型是 Person * const(指向不可改);加上 const 后,this 类型变成 const Person * const(指向和指向的内容都不可改)。
mutable 关键字
mutable 用于突破 const 的限制。被它修饰的成员变量,即使所在对象是常对象、即使通过常函数访问,也依然可以被修改。
典型用途:缓存、计数器、互斥锁等"逻辑上不改变对象状态"的成员。
cpp
class Cache {
    mutable int hitCount = 0;   // 统计调用次数,不算修改对象"内容"

public:
    int getData() const {
        hitCount++;             // ✅ mutable 允许在 const 函数中修改
        return 42;
    }
};
14.3 const 修饰对象(常对象)
在对象前加
const,即为常对象。
cpp
const Person P2;两条规则:
- 常对象的属性不可修改 ,但用
mutable修饰的属性可以修改; - 常对象只能调用常函数,因为普通成员函数可以修改属性。
cpp
#include <iostream>
using namespace std;

class Person {
public:
    mutable int m_A;
    int m_B;

    Person() : m_A(10), m_B(20) {}

    void showPerson() const {   // 常函数
        cout << "常函数被调用" << endl;
    }

    void modify() {             // 普通成员函数
        m_B = 100;
    }
};

int main() {
    const Person p;      // 常对象

    // p.m_B = 30;       // ❌ 错误:常对象的属性不可修改
    p.m_A = 30;          // ✅ 正确:mutable 属性可以修改

    p.showPerson();      // ✅ 正确:常对象只能调用常函数
    // p.modify();       // ❌ 错误:常对象不能调用普通成员函数

    return 0;
}
💡 设计价值 :
const是一种接口契约 。声明一个对象为const后,编译器会帮你保证它的"内容"不会被任何途径修改,这对多线程共享数据、API 设计都非常有价值。
补充:const 的传播规律
| 修饰对象 | 可以调用的成员函数 | 何时用 |
|---|---|---|
| 普通对象 | 常函数 + 普通函数 | 常规使用 |
常对象 const T |
仅常函数 | 只读使用,如函数参数 |
另一个常见用途:常引用作函数参数------既避免了拷贝,又保证函数内不会修改原对象。
cpp
void printInfo(const Person& p) {   // ✅ 高效 + 安全
    // p.m_B = 1;   // ❌ 编译期就被拦住
}
第 15 章 友元
15.1 概念
友元的目的 :让一个类外函数或者类能够访问另一个类中的私有成员 。
关键字 :
friend
友元有三种形式:
| 形式 | 声明位置 | 示例 |
|---|---|---|
| 全局函数作友元 | 被访问的类内 | friend void goodGay(Building*); |
| 类作友元 | 被访问的类内 | friend class goodGay; |
| 成员函数作友元 | 被访问的类内 | friend void goodGay::visit(); |
💡 友元是单向的、不可传递的 :
A是B的朋友,不代表B是A的朋友;A是B的朋友、B是C的朋友,不代表A是C的朋友。
15.2 全局函数作友元
cpp
#include <iostream>
#include <string>
using namespace std;

class Building {
    // 告诉编译器:goodGay 全局函数是 Building 类的好朋友,可以访问类中的私有成员
    friend void goodGay(Building* building);

public:
    Building() {
        this->m_SittingRoom = "客厅";
        this->m_BedRoom = "卧室";
    }

public:
    string m_SittingRoom;    // 客厅
private:
    string m_BedRoom;        // 卧室
};

// 全局函数
void goodGay(Building* building) {
    cout << building->m_SittingRoom << endl;   // ✅ 公有成员
    cout << building->m_BedRoom << endl;       // ✅ 私有成员,因为是友元
}

int main() {
    Building B1;
    goodGay(&B1);
    return 0;
}
⚠️ 原文此处写成
cout m_SittingRoom << endl;,缺少了<<和对象指针,是明显的笔误。正确写法见上面代码。
15.3 类作友元
cpp
#include <iostream>
#include <string>
using namespace std;

class Building;    // 前向声明,使 goodGay 类中可以使用 Building 这个类名

class goodGay {
public:
    goodGay();     // 构造函数,在类外定义

    ~goodGay() {
        if (building != NULL) {
            delete building;
            building = NULL;
        }
    }

    void visit();

private:
    Building* building;   // 对象指针,指向 Building 类的某个对象
};

class Building {
    // 告诉编译器:goodGay 类是 Building 类的好朋友,
    // 可以访问到 Building 类中的私有内容
    friend class goodGay;

public:
    Building();

public:
    string m_SittingRoom;   // 客厅
private:
    string m_BedRoom;       // 卧室
};

Building::Building() {      // Building 类的构造函数
    this->m_BedRoom = "卧室";
    this->m_SittingRoom = "客厅";
}

goodGay::goodGay() {        // goodGay 类的构造函数
    // building 是 goodGay 类中指向 Building 类对象的成员指针
    building = new Building;    // 向堆区申请创建一个 Building 类对象
}

void goodGay::visit() {
    cout << building->m_BedRoom << endl;
    cout << building->m_SittingRoom << endl;
    /* m_BedRoom 是 Building 类对象(堆区创建的那个)的私有成员,
       但因为 goodGay 类是 Building 类的好朋友,
       所以 goodGay 类的对象可以访问 */
}

int main() {
    goodGay gg;
    gg.visit();
    return 0;
}关键点:
class Building;是前向声明 ,让goodGay类中可以出现Building*这样的指针类型(指针只需知道类型名存在即可);- 友元声明
friend class goodGay;必须写在Building类内; goodGay::goodGay()中用new Building在堆区创建对象时,程序会自动调用Building类的构造函数对该对象进行初始化。
15.4 成员函数作友元
目的 :让 goodGay 对象的某一个成员函数 可以访问 Building 所属对象的私有成员。
cpp
#include <iostream>
#include <string>
using namespace std;

/* introduce: 让 goodGay 的对象的一个成员函数
              可以访问 Building 所属对象的私有成员 */
class Building;

class goodGay {
public:
    goodGay();

    ~goodGay() {
        if (building != NULL) {
            delete building;
            building = NULL;
        }
    }

    void visit();

private:
    Building* building;    // 创建一个指向 Building 类对象的指针
};

class Building {
    // 告诉编译器:goodGay 类对象中的 visit 成员函数
    // 是 Building 类对象的好朋友,可以访问其私有内容
    friend void goodGay::visit();

public:
    string m_SittingRoom;

private:
    string m_BedRoom;

public:
    Building();
};

goodGay::goodGay() {
    building = new Building;   // 在堆区创建一个 Building 类对象
    // 注意:在堆区创建时,程序会自动调用 Building 类的构造函数对该对象进行初始化
}

void goodGay::visit() {
    cout << building->m_SittingRoom << endl;
    cout << building->m_BedRoom << endl;   // ✅ 访问 Building 类对象的私有成员
}

Building::Building() {
    m_SittingRoom = "客厅";
    m_BedRoom = "卧室";
}

int main() {
    goodGay gg;
    gg.visit();
    return 0;
}
⚠️ 顺序陷阱 :友元声明
friend void goodGay::visit();要求编译器已经知道goodGay类的定义(因为要确定visit确实是它的成员)。因此这里必须先完整定义goodGay类,再定义Building类。
15.5 三种友元形式对比
| 形式 | 声明写法 | 授权粒度 | 常见场景 |
|---|---|---|---|
| 全局函数 | friend void f(MyClass&); |
单个函数 | 运算符重载(如 operator<<) |
| 整个类 | friend class Other; |
整个类 | 强耦合的协作类(如容器与迭代器) |
| 成员函数 | friend void Other::f(); |
单个成员函数 | 权限最小化,比整类友元更安全 |
💡 设计建议 :优先选择粒度最小的友元形式。能用成员函数友元就不要用整类友元。友元破坏了封装性,应谨慎使用;但运算符重载、测试类等场景下它是必要的。
第 16 章 运算符重载
16.1 概念
运算符重载让自定义类型也能使用标准运算符,使代码更自然、更贴近人类直觉。
运算符重载有两种实现形式:成员函数 形式和全局函数形式。
16.2 + 运算符重载
目标:实现两个自定义数据类型的相加。
cpp
#include <iostream>
using namespace std;

class Person {
public:
    Person() {}
    Person(int a, int b) {
        this->m_A = a;
        this->m_B = b;
    }

    // ===== 成员函数实现 + 号运算符重载 =====
    // Person operator+ (const Person & p)
    // {
    //     Person temp;
    //     temp.m_A = this->m_A + p.m_A;
    //     temp.m_B = this->m_B + p.m_B;
    //     return temp;
    //     /* 以值传递的方式返回局部对象 temp,等价于
    //        创建一个匿名对象,调用默认拷贝函数将 temp 的属性值拷贝给匿名对象 */
    // }

public:
    int m_A;
    int m_B;
};

// ===== 全局函数实现 + 号运算符重载 =====
Person operator+(const Person& p1, const Person& p2) {
    Person temp;
    temp.m_A = p1.m_A + p2.m_A;
    temp.m_B = p1.m_B + p2.m_B;
    return temp;
}

int main() {
    Person P1(10, 20);
    Person P2(10, 20);

    /* 成员函数实现 + 号运算符重载:本质 = P1.operator+(P2);
       全局函数实现 + 号运算符重载:本质 = operator+(P1, P2); */

    Person P3 = P1 + P2;   // 创建对象 P3,并以隐式转换法
                           // 调用默认拷贝函数对其进行初始化
    cout << P3.m_A << " " << P3.m_B << endl;   // 20 40
    return 0;
}两种实现方式的本质对照:
| 实现方式 | 编译器展开形式 | 参数个数 |
|---|---|---|
| 成员函数 | P1.operator+(P2) |
1 个(this 隐含为左操作数) |
| 全局函数 | operator+(P1, P2) |
2 个 |
💡 选择依据:
- 如果左操作数是本类对象,优先成员函数;
- 如果左操作数不是本类对象 (如
ostream),必须用全局函数。
16.3 << 左移运算符重载
cpp
#include <iostream>
using namespace std;

class Person {
public:
    Person() {
        m_A = 10;
        m_B = 20;
    }

public:
    int m_A;
    int m_B;
};

// ⚠️ 只有全局函数能实现左移运算符重载
// ostream 类(标准输出类)对象只能有一个
// cout 是 ostream 类下的全局对象
ostream& operator<<(ostream& cout, Person& p) {
    /* 以引用的方式返回 cout,即返回 cout 的别名,利用此可以实现链式编程
       引用返回相较于值返回,不会创建临时对象,减少了对内存空间的占用 */
    cout << p.m_A << " " << p.m_B;
    return cout;
}

int main() {
    Person p1;
    cout << p1 << endl;   // cout << p1 传入的是 cout 和 p1,
                          // 所以调用的是运算符重载函数
    return 0;
}
为什么必须用全局函数?
因为表达式 cout << p1 的左操作数是 cout,类型是 std::ostream。如果写成成员函数,就得是 ostream::operator<<(Person&)------这需要我们修改标准库的 ostream 类,是不可能的。
cpp
// 若写成成员函数,编译器会尝试:
cout.operator<<(p1);   // ❌ 需要给 ostream 类添加成员函数,无法做到

// 全局函数版本:
operator<<(cout, p1);  // ✅ 可行
为什么要返回 ostream&?
cpp
cout << p1 << "hello" << endl;解析顺序是 ((cout << p1) << "hello") << endl;。若 operator<< 返回值而不是引用:
- 每次调用都会拷贝一个
ostream对象 (开销大,且ostream本就不可拷贝); - 链式调用会作用在临时副本上,输出可能丢失或乱序。
返回引用则让整个链条始终作用在同一个 cout 上。
完整规范写法(含 const)
cpp
// ✅ 工程中的标准写法
ostream& operator<<(ostream& os, const Person& p) {
    os << "(" << p.m_A << ", " << p.m_B << ")";
    return os;
}

// 有时需要配套友元声明(若访问私有成员)
class Person {
    friend ostream& operator<<(ostream& os, const Person& p);
    // ...
};
💡 注意参数名不要叫
cout(会遮蔽全局cout),工程中惯例用os或out。
16.4 其他常用运算符重载速查
| 运算符 | 推荐实现方式 | 返回类型 | 备注 |
|---|---|---|---|
+ - * / |
全局函数 | 值 | 左右操作数地位对称 |
+= -= |
成员函数 | T& |
修改自身,返回 *this |
== != < |
全局函数 | bool |
C++20 起可用 <=> 简化 |
<< >> |
全局函数 | ostream& / istream& |
左操作数是流对象 |
[] |
必须成员函数 | T& |
一般成对提供 const 版本 |
() |
必须成员函数 | 任意 | 函数对象(仿函数) |
++ -- 前置 |
成员函数 | T& |
operator++() |
++ -- 后置 |
成员函数 | T |
operator++(int),int 是占位参数 |
示例:[] 与 ++ 重载
cpp
class MyArray {
    int data[10];
public:
    // 下标运算符(必须成员函数)
    int& operator[](int i) { return data[i]; }
    const int& operator[](int i) const { return data[i]; }

    // 前置 ++:先自增,返回自身引用
    MyArray& operator++() {
        for (int i = 0; i < 10; i++) data[i]++;
        return *this;
    }

    // 后置 ++:先返回旧值副本,再自增(int 占位用于区分)
    MyArray operator++(int) {
        MyArray temp = *this;
        ++(*this);
        return temp;
    }
};
⚠️ 可以重载的运算符限制:
- 不能发明新运算符;
- 不能改变运算符的优先级、结合性、操作数个数;
::、.、.*、?:、sizeof不能重载。
第 17 章 继承
17.1 概念与调用方式
继承同一个父类(基类)的多个子类(派生类)都拥有父类的共性 ,但又分别拥有自己的特性 。
继承的目的是减少代码的重复。
语法:
cpp
class 子类名 : 继承方式 父类名 {
    // ...
};示例:
cpp
#include <iostream>
using namespace std;

// 基类
class Animal {
public:
    string m_name;
    int m_age;

    void eat() {
        cout << m_name << " 在吃东西" << endl;
    }
};

// 派生类:公有继承
class Dog : public Animal {
public:
    void bark() {
        cout << m_name << " 在汪汪叫" << endl;
    }
};

int main() {
    Dog d;
    d.m_name = "旺财";    // 继承自父类的成员
    d.m_age = 3;
    d.eat();              // 继承自父类的行为
    d.bark();             // 自己的特性
    return 0;
}
17.2 继承方式
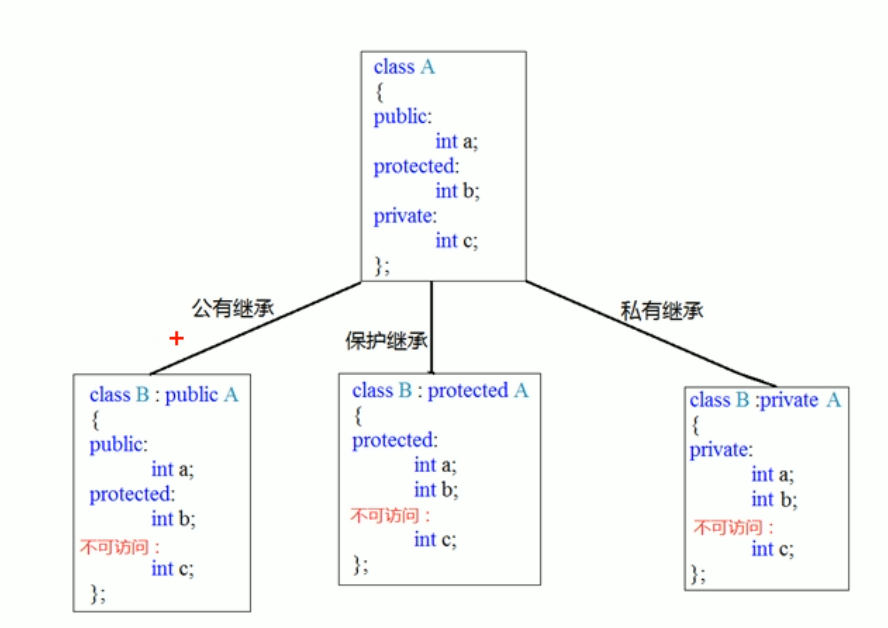
17.2.1 总原则
无论何种继承方式,父类中的私有权限成员,子类都访问不到。
17.2.2 三种继承方式对比
| 父类成员权限 | 公有继承 public |
保护继承 protected |
私有继承 private |
|---|---|---|---|
public |
仍是 public |
变为 protected |
变为 private |
protected |
仍是 protected |
变为 protected |
变为 private |
private |
不可访问 | 不可访问 | 不可访问 |
图中 class A 的定义:
cpp
class A {
public:
    int a;
protected:
    int b;
private:
    int c;
};
三种继承后的结果(与上表一致):
cpp
class B : public A    { };   // a: public,     b: protected, c: 不可访问
class B : protected A { };   // a: protected,  b: protected, c: 不可访问
class B : private A   { };   // a: private,    b: private,   c: 不可访问
💡 权限只能收紧,不能放宽 :
public可以被降级为protected或private;但protected/private永远不会被升级为public。
17.2.3 三条重要补充
-
父类中的所有非静态成员属性都会被子类继承,为子类所拥有。
-
父类中的私有成员同样也被子类继承、被子类拥有 ,但是被编译器隐藏,所以访问不到。
⚠️ 注意区分:"继承到了" 与 "能访问" 是两回事。私有成员确实存在于子类对象的内存布局中,只是编译器不允许你通过子类的语法访问它。
-
创建子类对象时,会先创建一个父类对象 ,调用父类中的构造函数初始化该父类对象,让子类对象继承父类对象的成员属性,然后才调用子类的构造函数。
17.2.4 构造与析构顺序
cpp
#include <iostream>
using namespace std;

class Base {
public:
    Base()  { cout << "父类构造" << endl; }
    ~Base() { cout << "父类析构" << endl; }
};

class Derived : public Base {
public:
    Derived()  { cout << "子类构造" << endl; }
    ~Derived() { cout << "子类析构" << endl; }
};

int main() {
    Derived d;
    return 0;
}输出:
父类构造
子类构造
子类析构
父类析构
💡 与"对象成员"的规律一致:构造时父类先于子类,析构时子类先于父类。整体呈"洋葱式"的对称结构。
17.2.5 需要在初始化列表中显式调用父类构造
cpp
class Derived : public Base {
public:
    // 若父类只有有参构造,子类必须显式调用
    Derived(int x) : Base(x), m_data(x) { }

private:
    int m_data;
};
17.3 补充:using 恢复权限与多继承
cpp
class B : private A {
public:
    using A::a;    // ✅ 把继承来的私有 a 重新提升为 public
};多继承(C++ 特有):
cpp
class C : public A, public B { }; // 同时继承 A 和 B⚠️ 菱形继承问题 :若
B和C都继承自A,而D同时继承B和C,则D中会有两份A的成员 ,产生二义性。解决方式是虚继承:
cppclass B : virtual public A { }; class C : virtual public A { }; class D : public B, public C { }; // 此时 A 的成员只有一份工程实践中,多继承应谨慎使用,通常只在实现多个"接口类"时使用。
第 18 章 多态
18.1 概念
多态分为两类:
- 静态多态 :函数重载和运算符重载属于静态多态,复用函数名;
- 动态多态 :派生类和虚函数实现运行时多态。
两者的区别:
| 静态多态 | 动态多态 | |
|---|---|---|
| 绑定时机 | 早绑定:编译阶段确定函数地址 | 晚绑定:运行阶段确定函数地址 |
| 实现手段 | 函数重载、运算符重载、模板 | 虚函数 + 继承 |
| 性能 | 无额外开销 | 有一次虚表查表开销 |
18.2 动态多态的实现
两个条件:
- 有继承关系;
- 子类重写(override)父类的虚函数。
cpp
#include <iostream>
using namespace std;

class Animal {
public:
    // 虚函数
    virtual void speak() {
        cout << "动物在说话" << endl;
    }
};

class Cat : public Animal {
public:
    void speak() override {          // 重写
        cout << "小猫在说话" << endl;
    }
};

class Dog : public Animal {
public:
    void speak() override {
        cout << "小狗在说话" << endl;
    }
};

// 关键:参数是父类的引用或指针
void doSpeak(Animal& animal) {
    animal.speak();     // 运行时才决定调用哪个版本
}

int main() {
    Cat cat;
    Dog dog;

    doSpeak(cat);       // 小猫在说话
    doSpeak(dog);       // 小狗在说话
    return 0;
}
💡 多态的价值 :
doSpeak只写一次,就能处理所有继承自Animal的类型。新增一种动物时,doSpeak完全不需要修改 ------这就是"对扩展开放、对修改关闭"的开闭原则。
18.3 虚函数的工作原理(虚函数表)
cpp
Animal a;
cout << sizeof(a) << endl; // 有虚函数后,对象会多一个指针大小(虚表指针 vptr)机制:
-
类中只要有虚函数,编译器就会为这个类生成一张虚函数表(vtable),表中存放各虚函数的地址;
-
每个对象内存布局的最前面多出一个
vptr(虚表指针),指向所属类的虚表; -
调用
animal.speak()时,实际是(*animal.vptr[0])()------运行时 通过对象的vptr找到真实类型对应的函数。Cat 对象: [ vptr ] → Cat 的虚表 → [ &Cat::speak ]
Dog 对象: [ vptr ] → Dog 的虚表 → [ &Dog::speak ]
⚠️ 对比:不加
virtual会怎样?若
speak不是虚函数,则doSpeak中的animal.speak()在编译期 就被绑定为Animal::speak,输出永远是"动物在说话"------这就失去了多态。
18.4 重写、重载、重定义的区别(易混淆)
| 概念 | 英文 | 条件 | 体现 |
|---|---|---|---|
| 重载 | overload | 同一作用域,函数名相同,参数列表不同 | 静态多态,编译期决议 |
| 重写 | override | 派生类中,函数签名完全相同 (含 const),且父类函数是虚函数 |
动态多态,运行期决议 |
| 重定义 | redefine / hide | 派生类中出现同名函数,但不满足重写条件(如父类非虚,或签名不同) | 父类版本被隐藏 |
cpp
class Base {
public:
    virtual void f(int)  { cout << "Base::f(int)" << endl; }
    void g()             { cout << "Base::g()" << endl; }   // 非虚
};

class Derived : public Base {
public:
    void f(int) override { cout << "Derived::f(int)" << endl; }  // 重写
    void g()             { cout << "Derived::g()" << endl; }     // 重定义(隐藏)
};
💡 强烈建议 :重写虚函数时一律加上
override关键字。它能让编译器检查"你是否真的重写了某个虚函数",避免因签名写错(比如漏了const)而悄悄变成"重定义"------这类 bug 极其隐蔽。
18.5 补充:虚析构函数(多态场景必看)
cpp
class Base {
public:
    virtual ~Base() { cout << "Base 析构" << endl; }   // ✅ 虚析构
};

class Derived : public Base {
public:
    ~Derived() { cout << "Derived 析构" << endl; }
};

int main() {
    Base* p = new Derived;
    delete p;    // ✅ 若 ~Base 是虚函数,会正确调用 ~Derived 再调用 ~Base
    return 0;
}
⚠️ 规则 :只要一个类可能被继承并通过基类指针删除对象,其析构函数就必须是虚函数。 否则
delete p只会调用Base::~Base,Derived中申请的资源就会泄漏,且行为未定义。
18.6 补充:纯虚函数与抽象类
cpp
class Shape {                    // 抽象类
public:
    virtual double area() const = 0;   // 纯虚函数
    virtual ~Shape() = default;
};

class Circle : public Shape {
    double r;
public:
    Circle(double r) : r(r) {}
    double area() const override { return 3.14159 * r * r; }
};规则:
- 含纯虚函数 的类是抽象类 ,不能被实例化;
- 抽象类的子类必须实现所有纯虚函数,否则它也是抽象类;
- 抽象类常用于定义接口。
💡 与 Java 的
interface类似。C++ 没有独立的接口关键字,用"只有纯虚函数、没有数据成员的抽象类"来模拟。
第四部分 文件操作与底层补充
第 19 章 文件操作
19.1 概念
需要包含头文件 <fstream>(文件流)。
文件类型分为两种:
- 文本文件:以 ASCII 码存储;
- 二进制文件:以二进制形式存储。
操作文件的三个"类"(是 C++ 中的类):
| 类名 | 用途 |
|---|---|
ofstream |
写操作(输出文件流) |
ifstream |
读操作(输入文件流) |
fstream |
读写操作(文件流) |
💡 记忆:
o= out(写),i= in(读),无前缀 = 读写皆可。
19.2 打开方式表格
| 打开方式 | 解释 |
|---|---|
ios::in |
为读文件而打开文件 |
ios::out |
为写文件而打开文件 |
ios::ate |
初始位置:文件尾 |
ios::app |
追加方式写文件 |
ios::trunc |
如果文件存在先删除,再创建 |
ios::binary |
二进制方式 |
注意 :文件打开方式可以配合使用 ,利用
|(按位或)操作符。例如 :用二进制方式写文件 →
ios::binary | ios::out
补充说明:
ios::out默认就隐含trunc(会清空原文件)。如果想保留原内容并追加,必须显式用ios::app;- 用
|组合时,ios::in | ios::out表示"读写打开"; - 若文件不存在,
ios::in会打开失败,而ios::out会自动创建文件。
19.3 写文件
五个步骤:
cpp
#include <fstream>      // 1. 包含头文件
using namespace std;

int main() {
    ofstream ofs;                          // 2. 创建流对象
    ofs.open("文件路径", 打开方式);          // 3. 打开文件
    ofs << "写入的数据";                    // 4. 写数据
    ofs.close();                           // 5. 关闭文件
    return 0;
}
读文件同理 (换成 ifstream 和 >>)。
完整示例
cpp
#include <iostream>
#include <fstream>
using namespace std;

int main() {
    // 读写文件流类 fstream
    fstream fst;
    fst.open("text.txt", ios::out);
    fst << "123" << endl << "456";
    fst.close();
    return 0;
}
💡 好习惯 :写完立刻
close()。虽然流对象析构时会自动关闭文件,但显式关闭能更早释放资源,也让意图更清晰。
使用 ofstream + ios::app 追加写入:
cpp
#include <fstream>
using namespace std;

int main() {
    ofstream ofs("log.txt", ios::app);     // 也可以在构造函数中直接打开
    if (!ofs.is_open()) {
        return -1;
    }
    ofs << "新的一条日志" << endl;
    ofs.close();
    return 0;
}
19.4 读文件
四个步骤 + 一种判断:
cpp
ifstream ifs;                       // 1. 创建流对象
ifs.open("文件路径", 打开方式);      // 2. 打开文件
if (!ifs.is_open()) { ... }         //    判断是否打开成功
// 3. 读数据(四种方式)
ifs.close();                        // 4. 关闭文件
完整示例
cpp
#include <iostream>
#include <fstream>
#include <string>
using namespace std;

int main() {
    fstream fst;
    fst.open("text.txt", ios::in);

    if (!fst.is_open()) {           // is_open 返回布尔类型
        cout << "文件打开失败" << endl;   // 判断文件是否打开成功
        return -1;
    }

    // ===== 读文件第一种方式:按词(遇空白分隔) =====
    /* char buf[100] = { 0 };
    while (fst >> buf) {
        cout << buf << endl;
    }
    fst.close(); */

    // ===== 读文件第二种方式:按行(C 风格缓冲区) =====
    /* char buf[100] = { 0 };
    while (fst.getline(buf, sizeof(buf))) {
        cout << buf << endl;
    }
    fst.close(); */

    // ===== 读文件第三种方式:按行(std::string,推荐) =====
    /* string buf;
    while (getline(fst, buf)) {
        cout << buf << endl;
    }
    fst.close(); */

    // ===== 读文件第四种方式:逐字符 =====
    char c;
    while ((c = fst.get()) != EOF) {    // EOF: end of file
        cout << c;
    }
    fst.close();

    return 0;
}
四种读法对比
| 方式 | 核心调用 | 分隔依据 | 是否保留空白 | 适用场景 |
|---|---|---|---|---|
① >> |
fst >> buf |
任意空白(空格/换行/制表) | ❌ 丢弃 | 读取结构化数据(数字、单词) |
② getline(数组) |
fst.getline(buf, n) |
换行符 | ✅ 保留(不含换行) | 逐行读取,长度有限制 |
③ getline(string) |
getline(fst, s) |
换行符 | ✅ 保留(不含换行) | 最推荐,长度无限制 |
④ get() |
fst.get() |
无 | ✅ 完全保留 | 需要逐字符处理(如词法分析) |
💡 工程建议:优先使用方式 ③。它不需要预先猜测行长度,也不会因为行太长而截断。
19.5 二进制文件读写(补充)
cpp
#include <fstream>
using namespace std;

struct Student {
    char name[20];
    int age;
};

int main() {
    Student s = {"张三", 18};

    // 写二进制
    ofstream ofs("stu.dat", ios::out | ios::binary);
    ofs.write((const char*)&s, sizeof(s));
    ofs.close();

    // 读二进制
    Student s2;
    ifstream ifs("stu.dat", ios::in | ios::binary);
    ifs.read((char*)&s2, sizeof(s2));
    ifs.close();

    return 0;
}
⚠️ 注意 :二进制方式读写要求写入和读取的结构体布局完全一致(同样的编译器、同样的对齐设置)。跨平台/跨编译器时容易出错,工程中应改用序列化方案。
19.6 文件操作检查清单
- ✅ 包含
<fstream>; - ✅ 打开后务必检查
is_open()(尤其是读文件); - ✅
open的路径注意转义 :"C:\\data\\a.txt"或R"(C:\data\a.txt)"; - ✅ 用完显式
close(); - ✅ 明确区分文本/二进制模式,尤其在 Windows 上(文本模式会把
\n转换成\r\n)。
第 20 章 汇编与 DOS 指令入门
20.1 DOS 常用指令
| 指令 | 作用 | 说明 |
|---|---|---|
dir |
展示目录内容 | 列出当前目录下的文件与子目录 |
mount c d:\masm |
将驱动器 c 挂载到 d:\masm |
在 DOSBox 等模拟器中把宿主目录映射为虚拟盘 |
c: |
进入驱动器 c |
切换当前驱动器 |
说明 :这三个指令通常出现在汇编语言学习环境(如 DOSBox + MASM)中。
bat
dir                     :: 查看当前目录
mount c d:\masm         :: 把 d:\masm 挂载为 C 盘
c:                      :: 切到 C 盘
dir                     :: 此时看到的是 masm 目录内容
💡 为什么学汇编要用 DOS 环境? 因为 MASM 等经典汇编器是老式 16 位工具,需要 DOS 环境才能正常运行。现代学习可以用 NASM + 64 位 Linux,或继续用 DOSBox。
💡 学习汇编的价值 :理解 C/C++ 中"未定义行为""指针""函数调用约定""栈帧"这些概念的底层真相。比如本次笔记中
i = i++ + ++i的 GCC/Clang 差异,只有看汇编才能真正明白。
20.2 从 C++ 到汇编:一个小例子
cpp
int add(int a, int b) { return a + b; }

int main() {
    int x = add(2, 3);
    return 0;
}
用 g++ -S -O0 test.cpp 生成的汇编(x64,节选简化):
asm
add:
    push    rbp
    mov     rbp, rsp
    mov     DWORD PTR [rbp-4], edi    ; 形参 a 存入栈
    mov     DWORD PTR [rbp-8], esi    ; 形参 b 存入栈
    mov     eax, DWORD PTR [rbp-4]
    add     eax, DWORD PTR [rbp-8]
    pop     rbp
    ret

main:
    push    rbp
    mov     rbp, rsp
    sub     rsp, 16
    mov     esi, 3          ; 第二个实参
    mov     edi, 2          ; 第一个实参
    call    add
    mov     DWORD PTR [rbp-4], eax
    mov     eax, 0
    leave
ret可以验证前面学过的两件事:
- 形参先入栈 (
[rbp-4]、[rbp-8]),这正是"局部变量住在栈区"的实证; - 实参从右往左准备 (先
mov esi, 3再mov edi, 2),印证了"参数从右至左入栈"。
附录 A 易错点速查表
按主题汇总全文标注 ⚠️ 的坑,考前/写代码前扫一遍。
A.1 字符与字符串
| 坑 | 错误写法 | 正确写法 |
|---|---|---|
| 混淆空格与空字符 | 用 ' '(32)当结束符 |
用 '\0'(0) |
| 字符数组当字符串 | char s[5] = {'a','e','i','o','u'}; |
预留 '\0' 位置,或用 char s[] = "aeiou"; |
| 数组整体赋值 | char s[5]; s = "good"; |
strcpy(s, "good");(并保证空间足够) |
| 空间刚好不够 | char s[5] = "good!"; |
char s[6] = "good!"; 或更长 |
scanf 越界 |
scanf("%s", arr) 不检查长度 |
scanf_s("%s", arr, sizeof(arr)) |
| 野指针读取 | char *p; scanf("%s", p); |
先让 p 指向已分配空间 |
| 修改常量区 | char *p = "abc"; p[0] = 'x'; |
用 char p[] = "abc"; |
gets 不安全 |
gets(s) |
fgets(s, sizeof(s), stdin) |
A.2 指针与内存
| 坑 | 说明 |
|---|---|
| 返回局部变量的指针/引用 | 函数返回后栈空间失效,结果不可预期 |
new[] 用 delete 释放 |
必须用 delete[] |
new 与 free 混用 |
UB,必须成对匹配 |
delete 后继续使用 |
悬空指针,应立刻置为 nullptr |
重复 delete |
double free,崩溃 |
| 未初始化的指针 | 野指针,必须初始化为 nullptr 或合法地址 |
'\\' 路径未转义 |
用 "C:\\a\\b.txt" 或 R"(C:\a\b.txt)" |
A.3 函数
| 坑 | 说明 |
|---|---|
| 默认参数写在左边 | 有默认值的参数必须在形参列表最右边 |
| 声明和定义都写默认值 | 只能写一处,通常在声明处 |
| 重载时使用默认参数 | 容易产生二义性,应避免 |
| 试图用返回值区分重载 | 返回值不参与重载决议 |
Student ob1(); |
被解析为函数声明(most vexing parse) |
| 隐式类型转换 | 单参构造应加 explicit |
A.4 类与对象
| 坑 | 说明 |
|---|---|
| 忘记类外初始化静态成员 | int Person::m_A = 10; 必须写 |
| 静态函数访问非静态成员 | 静态函数没有 this 指针 |
构造函数内 m_age = m_age; |
形参遮蔽成员,必须 this->m_age = m_age; |
| 链式编程返回值类型 | 必须返回引用,返回类名副本会断链 |
| 浅拷贝指针成员 | 会导致 double free,必须深拷贝 |
| 常对象调用普通成员函数 | 常对象只能调用常函数 |
| 基类析构函数非虚 | 通过基类指针 delete 派生类对象会泄漏 |
重写虚函数漏写参数/const |
静默变成"重定义",应加 override |
A.5 运算符与表达式
| 坑 | 说明 |
|---|---|
i = i++ + ++i; |
未定义行为,不要试图"记答案" |
| 有符号/无符号混用 | -1 > 0u 为真 |
unsigned 倒序循环 |
for (unsigned i = n-1; i >= 0; i--) 死循环 |
忘记 virtual |
静态绑定,多态失效 |
<< 重载返回类型 |
必须返回 ostream& 才能链式调用 |
A.6 文件操作
| 坑 | 说明 |
|---|---|
不检查 is_open() |
读取失败时后续操作全是 UB |
ios::out 清空原文件 |
想追加必须用 ios::app |
忘记 close() |
数据可能未刷盘 |
| 文本/二进制模式混用 | Windows 上 \n 会被转换,二进制数据会损坏 |
结语
本文档在原始笔记的基础上做了以下工作:
- 重构章节结构 :按"C 语言 → C++ 面向过程 → C++ 面向对象 → 文件操作与底层"的认知顺序重新编排,标题层级统一为
章 / 节 / 小节。 - 补全缺失前置知识:新增第 0 章(内存四区、栈的生长方向),因为原文中多处结论(静态变量为何是 0、为何不能返回局部变量的引用、默认参数为何必须在右边)都依赖这些前置知识。
- 修正与澄清:对原文中表述不严谨的地方(如"低位常量转为高位量"、"strcpy_s 第二个参数是源串长度"、"枚举成员无需定义变量"等)给出了更准确的说法。
- 补充可运行示例:为每个较难理解的知识点补上了完整、可直接编译运行的代码示例,并标注了预期输出。
- 归位图片资料:把原文中散落的 18 张截图按主题重新归类,并在图旁补充了文字说明。
- 补充工程实践建议 :如
explicit、override、虚析构函数、三/五法则、nullptr替代NULL等 C++11 之后的现代写法。
学习建议:本文档更适合作为复习提纲 + 速查手册 使用。第一遍通读把握体系,之后遇到具体问题再回来查阅对应章节。代码示例建议亲手敲一遍,尤其是"易错点"部分------很多坑只有在真正踩到时才会形成肌肉记忆。