🔥 星光编译者 · 个人主页
📚 学习专栏: 《C/C++ 成长笔记》 · 《Linux 实践手册》 · 《数据结构与算法》
🌄 向云端飞扬,编译属于自己的代码星河。
☕ 写在开篇
你好,这里是 星光编译者。
这里记录我在 C/C++、Linux、数据结构与算法 学习中遇到的真实问题、亲手验证过的代码,以及那些容易被忽略的实现细节。
比起简单罗列结论,我更愿意从问题出发,把一个知识点的来由讲清楚,把"为什么会这样"和"应该怎样解决"说明白,让每一次踩坑都沉淀成可以复用的经验。
如果这篇记录能帮你少绕一点路,或让某个模糊的地方忽然变得清晰,那么这次分享便有了意义。愿我们在一次次阅读、编译与调试中稳步向前,慢慢搭起属于自己的技术世界。
🔥 本文定位 :把
sizeof、strlen、数组名、二维数组和多级指针放进同一套"类型---步长---边界"分析框架,逐题拆解课程中的经典笔试题。💡 学习目标 :能区分对象大小与字符串长度;准确判断数组名何时表示整个数组、何时转换为首元素地址;能从指针目标类型推出
+1的跨度;能识别题目中的约束违反、未定义行为和平台相关假设。📌 平台说明 :课程题目多按 x86 环境、
sizeof(int) == 4、指针大小为 4 字节来讨论。本文会同时给出常见课程答案和 ISO C 语义下的边界。打印sizeof结果统一使用%zu。
文章目录
- 一、这些题真正考的不是"算地址"
- [二、sizeof 与 strlen:一个看对象,一个找终止符](#二、sizeof 与 strlen:一个看对象,一个找终止符)
- 三、数组名的三条核心规则
- [四、一维数组 sizeof 题逐项拆解](#四、一维数组 sizeof 题逐项拆解)
- [五、字符数组与 strlen:先证明它是字符串](#五、字符数组与 strlen:先证明它是字符串)
- 六、二维数组:首元素是一整行
- 七、七道指针运算题完整解析
- 八、笔试题的稳定解题流程
- 九、高频问答与动手练习
- 总结
一、这些题真正考的不是"算地址"
看到 &a + 1、*--*++cpp + 3 这样的表达式,很多人的第一反应是画地址、数星号。这样做偶尔能猜对,但一旦数组维度、指针层级或平台发生变化,就很容易失去依据。
更稳定的顺序是:
- 写出表达式当前的完整类型;
- 判断它处在
sizeof、一元&还是普通表达式中; - 若发生指针算术,确定目标类型与步长;
- 检查运算是否仍位于允许的数组对象范围内;
- 最后才读取值、计算结果或分析副作用。
例如:
c
int a[4] = {1, 2, 3, 4};a 在多数表达式中转换为 int *,因此 a + 1 跨过一个 int;&a 的类型是 int (*)[4],因此 &a + 1 跨过整个 int[4]。二者打印出的起始地址可能相同,类型和步长却完全不同。
这正是本讲的主线:地址值只告诉我们"从哪里开始",类型还决定"怎样解释"和"一步走多远"。
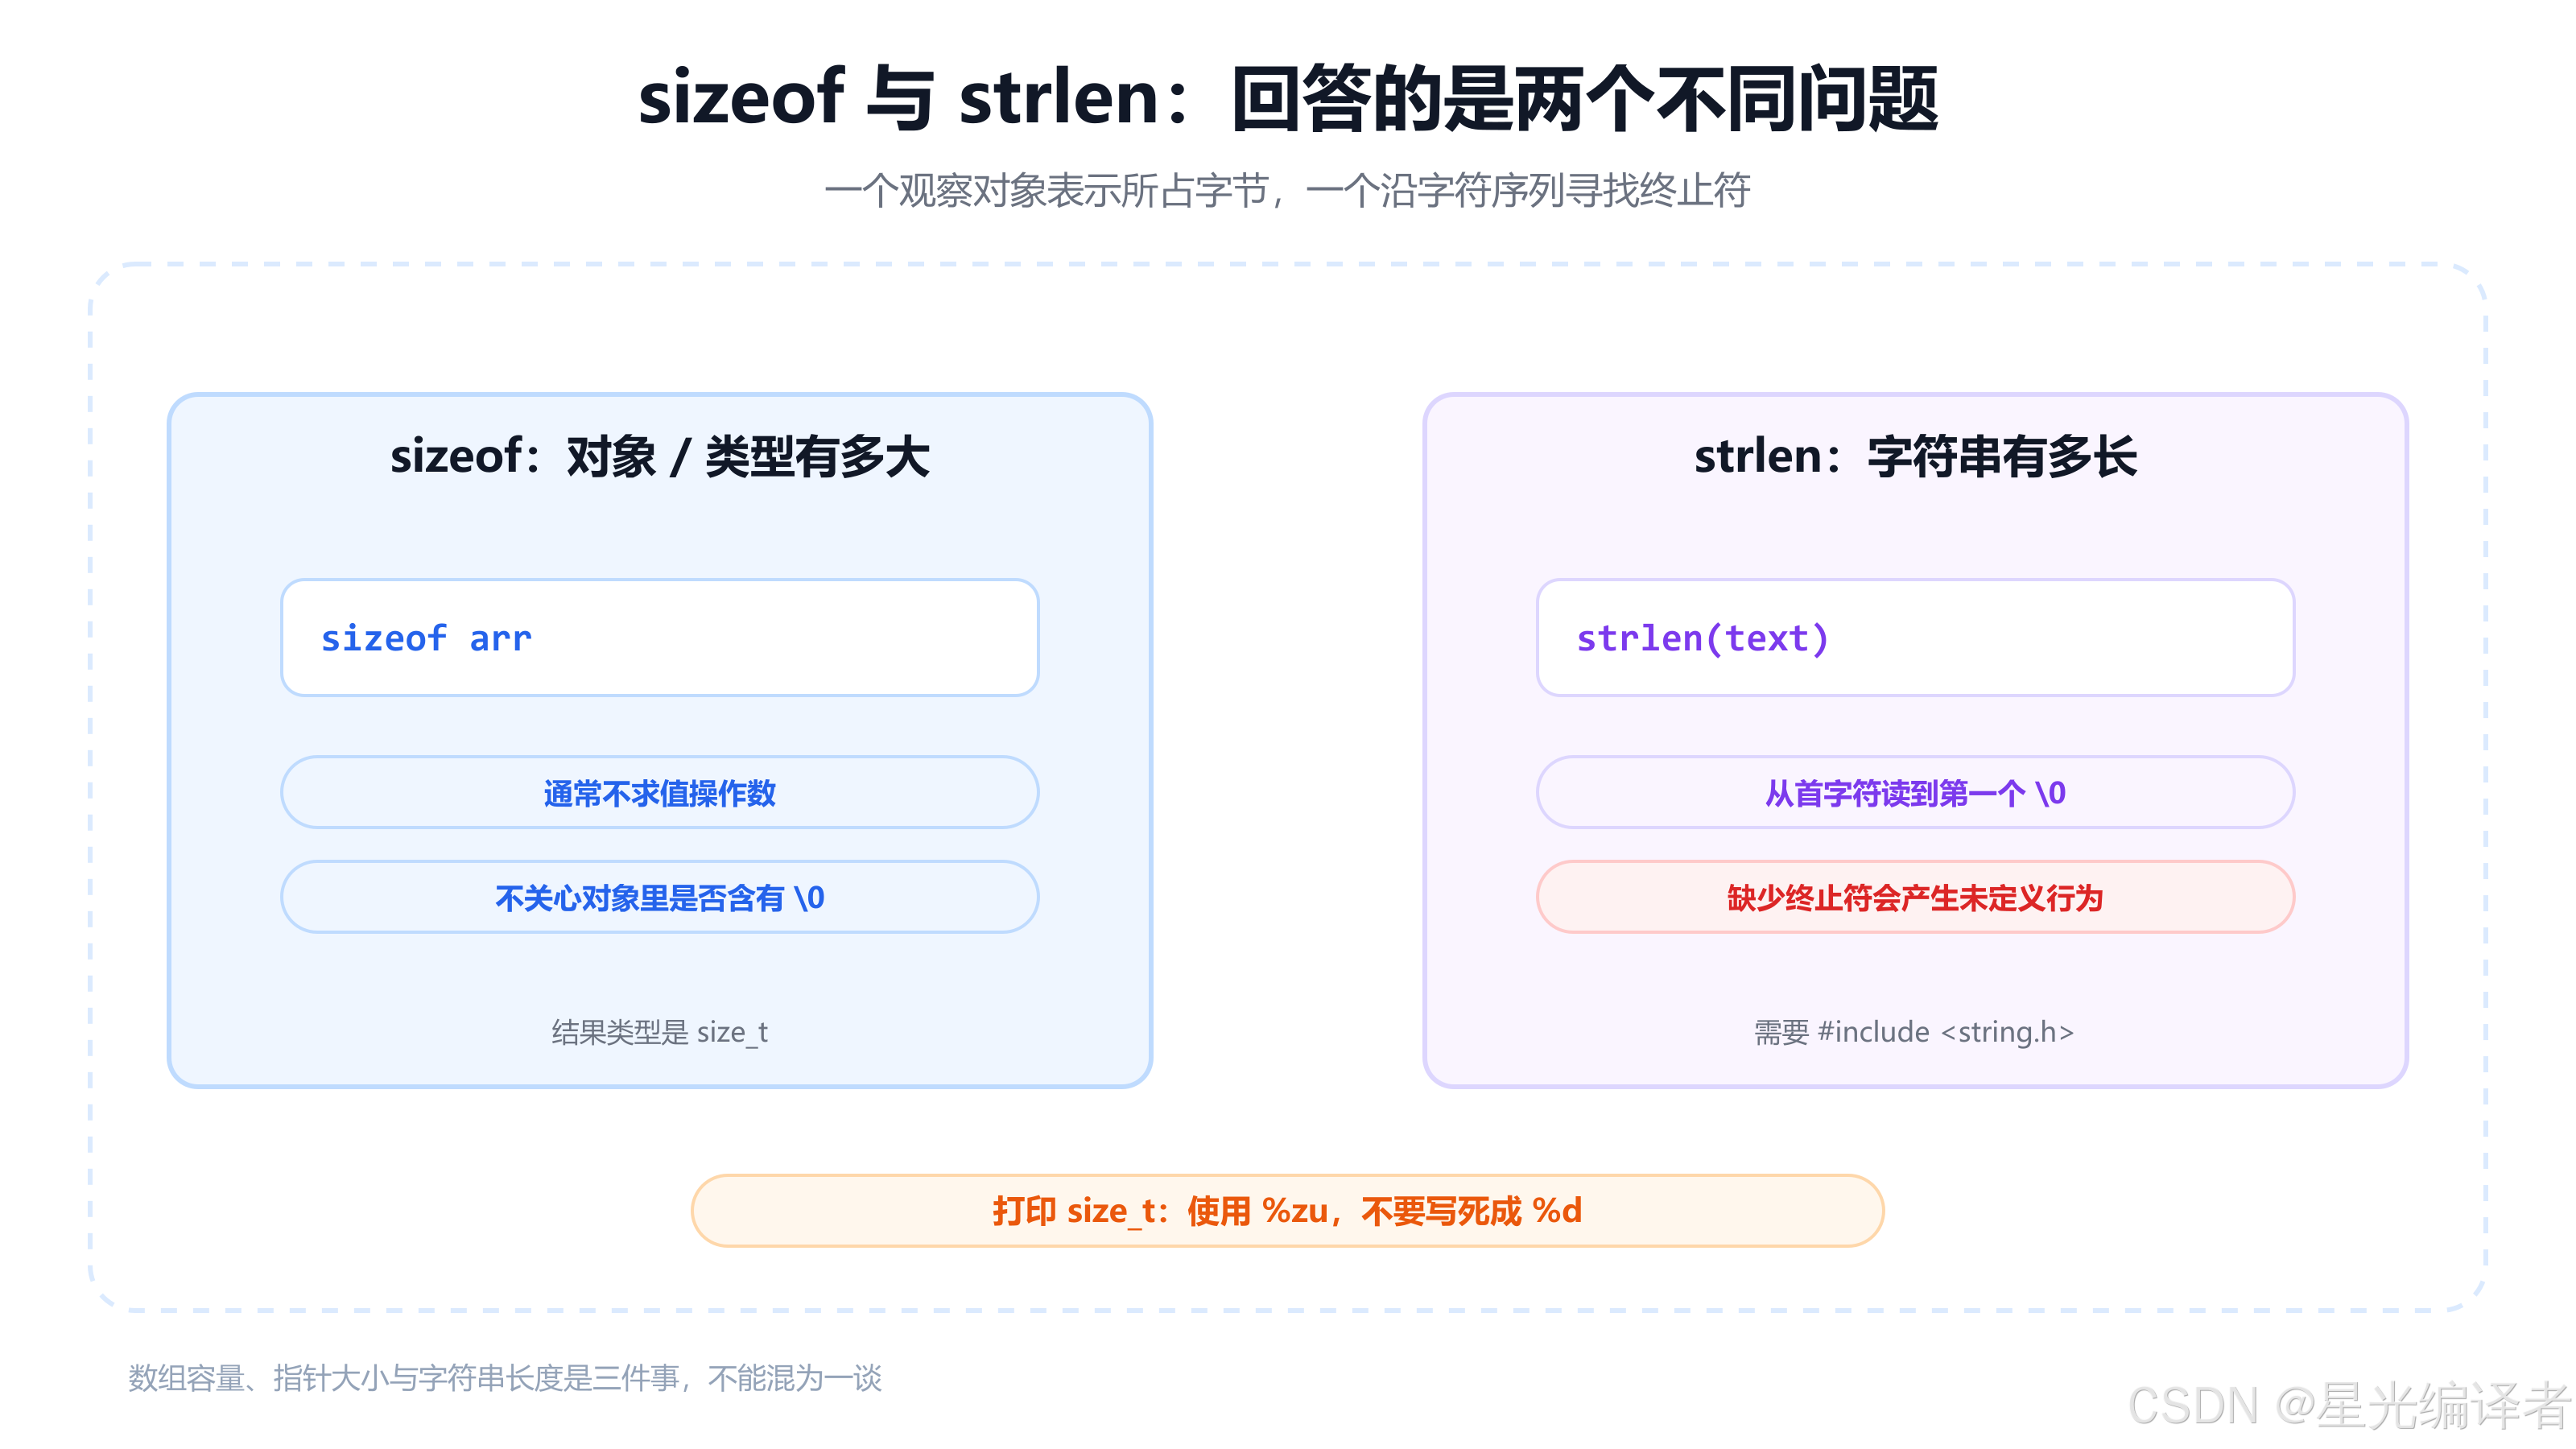
二、sizeof 与 strlen:一个看对象,一个找终止符
2.1 sizeof 是运算符
sizeof 用来得到对象或类型所占的字节数,结果类型为 size_t:
c
#include <stdio.h>

int main(void)
{
    int value = 10;

    printf("%zu\n", sizeof(value));
    printf("%zu\n", sizeof value);
    printf("%zu\n", sizeof(int));
    return 0;
}
当操作数是表达式时,圆括号不是必需的;当操作数写成类型名时,必须使用 sizeof(type)。
sizeof 的关注点是类型与对象表示,不是对象里保存的数值。普通非 VLA 表达式通常不会被求值:
c
int n = 7;
size_t bytes = sizeof(n++);

printf("%d %zu\n", n, bytes); /* n 仍然是 7 */
这里要保留一个标准层面的例外:若操作数的类型是变长数组 VLA,计算大小可能需要在运行期求值。因此,"sizeof 永远在编译期完成、永远不求值"并不是完整表述。
2.2 strlen 是库函数
strlen 的声明位于 <string.h>:
c
size_t strlen(const char *str);它从 str 指向的位置开始逐字符向后读取,直到遇到第一个空字符 \0,返回此前字符的数量。终止符本身不计入长度。
c
#include <stdio.h>
#include <string.h>

int main(void)
{
    char text[] = "abcdef";

    printf("容量:%zu\n", sizeof text);  /* 7,包含 \0 */
    printf("长度:%zu\n", strlen(text)); /* 6,不包含 \0 */
    return 0;
}
2.3 最容易混淆的三个量
c
char text[] = "abcdef";
char *pointer = text;
在常见 64 位平台上:
| 表达式 | 含义 | 常见结果 |
|---|---|---|
sizeof text |
整个字符数组的容量 | 7 |
sizeof pointer |
指针变量本身的大小 | 8 |
strlen(text) |
第一个 \0 之前的字符数 |
6 |
32 位平台上的指针大小通常为 4,因此不能把"指针永远是 4 字节"或"指针永远是 8 字节"当成语言规则。
2.4 打印结果时为什么要用 %zu
sizeof 与 strlen 都返回 size_t。正确的格式说明符是 %zu:
c
printf("%zu\n", sizeof(int));
printf("%zu\n", strlen("abc"));
用 %d 读取 size_t 参数会造成格式与实参类型不匹配。即使小数值在某个平台上"看起来正常",也不应依赖这种偶然表现。
三、数组名的三条核心规则
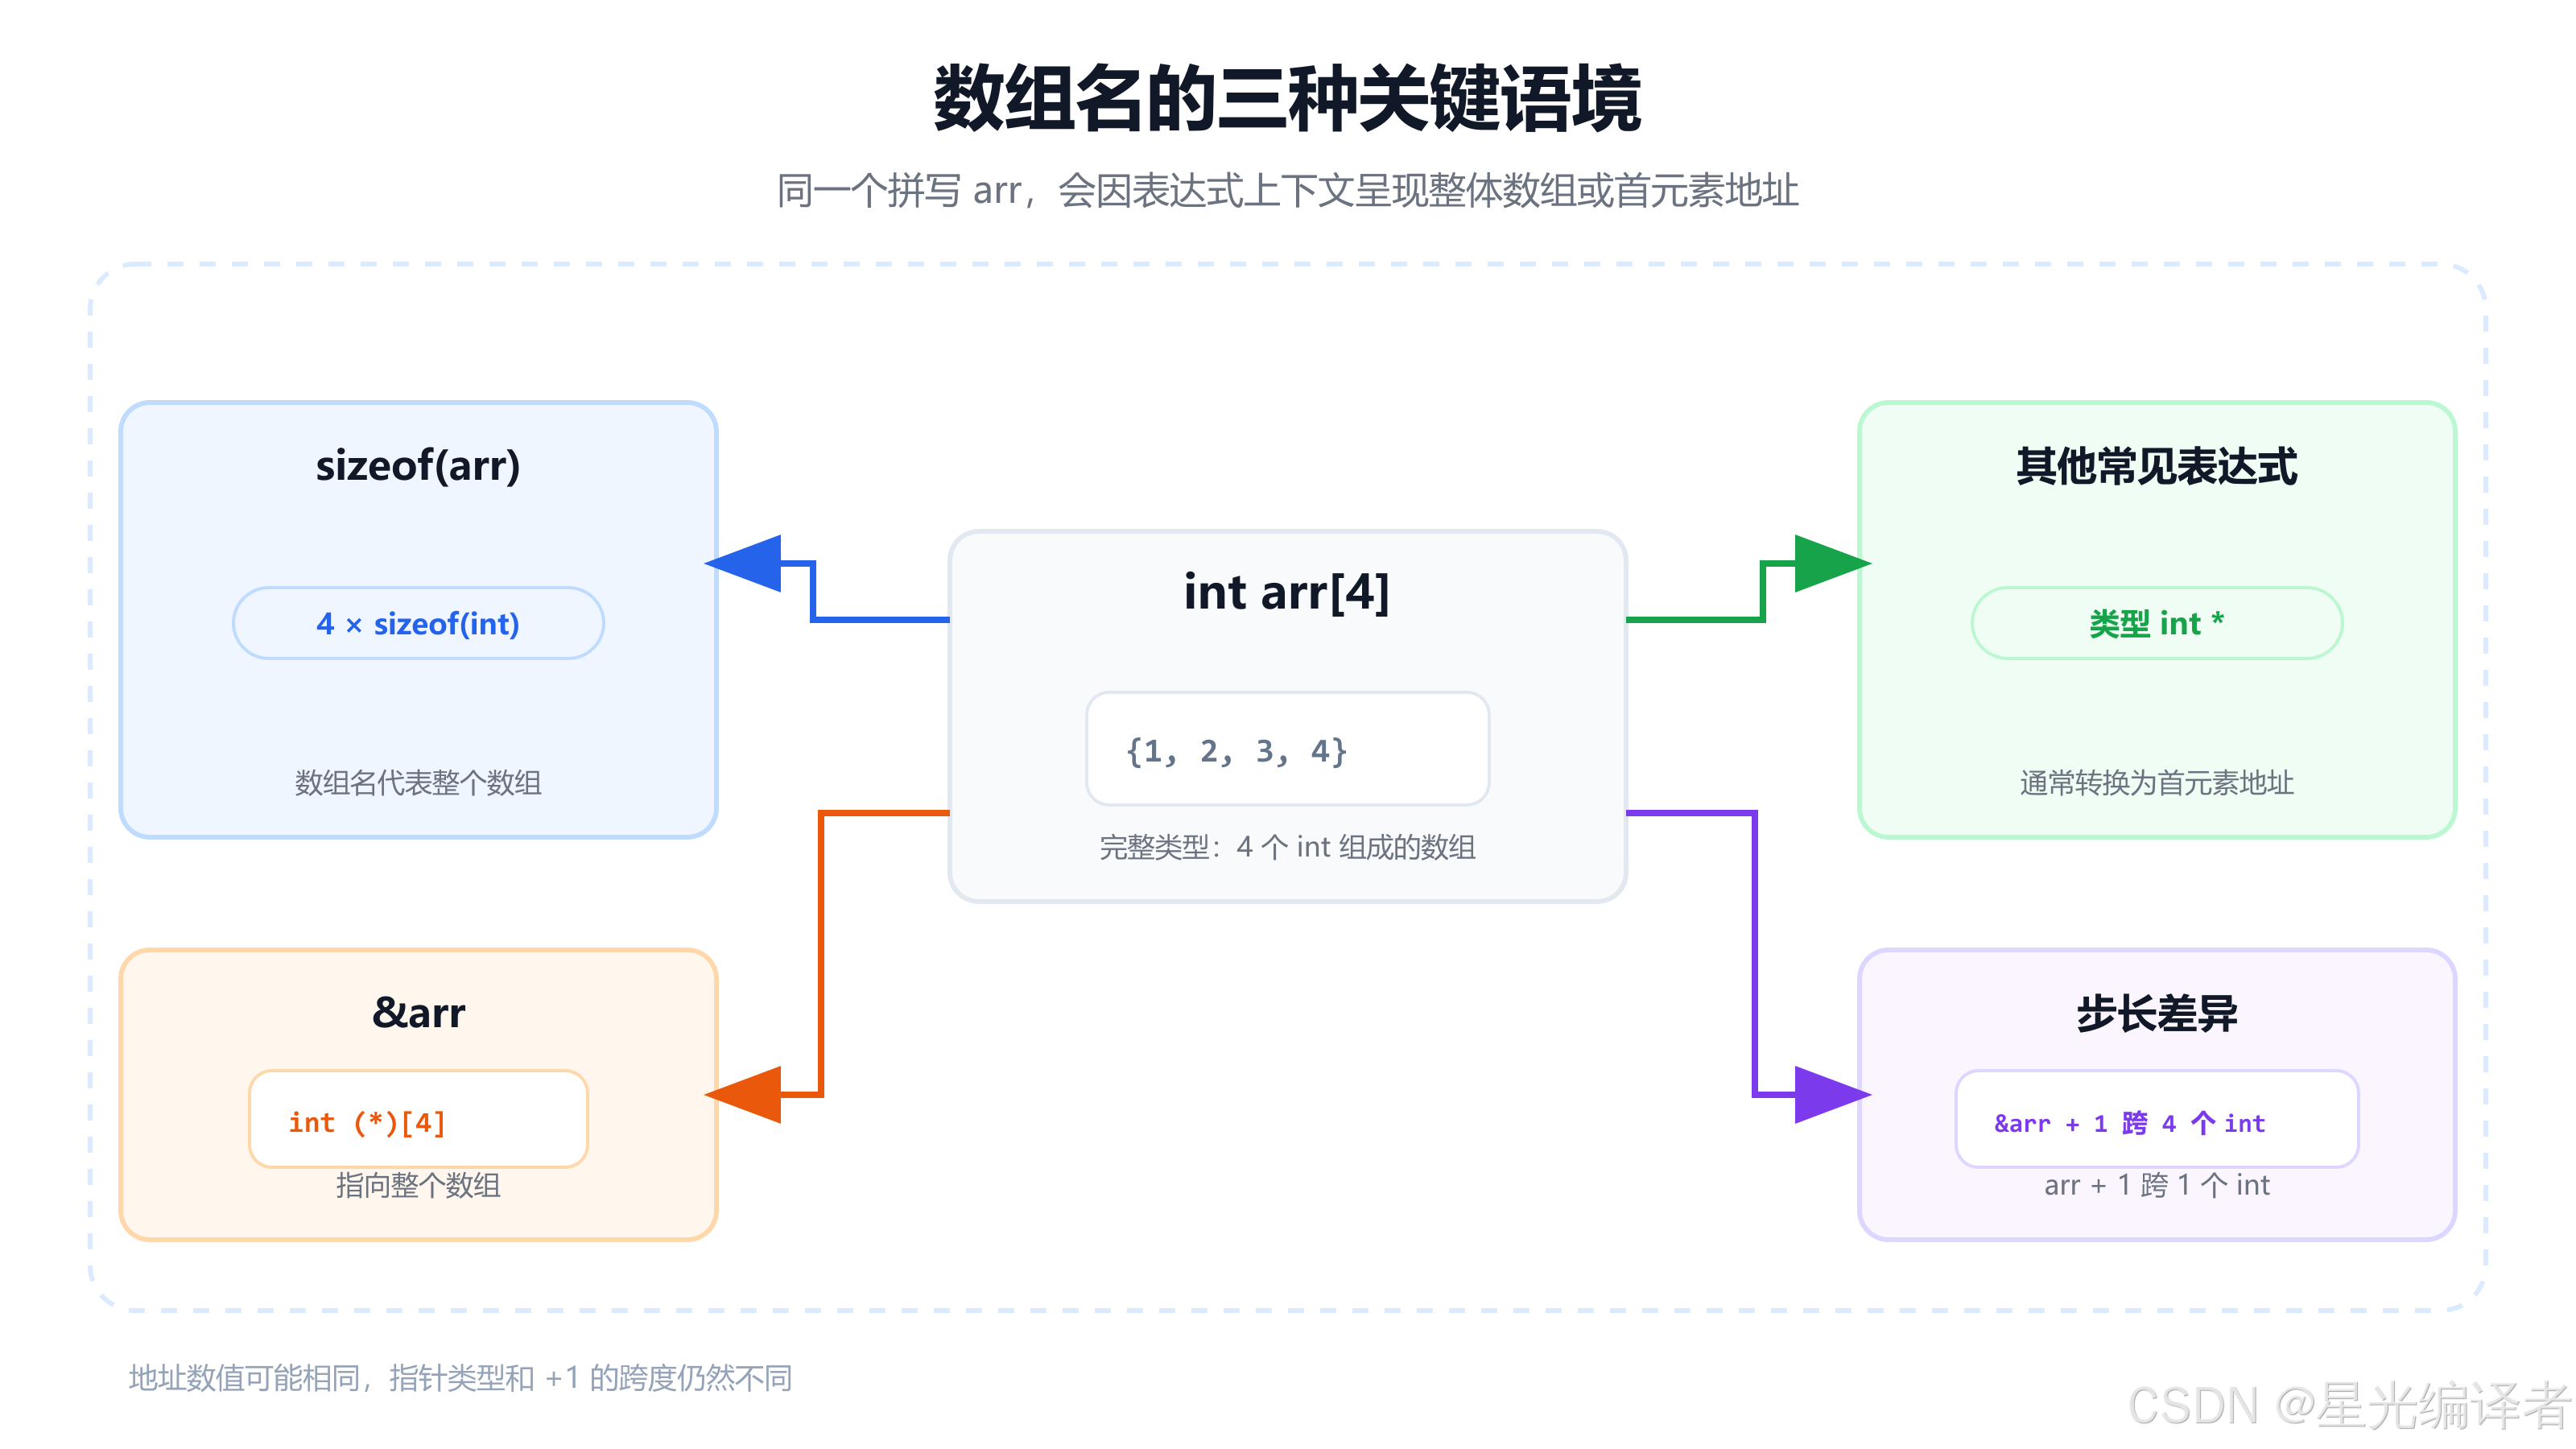
为了处理本讲的所有题目,可以先记住这组实用规则:
- 在
sizeof(数组名)中,数组名表示整个数组,得到整个数组的字节数; - 在
&数组名中,取得的是整个数组的地址,结果是"数组指针"; - 在多数其他表达式中,数组表达式转换为指向首元素的指针。
以 int a[4] 为例:
c
int a[4] = {1, 2, 3, 4};| 表达式 | 类型 | 说明 |
|---|---|---|
a(普通表达式中) |
int * |
指向 a[0] |
&a[0] |
int * |
明确取得首元素地址 |
&a |
int (*)[4] |
指向整个数组 |
*(&a) |
int[4] |
解引用后又得到整个数组左值 |
注意:"起始地址相同"不能推出"类型相同"。
c
a + 1;   /* 跨过 1 个 int */
&a + 1;  /* 跨过 1 个 int[4],也就是整个数组 */
严格说,数组到指针的转换还有字符串字面量用于数组初始化等语境需要单独理解;但在本讲的 sizeof 与指针算术题中,上述三条已经足够建立稳定判断。
四、一维数组 sizeof 题逐项拆解
课程题目:
c
int a[] = {1, 2, 3, 4};

printf("%zu\n", sizeof(a));
printf("%zu\n", sizeof(a + 0));
printf("%zu\n", sizeof(*a));
printf("%zu\n", sizeof(a + 1));
printf("%zu\n", sizeof(a[1]));
printf("%zu\n", sizeof(&a));
printf("%zu\n", sizeof(*&a));
printf("%zu\n", sizeof(&a + 1));
printf("%zu\n", sizeof(&a[0]));
printf("%zu\n", sizeof(&a[0] + 1));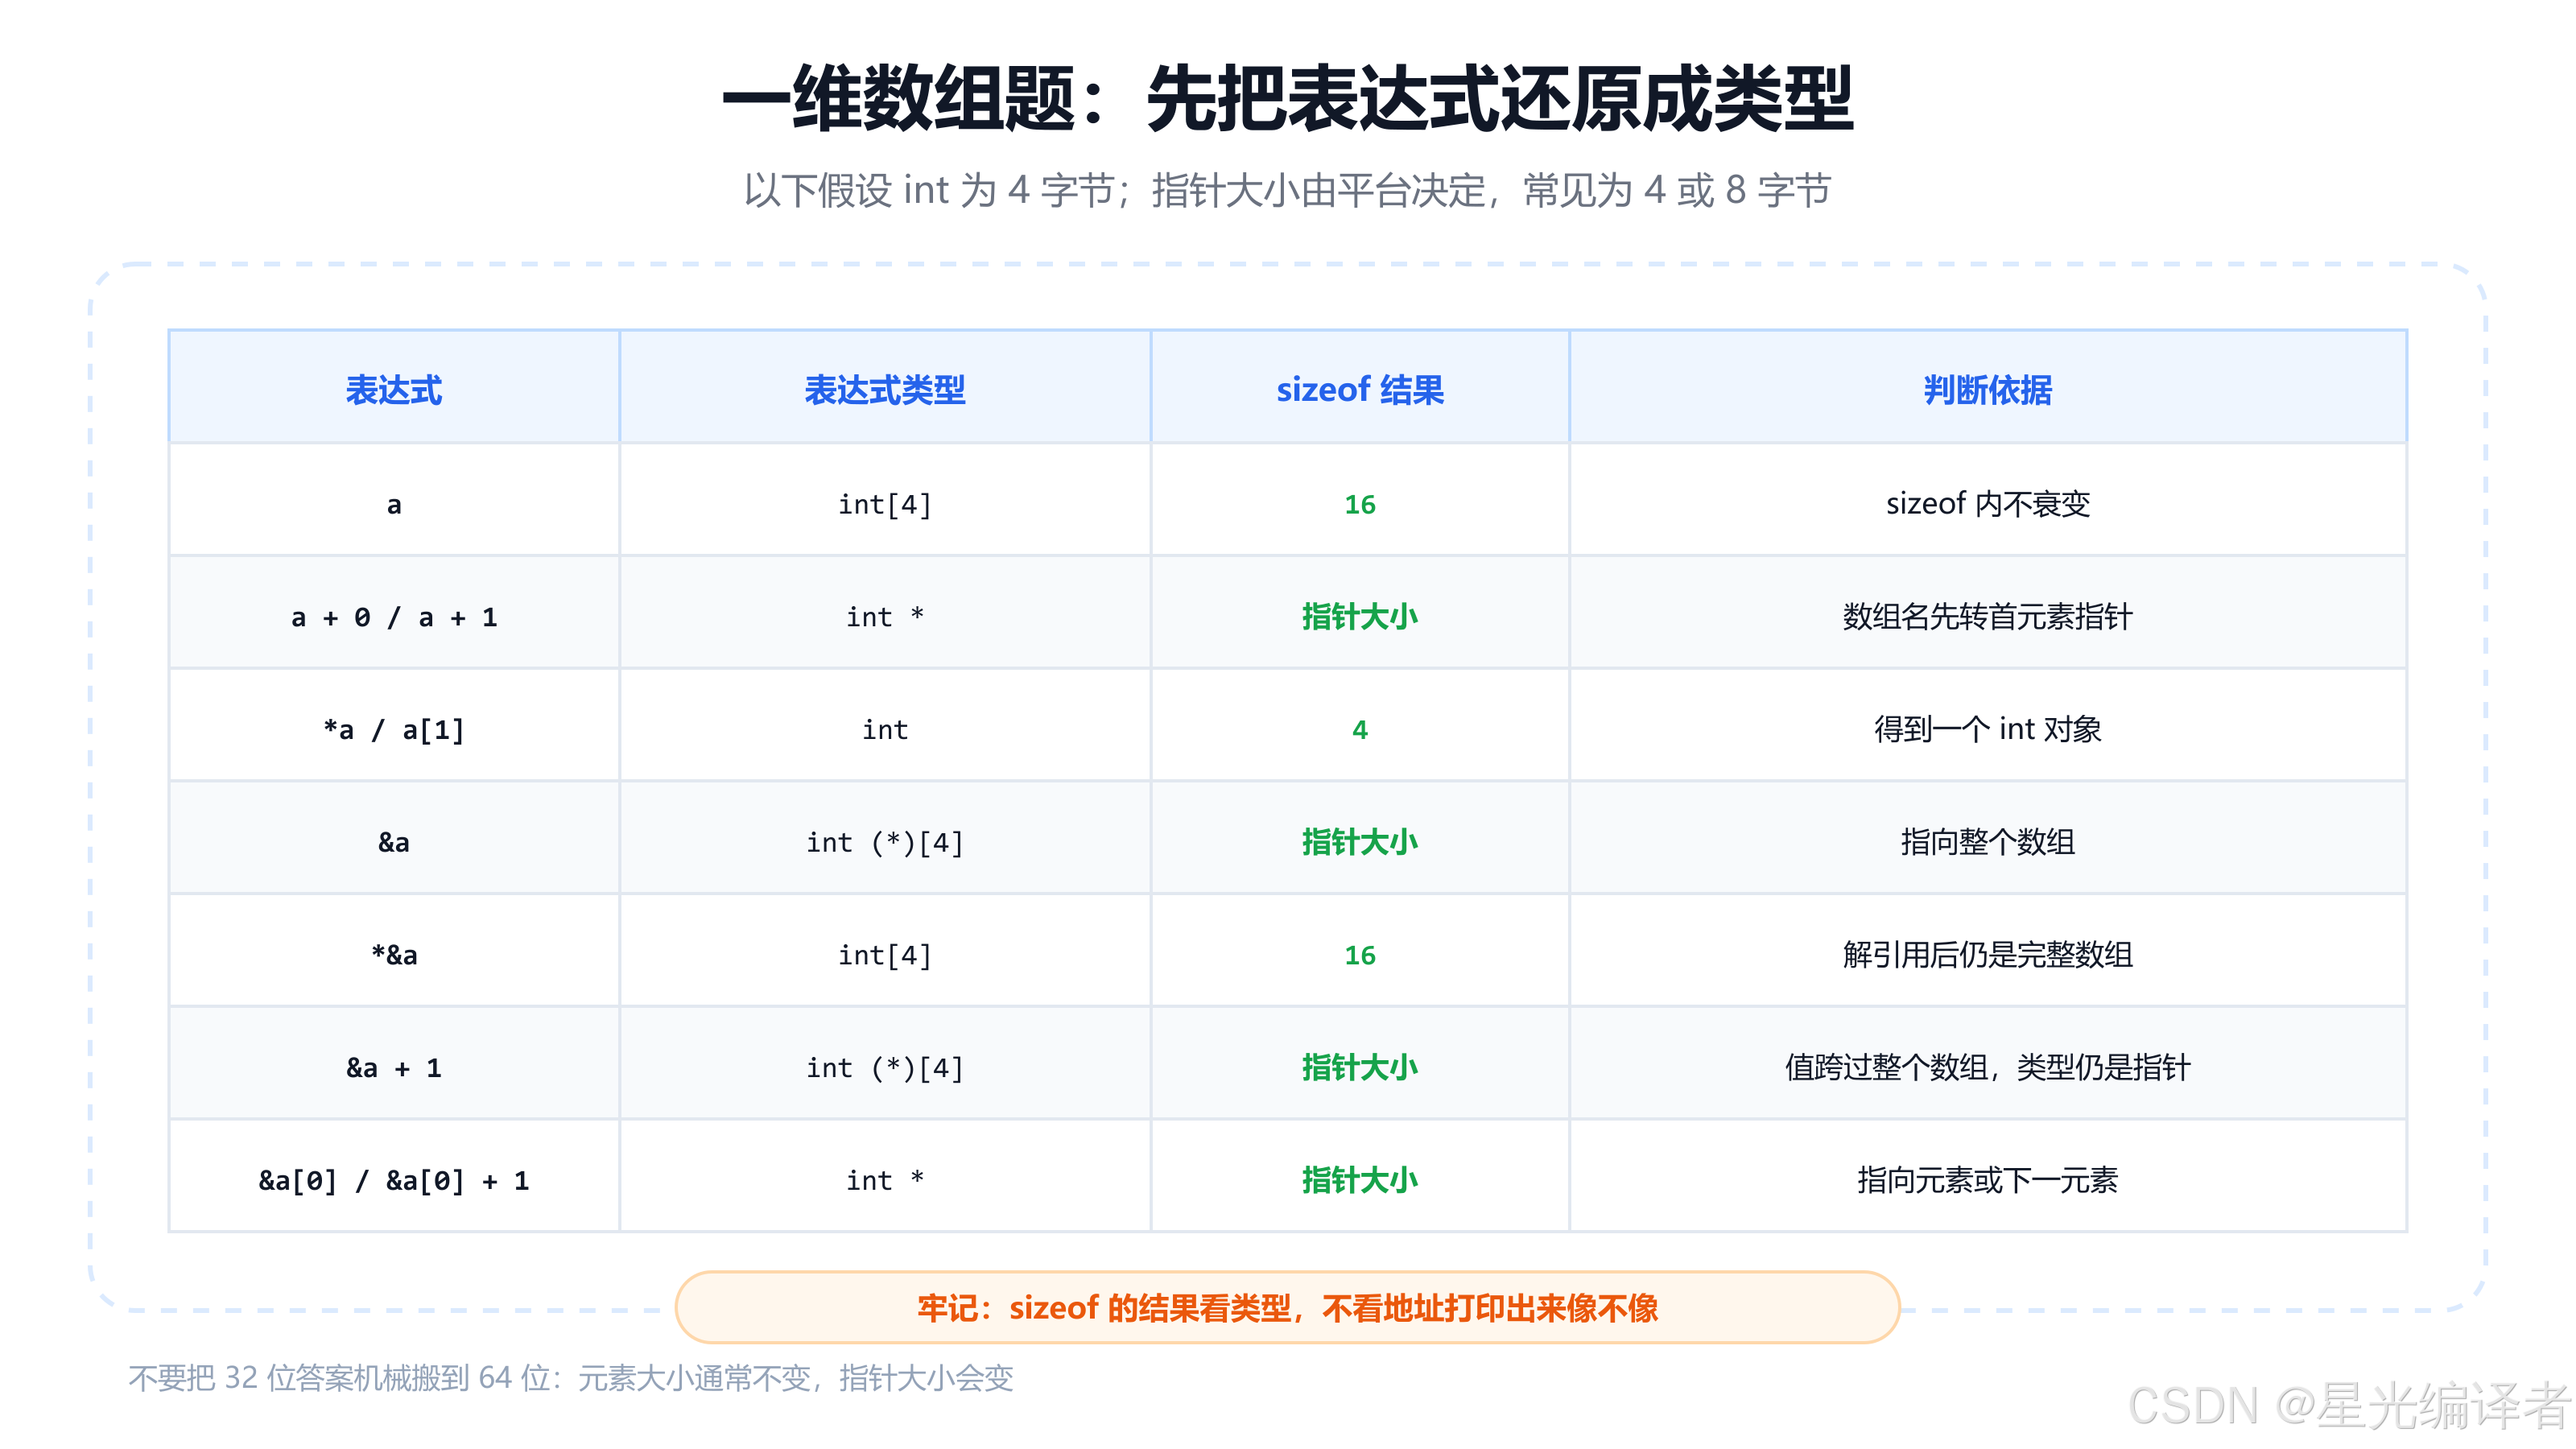
假设 sizeof(int) == 4,逐项分析如下:
| 表达式 | 进入 sizeof 前的关键类型 |
结果 |
|---|---|---|
a |
int[4],没有衰变 |
16 |
a + 0 |
int * |
指针大小 |
*a |
int |
4 |
a + 1 |
int * |
指针大小 |
a[1] |
int |
4 |
&a |
int (*)[4] |
指针大小 |
*&a |
int[4] |
16 |
&a + 1 |
int (*)[4] |
指针大小 |
&a[0] |
int * |
指针大小 |
&a[0] + 1 |
int * |
指针大小 |
这里有两个高频误区。
第一,sizeof(&a + 1) 计算的是表达式结果这个指针的大小,不是它跨过的字节数。指针值向后移动了一个数组,但类型仍是指针。
第二,*&a 中先取整个数组的地址,再解引用,结果仍是数组本身。这个数组直接作为 sizeof 的操作数,不发生首元素指针转换,因此结果仍是 16。
五、字符数组与 strlen:先证明它是字符串
5.1 没有 \0 的字符数组不是 C 字符串
c
char arr[] = {'a', 'b', 'c', 'd', 'e', 'f'};这个数组恰好有 6 个元素,内部没有空字符。于是:
c
sizeof(arr);     /* 6 */
sizeof(arr + 0); /* 指针大小 */
sizeof(*arr);    /* 1 */
sizeof(arr[1]);  /* 1 */
sizeof(&arr);    /* 指针大小 */
以上都只依赖类型,不要求数组是字符串。但下面的调用不同:
c
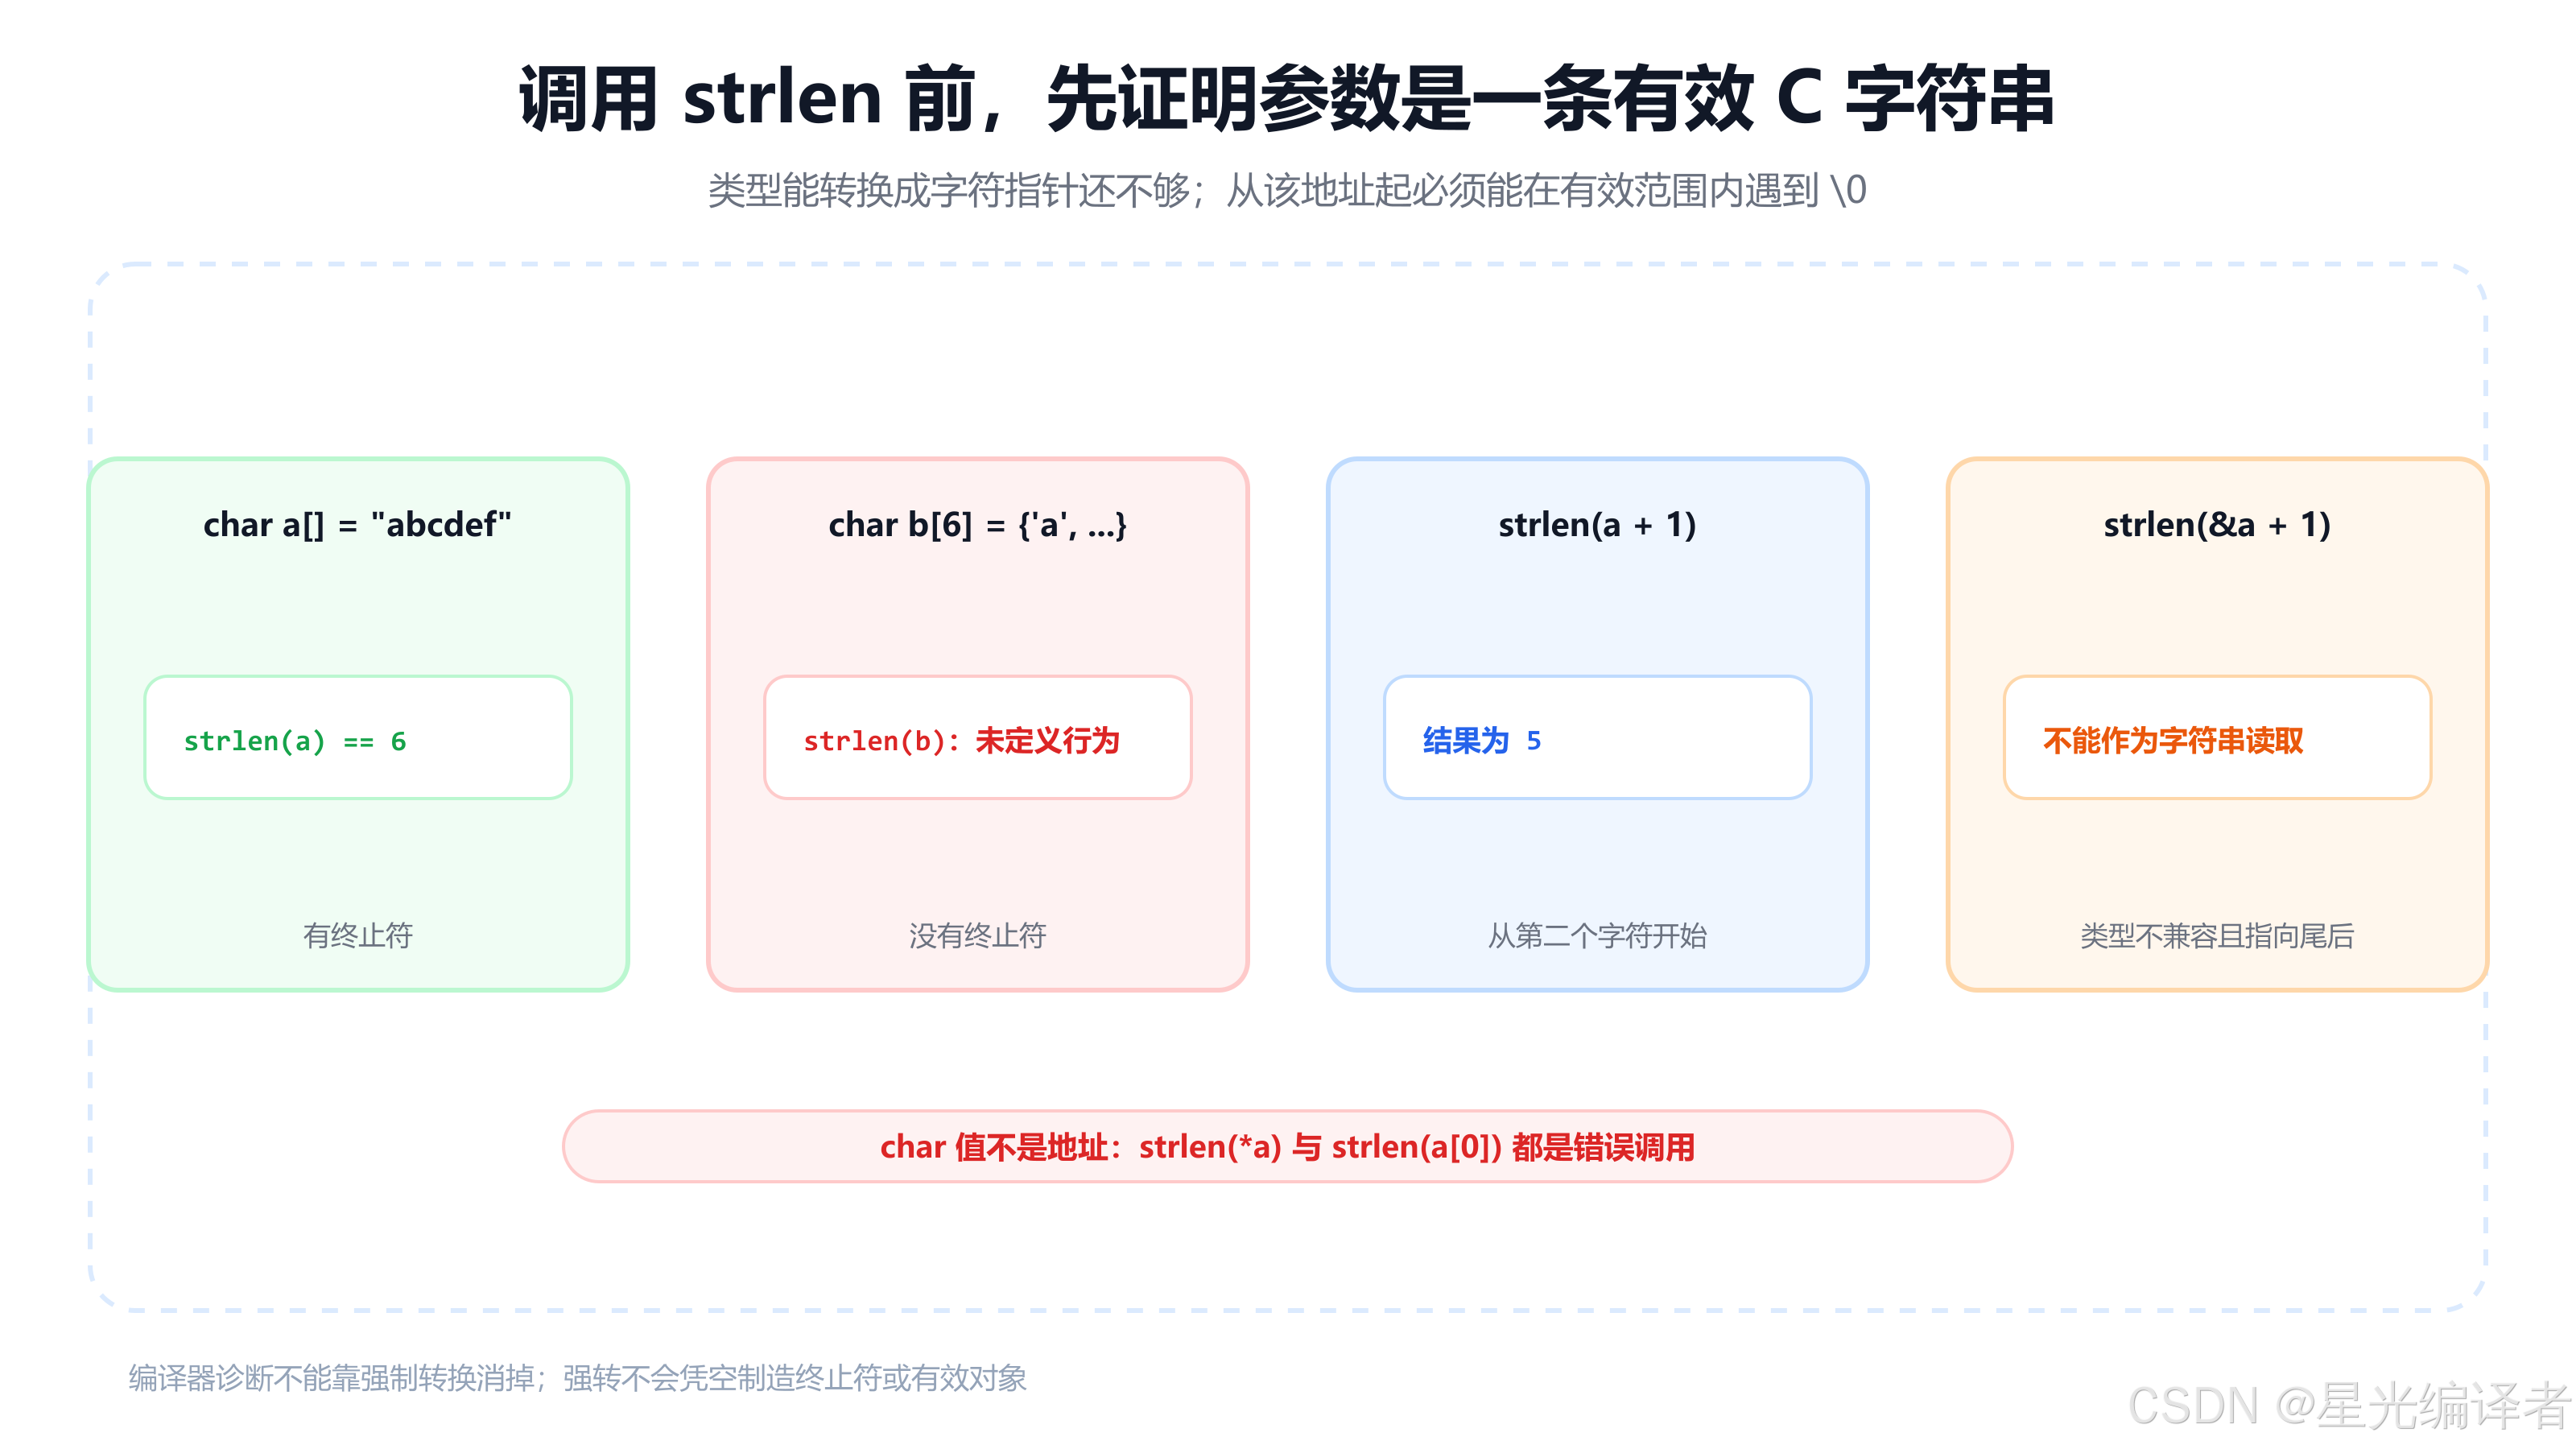
strlen(arr); /* 未定义行为 */strlen 会继续寻找 \0,一旦读取越过数组边界,行为就不再由 C 语言定义。结果可能是一个看似合理的数字,也可能崩溃;不能把某次运行结果当作答案。
5.2 字符串初始化会自动补终止符
c
char arr[] = "abcdef";此时数组包含 7 个字符:
text
'a' 'b' 'c' 'd' 'e' 'f' '\0'因此:
| 表达式 | 结果或结论 |
|---|---|
sizeof(arr) |
7 |
strlen(arr) |
6 |
strlen(arr + 0) |
6 |
strlen(&arr[0] + 1) |
5 |
5.3 哪些 strlen 调用本身就不成立
课程把多种表达式放进 strlen,目的正是检查我们是否分清"字符"和"字符地址":
c
strlen(*arr);   /* *arr 是 char,不是指针 */
strlen(arr[1]); /* arr[1] 也是 char */
strlen 需要 const char *。把字符值 'a' 当地址传入会触发编译器诊断;若强行绕过诊断并执行,通常会访问无效地址。
下面两个也不能当作正确的字符串调用:
c
strlen(&arr);     /* 类型是 char (*)[7],与 const char * 不兼容 */
strlen(&arr + 1); /* 指向整个数组之后,那里不是可读字符串起点 */某些实现中,&arr 与 arr 的数值地址相同,于是带警告编译的代码可能碰巧输出 6。但这不能改变参数类型不兼容的事实。&arr + 1 更已到达数组尾后,不能从那里继续读字符串。
5.4 字符指针版本
c
const char *p = "abcdef";p 是指针变量,因此:
| 表达式 | 结果或结论 |
|---|---|
sizeof(p) |
指针大小 |
sizeof(p + 1) |
指针大小 |
sizeof(*p) |
1 |
sizeof(p[0]) |
1 |
sizeof(&p) |
指针大小 |
strlen(p) |
6 |
strlen(p + 1) |
5 |
strlen(*p)、strlen(p[0]) |
参数类型错误 |
strlen(&p)、strlen(&p + 1) |
把指针对象的字节误当字符串,类型不兼容且行为不可靠 |
一句话总结:sizeof 可以只看类型;strlen 必须拿到有效字符地址,还必须保证从该地址起能在对象范围内遇到 \0。
六、二维数组:首元素是一整行
c
int a[3][4] = {0};a 是"含 3 个元素的数组",而每个元素又是 int[4]。因此它的首元素不是一个 int,而是第一整行 a[0]。
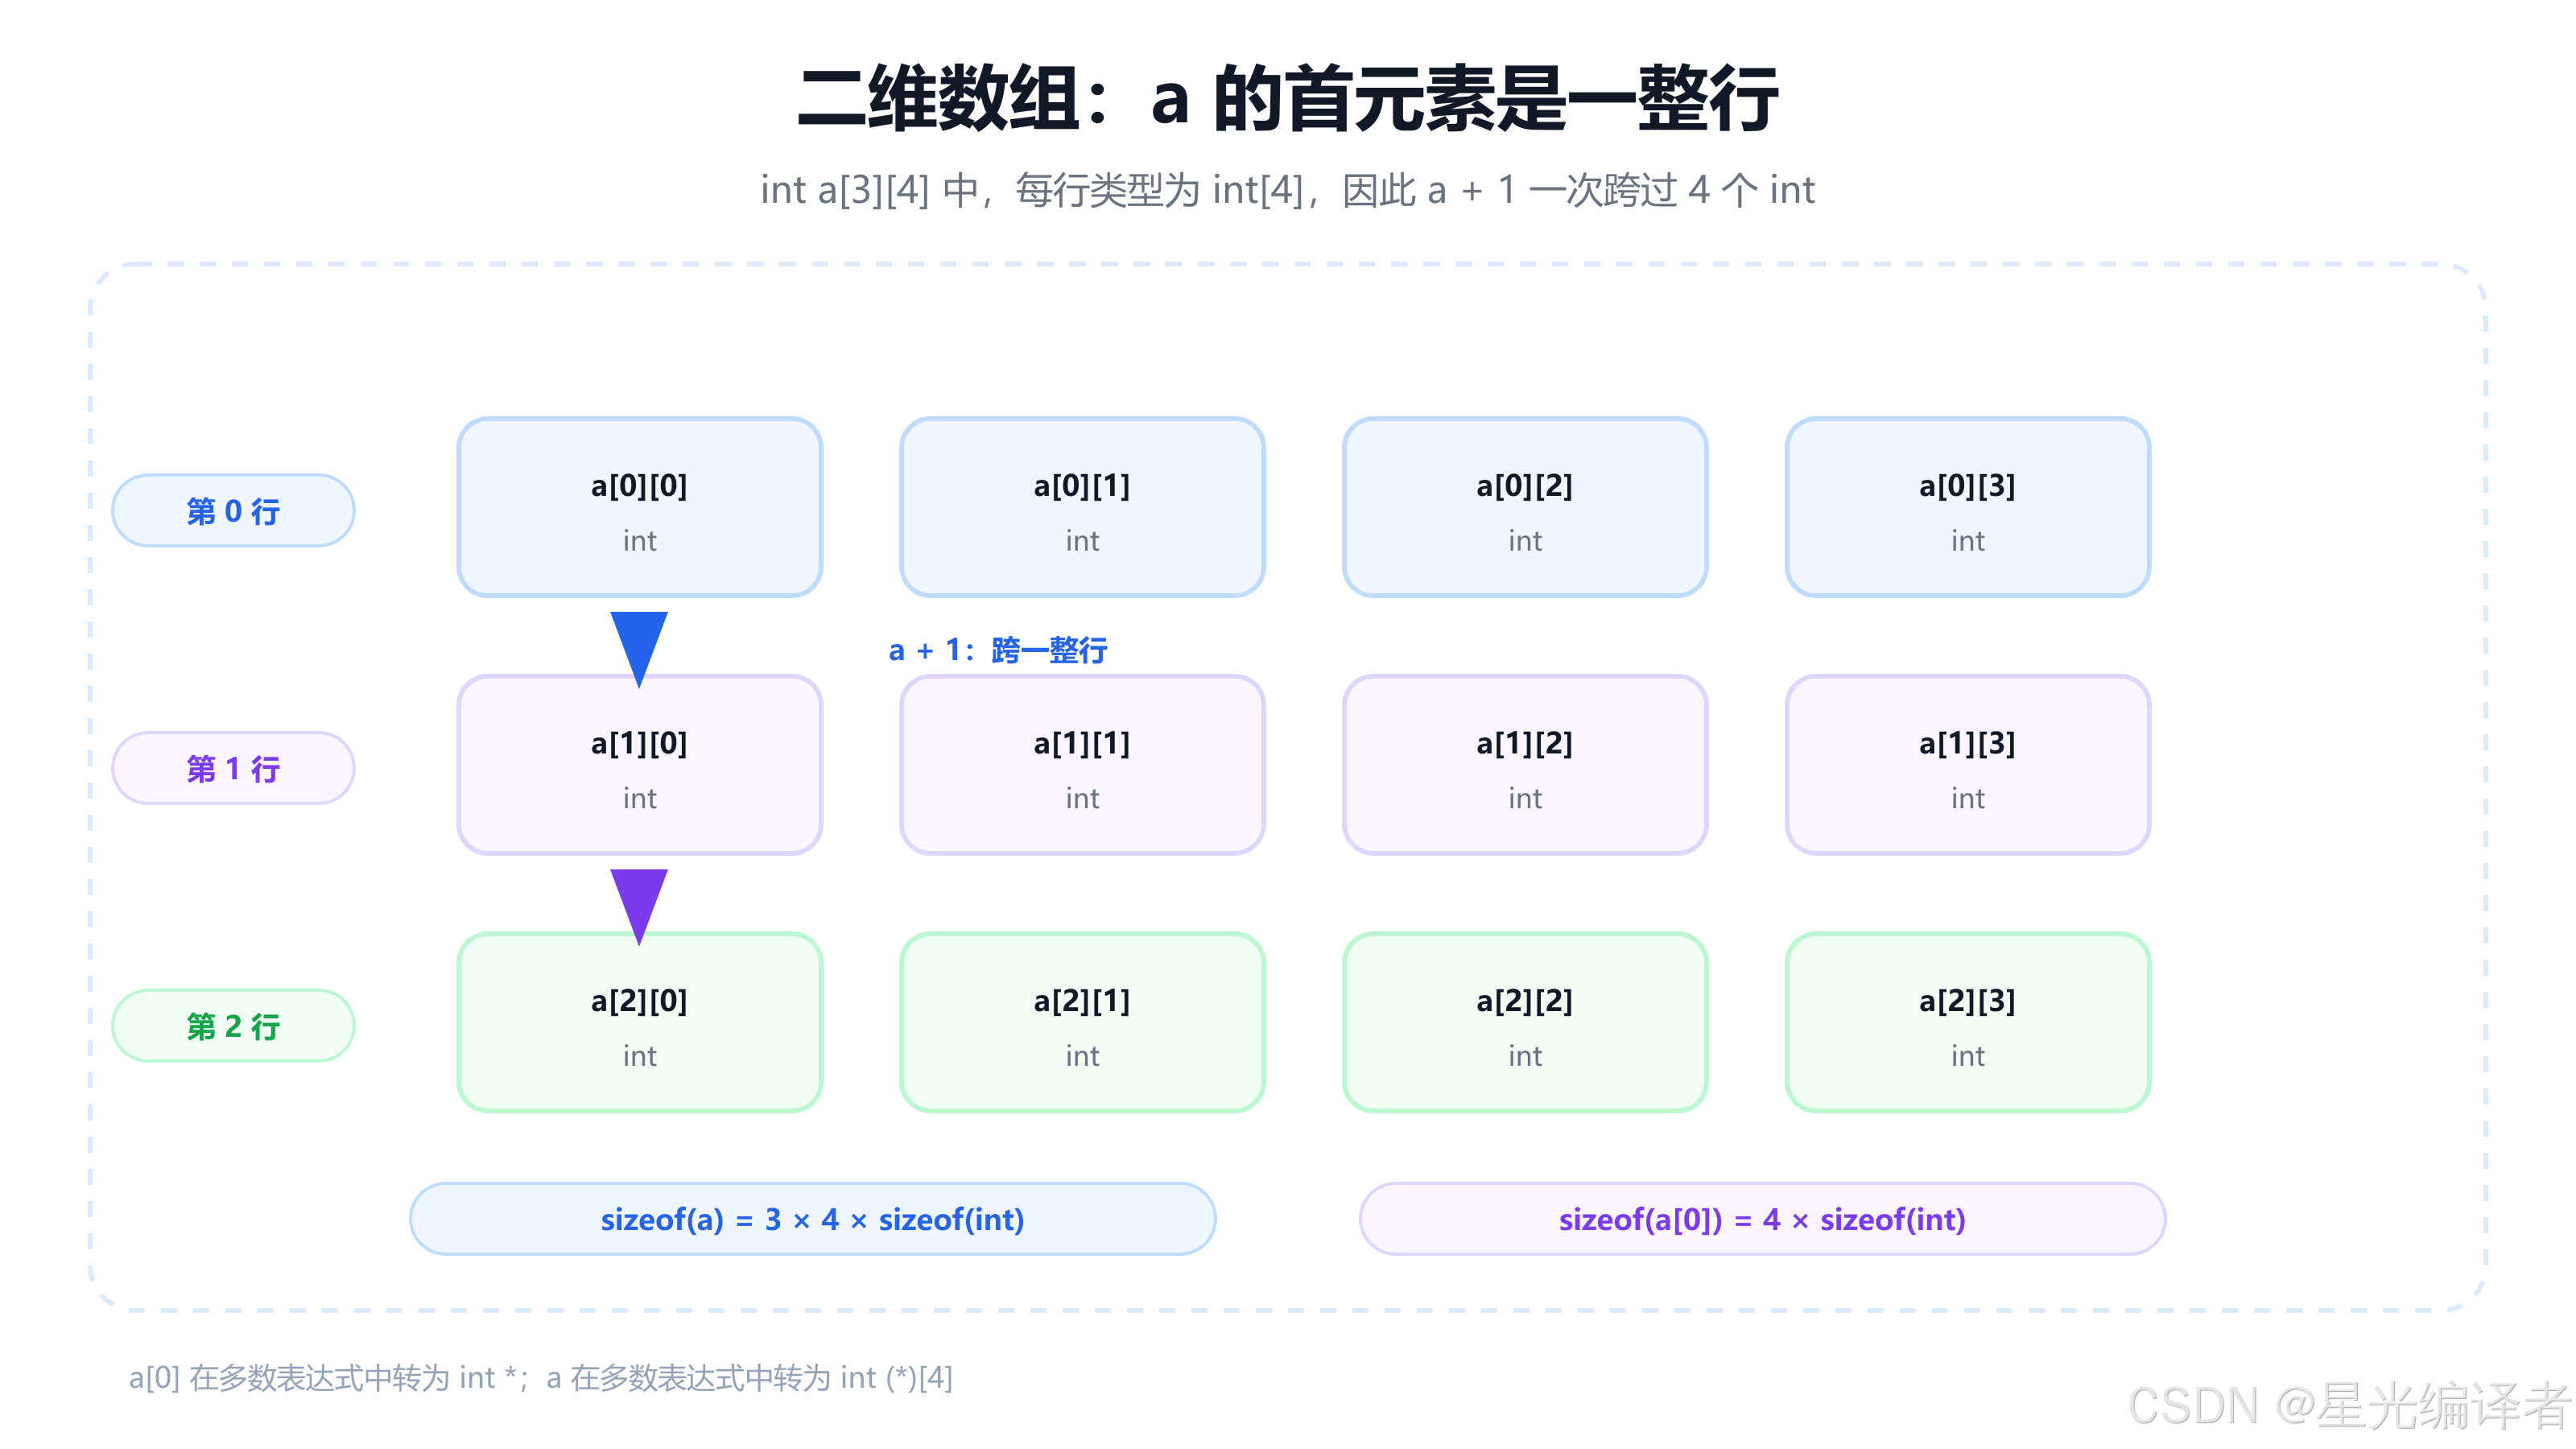
假设 sizeof(int) == 4:
| 表达式 | 类型分析 | 结果 |
|---|---|---|
sizeof(a) |
整个 int[3][4] |
48 |
sizeof(a[0][0]) |
一个 int |
4 |
sizeof(a[0]) |
一行 int[4] |
16 |
sizeof(a[0] + 1) |
int * |
指针大小 |
sizeof(*(a[0] + 1)) |
int |
4 |
sizeof(a + 1) |
int (*)[4] |
指针大小 |
sizeof(*(a + 1)) |
第二行 int[4] |
16 |
sizeof(&a[0] + 1) |
int (*)[4] |
指针大小 |
sizeof(*(&a[0] + 1)) |
第二行 int[4] |
16 |
sizeof(*a) |
第一行 int[4] |
16 |
sizeof(a[3]) |
表达式类型为 int[4],普通数组下标不被执行 |
16 |
最后一项最容易让人紧张。a[3] 若在普通求值语境中访问就越界,但这里它是非 VLA 的 sizeof 操作数,表达式不会被执行;编译器只需要确定其类型为 int[4]。
二维数组的关键等价关系是:
c
a + 1        /* 指向第二行,类型 int (*)[4] */
*(a + 1)     /* 第二行数组,类型 int[4] */
*(a + 1) + 2 /* 指向 a[1][2],类型 int * */
*(*(a + 1) + 2) /* a[1][2],类型 int */
七、七道指针运算题完整解析
7.1 题目 1:&a + 1 指向哪里
c
int a[5] = {1, 2, 3, 4, 5};
int *ptr = (int *)(&a + 1);

printf("%d,%d\n", *(a + 1), *(ptr - 1));
&a 指向整个 int[5],所以 &a + 1 指向整个数组之后。转换成 int * 后再减 1,在课程采用的连续内存模型里回到最后一个元素。
text
*(a + 1)   → a[1] → 2
*(ptr - 1) → a[4] → 5
课程答案:
text
2,5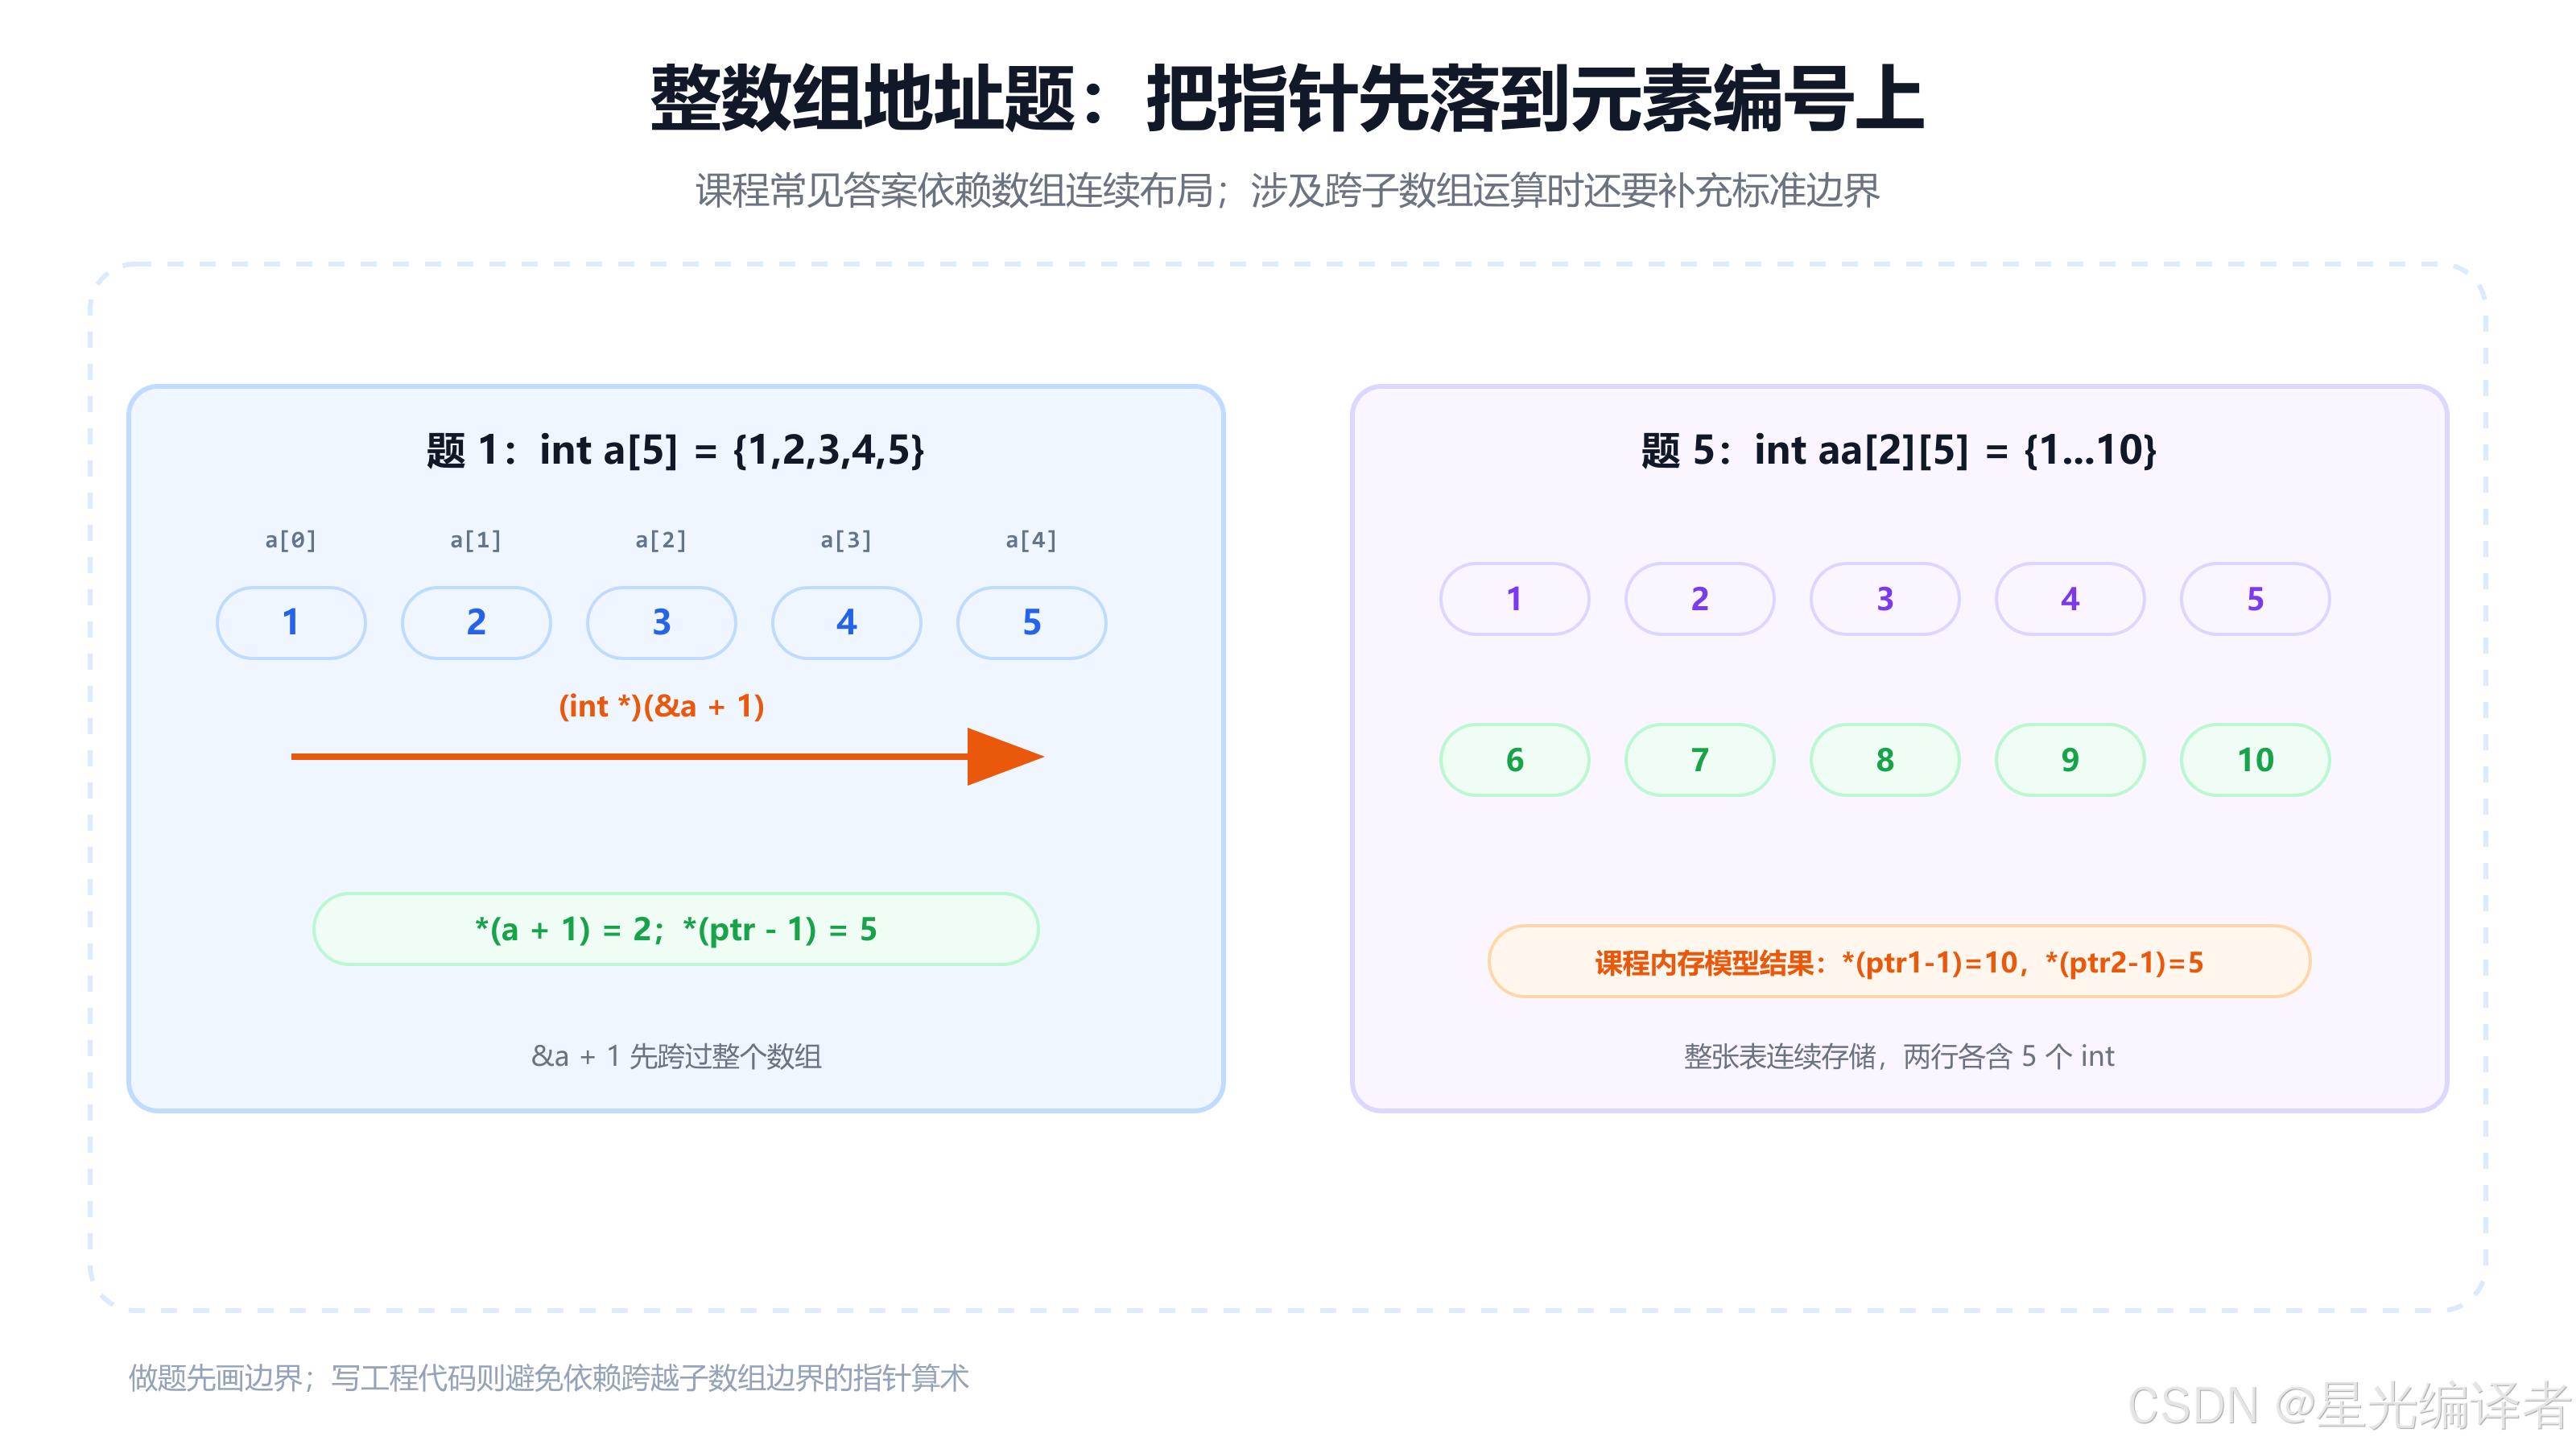
这类写法适合帮助理解"整个数组地址"的跨度,但工程代码若只是访问尾元素,直接写 a[4] 或 a[length - 1] 更清楚。
7.2 题目 2:不同目标类型带来不同步长
题设假定 x86 环境,sizeof(struct Test) == 20:
c
struct Test
{
    int Num;
    char *pcName;
    short sDate;
    char cha[2];
    short sBa[4];
} *p = (struct Test *)0x100000;
三种表达式的课程推导如下:
c
p + 0x1;                 /* 按 struct Test 前进:+20 字节 */
(unsigned long)p + 0x1;  /* 已转为整数:数值 +1 */
(unsigned int *)p + 0x1; /* 按 unsigned int 前进:+4 字节 */
于是典型题设答案是:
text
0x100014
0x100001
0x100004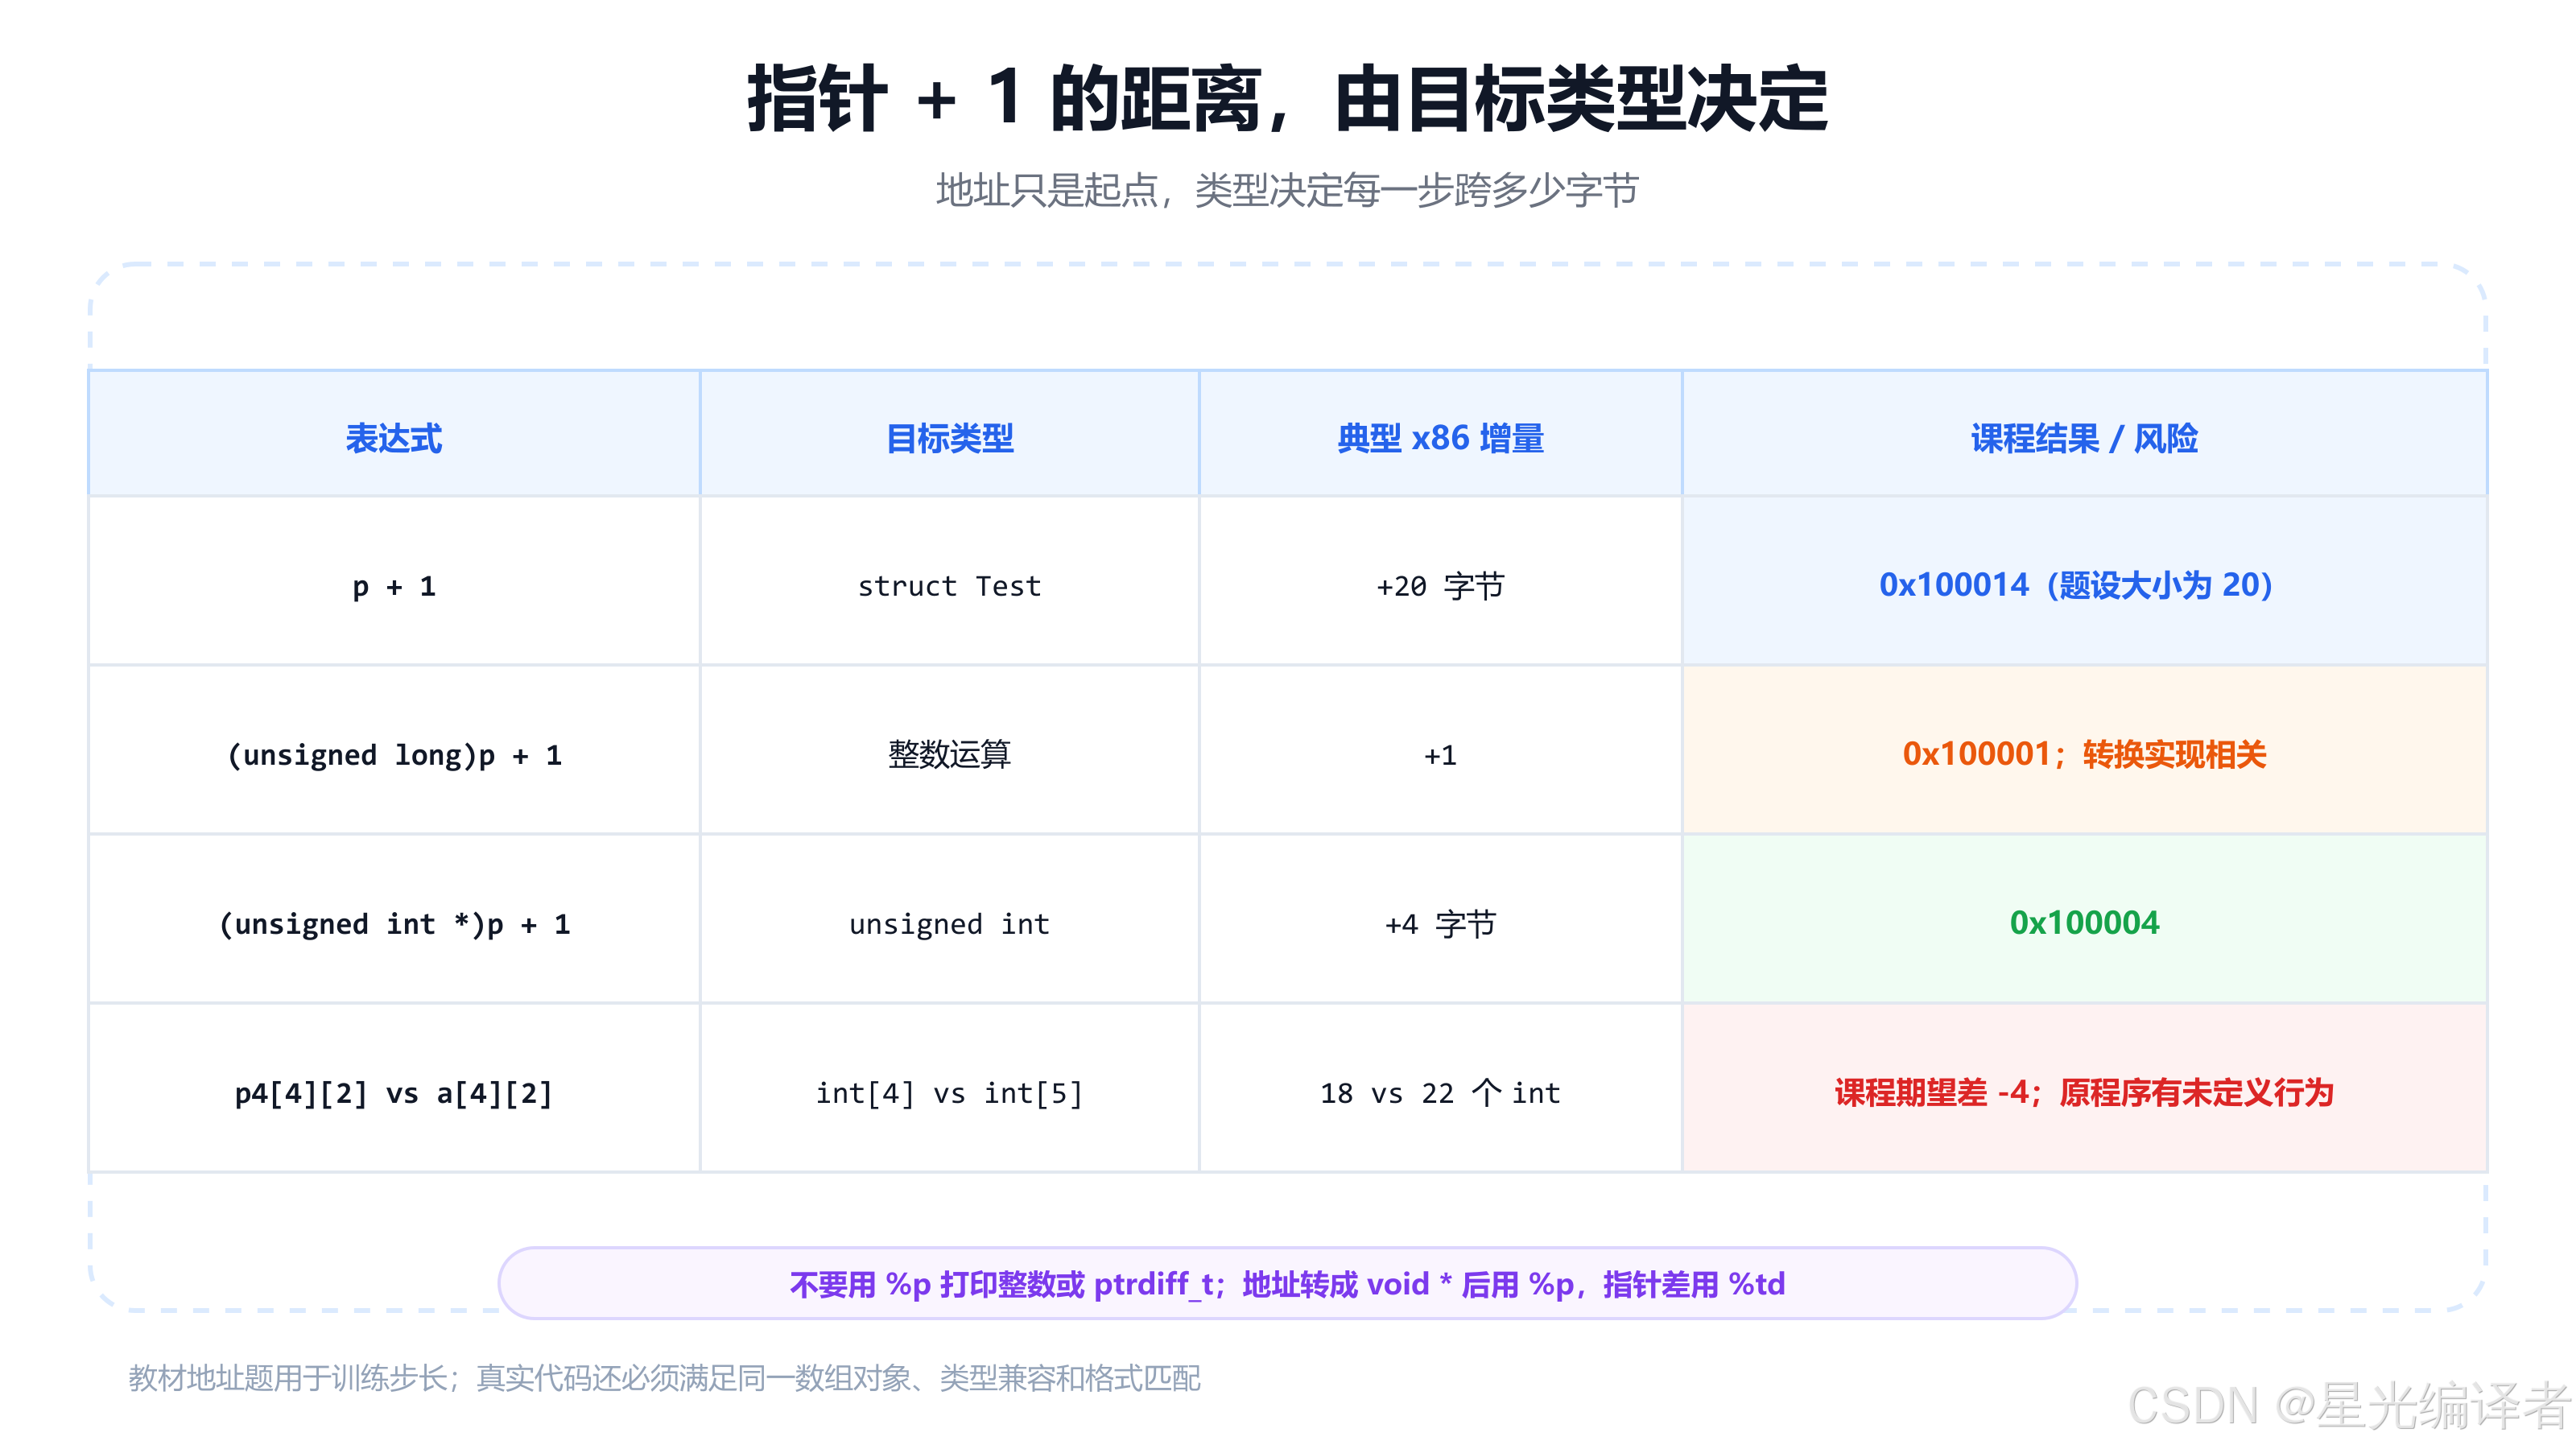
不过,这段程序不是可移植的地址实验:
- 把整数常量转换成指针是实现定义行为;
p并未指向一个真实的struct Test数组,直接做指针算术不满足标准要求;- 指针转成
unsigned long可能在某些数据模型中丢失位数; %p要求对应实参为void *,不能拿来打印整数表达式。
若需要保存可往返转换的地址整数,应研究 <stdint.h> 中实现提供的 uintptr_t;若只打印合法对象地址,应转换为 void * 后使用 %p。
7.3 题目 3:逗号表达式不是"每行两个元素"
c
int a[3][2] = {(0, 1), (2, 3), (4, 5)};
int *p = a[0];

printf("%d\n", p[0]);括号中的逗号是逗号运算符:先计算左操作数,再以右操作数作为整个表达式的值。
text
(0, 1) → 1
(2, 3) → 3
(4, 5) → 5
由于省略了内层花括号,这三个标量初始化值按行优先顺序填入二维数组,其余元素补 0:
text
a = {
    {1, 3},
    {5, 0},
    {0, 0}
}
p 指向 a[0][0],所以输出:
text
1若本意是逐行初始化为 0 到 5,应写:
c
int a[3][2] = {{0, 1}, {2, 3}, {4, 5}};7.4 题目 4:错误的列数会改变整行步长
c
int a[5][5];
int (*p)[4];
p = a;

printf("%p,%d\n", &p[4][2] - &a[4][2],
                    &p[4][2] - &a[4][2]);
课程通常这样计算偏移:
text
p[4][2]:4 × 4 + 2 = 第 18 个 int
a[4][2]:4 × 5 + 2 = 第 22 个 int
差值:18 - 22 = -4
在典型 32 位环境中,第一项若被错误地按地址样式显示,课程可能给出类似 FFFFFFFC,-4 的结果。
但标准层面的首要结论不是这个数字,而是原程序本身有问题:
a转换后的类型是int (*)[5],不能赋给int (*)[4];- 以错误行宽做指针运算不满足原数组对象的类型与边界要求;
- 两个指针并非通过同一合法数组元素序列得到,直接相减没有可移植保证;
- 指针差的类型是
ptrdiff_t,应使用%td,不能用%p或假定它就是int。
正确的指针声明应保留真实列数:
c
int (*p)[5] = a;7.5 题目 5:整个二维数组之后与第二行开头
c
int aa[2][5] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
int *ptr1 = (int *)(&aa + 1);
int *ptr2 = (int *)(*(aa + 1));

printf("%d,%d\n", *(ptr1 - 1), *(ptr2 - 1));
课程内存模型中的推导:
&aa + 1越过整个int[2][5],转成int *后减 1,落到 10;aa + 1指向第二行,*(aa + 1)是第二行数组,转换后指向 6;再减 1,落到前一行末尾的 5。
课程答案:
text
10,5需要补充的是,ISO C 的指针算术按具体数组对象界定。把"二维数组物理上连续"直接等同于"任意 int * 都能跨子数组边界移动",会越过标准保证。真实代码应通过合法的行、列下标访问,不要把这类笔试技巧当成通用遍历写法。
7.6 题目 6:二级指针移动一个元素
c
char *a[] = {"work", "at", "alibaba"};
char **pa = a;

pa++;
printf("%s\n", *pa);
a 是指针数组,每个元素的类型为 char *。在普通表达式中,a 转换成指向首元素的 char **。
text
pa 初始指向 a[0]
pa++ 后指向 a[1]
*pa 得到 a[1],即 "at"
输出:
text
at字符串字面量不应被修改,现代代码更推荐写成:
c
const char *a[] = {"work", "at", "alibaba"};
const char **pa = a;
7.7 题目 7:三级指针与连续副作用
c
char *c[] = {"ENTER", "NEW", "POINT", "FIRST"};
char **cp[] = {c + 3, c + 2, c + 1, c};
char ***cpp = cp;

printf("%s\n", **++cpp);
printf("%s\n", *--*++cpp + 3);
printf("%s\n", *cpp[-2] + 3);
printf("%s\n", cpp[-1][-1] + 1);
先画出三层关系:
text
c  : ["ENTER", "NEW", "POINT", "FIRST"]
cp : [ c+3,      c+2,    c+1,     c      ]
cpp:   ^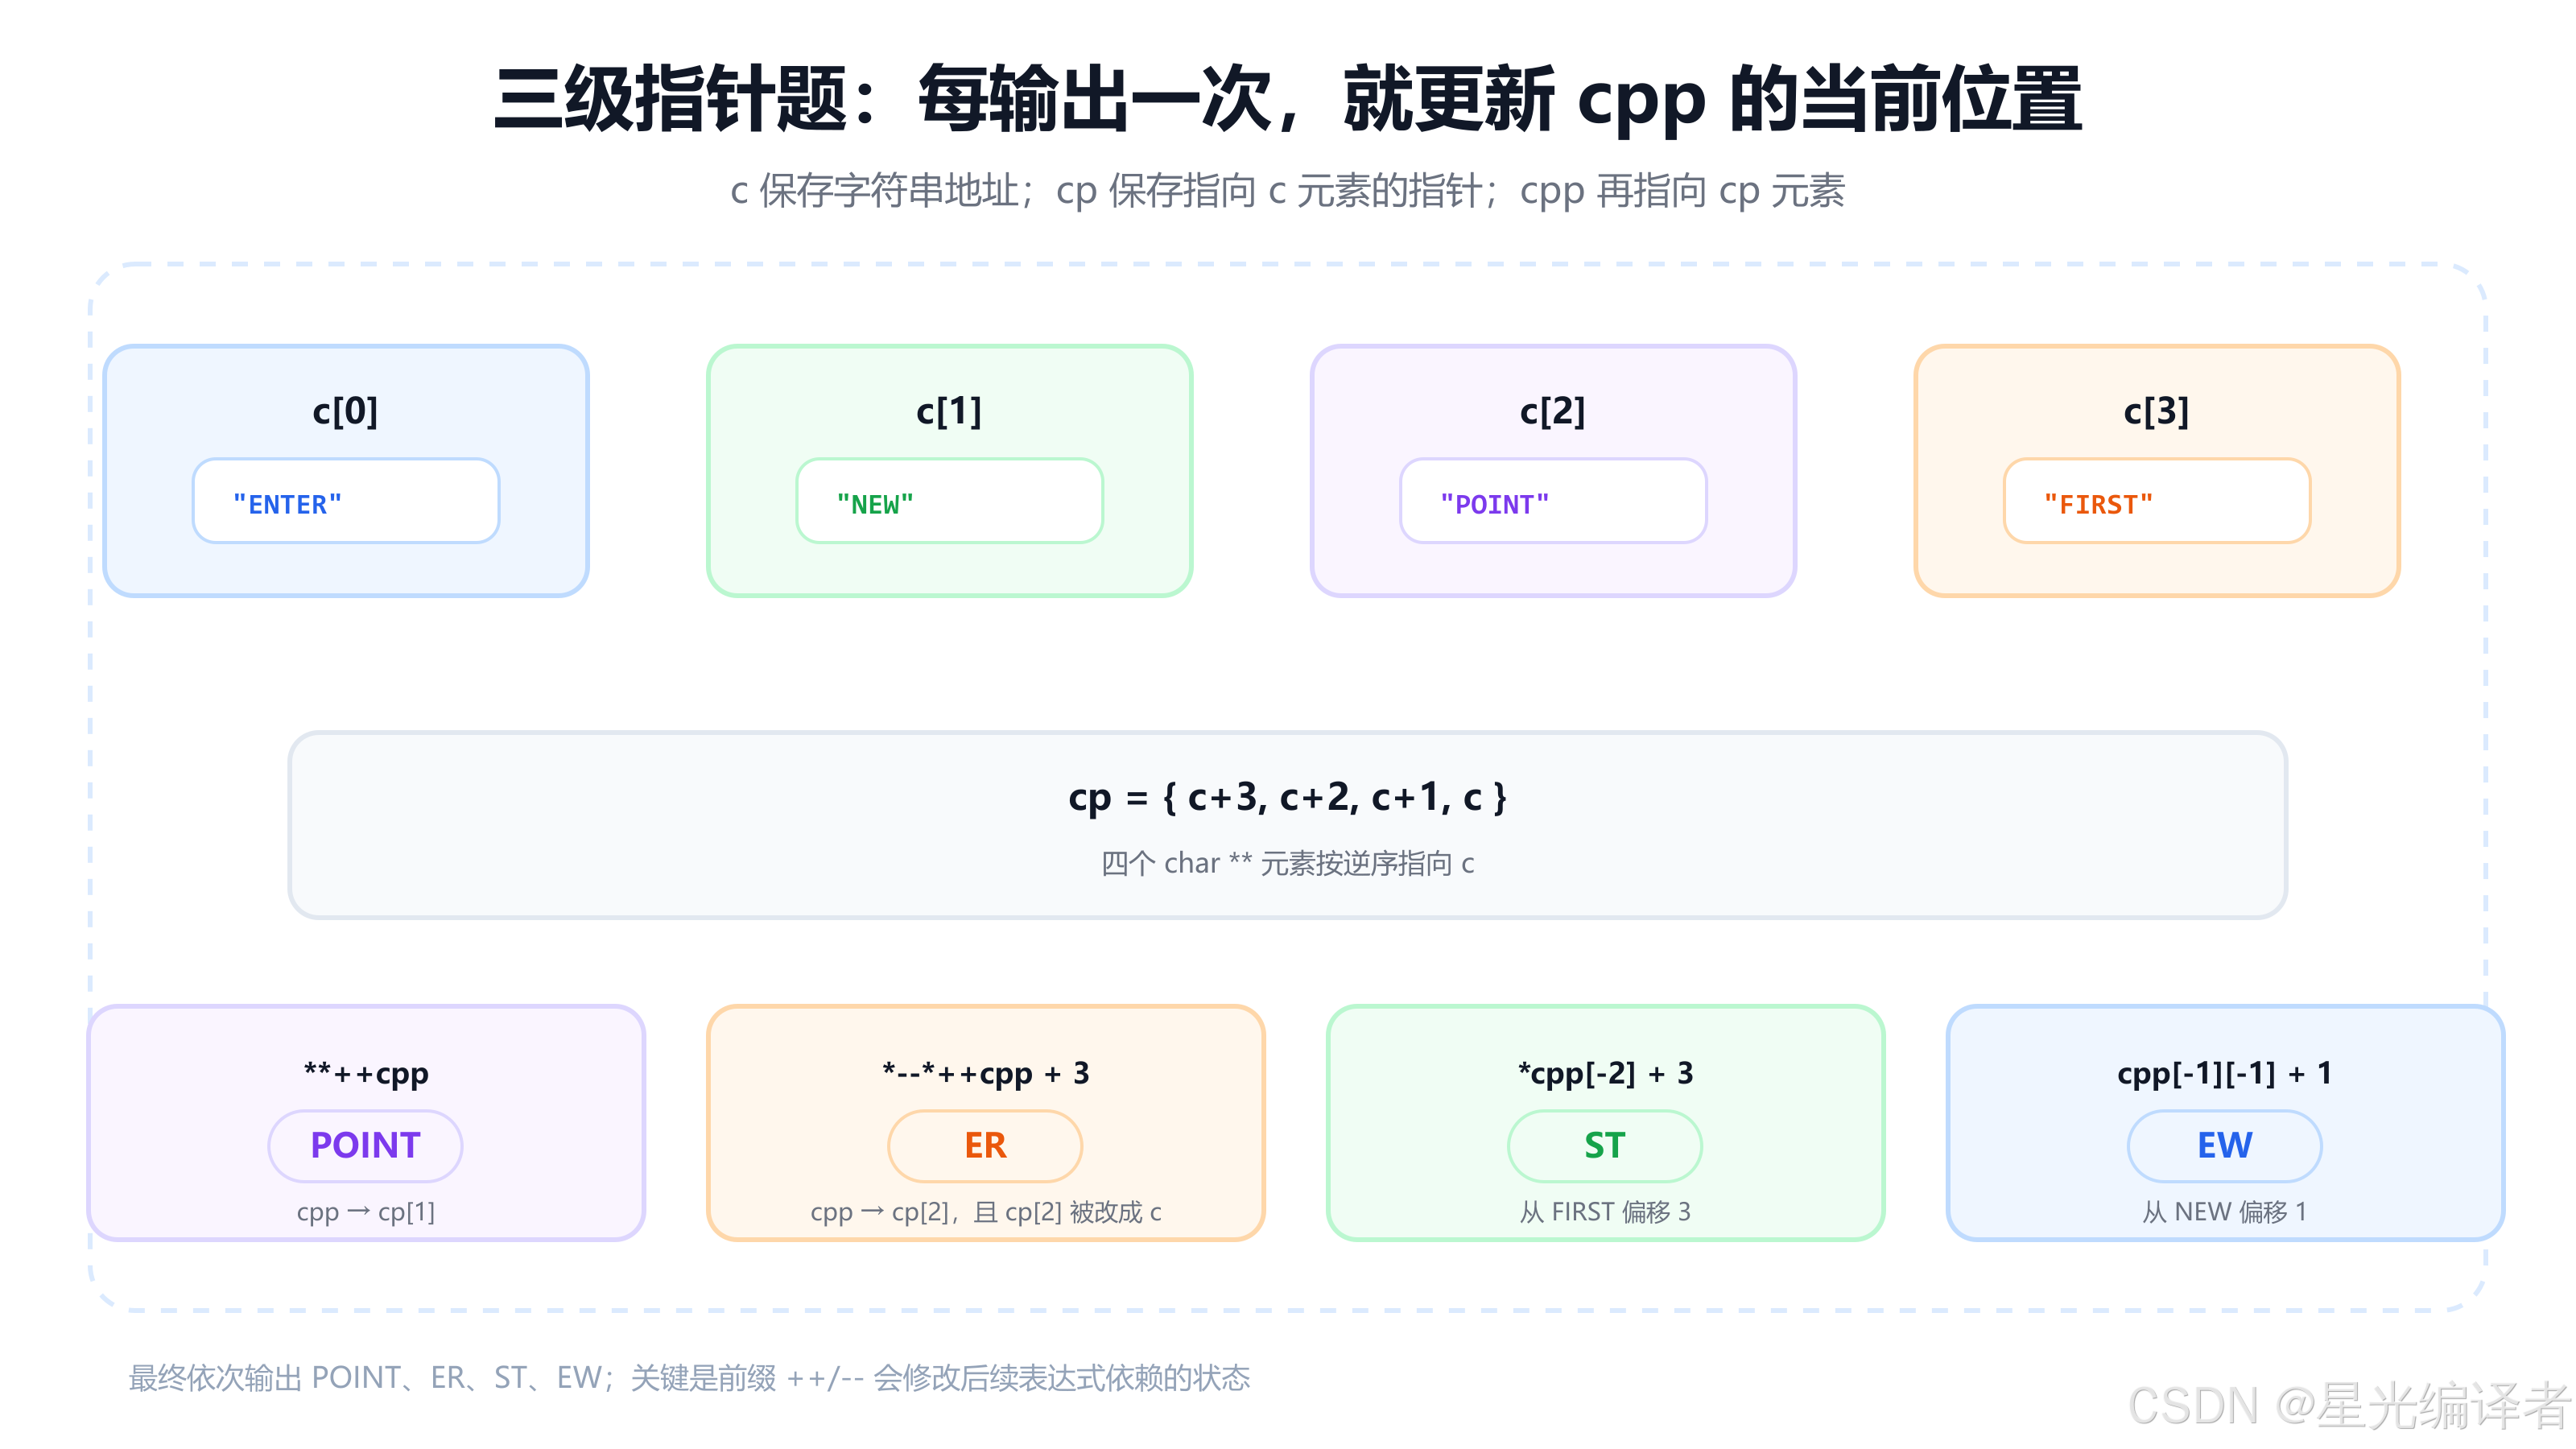
逐句分析。
第一句:
c
**++cppcpp 先从 cp[0] 移到 cp[1];*cpp 得到 c + 2;再次解引用得到 c[2],即:
text
POINT第二句:
c
*--*++cpp + 3可以按一元运算符从右向左结合来理解:
++cpp:移动到cp[2];*++cpp:得到cp[2]这个char **左值,原值是c + 1;--*++cpp:把cp[2]改为c;- 再解引用得到
c[0],也就是字符串"ENTER"; + 3从字符'E'开始偏移 3 个位置,指向后缀"ER"。
输出:
text
ER注意:这一步不仅产生输出,还把 cp[2] 从 c + 1 改成了 c。后续分析必须保留这个状态。
第三句:
c
*cpp[-2] + 3此时 cpp == cp + 2,所以 cpp[-2] 等于 cp[0],也就是 c + 3。解引用得到 "FIRST",再偏移 3 个字符,输出:
text
ST第四句:
c
cpp[-1][-1] + 1cpp[-1] 等于 cp[1],其值为 c + 2;再取 [-1] 得到 c[1],也就是 "NEW";最后偏移 1 个字符,输出:
text
EW四行最终结果为:
text
POINT
ER
ST
EW这道题最难的不是星号数量,而是优先级、指针层级和副作用状态必须同时跟踪。
八、笔试题的稳定解题流程
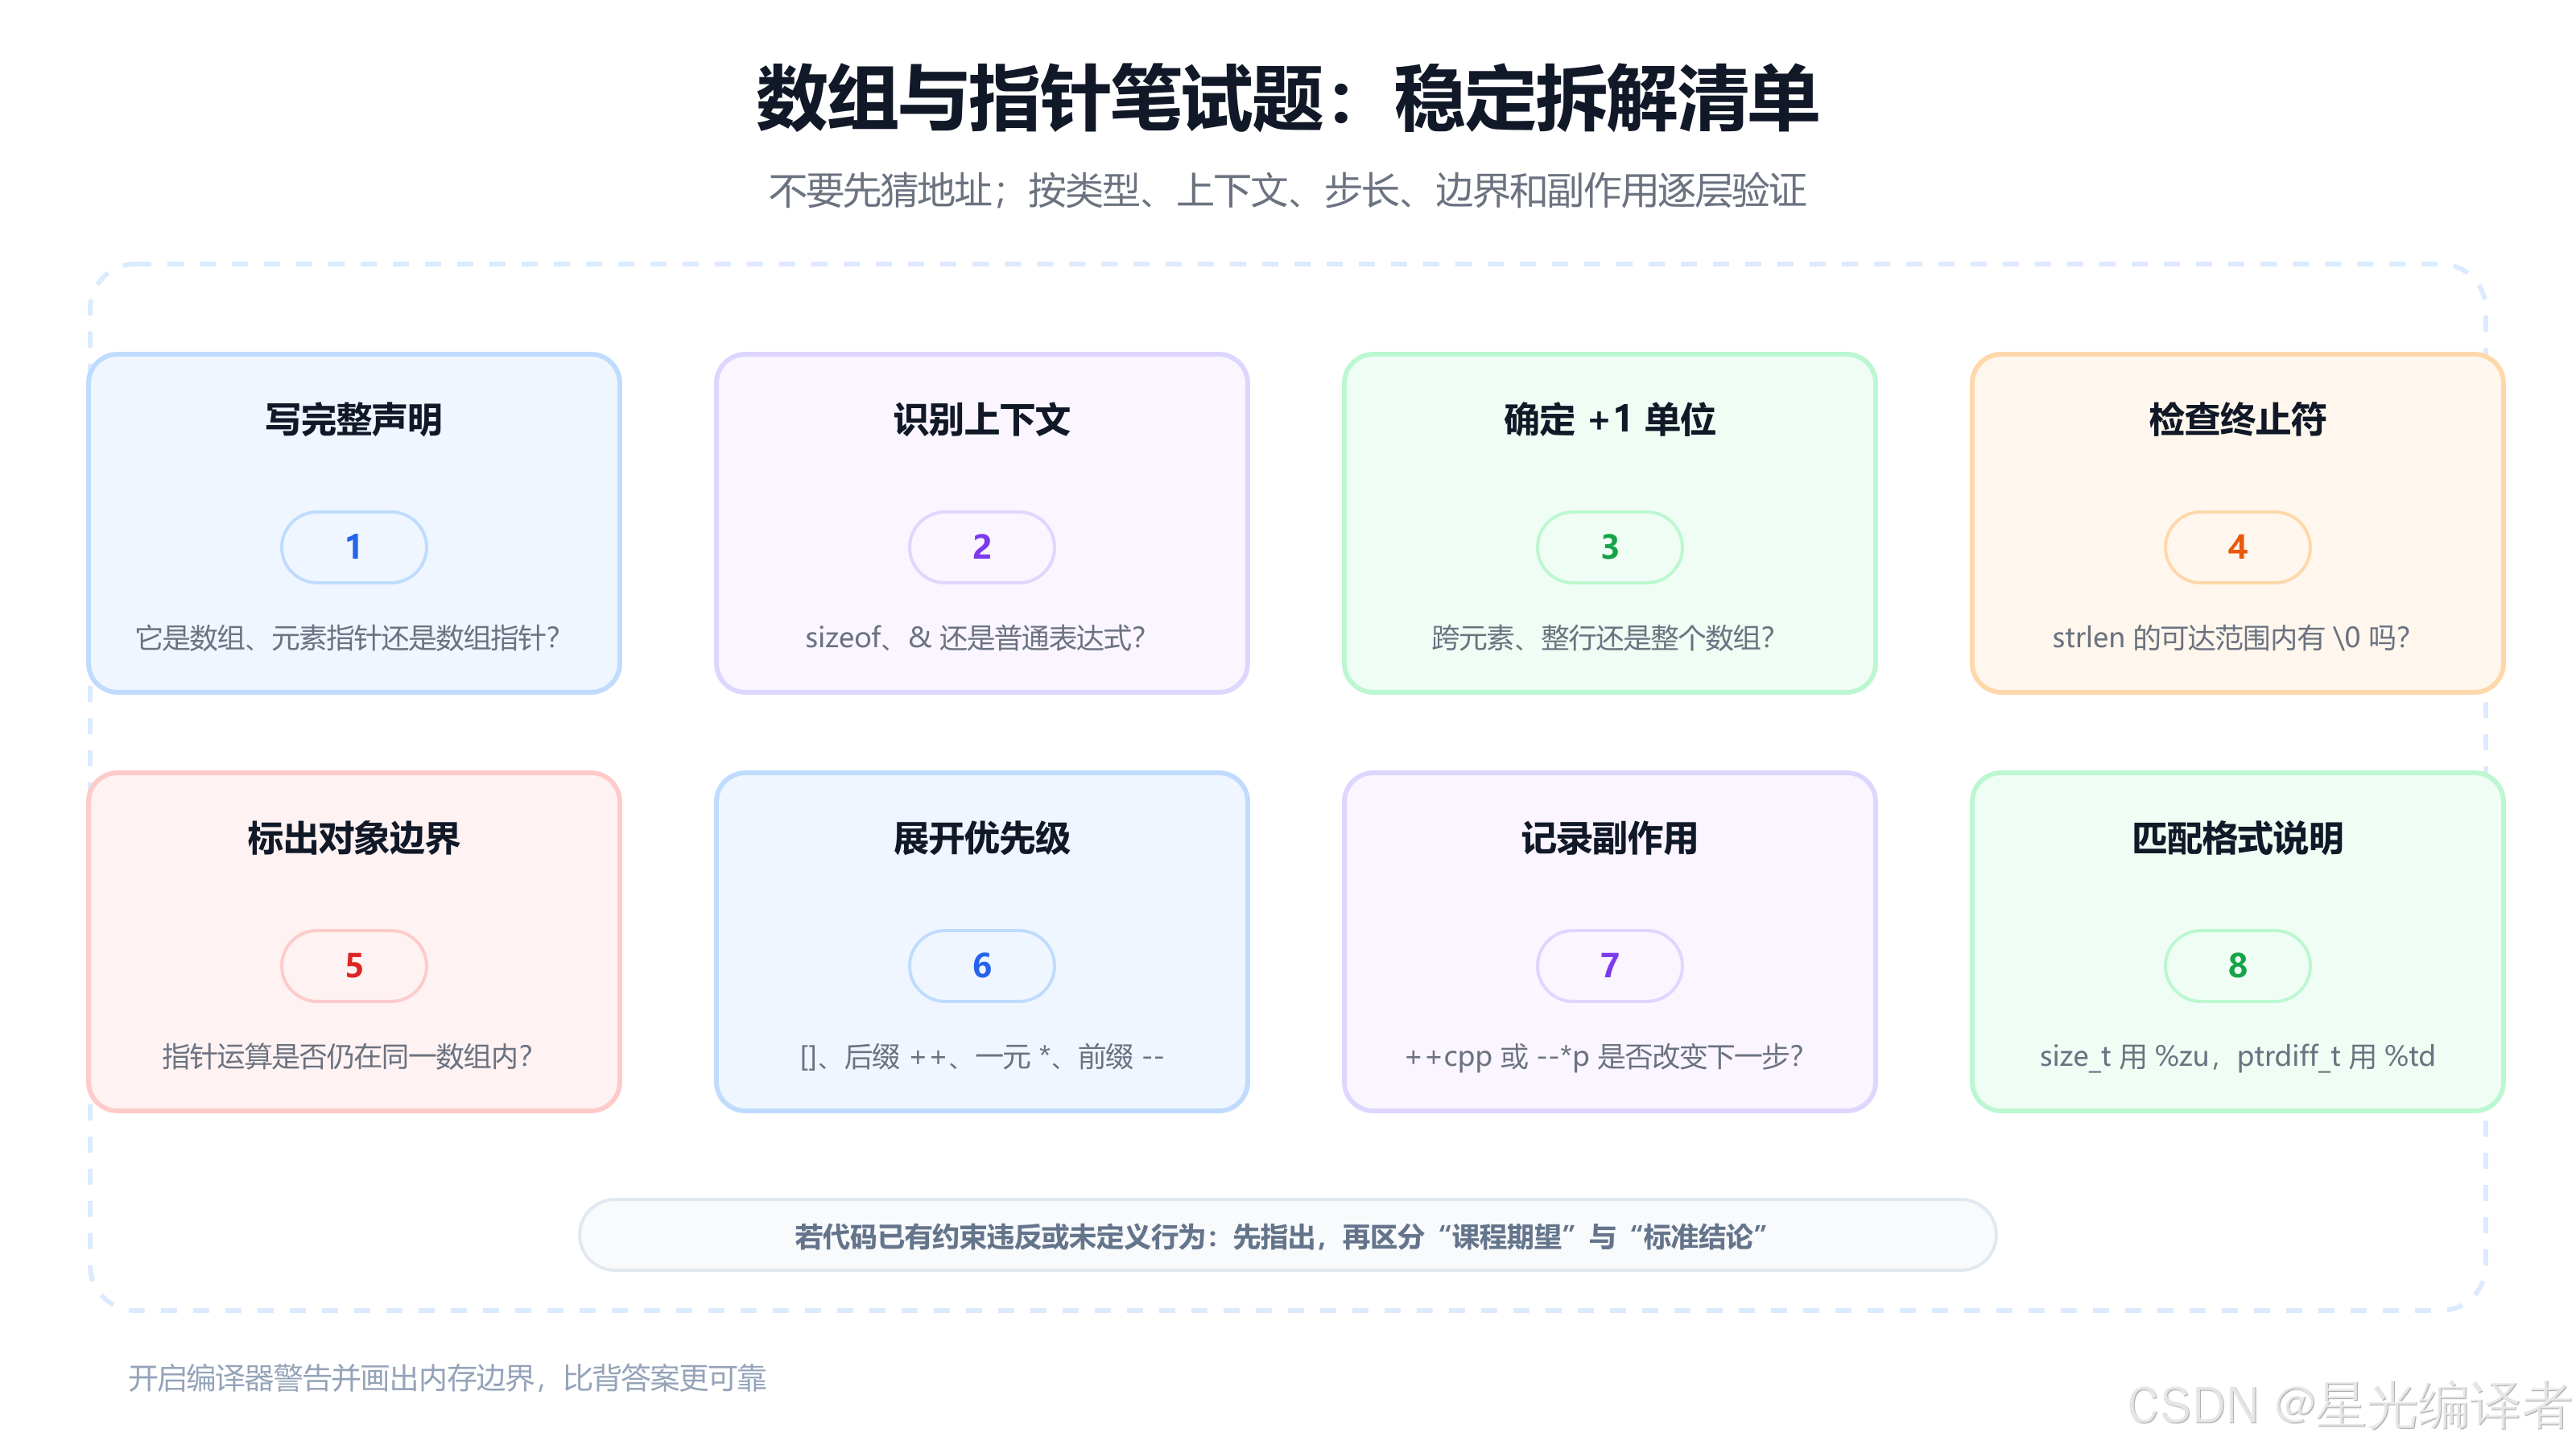
遇到数组与指针综合表达式时,可以按下面的顺序处理。
8.1 第一步:先写类型
不要急着代地址,先明确每一层:
c
int a[3][4]; /* a 的元素类型是 int[4] */
int (*p)[4]; /* p 指向 int[4] */
int **q;     /* q 指向 int *,与二维数组指针不同 */
8.2 第二步:圈出特殊上下文
重点寻找:
sizeof(数组名):看整个数组;&数组名:取得整个数组地址;- 普通表达式里的数组名:通常转换为首元素地址;
strlen:它不是类型运算,必须真正读取字符。
8.3 第三步:把 +1 翻译成"跨一个什么"
text
int *          + 1 → 跨一个 int
int (*)[4]     + 1 → 跨一行 int[4]
struct Test *  + 1 → 跨一个 struct Test
char ***       + 1 → 跨一个 char ** 元素
8.4 第四步:画对象边界
指针加减与比较并不是对任意整数地址都成立。要问:
- 指针是否来自真实对象?
- 运算后是否仍在同一个数组对象内,或恰好位于尾后位置?
- 尾后指针是否只用于比较或回退,而没有被解引用?
- 二维数组中是否错误跨越了内层子数组边界?
8.5 第五步:展开优先级并记录副作用
常用优先级从高到低可记为:
text
后缀 []、后缀 ++
前缀 ++、前缀 --、一元 *、一元 &
加减 + -
对 *--*++cpp + 3 这类表达式,最好每执行一个前缀自增或自减,就在草稿上更新对应变量或表项,避免仍按旧状态继续推导。
8.6 第六步:区分三类答案
一道题可能同时存在三种层次:
- 语言标准保证的结论;
- 题设平台与编译器下的典型结果;
- 原程序已有未定义行为,不能给出可移植结果。
高质量分析不应只报一个数字,还应说明这个数字依赖哪些前提。
九、高频问答与动手练习
高频问答
Q1:sizeof 是函数吗?
不是。它是 C 语言运算符。对类型名使用时写 sizeof(type);对表达式使用时括号通常可省略,例如 sizeof value。
Q2:strlen 为什么可能越界?
因为参数只携带一个起始地址,没有同时携带缓冲区长度。若有效对象范围内没有 \0,函数就会继续读取,产生未定义行为。
Q3:数组名是不是地址常量?
不宜这样概括。数组是对象,数组名在多数表达式中会转换为首元素指针;在 sizeof、一元 & 等语境中表现不同。用"上下文中的数组到指针转换"解释更准确。
Q4:a 和 &a 数值相同,为什么 +1 不同?
a 通常转换为指向首元素的指针,&a 指向整个数组。指针算术以目标类型为单位,所以一个跨元素,一个跨整数组。
Q5:sizeof(a[3]) 中 a[3] 越界吗?
对于本文的固定长度二维数组,sizeof 不执行 a[3],只分析其类型,因此可得到一行的大小。若涉及 VLA,需要另外考虑运行期求值规则。
Q6:为什么 int ** 不能接收 int a[3][4]?
a 转换后是 int (*)[4],指向一整行;int ** 指向的是一个 int * 对象。二者目标类型与内存模型不同。
Q7:指针相减应该用什么类型和格式?
结果类型是 <stddef.h> 中的 ptrdiff_t,打印使用 %td。前提是两个指针指向同一数组对象中的元素或尾后位置。
Q8:把警告用强制转换压掉,程序就正确了吗?
不会。强制转换只改变编译器如何解释表达式,不能修复缺失的 \0、错误的数组列数、无效生命周期或越界指针。
动手练习
- 在 32 位和 64 位环境分别预测
sizeof(char *)、sizeof(int (*)[10]),并说明哪些结果由平台决定。 - 给出
char text[10] = "abc";中sizeof(text)、strlen(text)和strlen(text + 2)的结果。 - 分析
int matrix[2][3]中matrix + 1、*matrix + 1与&matrix + 1各跨过多少个int。 - 将题目 4 的数组指针改为正确类型,并使用
%td打印两个合法元素指针之差。 - 为三级指针题画出
c、cp、cpp三行表格,每执行一条printf就更新一次状态。 - 编写函数
size_t bounded_length(const char *s, size_t capacity),只在给定容量内查找\0,并为无终止符情况设计返回约定。
参考答案要点:
- 两者都是指针类型,大小通常随数据模型变化;目标类型不同不意味着指针对象本身大小必然不同。
- 分别为
10、3、1。 matrix + 1跨 3 个int;*matrix + 1跨 1 个int;&matrix + 1跨整个 2×3 数组,也就是 6 个int。- 使用
int (*p)[5] = a;;只有同一真实数组内的元素指针才能可靠相减。 - 重点记录第二条语句把
cp[2]从c + 1改成了c。 - 循环上限必须是
capacity,不能在未发现\0时继续读取;可返回capacity或额外状态,但接口文档必须说明。
总结
这一讲把数组、字符串与指针运算放到了一起。sizeof 依据类型回答"对象占多少字节",strlen 通过实际读取回答"终止符之前有多少字符";数组名在不同上下文中可能表示完整数组,也可能转换为首元素地址;二维数组的首元素是一整行,因此列数会直接进入指针类型和步长。
面对笔试题时,真正可靠的方法不是背下 2,5、10,5 或 POINT/ER/ST/EW,而是坚持这条分析链:写出类型 → 识别上下文 → 确定步长 → 检查边界 → 展开优先级 → 记录副作用。若原程序含有类型不兼容、格式错误或未定义行为,还要明确区分"题设平台上的典型结果"和"标准能够保证的结论"。
当你开始用类型和对象边界解释地址,而不是只盯着十六进制数字,数组与指针题就会从猜谜变成一套可以重复验证的推理过程。