引言
我们推出 DeepSeek-V4.1-Flash,这是一款多模态混合专家(MoE)模型,主干参数量达 5520 亿,并支持高达一百万 token 的上下文长度。该模型原生支持图像和文本输入,并以自回归方式生成文本。
架构。 DeepSeek-V4.1-Flash 采用 因果编码器-解码器(Causal Encoder-Decoder, CED) 架构:由一个 20 层因果编码器后接一个 20 层解码器组成的 40 层 Transformer。在 CED 架构中,解码器的全局 KV 缓存是从编码器最终隐藏状态投影而来,而非从每个解码器层自身的隐藏状态派生。这一设计使得模型在预填充阶段每 token 仅激活 80 亿参数,在解码阶段激活 160 亿参数,显著提升了输入密集型智能体工作负载的成本效率。SWA 有界重放(SWA Bounded Replay) 通过仅重放最近的 n_win 个 token 来重建缺失的 SWA KV 状态,避免了将 SWA KV 持久化到 SSD 的需求,并将持久化 KV 缓存占用空间降至 DeepSeek-V4-Flash 的约 1/8。
压缩稀疏注意力 2(Compressed Sparse Attention 2, CSA2)。 DeepSeek-V4.1-Flash 使用 CSA2,为每个注意力层分配三种静态模式之一------Full、Reindex 或 Reuse------以跨层共享主 KV 和索引器 K,并复用 Top-K 稀疏注意力索引。在解码器中,分层稀疏索引器(Hierarchical Sparse Indexer) 进一步限制后续索引层只能在首个 Full 模式层构建的候选池内进行搜索,从而使深层索引器的计算开销与上下文长度无关。结合 FP4 主 KV 缓存(E2M1 格式,每 16 个通道共享一个 E4M3 缩放因子),这些设计将全局 KV 缓存占用降至每 token 890 字节------约为 DeepSeek-V4-Flash 的 1/4。
其他架构组件 包括单次传递 mHC(Single-Pass mHC,通过高效的 Mega-mHC 内核改进残差流混合)、Engram 条件记忆(1960 亿参数,通过基于 token 的查找稀疏访问)以及 DSpark 推测解码(半自回归草稿生成配合置信度调度验证)。该模型在每个 MoE 层使用 1 个共享专家和 384 个路由专家,每 token 激活其中 6 个路由专家。
多模态架构。 视觉编码器(DeepSeek-ViT,从零开始训练,采用 2D-RoPE 和 3×3 像素反混叠下采样)与一个两层 MLP 投影器共同将图像转换为视觉嵌入,并从语言模型预训练初始阶段起就与文本嵌入联合处理。
预训练。 DeepSeek-V4.1-Flash 在包含 45 万亿 token 的多模态语料库上从零开始训练,其中稀疏注意力在 64K 序列长度下训练,并在累计 34 万亿 token 时将上下文扩展至 100 万 token。
后训练。 后训练方案遵循标准的 SFT → RL → 在线蒸馏(OPD)范式,未对算法本身进行修改。所有实质性改动均体现在数据管道中:大规模自动化合成智能体任务与环境,并对数据、任务和轨迹进行渐进式扩展。该模型支持一种连续可控的推理强度设置(整数 1--100),可在推理成本与准确率之间进行权衡。
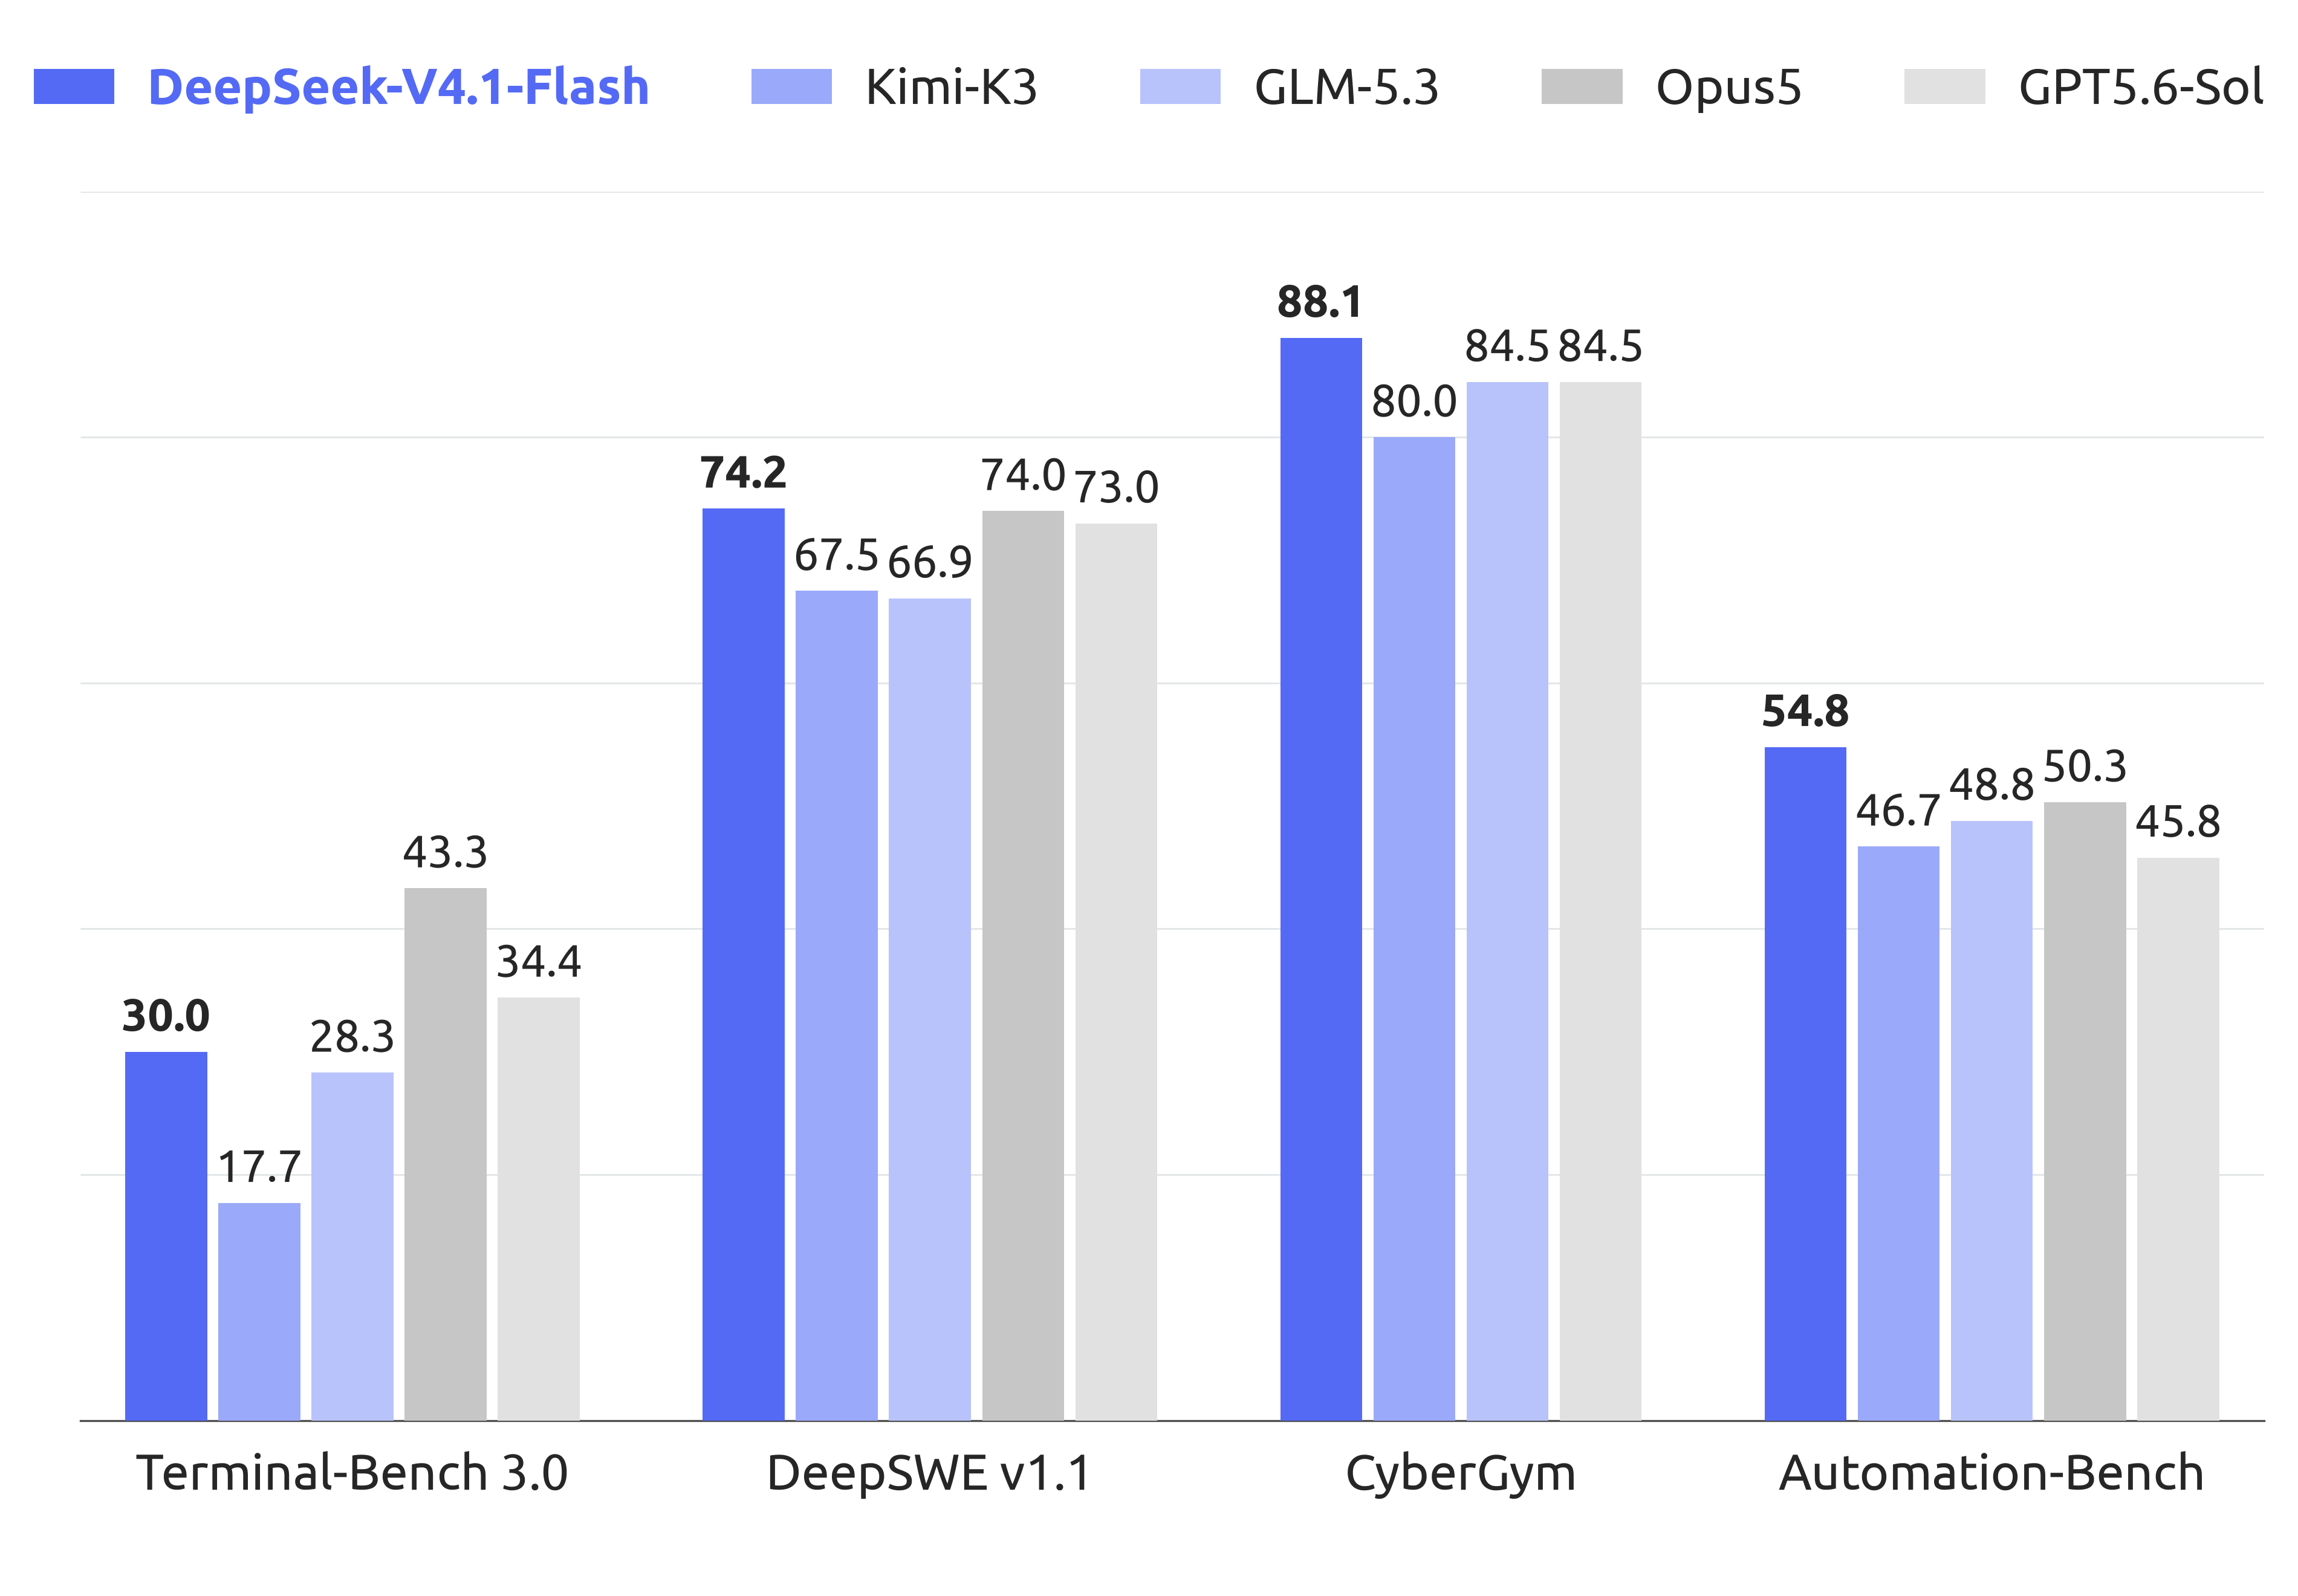
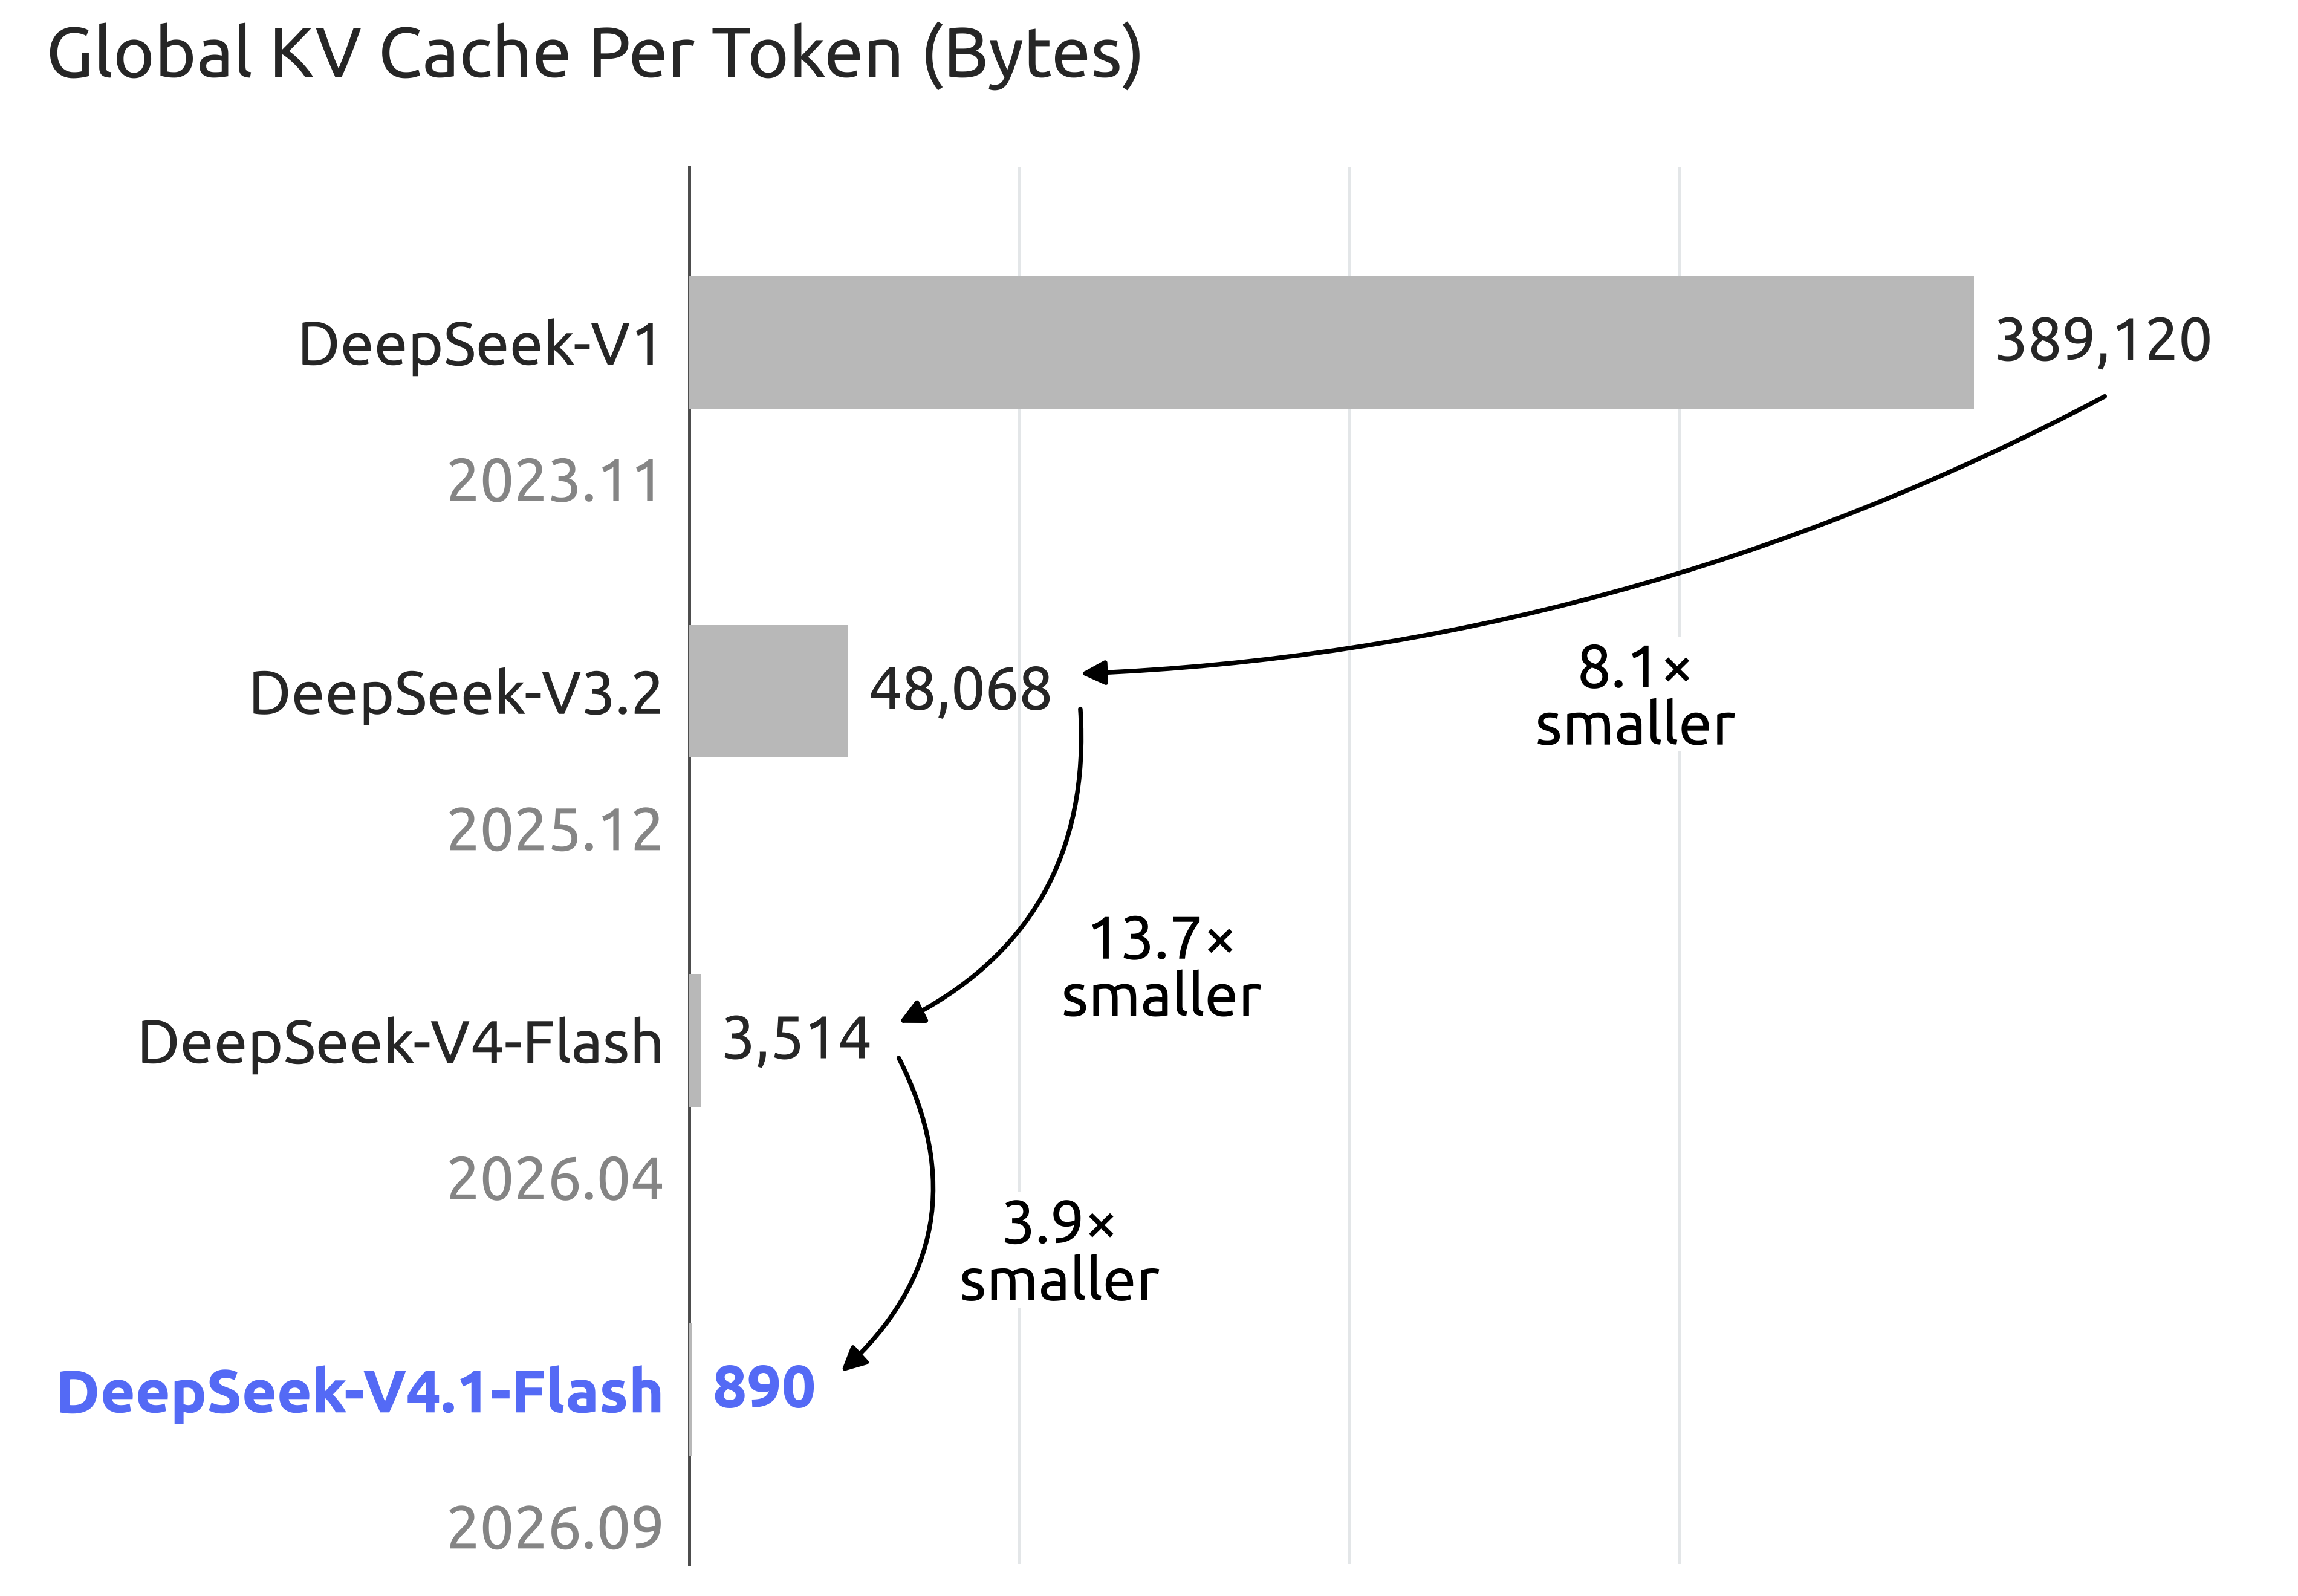
图 1. (a) DeepSeek-V4.1-Flash 及其竞品在智能体基准上的性能。(b) DeepSeek 各代模型每个 token 的全局 KV 缓存大小(字节)。DeepSeek-V4.1-Flash 相比 DeepSeek-V4-Flash 和 DeepSeek-V1 分别实现了约 4 倍和 437 倍的缩减。
评估结果
基础模型
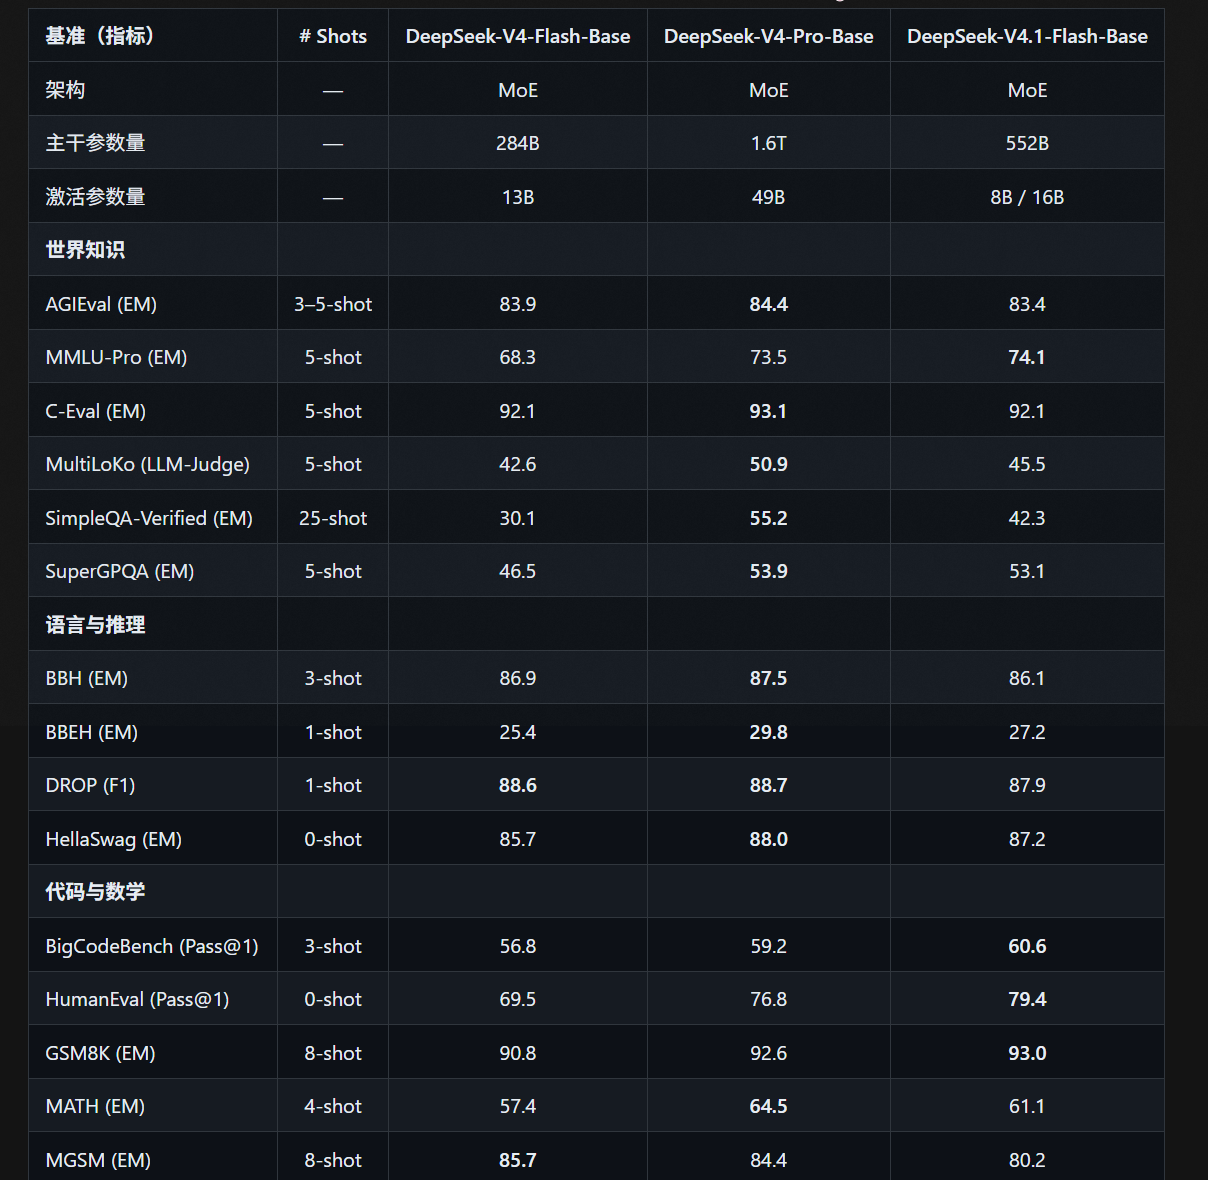
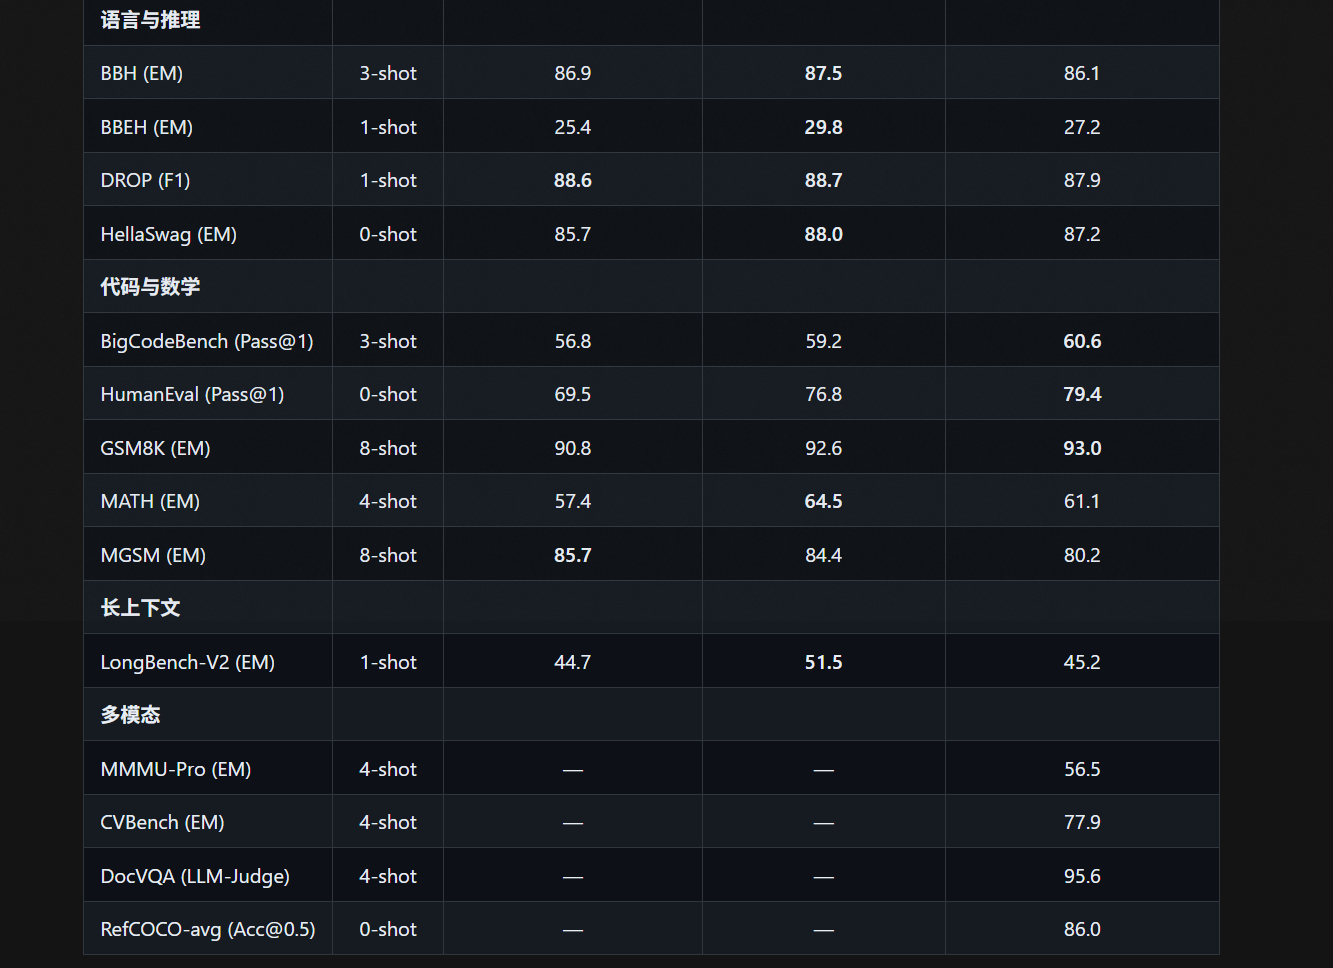
所有基础模型均在我们的内部框架下使用相同的评估设置进行评测。彼此得分相差不超过 0.3 的视为等效。
指令微调模型
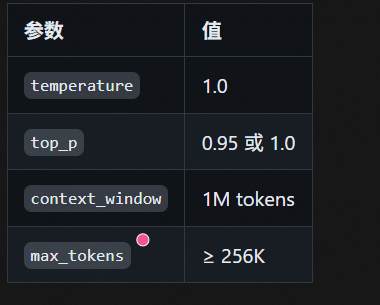
DeepSeek-V4.1-Flash 支持从 1 到 100 的连续可控推理强度。以下所有指令微调模型的结果均使用最大推理强度设置(reasoning_effort=100)。评估时使用 temperature=1.0, top_p=0.95。
对于代码智能体基准(Terminal-Bench 2.1/3.0/4.0、DeepSWE v1.1、NL2Repo-Bench、ProgramBench),模型在 DeepSeek Harness 的 Minimal 模式下进行评估,并使用 1M token 的上下文窗口。为符合官方设置要求,DeepSWE v1.1 使用 mini-SWE harness,SEC-Bench Pro 使用 Claude Code harness。视觉智能体基准(Chartography、BabyVision、ZeroBench)使用 Claude Code harness 并配备 512k token 的上下文窗口。Agent's Last Exam 和 AutomationBench 使用其官方脚手架。所有智能体评估均使用 temperature=1.0, top_p=0.95。
与前沿模型对比(最大推理强度)
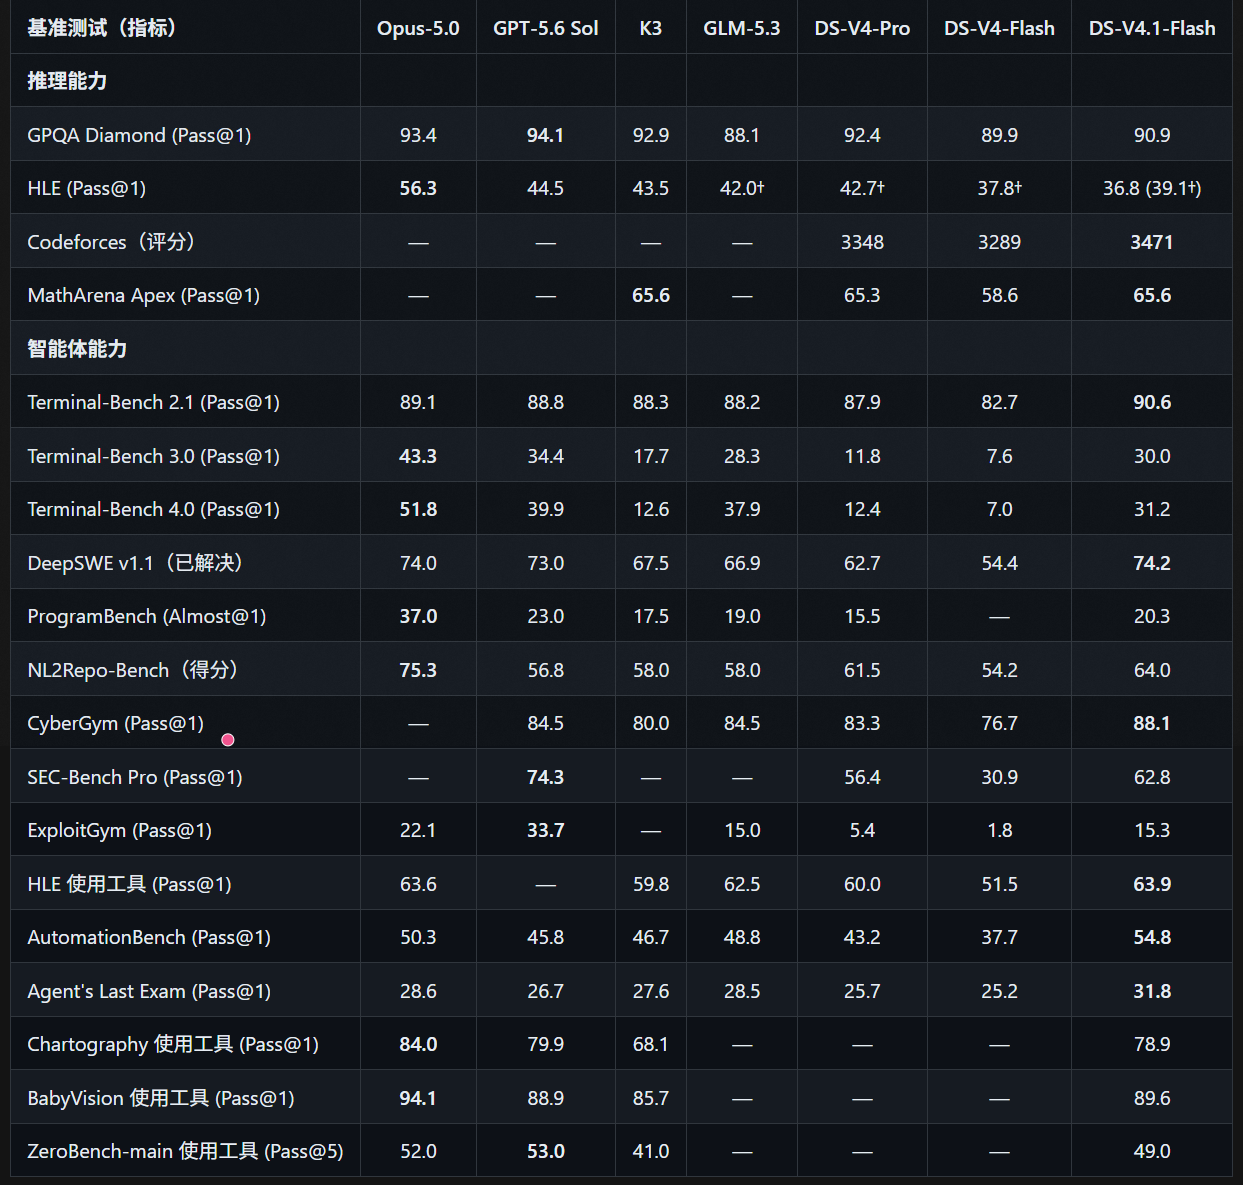
† HLE 的纯文本子集。
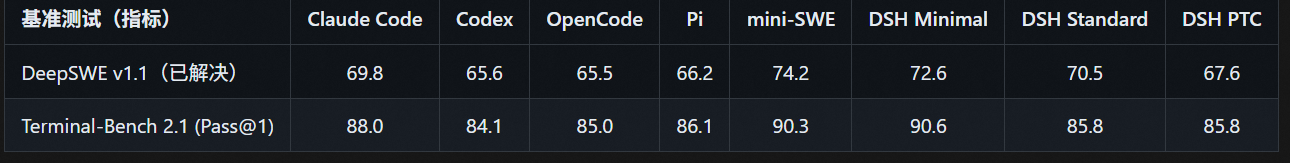
不同智能体框架下的性能表现(DeepSWE v1.1 和 Terminal-Bench 2.1,最大推理努力)
所有框架在 DeepSWE v1.1 上每个任务使用 N=8 个样本,在 Terminal-Bench 2.1 上使用 N=3 个样本,均基于 Linux 容器,设置 temperature=1.0、top_p=0.95、上下文长度限制为 1M tokens,每个智能体最多执行 500 步。Terminal-Bench 2.1 的评估不包含网络访问。
提示词编码
本次发布未包含 Jinja 格式的聊天模板。encoding 文件夹中包含一个独立的 Python 参考实现(encoding.py),并附带针对多轮对话、工具调用、思考模式、数值推理努力、对话中途的系统消息以及交错图像内容的测试用例。
对于生产环境使用,我们还发布了 deepseek-recipe,这是一组带有 Python 绑定的 Rust 库,提供与上述相同的提示格式,并作为一个维护良好、协议感知的工具包。它可以将 Messages、Chat Completions 和 Responses API 请求转换为 Conversation 格式,编码为 DeepSeek V4 和 V4.1 的提示或 token ID,并将模型输出解析回完整或流式响应------涵盖思考过程、工具调用、图像和生成设置。模型推理、工具执行和 HTTP 传输由调用方自行处理。
最小化推理
有关权重转换和本地运行推理的说明,请参阅 inference 文件夹。
推荐采样参数:
复现 DeepSWE 基准测试结果
evaluation 文件夹包含逐步说明,用于复现 DeepSWE v1.1 基准测试结果,涵盖 dsh-minimal 智能体和官方 mini-swe-agent。其中还包含了将 dsh-minimal 集成到 Pier 所需的补丁。