《扩散模型原理:从起源到发展》 第六章:扩散模型的统一系统化视角
专著参考 :The Principles of Diffusion Models
前序阅读章节:
【扩散模型原理】(一)Deep Generative Modeling
【扩散模型原理】(二)Variational Perspective: From VAEs to DDPMs
【扩散模型原理】(三)Score-Based Perspective: From EBMs to NCSN
【扩散模型原理】(四)Diffusion Models Today: Score SDE Framework(1)
【扩散模型原理】(四)Diffusion Models Today: Score SDE Framework(2)
【扩散模型原理】(五)Flow-Based Perspective : From NFs to Flow Matching(1)
【扩散模型原理】(五)Flow-Based Perspective : From NFs to Flow Matching(2)
【扩散模型原理】(五)Flow-Based Perspective : From NFs to Flow Matching(3)
【扩散模型原理】(六)A Unified and Systematic Lens on Diffusion Models(1)
6.3 扩散模型中的等价性(Equivalence in Diffusion Models)
6.2.1 节介绍的四类预测方式,将在后续(6.3.1 节)证明其在梯度最小化条件下相互等价 。随后本文在 6.3.3 节拓展该结论,证明不同前向噪声调度可通过简单的时间与空间重缩放建立联系。
6.3.1 四类预测方式的等价性(Four Prediction Types Are Equivalent)
本节首先分析式 6.2.5 中模块 (B) 的设计选项。
L ( ϕ ) : = E x 0 , ϵ E p time ( t ) ω ( t ) ∥ N N ϕ ( x t , t ) − ( A t x 0 + B t ϵ ) ∥ 2 2 . (6.2.5) \mathcal{L}(\phi):=\mathbb{E}{\mathbf{x}0,\boldsymbol{\epsilon}} \mathbb{E}{p{\text{time}}(t)} \left\\omega(t) \\left\\\|\\mathrm{NN}_\\phi\\left(\\mathbf{x}_t,t\\right)-\\left(A_t\\mathbf{x}_0+B_t\\boldsymbol{\\epsilon}\\right)\\right\\\|_2\^2\\right. \tag{6.2.5} L(ϕ):=Ex0,ϵEptime(t)ω(t)∥NNϕ(xt,t)−(Atx0+Btϵ)∥22.(6.2.5)
前文已经说明,四类预测方式并非彼此独立,而是对同一基础物理量的不同表达形式。例如,噪声预测与干净样本预测之间存在直接关联(2.2.4 节),得分预测与噪声预测同样如此(3.4 节)。该反复出现的规律揭示了一条更本质的原理:**四种参数化方式在代数意义上等价,可通过简单变换实现相互转换。**为精确描述该对应关系,本文参照(Kingma 等人,2021)给出如下命题,对应 图 6.1。
命题 6.3.1:各参数化形式的等价性
设分别对应噪声、原始样本、分数、速度参数化形式,且可最小化各自目标函数的最优预测为:
ϵ ∗ ( x t , t ) = − σ t s ∗ ( x t , t ) , x ∗ ( x t , t ) = 1 α t x t + σ t 2 α t s ∗ ( x t , t ) , v ∗ ( x t , t ) = α t ′ x ∗ + σ t ′ ϵ ∗ = f ( t ) x t − 1 2 g 2 ( t ) s ∗ ( x t , t ) . \begin{align} \boldsymbol{\epsilon}^*(\mathbf{x}_t,t) &= -\sigma_t \mathbf{s}^*(\mathbf{x}_t,t), \notag \\ \mathbf{x}^*(\mathbf{x}_t,t) &= \frac{1}{\alpha_t}\mathbf{x}_t + \frac{\sigma_t^2}{\alpha_t}\mathbf{s}^*(\mathbf{x}_t,t), \tag{6.3.1} \\ \mathbf{v}^*(\mathbf{x}_t,t) &= \alpha_t'\mathbf{x}^* + \sigma_t'\boldsymbol{\epsilon}^* = f(t)\mathbf{x}_t - \frac{1}{2}g^2(t)\mathbf{s}^*(\mathbf{x}_t,t). \notag \end{align} ϵ∗(xt,t)x∗(xt,t)v∗(xt,t)=−σts∗(xt,t),=αt1xt+αtσt2s∗(xt,t),=αt′x∗+σt′ϵ∗=f(t)xt−21g2(t)s∗(xt,t).(6.3.1) 式中 f ( t ) f(t) f(t) 与 g ( t ) g(t) g(t) 通过引理 4.4.1 和 α t \alpha_t αt、 σ t \sigma_t σt 建立关联。此外,上述极小值解满足式 (6.2.1)~ 式 (6.2.4) 给出的恒等式。
命题证明
本证明思路与定理 4.2.1 类似;定理 4.2.1 分析了在 DSM 目标下各类匹配损失的全局最优解,详细推导参见附录 D.4。
Figure 6.1 | 四种参数化形式之间的等价关系:**速度预测 满足 v ∗ = α t x ∗ + σ t ϵ ∗ \mathbf{v}^* = \alpha_t\mathbf{x}^* + \sigma_t\boldsymbol{\epsilon}^* v∗=αtx∗+σtϵ∗,其中原始样本预测** 与噪声预测 可通过 x t = α t x ∗ + σ t ϵ ∗ \mathbf{x}_t = \alpha_t\mathbf{x}^* + \sigma_t\boldsymbol{\epsilon}^* xt=αtx∗+σtϵ∗ 实现相互转换。
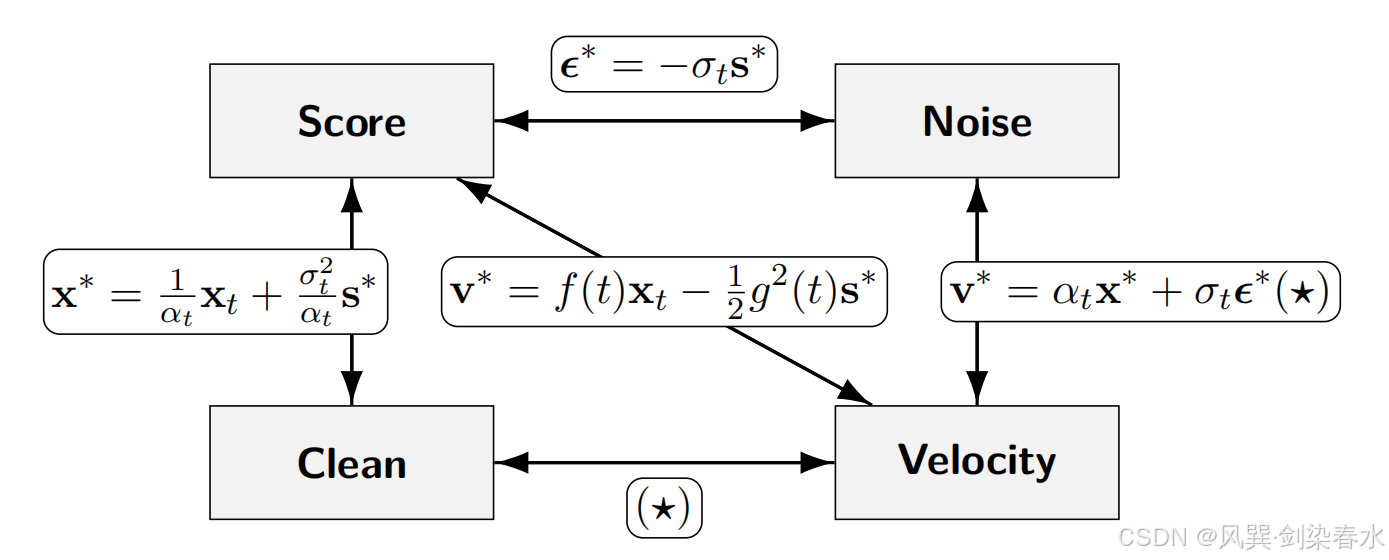
式 (6.3.1) 可在给定前向加噪系数的条件下,对任意时刻 t t t,在如下 4 种参数化模型输出之间建立一一映射关系:
ϵ ϕ ( x t , t ) , x ϕ ( x t , t ) , s ϕ ( x t , t ) , v ϕ ( x t , t ) . \boldsymbol{\epsilon}_\phi(\mathbf{x}t,t),\quad \mathbf{x}\phi(\mathbf{x}t,t),\quad \mathbf{s}\phi(\mathbf{x}t,t),\quad \mathbf{v}\phi(\mathbf{x}t,t). ϵϕ(xt,t),xϕ(xt,t),sϕ(xt,t),vϕ(xt,t).在实际应用中,仅采用一种参数化形式训练单个网络(例如 ϵ ϕ \boldsymbol{\epsilon}\phi ϵϕ),其余物理量均可通过式 (6.3.1) 的转换关系进行事后推导得到。
6.3.2 不同参数化形式下的 PF‑ODE(PF-ODE in Different Parameterizations)
PF‑ODE 可采用多种等价参数化形式(分数、噪声、去噪样本、速度 )。尽管上述形式在理论上可以相互转换,但参数化形式的选取会带来实际影响:其会改变向量场的刚性程度、离散化误差的变化特性以及优化的难易程度。
采用高阶常微分方程求解器实现快速采样(见第 9 章)时,研究人员通常选用 ϵ \boldsymbol{\epsilon} ϵ 预测或者 x \mathbf{x} x 预测(DPM solver采样);该类参数化形式与求解器输入适配性良好,能够降低误差累积。针对仅需少量函数求值的生成模型训练场景(见第 11 章), x \mathbf{x} x 预测或 v \mathbf{v} v 预测往往能够得到更平滑的目标函数,同时具备更优的步间一致性。
本文基于各类参数化形式写出 PF‑ODE,并借助式 (6.3.1) 显式给出不同形式之间的转换关系,相关结论汇总于下述命题。
命题 6.3.2 不同参数化形式下的 PF‑ODE
设 α t \alpha_t αt 与 σ t \sigma_t σt 为前向扰动调度,时间导数记为 α t ′ : = d α t d t \alpha_t' \mathrel{:=} \frac{\mathrm{d}\alpha_t}{\mathrm{d}t} αt′:=dtdαt, σ t ′ : = d σ t d t \sigma_t' \mathrel{:=} \frac{\mathrm{d}\sigma_t}{\mathrm{d}t} σt′:=dtdσt。则经验 PF‑ODE 具有如下等价形式:
d x ( t ) d t = α t ′ α t x ( t ) − σ t ( α t ′ α t − σ t ′ σ t ) ϵ ∗ ( x ( t ) , t ) = σ t ′ σ t x ( t ) + α t ( α t ′ α t − σ t ′ σ t ) x ∗ ( x ( t ) , t ) = α t ′ α t x ( t ) + σ t 2 ( α t ′ α t − σ t ′ σ t ) s ∗ ( x ( t ) , t ) = α t ′ x ∗ ( x ( t ) , t ) + σ t ′ ϵ ∗ ( x ( t ) , t ) = v ∗ ( x ( t ) , t ) . \begin{align} \frac{d\mathbf{x}(t)}{dt} &= \frac{\alpha_t'}{\alpha_t}\mathbf{x}(t) - \sigma_t \left( \frac{\alpha_t'}{\alpha_t} - \frac{\sigma_t'}{\sigma_t} \right) \boldsymbol{\epsilon}^*(\mathbf{x}(t), t) \notag \\ &= \frac{\sigma_t'}{\sigma_t}\mathbf{x}(t) + \alpha_t \left( \frac{\alpha_t'}{\alpha_t} - \frac{\sigma_t'}{\sigma_t} \right) \mathbf{x}^*(\mathbf{x}(t), t) \notag \\ &= \frac{\alpha_t'}{\alpha_t}\mathbf{x}(t) + \sigma_t^2 \left( \frac{\alpha_t'}{\alpha_t} - \frac{\sigma_t'}{\sigma_t} \right) \mathbf{s}^*(\mathbf{x}(t), t) \notag \\ &= \alpha_t'\mathbf{x}^*(\mathbf{x}(t), t) + \sigma_t'\boldsymbol{\epsilon}^*(\mathbf{x}(t), t) \notag \\ &= \mathbf{v}^*(\mathbf{x}(t), t). \tag{6.3.2} \end{align} dtdx(t)=αtαt′x(t)−σt(αtαt′−σtσt′)ϵ∗(x(t),t)=σtσt′x(t)+αt(αtαt′−σtσt′)x∗(x(t),t)=αtαt′x(t)+σt2(αtαt′−σtσt′)s∗(x(t),t)=αt′x∗(x(t),t)+σt′ϵ∗(x(t),t)=v∗(x(t),t).(6.3.2)
为得到分数随机微分方程(Score SDE)表达形式,回顾引理 4.4.1。令
f ( t ) = α t ′ α t , g 2 ( t ) = d d t ( σ t 2 ) − 2 α t ′ α t σ t 2 = 2 σ t σ t ′ − 2 α t ′ α t σ t 2 , f(t)=\frac{\alpha_t'}{\alpha_t},\quad g^2(t)=\frac{\mathrm{d}}{\mathrm{d}t}\big(\sigma_t^2\big)-2\frac{\alpha_t'}{\alpha_t}\sigma_t^2 =2\sigma_t\sigma_t'-2\frac{\alpha_t'}{\alpha_t}\sigma_t^2, f(t)=αtαt′,g2(t)=dtd(σt2)−2αtαt′σt2=2σtσt′−2αtαt′σt2,则 PF‑ODE 可写为熟知的分数 SDE 形式:
d x ( t ) d t = f ( t ) x ( t ) − 1 2 g 2 ( t ) s ∗ ( x ( t ) , t ) . \frac{\mathrm{d}\mathbf{x}(t)}{\mathrm{d}t}=f(t)\mathbf{x}(t)-\frac12 g^2(t)\mathbf{s}^{*}(\mathbf{x}(t),t). dtdx(t)=f(t)x(t)−21g2(t)s∗(x(t),t). 为直观说明采样过程中 PF‑ODE 的离散化实现方式,本文将在 9.2 节介绍一种广泛使用的扩散 ODE 采样器 ------DDIM 算法的更新规则。该示例将展示欧拉离散化与 PF‑ODE 之间的内在联系。
6.3.3 所有仿射流均相互等价(All Affine Flows Are Equivalent)
接下来分析式 (6.2.5) 中 (A) 部分的设计选择。
状态层面等价性。 流匹配(FM,Lipman 等人,2022)与射线流(RF,Liu,2022)中采用的标准插值形式为:
x t F M = ( 1 − t ) x 0 + t ϵ = x 0 + t ( ϵ − x 0 ) , \mathbf{x}_t^\mathrm{FM} = (1-t)\mathbf{x}_0 + t\boldsymbol{\epsilon} = \mathbf{x}_0 + t(\boldsymbol{\epsilon}-\mathbf{x}_0), xtFM=(1−t)x0+tϵ=x0+t(ϵ−x0), 其速度 为常向量 ϵ − x 0 \boldsymbol{\epsilon}-\mathbf{x}_0 ϵ−x0。本小节核心观点是:该形式看似简洁,但这一特性并非本质属性 ;任意仿射插值
x t = α t x 0 + σ t ϵ \mathbf{x}_t = \alpha_t \mathbf{x}_0 + \sigma_t \boldsymbol{\epsilon} xt=αtx0+σtϵ 均可表示为标准路径经过时间重参数化与尺度缩放后的形式。作如下定义:
c ( t ) : = α t + σ t , τ ( t ) : = σ t α t + σ t ( c ( t ) ≠ 0 ) . c(t) \mathrel{:=} \alpha_t+\sigma_t,\quad \tau(t)\mathrel{:=}\frac{\sigma_t}{\alpha_t+\sigma_t}\quad (c(t)\neq 0). c(t):=αt+σt,τ(t):=αt+σtσt(c(t)=0). 通过直接代数变形可得:
x t = α t x 0 + σ t ϵ = ( α t + σ t ) ( α t α t + σ t x 0 + σ t α t + σ t ϵ ) = c ( t ) ( ( 1 − τ ( t ) ) x 0 + τ ( t ) ϵ ) = c ( t ) x τ ( t ) F M . \begin{align*} \mathbf{x}_t &= \alpha_t \mathbf{x}_0 + \sigma_t \boldsymbol{\epsilon} \\ &= (\alpha_t+\sigma_t)\left( \frac{\alpha_t}{\alpha_t+\sigma_t}\mathbf{x}_0+\frac{\sigma_t}{\alpha_t+\sigma_t}\boldsymbol{\epsilon} \right) \\ &= c(t)\big((1-\tau(t))\mathbf{x}0+\tau(t)\boldsymbol{\epsilon}\big) = c(t)\,\mathbf{x}{\tau(t)}^\mathrm{FM}. \end{align*} xt=αtx0+σtϵ=(αt+σt)(αt+σtαtx0+αt+σtσtϵ)=c(t)((1−τ(t))x0+τ(t)ϵ)=c(t)xτ(t)FM.因此,任意仿射路径均可通过变量替换 t ↦ τ ( t ) t \mapsto \tau(t) t↦τ(t) 与空间重缩放 x ↦ c ( t ) x \mathbf{x} \mapsto c(t)\mathbf{x} x↦c(t)x,由标准流匹配(FM)路径映射得到。该等式逐点成立,故在分布意义下同样成立。
对于对应的速度场 ,对 x t = c ( t ) x τ ( t ) F M \mathbf{x}t = c(t)\mathbf{x}{\tau(t)}^{\mathrm{FM}} xt=c(t)xτ(t)FM 应用链式法则:
v ( x t , t ) : = d d t ( α t x 0 + σ t ϵ ) = d d t ( c ( t ) x τ ( t ) F M ) = c ′ ( t ) x τ ( t ) F M + c ( t ) τ ′ ( t ) d d s x s F M ∣ s = τ ( t ) = c ′ ( t ) x τ ( t ) F M + c ( t ) τ ′ ( t ) v F M ( x τ ( t ) F M , τ ( t ) ) , \begin{aligned} \mathbf{v}(\mathbf{x}t, t) &:= \frac{\mathrm{d}}{\mathrm{d}t}\left(\alpha_t \mathbf{x}0 + \sigma_t \boldsymbol{\epsilon}\right) \\ &= \frac{\mathrm{d}}{\mathrm{d}t}\big(c(t)\mathbf{x}{\tau(t)}^{\mathrm{FM}}\big) \\ &= c'(t)\mathbf{x}{\tau(t)}^{\mathrm{FM}} + c(t)\tau'(t)\left.\frac{\mathrm{d}}{\mathrm{d}s}\mathbf{x}{s}^{\mathrm{FM}}\right|{s=\tau(t)} \\ &= c'(t)\mathbf{x}{\tau(t)}^{\mathrm{FM}} + c(t)\tau'(t)\mathbf{v}^{\mathrm{FM}}\left(\mathbf{x}{\tau(t)}^{\mathrm{FM}},\tau(t)\right), \end{aligned} v(xt,t):=dtd(αtx0+σtϵ)=dtd(c(t)xτ(t)FM)=c′(t)xτ(t)FM+c(t)τ′(t)dsdxsFM s=τ(t)=c′(t)xτ(t)FM+c(t)τ′(t)vFM(xτ(t)FM,τ(t)),这是因为在标准路径上满足 v F M ( x τ F M , τ ) = − x 0 + ϵ \mathbf{v}^{\mathrm{FM}}(\mathbf{x}_\tau^{\mathrm{FM}},\tau) = -\mathbf{x}_0+\boldsymbol{\epsilon} vFM(xτFM,τ)=−x0+ϵ。
下文将上述推导整理为命题形式的正式结论。
命题 6.3.3:仿射流的等价性
设 x t F M = ( 1 − t ) x 0 + t ϵ \mathbf{x}{t}^{\mathrm{FM}} = (1-t)\mathbf{x}{0}+t\boldsymbol{\epsilon} xtFM=(1−t)x0+tϵ, x t = α t x 0 + σ t ϵ \mathbf{x}{t}=\alpha{t}\mathbf{x}{0}+\sigma{t}\boldsymbol{\epsilon} xt=αtx0+σtϵ,且定义 c ( t ) : = α t + σ t ≠ 0 c(t):=\alpha_{t}+\sigma_{t}\neq0 c(t):=αt+σt=0, τ ( t ) : = σ t / ( α t + σ t ) \tau(t):=\sigma_{t}/(\alpha_{t}+\sigma_{t}) τ(t):=σt/(αt+σt),则
x t = c ( t ) x τ ( t ) F M , v ( x t , t ) = c ′ ( t ) x τ ( t ) F M + c ( t ) τ ′ ( t ) v F M ( x τ ( t ) F M , τ ( t ) ) . (6.3.3) \begin{aligned} \mathbf{x}{t} &= c(t)\mathbf{x}{\tau(t)}^{\mathrm{FM}}, \\ \mathbf{v}(\mathbf{x}{t},t) &= c'(t)\mathbf{x}{\tau(t)}^{\mathrm{FM}} + c(t)\tau'(t)\mathbf{v}^{\mathrm{FM}}\big(\mathbf{x}_{\tau(t)}^{\mathrm{FM}},\tau(t)\big). \end{aligned} \tag{6.3.3} xtv(xt,t)=c(t)xτ(t)FM,=c′(t)xτ(t)FM+c(t)τ′(t)vFM(xτ(t)FM,τ(t)).(6.3.3)特别地,所有仿射插值在时间重参数化与空间重缩放意义下相互等价。
**与三角流的等价性。**三角插值是另一类被广泛使用的仿射流(Salimans 与 Ho,2021;Albergo 等人,2023;Lu 与 Song,2024)。作为具体实例,下文将证明任意仿射流均可写成该形式。三角路径定义为:
x u T r i g : = cos ( u ) x 0 + sin ( u ) ϵ . (6.3.4) \mathbf{x}{u}^{\mathrm{Trig}}:=\cos(u)\mathbf{x}{0}+\sin(u)\boldsymbol{\epsilon}. \tag{6.3.4} xuTrig:=cos(u)x0+sin(u)ϵ.(6.3.4)设 R t : = α t 2 + σ t 2 R_{t}:=\sqrt{\alpha_{t}^{2}+\sigma_{t}^{2}} Rt:=αt2+σt2 ,且满足 R t > 0 R_{t}>0 Rt>0。选取角度 τ t \tau_{t} τt,使得
cos τ t = α t R t , sin τ t = σ t R t . \cos\tau_{t}=\frac{\alpha_{t}}{R_{t}},\quad \sin\tau_{t}=\frac{\sigma_{t}}{R_{t}}. cosτt=Rtαt,sinτt=Rtσt.则任意仿射插值 x t = α t x 0 + σ t ϵ \mathbf{x}{t}=\alpha{t}\mathbf{x}{0}+\sigma{t}\boldsymbol{\epsilon} xt=αtx0+σtϵ 均可表示为经过缩放与时间重参数化 的三角路径:
x t = α t x 0 + σ t ϵ = R t ( α t R t x 0 + σ t R t ϵ ) = R t x τ t T r i g . (6.3.5) \mathbf{x}{t}=\alpha{t}\mathbf{x}{0}+\sigma{t}\boldsymbol{\epsilon}=R_{t}\left(\frac{\alpha_{t}}{R_{t}}\mathbf{x}{0}+\frac{\sigma{t}}{R_{t}}\boldsymbol{\epsilon}\right)=R_{t}\mathbf{x}{\tau{t}}^{\mathrm{Trig}}. \tag{6.3.5} xt=αtx0+σtϵ=Rt(Rtαtx0+Rtσtϵ)=RtxτtTrig.(6.3.5) ( α t , σ t ) (\alpha_{t},\sigma_{t}) (αt,σt) 可视为平面内的一个点。利用 R t R_{t} Rt 做归一化后,该点落在单位圆上,由此确定角度 τ t \tau_{t} τt,进而确定状态 x τ t T r i g \mathbf{x}{\tau{t}}^{\mathrm{Trig}} xτtTrig;而半径 R t R_{t} Rt 表征整体缩放尺度。
将 x u T r i g \mathbf{x}_{u}^{\mathrm{Trig}} xuTrig 对 u u u 求导,得到其速度:
v u T r i g = − sin ( u ) x 0 + cos ( u ) ϵ . \mathbf{v}{u}^{\mathrm{Trig}}=-\sin(u)\mathbf{x}{0}+\cos(u)\boldsymbol{\epsilon}. vuTrig=−sin(u)x0+cos(u)ϵ.采用与上式相同的变量替换,即可得到速度的闭式转换关系(其余参数化形式可同理推导)。
结论 6.3.1:无论调度 ( α t , σ t ) (\alpha_t,\sigma_t) (αt,σt) 取何种形式,包括 VE、VP(如三角形式)、FM 或 RF,各类仿射插值均可通过恰当的时间变量替换与标量重缩放实现相互转换。
**四种参数化形式的训练目标。**设 x t = α t x 0 + σ t ϵ \mathbf{x}_t=\alpha_t\mathbf{x}_0+\sigma_t\boldsymbol{\epsilon} xt=αtx0+σtϵ,其中 σ t > 0 \sigma_t>0 σt>0, ( α t , σ t ) (\alpha_t,\sigma_t) (αt,σt) 可微,且满足 α t ′ σ t − α t σ t ′ ≠ 0 \alpha_t'\sigma_t-\alpha_t\sigma_t'\neq0 αt′σt−αtσt′=0。定义理论最优目标:
ϵ ∗ ( x t , t ) = E ϵ ∣ x t , x 0 ∗ ( x t , t ) = E x 0 ∣ x t , v ∗ ( x t , t ) = E α t ′ x 0 + σ t ′ ϵ ∣ x t . \boldsymbol{\epsilon}^{*}(\mathbf{x}_t,t)=\mathbb{E}\big\\boldsymbol{\\epsilon}\\mid\\mathbf{x}_t\\big,\quad \mathbf{x}_0^{*}(\mathbf{x}_t,t)=\mathbb{E}\big\\mathbf{x}_0\\mid\\mathbf{x}_t\\big,\quad \mathbf{v}^{*}(\mathbf{x}_t,t)=\mathbb{E}\big\\alpha_t'\\mathbf{x}_0+\\sigma_t'\\boldsymbol{\\epsilon}\\mid\\mathbf{x}_t\\big. ϵ∗(xt,t)=Eϵ∣xt,x0∗(xt,t)=Ex0∣xt,v∗(xt,t)=Eαt′x0+σt′ϵ∣xt.根据命题 6.3.1,上述目标满足如下关系:
∇ x t log p t ( x t ) = − 1 σ t ϵ ∗ ( x t , t ) = α t σ t 2 ( x 0 ∗ ( x t , t ) − x t α t ) , v ∗ = α t ′ x 0 ∗ + σ t ′ ϵ ∗ . \nabla_{\mathbf{x}_t}\log p_t(\mathbf{x}_t)=-\frac{1}{\sigma_t}\boldsymbol{\epsilon}^{*}(\mathbf{x}_t,t) =\frac{\alpha_t}{\sigma_t^2}\left(\mathbf{x}_0^{*}(\mathbf{x}_t,t)-\frac{\mathbf{x}_t}{\alpha_t}\right),\quad \mathbf{v}^{*}=\alpha_t'\mathbf{x}_0^{*}+\sigma_t'\boldsymbol{\epsilon}^{*}. ∇xtlogpt(xt)=−σt1ϵ∗(xt,t)=σt2αt(x0∗(xt,t)−αtxt),v∗=αt′x0∗+σt′ϵ∗.在输出头转换关系
s ϕ ≡ − 1 σ t ϵ ϕ ≡ α t σ t 2 ( x ϕ − x t α t ) , \mathbf{s}\phi \equiv -\frac{1}{\sigma_t}\boldsymbol{\epsilon}\phi \equiv \frac{\alpha_t}{\sigma_t^2}\left(\mathbf{x}_\phi-\frac{\mathbf{x}_t}{\alpha_t}\right), sϕ≡−σt1ϵϕ≡σt2αt(xϕ−αtxt),以及速度‑分数转换公式
s ϕ = α t σ t ( α t ′ σ t − α t σ t ′ ) v ϕ − α t ′ σ t ( α t ′ σ t − α t σ t ′ ) x t , \mathbf{s}\phi=\frac{\alpha_t}{\sigma_t\left(\alpha_t'\sigma_t-\alpha_t\sigma_t'\right)}\mathbf{v}\phi-\frac{\alpha_t'}{\sigma_t\left(\alpha_t'\sigma_t-\alpha_t\sigma_t'\right)}\mathbf{x}_t, sϕ=σt(αt′σt−αtσt′)αtvϕ−σt(αt′σt−αtσt′)αt′xt,的作用下,各样本的平方损失仅相差与时间相关的权重因子,满足如下等式:
∥ s ϕ − ∇ x t log p t ( x t ) ∥ 2 2 = 1 σ t 2 ∥ ϵ ϕ − ϵ ∗ ∥ 2 2 = α t 2 σ t 4 ∥ x ϕ − x 0 ∗ ∥ 2 2 = ( α t σ t ( α t ′ σ t − α t σ t ′ ) ) 2 ∥ v ϕ − v ∗ ∥ 2 2 . (6.3.6) \begin{aligned} \big\|\mathbf{s}\phi-\nabla{\mathbf{x}_t}\log p_t(\mathbf{x}_t)\big\|2^2 &=\frac{1}{\sigma_t^2}\big\|\boldsymbol{\epsilon}\phi-\boldsymbol{\epsilon}^{*}\big\|2^2 \\ &=\frac{\alpha_t^2}{\sigma_t^4}\big\|\mathbf{x}\phi-\mathbf{x}_0^{*}\big\|2^2 \\ &=\left(\frac{\alpha_t}{\sigma_t\left(\alpha_t'\sigma_t-\alpha_t\sigma_t'\right)}\right)^2\big\|\mathbf{v}\phi-\mathbf{v}^{*}\big\|_2^2. \end{aligned} \tag{6.3.6} sϕ−∇xtlogpt(xt) 22=σt21 ϵϕ−ϵ∗ 22=σt4αt2 xϕ−x0∗ 22=(σt(αt′σt−αtσt′)αt)2 vϕ−v∗ 22.(6.3.6) 根据命题 6.3.3,任意仿射流 x t = α t x 0 + σ t ϵ \mathbf{x}_t=\alpha_t\mathbf{x}_0+\sigma_t\boldsymbol{\epsilon} xt=αtx0+σtϵ,均可借助 x t = c ( t ) x τ ( t ) F M \mathbf{x}t=c(t)\mathbf{x}{\tau(t)}^{\mathrm{FM}} xt=c(t)xτ(t)FM 映射为标准流匹配(FM)路径,其中 c ( t ) = α t + σ t c(t)=\alpha_t+\sigma_t c(t)=αt+σt, τ ( t ) = σ t / ( α t + σ t ) \tau(t)=\sigma_t/(\alpha_t+\sigma_t) τ(t)=σt/(αt+σt)。对该式求导可得
v ϕ ( x t , t ) = c ′ ( t ) x τ ( t ) F M + c ( t ) τ ′ ( t ) v ϕ F M ( x τ ( t ) F M , τ ( t ) ) , x τ ( t ) F M = x t c ( t ) , \mathbf{v}\phi(\mathbf{x}t,t)=c'(t)\mathbf{x}{\tau(t)}^{\mathrm{FM}}+c(t)\tau'(t)\mathbf{v}\phi^{\mathrm{FM}}\big(\mathbf{x}{\tau(t)}^{\mathrm{FM}},\tau(t)\big),\quad \mathbf{x}{\tau(t)}^{\mathrm{FM}}=\frac{\mathbf{x}_t}{c(t)}, vϕ(xt,t)=c′(t)xτ(t)FM+c(t)τ′(t)vϕFM(xτ(t)FM,τ(t)),xτ(t)FM=c(t)xt,该关系对理论最优速度场 v ∗ \mathbf{v}^{*} v∗ 同样成立。因此速度损失做如下变换:
∥ v ϕ ( x t , t ) − v ∗ ( x t , t ) ∥ 2 2 = ( c ( t ) τ ′ ( t ) ) 2 ∥ v ϕ F M ( x t c ( t ) , τ ( t ) ) − ( v F M ) ∗ ( x t c ( t ) , τ ( t ) ) ∥ 2 2 . \begin{aligned} \big\|\mathbf{v}_\phi(\mathbf{x}_t,t)-\mathbf{v}^{*}(\mathbf{x}_t,t)\big\|2^2 =\big(c(t)\tau'(t)\big)^2\left\|\mathbf{v}\phi^{\mathrm{FM}}\left(\frac{\mathbf{x}_t}{c(t)},\tau(t)\right) -\big(\mathbf{v}^{\mathrm{FM}}\big)^{*}\left(\frac{\mathbf{x}_t}{c(t)},\tau(t)\right)\right\|_2^2. \end{aligned} vϕ(xt,t)−v∗(xt,t) 22=(c(t)τ′(t))2 vϕFM(c(t)xt,τ(t))−(vFM)∗(c(t)xt,τ(t)) 22.基于上述推导,可以得到如下结论:
结论 6.3.2:分数、噪声、原始样本以及速度这四类训练目标,在理论意义下仅相差由 ( α t , σ t ) (\alpha_t,\sigma_t) (αt,σt) 决定的时间相关权重;对于速度目标,还额外包含一项与 x t \mathbf{x}_t xt 相关的输出头仿射变换,各类目标之间相互等价。
6.3.4 (选读)参数化形式与标准流的概念性分析((Optional) Conceptual Analysis of Parametrizations and the Canonical Flow)
尽管前文已经证明,四种参数化形式在数学上等价且可相互转换,同时前向仿射加噪流与如下标准形式等价
x t F M = ( 1 − t ) x 0 + t ϵ , \mathbf{x}{t}^{\mathrm{FM}}=(1-t)\mathbf{x}{0}+t\boldsymbol{\epsilon}, xtFM=(1−t)x0+tϵ,本小节将进一步给出直观解释,并分析将速度预测参数化与该标准仿射流结合所具备的潜在优势。
本小节探讨一个核心问题:不同的参数化形式与噪声调度会如何影响模型的学习内容与采样过程。 下文分三部分展开分析:
- 回归目标与噪声调度 :阐释将速度预测与标准线性调度 ( α t , σ t ) = ( 1 − t , t ) (\alpha_t,\sigma_t)=(1-t,t) (αt,σt)=(1−t,t) 相结合的内在合理性:该组合能够在全部时间步上维持目标量尺度稳定,消除动力学过程中的曲率效应。
- 对数值求解器的影响:分析该参数化形式与数值积分算法之间的概念关联;欧拉求解器、Heun 方法等具体实例将留至 9.2.2 节与 9.4.5 节展开介绍。
正式展开分析前,为避免概念混淆,本文区分两类速度场。条件速度 是可用于训练的可求解目标,其定义为
v t ( x t ∣ z ) = x t ′ = α t ′ x 0 + σ t ′ ϵ , 其中 z = ( x 0 , ϵ ) , \mathbf{v}_t(\mathbf{x}_t|\mathbf{z})=\mathbf{x}_t'=\alpha_t'\mathbf{x}_0+\sigma_t'\boldsymbol{\epsilon},\quad \text{其中}\ \mathbf{z}=(\mathbf{x}_0,\boldsymbol{\epsilon}), vt(xt∣z)=xt′=αt′x0+σt′ϵ,其中 z=(x0,ϵ),而理论最优(边缘)速度 用于 PF‑ODE 求解的推理阶段实现样本演化,定义如下:
v ∗ ( x , t ) = E v t ( ⋅ ∣ z ) ∣ x t = x . \mathbf{v}^{*}(\mathbf{x},t)=\mathbb{E}\big\\mathbf{v}_t(\\cdot\|\\mathbf{z})\\,\\big\|\\,\\mathbf{x}_t=\\mathbf{x}\\big. v∗(x,t)=Evt(⋅∣z) xt=x.
视角 1:为什么 ( α t , σ t ) = ( 1 − t , t ) (\alpha_t,\sigma_t)=(1-t,t) (αt,σt)=(1−t,t) 是一种自然调度。令时变函数 ρ ( t ) \rho(t) ρ(t),设 σ t : = ρ ( t ) \sigma_t:=\rho(t) σt:=ρ(t), α t : = 1 − ρ ( t ) \alpha_t:=1-\rho(t) αt:=1−ρ(t),则条件速度可写为(速度的方向就是"从图片指向噪声"的方向,大小由图片和噪声的差异决定)
v t ( x t ∣ z ) = ρ ′ ( t ) ( ϵ − x 0 ) , 其中 z = ( x 0 , ϵ ) . \mathbf{v}_t(\mathbf{x}_t|\mathbf{z})=\rho'(t)(\boldsymbol{\epsilon}-\mathbf{x}_0),\quad \text{其中}\ \mathbf{z}=(\mathbf{x}_0,\boldsymbol{\epsilon}). vt(xt∣z)=ρ′(t)(ϵ−x0),其中 z=(x0,ϵ).
-
单位尺度回归目标。对于标准调度 ρ ( t ) = t \rho(t)=t ρ(t)=t,条件速度 v t ( ⋅ ∣ z ) \mathbf{v}_t(\cdot|\mathbf{z}) vt(⋅∣z) 满足
E ∥ v t ( ⋅ ∣ z ) ∥ 2 2 = E ϵ ∥ ϵ ∥ 2 2 + E x 0 ∥ x 0 ∥ 2 2 = D + T r C o v x 0 ⏟ 总方差 + ∥ E x 0 ∥ 2 2 ⏟ 均值 . (6.3.7) \mathbb{E}\left\\\|\\mathbf{v}_t(\\cdot\|\\mathbf{z})\\\|_2\^2\\right =\mathbb{E}_{\boldsymbol{\epsilon}}\|\boldsymbol{\epsilon}\|2^2+\mathbb{E}{\mathbf{x}_0}\|\mathbf{x}_0\|2^2 =D+\underbrace{\mathrm{Tr}\,\mathrm{Cov}\\mathbf{x}_0}{\text{总方差}}+\underbrace{\|\mathbb{E}\mathbf{x}_0\|2^2}{\text{均值}}. \tag{6.3.7} E∥vt(⋅∣z)∥22=Eϵ∥ϵ∥22+Ex0∥x0∥22=D+总方差 TrCovx0+均值 ∥Ex0∥22.(6.3.7)因此,目标量的期望模长与时间 t t t 无关 。若将数据标准化为零均值、单位协方差(即 C o v x 0 = I \mathrm{Cov}\\mathbf{x}_0=\mathbf{I} Covx0=I),则对任意时刻 t t t, α t ′ x 0 \alpha_t'\mathbf{x}_0 αt′x0 与 σ t ′ ϵ \sigma_t'\boldsymbol{\epsilon} σt′ϵ 两项贡献量级相当,可避免端点处出现梯度爆炸或梯度消失。为说明该性质,考察扩散模型的训练目标:
L v e l o c i t y ( ϕ ) = E t E x 0 , ϵ ∥ v ϕ ( x t , t ) − v t ( x t ∣ z ) ∥ 2 2 . \mathcal{L}_{\mathrm{velocity}}(\phi)=\mathbb{E}t\mathbb{E}{\mathbf{x}_0,\boldsymbol{\epsilon}}\left\\left\\\|\\mathbf{v}_\\phi(\\mathbf{x}_t,t)-\\mathbf{v}_t(\\mathbf{x}_t\|\\mathbf{z})\\right\\\|_2\^2\\right. Lvelocity(ϕ)=EtEx0,ϵ∥vϕ(xt,t)−vt(xt∣z)∥22.由链式求导法则,该损失关于模型参数 ϕ \phi ϕ 的梯度为
∇ ϕ L v e l o c i t y ( ϕ ) = 2 E t E x 0 , ϵ ∂ ϕ v ϕ ( x t , t ) ⊤ ( v ϕ ( x t , t ) − v t ( x t ∣ z ) ) . \nabla_\phi\mathcal{L}_{\mathrm{velocity}}(\phi)=2\mathbb{E}t\mathbb{E}{\mathbf{x}_0,\boldsymbol{\epsilon}}\left\\partial_\\phi\\mathbf{v}_\\phi(\\mathbf{x}_t,t)\^\\top\\big(\\mathbf{v}_\\phi(\\mathbf{x}_t,t)-\\mathbf{v}_t(\\mathbf{x}_t\|\\mathbf{z})\\big)\\right. ∇ϕLvelocity(ϕ)=2EtEx0,ϵ∂ϕvϕ(xt,t)⊤(vϕ(xt,t)−vt(xt∣z)).由此可见,目标量 ∥ v t ( x t ∣ z ) ∥ 2 \|\mathbf{v}_t(\mathbf{x}t|\mathbf{z})\|2 ∥vt(xt∣z)∥2 的尺度会影响梯度稳定性;其余条件不变时,若该模长在某时刻 t t t 趋于 0(或趋于无穷),梯度将发生消失(或爆炸)。采用标准选取 ρ ( t ) = t \rho(t)=t ρ(t)=t,由式 (6.3.7) 可得目标模长与 t t t 相互独立,因此回归信号本身不会在端点( t = 0 t=0 t=0 或 t = 1 t=1 t=1)处发生幅值坍缩或激增(前提是 E ∥ ∂ ϕ v ϕ ( x t , t ) ∥ 2 \mathbb{E}\|\partial\phi\mathbf{v}\phi(\mathbf{x}_t,t)\|^2 E∥∂ϕvϕ(xt,t)∥2 与时间权重均处于可控范围)。
-
标准调度与速度预测的相互作用。对于仿射路径 x t = α t x 0 + σ t ϵ x_t = \alpha_t x_0 + \sigma_t \epsilon xt=αtx0+σtϵ,理论最优速度 可分解为:
v ∗ ( x , t ) = α t ′ x ∗ ( x , t ) + σ t ′ ϵ ∗ ( x , t ) \boldsymbol{v}^{*}(\mathbf{x}, t)=\alpha_{t}^{\prime} \mathbf{x}^{*}(\mathbf{x}, t)+\sigma_{t}^{\prime} \boldsymbol{\epsilon}^{*}(\mathbf{x}, t) v∗(x,t)=αt′x∗(x,t)+σt′ϵ∗(x,t)其中 x ∗ = E x 0 ∣ x t = x \mathbf{x}^{*}=\mathbb{E}\left\\mathbf{x}_{0} \| \\mathbf{x}_{t}=\\mathbf{x}\\right x∗=Ex0∣xt=x, ϵ ∗ = E ϵ ∣ x t = x \boldsymbol{\epsilon}^{*}=\mathbb{E}\left\\boldsymbol{\\epsilon} \| \\mathbf{x}_{t}=\\mathbf{x}\\right ϵ∗=Eϵ∣xt=x。在固定 x \mathbf{x} x 下对时间求导可得:
∂ t v t ∗ = α t ′ ′ x ∗ + σ t ′ ′ ϵ ∗ ⏟ schedule curvature + α t ′ ∂ t x ∗ + σ t ′ ∂ t ϵ ∗ \partial_{t} \mathbf{v}{t}^{*}=\underbrace{\alpha{t}^{\prime \prime} \mathbf{x}^{*}+\sigma_{t}^{\prime \prime} \boldsymbol{\epsilon}^{*}}{\text{schedule curvature}}+\alpha{t}^{\prime} \partial_{t} \mathbf{x}^{*}+\sigma_{t}^{\prime} \partial_{t} \boldsymbol{\epsilon}^{*} ∂tvt∗=schedule curvature αt′′x∗+σt′′ϵ∗+αt′∂tx∗+σt′∂tϵ∗采用线性调度 α t = 1 − t \alpha_t = 1-t αt=1−t、 σ t = t \sigma_t = t σt=t 时,曲率项消失( α t ′ ′ = σ t ′ ′ = 0 \alpha_t''=\sigma_t''=0 αt′′=σt′′=0)。此时 v t ∗ \boldsymbol{v}_t^* vt∗ 的时间变化主要来源于后验演化项 ( ∂ t x ∗ , ∂ t ϵ ∗ ) \left(\partial_t\mathbf{x}^*,\partial_t\boldsymbol{\epsilon}^*\right) (∂tx∗,∂tϵ∗),而非调度本身。该特性在速度预测中表现尤为突出:系数 α t ′ \alpha_t' αt′、 σ t ′ \sigma_t' σt′ 均为常数(分别为 − 1 -1 −1 与 + 1 +1 +1),避免漂移项中引入额外与时间 t t t 相关的缩放因子。与之相比,分数参数化、 x 0 \mathbf{x}_0 x0 参数化与 ϵ \boldsymbol{\epsilon} ϵ 参数化往往会引入 σ t ′ / σ t \sigma_t'/\sigma_t σt′/σt、 α t ′ / α t \alpha_t'/\alpha_t αt′/αt 这类比值项;即便使用线性调度,这类比值在时间端点附近也会发生剧烈变化。因此,尽管并非唯一可行方案,线性 ( 1 − t , t ) (1-t,t) (1−t,t) 调度搭配速度预测,能够使理论最优速度具备格外稳定且物理含义清晰的时间依赖关系。(在训练扩散模型时,只要用线性调度 ( 1 − t , t ) (1-t,t) (1−t,t) 搭配速度预测,就能让训练过程最稳、最不容易崩溃。)
-
条件能量最小化。接下来我们从最优传输的理论视角展开分析(参见第 7 章)。其中,条件动能 用于量化条件速度沿前向路径的总期望运动,即从 x 0 \mathbf{x}_0 x0 演化至 ϵ \boldsymbol{\epsilon} ϵ 所需的瞬时移动量(也称为动能损耗),其定义为:
K ρ : = ∫ 0 1 E x 0 , ϵ ∥ v t ( ⋅ ∣ z ) ∥ 2 2 d t = ( D + T r C o v x 0 + ∥ E x 0 ∥ 2 2 ) ∫ 0 1 ( ρ ′ ( t ) ) 2 d t \mathcal{K}\\rho:= \int_{0}^{1} \mathbb{E}{\mathbf{x}{0},\boldsymbol{\epsilon}}\big\\\|\\mathbf{v}_{t}(\\cdot \| \\mathbf{z})\\\|_{2}\^{2}\\big \mathrm{d}t = \Big(D + \mathrm{Tr}\,\mathrm{Cov}\\mathbf{x}_{0} + \|\mathbb{E}\mathbf{x}{0}\|{2}^{2}\Big)\int_{0}^{1} \big(\rho'(t)\big)^{2} \mathrm{d}t Kρ:=∫01Ex0,ϵ∥vt(⋅∣z)∥22dt=(D+TrCovx0+∥Ex0∥22)∫01(ρ′(t))2dt因此,最小化 K ρ \mathcal{K}\\rho Kρ 等价于在期望意义下求解最平滑、能量最低 的演化路径。在边界条件 ρ ( 0 ) = 0 \rho(0)=0 ρ(0)=0、 ρ ( 1 ) = 1 \rho(1)=1 ρ(1)=1 的约束下,欧拉‑拉格朗日方程 ρ ′ ′ ( t ) = 0 \rho''(t)=0 ρ′′(t)=0 的最优解为 ρ ( t ) = t \rho(t)=t ρ(t)=t,对应直线型条件演化路径。该结果表明,在所有连接 x 0 \mathbf{x}_0 x0 与 ϵ \boldsymbol{\epsilon} ϵ 的光滑插值路径中,标准流 ρ ( t ) = t \rho(t)=t ρ(t)=t 是二者之间能量消耗最低的演化方式。我们将在命题 7.5.1 中对该结论做更为详尽的推导说明。
-
关于理论最优速度的注释。倘若我们改用边缘速度定义能量:
∫ 0 1 E x t ∥ v ∗ ( x t , t ) ∥ 2 d t \int_{0}^{1}\mathbb{E}{\mathbf{x}{t}}\left\\left\\\|\\mathbf{v}\^{\*}\\left(\\mathbf{x}_{t},t\\right)\\right\\\|\^{2}\\right\mathrm{d}t ∫01Ext∥v∗(xt,t)∥2dt令 z = ( x 0 , ϵ ) \mathbf{z}=(\mathbf{x}{0},\boldsymbol{\epsilon}) z=(x0,ϵ),且 v t ( x t ∣ z ) = ρ ′ ( t ) ( ϵ − x 0 ) \mathbf{v}{t}(\mathbf{x}{t}|\mathbf{z})=\rho'(t)(\boldsymbol{\epsilon}-\mathbf{x}{0}) vt(xt∣z)=ρ′(t)(ϵ−x0),则
v ∗ ( x , t ) = E v t ( ⋅ ∣ z ) ∣ x t = x = ρ ′ ( t ) E ϵ − x 0 ∣ x t = x \mathbf{v}^{*}(\mathbf{x},t)=\mathbb{E}\big\\mathbf{v}_{t}(\\cdot\|\\mathbf{z})\\big\|\\mathbf{x}_{t}=\\mathbf{x}\\big=\rho'(t)\mathbb{E}\big\\boldsymbol{\\epsilon}-\\mathbf{x}_{0}\\big\|\\mathbf{x}_{t}=\\mathbf{x}\\big v∗(x,t)=Evt(⋅∣z) xt=x=ρ′(t)Eϵ−x0 xt=x由此可得边缘速度对应的能量表达式:
∫ 0 1 E x t ∼ p t ∥ v ∗ ( x t , t ) ∥ 2 2 d t = ∫ 0 1 E x t ∥ ρ ′ ( t ) E \[ ϵ − x 0 ∣ x t ∥ 2 2 ] d t = ∫ 0 1 ( ρ ′ ( t ) ) 2 κ ( t ) d t \int_{0}^{1}\mathbb{E}{\mathbf{x}{t}\sim p_{t}}\left\\left\\\|\\mathbf{v}\^{\*}(\\mathbf{x}_{t},t)\\right\\\|_{2}\^{2}\\right\mathrm{d}t =\int_{0}^{1}\mathbb{E}{\mathbf{x}{t}}\left\\left\\\|\\rho'(t)\\mathbb{E}\\big\[\\boldsymbol{\\epsilon}-\\mathbf{x}_{0}\\big\|\\mathbf{x}_{t}\\big\right\|{2}^{2}\right]\mathrm{d}t =\int{0}^{1}\big(\rho'(t)\big)^{2}\kappa(t)\mathrm{d}t ∫01Ext∼pt∥v∗(xt,t)∥22dt=∫01Ext ρ′(t)E\[ϵ−x0 xt 22]dt=∫01(ρ′(t))2κ(t)dt其中 κ ( t ) : = E x t ∼ p t ∥ E \[ ϵ − x 0 ∣ x t ∥ 2 2 ] \kappa(t):=\mathbb{E}{\mathbf{x}{t}\sim p_{t}}\left\\left\\\|\\mathbb{E}\\big\[\\boldsymbol{\\epsilon}-\\mathbf{x}_{0}\\big\|\\mathbf{x}_{t}\\big\right\|_{2}^{2}\right] κ(t):=Ext∼pt E\[ϵ−x0 xt 22]因此,边缘最优调度 ρ ( t ) \rho(t) ρ(t) 未必为线性函数。仅当 κ ( t ) \kappa(t) κ(t) 为常数时,调度才取线性形式。一般情形下,欧拉‑拉格朗日条件
( κ ( t ) ρ ′ ( t ) ) ′ = 0 ⟹ ρ ′ ( t ) ∝ 1 κ ( t ) \big(\kappa(t)\rho'(t)\big)'=0 \implies \rho'(t) \propto \frac{1}{\kappa(t)} (κ(t)ρ′(t))′=0⟹ρ′(t)∝κ(t)1表明理论最优调度对时间执行自适应重参数化。直观上, κ ( t ) \kappa(t) κ(t) 衡量可由 x t ∼ p t \mathbf{x}_t\sim p_t xt∼pt 预测标签 ( ϵ − x 0 ) (\boldsymbol{\epsilon}-\mathbf{x}_0) (ϵ−x0) 的程度:当 κ ( t ) \kappa(t) κ(t) 取值较大时,理论流的演化速度会降低,对应理论最优速度期望模长较大的区间;当 κ ( t ) \kappa(t) κ(t) 取值较小时,则加快演化速度。由此可见,即便条件流采用线性调度 ( 1 − t , t ) (1-t,t) (1−t,t),其对应的边缘化(理论最优)动力学一般仍为非线性。
视角 2:速度预测用于采样的内在合理性。
-
基于 x \mathbf{x} x、 ϵ \boldsymbol{\epsilon} ϵ 与分数预测下 PF‑ODE 的半线性形式。在干净样本、噪声与分数参数化方式下,漂移项具备半线性形式 (参见式 (6.3.2) 前三项恒等式):
d x ( t ) d t = L ( t ) x ( t ) ⏟ 线性部分 + N ϕ ( x ( t ) , t ) ⏟ 非线性 part , N ϕ ∈ { x ϕ , ϵ ϕ , s ϕ } \frac{\mathrm{d}\mathbf{x}(t)}{\mathrm{d}t}= \underbrace{L(t)\mathbf{x}(t)}{\text{线性部分}}+\underbrace{\mathbf{N}{\phi}(\mathbf{x}(t),t)}{\text{非线性 part}},\quad \mathbf{N}{\phi}\in\{\mathbf{x}{\phi},\boldsymbol{\epsilon}{\phi},\mathbf{s}_{\phi}\} dtdx(t)=线性部分 L(t)x(t)+非线性 part Nϕ(x(t),t),Nϕ∈{xϕ,ϵϕ,sϕ}若线性漂移 L ( t ) x ( t ) L(t)\mathbf{x}(t) L(t)x(t) 与非线性部分沿不同方向驱动 x ( t ) \mathbf{x}(t) x(t) 的演化速率差异悬殊,则该系统属于刚性系统 。即漂移项关于 x \mathbf{x} x 的雅可比矩阵
J ( x , t ) : = L ( t ) + ∇ x N ϕ ( x , t ) \mathbf{J}(\mathbf{x},t):= L(t)+\nabla_{\mathbf{x}}\mathbf{N}_{\phi}(\mathbf{x},t) J(x,t):=L(t)+∇xNϕ(x,t)其特征值实部相差多个数量级(模值越大对应演化方向越快)。例如, x ( t ) \mathbf{x}(t) x(t) 的动力学过程可同时包含 "快速线性" 变化与 "缓慢非线性" 变化。该场景下,显式求解器必须采用极小的时间步长,方可保证数值稳定性。
为解决这种速率失衡问题,高阶稳定求解器通常引入积分因子 :对线性项 L ( t ) x L(t)\mathbf{x} L(t)x 做解析处理,仅对变化较慢的非线性余项执行离散化;但该方法会提升代数运算与代码实现的复杂度。第 9 章将针对该内容展开详细讨论。
-
v 预测下的 PF‑ODE。采用 v 预测时,模型直接学习速度场并完成积分运算:
d x ( t ) d t = v ϕ ( x ( t ) , t ) ≈ v ∗ ( x ( t ) , t ) \frac{\mathrm{d}\mathbf{x}(t)}{\mathrm{d}t}= \mathbf{v}{\phi}(\mathbf{x}(t),t)\approx \mathbf{v}^{*}(\mathbf{x}(t),t) dtdx(t)=vϕ(x(t),t)≈v∗(x(t),t)在该表达形式中,显式线性项被吸收至单一的待学习场中,动力学不再拆分为相互独立的组成部分。因此,积分步长由学习得到的场 v ϕ ( x , t ) \mathbf{v}{\phi}(\mathbf{x},t) vϕ(x,t) 关于 x \mathbf{x} x 和 t t t 的光滑程度决定,而不再受预先设定的标量系数 L ( t ) L(t) L(t) 的幅值约束。换言之,原本变化剧烈的线性漂移被整合到统一的速度场内部,缩小了系统内部时间尺度的差异,从而降低数值积分的求解难度。
在 9.2.2 节中,本文将通过简单算例说明 v 预测在采样过程中具备结构简洁的特点。若要使 PF‑ODE 获得与 DDIM(扩散模型应用最广泛的快速采样器之一,Song 等人,2020a)完全一致的离散更新形式,在 ϵ \epsilon ϵ、 x \mathbf{x} x 或 s \mathbf{s} s 参数化下,普通欧拉步仅能对线性项做近似处理,无法实现精确计算(见公式 9.1.8 9.1.8 9.1.8)。因此,上述参数化需要采用更复杂的指数积分器,才能够分离并精确求解线性项。与之不同,采用 v 预测时,PF‑ODE 漂移项不存在需要单独分离的线性项,普通欧拉更新即可自然等价于 DDIM 的表达形式。
9.4.5 节还给出一个高度相关的类比:二阶 DPM‑Solver(Lu 等人,2022b)与经典休恩(Heun)方法具有对应关系。对于 v 预测,该算法即为普通休恩法;而对于 ϵ \epsilon ϵ、 x \mathbf{x} x 或 s \mathbf{s} s 预测,则对应指数休恩法。详细分析将放在对应章节展开。
需要说明的是,生成效果的提升(例如在 PF‑ODE 求解过程中,以更少的模型调用获得更高的样本质量)取决于两方面:一是 v ϕ \mathbf{v}_\phi vϕ 对理论最优速度场的逼近精度;二是采样算法(包含数值积分器、离散调度、步长控制)与模型的适配能力。 因此,仅采用 v 参数化本身,并不能保证采样性能得到提升。(理论上速度预测最好)
结论。尽管 v 预测结合标准线性调度具备若干理论优势,例如目标幅值恒定、调度不存在曲率,但上述性质并不意味着该方案在所有场景下都更优 。在实际应用中,模型性能受多种相互耦合的因素影响,包括网络架构、归一化方案、时间维度上的损失权重、采样器与离散步数的选取、引导强度、正则化策略、数据缩放以及整体训练开销。
不同数据集与任务目标可能更适配其他参数化方式或调度方案;最优配置本质上属于经验问题,需要通过验证实验与消融研究来确定。(工程经验,懂得都懂(●'◡'●))
6.4 底层理论:福克 - 普朗克方程(Beneath It All: The Fokker--Planck Equation)
**Figure 6.2 | 通过连续性方程建立变分形式、随机微分方程(SDE)与常微分方程(ODE)的统一框架,所有 p t ( x ) p_t(\mathbf{x}) pt(x) 在同一动力学规则下演化。**速度场: v ∗ ( x , t ) = f ( t ) x − 1 2 g 2 ( t ) s ∗ ( x , t ) \mathbf{v}^{*}(\mathbf{x}, t)=f(t)\mathbf{x}-\frac{1}{2}g^{2}(t)\mathbf{s}^{*}(\mathbf{x}, t) v∗(x,t)=f(t)x−21g2(t)s∗(x,t) 由分数函数 s ∗ ( x , t ) : = ∇ x log p t ( x ) \mathbf{s}^{*}(\mathbf{x}, t):=\nabla_{\mathbf{x}}\log p_t(\mathbf{x}) s∗(x,t):=∇xlogpt(x) 决定。系数 f ( t ) , g ( t ) , σ t , α t f(t),g(t),\sigma_t,\alpha_t f(t),g(t),σt,αt 为预先定义的时变函数, γ ( t ) \gamma(t) γ(t) 为可调节的时变超参数。
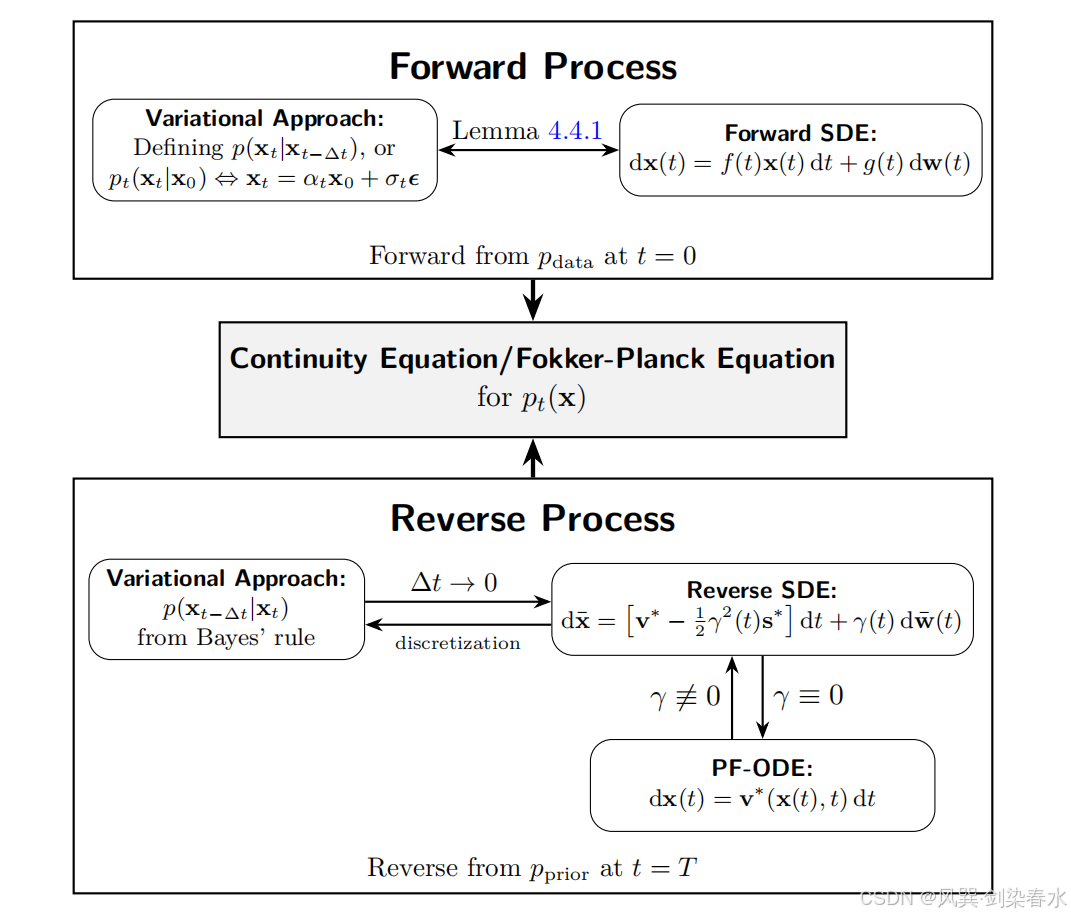
本节将说明,扩散模型的三大主流视角 ------ 变分视角、基于分数的视角与基于流的视角 ------ 并非相互独立的理论体系,而是源自同一个统一原理:控制前向过程下密度演化的连续性方程,即福克 - 普朗克方程。
首先回顾第 4.5 节的分析,该部分将基于离散核与贝叶斯法则的变分视角,和描述连续动力学的基于分数随机微分方程(SDE)视角进行统一。本文通过证明变分模型是底层前向与反向随机微分方程的自洽离散形式,建立二者之间的联系。具体而言,通过离散核逐步计算得到的边缘密度,其演化规律与刻画连续时间动力学的福克 - 普朗克方程保持一致。这一结论证明两种视角在本质上等价。
随后,本文建立基于流的视角与基于分数的视角之间的关联。在 6.4.1 节中将证明,常微分方程流能够确定一条密度演化路径,该路径对应的边缘分布总能由一族随机过程实现。这使得确定性流与随机 SDE 可归属于同一理论体系。
综上,上述结果将三类视角统一至同一框架下(见 图 6.2)。最后,将在 6.5 节对本章进行总结。
6.4.1 基于流的方法与分数随机微分方程的联系(Connection of Flow-Based Approach and Score SDE)
扩散模型一个突出的特点是:不同动力学系统(无论确定性系统还是随机系统)可以实现完全相同的概率分布演化。本节将揭示 5.2 节中基于常微分方程的流模型 与分数随机微分方程 之间简洁自然的内在联系。具体而言,**本文证明:生成式常微分方程所定义的速度场,能够转化为满足相同福克 - 普朗克动力学的随机对应形式,从而在确定性插值与随机采样之间建立严谨的理论桥梁。**由此可以得到一组连续的模型族,涵盖从常微分方程到随机微分方程,它们均可生成相同的数据分布路径。
本文考虑连续时间设定,其扰动核定义为
p t ( x t ∣ x 0 ) = N ( x t ; α t x 0 , σ t 2 I ) , p_t(\mathbf{x}_t|\mathbf{x}_0)=\mathcal{N}(\mathbf{x}_t;\alpha_t\mathbf{x}0,\sigma_t^2\mathbf{I}), pt(xt∣x0)=N(xt;αtx0,σt2I),其中 x 0 ∼ p data \mathbf{x}0 \sim p{\text{data}} x0∼pdata。如常规设定,该条件分布诱导出边缘密度路径 p t ( x t ) = E x 0 ∼ p data p ( x t ∣ x 0 ) p_t(\mathbf{x}t)=\mathbb{E}{\mathbf{x}0\sim p{\text{data}}}p(\\mathbf{x}_t\|\\mathbf{x}_0) pt(xt)=Ex0∼pdatap(xt∣x0),且满足 p T ≈ p prior p_T \approx p{\text{prior}} pT≈pprior。
为匹配该密度路径,考虑如下常微分方程:
d x ( t ) d t = v t ( x ( t ) ) , t ∈ 0 , T , (6.4.1) \frac{\mathrm{d}\mathbf{x}(t)}{\mathrm{d}t}=\mathbf{v}_t(\mathbf{x}(t)),\quad t\in0,T, \tag{6.4.1} dtdx(t)=vt(x(t)),t∈0,T,(6.4.1)式中 v t ( x ) = E α t ′ x 0 + σ t ′ ϵ \| x \mathbf{v}t(\mathbf{x}) = \mathbb{E}\left\\alpha_t'\\mathbf{x}_0+\\sigma_t'\\boldsymbol{\\epsilon}\\middle\|\\mathbf{x}\\right vt(x)=Eαt′x0+σt′ϵ∣x 为 5.2.10 式给出的理论最优速度场(注意此处时间已按照扩散模型惯例进行翻转)。从 x ( T ) ∼ p prior \mathbf{x}(T)\sim p{\text{prior}} x(T)∼pprior 反向积分该方程,即可得到服从 p 0 p_0 p0 的样本。
尽管该常微分方程足以生成高质量样本,但引入随机性能够提升样本多样性。由此引出下述问题:
问题 6.4.1。是否存在一个随机微分方程(SDE),其动力学过程从 p prior p_{\text{prior}} pprior 出发,可以得到与式 (6.4.1) 中的常微分方程完全相同的边缘密度?
该结论表明:存在一族逆时随机微分方程,其诱导出的边缘密度路径与对应的 PF-ODE 完全一致。由这些随机微分方程生成的密度满足该路径下同一个福克 - 普朗克方程 ,因此它们的单时刻边缘分布与预设插值序列 { p t } t ∈ 0 , T \{p_t\}_{t\in0,T} {pt}t∈0,T 保持一致。
命题 6.4.1:逆时随机微分方程可生成与插值相同的边缘分布
设 γ ( t ) ≥ 0 \gamma(t) \ge 0 γ(t)≥0 为任意时变系数。考虑逆时随机微分方程
d x ˉ ( t ) = v ∗ ( x ˉ ( t ) , t ) − 1 2 γ 2 ( t ) s ∗ ( x ˉ ( t ) , t ) d t ˉ + γ ( t ) d w ˉ ( t ) , (6.4.2) \mathrm{d}\bar{\mathbf{x}}(t)=\left\\mathbf{v}\^{\*}(\\bar{\\mathbf{x}}(t),t)-\\frac12\\gamma\^{2}(t)\\mathbf{s}\^{\*}(\\bar{\\mathbf{x}}(t),t)\\right\mathrm{d}\bar{t}+\gamma(t)\mathrm{d}\bar{\mathbf{w}}(t), \tag{6.4.2} dxˉ(t)=v∗(xˉ(t),t)−21γ2(t)s∗(xˉ(t),t)dtˉ+γ(t)dwˉ(t),(6.4.2)该过程从 x ˉ ( T ) ∼ p T \bar{\mathbf{x}}(T)\sim p_T xˉ(T)∼pT 反向演化至 t = 0 t=0 t=0。则该过程 { x ˉ ( t ) } t ∈ 0 , T \{\bar{\mathbf{x}}(t)\}{t\in0,T} {xˉ(t)}t∈0,T 与由常微分方程密度路径诱导的预设边缘分布 { p t } t ∈ 0 , T \{p_t\}{t\in0,T} {pt}t∈0,T 保持一致。式中, s ( x , t ) : = ∇ x log p t ( x ) \mathbf{s}(\mathbf{x},t):=\nabla_{\mathbf{x}}\log p_t(\mathbf{x}) s(x,t):=∇xlogpt(x) 为分数函数,其与速度场 v ( x , t ) \mathbf{v}(\mathbf{x},t) v(x,t) 满足如下关系:
v ∗ ( x , t ) = f ( t ) x − 1 2 g 2 ( t ) s ∗ ( x , t ) , s ∗ ( x , t ) = 1 σ t α t v ∗ ( x , t ) − α t ′ x α t ′ σ t − α t σ t ′ . (6.4.3) \mathbf{v}^{*}(\mathbf{x},t)=f(t)\mathbf{x}-\frac12g^{2}(t)\mathbf{s}^{*}(\mathbf{x},t),\quad \mathbf{s}^{*}(\mathbf{x},t)=\frac{1}{\sigma_t}\frac{\alpha_t\mathbf{v}^{*}(\mathbf{x},t)-\alpha_t'\mathbf{x}}{\alpha_t'\sigma_t-\alpha_t\sigma_t'}. \tag{6.4.3} v∗(x,t)=f(t)x−21g2(t)s∗(x,t),s∗(x,t)=σt1αt′σt−αtσt′αtv∗(x,t)−αt′x.(6.4.3)
命题证明
式 (6.4.2) 对应的逆时福克 - 普朗克方程为
∂ t p = − ∇ ⋅ ( v ∗ − 1 2 γ 2 s ∗ p ) + 1 2 γ 2 Δ p \partial_t p=-\nabla\cdot\left(\left\\mathbf{v}\^{\*}-\\frac12\\gamma\^{2}\\mathbf{s}\^{\*}\\rightp\right)+\frac12\gamma^{2}\Delta p ∂tp=−∇⋅(v∗−21γ2s∗p)+21γ2Δp利用恒等式 ∇ ⋅ ( s ∗ p ) = Δ p \nabla\cdot(\mathbf{s}^{*}p)=\Delta p ∇⋅(s∗p)=Δp(由 s ∗ = ∇ log p \mathbf{s}^{*}=\nabla\log p s∗=∇logp 可得),二阶项相互抵消,得到
∂ t p = − ∇ ⋅ ( v ∗ p ) \partial_t p=-\nabla\cdot\left(\mathbf{v}^{*}p\right) ∂tp=−∇⋅(v∗p)该式即为 PF-ODE 对应的一阶(仅含漂移项)福克 - 普朗克方程。因此该逆时随机微分方程与常微分方程将诱导出相同的边缘密度路径 { p t } \{p_t\} {pt}。证明详见 Ma 等人(2024)论文附录 A.2--A.3。
超参数 γ ( t ) \gamma(t) γ(t) 可任意选取,与 α t \alpha_t αt、 σ t \sigma_t σt 相互独立;即便完成训练后仍可调整该参数,因为它不会改变速度场 v ( x , t ) \mathbf{v}(\mathbf{x},t) v(x,t) 与分数函数 s ( x , t ) \mathbf{s}(\mathbf{x},t) s(x,t)。下面给出若干示例:
- 令 γ ( t ) = 0 \gamma(t)=0 γ(t)=0,即可还原得到式 (6.4.1) 中的常微分方程。
- 当 γ ( t ) = g ( t ) \gamma(t)=g(t) γ(t)=g(t) 时,式 (6.4.2) 退化为式 (4.1.6) 中的逆时随机微分方程。这是由于理论最优速度场 v ( x , t ) \mathbf{v}(\mathbf{x},t) v(x,t) 满足(参见命题 6.3.1):
v ∗ ( x , t ) = f ( t ) x − 1 2 g 2 ( t ) s ∗ ( x , t ) . \mathbf{v}^{*}(\mathbf{x},t)=f(t)\mathbf{x}-\frac12g^{2}(t)\mathbf{s}^{*}(\mathbf{x},t). v∗(x,t)=f(t)x−21g2(t)s∗(x,t). - 研究人员也探究了 γ ( t ) \gamma(t) γ(t) 的其他取值方案。例如,Ma 等人(2024)选取 γ ( t ) \gamma(t) γ(t),以最小化真实数据分布 p data p_{\text{data}} pdata 与从时刻 t = T t=T t=T 求解式 (6.4.2) 得到的 t = 0 t=0 t=0 时刻密度之间的 KL 散度。
参照分数随机微分方程(Score SDE)框架,训练得到的速度场 v ϕ × ( x , t ) \mathbf{v}{\phi^{×}}(\mathbf{x},t) vϕ×(x,t) 可通过式 (6.4.3) 转换为参数化分数函数 s ϕ × ( x , t ) \mathbf{s}{\phi^{×}}(\mathbf{x},t) sϕ×(x,t)。将其代入式 (6.4.2),即可得到经验逆时随机微分方程;该方程可从 t = T t=T t=T 处出发进行数值积分采样,初始条件满足 x ˉ ( T ) ∼ p prior \bar{\mathbf{x}}(T)\sim p_{\text{prior}} xˉ(T)∼pprior。
该命题揭示了扩散模型具备极强的灵活性:一旦边缘密度路径 { p t } t ∈ 0 , T \{p_t\}_{t\in0,T} {pt}t∈0,T 确定,存在一整套动力学过程均可复现该密度路径,其中包含 PF-ODE 与逆时随机微分方程:
d x ˉ ( t ) = v ∗ ( x ˉ , t ) − 1 2 γ 2 ( t ) s ∗ ( x ˉ , t ) d t ˉ + γ ( t ) d w ˉ ( t ) , γ ( t ) ≥ 0. \mathrm{d}\bar{\mathbf{x}}(t)=\left\\mathbf{v}\^{\*}(\\bar{\\mathbf{x}},t)-\\frac12\\gamma\^{2}(t)\\mathbf{s}\^{\*}(\\bar{\\mathbf{x}},t)\\right\mathrm{d}\bar{t}+\gamma(t)\mathrm{d}\bar{\mathbf{w}}(t),\quad \gamma(t)\ge 0. dxˉ(t)=v∗(xˉ,t)−21γ2(t)s∗(xˉ,t)dtˉ+γ(t)dwˉ(t),γ(t)≥0.所有这类动力学过程均满足同一个逆时福克 - 普朗克方程,因此会产生完全一致的边缘演化规律。函数 γ ( t ) \gamma(t) γ(t) 能够连续调节随机性强度,且不会改变各时刻边缘分布。这一结论揭示了确定性基于流的常微分方程与其对应的随机微分方程之间存在深刻联系,相关示意如 图 6.2 所示。
6.5 结语(Closing Remarks)
本章是本文理论研究的核心基石,将变分视角、分数视角与基于流的视角整合为统一自洽的理论框架。本文证明:这三类看似相互独立的方法并非只是并行的技术路线,而是存在深层次的本质关联。
本次理论统一建立在两项核心结论之上。第一,**本文找到了所有框架共有的核心机制:条件化技巧。**该技巧可将难以求解的边缘分布训练目标转化为可求解的条件训练目标,实现稳定且高效的学习。第二,**本文证明福克 - 普朗克方程是控制概率密度演化的普适规律。**上述三类视角均以各自方式构建服从该基础动力学规律的生成过程。
此外,本文论证了各类模型参数化形式(即噪声预测、干净样本预测、分数预测与速度预测)之间可以相互转换。该结果表明,预测目标的选择仅属于工程实现与数值稳定性层面的考量,并非建模层面的本质差异 。本章最终结论为:现代扩散方法尽管起源各不相同,但均遵循同一核心原理 ------ 学习一个时变向量场,将简单先验分布变换为数据分布。
在这套统一且严谨的理论基础建立完成后,我们便可从基础理论转向扩散模型的实际应用与加速算法研究。生成过程等价于求解微分方程这一核心结论,为模型的可控性与优化提供了有力支撑。本书后续章节将基于该统一理论框架,解决若干关键实际问题:
- C 部分聚焦于提升推理阶段的采样过程。该部分将探究如何引导生成轨迹以实现可控生成(第 8 章),并研究先进数值求解器,用以大幅加速缓慢的迭代采样流程(第 9 章)。
- D 部分将跳出迭代求解器的思路,直接学习快速生成器。该部分探讨仅需一步或少数几步即可生成高质量样本的方法,包括基于教师模型的蒸馏方案(第 10 章)以及从零开始训练的方案(第 11 章)。
在完成对扩散模型 "是什么" 与 "为什么" 的理论统一之后,接下来我们将着眼于更具现实意义、充满探索空间的 "如何实现" 这一前沿方向。
下一章:【扩散模型原理】(七)Diffusion Models and Optimal Transport(1)