在目标检测、语义分割以及卷积神经网络(CNN)中,经常会看到两个概念:上采样(Upsampling)和下采样(Downsampling)。
简单来说:
下采样:减小特征图的尺寸
上采样:增大特征图的尺寸
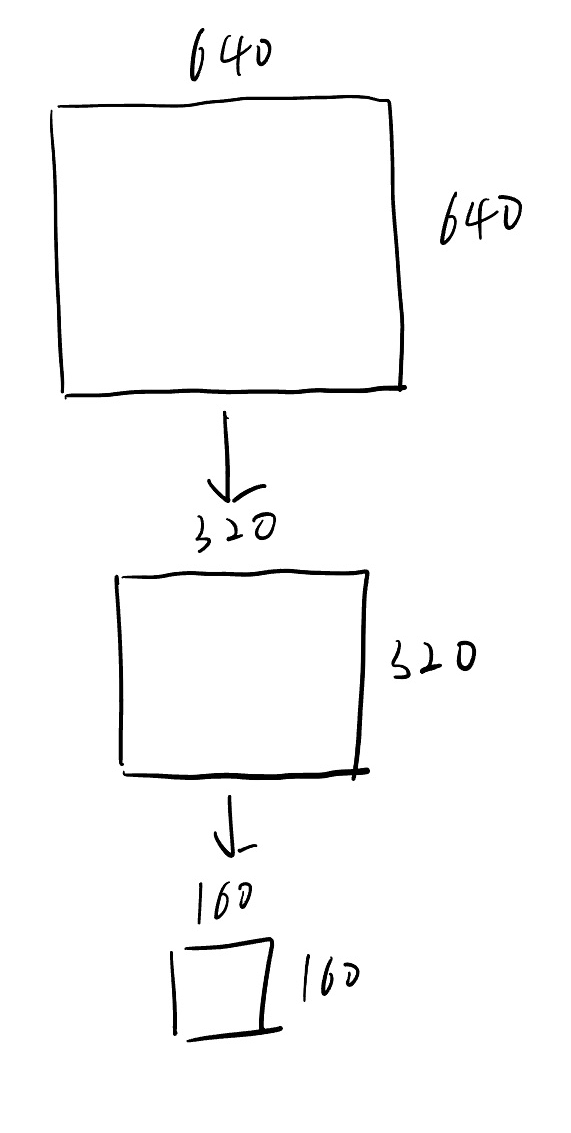
例如,一张大小为 640×640 的图像经过多次下采样后:
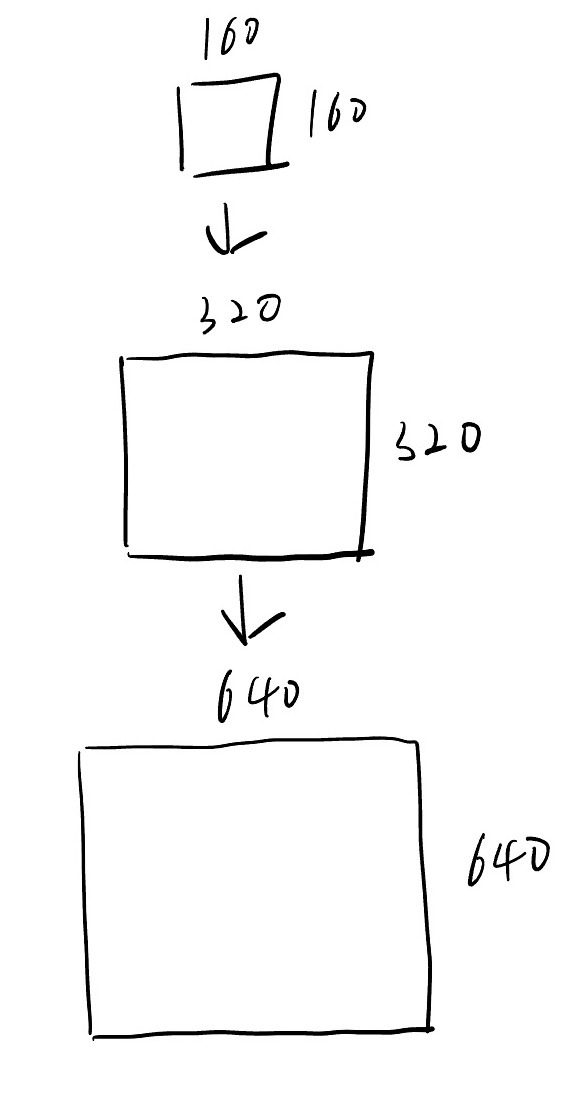
而上采样则相反:
1. 什么是下采样?
下采样(Downsampling)就是降低图像或者特征图的空间分辨率。
例如:
640×640 → 320×320
宽和高都变成原来的 1/2,像素数量则变成原来的 1/4。
在卷积神经网络中,下采样主要有几个作用:
1.减少特征图尺寸,降低计算量;
2.扩大感受野;
3.提取更加高级的语义特征;
4.降低模型后续网络层的计算和显存开销。
常见的下采样方法
(1)步长卷积
例如使用 stride=2 的卷积:
import torch.nn as nn
conv = nn.Conv2d(
in_channels=3,
out_channels=32,
kernel_size=3,
stride=2,
padding=1
)
输入:
640×640
经过卷积后,特征图大致变为:
320×320
(2)池化
例如最大池化:
pool = nn.MaxPool2d(
kernel_size=2,
stride=2
)
同样可以实现:
640×640 → 320×320
2. 什么是上采样?
上采样(Upsampling)与下采样相反,就是增大图像或者特征图的空间尺寸。
例如:
80×80 → 160×160
需要注意的是,上采样并不是凭空恢复已经丢失的原始信息,而是通过插值、可学习参数等方式,将低分辨率特征映射到更高的空间分辨率。
常见的上采样方法
(1)最近邻插值
upsample = nn.Upsample(
scale_factor=2,
mode="nearest"
)
例如:
80×80 → 160×160
(2)双线性插值
upsample = nn.Upsample(
scale_factor=2,
mode="bilinear",
align_corners=False
)
双线性插值会根据周围像素计算新的像素值,因此通常比最近邻插值更加平滑。
(3)转置卷积
deconv = nn.ConvTranspose2d(
in_channels=256,
out_channels=128,
kernel_size=2,
stride=2
)
转置卷积中的参数可以通过训练学习,因此也经常用于分割网络的解码器。