写在前面:为什么这篇论文值得花时间
大模型架构论文有一个通病:改动太大,读者看完不知道能不能用。这篇论文反过来了。
它的核心改动只有一行:
cpp
attn_output = attn_output * torch.sigmoid(gate_score)在缩放点积注意力(SDPA)的输出后面乘一个 sigmoid 门。就这一下,论文报告了:
- 首 token 注意力占比从 46.7% 降到 4.8%
- 中间层最大激活值从 1053 降到 94
- MMLU 涨 2 分 ,PPL 降 0.2 以上
- RULER 长上下文基准涨 10 分以上
- 参数只增加 约 1% ,计算开销增加 不到 2%
并且这个机制已经进了 Qwen3-Next-80B-A3B 。
但真正让这篇文章有价值的地方,不在于"结论是什么",而在于为什么 。这篇论文用 30 组变体、1.7B dense + 15B MoE 两种规模、3.5T token 的数据 ,把门控"该加在哪、加成什么样"做成了受控实验。这种消融密度在架构论文里很少见,也意味着它的结论可以拿来指导工程决策,而不仅仅是"看起来很美"。
下面按因果链讲:问题是什么 → 为什么会有这个问题 → 门控怎么解 → 数据支不支持 → 工程上怎么落地 → 怎么自己复现 。
一、问题的起点:softmax 有一个"必须分配"的硬约束
1.1 现象:第一个 token 吃掉了近一半的注意力
Attention Sink(注意力汇聚)由 Xiao 等人在 2023 年的 StreamingLLM 工作中提出:训练好的 LLM 倾向于把大量注意力权重分配给序列最前面的几个 token,尤其是 BOS------即使这些 token 不携带任何语义信息 。
论文实测的量化结果:在基线模型上,平均 46.7% 的注意力分数被倾倒到第一个 token 上 。在某些层这个现象更极端------第 21 层基线模型有 83% 的注意力集中在首个 token。
1.2 数学根源:softmax 把概率质量"必须分完"
标准的缩放点积注意力:
softmax 有两个性质:输出非负,且按行求和恒为 1 。
这两个性质决定了:无论当前 query 有没有真正需要检索的信息,它都必须把总量为 1 的注意力分配出去。当一行确实"没什么可看"时,模型只能把这份质量倒到一个无害的位置上------第一个 token 是序列中最稳定、永远存在的那个位置,于是它成了"注意力垃圾桶"。
关键在于:这个约束剥夺了注意力头表达"本次我不参与"的能力。
一个 head 可以决定往哪里看 ,但不能决定要不要参与 。没有信息可写时,它只能被迫写一个 softmax 加权平均出来的向量,而这个向量很可能只是噪声------它会被送进输出投影,污染残差流。
1.3 三重代价
Attention sink 不是审美问题,它有很实在的代价:
- 注意力容量被浪费 。近一半的注意力权重没有用在有效信息上,序列越靠后的内容越难获得关注。
- 长上下文外推受限 。模型在训练长度内学会了"把权重倒给起始 token"这个模式,一旦序列超过训练长度,这个模式无法有意义地延伸,长文本性能断崖式下跌。
- 数值不稳定 。大量注意力集中在少数位置会导致 hidden state 出现 massive activations (激活值离群点)。论文实测基线模型中间层的最大激活值高达 1053 。在 BF16 下,这种量级的离群点会显著吃掉有效数值精度,是训练中出现 loss spike 的重要诱因。
二、一行改动:门控注意力的定义
2.1 公式
论文采用的方案(head-specific、sigmoid、乘法、加在 SDPA 输出之后):
其中 X 是该注意力层的输入 hidden state,W_gate 是一个新加的线性层,σ 是 sigmoid,⊙ 是逐元素相乘。
三个要点:
- 门控值取自输入 x ,因此是 query 依赖 的------每个 token 自己决定这个 head 要放多少信息通过;
- 门控作用在输出侧 ,注意力计算本身(Q/K/V 投影、softmax)完全没动,所以它不改变注意力的检索过程 ,只改变"检索到的内容有多少被写进残差流";
- sigmoid 把门值压在 (0, 1),乘法形式意味着门值接近 0 时整个 head 的输出被关掉。
2.2 门控该加在哪:G1--G5 五个位置的对照
这是论文最实用的部分。作者在五个位置分别插门:
|--------|------------|--------------|-------------------------------------|
| 位置 | 插在哪 | 效果 | 原因 |
| G1 | SDPA 输出之后 | 最好 | 同时获得非线性 + query 依赖稀疏,是唯一同时解决两个问题的位置 |
| G2 | Value 投影之后 | 次优( PPL 尤其好) | 也能补上非线性,但对 value 的调制不如对输出调制直接 |
| G3 | Key 投影之后 | 提升很小 | Q/K 后面紧跟 softmax ,本身就是非线性,加门边际收益低 |
| G4 | Query 投影之后 | 提升很小 | 同上 |
| G5 | 输出投影之后 | 几乎无效 | 没有补上 Wv 与 Wo 之间缺失的那层非线性 |
结论很清晰:门要加在"两条连续线性层之间",而不是加在已经存在非线性的地方。
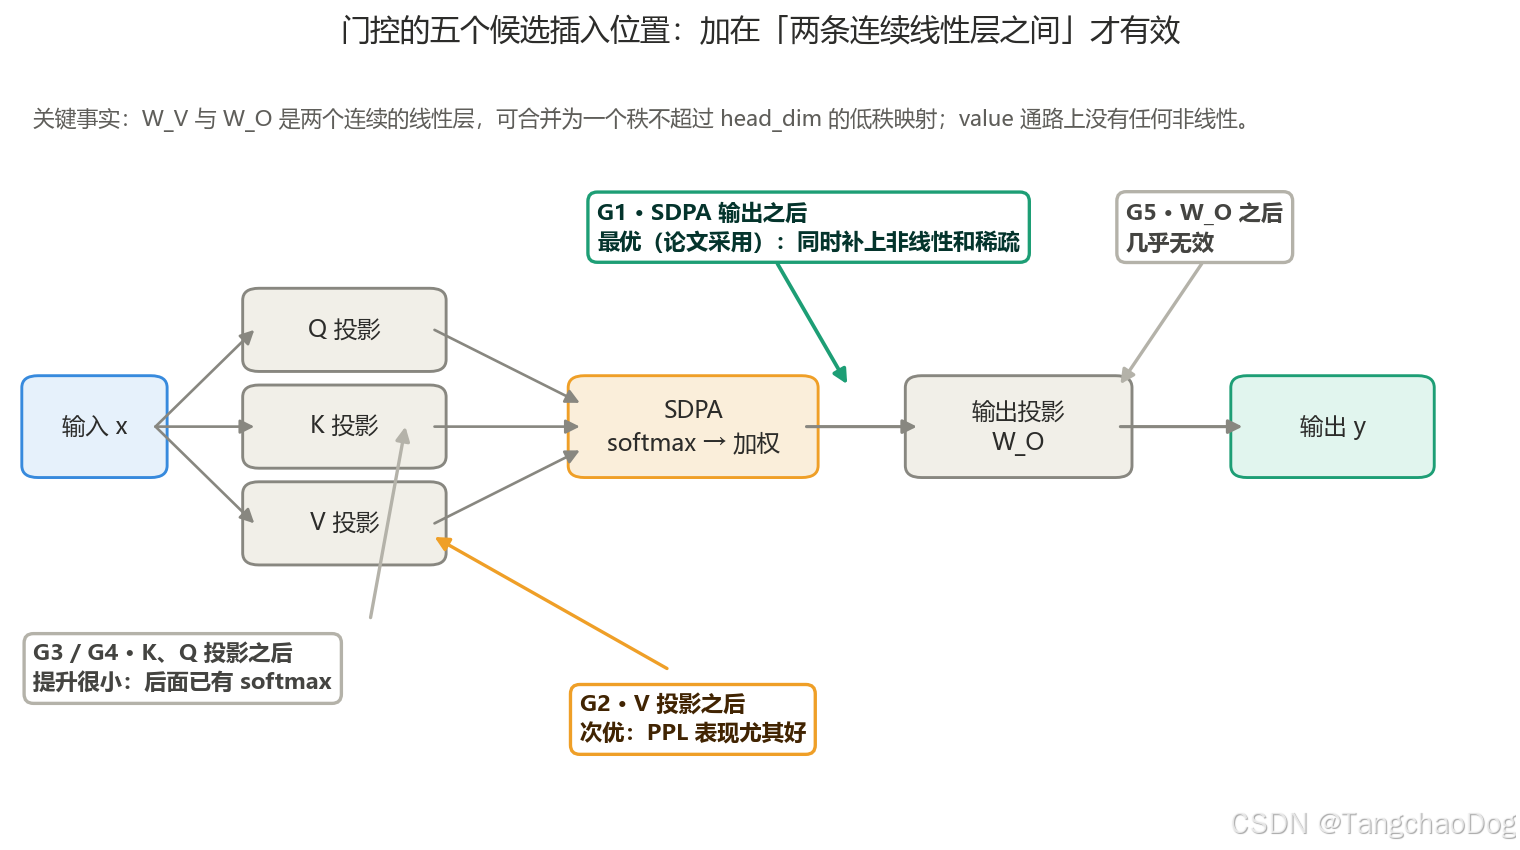
图 1 门控的五个候选插入位置
2.3 粒度与形式:三个受控对比
论文把门控的三个自由度都做了消融:
|-----------|-------------------------------------------------------------------------------------------|
| 维度 | 结论 |
| 粒度 | elementwise (每个 head 的每个特征维一个门)效果最强;但 headwise (每个 head 一个标量门) 效果几乎持平 |
| 共享方式 | head-specific (每个 head 独立门)显著优于 head-shared (所有 head 共用一个门) ------ 因为不同 head 学到的语义特征本来就不同 |
| 非线性形式 | 乘法 sigmoid > SiLU > 加法形式 |
粒度这一条是整篇论文里最有工程价值的取舍。以论文的 15B MoE 配置(d_model=2048、16 heads、head_dim=128、48 层)反推:
- headwise 门控增加参数:2048 × 16 × 48 ≈ 1.57M
- elementwise 门控增加参数:1.57M × 128 ≈ 201M
- 两者比值恰好等于 head_dim,即 128 倍
而效果接近。也就是说,elementwise 在多花 128 倍参数的情况下,几乎没有换来额外收益 。对于任何要考虑显存和访存的工程团队,这个数字比"最佳配置"更有决策意义。
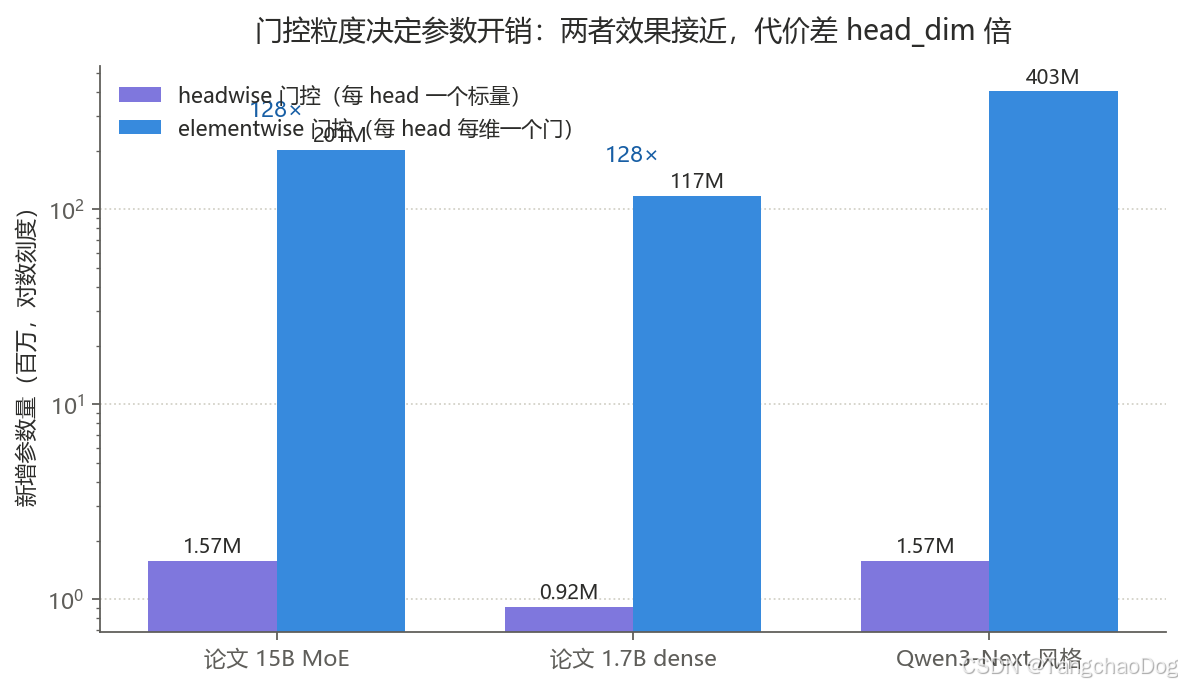
图 2 门控粒度与参数开销
三、为什么有效:把两个机制分开讲
论文把门控的有效性归因于两个因素。这两者必须分开理解,混在一起讲是很多解读文章出错的地方。
3.1 机制一:非线性------注意力层里藏着一条"没有激活函数"的低秩通路
先看一个容易被忽略的事实。在标准注意力里,value 投影 W_V 和输出投影 W_O 是连续的两个线性层 ,中间没有任何非线性激活:
这两个线性层在代数上可以合并成一个矩阵 W_V · W_O,而它的秩被 head_dim 上界约束 ------也就是说,它本质上是一个低秩线性映射 。
再看 softmax 的位置:softmax 作用在注意力分数 上,不在 value 上。所以从"输入 → 注意力层输出"这条通路上,唯一的非线性来自 softmax 对分数分布的塑造,value 通路本身是线性的 。
门控插在 W_V 和 W_O 之间,就把这条通路变成了:
这和 MLP 的设计思路(Linear → ReLU → Linear)完全一致。门控本质上把 MLP 的表达能力补进了注意力层。
这个解释顺便回答了 2.2 节的问题:为什么加在 G3/G4(query / key 之后)几乎没有提升?因为 Q/K 后面紧接着 softmax,那里本来就有非线性,再加一层门属于重复投资;而加在 G5(输出投影之后)也没用,因为它没有补上 W_V 与 W_O 之间缺失的那层非线性。
3.2 机制二:稀疏性------门控自己学会了"这次闭嘴"
论文测量了训练完成后的门控值分布:均值只有 0.116,绝大多数 token 的门值接近 0,少数接近 1 。
这个稀疏性不是通过任何正则项强制出来的 ,是模型自己学的。而且它是 query 依赖 的------同一个 head,面对不同的 query token,开合程度完全不同。
效果上,它相当于在 soft 的注意力机制之上又叠了一层硬的 token 级过滤器 :注意力权重再怎么分配,如果门控判定这个 head 这次检索到的内容没用,它可以整体乘以接近 0 的值,直接掐掉。
两个机制是叠加关系:非线性先把表达力打开,稀疏性再把噪声关掉。
3.3 于是 attention sink 消失了
现在把因果链接回问题起点。
softmax 的"和为 1"约束没有变,但门控提供了额外的泄压阀 。原来模型的处境是:
"这一行没有信息可看,但概率必须分完" → 只能倒给第一个 token。
有了门控之后变成:
"这一行没有信息可看" → softmax 照常分配概率,然后门控把这个 head 的输出整体乘 0。
作者的原话大意是:把"没有内容,那就丢给第一个 token"替换成了"没有内容,那就直接丢掉" 。sink 不再是必需的,于是它消失了。
四、实验数据
以下数据来自论文及其公开解读(论文基准测试涉及 1.7B dense 与 15B MoE 两种规模、总计 3.5T token 的训练数据;部分消融在 400B token 设置下完成)。不同表格的训练设置略有差异,引用时请注意口径。
|-----------------------|--------|-----------|----------------|
| 指标 | 基线 | 加门控 | 说明 |
| 首 token 注意力占比 | 46.7% | 4.8% | 全层平均 |
| 首 token 注意力占比(第 21 层) | 83% | 4% | 单层最坏情况 |
| 最大 hidden 激活值 | 1053 | 94 | 直接影响 BF16 有效精度 |
| PPL ( 15B MoE ) | 6.026 | 5.761 | −0.265 |
| MMLU ( 15B MoE ) | 58.79 | 60.82 | +2.03 |
| MMLU ( 1.7B dense ) | 50.21 | 51.15 | +0.94 |
| RULER 128K (长上下文) | 31.65 | 58.82 | 长上下文外推 |
| 额外参数 | --- | 约 1% | headwise 粒度下更低 |
| 额外计算 | --- | < 2% | --- |
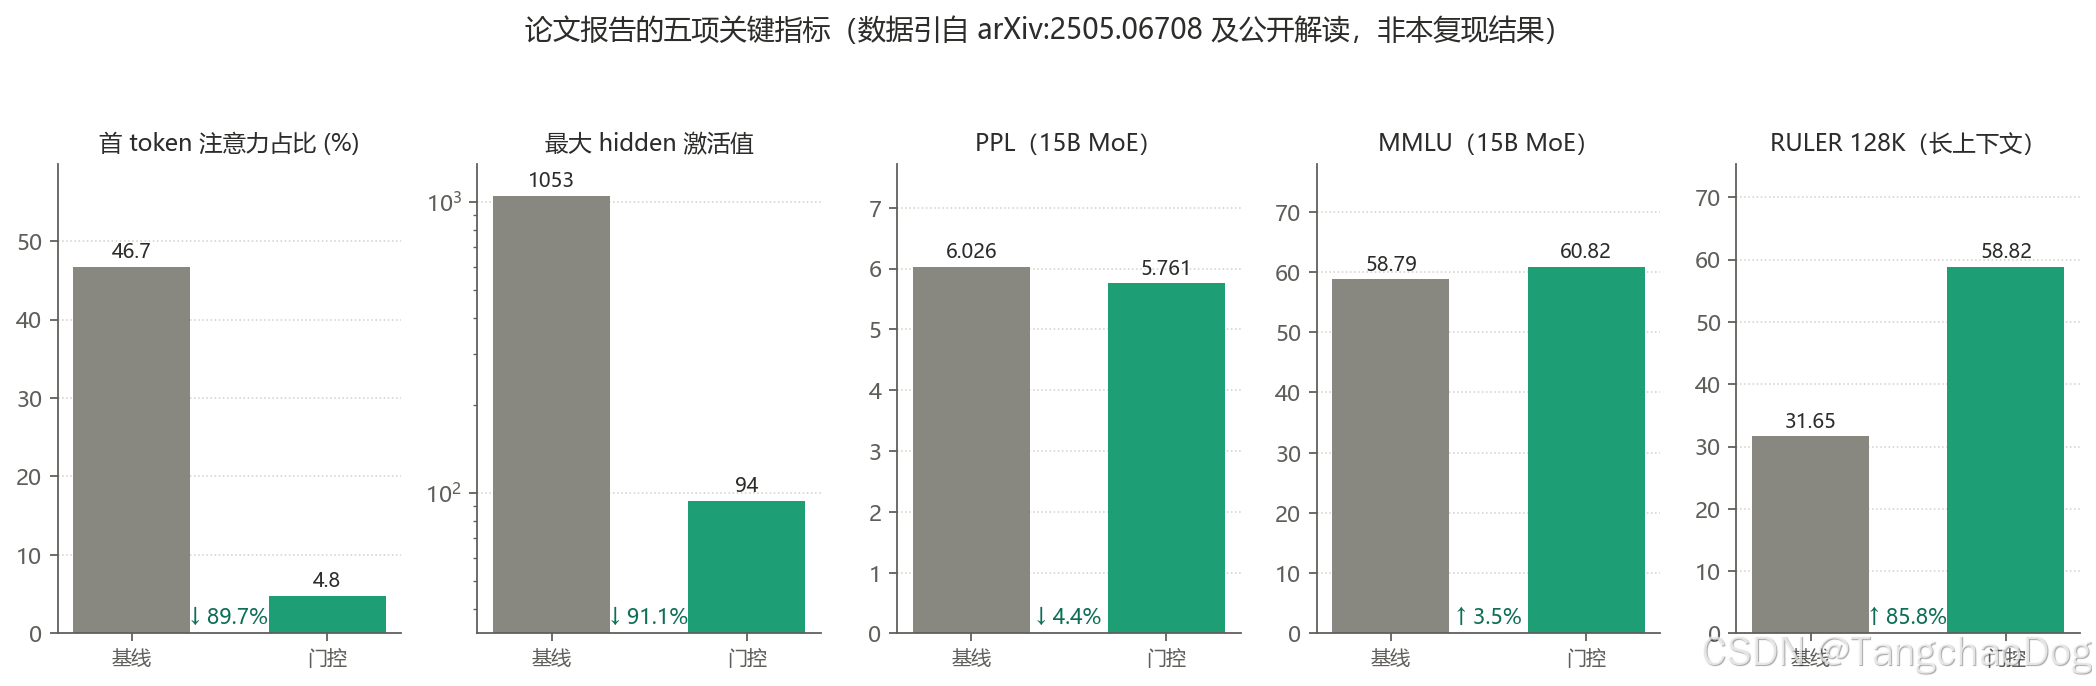
图 3 论文报告的五项关键指标
4.1 训练稳定性:loss spike 几乎消失,能扛 8e-3 的学习率
这是论文里我认为最被低估的一条结果。
在 1.7B 模型、1T token 的训练设置下,基线模型在超过某个学习率阈值后就会发散,而加门控的版本在 8e-3 的学习率下依然收敛 ,loss spike(训练中损失突然跳高)大幅减少。
论文给出的机理解释是数值层面的:最大激活值从 1053 降到 94 之后,BF16 的有效数值精度 显著上升,从而抑制了 spike 的形成。论文还进一步定位了 massive activation 的来源------通常起源于第 5 层左右的 FFN 输出。
这条结果的实际意义:训练稳定性被"设计"进了架构,而不是出了问题再打补丁 (去调梯度裁剪、降学习率、加 QK-Norm)。这个思路和同期 Kimi K2 用 QK-Clip 在优化器层面解决同一类问题是相通的。
4.2 长上下文外推:RULER 涨 10 分以上
sink 消失之后,长上下文的外推能力明显改善。论文在 RULER 基准上报告了 10 分以上 的提升,并且明确指出:当改变 RoPE 的频率设置来拉伸上下文长度时,加门控的模型更不容易崩。论文摘要将这一收益直接归因于稀疏门控对 attention sink 的缓解。
五、工业落地:Qwen3-Next 是怎么接的
Qwen3-Next 的官方博客明确写了「采用我们前期工作的输出门控机制」,理由同样是「缓解注意力中的低秩问题」,并且提到该机制有助于抑制 attention sink 和 massive activation,从而保证全模型数值稳定。
从公开配置看,它的注意力部分是这样组织的:
- GQA :16 个 Q heads、2 个 KV heads;
- head_dim = 256 ;
- partial RoPE :只在 256 维中的前 64 维施加旋转位置编码,其余 75% 的维度不带位置信息。官方解释是:带 RoPE 的维度在超出训练长度后旋转角进入未见区间、匹配失效;不带 RoPE 的维度只靠内容匹配,不受距离影响。把可失效的维度压缩到 25%,本身就是为长上下文外推做的设计。
需要强调的是:门控不是孤立改动。 Qwen3-Next 同时用了 Zero-Centered RMSNorm(把缩放因子拆成 1 + delta 并对 delta 施加 weight decay,防止缩放因子异常增长)、MoE router 初始化归一化、以及 MTP 多 token 预测模块。稳定训练是一组措施共同作用的结果,把功劳全归给门控并不严谨。
六、从零复现:在 CPU 上把这件事跑出来
理论和数据都清楚了,但"能不能自己跑出来"是另一个问题。配套脚本 gated_attention_repro.py 在纯 CPU、几分钟 内可以跑完,下面所有数字都来自它的真实输出,不是手写的示例。
6.1 实验一:参数量开销核算
用论文的配置反推(15B MoE:d_model=2048、16 heads、head_dim=128、48 层):
|-------------------------------|---------------------|------------------------|--------|
| 配置 | headwise 门控 | elementwise 门控 | 比值 |
| 论文 15B MoE | 1.57M | 201.3M | 128× |
| 论文 1.7B dense ( 28 层) | 0.92M | 117.4M | 128× |
| Qwen3-Next 风格( head_dim=256 ) | 1.57M | 402.7M | 256× |
比值精确等于 head_dim。论文报告的「约 1% 参数开销」与这里的 201.3M / 15B ≈ 1.3% 吻合。数量级对上了,说明对论文配置的还原是正确的。
6.2 实验二:机制验证------softmax 为什么给不了"闭嘴"选项
构造一个 8 token × 4 维的随机 value 矩阵 V(模拟"这个 head 面前没有任何相关信息"),然后解一个优化问题:在 softmax 参数化下,能把这个 head 的输出压到多小?
如果 head 能自由决定"不参与",答案应该是 0。实测结果:
- 均匀注意力下的输出范数:0.4635
- softmax 权重下能压到的最小范数:0.2449 (此时最大注意力权重卡在 0.338,再也压不下去)
- 加一个 sigmoid 门控后能压到的最小范数:8.2e-05 (接近 0)
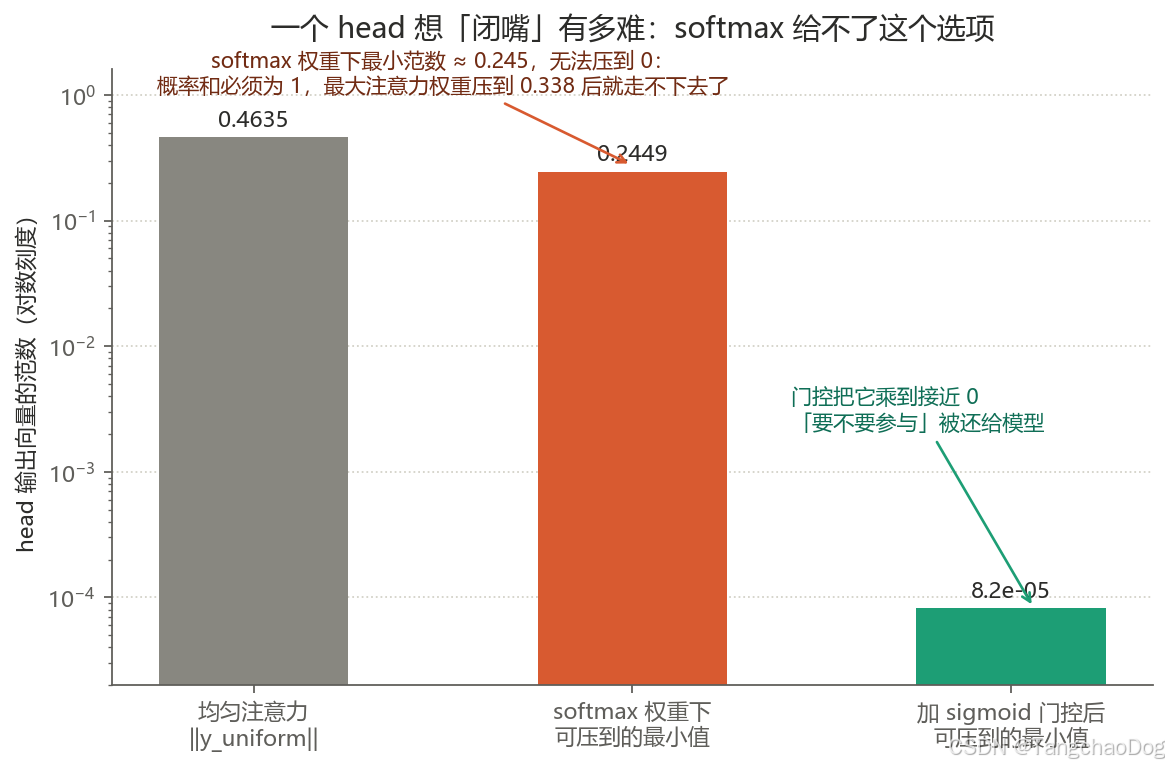
图 4 机制验证:softmax 给不了"闭嘴"选项
这 5 个数量级的差距就是整篇论文的立足点:只要概率和必须为 1,head 就只能决定"把注意力倒在哪里",不能决定"要不要参与"。
这里有一个必须注意的边界:门控是"抑制激活",不是"跳过计算"。 它把输出乘 0,但 SDPA 本身照样算完了。所以它优化的是信号质量 (不往残差流里写噪声),不是 FLOPs 。指望它省算力是误读------论文报告的额外计算开销是正的(<2%),不是负的。
6.3 实验三:端到端对照
任务选的是经典的 induction(重复子序列) :
模型需要学会"看到当前 token,回头找到它上一次出现的位置,然后预测那个位置的下一个 token"。这是一个真实需要检索的任务;同时第一段被 mask 掉、不参与损失,这些位置天然没有明确的信息可看------正是 sink 最好的滋生土壤 。
模型是 2 层、d_model=64、4 heads 的最小 GPT(约 0.1M 参数),序列长 63。作为参照,均匀注意力下每个位置的平均占比是 1/63 ≈ 1.6%。
训练后的全层平均注意力图:
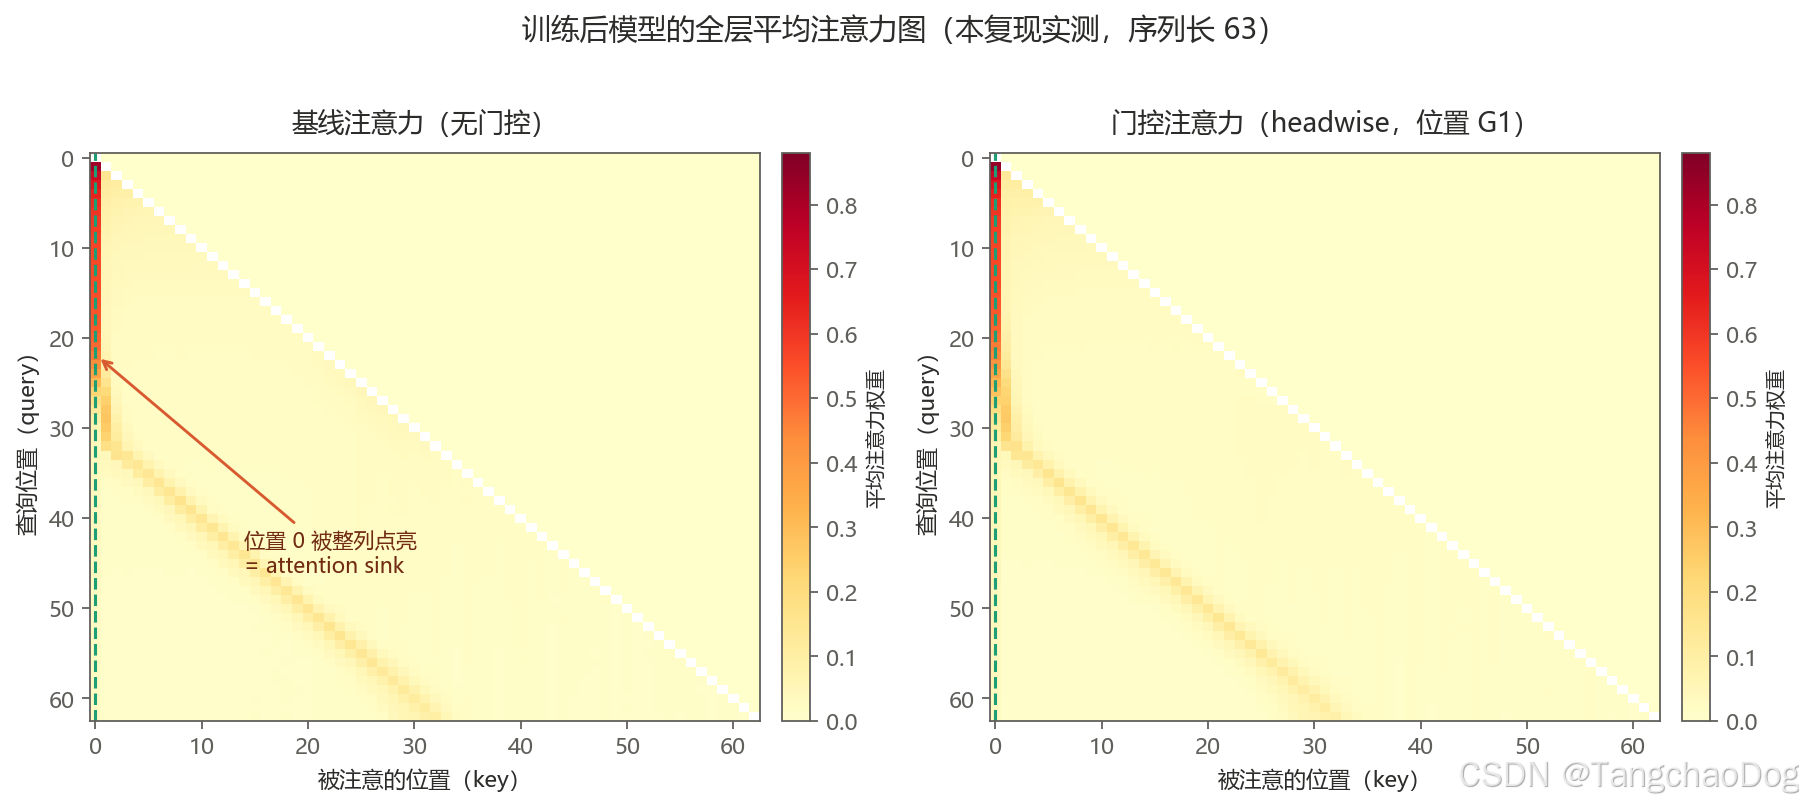
图 5 训练后模型的全层平均注意力图
位置级分布与首 token 占比:
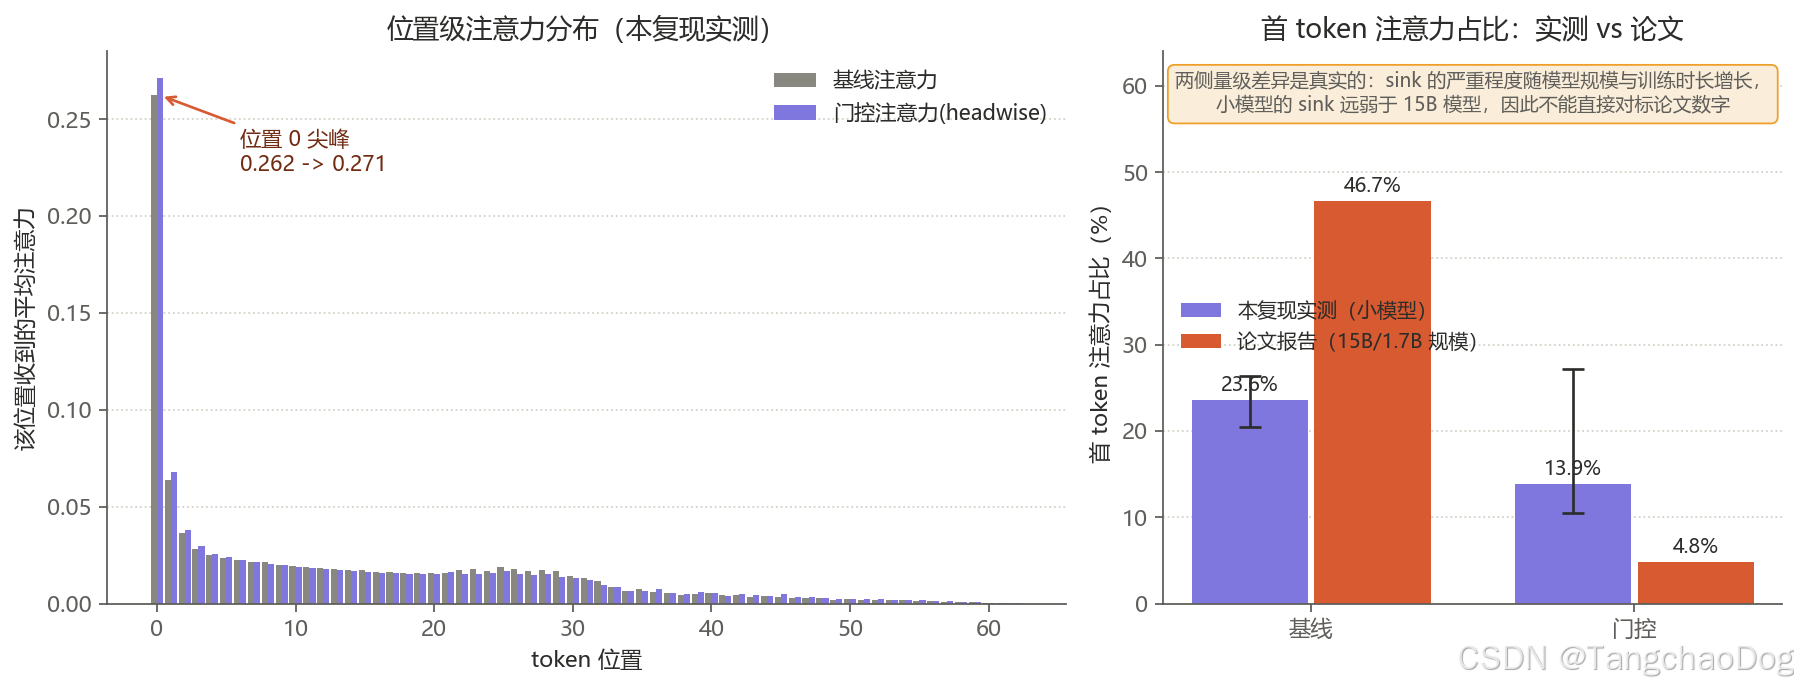
图 6 位置级注意力分布
主结果(2000 步训练、4 个随机种子,图中误差条为种子间最小-最大范围):
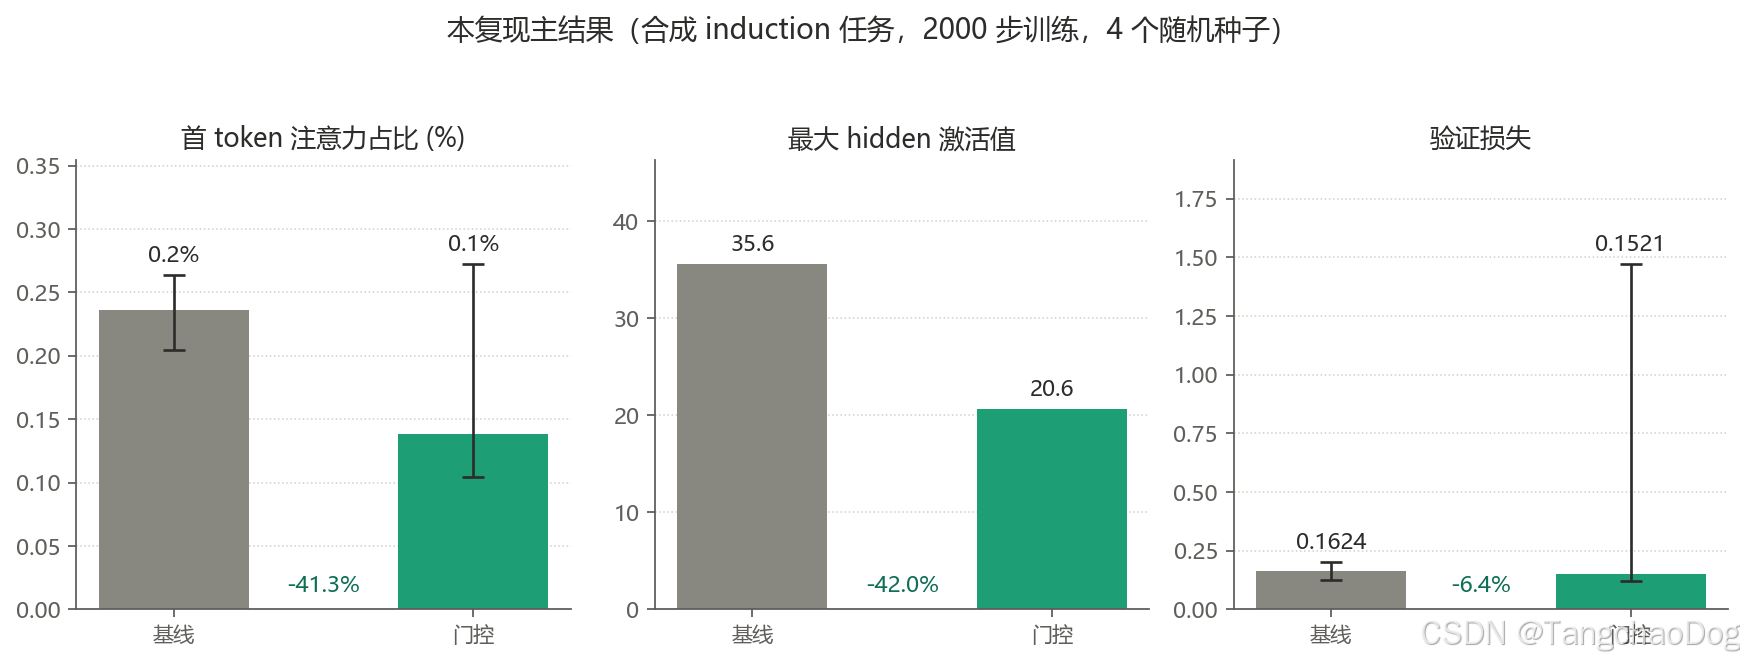
图 7 本复现主结果
|---------------|-------------|-------------|------------|
| 指标 | 基线(中位数) | 门控(中位数) | 相对变化 |
| 首 token 注意力占比 | 23.6% | 13.9% | −41.3% |
| 最大 hidden 激活值 | 35.6 | 20.6 | −42.0% |
| 验证损失 | 0.162 | 0.152 | −6.4% |
发现一:sink 确实被抑制,但种子间波动很大。 基线的首 token 占比在 20.4%~26.4% 之间(是均匀分布的 13~16 倍,sink 明确存在),门控在 4 个种子里有 3 个更低,整体中位数下降约 41%。但它不是那种一条直线就能看出来的效应------单种子结论在这个规模上不可靠,必须跑多种子。
发现二:最大激活值的下降是跨种子稳健的。 4 个种子上门控的最大激活值全部显著低于基线(聚合最大值 35.6 → 20.6,约 −42%;由于是对多种子取最大再做比较,这个 −42% 是保守估计)。这直接对应论文里 1053 → 94 那条结论的缩微版。
发现三:小模型上,门控学不会稀疏。 论文报告 15B 模型训练后的门控均值是 0.116 ;而这个 0.1M 的小模型训练 2000 步后门控均值是 0.847 ,只有 6% 的门值低于 0.1。也就是说,稀疏性不是免费的,它是大规模 + 大数据下才涌现出来的性质。
发现四:训练不够长时,门控看起来是"有害的"。 800 步、3 个种子的对照里,基线验证损失 1.786,门控 2.399------门控明显更差。延伸到 2000 步后这个劣势消失(中位数甚至略优):
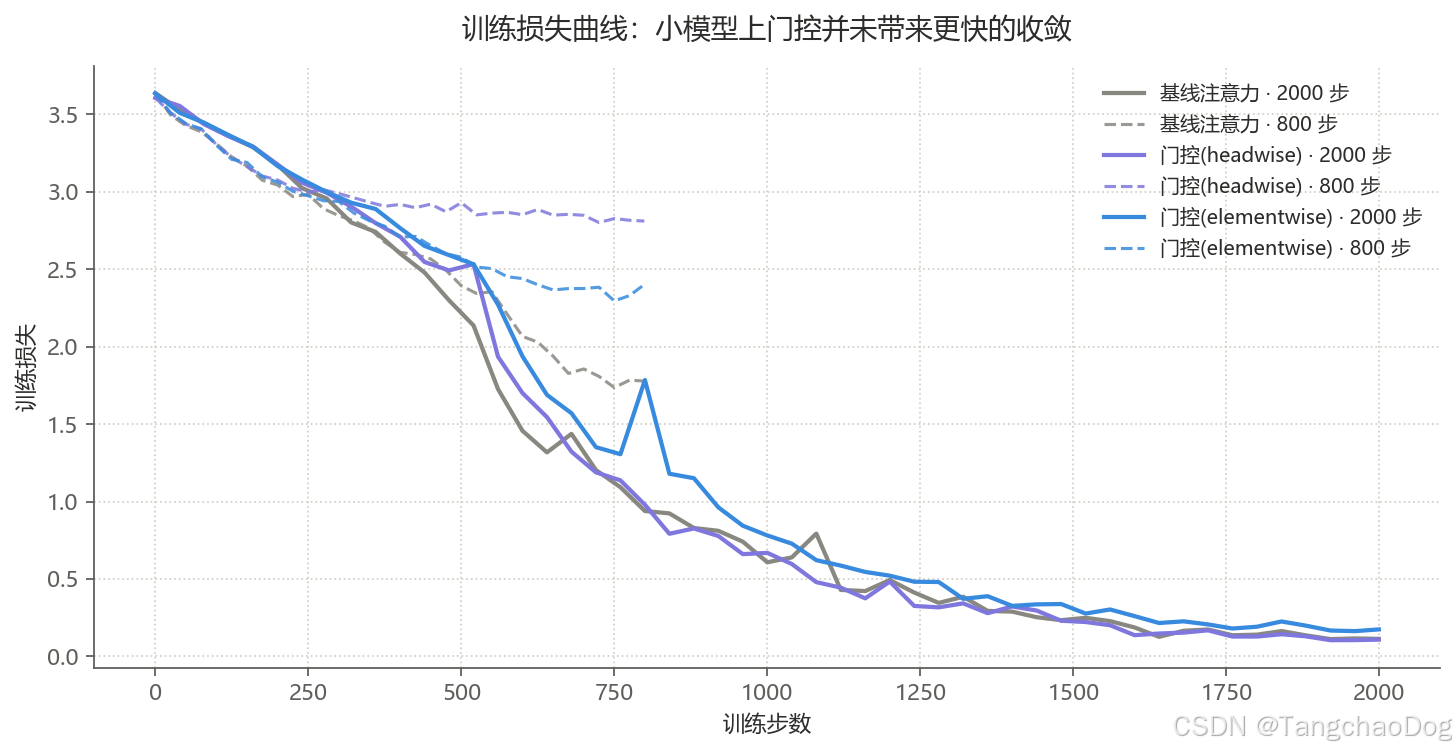
图 8 训练损失曲线
所以 800 步那个"门控更差"是收敛速度问题,不是本质缺陷 。这也是小规模复现最容易被误读的地方。
6.4 一个必须坦白的负结果
4 个种子里,门控有 1 个发散(验证损失 1.47,其余三个在 0.12~0.16)。这与论文"门控提升训练稳定性"的结论表面冲突 。
合理的解释是:门控在注意力输出上引入了一个逐 token 的乘法瓶颈。在 15B 规模,head 之间有大量冗余,关掉一些是免费的;在 0.1M 规模,每一个 head 都承担实际功能,这个瓶颈本身就可能成为不稳定的来源。"门控提升稳定性"这个结论同样是规模相关的,不能无条件外推。
6.5 怎么读这个结果
必须坦诚说明:这是机制级的小规模复现,不是论文基准数字的复现。
论文的 PPL / MMLU / RULER 收益来自 1.7B dense 和 15B MoE 在 3.5T token 上的训练。0.1M 参数的模型 + 合成任务不可能复刻那个量级的性能差。这个脚本能稳定给出的是三件事:参数量开销的数量级、softmax 约束的机制、以及"抑制激活 + 降低 sink"这两个方向 ------它们已经足够验证机制,但不足以验证收益大小。
一个更重要的认知:门控的收益随规模放大,而且它的几个关键性质(稀疏性、稳定性收益)都是规模涌现的。 论文选择在 1.7B / 15B 上做消融,而不是在 100M 上,本身就是这个原因。这一点对所有"小规模跑不出来就否定一个架构改进"的判断都适用。
七、三个容易搞错的点
这三个区分来自对论文的严格技术审阅,我认为比论文正文更适合放进工程决策的语境里。
7.1 抑制激活 ≠ 跳过计算
门控把输出乘以接近 0 的值,计算路径并没有被剪掉 。这在推理侧有直接后果:你不能指望靠门控降低 KV cache 压力,也不能指望它提升吞吐。它的收益是"不往残差流里写垃圾",不是"少算一点"。
7.2 引入输入依赖的映射 ≠ 提高了每个固定矩阵的秩
门控让有效映射随输入变化 ,而不是让 W_V · W_O 这个固定矩阵的秩变大。两者常被混为一谈。前者是在一个低秩线性映射外面套了一层输入自适应的调制;后者需要真正改变权重矩阵的结构。
7.3 "训练后 sink 消失" ≠ "门控在同一次前向里代数地消除了 sink"
attention sink 的消失是训练动力学的涌现结果 ,不是一个数学恒等式。门控并没有在代数层面把 sink 项从公式里消掉------它只是让模型在训练中学会了「不需要 sink 也能工作」。所以这个现象是依赖于训练过程 的:拿一个没有用门控训练的模型,事后加个门,sink 不会自动消失。
八、局限与未解问题
作为一篇要落地的技术文章,有必要把边界讲清楚:
- 收益的规模依赖性尚未完全验证。 论文的结论建立在 1.7B 和 15B 上。更大规模(100B+)是否有同样比例的收益,目前缺乏完整的公开证据。业界对混合注意力、SSM 等新架构在超大尺度上的表现仍持保留态度,门控也属于这一类需要通过更大规模验证的改动。
- 训练稳定性的归因需要更严格的隔离。 论文报告的门控减少 loss spike、允许更大学习率,是在特定配置下观察到的;Qwen3-Next 落地时同时引入了多项稳定化措施。门控单独的贡献份额,需要控制变量更彻底的实验才能给出。
- headwise 与 elementwise 的切换阈值没有明确。 论文给出了"两者效果接近"的结论,但没有给出"什么规模下应该退回 headwise"的判据。工程上目前只能靠自己的消融来定。
- 长上下文场景下的实际开销需要实测。 门控本身与序列长度无关,但它在每层都要多读一个投影、多存一份门值。在极端长上下文、KV cache 已经是瓶颈的场景下,这部分开销的相对占比需要用自己的 workload 测。
九、总结
这篇论文讲清楚了一件事:
softmax 的「概率和为 1」约束,逼着注意力头必须把输出写到残差流里,哪怕它什么都没检索到。门控把这个被剥夺的自由度------"要不要参与"------还给了模型。
由此展开的一切都是推论:
- 因为要补上 W_V 与 W_O 之间缺失的非线性,所以门要加在 G1;
- 因为门是 query 依赖且自动稀疏的,所以它能掐掉噪声 value;
- 因为"没内容就丢掉"替代了"没内容就倒给第一个 token",所以 sink 消失了;
- 因为 massive activation 随之减少,所以 BF16 有效精度上升、loss spike 消失、学习率可以放大;
- 因为 sink 消失,所以长上下文外推能力变好。
一条完整的因果链,起点只是一行 sigmoid。