Cosmos Curator 只跑一条视频,为什么还会加载一串模型?
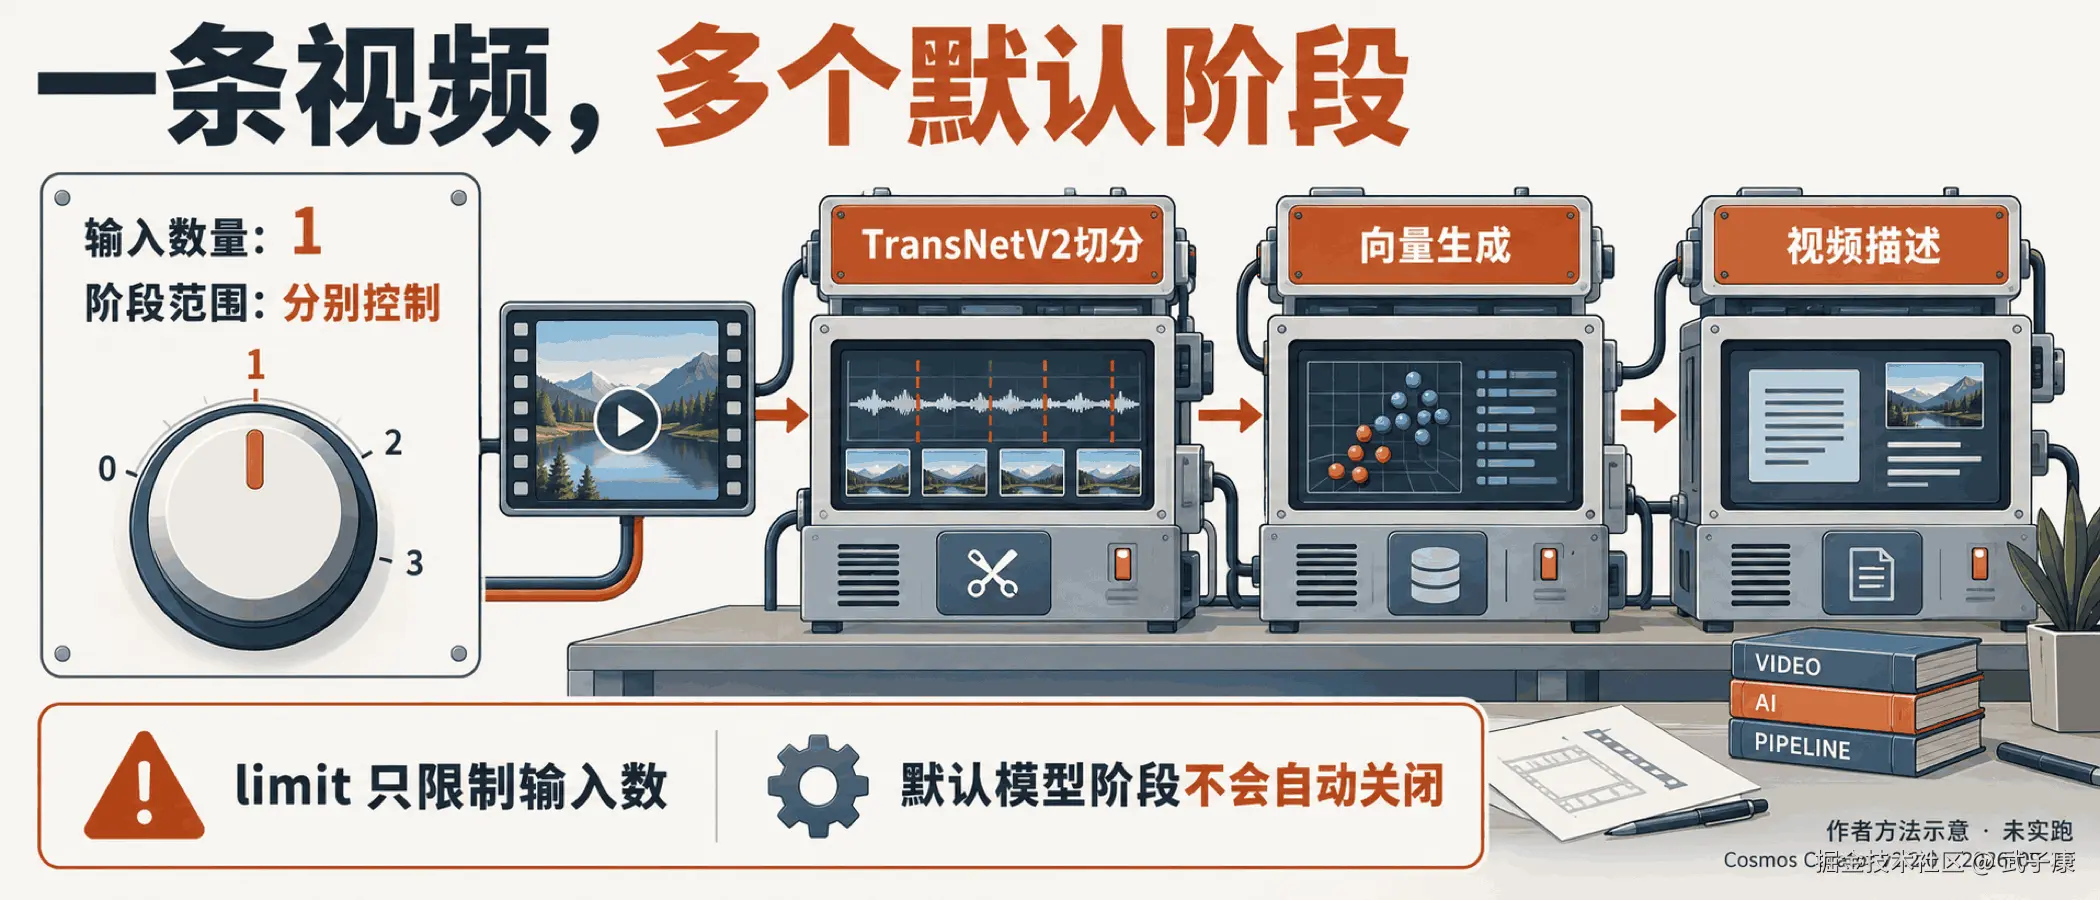
准备试用 Cosmos Curator 时,一个很自然的做法是找一段短视频,在官方示例后加上 --limit 1。输入已经缩到一条,按理说应该很快知道环境能不能跑。实际执行却可能停在权重下载、模型加载或资源分配,迟迟看不到输出片段。
这里先要检查的不是视频数量,而是这次命令究竟启用了哪些阶段。在本文核对的固定版本里,--limit 控制输入视频数量,切分默认采用 TransNetV2,向量生成和视频描述也默认开启。一条视频仍会进入包含多个模型的处理链。缩小输入量能减少处理工作,却不会自动删掉模型依赖。^1^
本文以 Cosmos Curator v2.2.0 对应提交 de89c5e4f76219c3f2985dc8fda790a74ab8bab0 的文档和源码为依据,不把它称为最新版本。以下是作者据此整理的首轮验证方法与命令示例,没有执行 Linux GPU 流水线,也没有测量显存或吞吐。我们要得到的是一份能回答"实际运行了什么、失败在哪里、哪些输出已经成立"的记录,而不是一条笼统的"部署成功"。
一条输入,依然可以带出多个模型
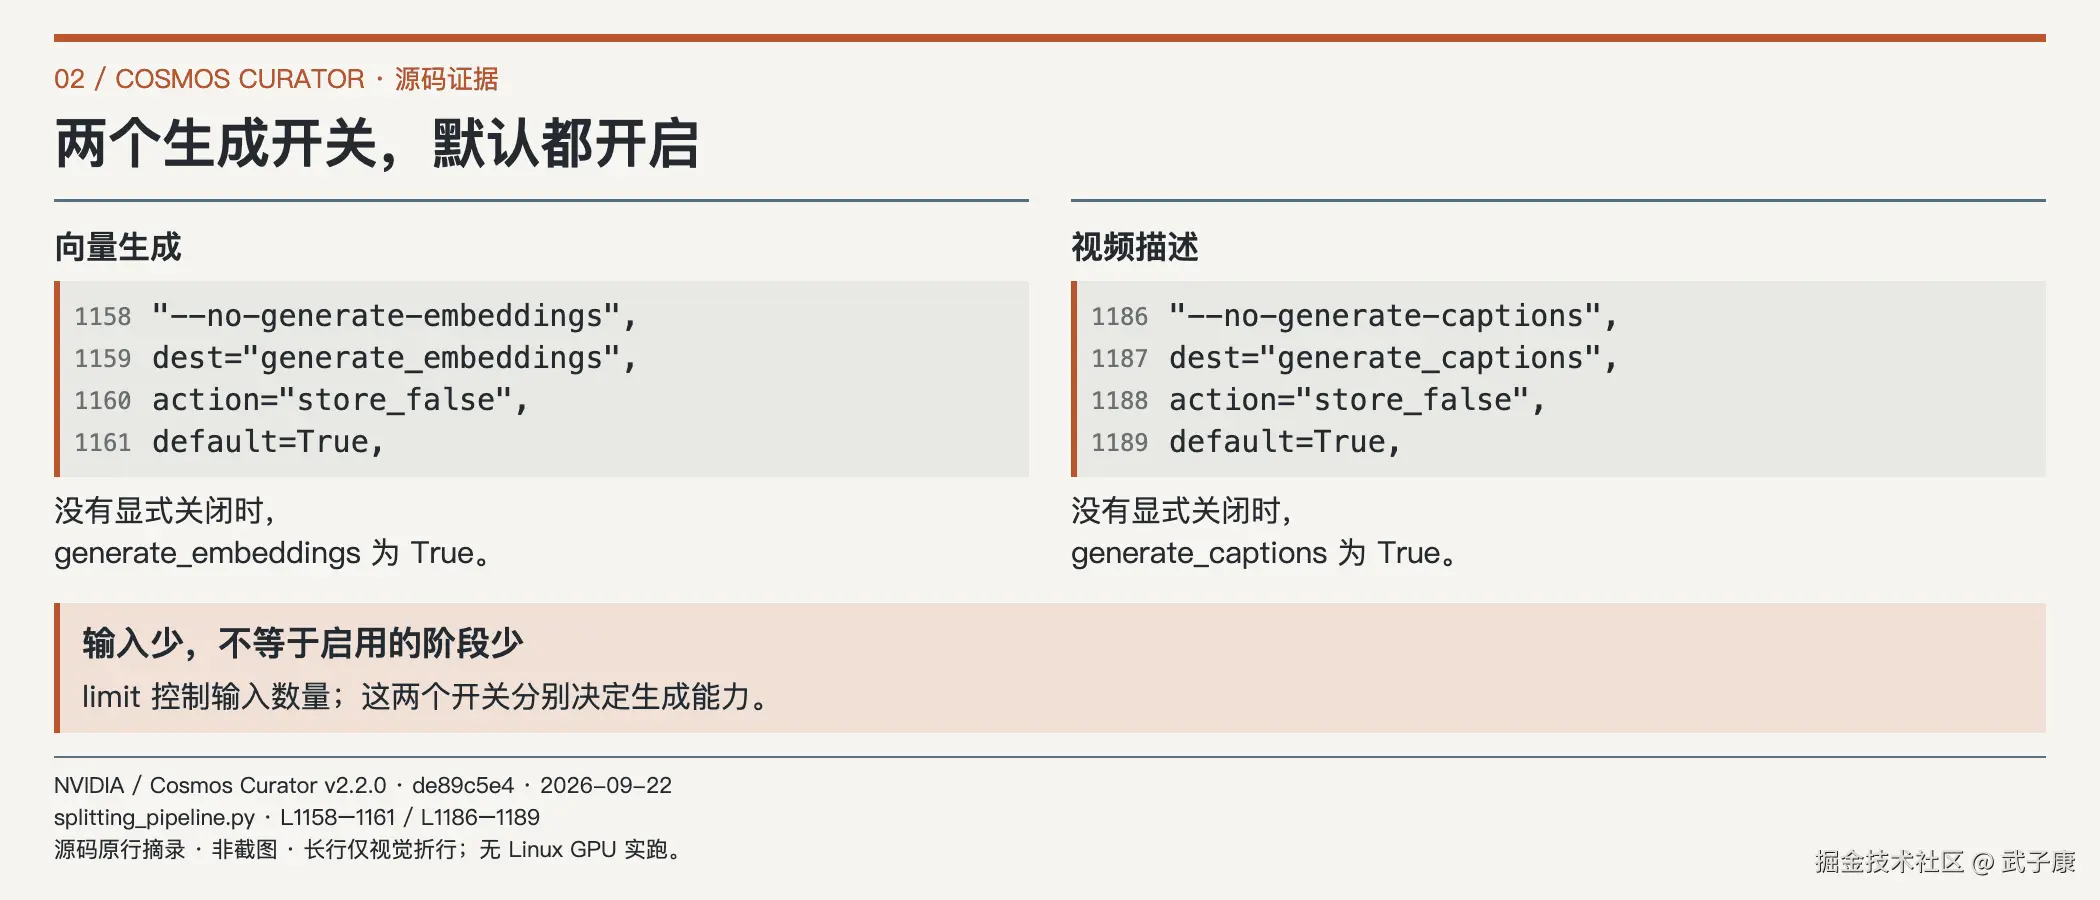
先看参数解析器的两个开关。固定源码对它们都使用反向关闭的写法:^1^
python
parser.add_argument(
    "--no-generate-embeddings",
    dest="generate_embeddings",
    action="store_false",
    default=True,
    help="Whether to generate embeddings for clips.",
)
python
parser.add_argument(
    "--no-generate-captions",
    dest="generate_captions",
    action="store_false",
    default=True,
    help="Whether to generate captions for clip windows.",
)
这意味着,没有写关闭参数时,相关功能仍然开启。默认向量算法是 internvideo2,默认描述算法标识是 qwen;切分算法的默认值则是 transnetv2。它们属于不同的处理职责:找到片段边界、把片段变成可比较的向量、用文字描述内容。只想确认文件能读写的读者,未必需要同时验证这三件事。
模型初始化的部分成本也不会随输入从一百条变成一条而同比下降。权重是否存在、模型能否加载、阶段资源能否满足,都可能在处理第一条数据前成为阻塞。因此,少量输入适合限制试验规模,却不足以证明这是一条轻量处理链。即便换成更短的视频,也不能据此断定可以绕过模型加载失败。
另一个常见误会是把"关闭描述"理解为"没有模型"。只加 --no-generate-captions,向量分支仍可能开启;即便再关闭向量,默认 TransNetV2 切分仍在。源码中的 _assemble_stages 按这些参数分别组装阶段,没有一个 --limit 1 会顺带关闭它们的逻辑。
如果首轮问题是"容器能不能读到这段视频,并把片段和元数据写回指定目录",可以先改用按固定时长切分的 fixed-stride,同时关闭向量与描述。这样得到的是一个更窄的验证范围。它不再评价镜头边界是否合理,也不能证明模型标注能力已经可用。少验证一些能力,是为了让当前失败更容易归因;后续仍要把业务真正需要的能力加回来。
先分清宿主机入口和容器执行入口
在排模型问题之前,先确认命令运行在哪一侧。官方指南明确把 cosmos-curator 定义为宿主机部署 CLI,用于构建镜像和启动任务。运行容器侧使用 pixi run --as-is 加任务别名,容器不保证包含这个部署 CLI 或 cosmos_curator.client 包。^2^
例如,宿主机完成对应版本的环境准备后,可以用下面的命令检查 CLI 是否可用:
bash
pixi run -e dev cosmos-curator --help这只能说明宿主机入口能启动和显示帮助。它没有创建视频流水线,更没有验证 GPU、模型权重、视频解码和结果写出。反过来,在运行容器里发现 cosmos-curator 命令不存在,也不能立即推断镜像损坏;应先对照文档,确认自己是否把宿主机入口放到了容器内执行。
命令中的 -- 也有实际边界。它前面是本地启动器参数,例如镜像名和标签;后面才是交给容器执行的命令。把 --no-generate-captions 放到启动器一侧,和把它放在 video-pipeline split 后面,不是同一个调用。看到参数错误时,先记录完整命令与错误来自哪一层,通常比重新下载权重更有用。
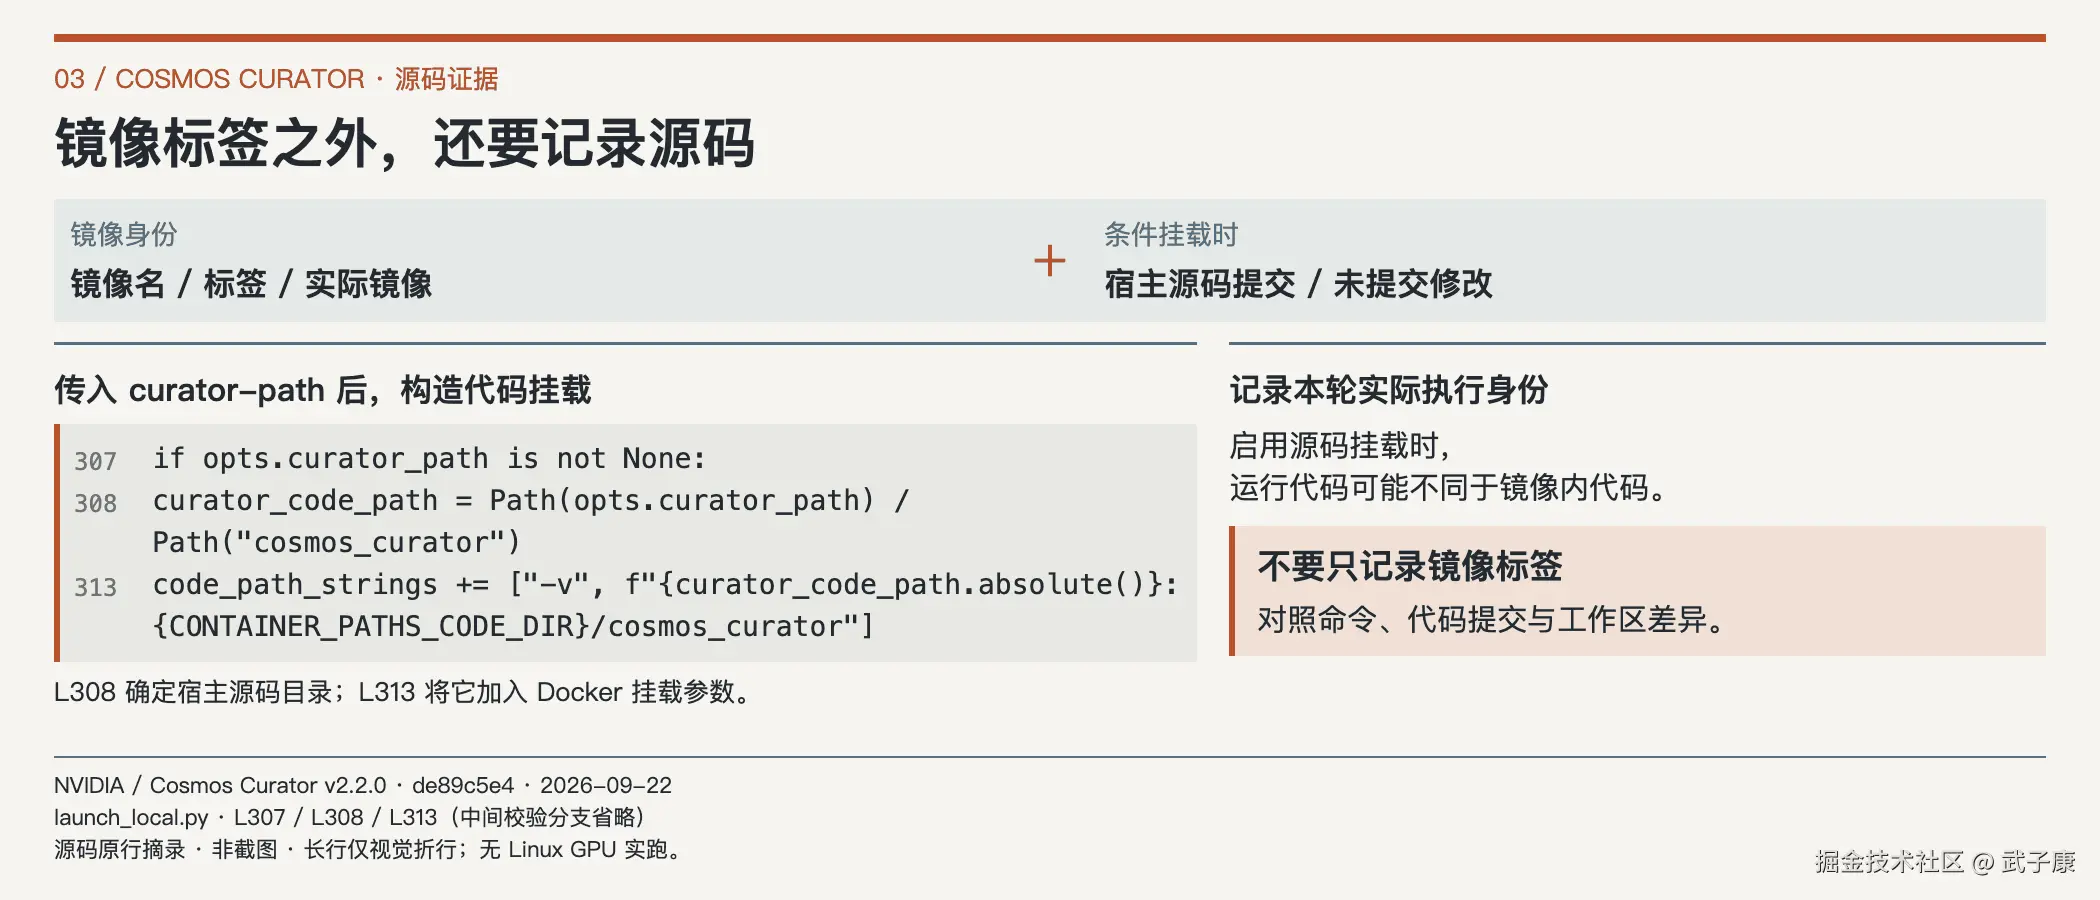
版本记录也不能只写镜像标签。标签是镜像命名的一部分,不足以单独证明源码提交。尤其当命令包含 --curator-path . 时,启动器会将本地 Curator 代码挂进容器;源码发生变化,容器实际运行的部分代码也会随之变化。固定源码里的 _get_code_mount_strings 明确构造了这个挂载。^3^
因此,一次运行至少要把镜像身份、宿主源码提交和是否挂载源码放在一起记录。若宿主工作区有未提交修改,也应如实保留差异。排查时不能拿镜像构建时的代码解释后来挂载进去的实现,否则即便日志真实,参数默认值与阶段行为仍可能对不上。
路径可见和资源可用,要在同一个运行边界内确认
假设测试文件放在宿主机 ~/cosmos_curator_local_workspace/raw_videos/。官方本地启动器将工作区映射为容器中的 /config/,流水线应使用 /config/raw_videos/,而不是直接照抄宿主机路径。自定义工作区前缀时,也要按实际映射确认。^2^
| 要检查的对象 | 宿主机上的位置示例 | 流水线使用的位置 |
|---|---|---|
| 输入目录 | ~/cosmos_curator_local_workspace/raw_videos/ |
/config/raw_videos/ |
| 本轮输出 | ~/cosmos_curator_local_workspace/output_baseline_01/ |
/config/output_baseline_01/ |
这张表只是默认映射示例,不能替代对实际容器的核查。额外挂载、工作区前缀和启动目录不同,都可能让"文件在我电脑上存在"与"执行进程能读到它"成为两件事。输出也一样:要检查目标目录的可写性,并从宿主机确认结果落在预期位置。
第一次试验建议用专门的输入目录,只放一段已知能播放的短视频,并记录文件哈希、时长、分辨率和编码。这样 --limit 1 选择的对象更明确。不要在包含很多文件的目录里只记"跑了第一条",否则后续修改文件集合后,比较的可能已经不是同一个输入。
硬件条件要按验证范围理解。该版本指南给出的条件包括至少 32 GB 主机内存、200 GB 磁盘、计算能力至少 8.0 的 GPU,以及 Ubuntu 22.04 或更高版本、宿主 Python 3.12 或更高版本和容器相关依赖。它把 Hello World 的显存条件列为 4 GB,把参考视频流水线列为 48 GB。^2^
这两个显存数字对应不同运行目标,不能用前者为完整视频流水线背书。反过来,裁剪掉部分模型阶段后,也不能仅凭推理就给出一张更低显存的"保证可运行"配置。具体缩减方案仍要在目标机器验证。关闭模型分支也不等于整个启动链已经支持无 GPU 主机:固定本地启动器仍会向 Docker 传递 GPU 参数。^3^
macOS 在这份指南中不是受支持的流水线运行平台。Apple Silicon 上能做轻量 CLI 检查,不意味着完整 CPU/GPU 流水线已运行。本文也不会为了写出"实测"而把帮助命令成功或源码分析充当部署证据。
把第一轮缩成读入、切分、转码和写出
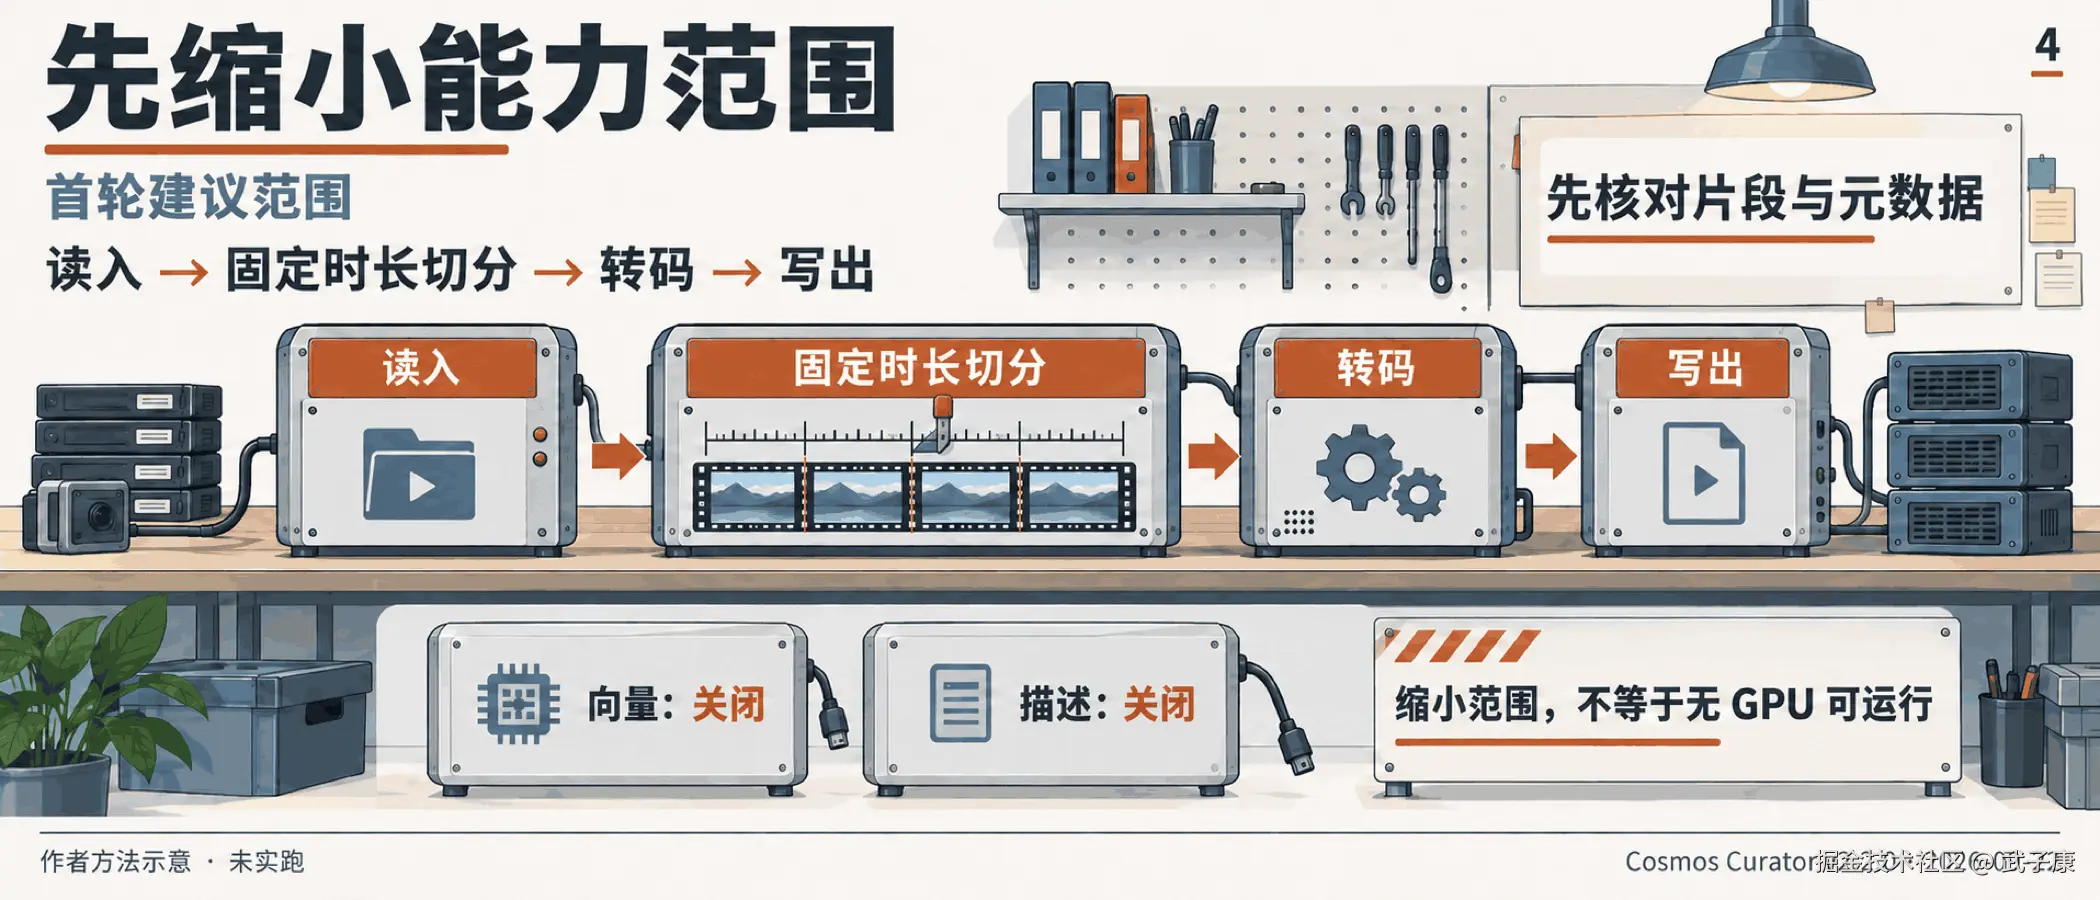
下面给出一个基于固定源码整理、尚未实跑的参数组合。前提是 Linux GPU 宿主机、容器工具链和参考视频运行镜像已经准备好;curator-baseline 只是本文示例镜像名,需要替换为实际已有镜像。示例不提供自动安装或自动下载权重脚本。
bash
pixi run -e dev cosmos-curator local launch \
  --image-name curator-baseline --image-tag 2.2.0 \
  --curator-path . \
  -- pixi run --as-is video-pipeline split \
  --input-video-path /config/raw_videos/ \
  --output-clip-path /config/output_baseline_01/ \
  --limit 1 \
  --limit-clips 2 \
  --splitting-algorithm fixed-stride \
  --fixed-stride-split-duration 10 \
  --no-generate-embeddings \
  --no-generate-captions \
--motion-filter disable这组参数有两个不同的数量限制:--limit 1 限制输入视频数,--limit-clips 2 限制每条输入视频的片段数。十秒切分时长用于建立容易人工核对的样本,不表示镜头真的在十秒处结束。短视频、最短片段限制与实际处理情况都会影响结果,不能把参数中的"2"当作必然写出两个文件的验收答案。^1^
默认转码编码器为 libopenh264,转码硬件解码加速默认关闭。这里保留这些固定默认值,不额外引入硬件编解码分支。但"少启用模型"只描述阶段范围,不能消除镜像依赖、FFmpeg 支持检查、运行时调度和存储访问。源码在运行入口调用 H.264 支持检查,再构建输入并组装阶段;错误发生在哪一步,需要结合实际日志判断。
若出现 CPU 资源无法分配,先核对已启用阶段的每 Worker 资源请求。固定源码给转码 Worker 的默认 CPU 请求是 5.0;官方参考文档也提醒,这类默认值面向服务器,可能超过受限工作站的可用调度资源。可以针对实际启用阶段降低相应 --*-cpus-per-worker 参数,但不能把所有数值改成 1 后就宣称资源适配完成。^4^
降低调度请求会改变并发和处理能力,甚至可能掩盖实际线程争用。首轮目标只是得到可解释的结果,不是追求最大吞吐。应先记录错误、请求与可用资源,再做一次有针对性的调整;若调整后仍失败,保留两轮命令和失败位置,而不是继续同时修改编码器、模型和输入数据。
另外,固定版本支持配置文件入口,但文档规定配置文件模式和 CLI 参数模式互斥。本文选择 CLI 参数表达,便于看清这一轮显式关闭了什么。已有配置文件的用户应在配置内修改对应字段,不要想当然地在命令末尾追加参数覆盖它。^2^
从第一条失败向内查,不要先把所有环境重装一遍
仍以这一个固定样本为例。如果命令直接报找不到宿主 CLI,当前尚未进入容器执行,应检查宿主 Pixi 环境和入口。若 Docker 无法启动或无法提供 GPU,当前边界在容器运行条件,不应先分析视频内容。容器启动后看不到输入,再核对路径映射和读取权限;等文件确实可读,才有必要继续追解码或切分错误。
如果日志显示正在加载描述模型,而记录中的目标是只做基础切分,优先比对实际命令和生效参数。可能执行的不是这份命令,也可能关闭参数没有传到正确入口,或者实际挂载源码与分析版本不同。此时增加显存未必能解决最先出现的偏差:本轮根本启动了不打算验证的能力。
当基础链已经产生片段后,再单独加入一种能力。例如先把 fixed-stride 改回 transnetv2,向量和描述仍关闭,用来检查镜头切分相关的权重与阶段;确认后再选向量或描述中的一种加入。每轮使用独立输出目录,保留相同原始输入和其他参数。这样第二轮失败时,至少有一个已成立的较小运行范围可以对照。
"独立输出目录"还有一个实际用途:避免把历史结果当成本轮产物。参考流水线有恢复处理机制,但首次验收不能只看目录里是否已经存在某个 MP4。尤其改变切分或描述配置后,旧文件的存在不能说明新配置已经跑完。应保存本轮起止时间、实际日志与输出位置,并核对这次生成或复用的对象。
这也限制了故障结论的力度。加入描述后失败,只能先说失败出现在新增能力相关范围,不能立刻断言是模型本身有缺陷。仍需沿第一条有效异常检查权重访问、模型许可、加载条件、预处理与执行资源。将失败范围缩小和证明根因,是两步不同的工作。
交付一份能复核的首轮运行记录
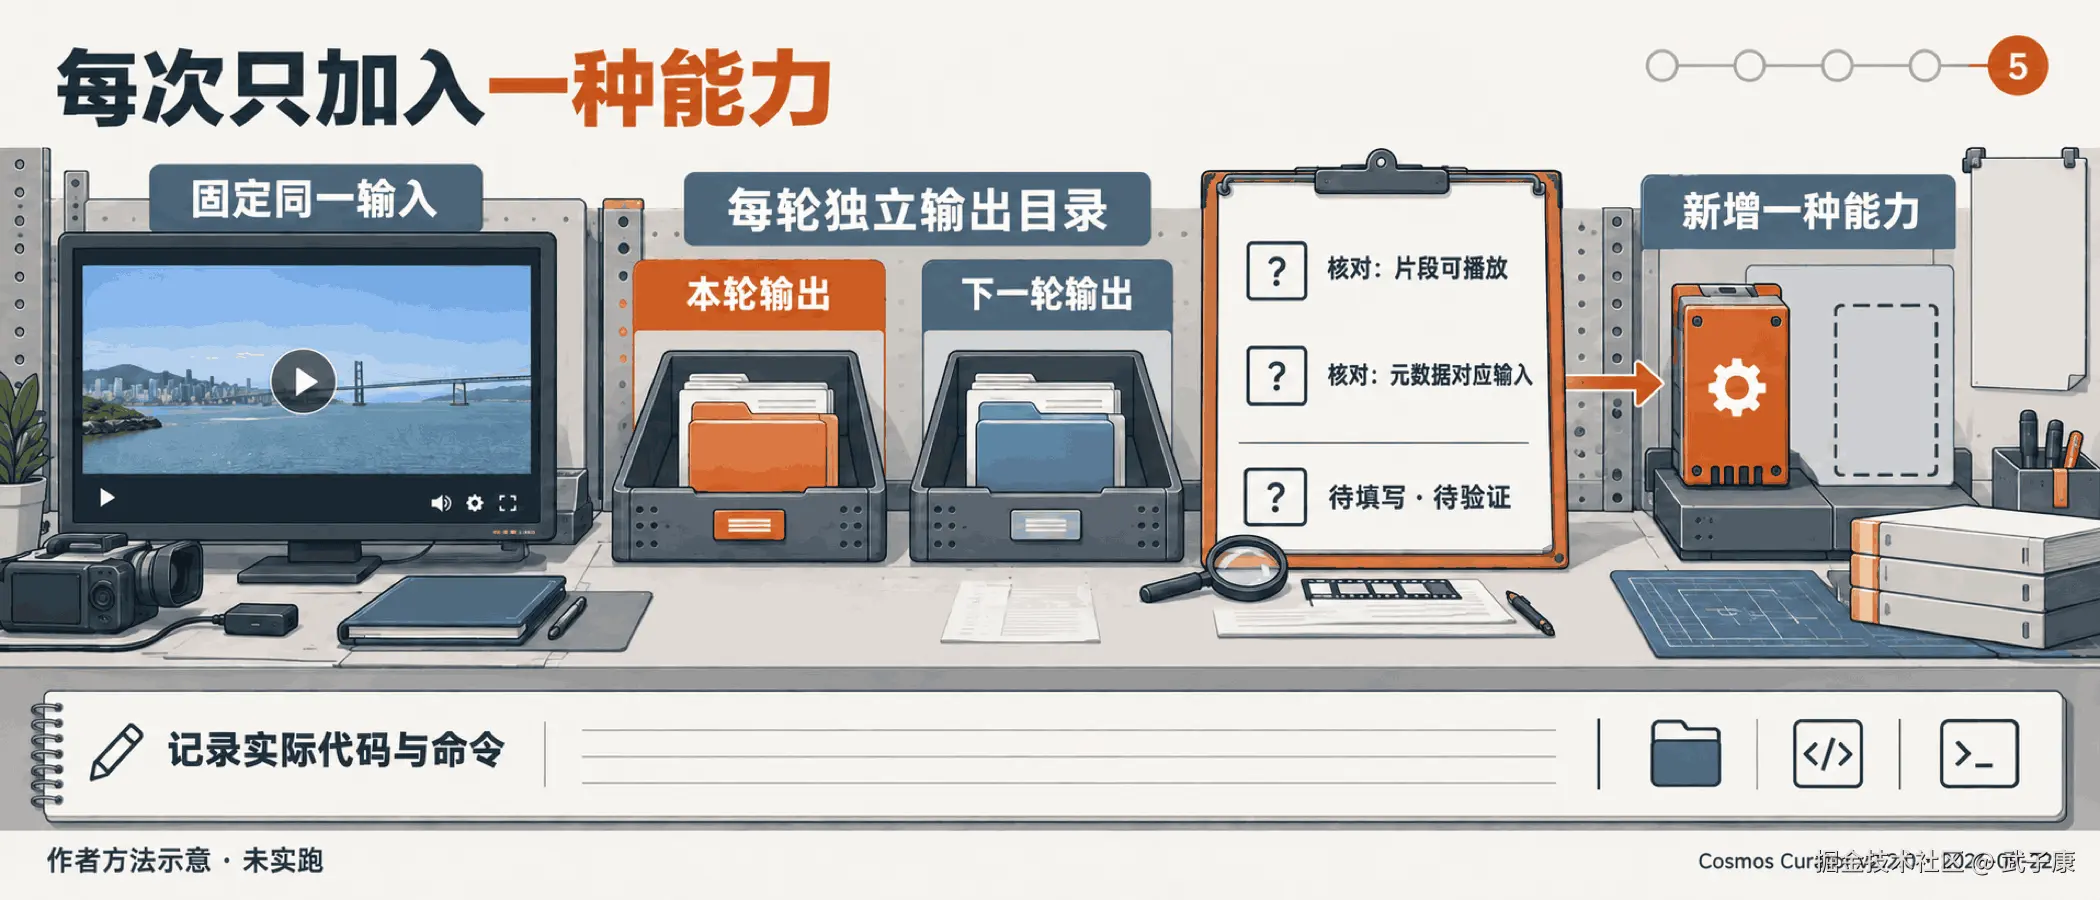
首轮验收的末尾,应回到输入和输出之间的对应关系。参考文档列出了 metas/v0/ 下的片段元数据、processed_videos/ 下的输入处理记录,以及整轮 summary.json 等产物。它们可以相互核对,但单独存在任何一个文件,都不等于业务结果完整。^4^
对上面的基础范围,至少要人工抽查输出片段是否能打开、时长与切分设置是否相符,并把片段元数据关联回那条输入视频。若输出少于预期,要先看片段长度约束、错误和实际选中范围;若摘要写了处理完成,也要确认对应文件可读,而不是只记录退出码。关闭描述与向量时,不应要求出现这两类结果,更不应把缺少它们写成流水线失败。
下面这份记录是待填写模板,不是本文已完成的测试报告:
text
输入:文件标识/哈希、时长、分辨率、编码
执行:源码提交及修改、镜像身份、宿主/容器边界、源码挂载
范围:实际命令、选中视频、切分方式、关闭的模型阶段
环境:GPU/驱动、可用CPU与内存、输入输出映射、可写空间
本轮:起止时间、独立输出目录、日志位置、退出状态
结果:片段与输入的对应、可播放性、元数据、处理记录、摘要
判断:已证实的能力;尚未验证的能力;第一处有效异常
下一轮:仅增加哪项能力,预期新增什么可检查的输出
如果这一轮只证明短视频能够读入、按固定时长切分并写回,就把结论停在这里。模型描述质量、向量检索效果、多机吞吐和业务筛选准确性,都需要后续各自的证据。这样的记录看起来没有"全流程部署成功"醒目,却能让接手的人直接复现运行范围,并决定下一次该加哪个阶段,而不必重新猜测第一轮到底验证了什么。
Footnotes
-
固定官方源码 splitting_pipeline.py,参数默认值、阶段组装、运行入口与输入选择。2026-09-22 下载归档;源码分析,不是运行结果。 ↩ ↩2 ↩3
-
固定官方 End-User Guide,硬件与平台条件、宿主/容器入口、工作区映射、配置模式。文档条件不构成本文环境的验证结论。 ↩ ↩2 ↩3 ↩4
-
固定官方 launch_local.py,本地源码挂载、GPU 参数与容器启动行为。 ↩ ↩2
-
固定官方 Video Pipelines,输出目录、能力开关与 CPU 资源请求说明。与本系列首篇归档为同一固定提交。 ↩ ↩2