摘要
做工业物联网平台的人,多半算过一笔账:中型工厂几千台设备、上万个测点,振动波形按 10kHz 采样,一天几百 GB。存下来不难,难的是存下来之后:看板要毫秒级刷新、预警要秒级响应、年报要跨一年聚合,老板还想让 AI 直接"问数据"------每个需求最后都压在同一个地方:数据库。
传统时序数据库定位是"把数据存好":吞吐和压缩率卷到极致,计算分析却要导出去做------Spark 跑批、Python 建模、向量库检索。链路一长,实时性没了,一致性难保,AI 拿到的永远是"过期的数据"。
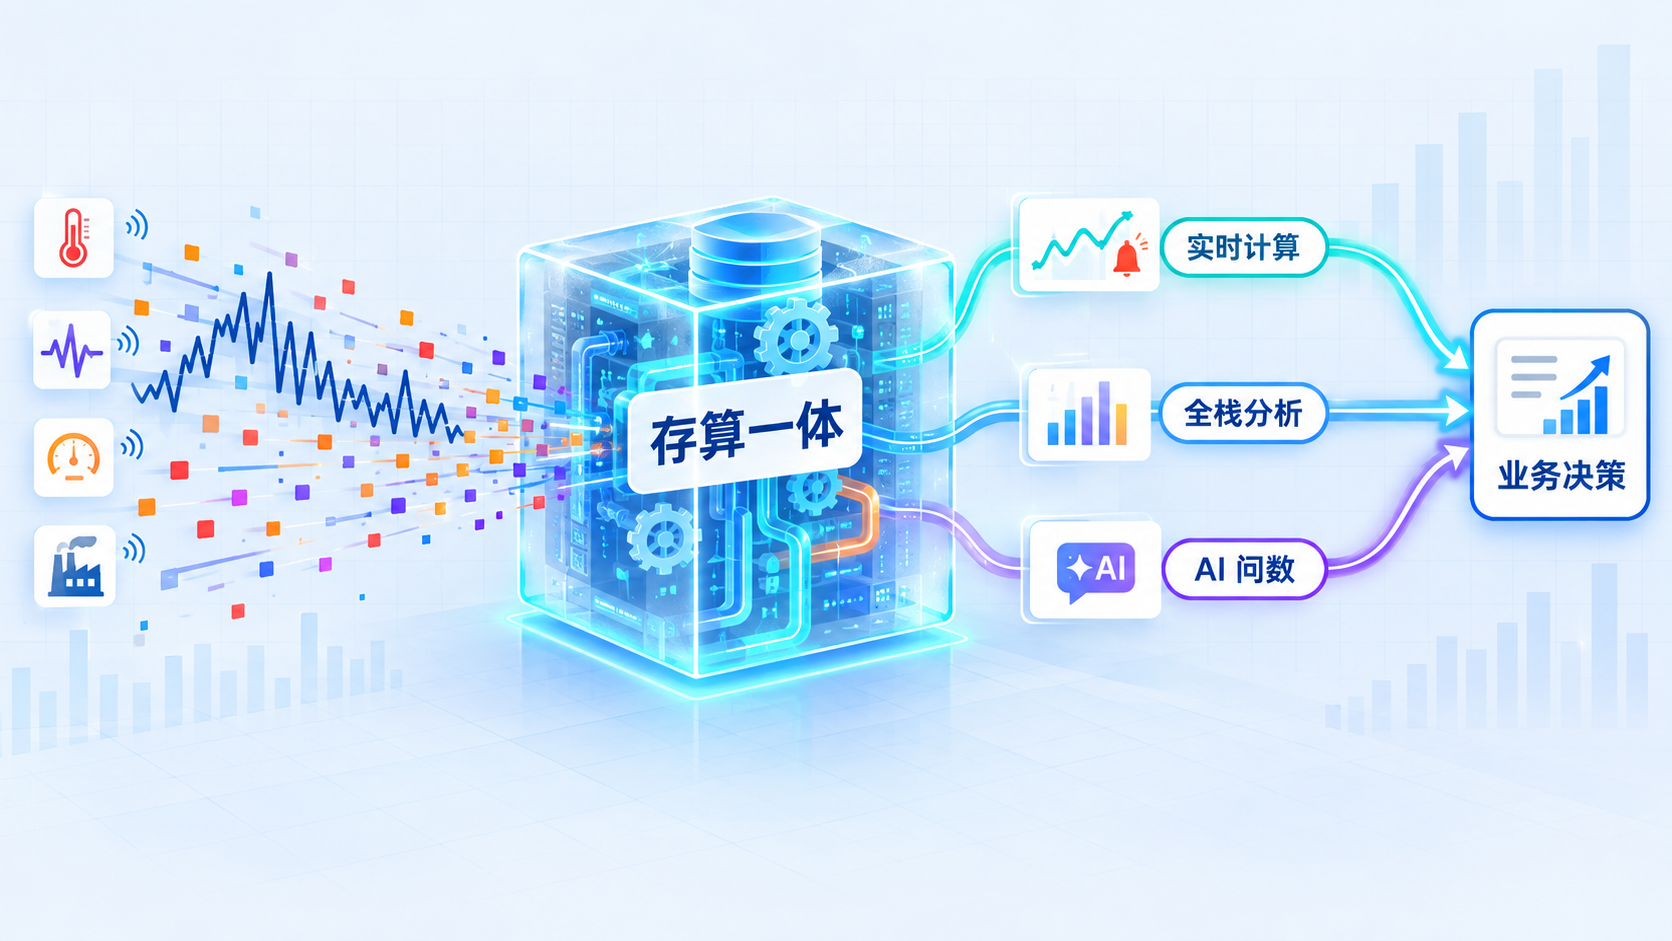
这篇围绕 DolphinDB 展开:如何用"存算一体 + 全栈计算 + AI 原生",把"数据---计算---AI---决策"的链路收拢到一个库里,并结合长江电力、中广核、中科院、中国航天等标杆案例讲清落地价值。
一、先摆困局:数据存下来之后的三道坎
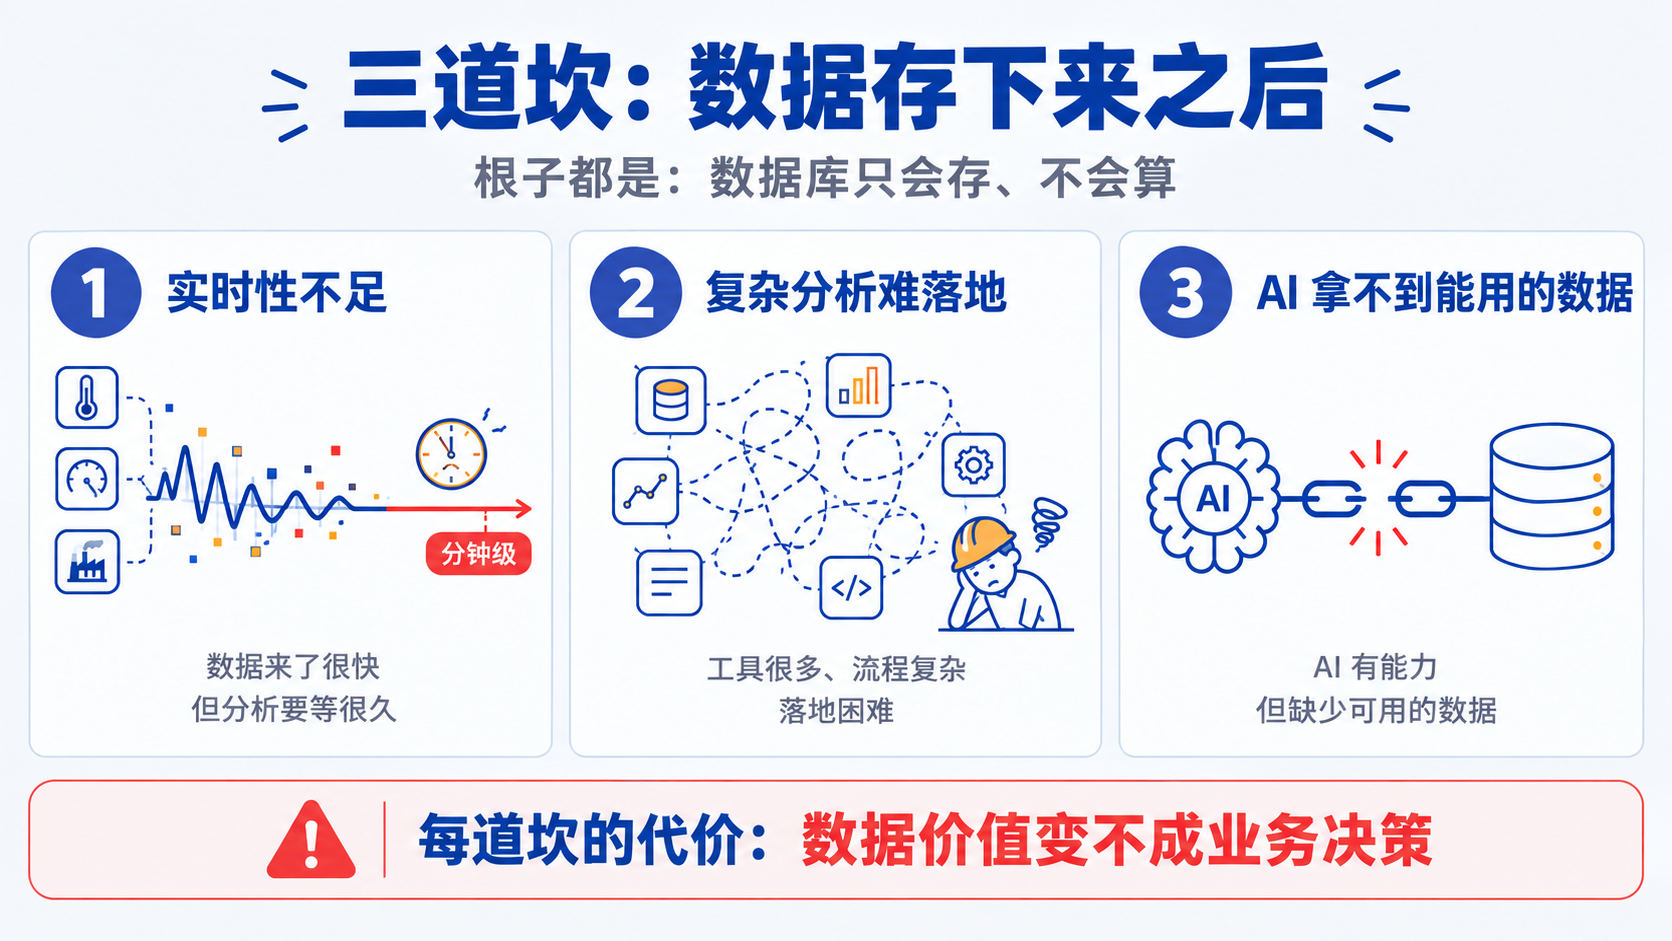
先把问题摆清楚。工业物联网的数据处理困境,表面千头万绪,拆开就是三道坎,每道都卡在"数据库只会存、不会算"这个根子上。
| 困局 | 典型表现 | 根因 |
|---|---|---|
| 实时性不足 | 故障预警压不到秒级、监控看板卡顿 | 存算分离:数据先落库、再导出到外部计算,链路天然带延迟 |
| 复杂分析难落地 | 一次多维聚合要跨四五套工具,统计口径对不齐 | 传统时序库"只能存、难分析、分析浅",计算能力依赖外部拼装 |
| AI 拿不到能用的数据 | 大模型不懂测点含义、无法继承权限、不敢让它碰生产库 | 数据底座与 AI 工具链割裂,实时数据、行业知识和治理体系互相不通 |
第一道坎是实时性。海量高频传感器数据接入后,传统时序库实时查询卡顿、复杂分析延迟高。设备故障从征兆到停机往往只有几秒到几分钟------预警停在分钟级,等于没有。根子在存算分离:数据"先存后算",每段都快,串起来也快不起来。
第二道坎是复杂分析的落地成本。工业分析远不止"查曲线":频域诊断要看 FFT 和小波,健康度要算滑动窗口统计,能耗优化要跨电表、工况、工单多维关联。传统架构里这些要联动多套工具,链路冗长、成本高昂,数据价值变不成业务决策。选一款"重存储、轻计算"的时序库,选完还得再搭分析平台------很多团队踩过的坑。
第三道坎最新也最棘手:AI 落地的最后一公里 。企业想引入大模型和 Agent,但模型不了解企业数据------不知道 temp_031 是哪台设备的测点、什么单位、超过多少算异常;不能继承生产权限,生成的脚本也不敢上生产库。老师傅的经验、设备手册、历史工单散落在系统之外,没人沉淀成 AI 能用的资产。
三道坎指向同一个判断:工业物联网需要的不是"存得更好"的数据库,而是"算得动、接得上 AI"的数据底座。这正是 DolphinDB 的切入点。
二、DolphinDB 是什么:一个长在数据上的计算平台
交代背景。DolphinDB 是浙江智臾科技自主研发的高性能分布式时序数据库,拥有完全自主知识产权;DB-Engines 时序数据库排名世界第五、国内第一,连续入选 Gartner 多份中国数据库报告代表厂商,是信创工委会会员单位,全面支持国产芯片与操作系统,在能源电力、石化、智能制造、核工业等领域有大规模生产级落地。
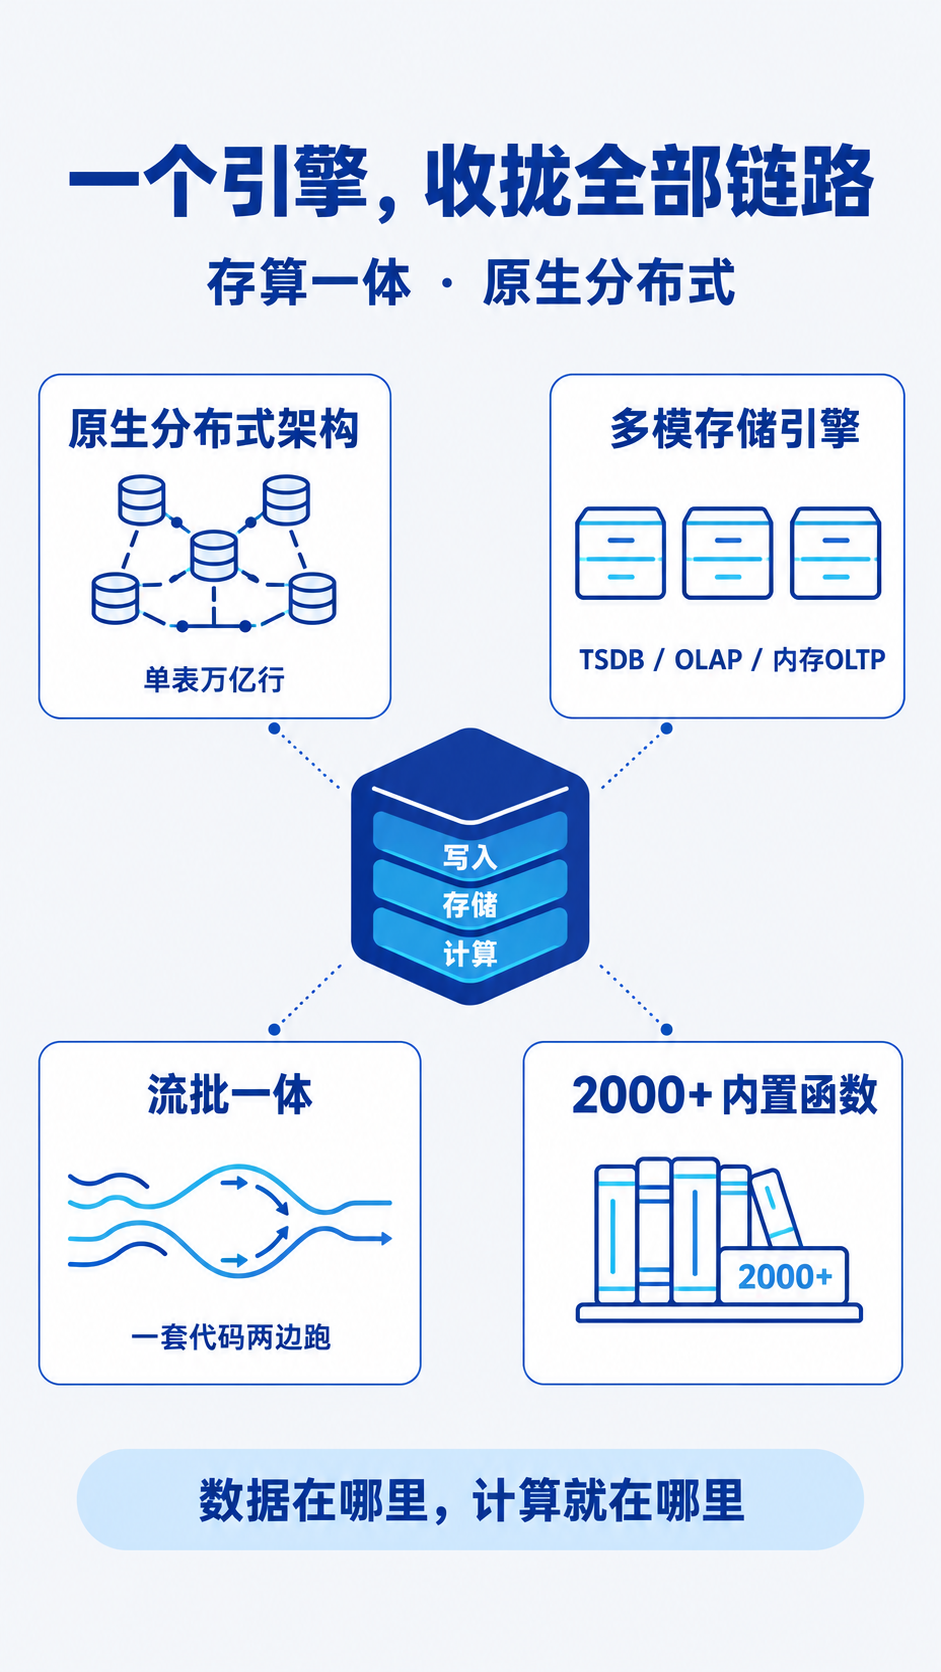
但比"是什么公司"更重要的,是"它把自己做成了什么形态"。在工业数据库这个赛道上,DolphinDB 的关键词不是"存储引擎",而是存算一体:
- 原生分布式架构:水平扩展、负载均衡、容错与分布式事务,单表可承载万亿行;
- 多模存储引擎:TSDB、OLAP、In-Memory OLTP 等引擎各司其职,测点、档案、工单、归档各落其位,关联时库内直接 join,不跨系统搬数据;
- 流批一体的低代码流计算:批计算研发的指标代码可直接用于流计算,一套代码两边跑;
- 两千多个深度优化的内置函数:从时序聚合、异常检测到信号处理、机器学习,覆盖工业分析的绝大部分需求。
一句话概括它的产品哲学:数据在哪里,计算就在哪里------写入、存储、实时计算、离线分析、AI 建模收拢在同一个引擎里,这是后面三道破局的共同前提。
三、第一道破局:实时计算,让预警追上故障的速度
先看最硬的指标。依托存算一体、原生分布式计算引擎与流批一体设计,DolphinDB 可以做到千万级测点/秒高并发写入、毫秒级实时查询响应、秒级复杂实时分析。这三个数字要合起来看------工业的难点不是单项性能,而是高速写入、实时查询、复杂计算同时发生。
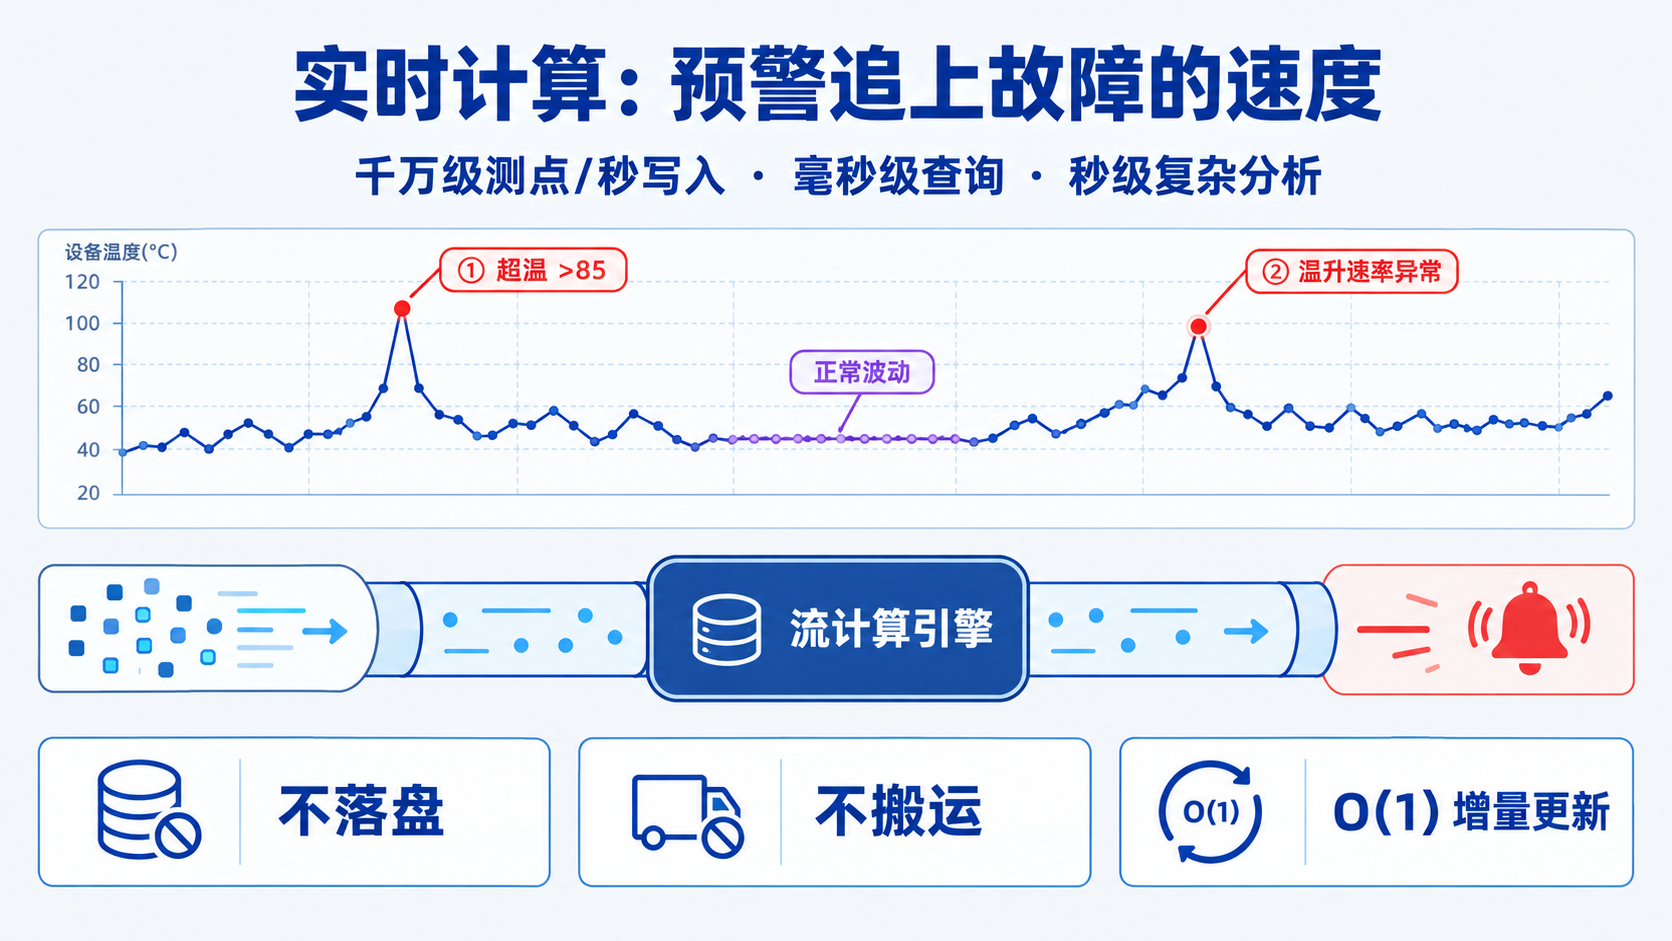
实时计算的核心载体是流计算引擎。以设备异常检测为例,思路是用简单表达式定义复杂异常规则,数据一进来就地判断、就地告警,不落盘、不搬运:
Plain
//流表接收设备实时数据
share streamTable(1:0, tsdeviceIdtemperaturevibration,
                  [TIMESTAMP, SYMBOL, DOUBLE, DOUBLE]) as deviceStream

//异常事件输出表:第一列记录命中的规则,其后为设备与时间
alerts = streamTable(1:0, anomalyRuledeviceId`ts,
                     [SYMBOL, SYMBOL, TIMESTAMP])

//三条规则同时挂上引擎:超温 / 温升速率异常 / 振动越限
createAnomalyDetectionEngine(
    name    = "deviceMonitor",
    metrics = <[temperature > 85,
                temperature - prev(temperature) > 10,
                vibration > 12]>,
    dummyTable = deviceStream,
    outputTable = alerts,
    timeColumn = ts,     keyColumn  = deviceId
)

//订阅实时流,数据一到即检测
subscribeTable(tableName = "deviceStream", actionName = "monitor",
              handler = getStreamEngine("deviceMonitor"))
几个工程细节:规则里能用 prev(temperature) 这类上下文函数表达"变化速率"语义,不需要自己维护状态;引擎内部大量增量计算,窗口统计量 O(1) 更新而非逐点重算;命中事件可直接对接消息中间件推送------从数值异常到告警送达全程在库内。这就是"存算一体"在延迟指标上的兑现。
这套能力在标杆项目里经受的考验更有说服力:
- 长江电力通过 DolphinDB 实现百万级水电测点实时监控,故障预警延迟从分钟级压缩至毫秒级------对工况变化以秒计的水电站,这是从事后处置到事中干预的质变;
- 某全球领先的智能制造服务商以 3 台 4 核 32GB 的普通服务器支撑无人工厂 32.4 万点/秒(双副本)实时写入,百亿量级下高并发即席查询保持毫秒级响应------硬件规格平平,靠的是架构;
- 某新能源车企的车联网平台用 DolphinDB 承接每秒 1.8 亿测点的不间断写入(含乱序数据),写入期间集群资源利用率稳定在 40% 左右,单点查询平均耗时 100ms 以内------写入扛住的同时查询还有余量,这才是"高并发"的真实含义。
四、第二道破局:全栈计算分析,把分析留在库内
实时性解决"快",这道破局解决"深"。DolphinDB 是工业时序数据的计算分析中枢而非存储工具------内置 2000+ 高度优化的时序计算函数,一站式覆盖时序聚合、异常检测、趋势推演、预测建模,无需额外开发。
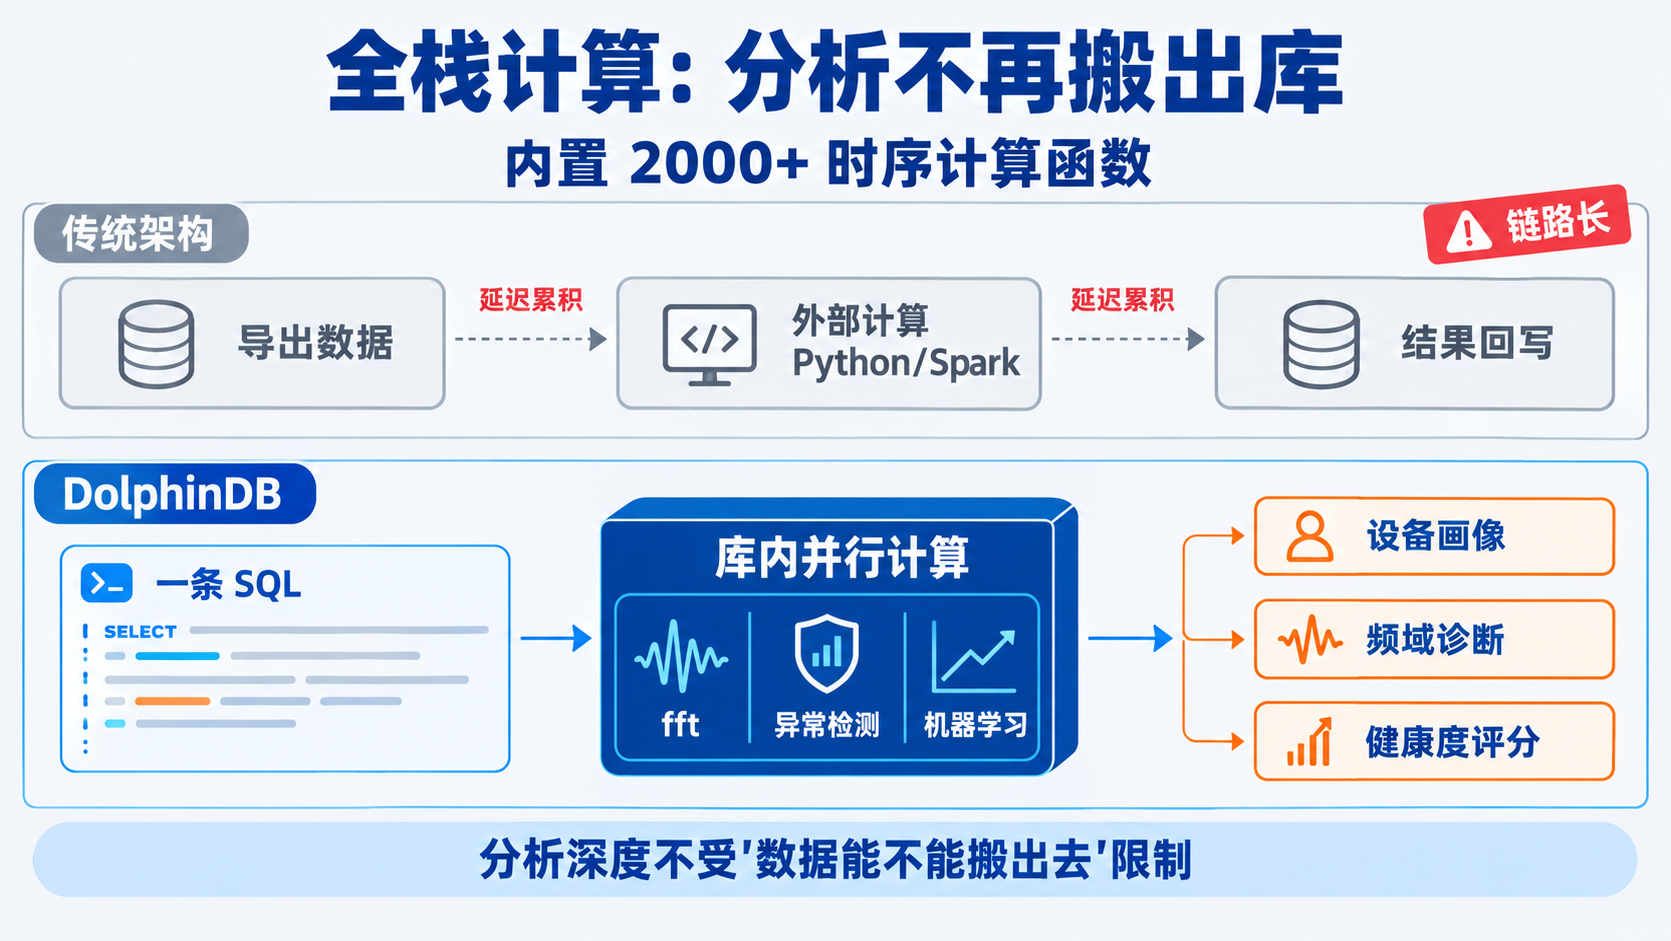
落到日常分析任务上,最直观的体验是"一条 SQL 出结果":
SQL
// 每台设备当日运行画像:样本量、均值、波动、摆幅、是否超温------库内一条查询
select deviceId,
       count(*)                                  as samples,
       avg(temperature)                          as avgTemp,
       std(temperature)                          as stdTemp,
       max(temperature) - min(temperature)       as swing,
       max(iif(temperature > 85, 1, 0))          as overheatFlag
from loadTable("dfs://iot", "device_metrics")
where date(ts) = 2026.09.14
group by deviceId
这段查询放到传统架构里,是"导出数据 → Python/Spark 计算 → 结果回写"三步;在 DolphinDB 里就是一条库内 SQL,聚合在存储节点上并行完成。再往上,函数库的深度开始显出差距:振动诊断的 fft、小波变换内置且向量化优化;异常检测从 3-sigma 到鲁棒 MAD 都有现成算子;机器学习与时序预测可以直接在库内训练推理------分析深度不再受"数据能不能搬出去"的限制。
更进一步是多模协同计算:时序、关系、文本、向量、空间数据在库内无缝融合------"查某台设备某时段的振动,同时关联它的档案、历史工单和相似故障案例",不再需要在四套系统之间拼数据。
标杆案例的验证同样扎实。某研究院借助 DolphinDB 完成核反应堆运行数据的实时分析与预测,无需额外搭建分析体系,效率显著提升;某地震台网中心用 DolphinDB 承接每 10 毫秒一条的地震波形,从 MiniSeed 解析、实时流接入、分布式存储到异常检测全流程库内完成,靠内置 FFT、小波与 FilterPicker 插件做到毫秒级波形异常检测;中核集团某研究院的工业组态监控体系则基于 DolphinDB 实现了对 MySQL 的平滑替代,单表百亿量级下查询响应保持在毫秒级。中广核、中国航天等用户的落地,也在持续验证同一件事:复杂工业分析,可以在数据库里完成。
五、第三道破局:AI 时代的智能数据库底座
第三道破局面向未来。工业客户对 AI 的诉求已从"要不要用"变成"怎么落到生产环境",卡点往往不在模型,在数据侧。DolphinDB 的回答是把数据库升级为智能数据库:让实时数据、计算、行业知识和治理体系原生长在同一个底座上,AI 直接站在数据库的肩膀上工作。
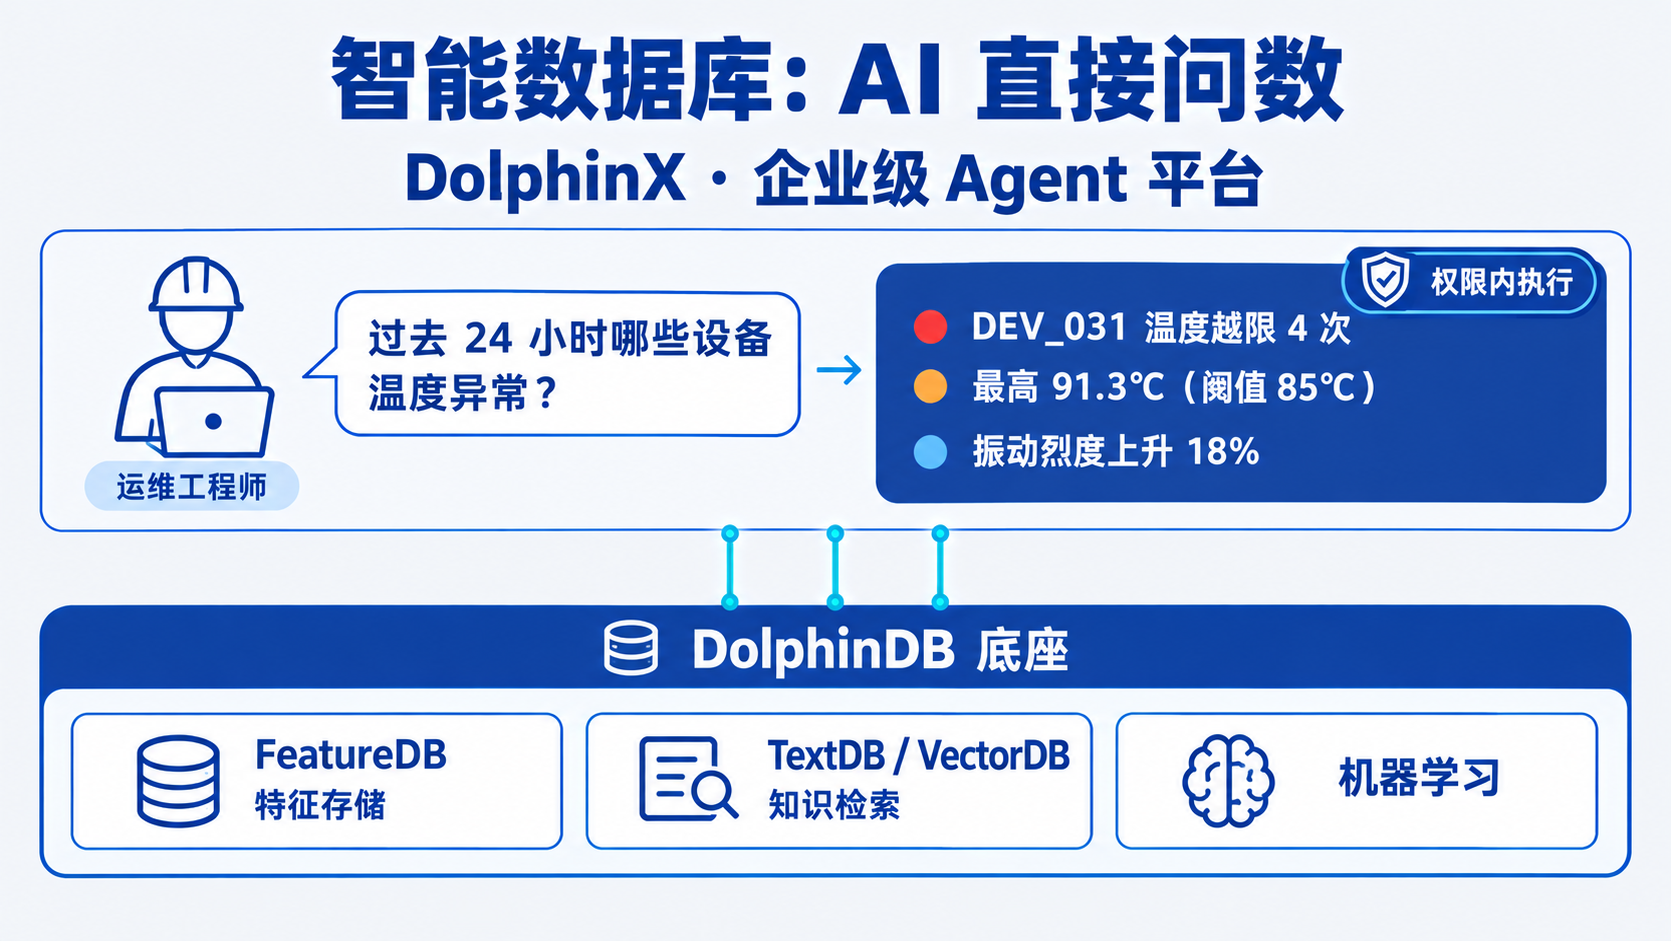
体系的核心是 DolphinX------内嵌于 DolphinDB Server 的企业级 AI Agent 开发与治理平台。它不是套在数据库外的"AI 助手"皮肤,而是把大模型与企业数据、计算、脚本、知识库、MCP、行业能力直接打通。工业现场的一个典型问法:
运维工程师:过去 24 小时哪些设备温度异常?
DolphinX:DEV_031(3 号机组冷却泵)过去 24 小时出现 4 次温度越限,最高 91.3°C(阈值 85°C),最近一次在 14:22;同时段振动烈度上升 18%,已关联该设备近 30 天健康度趋势,建议优先排查轴承。分析基于实时测点与告警记录生成,脚本已存档可复核。
回答它,系统要理解测点含义、单位和阈值,要关联告警与维修上下文,要在权限内安全执行脚本,还要把分析沉淀为可复用的经验。DolphinX 用自动上下文管理、记忆系统、RAG 知识库、Skill 与 MCP 工具体系、权限继承和脚本安全执行机制,把这些整合成可治理、可审计、可复用的 Agent 能力------解决企业 AI 落地最后一公里。
围绕 DolphinX 的 AI 产品矩阵各就各位:FeatureDB 提供低延时特征存储,支撑模型训练、在线推理与特征复用;TextDB 与 VectorDB 构建企业知识库与 RAG 检索,让 Agent 读懂设备说明、运维经验和历史案例;内置机器学习与时序分析支撑故障预测、负荷预测与健康度评分。关键在于这些能力不是外部拼装的------特征、知识、模型与实时数据、计算引擎、权限体系共享同一个底座,"数据---计算---AI---决策"在库内闭环。
六、写在最后
把整条链路串起来看:
Plain
海量测点接入 ──► 实时计算(毫秒级预警)      ──┐
                复杂分析(2000+ 函数库内完成)──┼──► 业务决策
                AI 问数(DolphinX + 特征/知识)──┘
同一个数据底座回到开头三道坎,答案已经清楚:实时性靠存算一体,分析深度靠全栈计算,AI 落地靠原生融合的智能数据库底座。长江电力、中广核、中科院、中国航天等标杆验证的不只是性能数字,更是这套架构在生产环境的可用性与工程成熟度。
对正在选型的团队,判断标准可以收敛为一句话:不要只问数据库能存多少、写多快,要问它在数据存下来之后能算多深、离 AI 有多近。工业智能化的下一程,比的不是数据仓库更大,而是谁能把实时数据、计算能力和行业知识拧成一股绳------从这个标准看,DolphinDB 的答卷值得认真放进短名单。